Cargando...

 BetaBeta
En la lección pasada apuntaste read-any-asset.ts a todo lo que Overgrowth posee y volvió con el estante completo: el mint SPROUT, los activos Almanac y un cNFT de crate Harvest que no tiene cuenta en ninguna parte on-chain. Esa lectura tuvo que pasar por un RPC de DAS, porque no había nada a lo que hacerle getAccountInfo. Ya pagaste el impuesto de lectura de la compresión una vez, a sabiendas.
Lo cual prepara la idea que hoy quiero matar. Si un millón de NFTs caben en un árbol por centavos, ¿por qué no meter también los balances de SPROUT en un árbol? ¿Por qué alguien sigue bloqueando casi dos millones de lamports de rent por cuenta de token?
La respuesta es aritmética, y puedes correrla antes de leer otro párrafo. Los dos factores con cara de magia son una cuenta de bytes y una tasa de rent: una cuenta de token clásica tiene 293 bytes (165 de datos más el encabezado de cuenta de 128 bytes), y mainnet cobraba 6,333 lamports por byte cuando lo leí el 2026-09-06:
node -e "console.log('break-even:', Math.floor((293 * 6_333 - 5_000) / 5_300), 'lifetime writes')"
break-even: 349 lifetime writes. Dos nombres antes de la aritmética, porque los dos son nuevos: Light Protocol es el equipo detrás de la compresión ZK, el segundo riel de compresión que esta lección presenta (cuentas probadas en vez de almacenadas, la prima fungible del truco de Bubblegum), y su generación de programa actual se llama V2, el V2 propio de Light, nada que ver con Bubblegum v2. El número compara una cuenta de token comprimida sobre ese riel (5,000 lamports para crearla, unos 5,300 lamports de costo de estado por transferencia) contra una cuenta de token SPL clásica: 293 × 6,333 = 1,855,569 lamports de rent a esa tasa fechada de mainnet, y nada por transferencia. La tasa es la mitad viva del producto. SIMD-0437 la está bajando por etapas y los clusters no van al mismo paso — devnet ya leía 5,080 el mismo día, lo que deja el mismo break-even en 279 — así que el rent es algo que re-derivas en tu cluster, nunca una constante que citas. Escribe esa cuenta 349 veces y la compresión ya gastó todo lo que la cuenta clásica apenas dejaba bloqueado. Escríbela 4,000 veces y quemaste más de once veces el rent que intentabas evitar.
Esa es la lección entera en una línea, y el resto es por qué la línea es verdadera, de dónde sale, y qué le hace a la foto la segunda mitad de la factura (cómputo, no lamports). Esta es una lección de razonamiento, no una lección de construcción. Hoy no vas a comprimir un token; vas a decidir si hacerlo.
El repliegue de la ayuda, dicho sin rodeos: el modelo de costos y los primeros tres veredictos de carga de trabajo se trabajan de punta a punta, las dos reglas descalificadoras las escribes tú, y la cuarta carga de trabajo más el informe son enteramente en solitario. Lo que te llevas es una herramienta pequeña, compression-verdict.ts, y una respuesta defendible a una pregunta que un compañero te va a hacer de verdad.
El módulo 7 ha sido un largo argumento de que guardar estado por activo en cuentas es una elección, no una ley. Bubblegum v2 lo demostró para los NFTs: un millón de crates Harvest, un árbol, una raíz on-chain, y los crates mismos viviendo como hojas hasheadas que un indexador reconstruye a demanda. El colapso de costo ahí es real y lo mediste.
Así que la pregunta natural, la que un lector agudo hace en cuanto el mint del cNFT funciona, es por qué el truco tiene forma de NFT. A nada en "hashea el estado, guarda la raíz, prueba la pertenencia cuando necesites escribir" le importa si el estado son los metadatos de un NFT o un balance de token o una PDA arbitraria. Si el truco generaliza, el modelo de cuentas entero es negociable.
Sí generaliza. Eso es la compresión ZK. Pero generaliza a través de un mecanismo distinto del que acabas de usar, y la diferencia de mecanismo es exactamente donde cambia la economía.
Empieza por la prueba, porque todo lo demás sale de ahí.
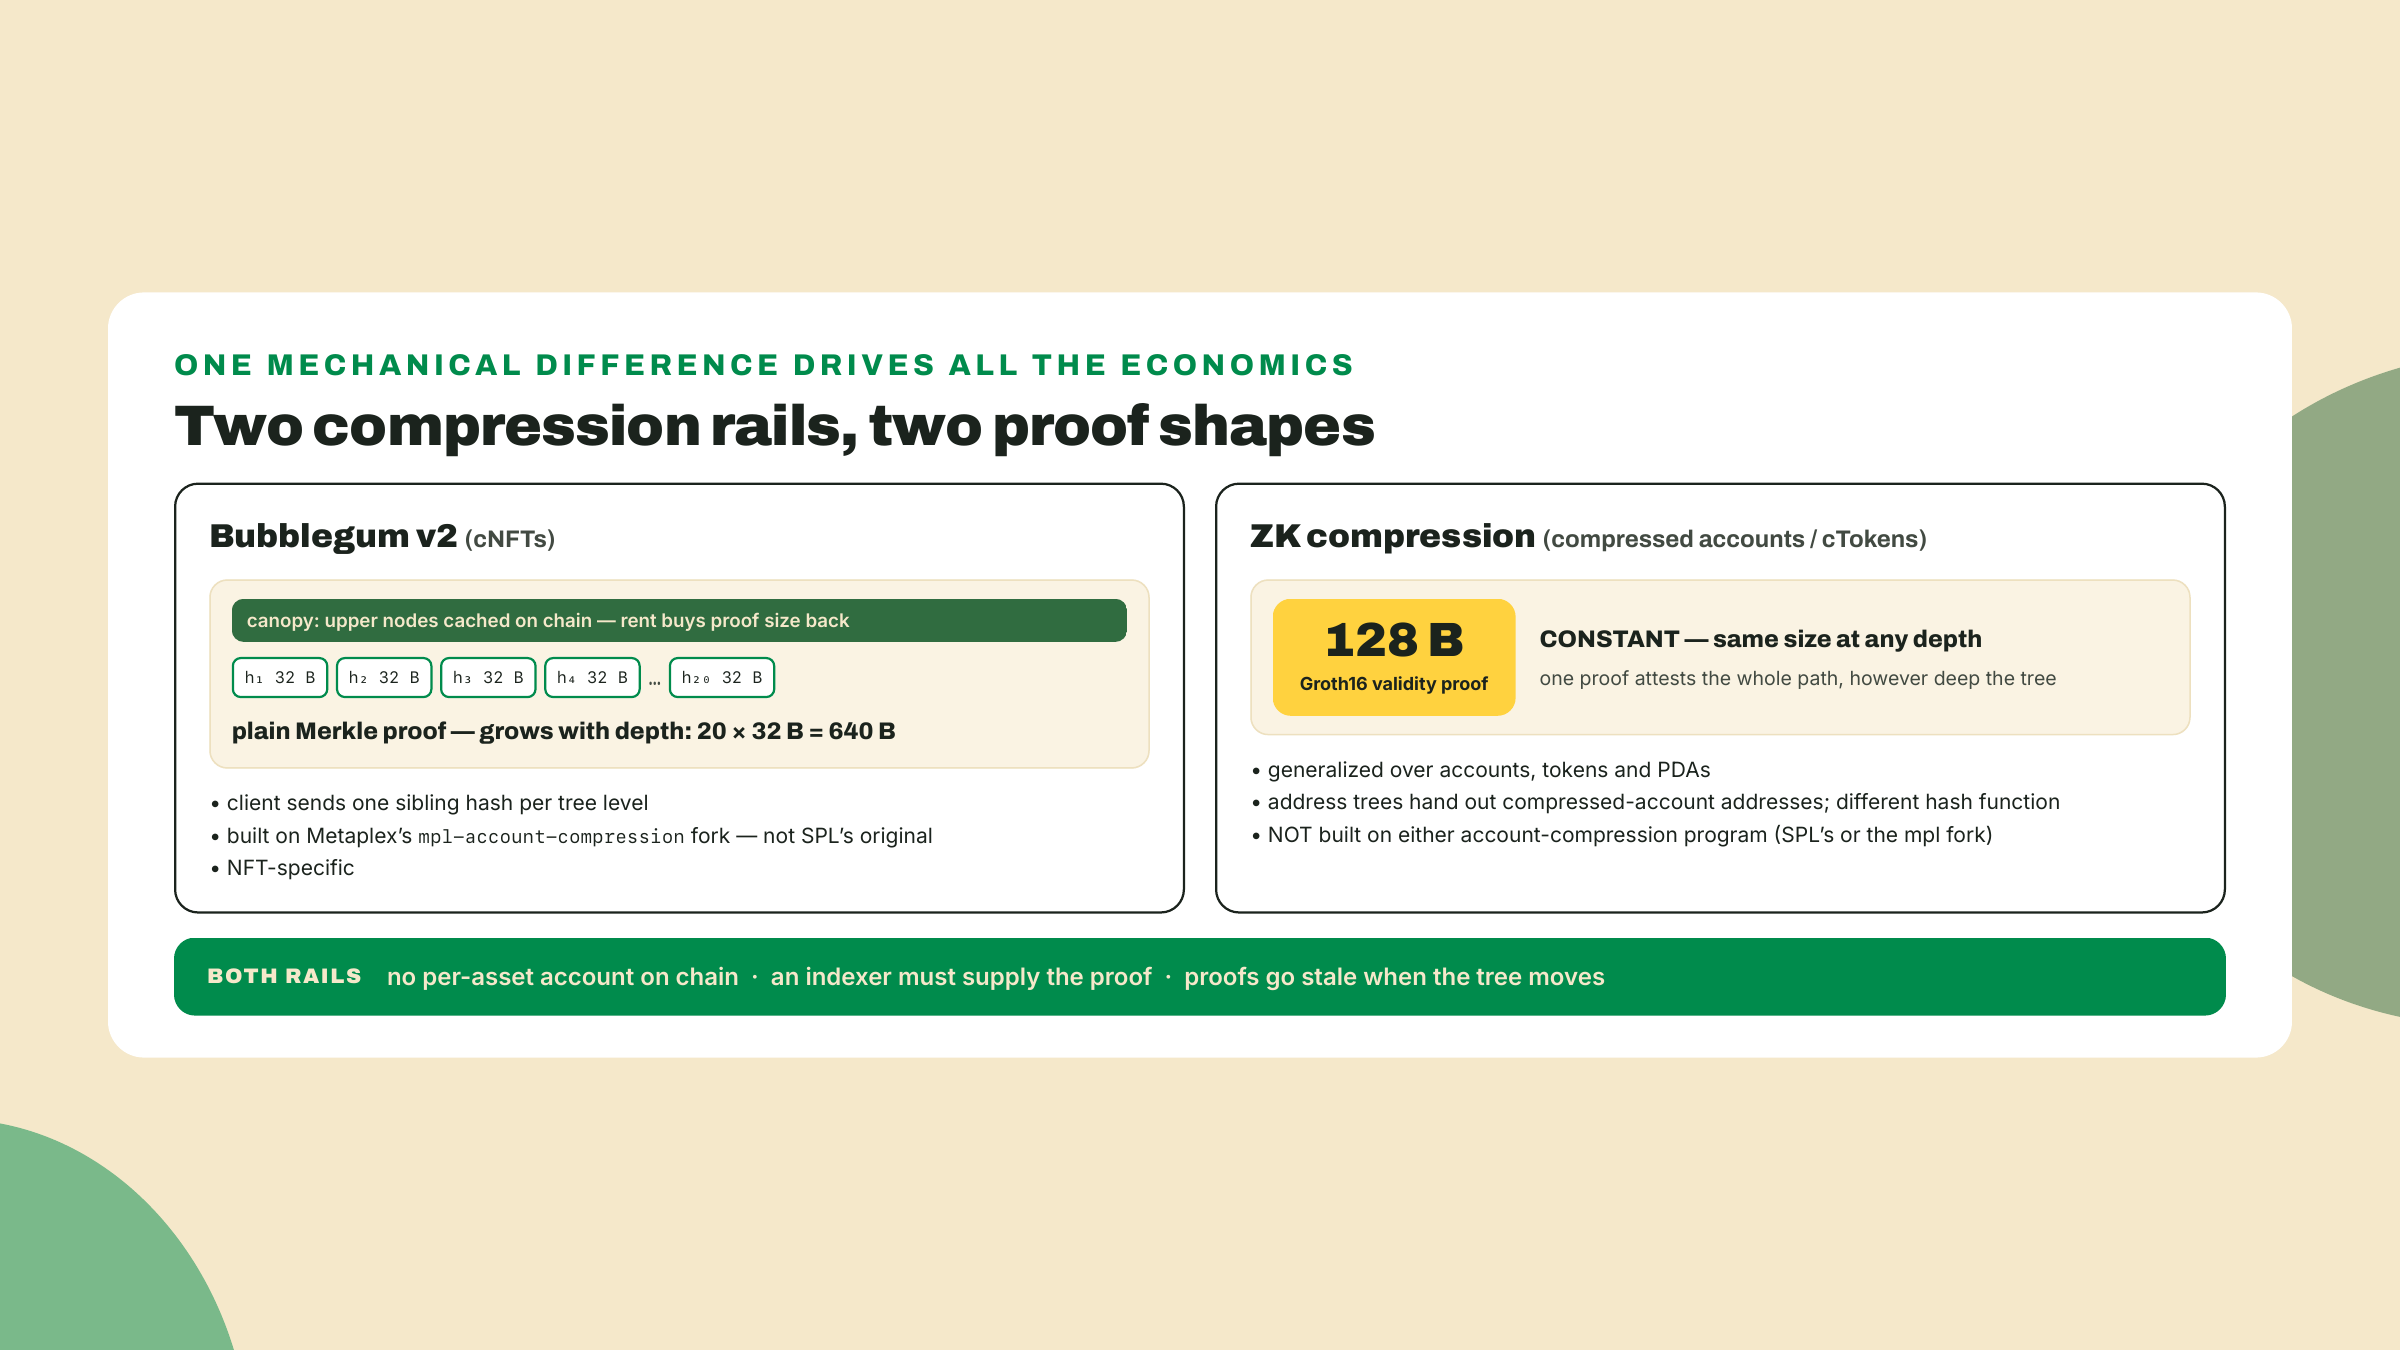
Una escritura de cNFT de Bubblegum es una prueba de Merkle simple. Para transferir una hoja le entregas al programa los hashes hermanos a lo largo del camino que va de tu hoja hasta la raíz, y el programa rehashea hacia arriba y verifica que llegó a la raíz que ya guarda. El tamaño de la prueba es la profundidad del árbol. Profundidad 20, por tomar un tamaño común, significa 20 hashes hermanos de 32 bytes cada uno, o sea 640 bytes de prueba viajando en tu transacción antes que cualquier otra cosa. Por eso existe el canopy: cachea los niveles de arriba del árbol on-chain, y el cliente solo manda la parte de abajo del camino. Compras pruebas más cortas para el cliente con rent, nivel por nivel.
La compresión ZK no manda el camino. Manda una prueba de validez: una prueba Groth16, 128 bytes, que sostiene que el estado que declaras está en el árbol sin recorrer nada. Constante. Un árbol poco profundo y uno profundo producen los mismos 128 bytes, porque una prueba sucinta es una afirmación sobre un cómputo, no una transcripción de él.
Compáralo con el papeleo. La prueba de Merkle es la cadena completa de recibos, y una historia más larga significa una carpeta más gruesa. La prueba de validez es una declaración notariada de que la carpeta está en regla, y el sello del notario es del mismo tamaño para una carpeta de diez páginas o de diez mil. Donde la analogía se rompe, y esto importa: el notario aquí es un prover, off-chain, y alguien tiene que correrlo y entregarte el sello por transacción. El tamaño constante no es lo mismo que gratis.
Ahora la definición, justo a tiempo.
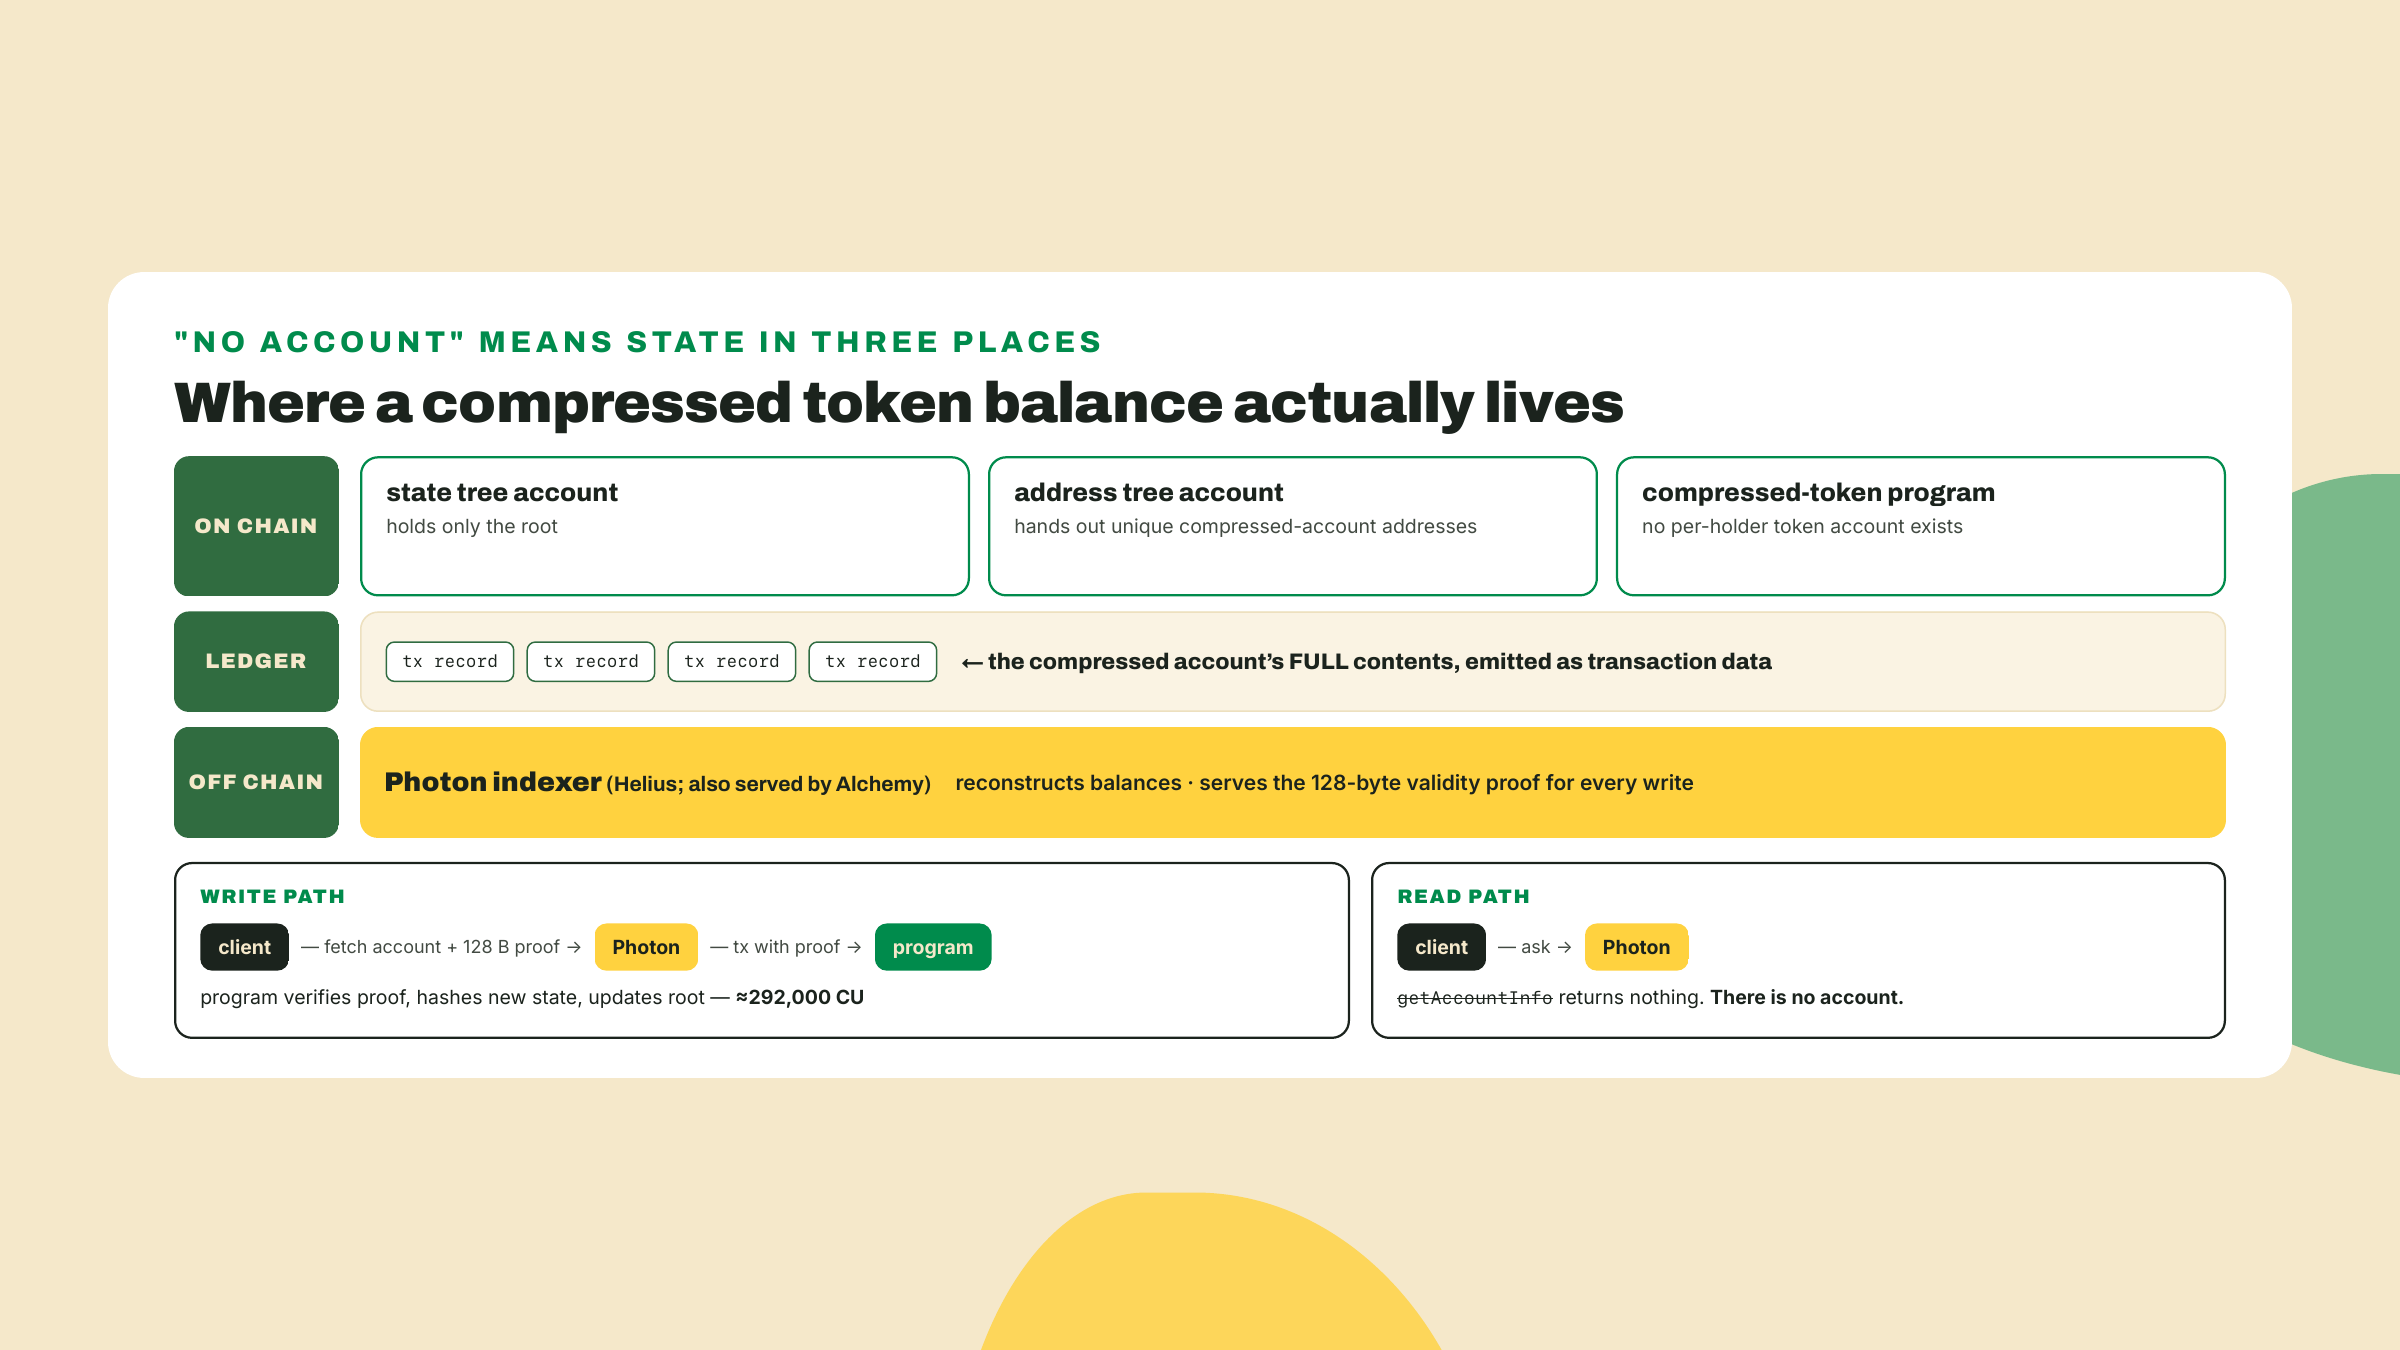
Una cuenta comprimida guarda las mismas cosas que guarda una cuenta normal de Solana: un programa dueño, un balance de lamports, un blob de datos, una dirección. Lo que no guarda es un lugar en la base de datos de cuentas que mantiene el validador. Su hash vive como una hoja en un árbol de estado, la raíz del árbol vive en una cuenta on-chain, y los contenidos reales de la cuenta viven en el ledger, reconstruidos por un indexador. Las direcciones salen de los árboles de direcciones, que existen para que una cuenta comprimida pueda tener una dirección estable, única y derivable en vez de quedar identificada solo por su posición en un árbol.
Un cToken es esa maquinaria aplicada a un balance de token: una cuenta comprimida cuyos datos son un layout de cuenta de token, propiedad del programa de tokens comprimidos.
La parte que la gente se salta, y la parte que hace que los dos rieles sean sistemas genuinamente distintos en vez de dos ajustes de un mismo sistema: la compresión ZK no está construida sobre account compression en ninguno de sus dos sabores, ni el original de SPL ni el fork de mpl sobre el que corre Bubblegum v2. Programa distinto, maquinaria de árbol distinta, función de hash distinta de la que usan los árboles de Bubblegum. Saber Bubblegum no quiere decir que sepas esto. Quiere decir que tienes la intuición y ninguna de las interfaces.
Dos números venden la compresión y un número debería frenarte.
Crear una cuenta de token comprimida cuesta unos 5,000 lamports. Crear una cuenta de token SPL clásica bloquea 1,855,569 lamports de rent — los 293 bytes × 6,333 lamports/byte del resumen, mainnet, 2026-09-06. Esa proporción, de unas 370x a esa tasa, es toda la razón por la que alguien hace airdrop con compresión, y la lección del drop del módulo 8 la convierte en una tabla por destinatario contra la que de verdad vas a presupuestar, junto con la sonda de una línea (solana rent 165 --url <cluster>) que relee la tasa el día que presupuestes.
Después el tercer número. Una transferencia de token comprimido corre unas 292,000 CU. La verificación de la prueba y el hasheo del árbol no son gratis, y los pagas por escritura. Pon eso al lado de la transferencia clásica que conociste en m01-l3, donde el motor p-token llevó la instrucción Transfer a 76 CU. La misma acción visible para el usuario, unas 3,800 veces el cómputo.
Desglósalo como una factura, por cuenta, a lo largo de una vida de W escrituras:
| Camino | Creación | Por escritura (lamports) | Por escritura (CU) |
|---|---|---|---|
| Cuenta de token SPL clásica | 1,855,569 de rent (293 × 6,333, mainnet 2026-09-06; un depósito reembolsable) | 0 | 76 |
| Cuenta de token comprimida | ~5,000 | ~5,300 (costo de estado en V2) | ~292,000 |
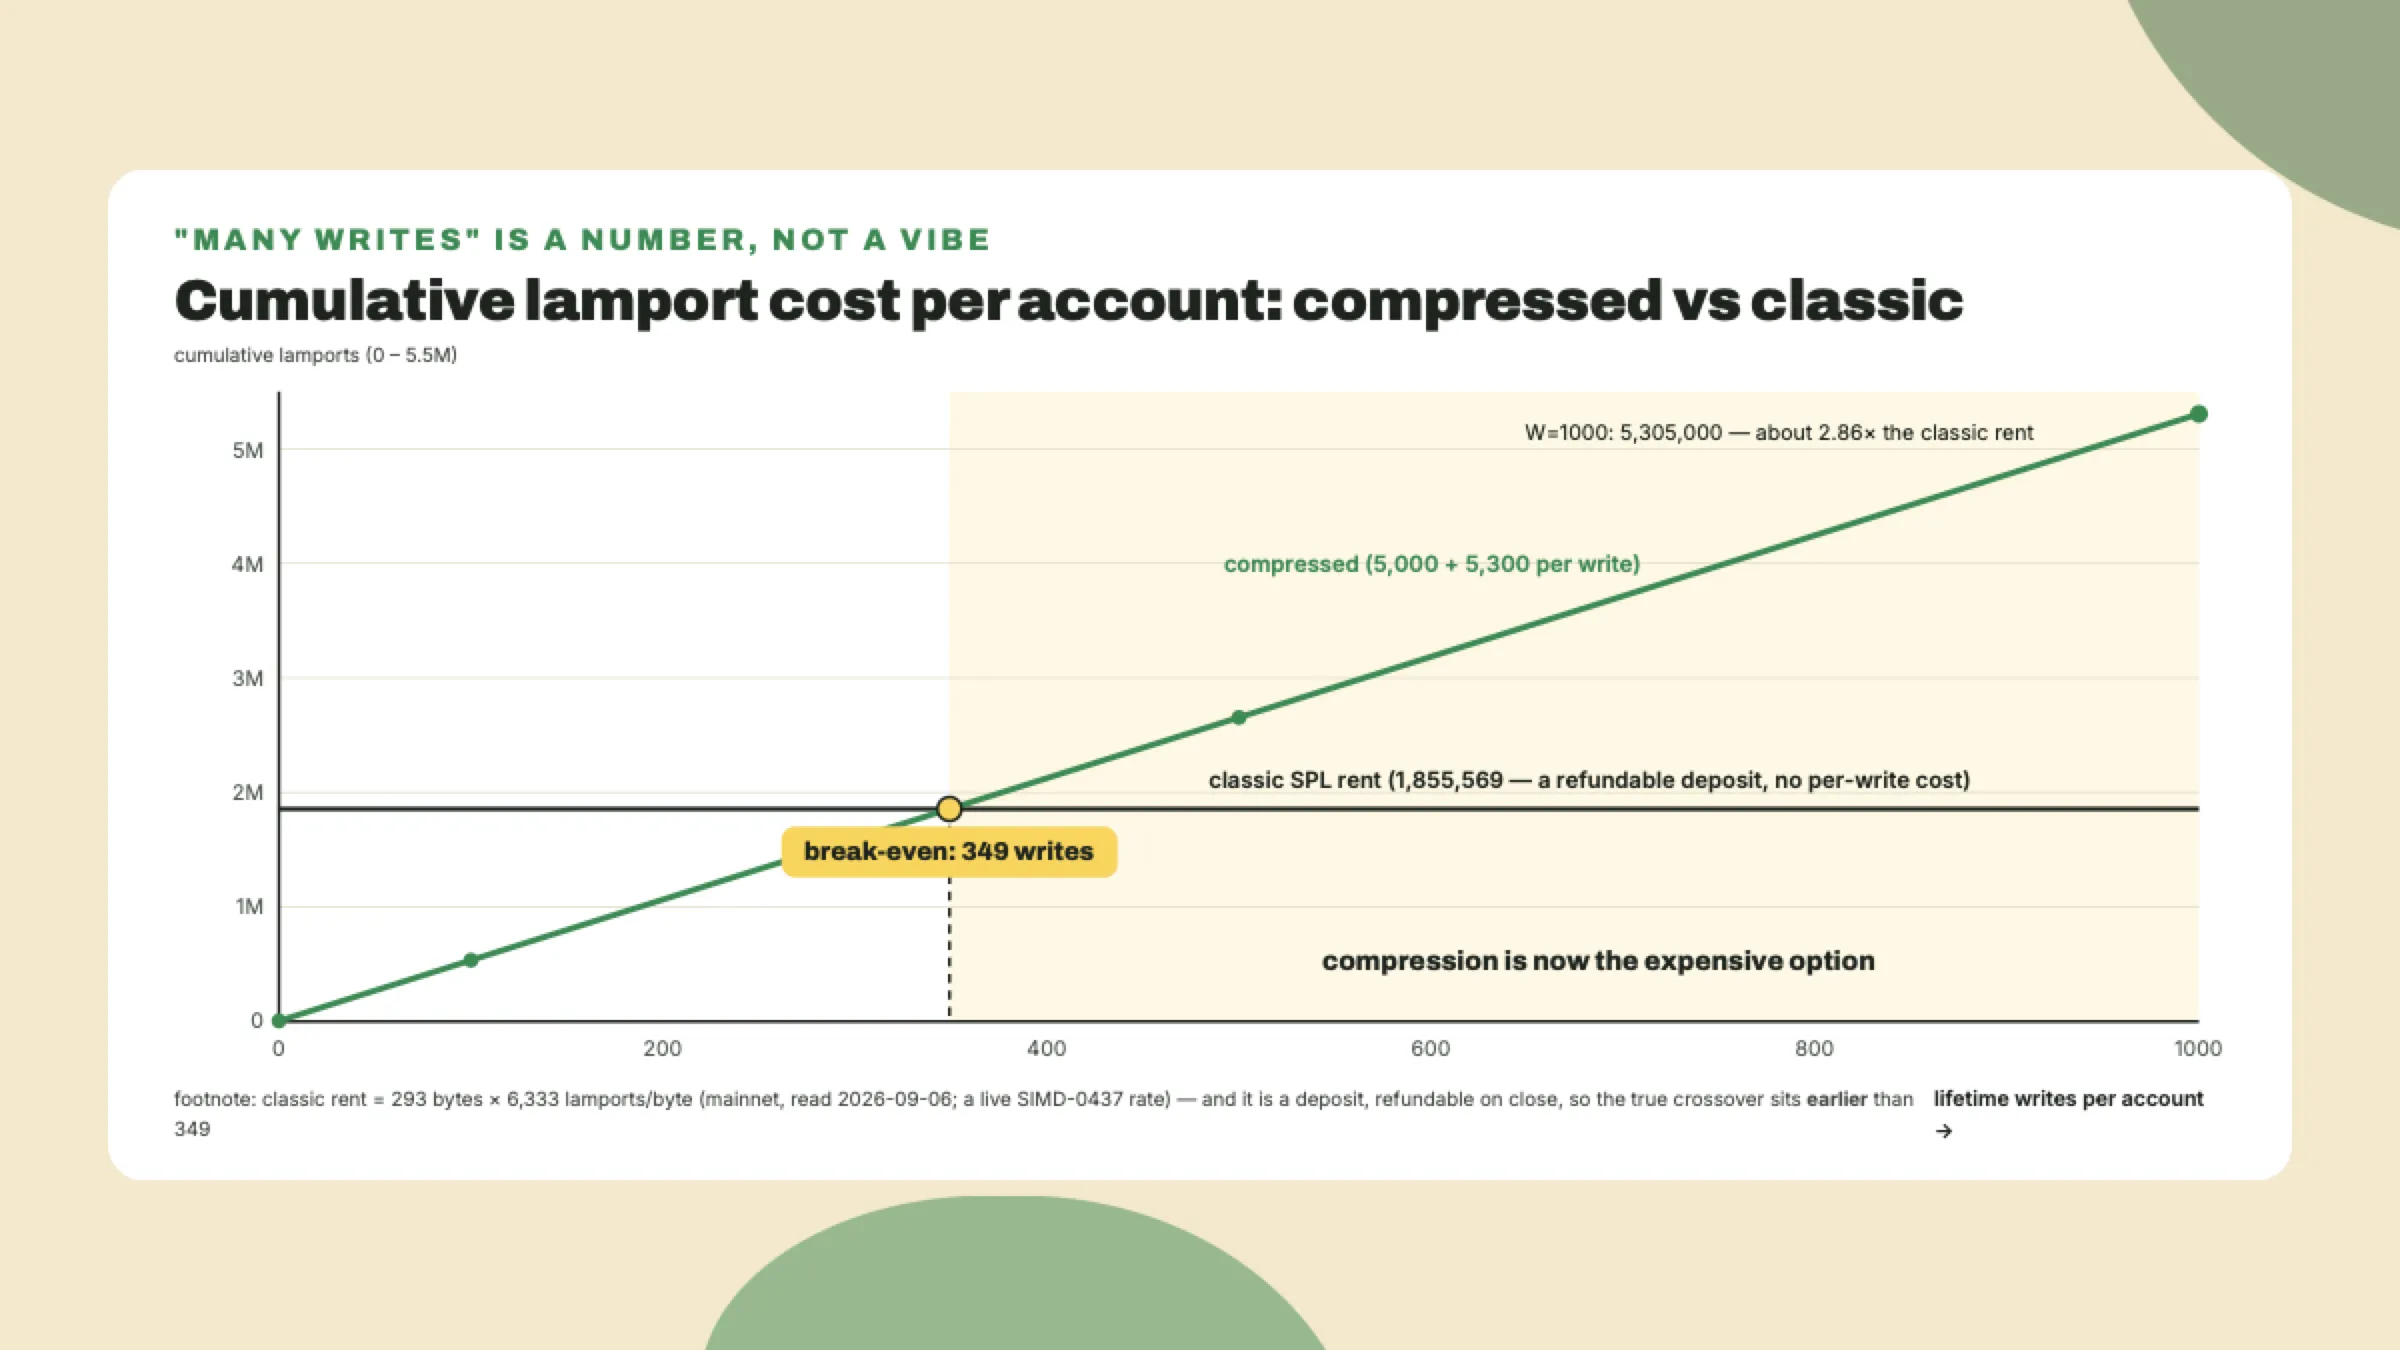
Iguala las dos columnas de lamports y te sale el número que imprimió el one-liner: 5,000 + 5,300W cruza 1,855,569 en W = 349. Por debajo de 349 escrituras de por vida, la compresión es más barata en lamports. Por encima, la compresión es más cara, y la brecha se ensancha para siempre desde ahí, porque un lado tiene un término por escritura y el otro no. Y como el lado clásico es una cuenta de bytes por una tasa viva, el cruce se mueve cuando la tasa baja un escalón: los 5,080 de devnet lo dejan hoy en 279, y el próximo paso de SIMD-0437 mueve los dos. El break-even es una salida del modelo, nunca una constante del modelo.
Hay una versión más afilada de ese argumento. Los 1,855,569 lamports de la cuenta clásica son rent, y el rent es un depósito: cierras la cuenta y te lo devuelven. Los 5,300 lamports por escritura de la cuenta comprimida están gastados. Así que el break-even honesto es más temprano que 349, y la razón para seguir citando 349 es que la mayoría de la gente nunca cierra sus cuentas de token y por eso nunca siente el reembolso. La guía que vas a ver citada en el ecosistema es de unas mil escrituras de por vida como la línea donde la compresión deja de convenir. Nuestra aritmética cruza bastante antes. Trata las mil como un techo generoso, no como una meta.
Con la factura sobre la mesa, recorre las posiciones obvias y mira cómo cada una falla.
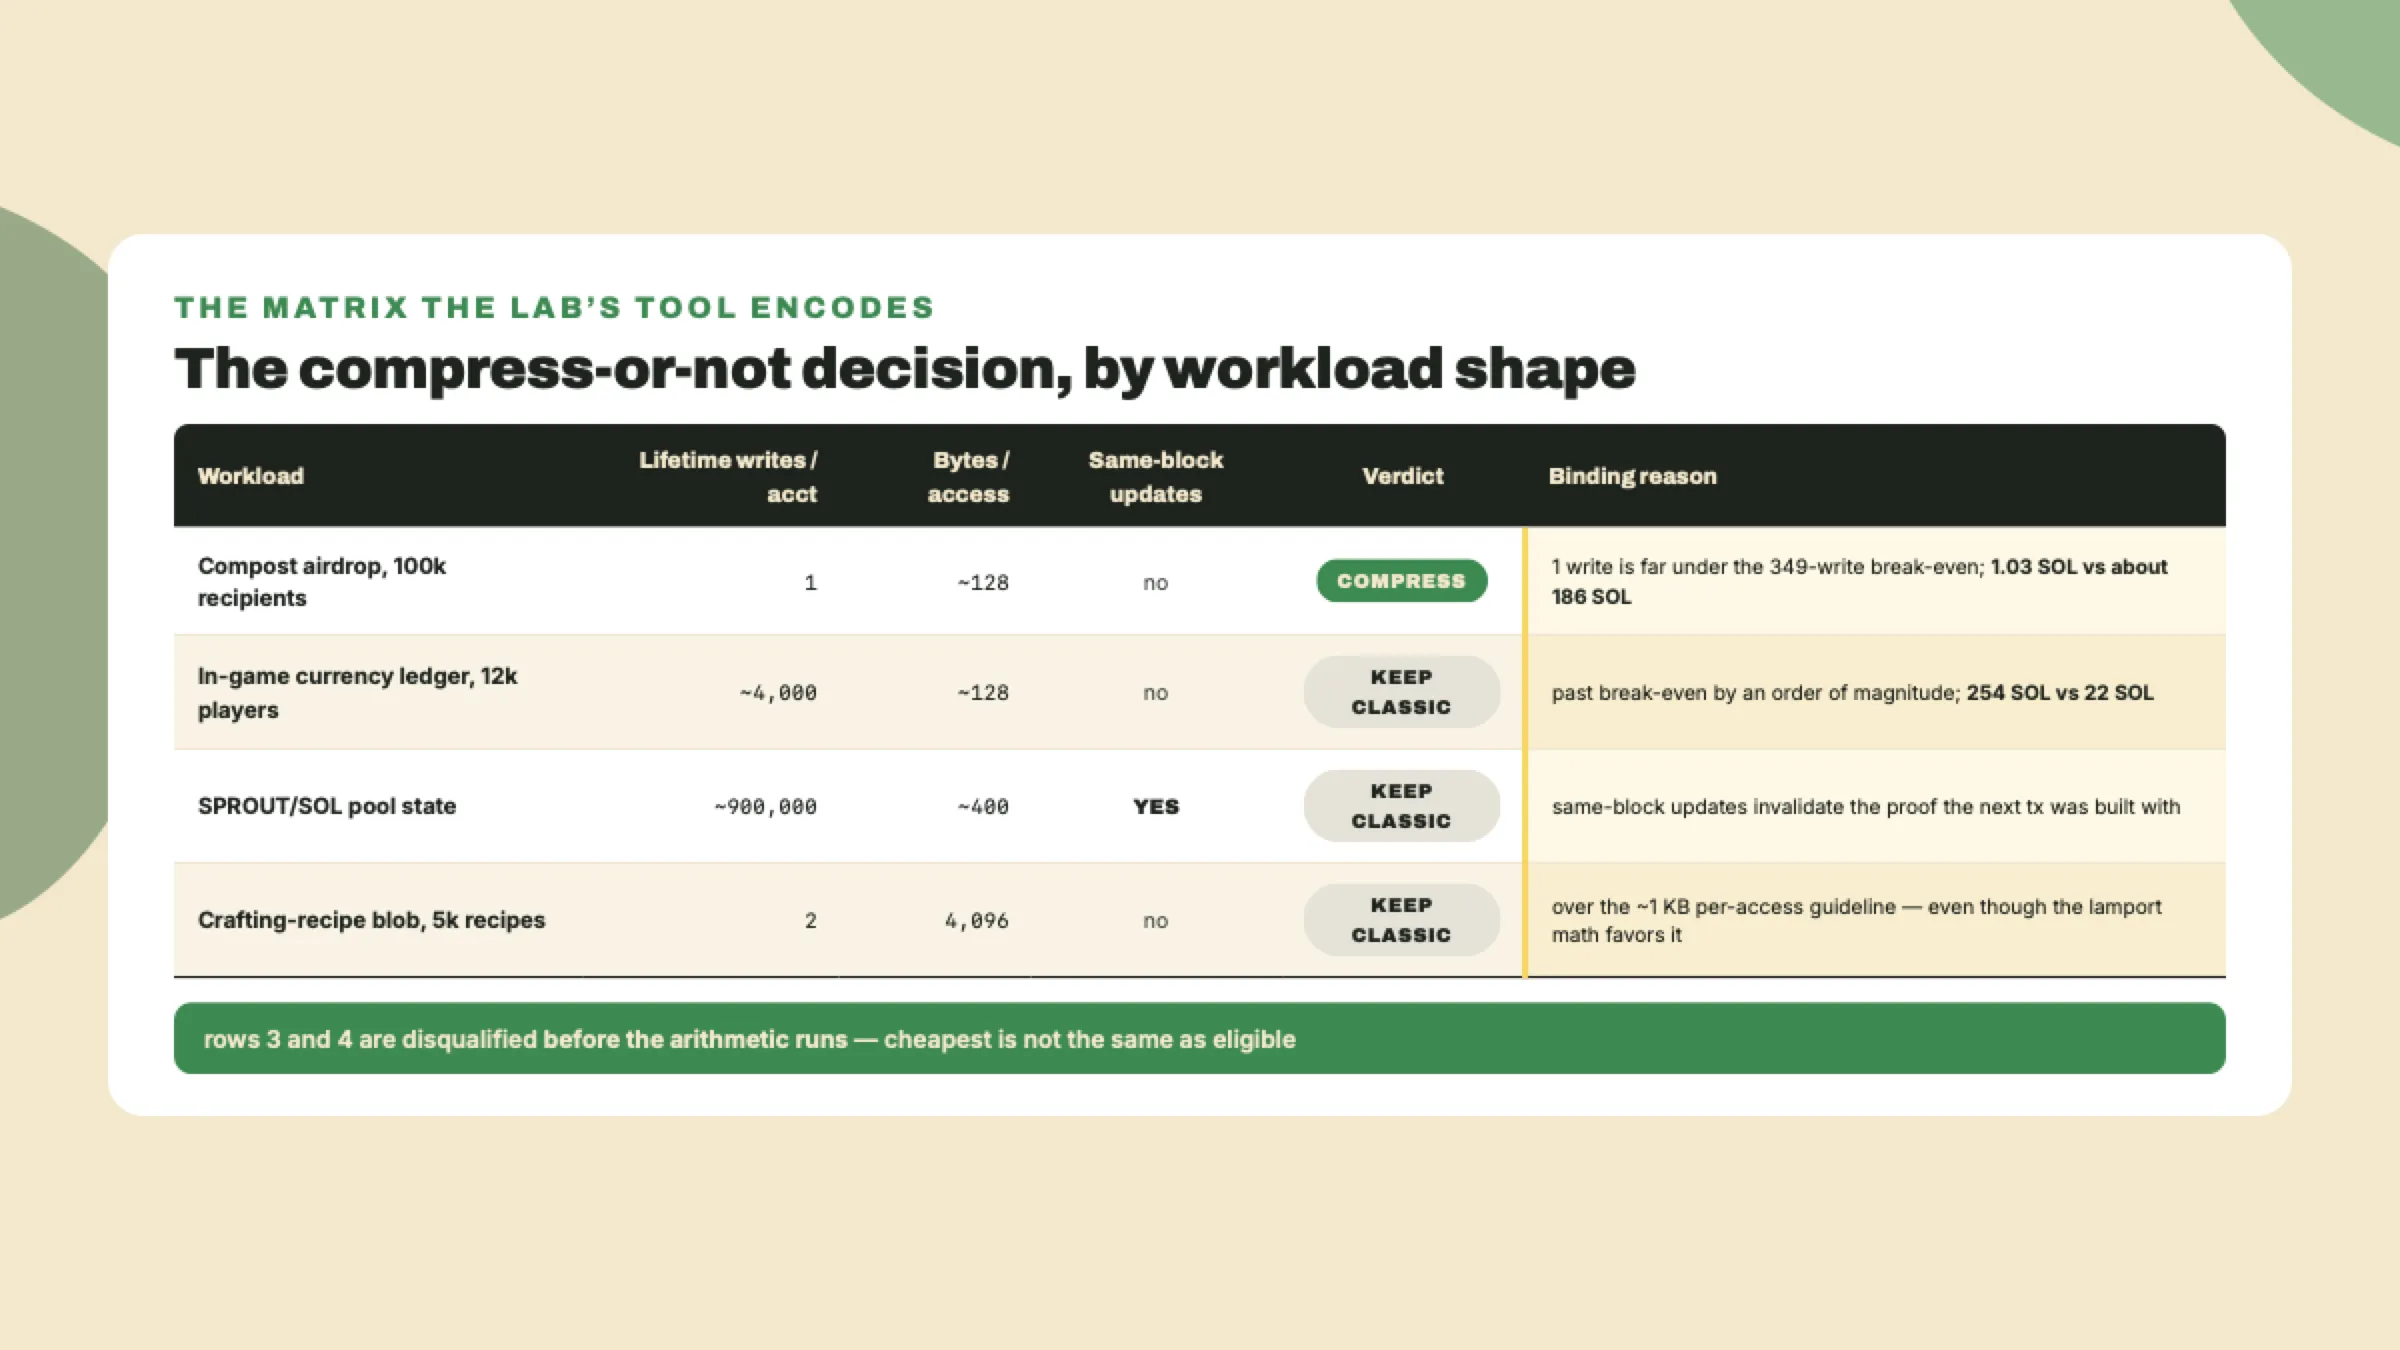
"Comprime todo." Falla solo con la columna de CU. Cualquier cuenta escrita más de unos cientos de veces paga más lamports y unas 3,800 veces el cómputo, para siempre. También falla por una restricción que la tabla no muestra: cada escritura necesita una prueba fresca de un indexador, así que convertiste una transacción autocontenida y capaz de funcionar offline en una con una dependencia viva de terceros en su camino de construcción.
"No comprimas nada, el rent es barato." Falla a escala. 1,855,569 lamports no son nada para una cuenta y son unos 186 SOL para cien mil de ellas. Un drop que cuesta 186 SOL en clásico cuesta unos 1.03 SOL comprimido, y esa es la diferencia entre entregar una distribución y cancelarla.
"Usa Bubblegum para los tokens también." Tentador después del módulo pasado, y no funciona, por una razón que vale la pena enunciar con precisión en vez de señalar de lejos. Los árboles de Bubblegum tienen forma de NFT: una hoja es un activo con dueño, y las instrucciones del programa son mint, transfer, burn, delegate. Un balance de token no es un activo, es un número al que se le suma y se le resta, y en ese programa no hay ningún esquema de hoja para "aumenta esto en 40". Estarías reconstruyendo el programa de tokens comprimidos adentro de un programa de NFTs comprimidos. Que es más o menos lo que es la compresión ZK, salvo hecho como se debe y generalizado a cualquier cuenta, no solo a balances de token.
"Comprime, después descomprime cuando se ponga caliente." Esta es la más cercana a lo correcto, que es lo que la hace la peligrosa. La descompresión es real y está soportada, y la vas a usar. Falla como política general porque no puedes predecir qué cuentas se ponen calientes, y las cuentas que se ponen calientes suelen estar calientes desde el arranque: el pool, la tesorería, el libro mayor compartido del juego. Una política que te exige adivinar correctamente la frecuencia de escritura futura por cuenta no es una política.
Lo cual acota la pregunta de forma útil. No "¿es buena la compresión?" sino: para esta cuenta específica, a lo largo de su vida esperada, ¿cuántas veces se va a escribir, y qué tan grande es cada acceso? Esas dos variables lo deciden, y ninguna de ellas es "cuántos tenedores tienes". El conteo de tenedores es a lo que la gente echa mano, y es el eje equivocado por completo. Un árbol escala a tenedores sin problema. Lo que te mata son las escrituras por tenedor.
De esas dos variables salen tres formas concretas de falla:
Cuentas con escritura pesada. Cualquier cosa mucho más allá de esa banda de unos cientos a mil escrituras de por vida. Un libro mayor de moneda del juego que debita en cada crafteo. Un balance de puntos que avanza en cada acción. Estas son las cuentas cuyo trabajo entero es ser escritas, y la compresión le pone precio a las escrituras.
Actualizaciones repetidas en el mismo bloque. Esto es peor que caro, es mecánicamente hostil. El estado del pool de un AMM se actualiza muchas veces dentro de un solo bloque, y cada actualización invalida la prueba con la que se construyó la transacción siguiente. No estás pagando más por el mismo comportamiento, estás peleando una carrera que no puedes ganar. El estado del pool se queda como cuenta normal. No "debería", no se puede con sensatez.
Accesos grandes. Pasando más o menos 1 KB por acceso, el costo de leer y hashear ese blob a través de la maquinaria de compresión deja de valer el rent que ahorraste. Los blobs grandes quieren una cuenta normal, o quieren no estar on-chain para nada.
Y la forma que gana, dicha con la misma claridad: estado creado una vez, escrito una o dos veces, en manos de una cantidad enorme de dueños distintos. Airdrops. Distribuciones. Derechos de reclamo. Artefactos de un solo uso. Que es exactamente la forma del compost drop que Overgrowth corre en el módulo 8 (una distribución masiva de puntos de compost a cada jugador, su primera aparición aquí como adelanto), y exactamente por qué ese módulo usa este riel en vez de pagar unos 186 SOL para crear cuentas de token para gente que quizá nunca las toque.
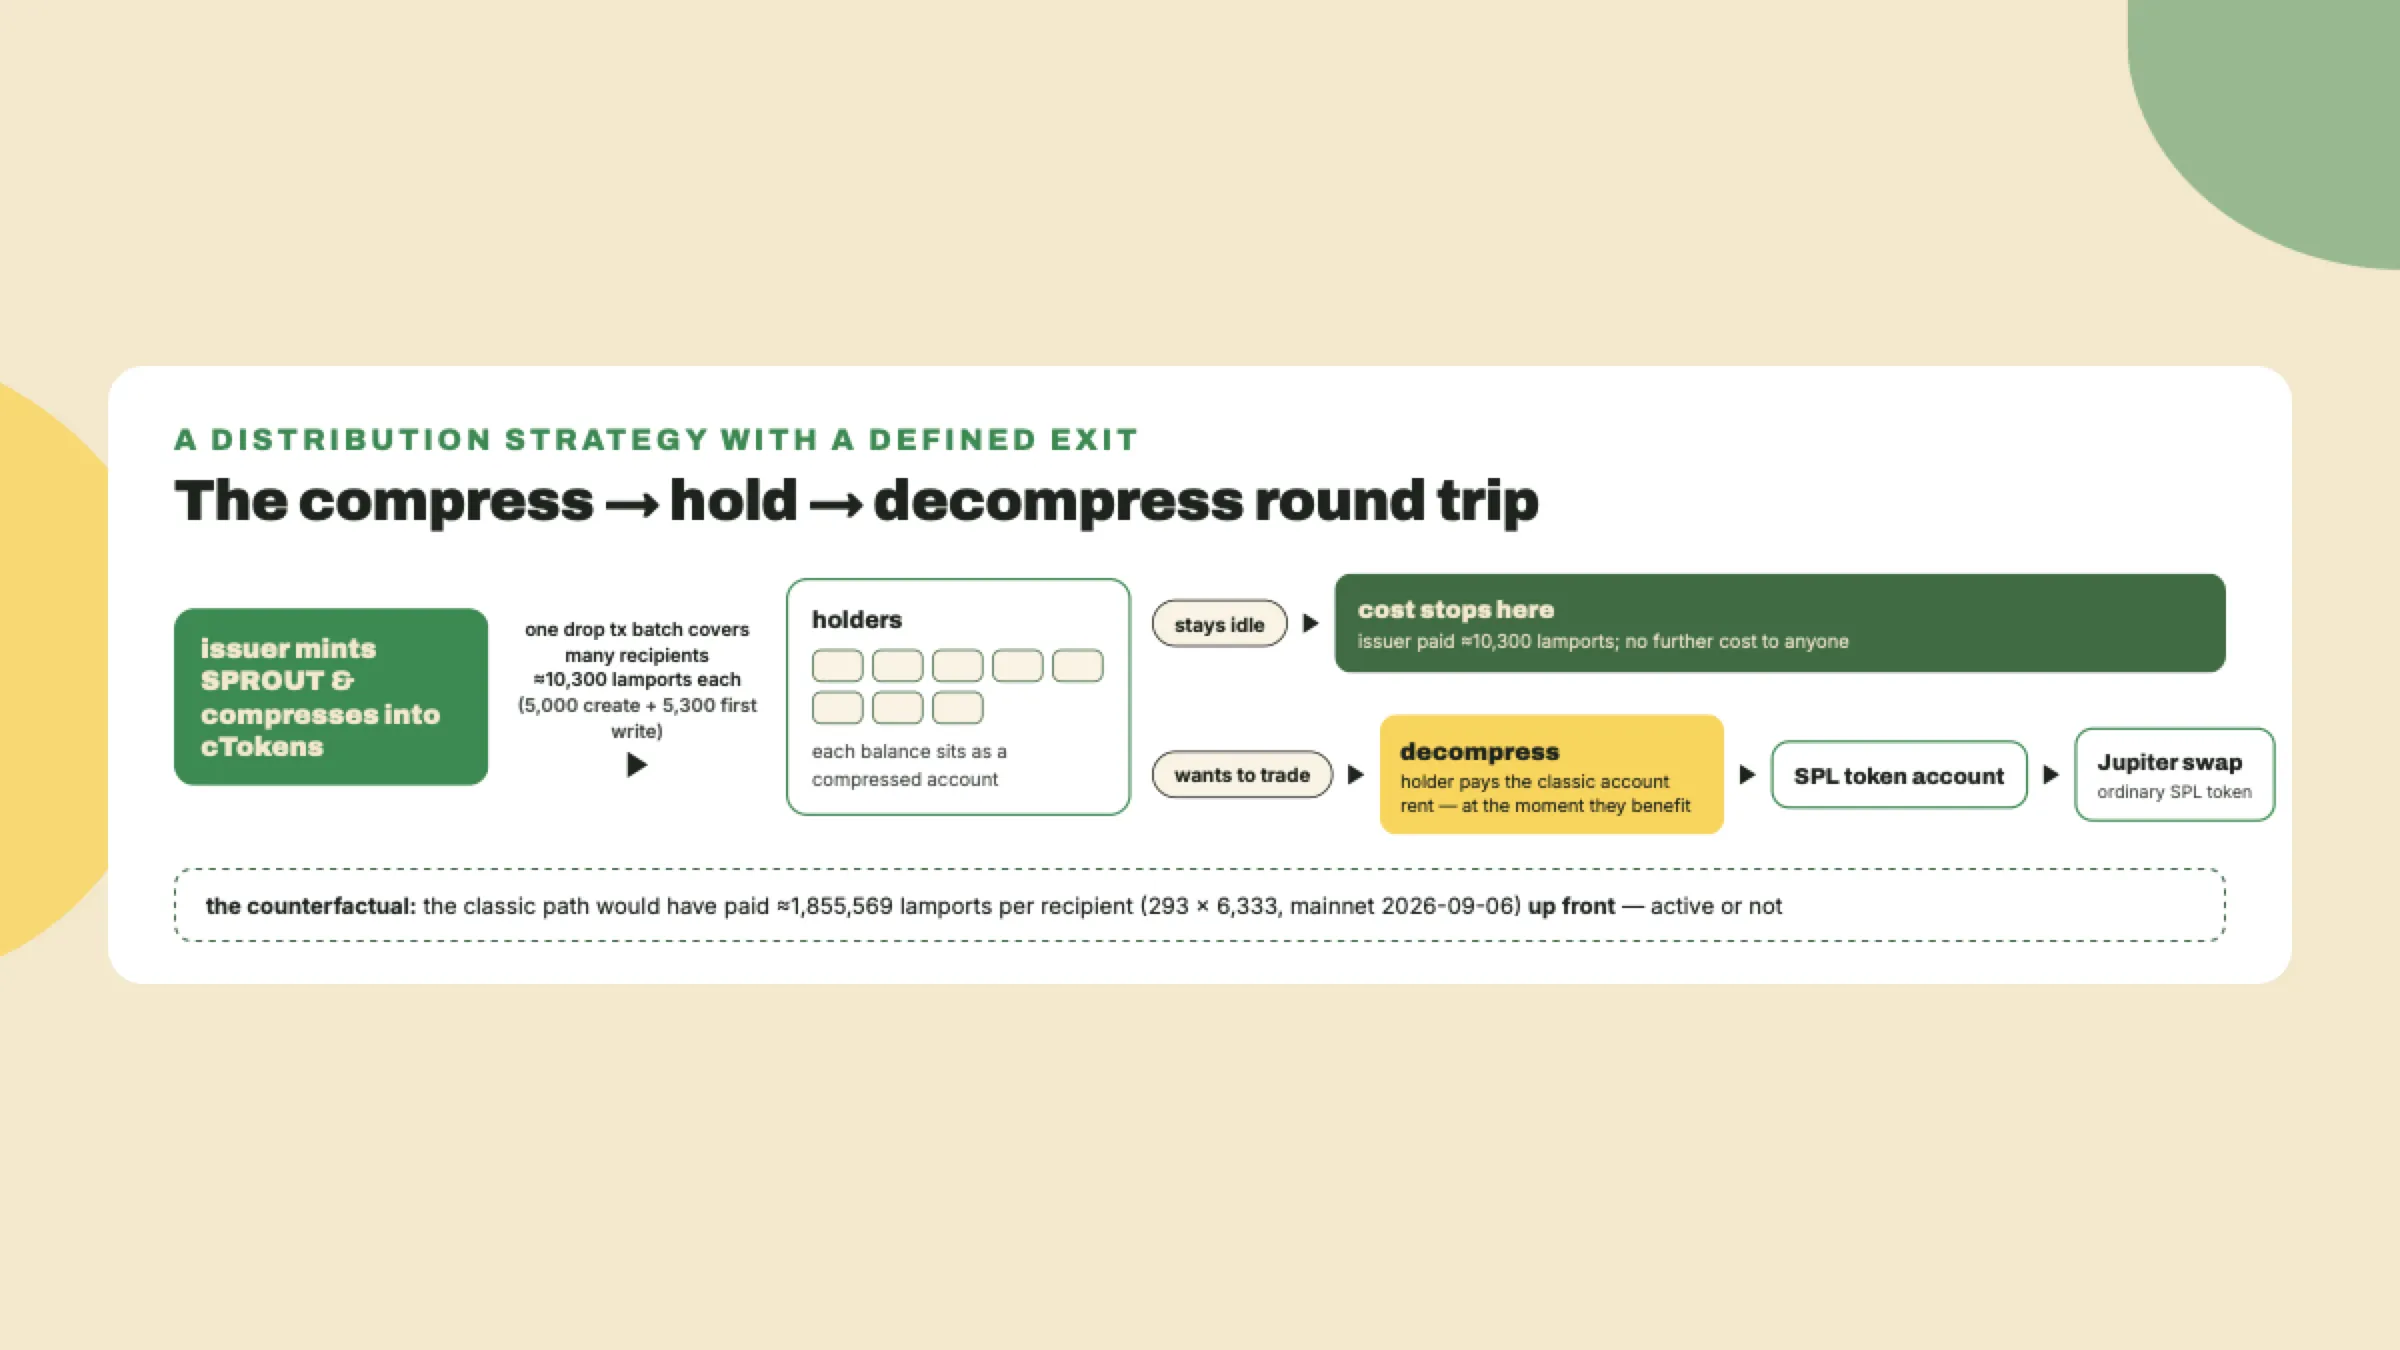
Nada de esto convierte a los tokens comprimidos en un callejón sin salida. La descompresión es de primera clase: un balance de token comprimido se puede volver a convertir en una cuenta de token SPL normal, y esa es la jugada estándar en cuanto un tenedor quiere hacer algo que el ecosistema más amplio entienda. Hacer swap en Jupiter es el ejemplo canónico. El router no sabe nada de tu cuenta comprimida, así que descomprimes, después enrutas.
Lee el viaje de ida y vuelta como un patrón de diseño y no como una escotilla de escape. Distribución barata a muchas billeteras, la mayoría de las cuales se queda inactiva, y la minoría que actúa paga una descompresión única para entrar a la vida normal de token. El costo cae sobre los usuarios que de verdad aparecieron en vez de sobre ti al momento del drop, por destinatario, por adelantado. Esa reasignación es el punto del riel entero.
La lección pasada nombró este impuesto para las lecturas, largo y tendido: DAS es un índice alquilado, con su propio límite de confianza. Aquí está la misma ley en su versión del camino de escritura, y generaliza a los dos rieles de compresión: si el estado no está en una cuenta, alguien tiene que reconstruirlo, y ese alguien es un indexador que tú no corres.
Para los cNFTs ese indexador habla DAS. Para la compresión ZK es Photon, construido por Helius y servido también por Alchemy. Photon es donde traes una cuenta comprimida, y Photon es donde traes la prueba de validez de 128 bytes que cada escritura necesita. La misma forma de dependencia, interfaz distinta, y no, tu elección de proveedor de DAS no se traslada automáticamente.
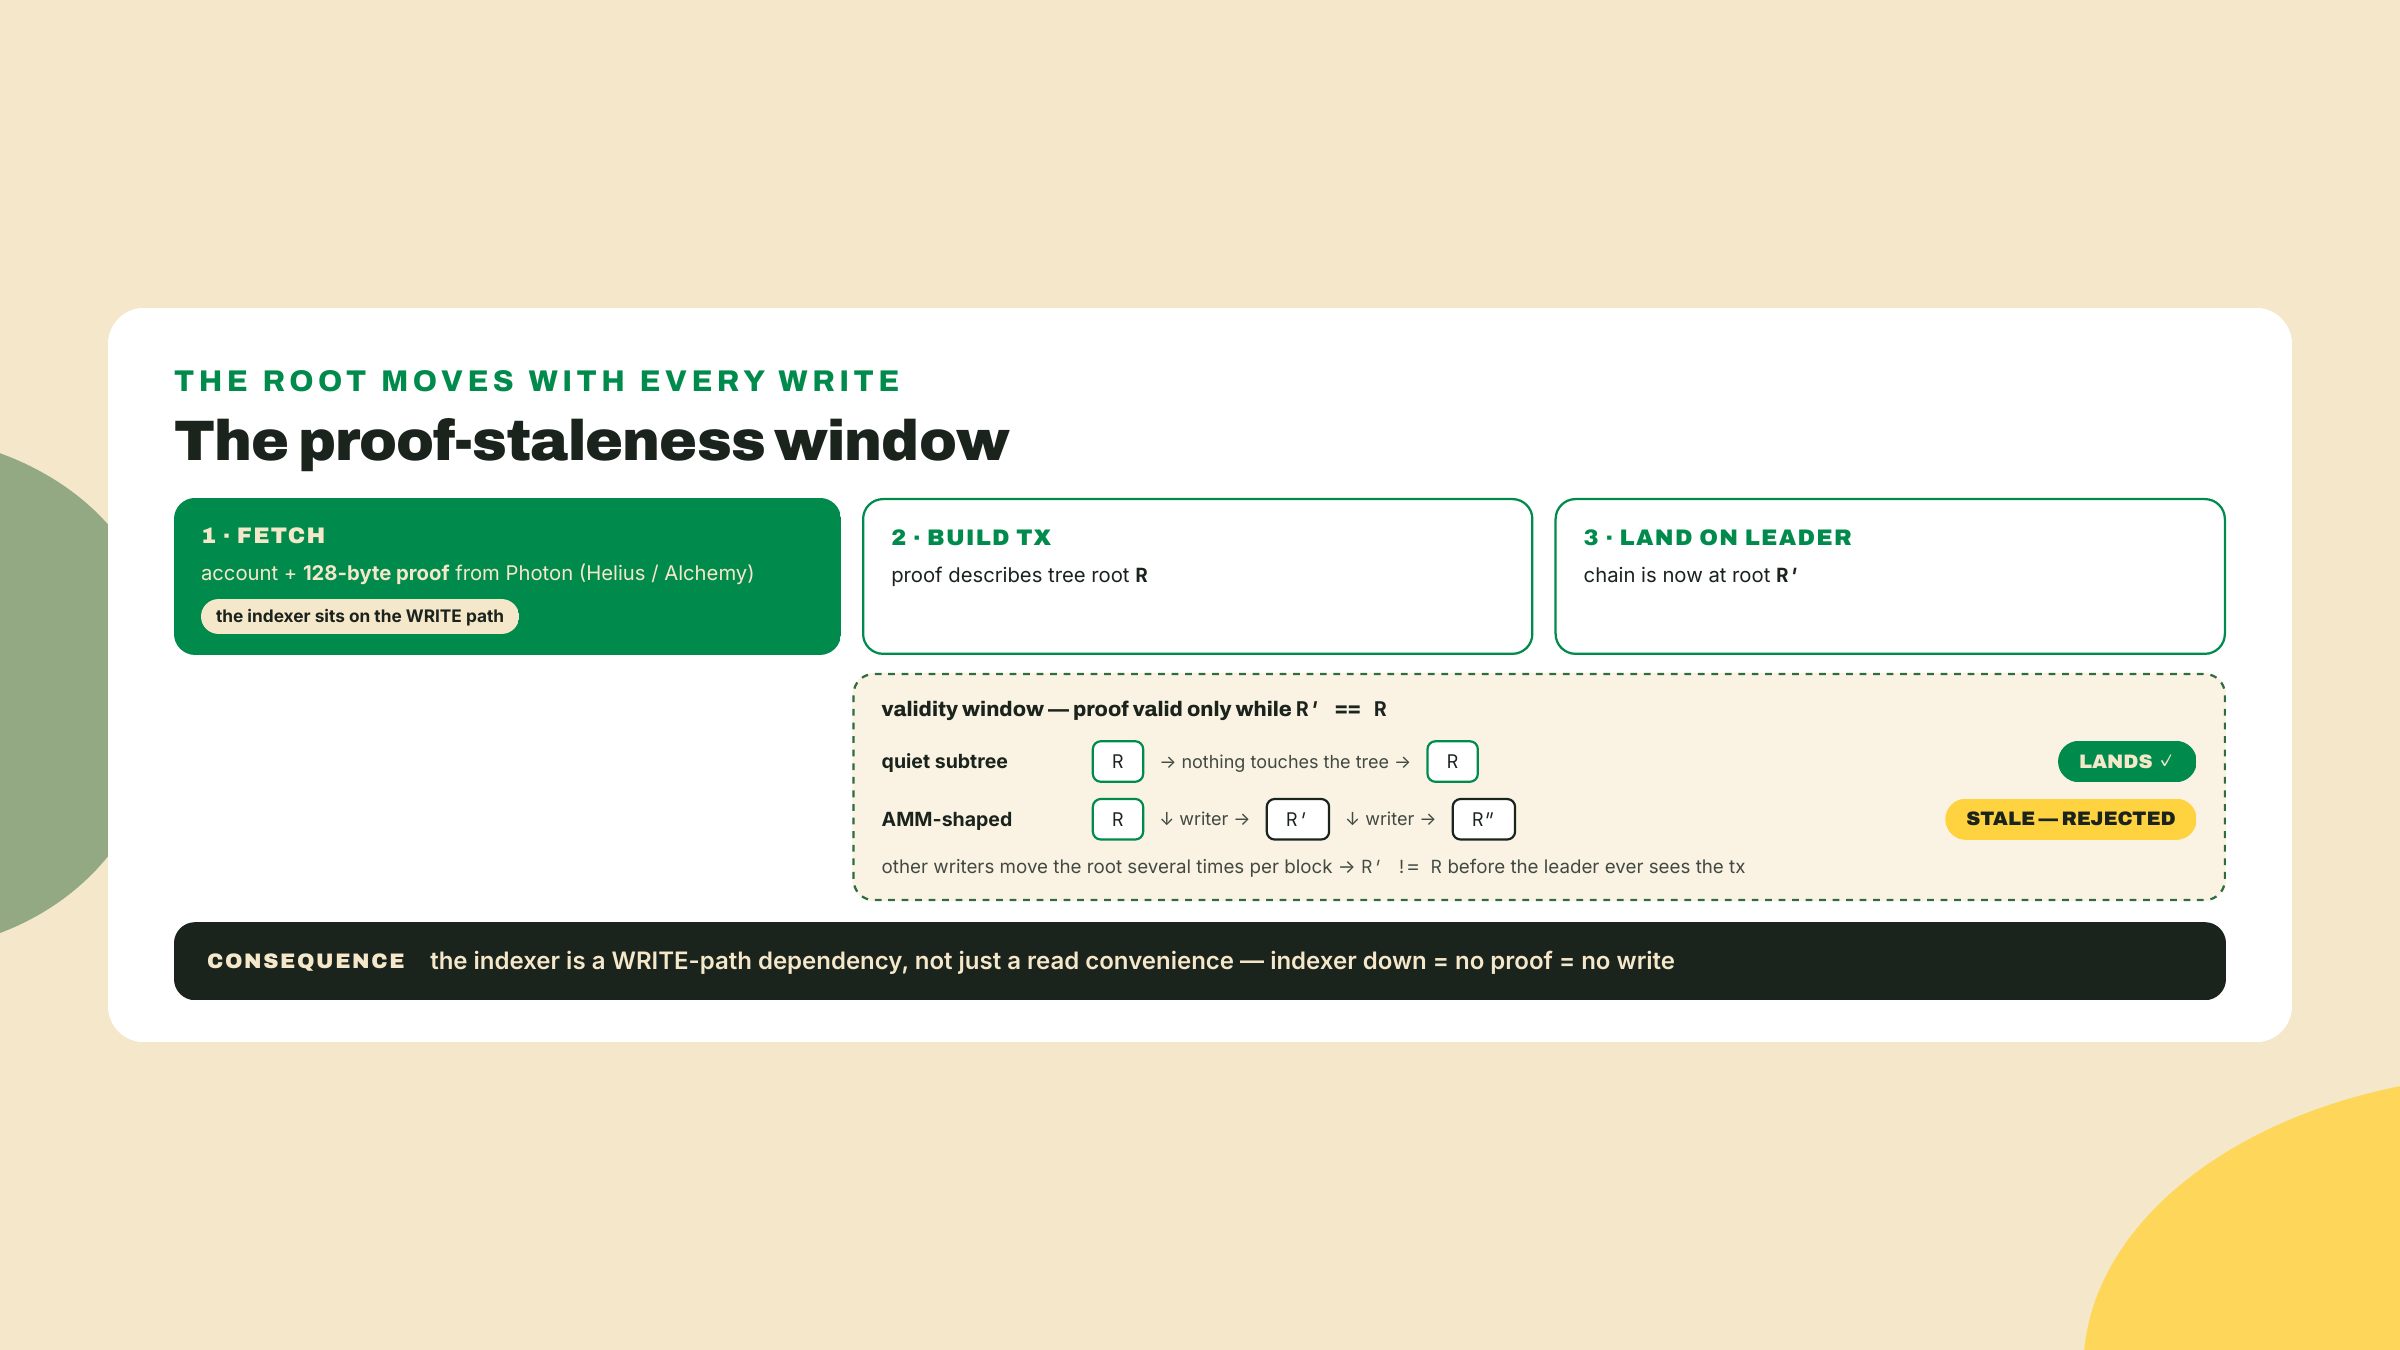
La plomería de proveedores a escala, los backfills, los firehoses de gRPC, correr tu propio índice, eso es territorio del curso planeado Client-Side Mastery y ahí se trata como se debe. Lo que corresponde aquí es la consecuencia de diseño: elegir compresión quiere decir elegir una dependencia de indexador en tu camino de escritura, no solo en el de lectura. Una transferencia de Bubblegum necesita una prueba. Una transferencia de cToken necesita una prueba. Si el indexador está caído, no estás escribiendo.
Y esa dependencia tiene un reloj encima, que es de donde sale el descalificador de mismo bloque mecánicamente y no como una regla que te pedí memorizar. Una prueba es una afirmación sobre una raíz de árbol en particular. Cualquier escritura que toca el árbol mueve la raíz, y toda prueba traída contra la raíz anterior está ahora describiendo un árbol que ya no existe. En el caso común esto no es problema, porque traes, construyes y aterrizas dentro de una ventana donde nada más tocó tu subárbol. En el caso del AMM es fatal, porque la cuenta la están escribiendo varias veces por bloque personas que no eres tú, y tu prueba ya estaba vieja antes de que tu transacción llegara al leader. La aritmética de lamports nunca tiene ocasión de importar ahí. Fíjate que esta es la misma falla que el changelog buffer de Bubblegum absorbe pero no elimina (el canopy solo acorta las pruebas en la red; el buffer es la perilla de concurrencia, según m07-l1), y por eso la presión de escrituras concurrentes es una propiedad de la familia de la compresión entera y no de una implementación.
Ahora la frontera, y la parte donde necesito que mantengas una línea.
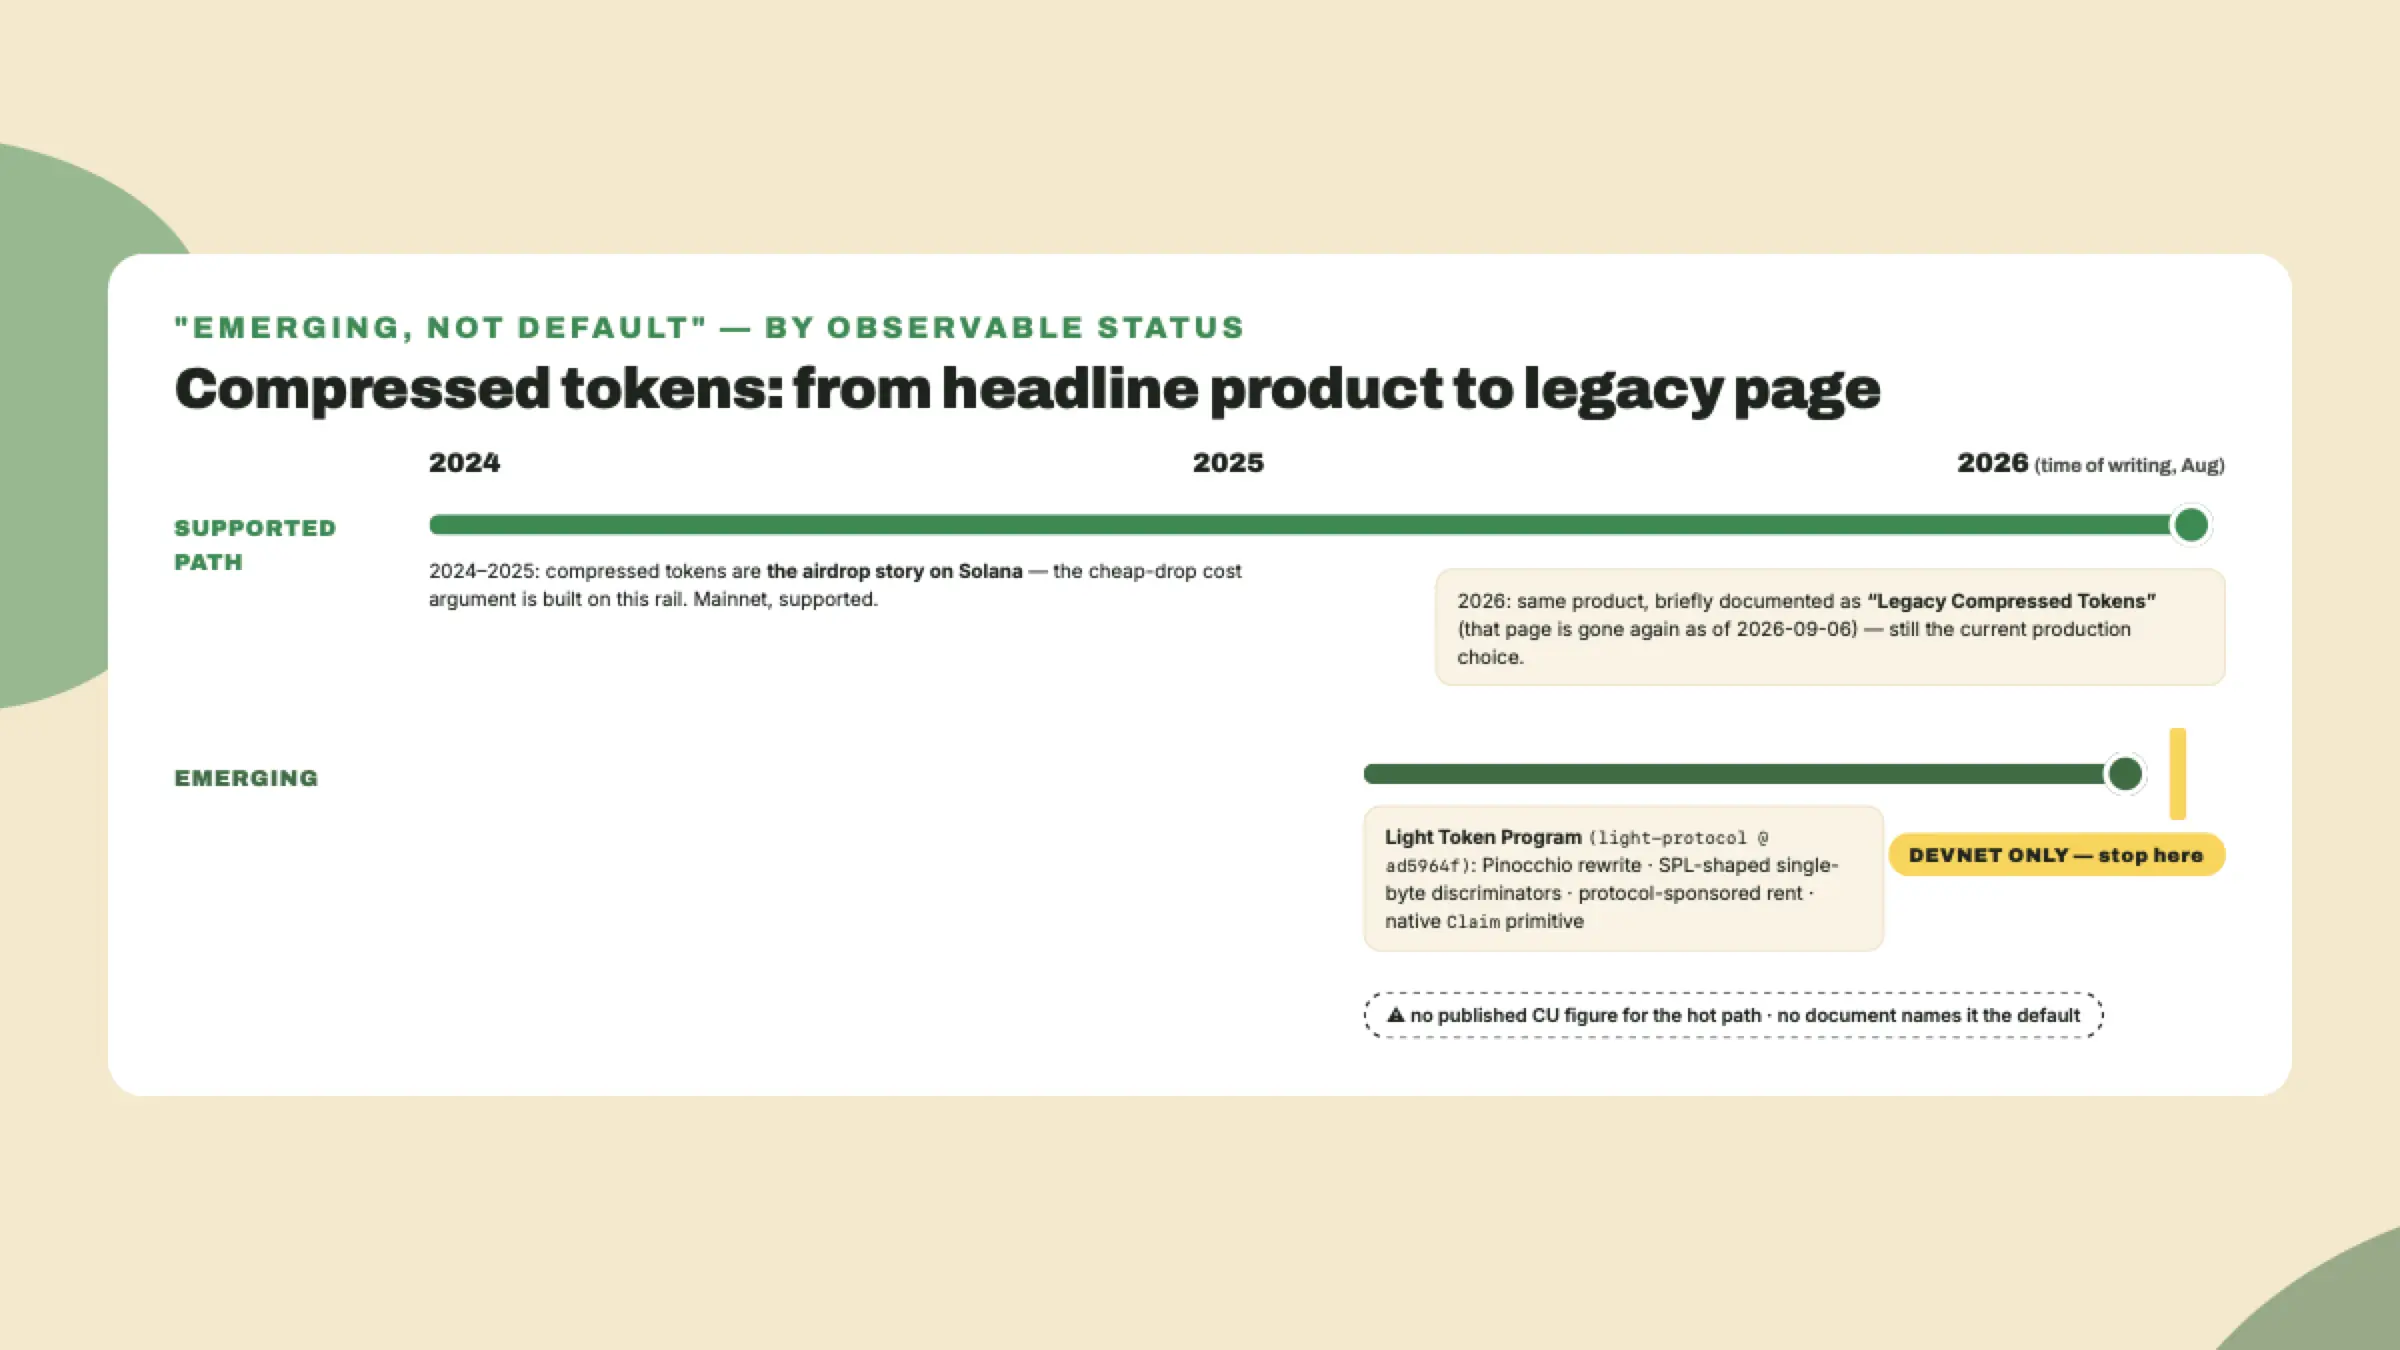
Light Protocol está reconstruyendo su propio producto estrella. Los tokens comprimidos fueron el consentido de los airdrops de 2024 y 2025, la cosa a la que todos apuntaban cuando argumentaban que la distribución en Solana podía ser barata. Un sucesor llamado Light Token Program está creciendo al lado.
Una nota de actualidad que deberías leer antes del resto de esta sección, porque es la sección con más probabilidad de estar vieja para cuando llegues aquí. Cuando se redactó esta lección, zkcompression.com archivaba el producto existente bajo una página titulada "Legacy Compressed Tokens", y de ese encuadre salió la forma de la sección. Al re-sondear los docs el 2026-09-06: esa página da 404, las 67 URLs del sitemap no contienen ninguna entrada "legacy" ni "light-token", y llms.txt no menciona ninguna de las dos. Los docs ahora presentan compressed-tokens a secas, sin etiqueta de legacy y sin página de sucesor al lado. No sé si eso quiere decir que el sucesor se plegó adentro, se renombró o se archivó, y no voy a adivinar. Lo que sigue es lo que decían esas páginas cuando las leí; trata toda afirmación de estado que haya ahí como fechada, y ve a leer el sitio tú mismo antes de repetir nada de eso.
El sucesor es genuinamente interesante. Es una reescritura en Pinocchio, así que hereda la misma postura de zero-copy y cero overhead de framework que llevó la transferencia del SPL Token clásico a 76 CU. Usa discriminadores de un solo byte con forma de SPL en vez de los de ocho bytes, que es una decisión pequeña con una consecuencia real: datos de instrucción que se parecen a los de SPL Token convierten la integración en cuestión de apuntar a otro programa en vez de aprender otro protocolo.
Las otras dos decisiones se leen como respuestas directas a quejas que esta lección viene haciendo. El rent patrocinado por el protocolo saca el costo de la cuenta de encima del usuario, lo que ataca el medio incómodo del viaje de ida y vuelta que acabas de mapear, donde un destinatario que quiere actuar tiene que financiar su propia salida. Y una primitiva Claim nativa importa porque "reclama tu drop" es lo más común que alguien hace con tokens comprimidos, y cada drop existente le atornilla encima un programa distributor aparte para hacerlo. Los dos son los instintos correctos. Ninguno es razón para mover dinero de producción hoy.
Aquí está la línea, tal como la dibujaban los docs al momento de esa lectura: el Light Token Program corría solo en la devnet de Solana, no en mainnet, y ningún documento lo posicionaba como el reemplazo del camino de tokens comprimidos soportado. Es un riel emergente, que vale la pena mirar, que vale la pena prototipar contra él, y no es donde lanzas la moneda de Overgrowth este trimestre.
Y aquí está la mitad duradera, la que sobrevive a que los docs se muevan debajo de los dos. La afirmación que decide tu arquitectura es "¿está soportado este riel en el cluster sobre el que lanzo?", y esa afirmación tiene un dueño: los docs del protocolo y sus propios deployments de programa, no un compañero, no un post de blog, y no esta página. Ve y compruébalo, anota la fecha al lado de lo que encuentres, y si un compañero te dice que el default cambió, pídele las mismas dos cosas. Una afirmación de estado sin fuente y sin fecha es un rumor, por más confianza con la que se entregue.
Una cosa más, y esto es una confesión más que un hecho. Un borrador temprano de esta lección llevaba una cifra de unidades de cómputo para el hot path de Light Token. Salió de mi memoria, se leía hermoso, y no sobrevivió a la revisión, porque no aparece en ninguna fuente publicada. No hay ningún número de CU publicado para ese camino. No cites uno, ni de mí, ni de un post de blog, ni de un asistente que suena seguro. En un programa así de joven, un número sin fuente es un número que alguien se inventó.
La compresión invierte el modelo de costos. No deroga la física.
Cambias una creación de cuenta unas 370x más barata por un cómputo por escritura mucho más alto, más una prueba que el cliente tiene que traer y mantener fresca, más una dependencia viva de indexador en el camino de escritura. Para distribución de un solo tiro a muchos dueños, ese canje es abrumadoramente bueno. Para estado con escritura pesada, estado grande, o estado tocado repetidamente dentro de un solo bloque, el mismo canje se invierte y se lleva tu economía con él.
El riel más nuevo compra elegancia al costo de ser hoy solo de devnet. Eso también es un canje, y hoy no es uno que hagas con dinero de producción.
Vas a codificar el razonamiento de arriba como un programa pequeño, porque un veredicto que puedes volver a correr sobre una carga de trabajo nueva vale más que un veredicto que recuerdas. Sin red, sin SDK, sin billetera. Solo el modelo de costos, cuatro cargas de trabajo y una salida honesta.
Prepara todo. Un directorio, dos dependencias de dev, ningún paquete de Solana.
mkdir -p labs/m07-l3 && cd labs/m07-l3
npm init -y
npm install -D tsx@4.23.12 typescript@5.9.3
Pins exactos, los mismos del versionStamp de esta lección (re-verificados el 2026-09-05); vuelve a revisar antes de fijar cualquier cosa de larga vida. tsx corre un archivo TypeScript directamente, que es todo lo que necesitamos aquí.
El modelo de costos (trabajado de punta a punta). Cada constante de este archivo es o una cifra congelada del curso o un valor leído de una fuente pública en una fecha declarada, y cada comentario dice cuál es el caso. Los valores derivados salen directo de ellas. Nada aquí es una adivinanza.
// labs/m07-l3/model.ts

/** Lamports to create one compressed token account. */
export const COMPRESSED_CREATE_LAMPORTS = 5_000;
/** Lamports of state cost per compressed transfer (Light's V2 program line). */
export const COMPRESSED_WRITE_LAMPORTS = 5_300;
/** A classic SPL token account: 165 bytes of data plus the 128-byte account header. */
export const CLASSIC_ACCOUNT_BYTES = 293;
/**
 * Rent-exemption price of one byte. THE ONLY NUMBER IN THIS FILE THAT
 * BELONGS TO THE NETWORK RATHER THAN TO A LAYOUT OR A PROGRAM: mainnet-beta,
 * read 2026-09-06; devnet was a step further down at 5,080 the same day.
 * SIMD-0437 is stepping the rate down over several releases, so re-read it
 * before you budget: solana rent 0 --url <cluster>, then divide by 128.
 */
export const LAMPORTS_PER_BYTE = 6_333;
/**
 * Rent locked by one classic SPL token account. DERIVED, not pasted: at
 * 6,333 this is 1,855,569, which is what `solana rent 165 --url
 * mainnet-beta` printed on 2026-09-06. Refundable on close.
 */
export const CLASSIC_RENT_LAMPORTS = CLASSIC_ACCOUNT_BYTES * LAMPORTS_PER_BYTE;
/** Compute units for one compressed token transfer: proof verification + hashing. */
export const COMPRESSED_TRANSFER_CU = 292_000;
/** Compute units for a classic Transfer on the p-token engine (see m01-l3). */
export const CLASSIC_TRANSFER_CU = 76;
/** Guideline ceiling on bytes touched per compressed-account access. */
export const MAX_ACCESS_BYTES = 1_024;

/**
 * Highest lifetime write count at which the compressed path is still cheaper
 * in lamports than one classic account's rent. An output of the model, not a
 * constant of it: 349 at mainnet's 6,333, 279 at devnet's 5,080, and it moves
 * again at the next rate step.
 */
export const BREAK_EVEN_WRITES = Math.floor(
  (CLASSIC_RENT_LAMPORTS - COMPRESSED_CREATE_LAMPORTS) / COMPRESSED_WRITE_LAMPORTS,
);

export function compressedLamports(writes: number): number {
  return COMPRESSED_CREATE_LAMPORTS + COMPRESSED_WRITE_LAMPORTS * writes;
}

export function classicLamports(): number {
  return CLASSIC_RENT_LAMPORTS;
}

export function sol(lamports: number): string {
  return `${(lamports / 1e9).toFixed(4)} SOL`;
}
La función de veredicto (tú llenas dos huecos). La forma está dada; las dos reglas descalificadoras son tuyas. Escríbelas antes de mirar el paso 4.
// labs/m07-l3/verdict.ts
import {
  BREAK_EVEN_WRITES,
  MAX_ACCESS_BYTES,
  classicLamports,
  compressedLamports,
} from "./model";

export interface Workload {
  name: string;
  accounts: number;
  lifetimeWritesPerAccount: number;
  bytesPerAccess: number;
  sameBlockUpdates: boolean;
}

export interface Verdict {
  workload: string;
  compress: boolean;
  reason: string;
  compressedTotalLamports: number;
  classicTotalLamports: number;
}

export function decide(w: Workload): Verdict {
  const compressedTotalLamports = w.accounts * compressedLamports(w.lifetimeWritesPerAccount);
  const classicTotalLamports = w.accounts * classicLamports();
  const base = { workload: w.name, compressedTotalLamports, classicTotalLamports };

  // TODO(you): disqualifier 1. Same-block repeated updates lose regardless of
  // lamports, because each update invalidates the proof the next transaction was
  // built with. Return { ...base, compress: false, reason: ... }.

  // TODO(you): disqualifier 2. Accesses above MAX_ACCESS_BYTES lose even when the
  // lamport math favours compression. Mention the actual byte count in the reason.

  const plural = w.lifetimeWritesPerAccount === 1 ? "" : "s";
  if (w.lifetimeWritesPerAccount > BREAK_EVEN_WRITES) {
    return {
      ...base,
      compress: false,
      reason: `${w.lifetimeWritesPerAccount} lifetime write${plural} per account is past the ${BREAK_EVEN_WRITES}-write break-even`,
    };
  }
  return {
    ...base,
    compress: true,
    reason: `${w.lifetimeWritesPerAccount} lifetime write${plural} per account is under the ${BREAK_EVEN_WRITES}-write break-even`,
  };
}
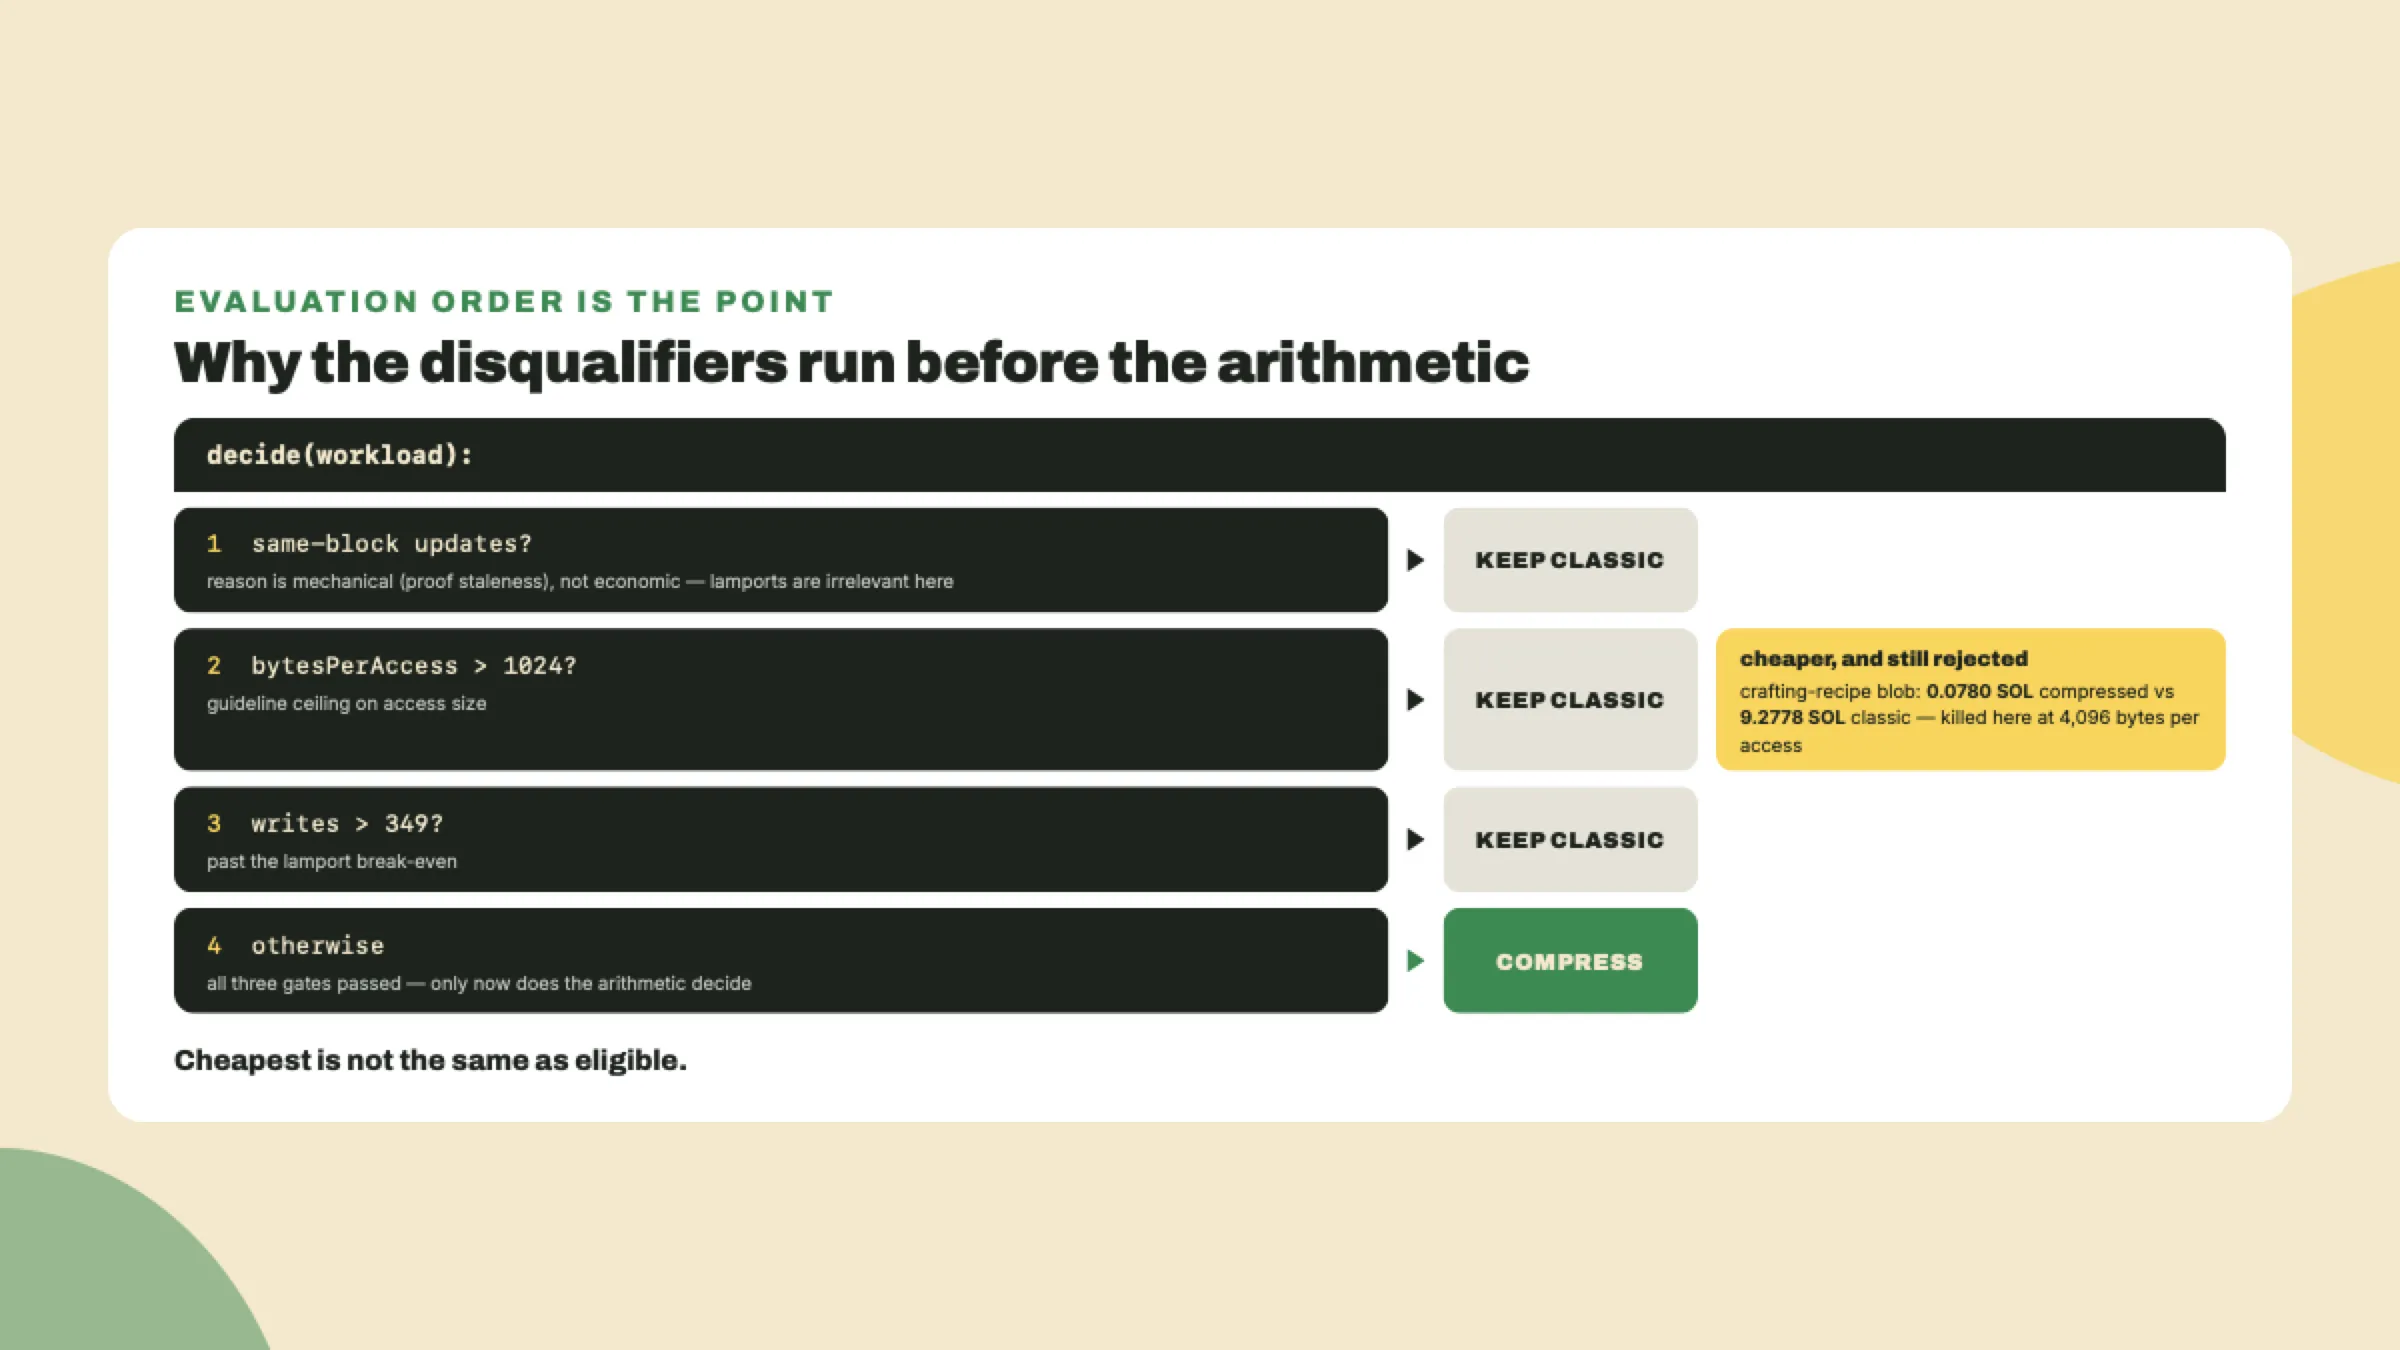
El orden importa aquí, y es la única decisión de diseño del archivo. Los dos descalificadores corren antes de la aritmética, porque una carga de trabajo puede ser más barata en lamports y aun así tener la forma equivocada. La fila 4 de la tabla de decisión es exactamente ese caso.
Los rellenos. Esta es la clave de respuestas para los dos TODOs del paso 3, y en una página renderizada nada se interpone físicamente entre la consigna y este bloque, así que la barrera es conductual y es tuya: si te desplazaste hasta aquí sin escribir tus dos reglas primero, vuelve atrás, escríbelas, después haz el diff. La lección solo sabe lo que hicieron tus manos. Descalificador 1:
if (w.sameBlockUpdates) {
  return {
    ...base,
    compress: false,
    reason: "same-block repeated updates: each update invalidates the next transaction's proof",
  };
}
Descalificador 2:
if (w.bytesPerAccess > MAX_ACCESS_BYTES) {
  return {
    ...base,
    compress: false,
    reason: `${w.bytesPerAccess} bytes per access is over the ${MAX_ACCESS_BYTES}-byte guideline`,
  };
}
Si escribiste la barrera de tamaño como una penalización suave en vez de un rechazo duro, no te equivocaste sobre la realidad, solo sobre esta herramienta. La línea de 1 KB es un gradiente empinado y no un acantilado, y yo la codifiqué como barrera para que la herramienta dé una respuesta en vez de un encogimiento de hombros. Dilo en tu informe si no estás de acuerdo, esa es una posición legítima para sostener y defender.
Las cargas de trabajo (córrelo). Tres de las cuatro de Overgrowth están trabajadas; la cuarta la agregas en el challenge.
// labs/m07-l3/run.ts
import { COMPRESSED_TRANSFER_CU, CLASSIC_TRANSFER_CU, sol } from "./model";
import { decide, type Workload } from "./verdict";

const workloads: Workload[] = [
  {
    name: "compost-drop (100k recipients)",
    accounts: 100_000,
    lifetimeWritesPerAccount: 1,
    bytesPerAccess: 128,
    sameBlockUpdates: false,
  },
  {
    name: "currency-ledger (12k players)",
    accounts: 12_000,
    lifetimeWritesPerAccount: 4_000,
    bytesPerAccess: 128,
    sameBlockUpdates: false,
  },
  {
    name: "sprout-sol-pool-state",
    accounts: 1,
    lifetimeWritesPerAccount: 900_000,
    bytesPerAccess: 400,
    sameBlockUpdates: true,
  },
];

for (const w of workloads) {
  const v = decide(w);
  console.log(v.workload);
  console.log(`  verdict: ${v.compress ? "COMPRESS" : "KEEP CLASSIC"}`);
  console.log(`  reason: ${v.reason}`);
  console.log(`  compressed: ${sol(v.compressedTotalLamports)}   classic: ${sol(v.classicTotalLamports)}`);
}

console.log(`\ncompute ratio per transfer: ${Math.round(COMPRESSED_TRANSFER_CU / CLASSIC_TRANSFER_CU)}x`);
npx tsx run.ts imprime:
compost-drop (100k recipients)
  verdict: COMPRESS
  reason: 1 lifetime write per account is under the 349-write break-even
  compressed: 1.0300 SOL   classic: 185.5569 SOL
currency-ledger (12k players)
  verdict: KEEP CLASSIC
  reason: 4000 lifetime writes per account is past the 349-write break-even
  compressed: 254.4600 SOL   classic: 22.2668 SOL
sprout-sol-pool-state
  verdict: KEEP CLASSIC
  reason: same-block repeated updates: each update invalidates the next transaction's proof
  compressed: 4.7700 SOL   classic: 0.0019 SOL

compute ratio per transfer: 3842x
Mira fijo la fila del medio. Doce mil jugadores, y la versión comprimida de su libro mayor de moneda cuesta más de once veces la versión clásica. Es el mismo mecanismo que hace de la fila uno un ahorro de 180x, corrido en la otra dirección. Un número, dos signos, y la frecuencia de escritura es lo único que cambió.
Verifica la fila del drop contra el módulo siguiente. Tu fila de compost-drop dice unos 10,300 lamports por destinatario. La lección de airdrop del módulo 8 presupuesta unos 10,300 comprimidos contra una cifra clásica derivada exactamente como la deriva este modelo: (128 + 165) bytes a la tasa de rent por byte de tu cluster, 6,333 en mainnet el 2026-09-06, dando 1,855,569 — la misma tasa y la misma fecha que fija este archivo. Tus números deberían coincidir exactamente de los dos lados. Si el lado comprimido no coincide, cambiaste una constante. Si el lado clásico no coincide, los dos archivos están fijando tasas de rent o fechas de lectura distintas, y gana la lectura más reciente — recomputa, no promedies.
Solo. Agrega la cuarta carga de trabajo y escribe el memo.
Agrega crafting-recipe-blob a run.ts: 5,000 cuentas, 2 escrituras de por vida cada una, 4,096 bytes por acceso, sin actualizaciones en el mismo bloque. Antes de correrlo, anota qué veredicto esperas y por qué. Después córrelo y revisa si tu razón coincide con la razón de la herramienta, no solo el veredicto. Sacar la respuesta correcta por la razón equivocada es el modo de falla que esta lección existe para prevenir.
Después el memo, y esta es la parte evaluada. Alguien de tu equipo propone mover la moneda del juego de Overgrowth a cuentas de token comprimidas para ahorrar rent, y agrega que deberías lanzarla sobre el Light Token Program porque ese es el nuevo default. Escríbele seis oraciones: el veredicto de comprimir-o-no con la razón de frecuencia de escritura y un número de tu propia corrida de la herramienta, la única carga de trabajo de Overgrowth que genuinamente debería comprimirse, y el estado exacto del Light Token Program.
Aceptado cuando el memo nombra la frecuencia de escritura (no el conteo de tenedores) como la restricción vinculante, cita una cifra que tu herramienta de verdad imprimió, y enuncia el estado del Light Token Program con la fuente y la fecha en que lo leíste en vez de repetir el de esta lección. Mi lectura decía emergente y solo devnet; la página de la que salió ya no está, que es exactamente por qué el entregable es una oración con fuente y no una memorizada. Un memo que dice "solo devnet, según esta URL, leído en esta fecha" está bien sea cual sea la respuesta. Si tu memo contiene una cifra de unidades de cómputo para el hot path de Light Token, bórrala, diga lo que diga tu fuente.
El criterio es que npx tsx run.ts imprima cuatro cargas de trabajo con un COMPRESS y tres KEEP CLASSIC, más un memo que de verdad enviarías.
La respuesta de una oración que deberías poder dar con la terminal cerrada: la compresión cambia una creación de cuenta unas 370x más barata por un costo por escritura en lamports y en cómputo, así que gana para estado creado una vez y en manos de muchos, y pierde para estado que se escribe, lo que quiere decir que la frecuencia de escritura y el tamaño de acceso lo deciden, nunca el conteo de tenedores.
Los errores que espero. Primero, la trampa del conteo de tenedores: si tu memo argumenta desde el número de jugadores, vuelve a leer la tabla de decisión, porque a un árbol no le importa qué tan ancho es. Segundo, la sorpresa de la fila cuatro: el blob de receta de crafteo es más barato comprimido y aun así queda rechazado, y si eso se sintió como un bug en la herramienta en vez de una lección sobre barreras, siéntate con eso otra vez. Tercero, el número de CU soltado con confianza, que es el que de verdad me preocupa, porque es el error que yo casi cometí escribiendo esto y el que un asistente va a cometer con gusto en tu nombre.
Suficiente razonamiento sobre tokens comprimidos. El módulo que viene sí usas uno: la lección de airdrop abre con un calentamiento de diez minutos que comprime un solo token y lo vuelve a leer a través de Photon, tu primer contacto práctico con un cToken, antes de construir el compost drop de Overgrowth sobre la aritmética exacta por destinatario que acabas de codificar. La herramienta que escribiste hoy es la que te dice que el drop es el lugar correcto para gastarlo.
Pregunta 1 de 3