Cargando...

 BetaBeta
Esta es la lección uno, así que todavía no hay nada construido. Llegas con el modelo mental de Solana ya en la cabeza: cuentas, PDAs, transacciones, comisiones. Quizá también algo de memoria muscular de Anchor 0.x o 1.0. Bien. Vamos a hurgar exactamente en la pieza de esa memoria muscular que Anchor V2 arranca y reconstruye.
Antes de que defina una sola cosa, haz esto. Abre una terminal con el CLI solana que ya tienes y confirma una transacción que ya aterricé en devnet para ti:
# Landed and verified on devnet 2026-09-02; the Lab pins all four values below.
export V1_TWIN_SIG="2BYB5oU12EfJjPTuQjaZCcxwMjWxSBUQ7WjeucW6V35Ge1PRFUda39nV4dU8NnDvt8ZfbN8H4fpAEoYpsEYysR43"

solana confirm -v "$V1_TWIN_SIG" --url devnet | grep -i "compute units"
Una línea de grep, un número, sacado de un log real en vez de que te lo pasen en una tabla. El gemelo de ese programa te da un segundo número, y la brecha entre los dos es toda la razón por la que este curso existe.
Dos programas. Misma llamada, mismas cuentas, mismas verificaciones de signer y de dueño. Uno construido sobre el Anchor que conoces, uno construido sobre Anchor V2. Vas a medir el costo en unidades de cómputo de cada uno, directo de los logs de la transacción, predecir qué gemelo gana antes de mirar, y después nombrar la única decisión de diseño que produjo la brecha. Esa decisión es la tesis de todo el curso: Account<T>, el tipo al que recurres en cada programa de Anchor, es el camino lento, y V2 lo hace rápido por defecto.
Unas cuantas reglas de la casa, porque valen para las treinta lecciones:
solana que ya tienes. La lección dos instala el toolchain de V2, y te va a dar pelea.Una cosa más, dicha en voz alta porque importa: esta lección te lleva de la mano en cada tecla. Eso es deliberado, y la ayuda se repliega. Para la lección dos instalas el toolchain tú mismo y entregas tu propio primer deploy. Más adentro, te paso una prueba que falla y un puntero de una línea y me quito del camino. Las rueditas se quitan según un cronograma. Ahora mismo están bien puestas.
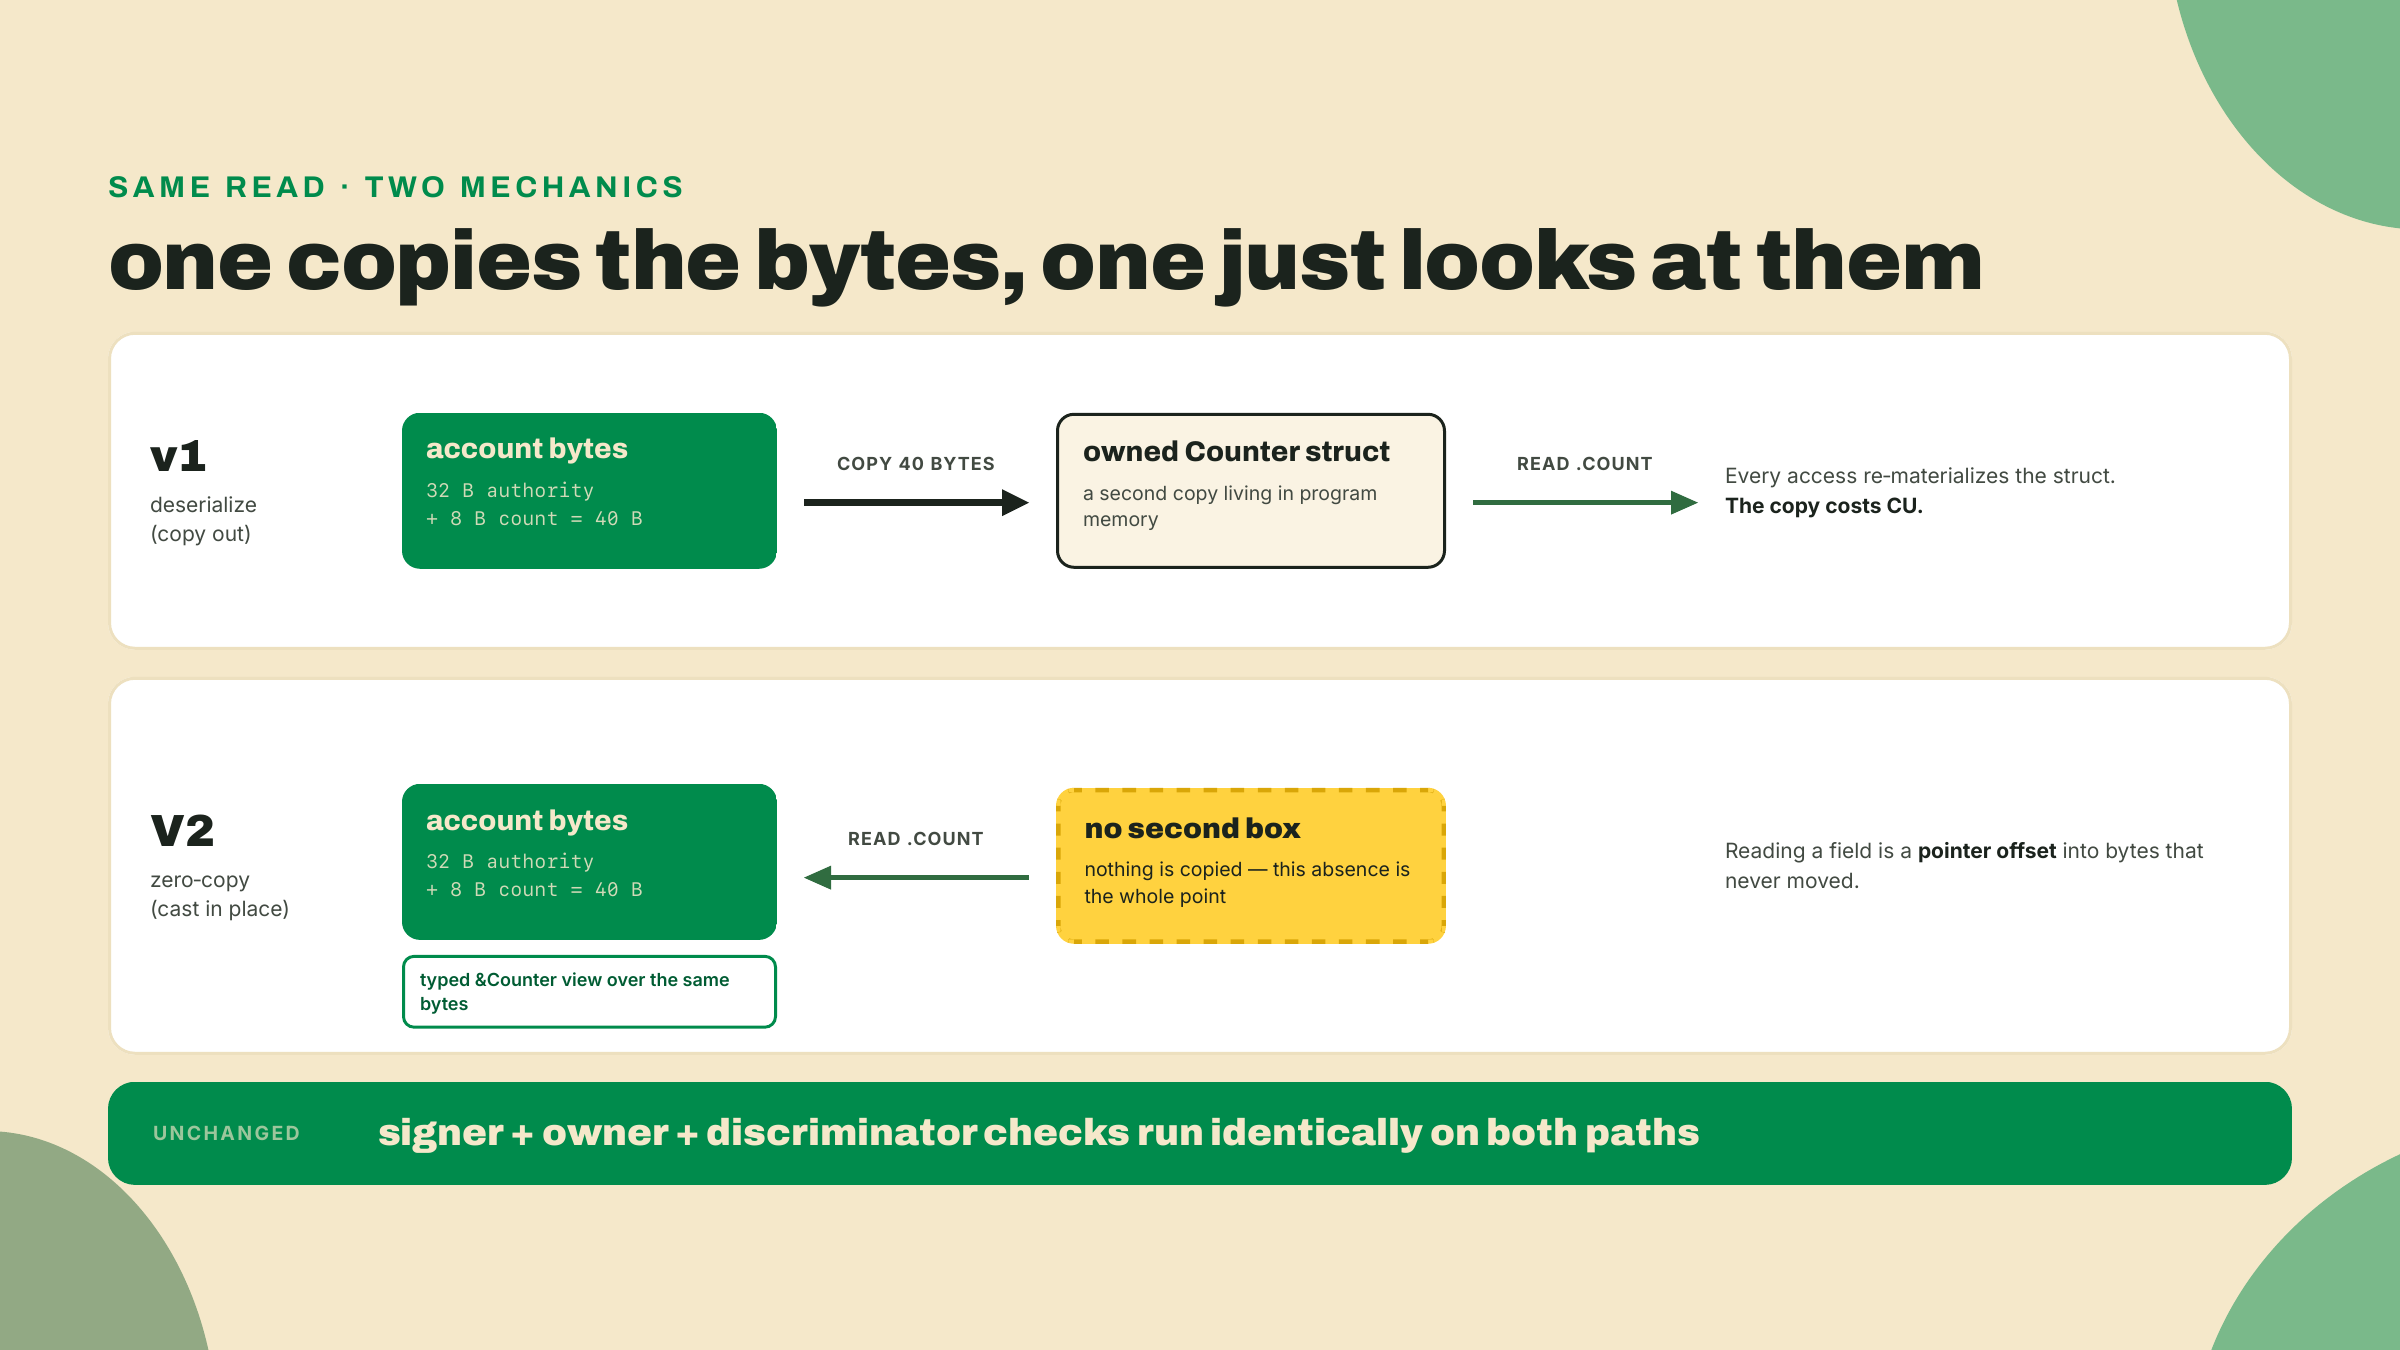
Esto es lo que pasa con Account<T> en el Anchor que conoces. Cada vez que tocas ctx.accounts.counter.count, el framework ya hizo algo por ti que probablemente nunca te imaginaste: leyó los bytes crudos de la cuenta, y los deserializó en una struct de Rust nueva que vive en la memoria de tu programa. Deserializar es una palabra cortés para copiar. Recorrió el buffer de la cuenta campo por campo y te construyó un Counter completamente nuevo, de tu propiedad.
Esa copia es invisible y no es gratis. Cuesta unidades de cómputo, el medidor de Solana para el trabajo on-chain. Cada instrucción corre bajo un presupuesto de CU, y cuando te lo pasas de largo el runtime mata tu transacción. La CU es la moneda de toda esta lección, así que mantén la imagen mental simple: más copia, más CU, menos margen para la lógica que de verdad querías correr.
¿Cuánto margen? A una sola instrucción le dan 200,000 CU por defecto, que es exactamente el of 200000 que vas a ver a la derecha de esa línea de log en un minuto. Puedes subir el techo con una instrucción de compute-budget, hasta un tope duro por transacción, pero nunca te sale gratis y siempre estás gastando contra una pared. Así que la copia es un impuesto sobre cada acceso a cuenta, descontado del mismo presupuesto que necesita tu lógica de negocio, no un error de redondeo que puedas ignorar hasta que duela. En un contador chico es una molestia. En un programa que lee una docena de cuentas gordas por llamada, es la diferencia entre caber bajo el presupuesto y terminar revertido.
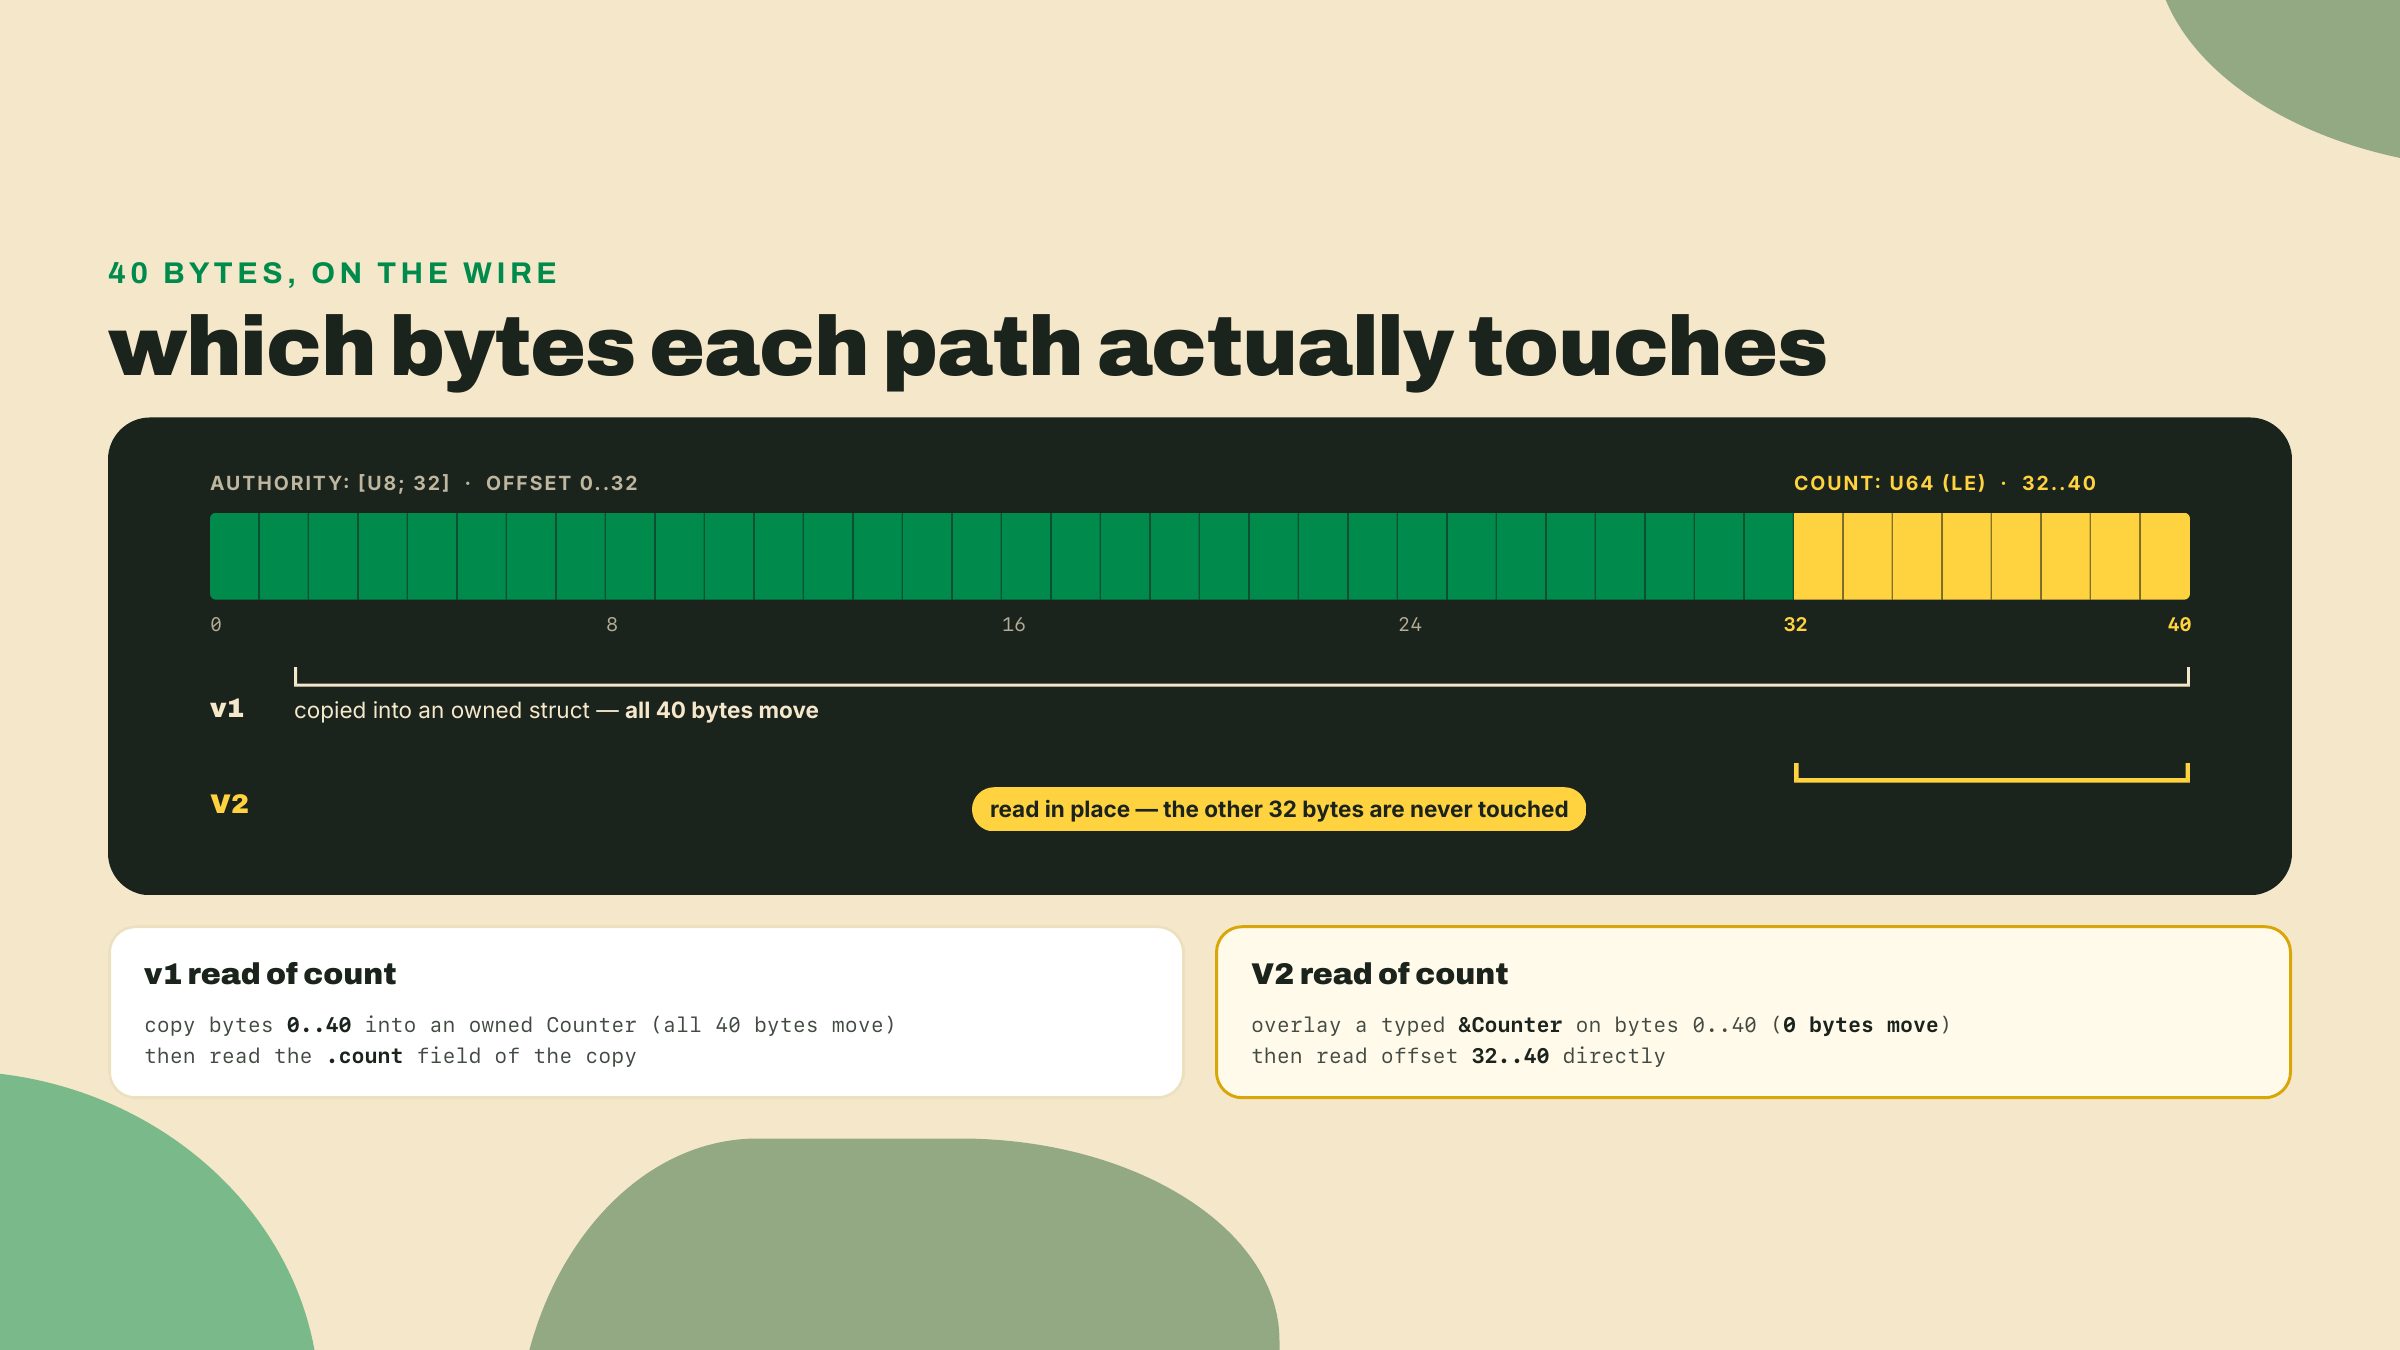
Déjame hacer concreta la copia. Digamos que tu cuenta es una autoridad de 32 bytes y un contador de 8 bytes, 40 bytes en total. Así se ve de verdad "deserializar" contra "leer en el lugar", en Rust simple que puedes correr con nada más que rustc:
use std::mem::size_of;

#[repr(C)]
#[derive(Clone, Copy)]
struct Counter {
    authority: [u8; 32],
    count: u64,
}

fn main() {
    // A real account buffer: 32-byte authority, then a u64 counter = 40 bytes.
    let mut account = [0u8; 40];
    account[32..40].copy_from_slice(&7u64.to_le_bytes());

    // v1 shape: to read `count`, deserialize the WHOLE account into an owned
    // struct first. You copy all 40 bytes even though you wanted 8 of them.
    let owned = Counter {
        authority: {
            let mut a = [0u8; 32];
            a.copy_from_slice(&account[0..32]);
            a
        },
        count: u64::from_le_bytes([
            account[32], account[33], account[34], account[35],
            account[36], account[37], account[38], account[39],
        ]),
    };
    println!("v1 copied {} bytes to read count = {}", size_of::<Counter>(), owned.count);

    // v2 shape: read `count` straight out of the buffer, in place, no owned
    // struct, no 40-byte copy. This is the idea zero-copy generalizes.
    let count_in_place = u64::from_le_bytes([
        account[32], account[33], account[34], account[35],
        account[36], account[37], account[38], account[39],
    ]);
    println!("v2 read {} bytes in place: count = {}", size_of::<u64>(), count_in_place);
}
Córrelo y ves el encuadre en una línea cada uno: 40 bytes copiados para llegar al contador, contra leer el campo donde ya está. Ese fragmento vuelve a decodificar por claridad; el truco real de V2 es más filoso. Te da una vista tipada &Counter puesta directamente sobre los bytes de la cuenta, así que leer cualquier campo es un offset de puntero, no una decodificación. Zero-copy (sin copia) quiere decir exactamente eso: cero copias del buffer de la cuenta. Los bytes en la cuenta y la struct en tu código son los mismos bytes.
Ahora, la pregunta justa que hace un lector cuidadoso: ¿no podías hacer esto ya en el Anchor que conoces? Sí, más o menos. El Anchor viejo entregaba un opt-in zero_copy para exactamente los casos de cuentas grandes donde la copia dolía más. Y esa es precisamente la lección que los autores de V2 sacaron de años de programas reales: un opt-in que resuelve el costo común solo cuando alguien se acuerda de recurrir a él no resuelve el costo común. Casi nadie echó mano de él. Voy a confesar mi propia parte en eso. He entregado programas 0.x y nunca recurrí a zero_copy, porque el Account<T> simple estaba justo ahí y funcionaba. Ese es todo el punto. El valor por defecto es lo que se entrega en diez mil programas.
Recorre los arreglos ingenuos y míralos fallar, porque el razonamiento es la parte interesante. Arreglo uno: documentar zero_copy mejor, escribir una guía linda. No cambia nada, porque un valor por defecto que nadie tiene razón para sobrescribir sigue siendo el valor por defecto. Arreglo dos: agregar un lint que te insista con zero_copy en cuentas grandes. Más cerca, pero todavía deja el camino rápido como el camino menos transitado, y no hace nada por las mil cuentas chicas que copian sin necesidad todo el día. El único arreglo que de verdad mueve la mediana de los programas es voltear cuál camino viene por defecto. Así que V2 lo invierte. El zero-copy dejó de ser un modo especial que pides; es lo que Account<T> es, y el opt-in al que ahora recurres, rara vez, es la copia.
Esa inversión tiene un nombre y un rastro de papel. El issue de diseño #4390 de Anchor se titula, sin adornos, "Zero-copy account deserialization by default", y adentro el Account<T> de hoy se llama el camino lento y la queja de rendimiento número uno entre los desarrolladores de Anchor. Toda la tesis de V2 cabe en el título de un issue. Alguien miró el tipo más usado del framework y dijo: lo que todos tocan es lo más lento, así que haz que lo rápido sea lo que todos tocan.
Esa frase, el camino lento, es el hilo conductor de todo este curso, así que voy a seguir usándola. Cada peldaño que construyas desde aquí es un pequeño argumento sobre si estás en el camino lento o en el rápido, y la respuesta de V2 viene cocinada en los valores por defecto que heredas gratis. Aquí está por qué debería importarte más allá del derecho a presumir un benchmark. Tus programas se hacen más grandes. El contador se vuelve un vault, el vault se compone con un escrow, el escrow llama a un swap, y cada una de esas llamadas lee cuentas. En el camino lento cada una de esas lecturas paga el impuesto de la copia, y los impuestos se acumulan hasta que una llamada que antes cabía bajo el presupuesto de golpe ya no cabe y empieza a revertir en producción. En el camino rápido toda esa clase de problema de "¿por qué me fue subiendo la CU cuando agregué features?" es más silenciosa por defecto. Lo que ganas con eso es margen para gastar en lo que de verdad querías construir.
Hay una segunda idea de diseño debajo de todo esto, y vale la pena nombrarla aunque no la vayas a tocar hasta módulos más adelante. V2 es una reescritura no_std desde cero construida sobre pinocchio. no_std quiere decir que deja fuera la biblioteca estándar de Rust, la gran capa de runtime que la mayoría de los programas asume, y trabaja contra el metal desnudo del runtime de Solana en cambio. Menos maquinaria entre tu struct y los bytes de la cuenta es un pedazo de dónde vienen los ahorros. No necesitas internalizar pinocchio hoy. Necesitas saber que los ahorros son estructurales, no un truco.
Vas a querer un multiplicador de portada. "V2 es N veces más barato." Voy a negarme a darte uno congelado, y aquí está la historia que explica por qué.
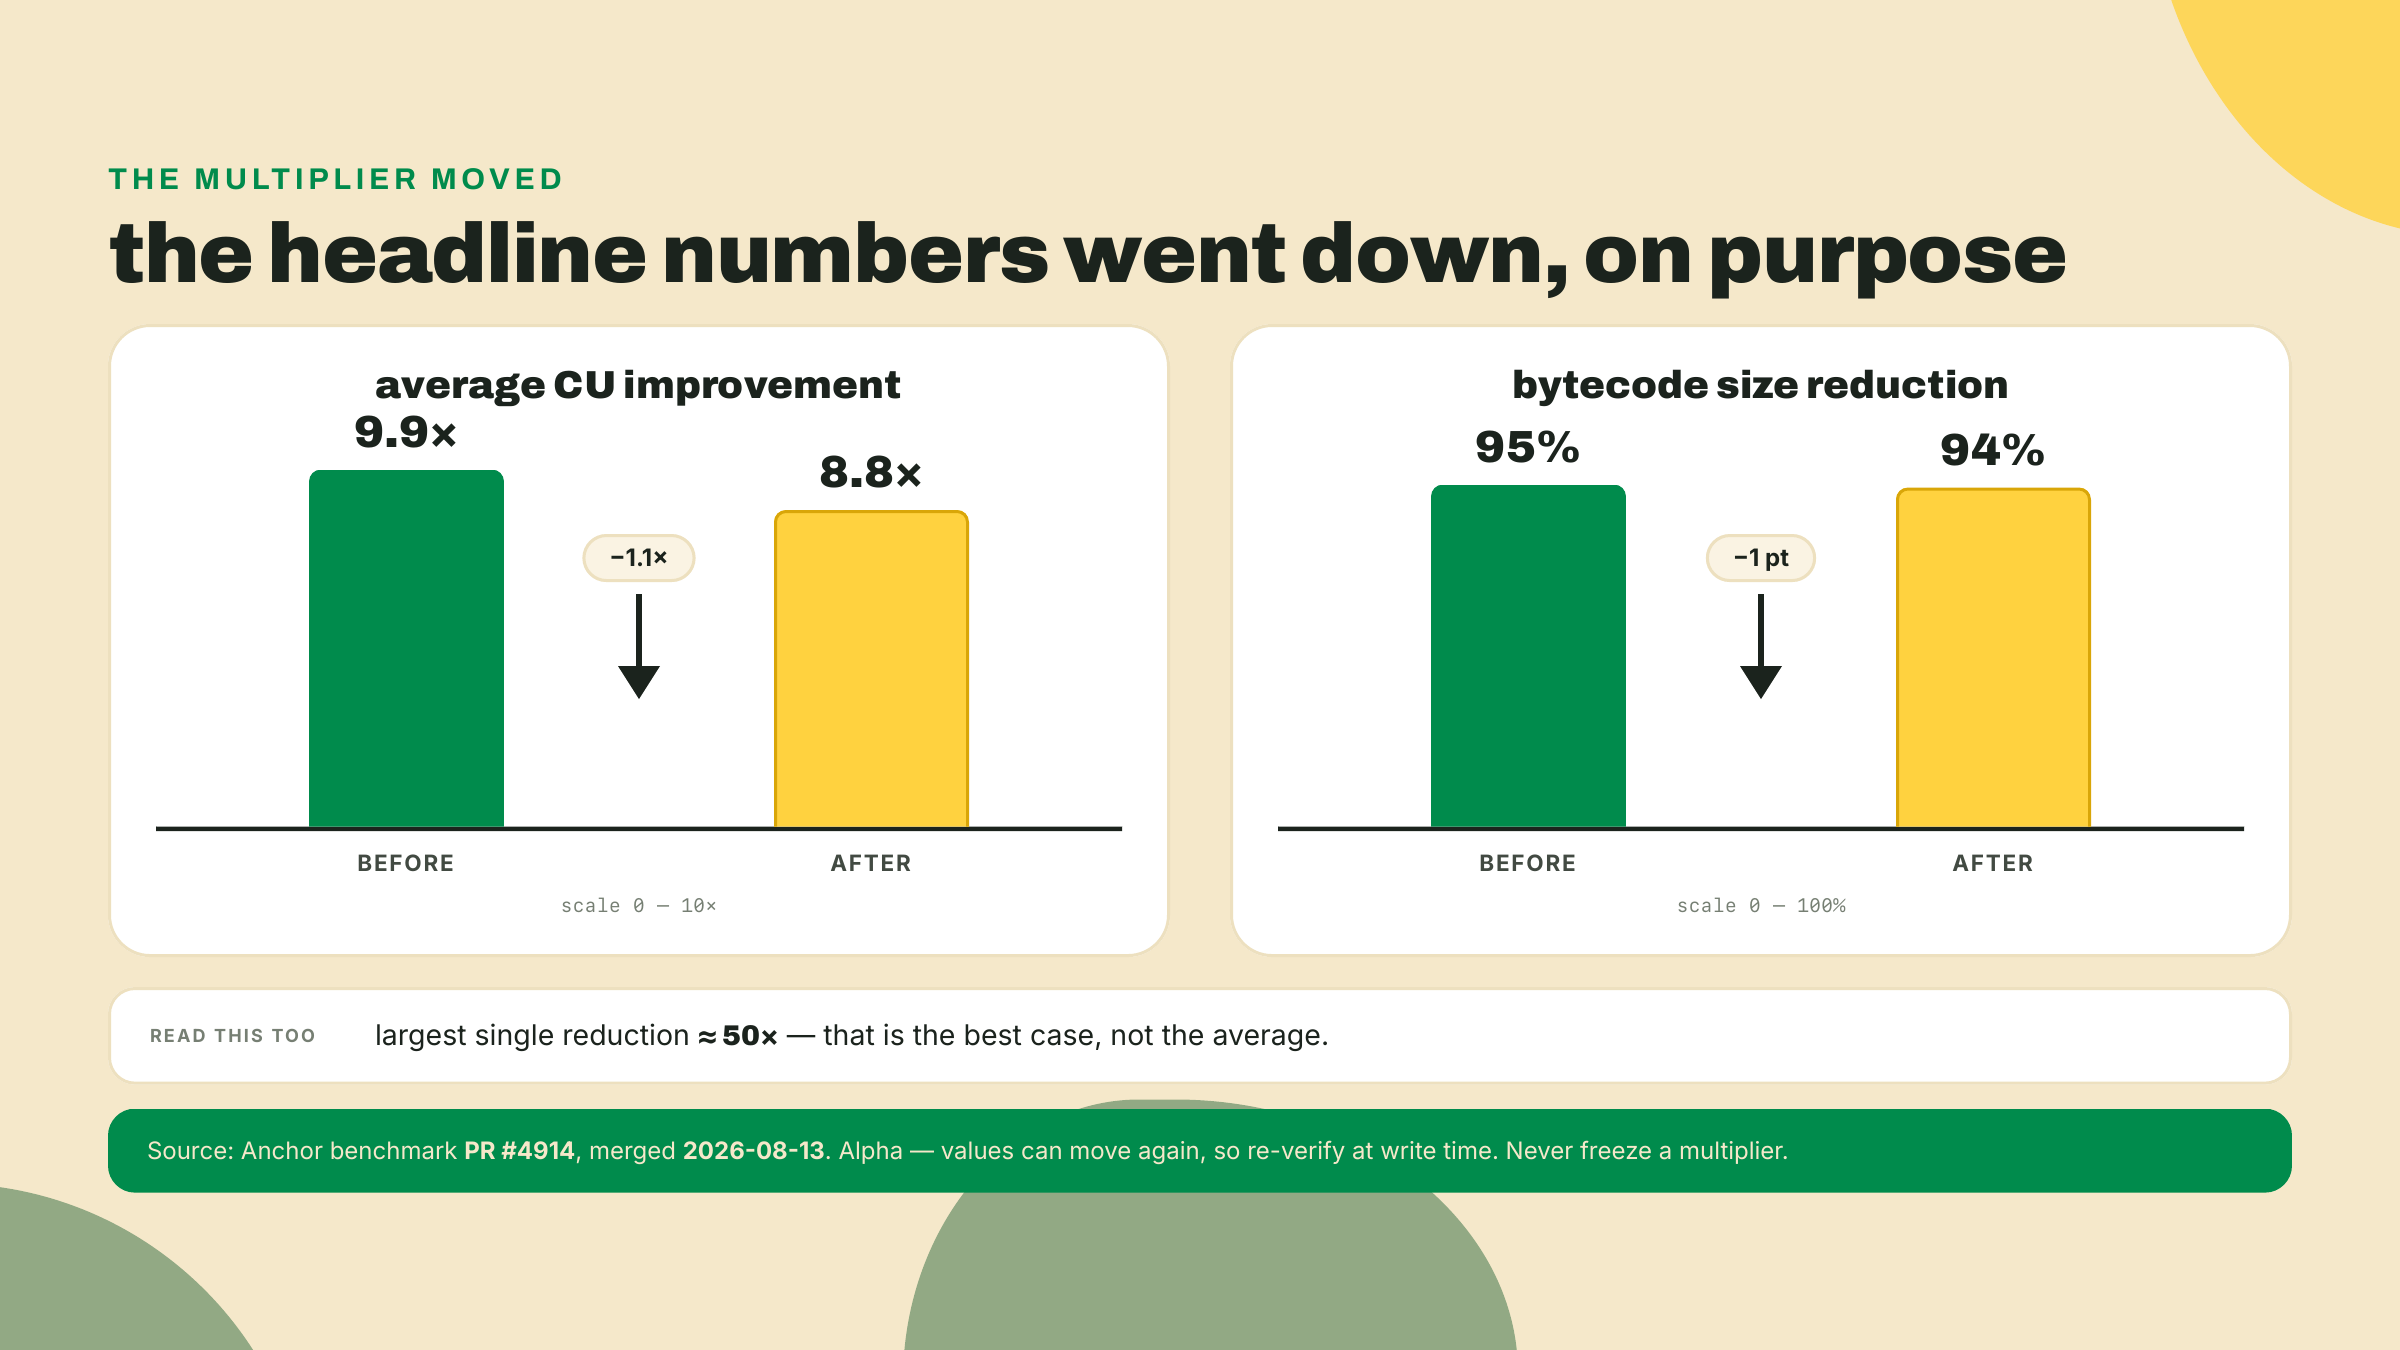
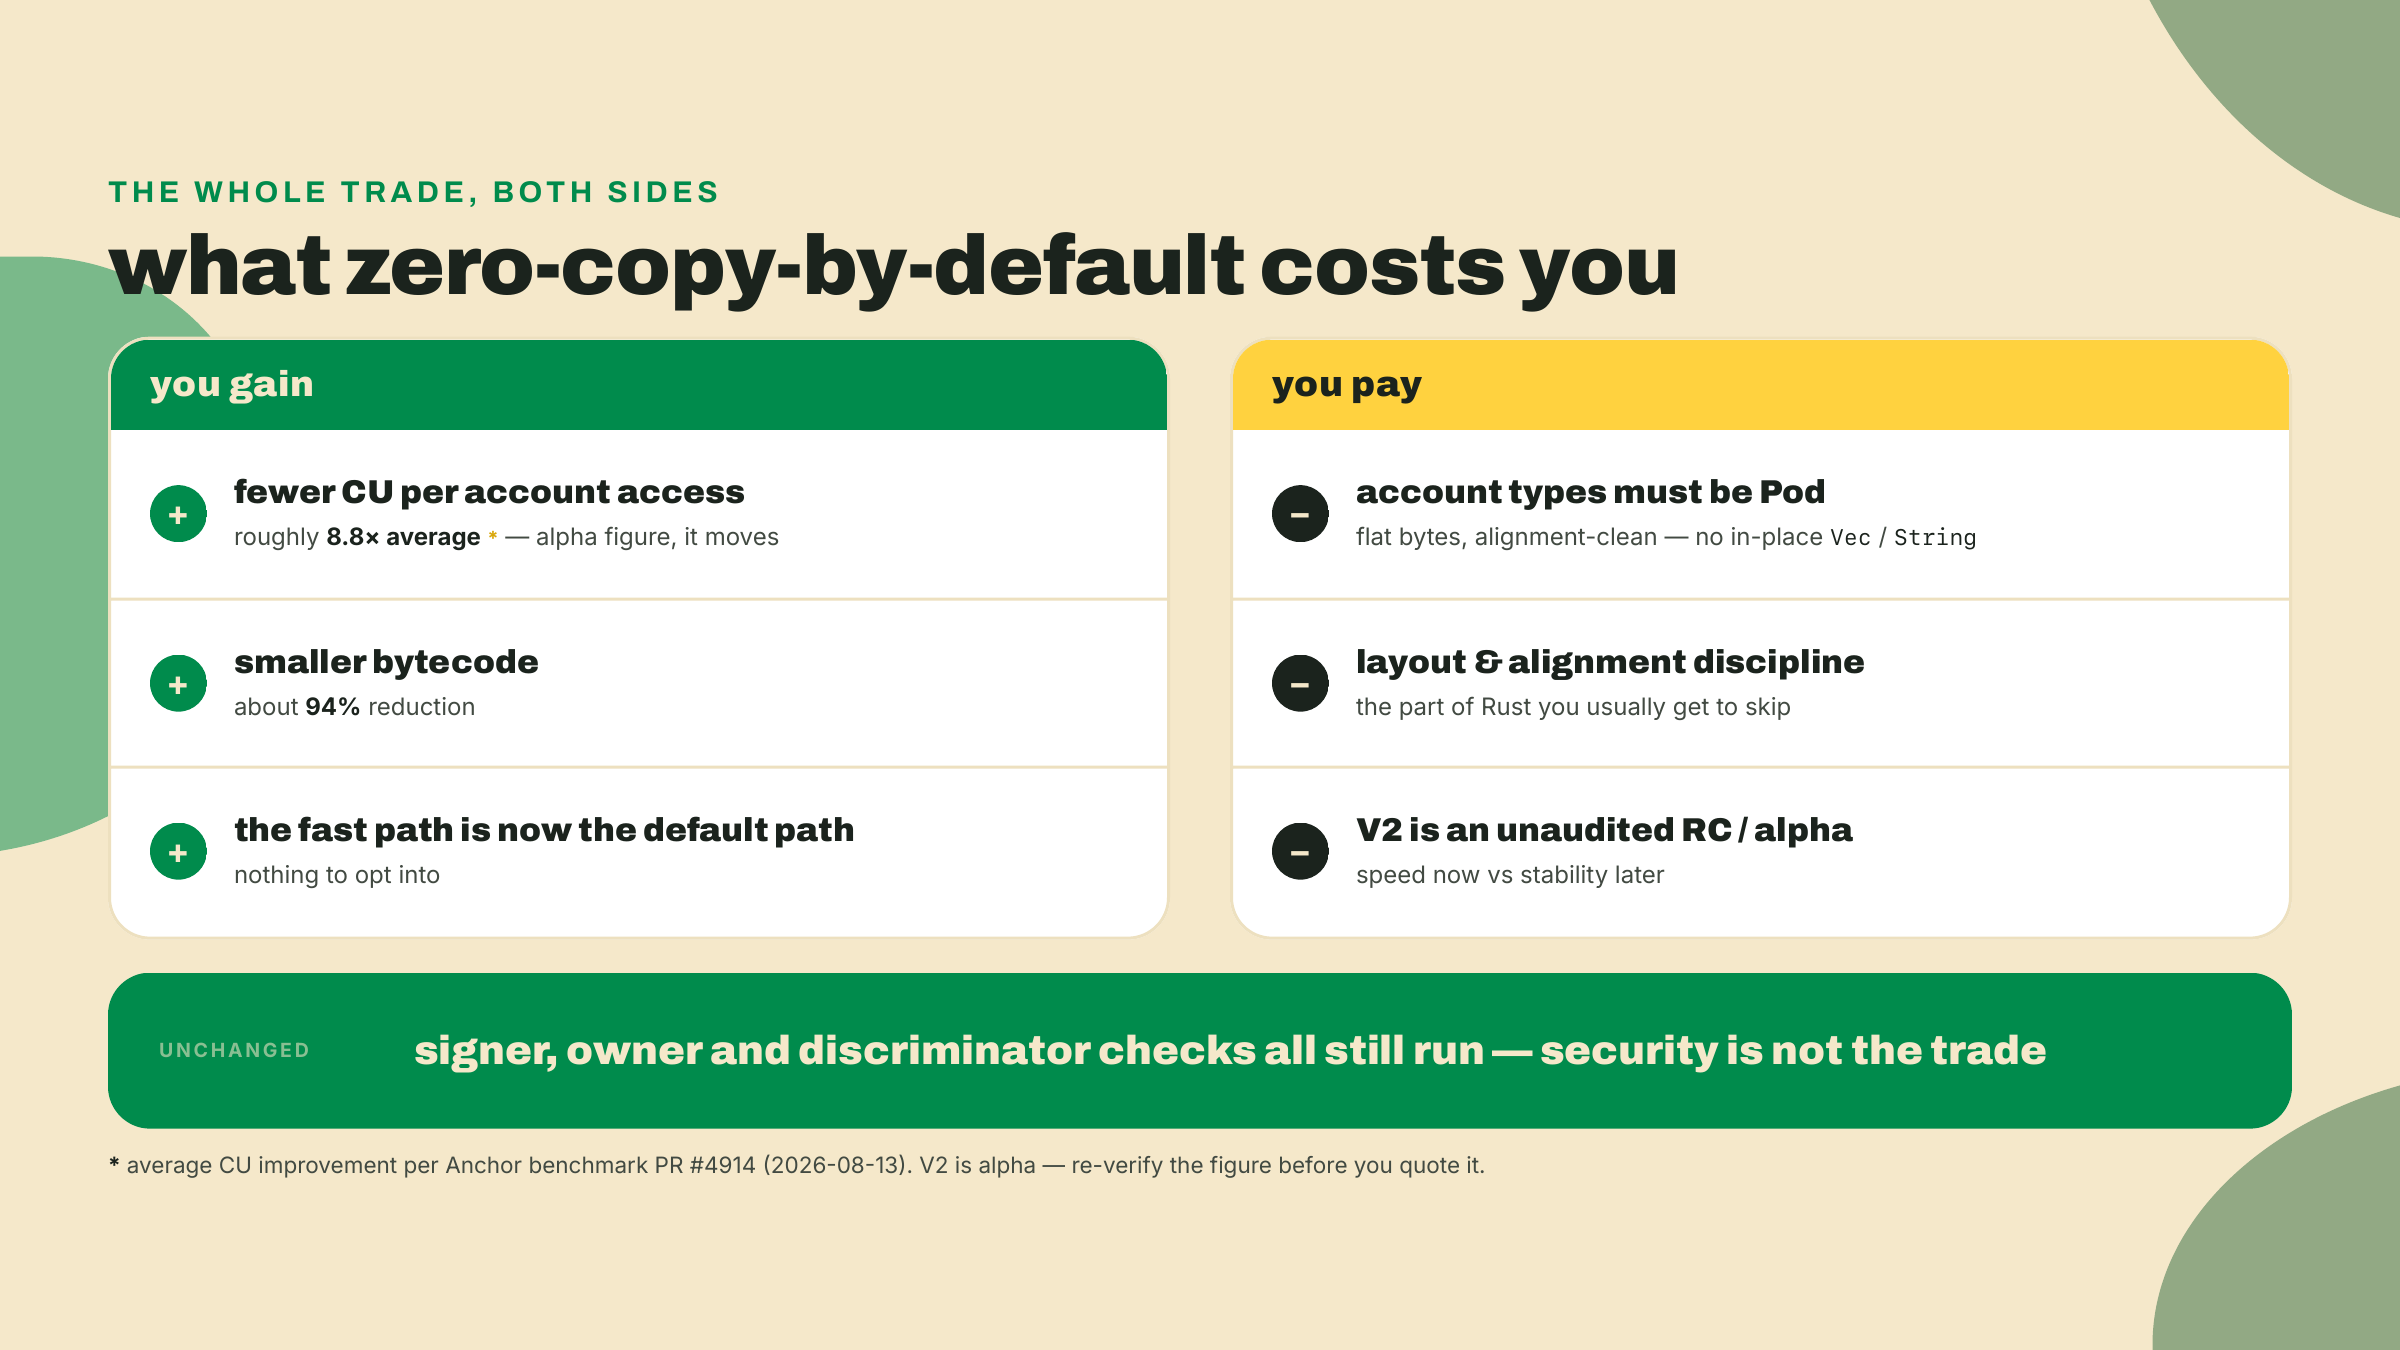
Los benchmarks de V2 originalmente anunciaban afirmaciones grandes y redondas. Después, el 2026-08-13, el PR de benchmark #4914 se mergeó y revisó los números de portada hacia abajo: la afirmación sobre el tamaño del bytecode pasó de 95% a 94%, y la mejora promedio de CU pasó de 9.9x a 8.8x. Eso no es una marcha atrás de la que haya que avergonzarse. Eso es un mantenedor mirando su propio marketing y haciéndolo coincidir con las mediciones. La mayor reducción individual de ese conjunto es de alrededor de 50x, pero ese es el mejor caso, no el promedio, y citar el mejor caso como el caso típico es exactamente el tipo de cosa que el PR #4914 estaba arreglando.
Así que la forma honesta del asunto, al momento de esa revisión del 2026-08-13: alrededor de 8.8x de reducción promedio de CU, alrededor de 94% menos bytecode. Los dos son números alpha sobre un framework alpha, y los dos pueden moverse otra vez antes de que leas esto. Trata cualquier multiplicador único como una instantánea con la fecha encima, nunca como una promesa. Esta es la trampa número uno, y es la razón por la que tu Lab no te da un número para memorizar. Te da un comando solana confirm para que midas la brecha en los programas reales, hoy, tú mismo.
Dos hechos más con los pies en la tierra, para que sepas el terreno donde estás parado. Primero, el trade-off, porque no te voy a vender velocidad sin la cuenta. El zero-copy por defecto compra la ganancia de CU, pero impone una disciplina que los desarrolladores de Rust normalmente se pueden saltar. Tus tipos de cuenta tienen que ser Pod, plain-old-data: datos planos de layout fijo, bytes con alineación limpia y sin punteros escondidos dentro. Eso descarta meter un Vec o un String directo en una cuenta y esperar que simplemente funcione, porque esos tipos no son bytes planos, son una longitud y un puntero a otro lugar en el heap, y no hay heap dentro de una cuenta.
Haz eso concreto. Una tabla de puntajes que modelarías en Rust normal como Vec<Score> no entra en una cuenta Pod tal como está escrita. La rediseñas: un array de capacidad fija más una longitud, dimensionado por adelantado. Eso es más previsión de la que Vec te pide, y a veces un tope fijo de verdad no se ajusta al problema. V2 mantiene una salida de emergencia para exactamente esos casos, un tipo de cuenta respaldado por borsh para cuando Pod no alcanza, y lo conoces en el módulo siguiente, en la lección sobre cuándo Pod se queda corto. Por ahora, solo anota la forma de la cuenta: cambias un poco de libertad en runtime por la ganancia de CU, pagada por adelantado en disciplina de layout. Y V2 mismo es una release candidate no auditada, de grado alpha. RC quiere decir release candidate, los mantenedores piensan que está casi lista. Alpha quiere decir trátalo como temprano y en movimiento sin importar la etiqueta. La velocidad ahora contra la estabilidad después es una elección real, y este curso la mantiene honesta en cada peldaño en vez de pretender que la RC está endurecida para producción.
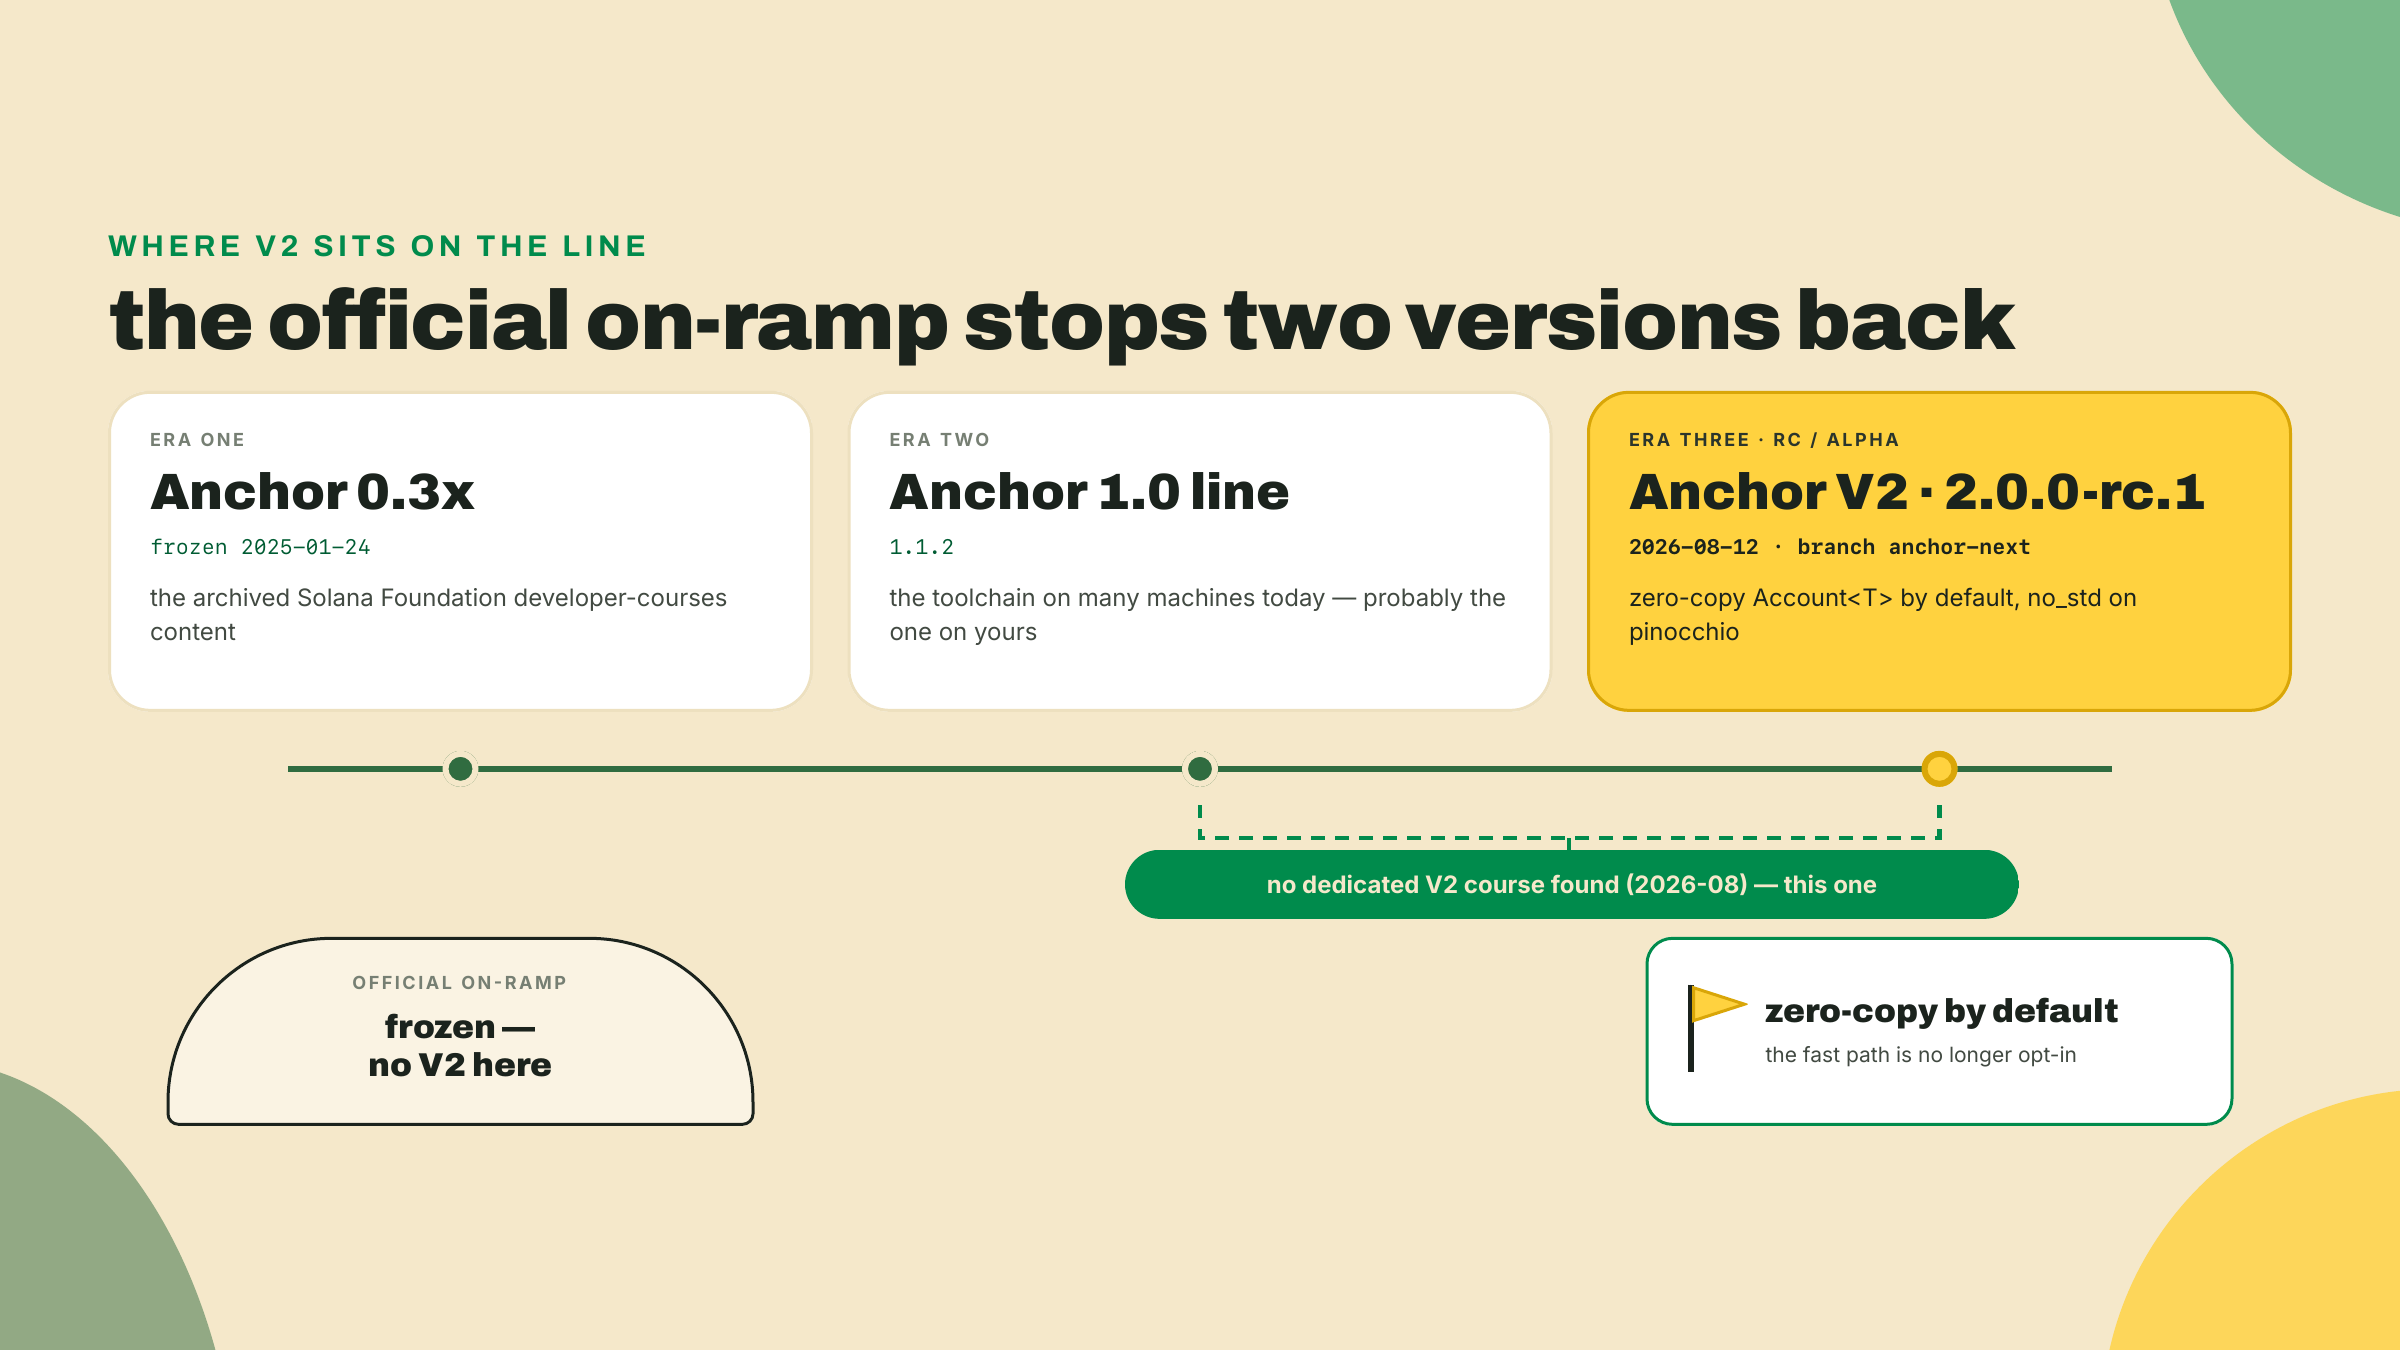
Segundo, por qué existe este curso siquiera. A agosto de 2026 me puse a buscar un curso dedicado a Anchor V2 o una guía extensa, y no encontré ninguno. No "no hay ninguno", no puedo demostrar una negativa, pero una búsqueda real no encontró nada. La ruta oficial de developer-courses de la Solana Foundation es peor que vacía: ahora redirige a un repositorio de contenido archivado, congelado el 2025-01-24, Anchor de la era 0.30 más o menos, una tumba con una lápida bonita. Así que esto no compite con la rampa de entrada. Está reemplazando una que dejó de respirar.
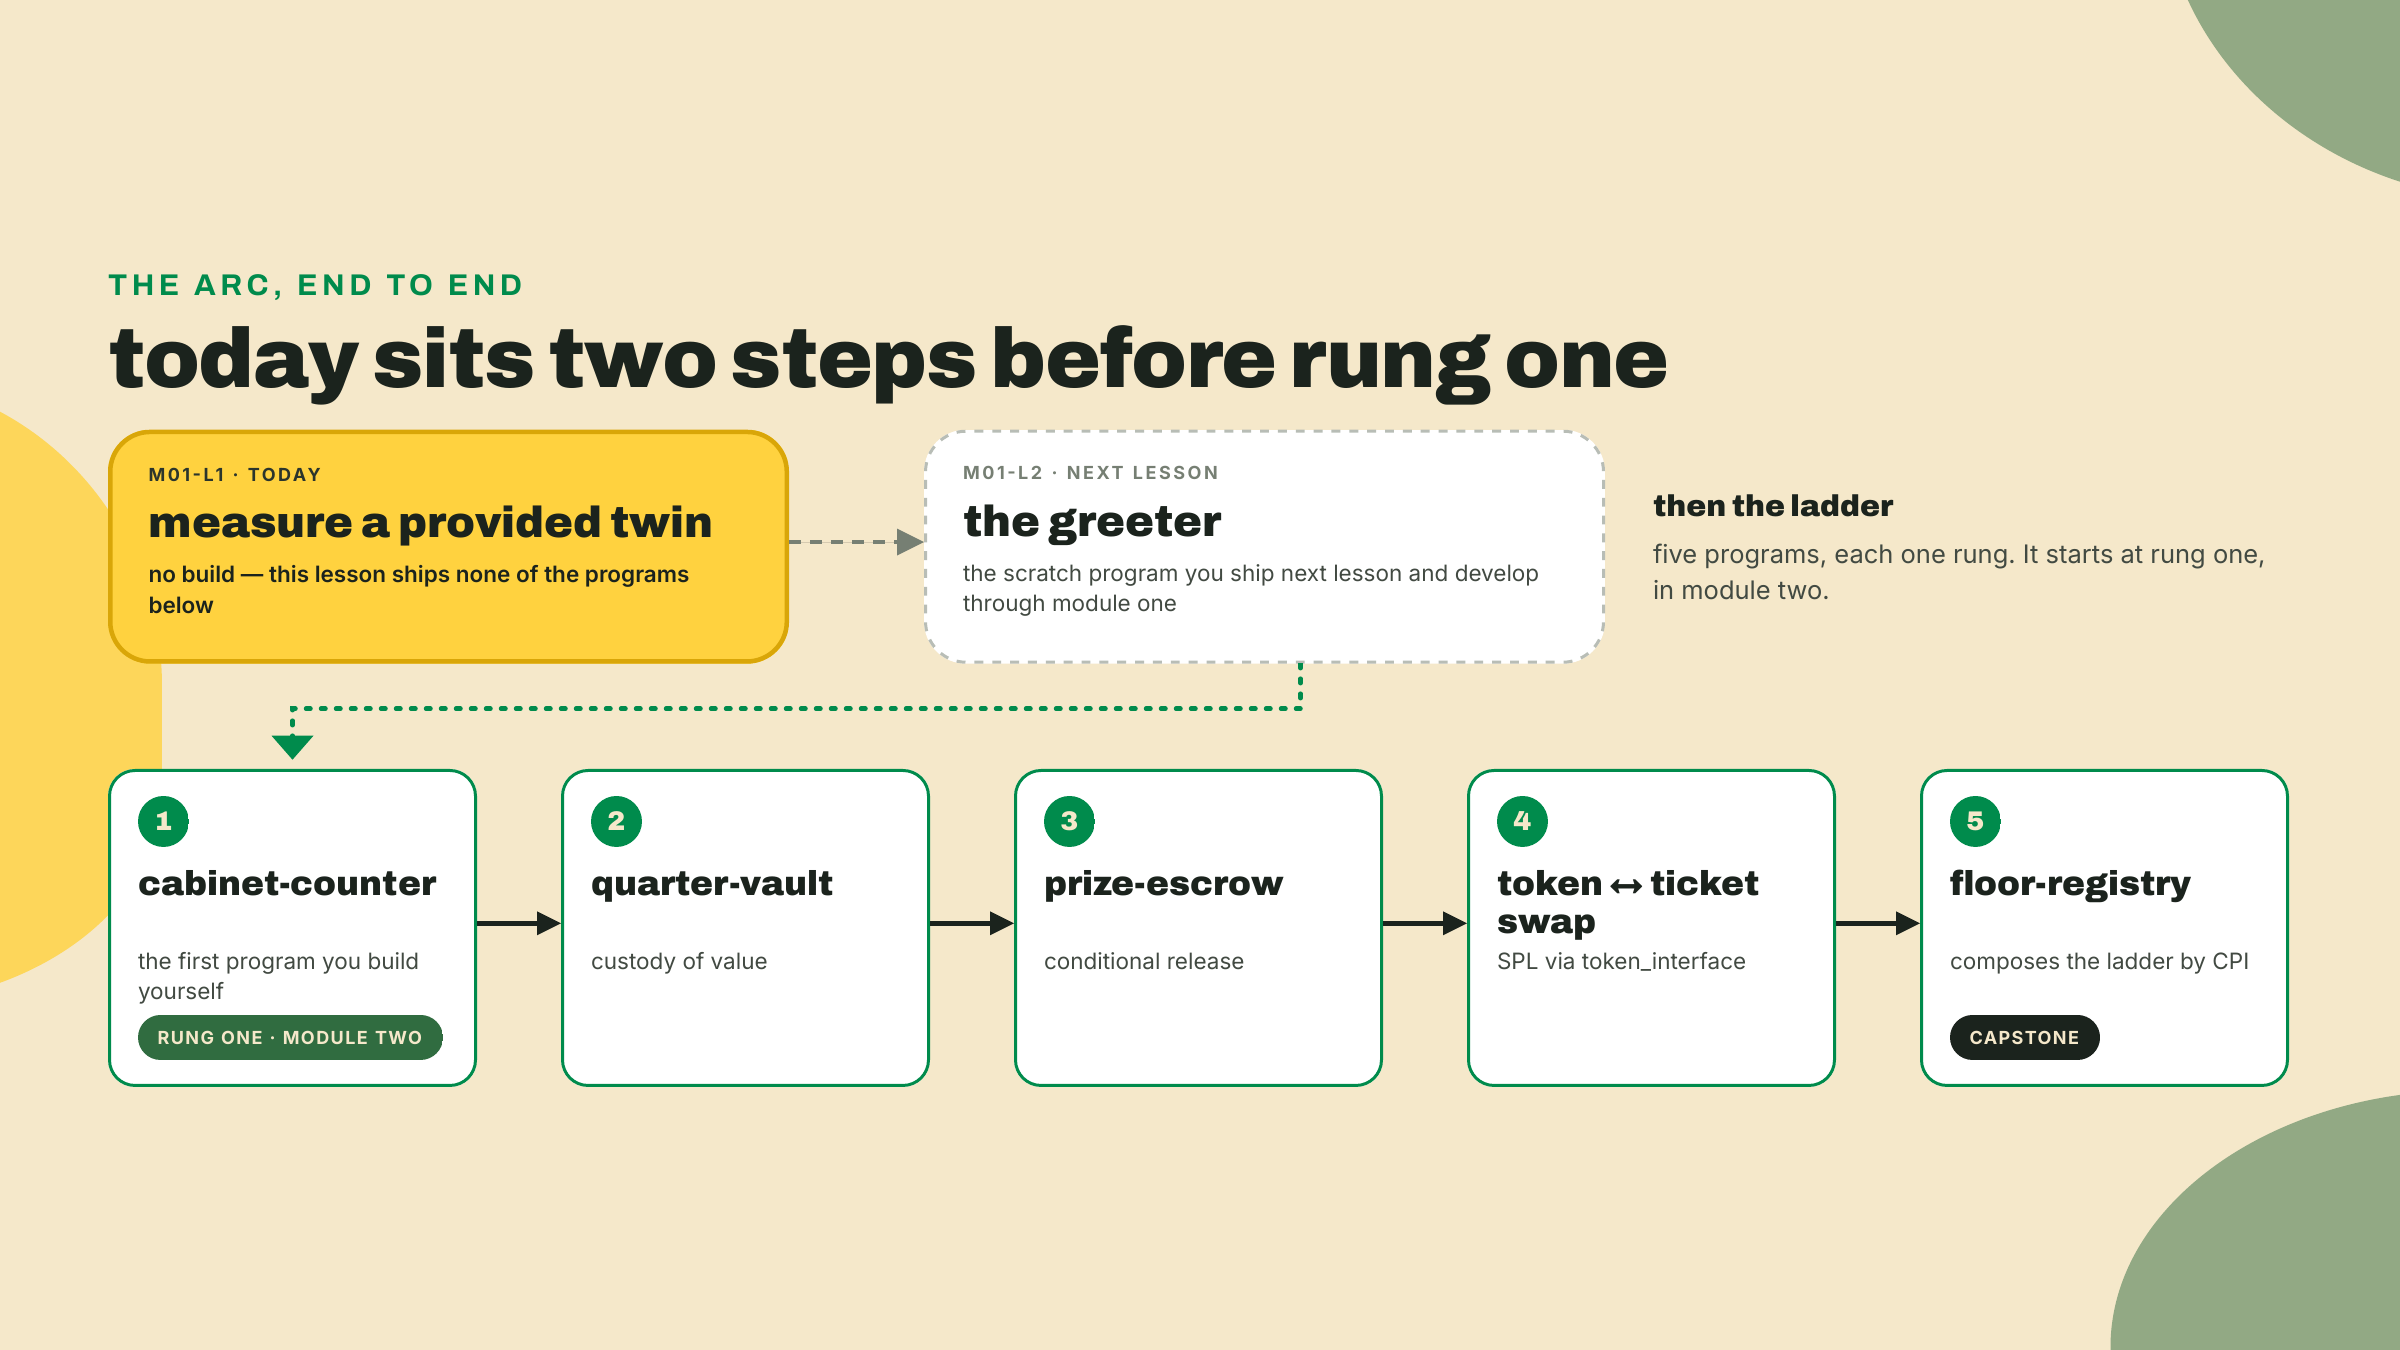
Antes del Lab, mira el camino. No vas a construir gemelos. Vas a construir un arcade. El dominio del curso es una economía de tokens de barcade retro llamada Quarters, y a lo largo de los módulos escribes una escalera real de programas: primero un cabinet-counter, después un quarter-vault que guarda valor, un prize-escrow, un swap de token a ticket, y un floor-registry capstone que compone toda la escalera por CPI. Cada peldaño es Rust contra la RC de V2. Los peldaños que dan al cluster se entregan en devnet — el greeter de borrador, el swap de token a ticket, el floor capstone — y los de en medio se demuestran en proceso, bajo el banco de pruebas que levantas en el módulo dos. Esta lección es el único peldaño que no construyes tú mismo, para que sientas el destino antes de dar el primer paso.
Manos al teclado, ahora. Esta es la parte que no te saltas. Sin instalación: todo lo de aquí corre en el CLI solana que ya tienes, apuntado a devnet. Los IDs de los dos programas gemelos y sus firmas de transacción de referencia están fijados aquí mismo en el paso 1 — aterrizados en devnet y verificados 2026-09-02, en la propia disciplina de frescura de este curso — y los seis pasos corren exactamente como están escritos.
El movimiento que vas a usar es solana confirm -v <SIGNATURE>, que imprime todos los mensajes de log de una transacción. Enterrada en esos logs hay una línea que el runtime escribe para cada programa que corre: Program <id> consumed X of Y compute units. Ese X es la lectura del medidor. Esa es toda la medición.
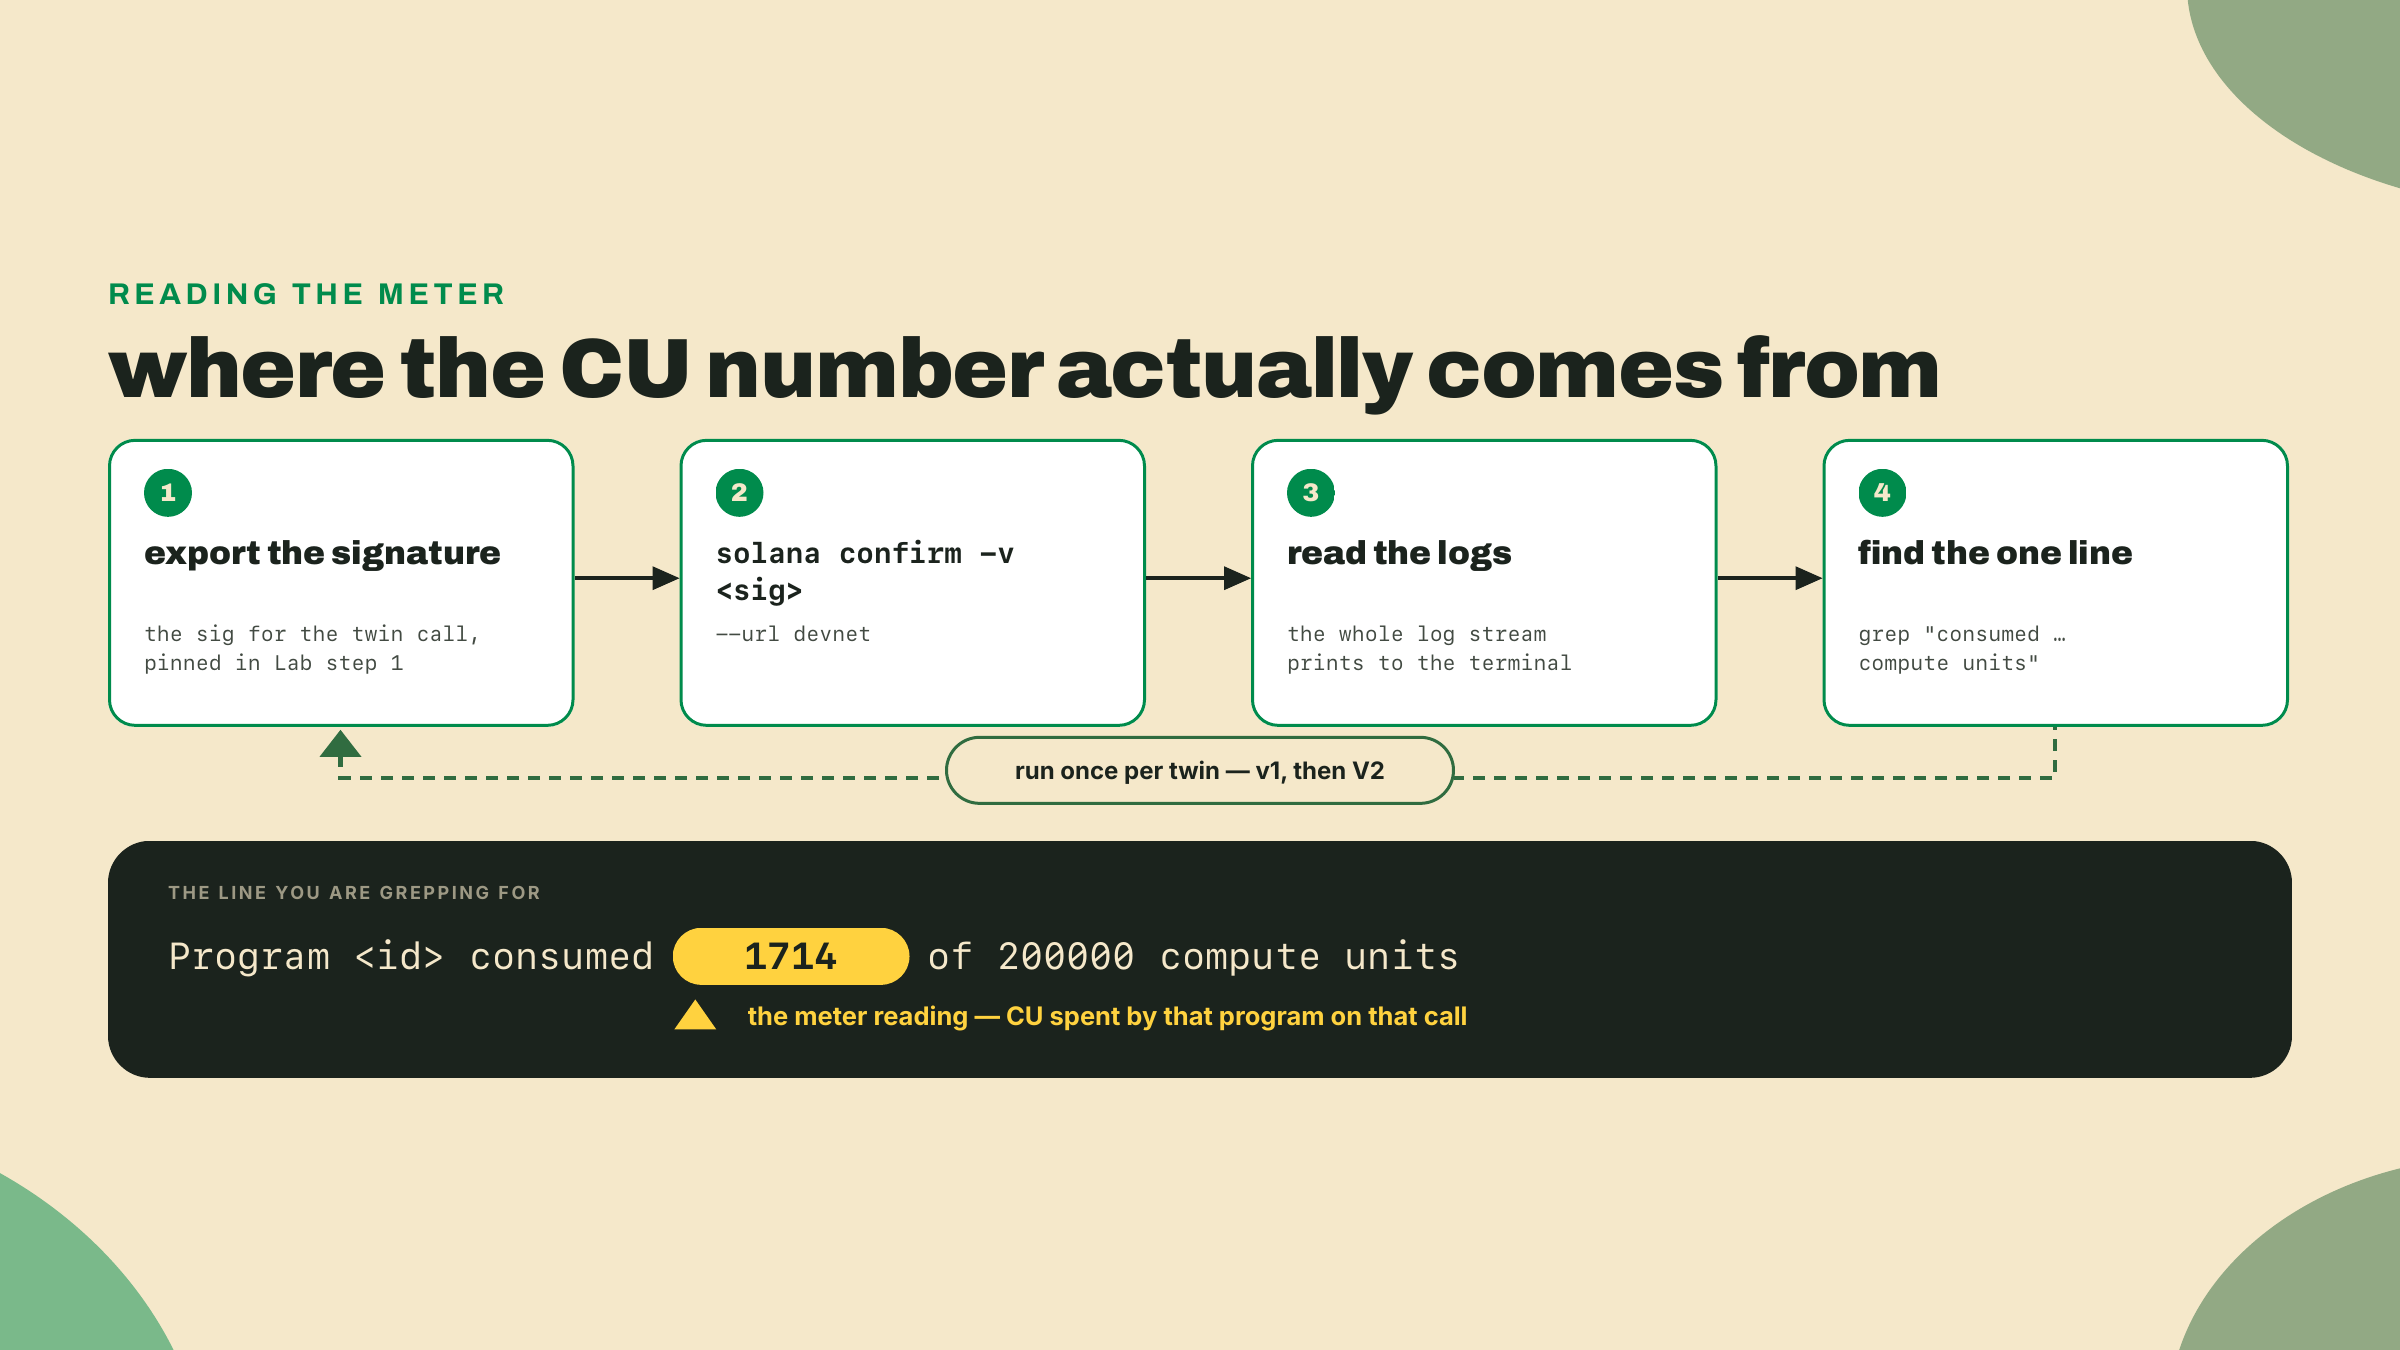
Apunta a devnet y fija los pins. Exporta los cuatro valores. Estos son los gemelos que aterricé para ti, verificados 2026-09-02. Si quieres comprobar que los programas están realmente desplegados, solana account "$V1_TWIN_ID" --url devnet muestra cada uno como una cuenta ejecutable.
export V1_TWIN_ID="8bhX52w9mGGaAFJwsoWLpv3nrZsXzc3ZfE2P622uGt3z"
export V2_TWIN_ID="2fLbW1PG2CeyAgR5krLF9okkqCXRmqy1o3srBh4E26WT"
export V1_TWIN_SIG="2BYB5oU12EfJjPTuQjaZCcxwMjWxSBUQ7WjeucW6V35Ge1PRFUda39nV4dU8NnDvt8ZfbN8H4fpAEoYpsEYysR43"
export V2_TWIN_SIG="43beWNMwXpC24VqRf2uVspVDgBgKEMG75brR7LMeLeH3EcuLa9NVibJb9JAGqbe8pUDckPhtTqKRFhuzDtoZpCRs"
Lee el medidor del gemelo v1. Confirma su transacción de referencia y saca la línea de compute-units:
solana confirm -v "$V1_TWIN_SIG" --url devnet | grep -i "compute units"
El mío imprimió dos líneas — el grep insensible a mayúsculas atrapa el resumen propio del CLI además de la línea de log del runtime — y la firma de referencia te repite la misma lectura:
Compute Units Consumed: 1714
  Program 8bhX52w9mGGaAFJwsoWLpv3nrZsXzc3ZfE2P622uGt3z consumed 1714 of 200000 compute units
Cada vez que este par se vuelva a aterrizar — por los mantenedores después de un reset de devnet, o por ti más adelante en el curso con tu propia billetera — el número exacto va a diferir; la forma no. Anota el consumed X del gemelo v1 — es la misma lectura que te hizo tomar la apertura.
Si grep regresa vacío, arréglalo antes de seguir. Tres causas habituales, en el orden en que deberías revisarlas. Estás apuntado al cluster equivocado, así que revisa de nuevo --url devnet. O el export se estropeó al pegarlo, así que el shell tiene una firma truncada. O, si solana confirm reporta la firma como no encontrada en vez de imprimir logs vacíos, la transacción de referencia ya salió por antigüedad del historial de transacciones de devnet, que se poda y no guarda firmas viejas para siempre. Esa tercera es la disciplina de frescura de este curso mordiendo al curso mismo, y la recuperación se entrega en esta misma página: la salida de log esperada para los dos gemelos está impresa en los pasos 2 y 4, así que la medición sigue en pie — y una firma podada es exactamente el tipo de pin viejo que este curso te entrena a marcar, así que repórtala y los mantenedores vuelven a aterrizar el par y vuelven a fijar estos cuatro valores. Un resultado en blanco aquí es un problema de configuración, no un problema tuyo.
Detente y predice. Antes de correr el gemelo v2, comprométete con una respuesta en voz alta o en papel: ¿qué gemelo esperas que consuma menos CU, y por alrededor de cuánto? Tienes la tesis y tienes el contexto honesto del promedio de 8.8x. Decídete ahora. Predecir antes de mirar es cómo descubres si de verdad entendiste la vista general o solo asentiste con la cabeza.
Lee el medidor del gemelo v2. La misma llamada, programa gemelo:
solana confirm -v "$V2_TWIN_SIG" --url devnet | grep -i "compute units"
Para que conste, la lectura de referencia, en la misma forma de dos líneas:
Compute Units Consumed: 200
  Program 2fLbW1PG2CeyAgR5krLF9okkqCXRmqy1o3srBh4E26WT consumed 200 of 200000 compute units
Anota el consumed X del gemelo v2.
Calcula el delta. Resta, y saca el ratio. Dos números reales de dos logs reales en el mismo devnet, haciendo el mismo trabajo con las mismas cuentas. La cifra de v2 debería ser materialmente más baja. Que tu ratio medido caiga cerca del vecindario del promedio de 8.8x o en otro lado es justamente el punto de medir en vez de memorizar: ahora tienes un número con la fecha de hoy encima, no un eslogan.
No te alarmes si tu ratio no es 8.8x. No debería serlo, exactamente, y eso es sano. El 8.8x es un promedio sobre una suite de benchmarks, y la ganancia escala con cuánta copia estaba haciendo el programa en primer lugar: un programa que lee cuentas grandes, o que las lee muchas veces por llamada, ahorra proporcionalmente más que un programa que apenas toca una cuenta chica. Los gemelos son deliberadamente simples, así que tu ratio refleja una llamada simple. Un multiplicador congelado habría escondido eso. Tu medición lo muestra.
Diagnostica antes de seguir leyendo. En una oración, nombra la causa raíz de la brecha. No espíes el párrafo siguiente hasta que la hayas escrito.
Aquí está la respuesta, para que puedas revisar la tuya. El gemelo v2 gasta menos CU porque el Account<T> de v1 deserializa, o sea, copia, los bytes de la cuenta en una struct en cada acceso, mientras que V2 castea los mismos bytes en el lugar y los lee donde están. Esa es la trampa número dos anticipada: la ganancia no es que V2 se haya saltado alguna verificación. Los dos gemelos corrieron la misma validación de signer, dueño y discriminator. Un discriminador es la pequeña etiqueta que Anchor escribe al frente de una cuenta para que una carga pueda rechazar el tipo de cuenta equivocado de entrada; derivas uno a mano en m01-l4. Quitarlos sería una regresión de seguridad, no una optimización. Los ahorros son las copias que ya no están pasando, nada más y nada menos.
El criterio de esta lección es pequeño y está enteramente en tus propias palabras. En tres piezas cortas:
Si tu única oración aterriza en "V2 castea los bytes de la cuenta en el lugar en vez de copiarlos en una struct en cada acceso", tienes la tesis de todo este curso en una forma que puedes defender. Si aterriza en "V2 es más rápido porque se salta verificaciones", vuelve atrás y relee el paso seis del Lab, porque esa es exactamente la mala lectura que el diseño tuvo cuidado de no generar.
En vez de leer una afirmación sobre unidades de cómputo, tomaste una lectura, dos veces, sobre programas que alguien más ya entregó, y atribuiste la brecha a una decisión de diseño específica en vez de a una sensación. Ese es el músculo que entrena todo el curso: medir, después explicar, después nunca congelar un número en movimiento.
Sentiste la brecha corriendo los gemelos de alguien más. La próxima lección dejas de pedir prestado y empiezas a entregar. Instalas el toolchain de V2, el que de verdad te da pelea, una RC con aristas filosas y uno o dos workarounds, y lanzas tu propio primer deploy a devnet: el greeter R0. Los números R son cómo este curso nombra los peldaños de la escalera de Quarters — R1 hasta R4, con el floor-registry capstone arriba — y R0 es el que está debajo del más bajo: el programa de borrador que comprueba tu toolchain, y que después sigues extendiendo por el resto del módulo uno. El primer peldaño de verdad, el cabinet-counter, viene el módulo siguiente. El acompañamiento se adelgaza a partir de ahí. Trae la terminal.
Pregunta 1 de 3