Cargando...

 BetaBeta
Resumen. En V1, en el instante en que tu programa guarda un u64 de verdad, Anchor paga un impuesto de deserialización en cada load: recorre los bytes de la cuenta y reconstruye un struct de Rust en el stack antes de que tu handler llegue a correr. V2 borra ese paso. Account<T> ahora es una ventana tipada directo sobre los bytes crudos de la cuenta, así que leer un campo es un cast de puntero, no un decode. Esa velocidad la pagas en disciplina de layout: cada campo tiene que ser un tipo de datos planos, y no puede haber relleno escondido. Esta lección construye R1, el cabinet-counter, para que sientas exactamente dónde cae esa cuenta.
En m01-l4 leíste lo que #[derive(Accounts)] genera de verdad: el orden load-luego-constraints-luego-dispatch, los discriminadores sha256, el layout de errores. Lo corriste sobre R0, el greeter, y le diste una cuenta Marquee de un solo campo puramente para tener una superficie que observar. R0 se queda donde está; hizo su trabajo. Con lo que cerró esa lección fue con la promesa de que la disciplina de layout detrás del plays: u64 desnudo de Marquee, que ya era un campo Pod legal sin que te dieras cuenta, deja de ser invisible ahora. El estado que de verdad guardas empieza aquí, en un programa nuevo. La variante #[event(bytemuck)] quedó estacionada con una nota: "espera hasta que exista Pod." Pod llega en esta lección, y la siguiente cobra esa promesa.
Así que hagámoslo existir para ti en los próximos dos minutos, sin toolchain nuevo: la RC de V2 que construiste desde git allá en m01-l2 es lo que compila todo esto. Confirma que PATH siga sirviéndolo antes de escribir nada, porque tu máquina también carga la línea estable 1.x y el modelo de cuentas de abajo se comporta distinto ahí:
which anchor       # ~/.cargo/bin/anchor either way — the avm shim lives at the same path, so this only proves it's on PATH
anchor --version   # the real check: expect the v2 line, not 1.1.2
No te apoyes en which para distinguir el shim de la instalación de git: el shim de avm es ~/.cargo/bin/anchor (un link a ~/.avm/bin/avm), y el build de git escribe la misma ruta, así que los dos son indistinguibles por ubicación. La línea de versión es la única verificación que puede atrapar el toolchain equivocado.
R1 es un programa nuevo, así que genera su scaffold al lado del greeter:
anchor init cabinet-counter
cd cabinet-counter
Primero las dependencias, y un scaffold recién hecho necesita más de una. El derive de Pod en el que estás por apoyarte lo verifica bytemuck, que el scaffold no trae — y al scaffold también le faltan los pins de wincode/solana-address de m01-l2, así que construirlo tal cual muere en la expansión de #[program] con el mismo E0433 que esa lección te enseñó a esperar. Abre programs/cabinet-counter/Cargo.toml, cambia la fila git de anchor-lang del scaffold a la versión de crates.io, y haz que [dependencies] diga:
anchor-lang = "2.0.0-rc.1"
bytemuck = "1.25"
wincode = { version = "0.5", features = ["derive"] }
solana-address = ">=2.6.1, <2.7"
El Paso 1 del Lab vuelve a cada una de estas filas y explica por qué se ve como se ve — incluido por qué ese último pin es un techo y no la igualdad =2.6.0 que usó m01-l2. Por ahora solo tienen que existir para que el build pueda.
Ahora abre programs/cabinet-counter/src/lib.rs y agrega este struct debajo del Counter generado, dejando el resto del scaffold tranquilo por ahora. PodU64 viene del anchor_lang::prelude::* que el scaffold ya importa; es el wrapper que esta lección se pasa su sección del medio derivando, y por los próximos dos minutos puedes leerlo como "un u64 que es seguro castear desde bytes":
#[account]
#[repr(C)]
pub struct Cabinet {
    pub play_count: PodU64, // 8 bytes
    pub high_score: PodU64, // 8 bytes
}
Después haz el build:
anchor build
Resultado esperado: compila. Ahora rómpelo a propósito. Cambia high_score por un pub high_score: bool desnudo y haz el build otra vez. Resultado esperado: un error de compilación que dice que bool no satisface el bound Pod. Dos campos que se pueden castear desde bytes compilan; un campo que no se puede castear impide que el programa exista siquiera. Esa negativa es toda la tesis de V2 apareciendo como mensaje del compilador, y el resto de esta lección es por qué es un buen trato. Vuelve a poner PodU64 antes de seguir leyendo.
Aquí está la frase que arrancó toda esta reescritura del framework. El issue #4390 de Anchor, titulado "Zero-copy account deserialization by default," llama al Account<T> de hoy el camino lento y la queja de rendimiento número uno entre los desarrolladores de Anchor. Todo el modelo de cuentas de V2 es la respuesta a ese único issue, así que vale la pena ir más despacio y derivar por qué el camino viejo es lento antes de celebrar el nuevo.
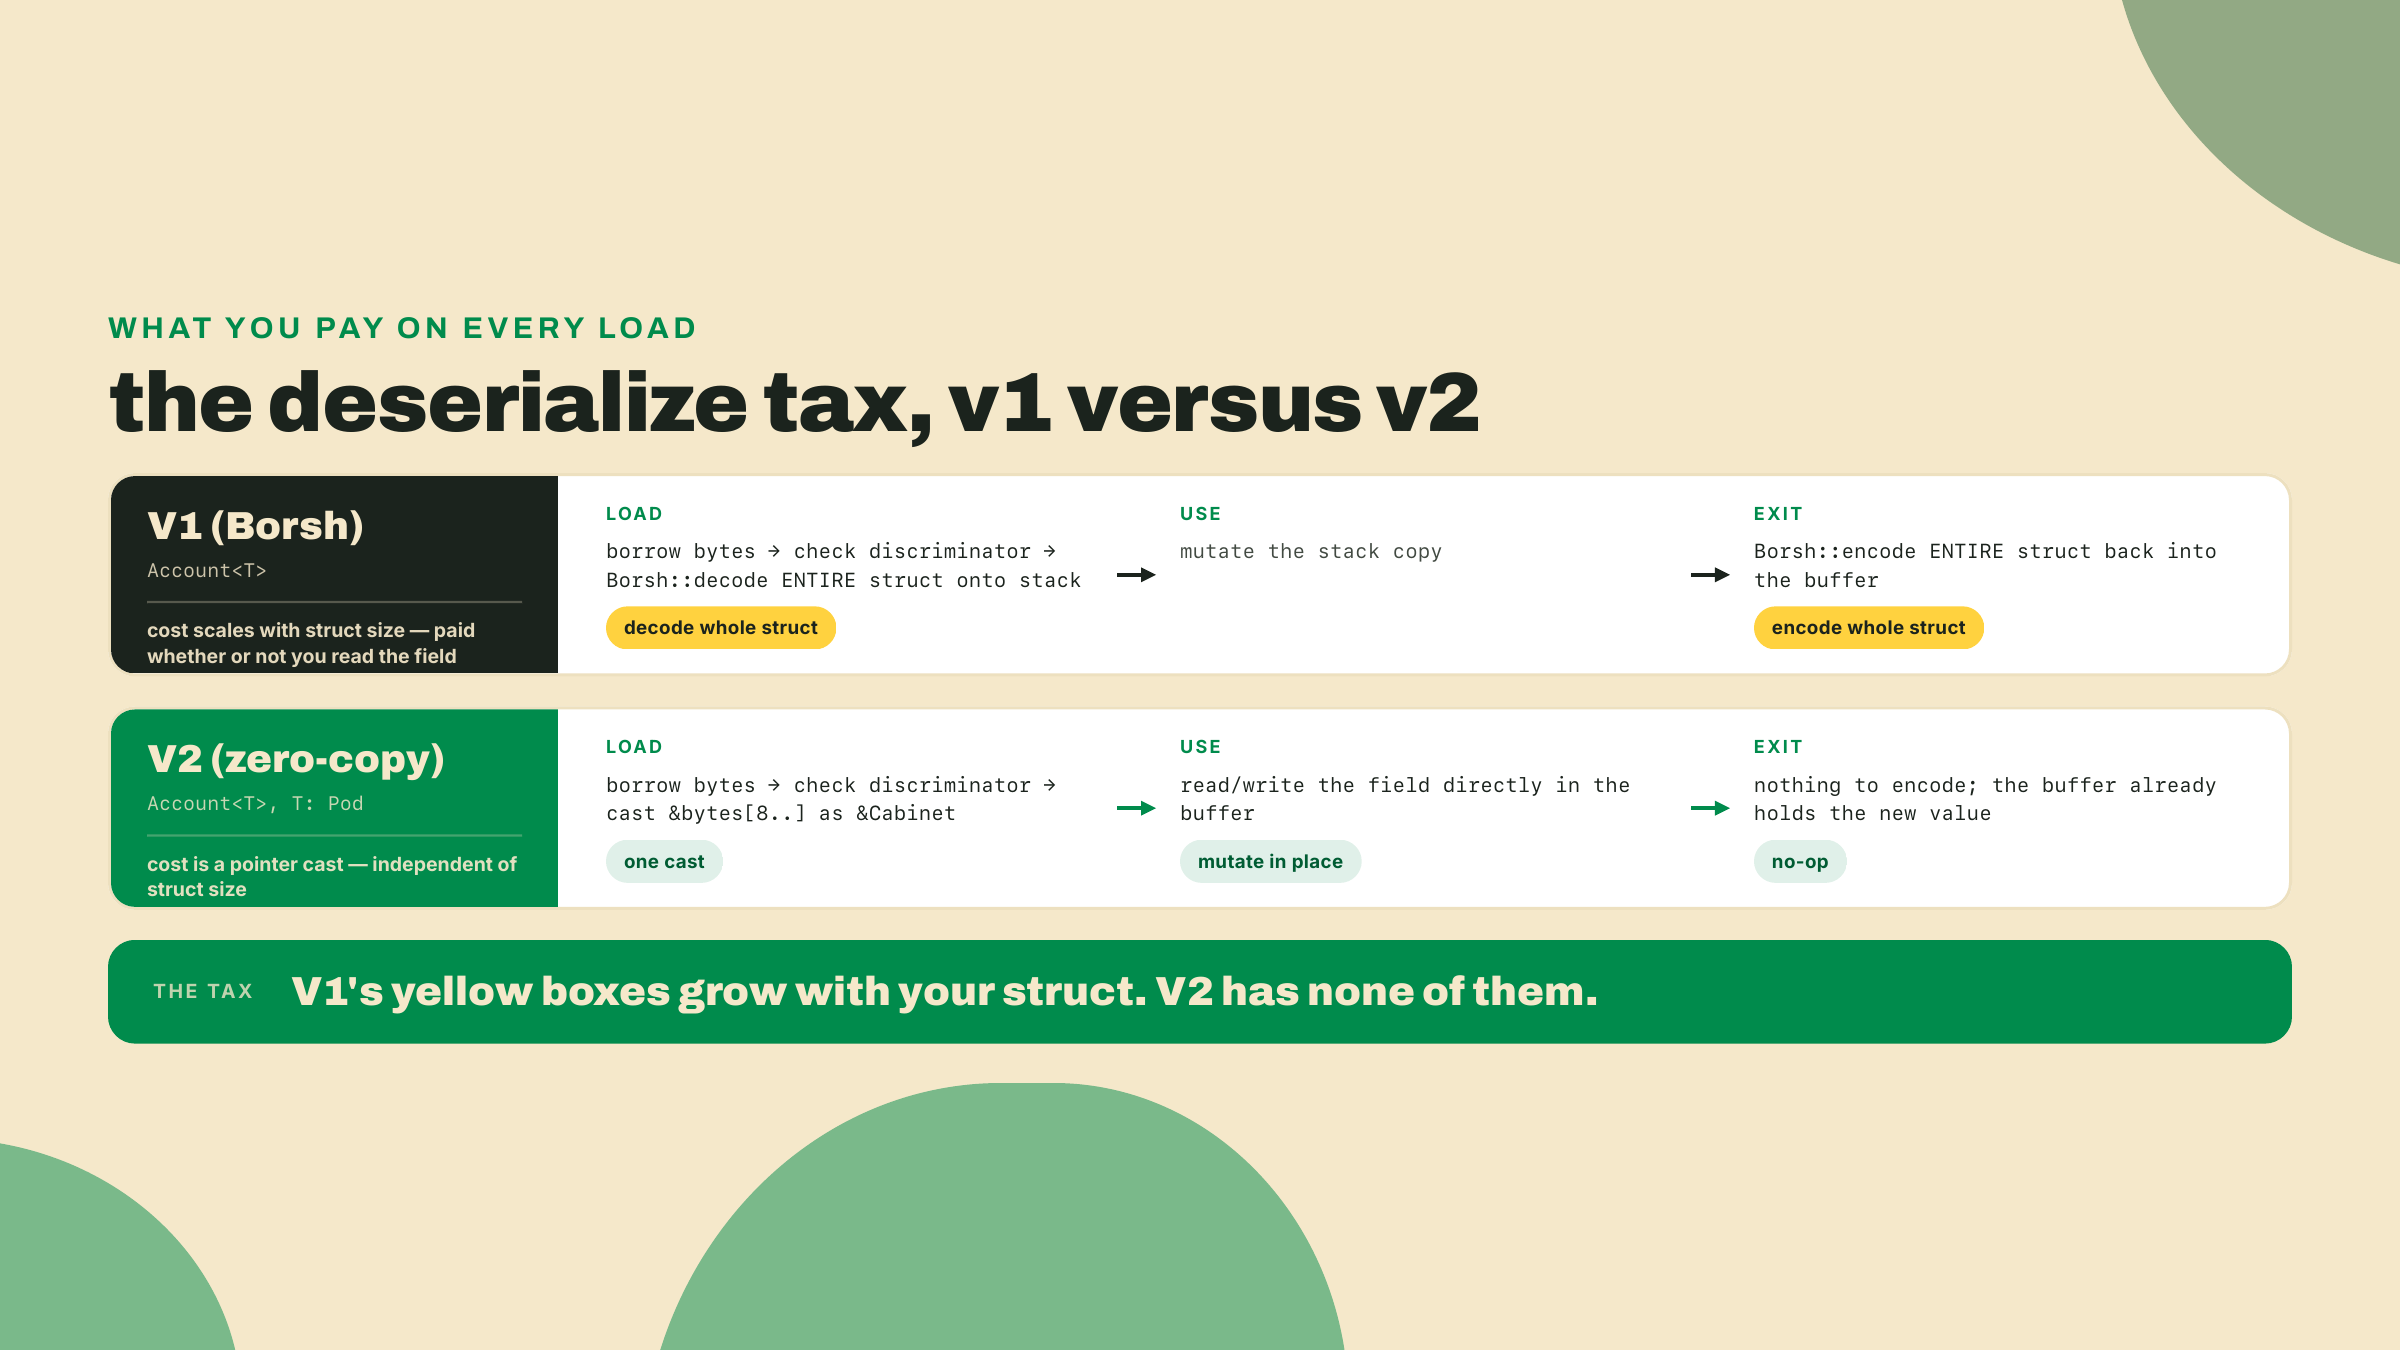
Imagínate el greeter R0 de la lección pasada, solo que ahora guarda un único contador. En V1, cuando una instrucción toca esa cuenta, Anchor hace más o menos esto: toma prestado el buffer de bytes crudos de la cuenta, verifica el discriminador de 8 bytes, y después llama a Borsh (el formato de serialización de Anchor) para recorrer los bytes restantes campo por campo y construir un valor Greeter { count: u64 } nuevo en el stack. Tu handler muta ese valor del stack. A la salida, Anchor serializa el struct completo de vuelta al buffer.
Para un solo u64 el costo es chico. Pero nunca se queda en un u64. Los programas reales guardan una config con quince campos, un vector de entradas, un par de pubkeys. Cada una de esas cosas se decodifica a la entrada y se vuelve a codificar a la salida, la haya leído tu handler o no. Ese es el impuesto. Escala con el tamaño del struct, no con el trabajo que realmente hiciste.
Desarma la cuenta en sus partes y es fácil ver por qué creció hasta ser la queja número uno. Está el decode en sí, una pasada sobre el buffer que asigna y llena un struct nuevo. Está el espacio de stack que ese struct ocupa mientras corre tu handler, que el runtime de SBF mide. Está el encode a la salida, una segunda pasada completa que escribe el struct de vuelta. Y está la copia que nunca pediste: un handler que solo quería subir un contador igual pagó por reconstruir los catorce campos que nunca tocó. Ninguno de esos cuatro costos está haciendo el trabajo real de tu programa. Son el precio de la abstracción, y lo que V2 afirma es que el precio debería ser cero.
Antes de recurrir a zero-copy, fíjate en que un ingeniero cuidadoso probaría arreglos más baratos primero, y vale la pena ver por qué falla cada uno, porque las fallas son las que fuerzan el diseño real.
El arreglo más ingenuo es "decodifica solo los campos que de verdad tocas." Borsh no puede hacer eso. Es un formato secuencial: para encontrar el campo cinco tienes que recorrer los campos uno al cuatro, porque el largo de cada campo puede depender de los bytes que van antes. Un vector en el medio no tiene offset fijo. Así que el decode parcial no es gratis, es la mayor parte del decode.
El arreglo siguiente es "cachea el struct decodificado para que las lecturas repetidas sean baratas." Eso ayuda dentro de una sola instrucción, pero el costo que nos importa es el decode una vez por load y el encode una vez por salida, y el cacheo no hace nada por esos. Sigues pagando en los dos extremos.
El tercer arreglo es "haz que Borsh sea más rápido." Ya lo hicieron. Sigue siendo un decode. Estás optimizando la constante de una operación que no debería pasar en absoluto.
Así que la pregunta real se afila hasta esto: ¿qué haría falta para que el runtime le entregue a tu programa una vista tipada de la cuenta sin ningún paso de decode en medio? Y la respuesta fuerza una restricción sobre tu struct, que es todo el resto de este módulo.
Un cast de bytes crudos a una referencia tipada solo es sólido si toda disposición posible de esos bytes es un valor válido del tipo. Esa propiedad tiene un nombre: Pod, corto para "plain old data": datos planos de layout fijo. Un tipo es Pod cuando cualquier patrón de bits del largo correcto es una instancia legal de él, sin estados inválidos y sin huecos sin inicializar.
bytemuck es el crate que codifica esta regla en el sistema de tipos. (bytemuck es una librería diminuta y auditada para reinterpretar bytes como valores tipados y de vuelta; V2 la trae para que el compilador, no tú, verifique que el cast es sólido.) Su trait Pod es el criterio. bytemuck::from_bytes::<Cabinet>(&data[8..]) compila solo si Cabinet: Pod, y Cabinet: Pod se cumple solo si cada campo es Pod a su vez y el struct no tiene relleno.
Mira dónde muerde eso. Un u64 es Pod: los 2^64 patrones de bits son valores u64 válidos. Un bool no. Un bool ocupa un byte pero solo dos de sus 256 patrones están definidos, 0 y 1; los otros 254 son comportamiento indefinido si los tratas como un bool. Así que bytemuck rechaza bool de plano. El arreglo es PodBool, un wrapper de un byte cuyos patrones son todos valores definidos. Misma historia para los enums, Option, cualquier cosa con estados inválidos.
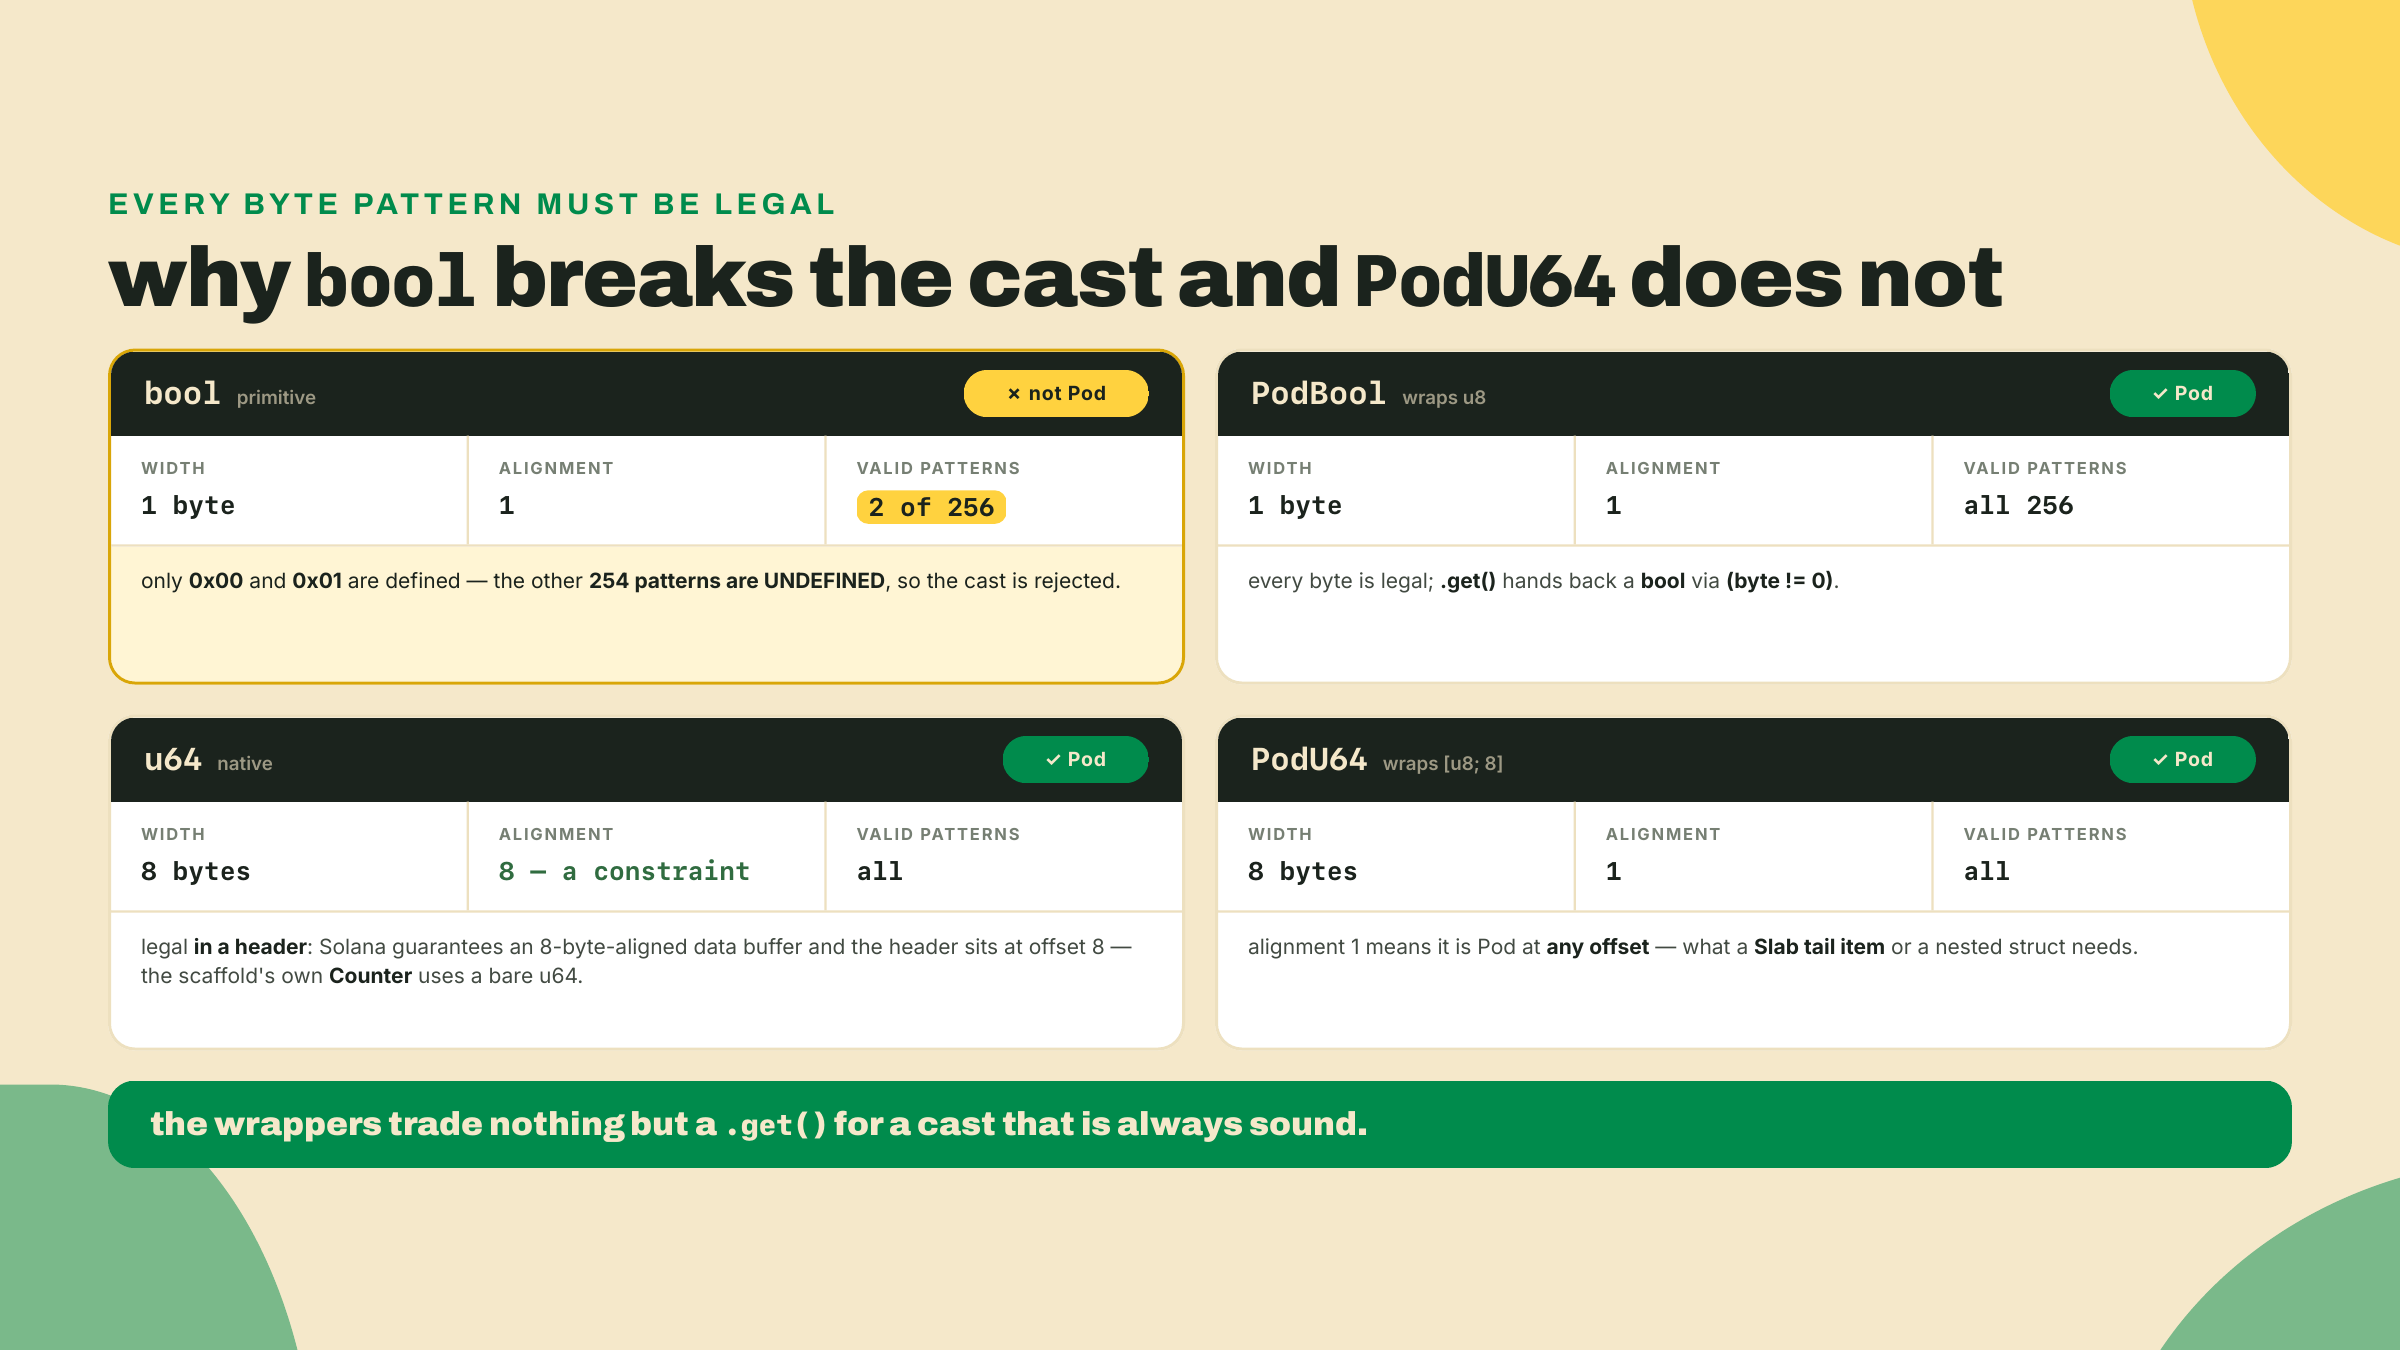
Esa nota sobre alineación en la tarjeta es la mitad sutil, y vale la pena ser preciso al respecto en vez de repetir el folclore. Un u64 nativo exige una dirección alineada a 8 bytes, y en un header la consigue: Solana garantiza que el buffer de datos de la cuenta está alineado a 8 bytes, y V2 coloca el header inmediatamente después del discriminador de 8 bytes, así que data[8..] también está alineado a 8. El framework afirma exactamente esto en tiempo de compilación, y rechaza cualquier header cuya alineación exceda la garantía de 8 bytes de Solana. Por eso la propia cuenta Counter generada por el scaffold se sale con la suya con un pub count: u64 desnudo, y la tuya también podría.
¿Entonces para qué los wrappers? Porque esa garantía se detiene en el header. PodU64 envuelve [u8; 8], que tiene alineación 1, así que el cast es sólido sin importar dónde en la cuenta caiga el campo, que es lo que necesitas en el momento en que un valor se sienta en una lista final, en un offset que el compilador no puede prealinear, o anidado dentro de otro struct Pod. Los campos con alineación 1 también vuelven imposible introducir relleno por accidente, y son la única manera de cargar un tipo de 16 bytes como i128, cuya alineación natural es más estricta que los 8 bytes que Solana promete. Guarda el número como bytes little-endian y lo devuelve a través de .get(); escribes uno convirtiendo desde el tipo nativo, PodU64::from(v) (no hay .set()). Este es el mismo truco que el código Solana de bajo nivel ha usado por años, y V2 le da un nombre y un tipo en el prelude. La señal de que esto es sobre layout y no sobre prohibir escalares nativos: PodU8 y PodI8 son literalmente alias de tipo para u8 e i8, porque un campo de un byte nunca tuvo un problema de alineación que resolver. Usamos los wrappers a lo largo de todo este módulo porque la lección que viene justo después pone estos campos en una lista final, donde dejan de ser opcionales.
Ahora el mecanismo, dicho con exactitud. En V2, Account<T> se define como Slab<T, HeaderOnly>. Un Slab es una vista tipada sobre el buffer de bytes crudos de una cuenta. El parámetro HeaderOnly dice que el header de tamaño fijo es T y que no hay región dinámica final. Leer account.play_count no deserializa nada; calcula un offset dentro del buffer y lee los bytes de ahí como un PodU64. Escribirlo escribe esos bytes. No hay copia en el stack, no hay encode a la salida, no hay lifetime <'info> que monte sobre el wrapper hasta dentro de la definición de tu struct como AccountLoader obligaba antes.
La palabra "vista" es estructural. Una vista no posee nada. Apunta a los bytes de la cuenta y los interpreta. Por eso el paso de salida en la comparación de arriba era un no-op: no hay una segunda copia que escribir de vuelta, porque estuviste editando el buffer real todo el tiempo.
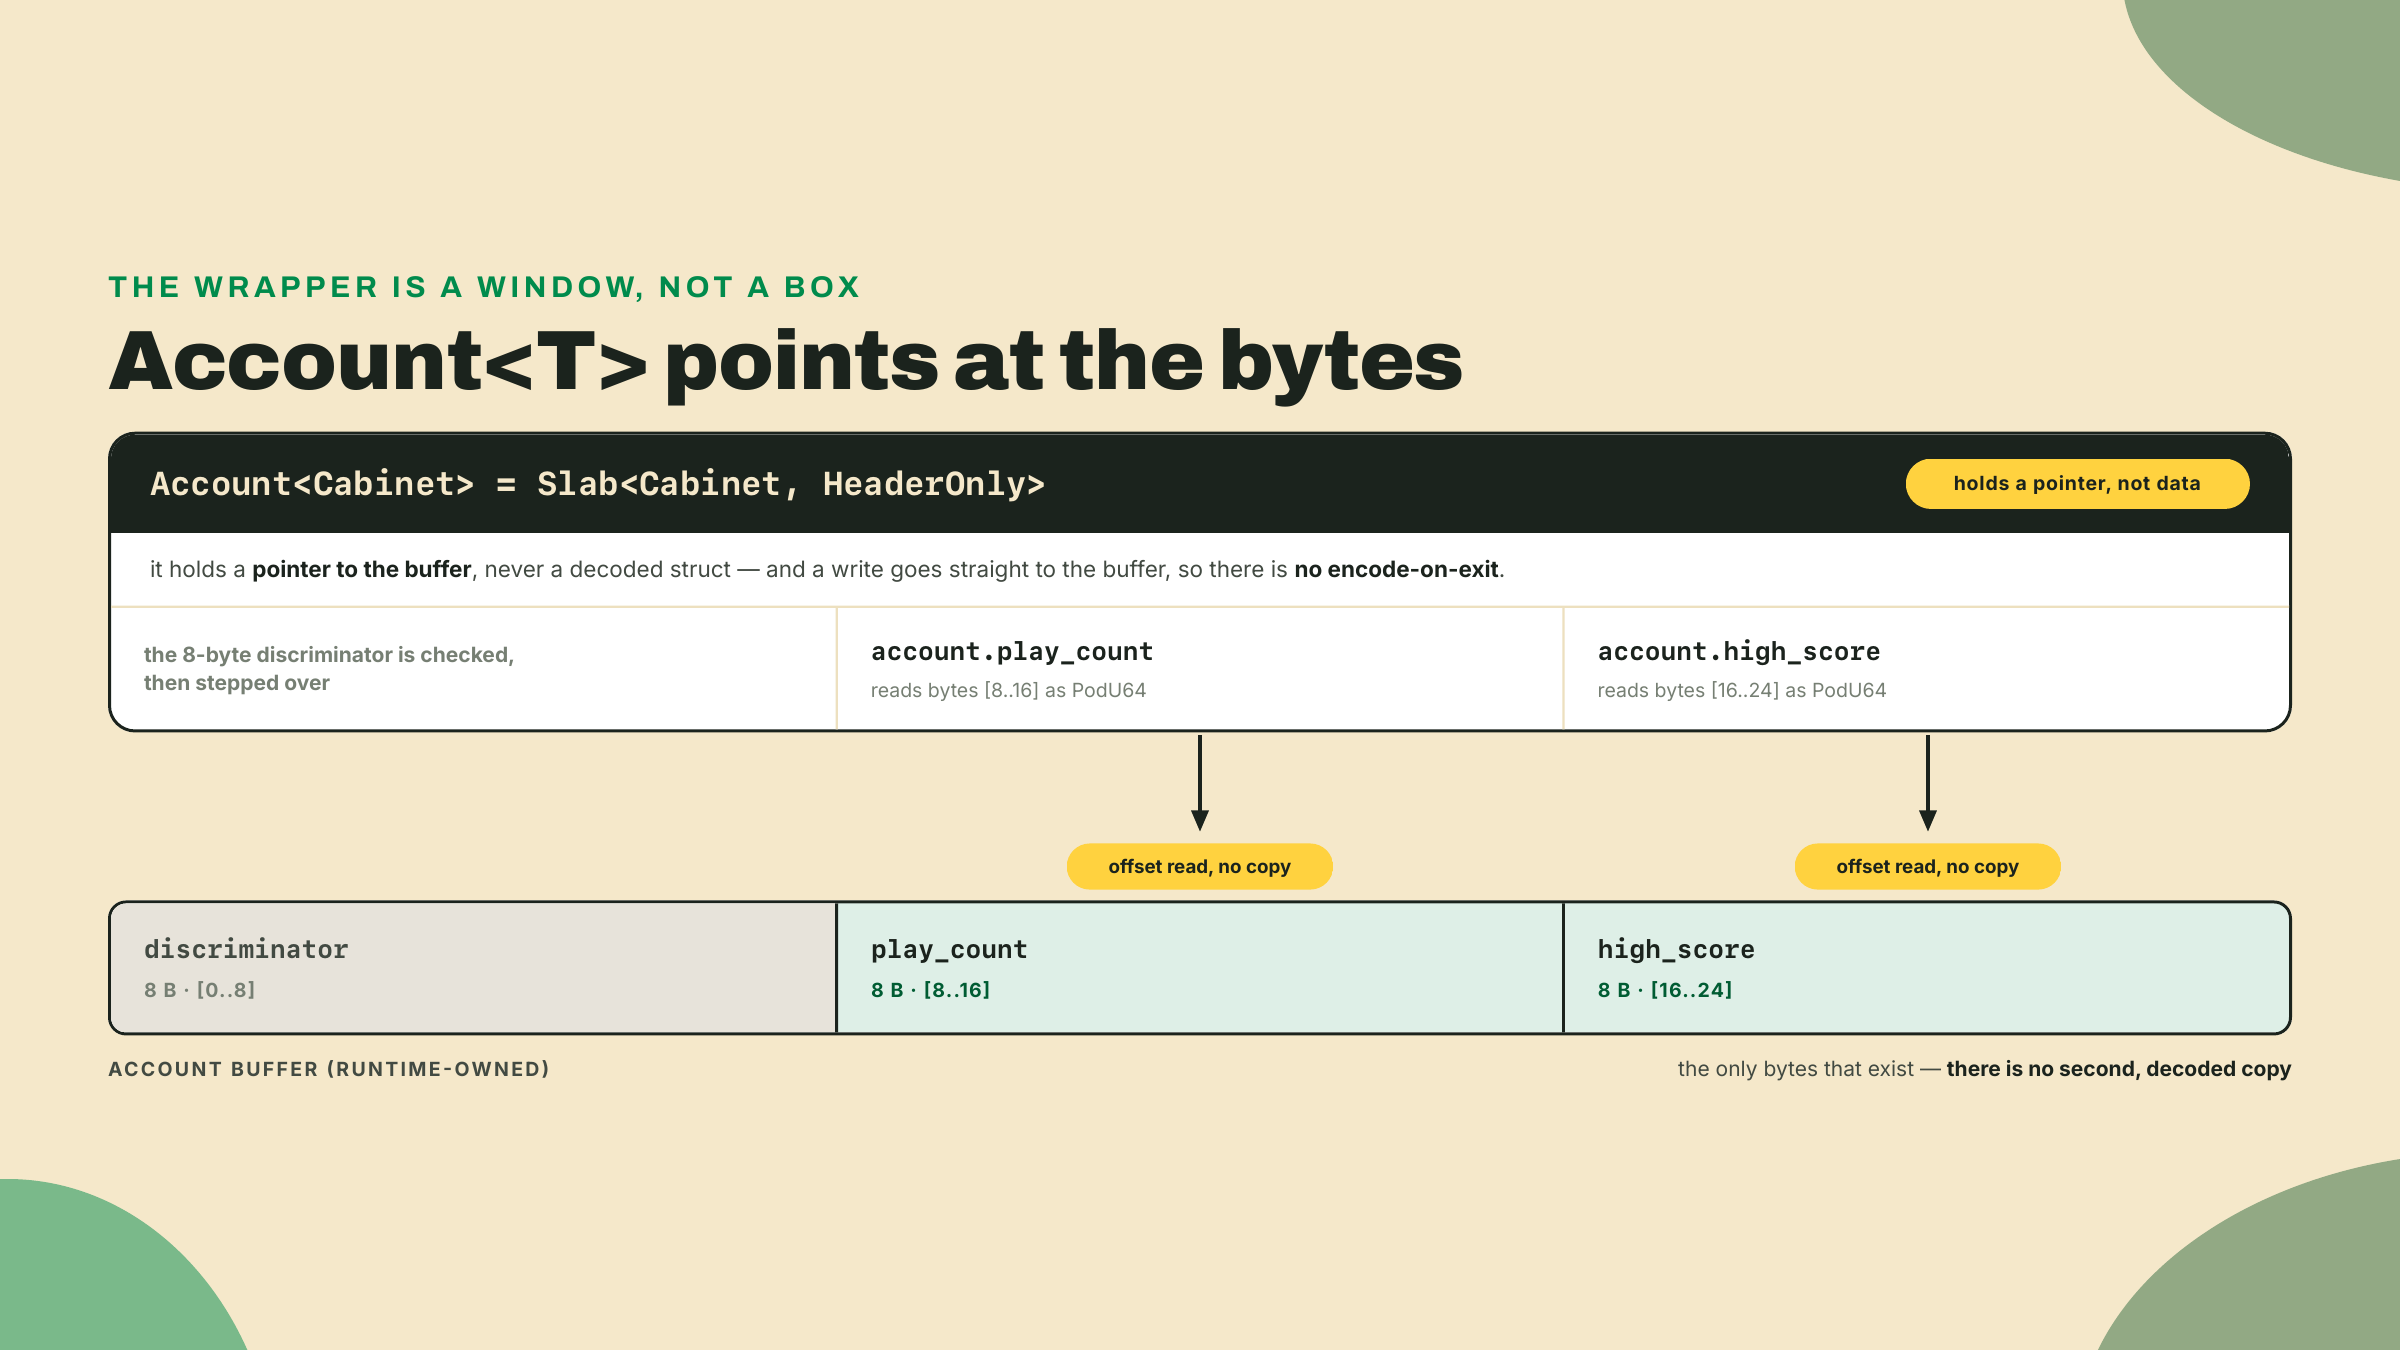
Una cosa que V2 no cambió: el discriminador de 8 bytes. Sigue siendo la etiqueta derivada de sha256 de m01-l4, sigue ocupando los primeros ocho bytes de la cuenta, sigue siendo cómo el runtime distingue un Cabinet de un Vault. El cuerpo Pod empieza inmediatamente después. Por eso HeaderOnly describe T solo y tus pruebas hacen el cast desde data[8..], nunca desde data[..].
Este es, sin duda, el error más común del primer día, así que déjame nombrar el síntoma antes de que te topes con él. Si tu prueba lee account.data y todos los campos se ven corridos ocho bytes respecto de lo que escribiste, hiciste el cast desde el offset cero y leíste el discriminador como tu primer campo. El arreglo es un solo slice: &data[8..]. Nada se corrompió, solo leíste desde el comienzo equivocado.
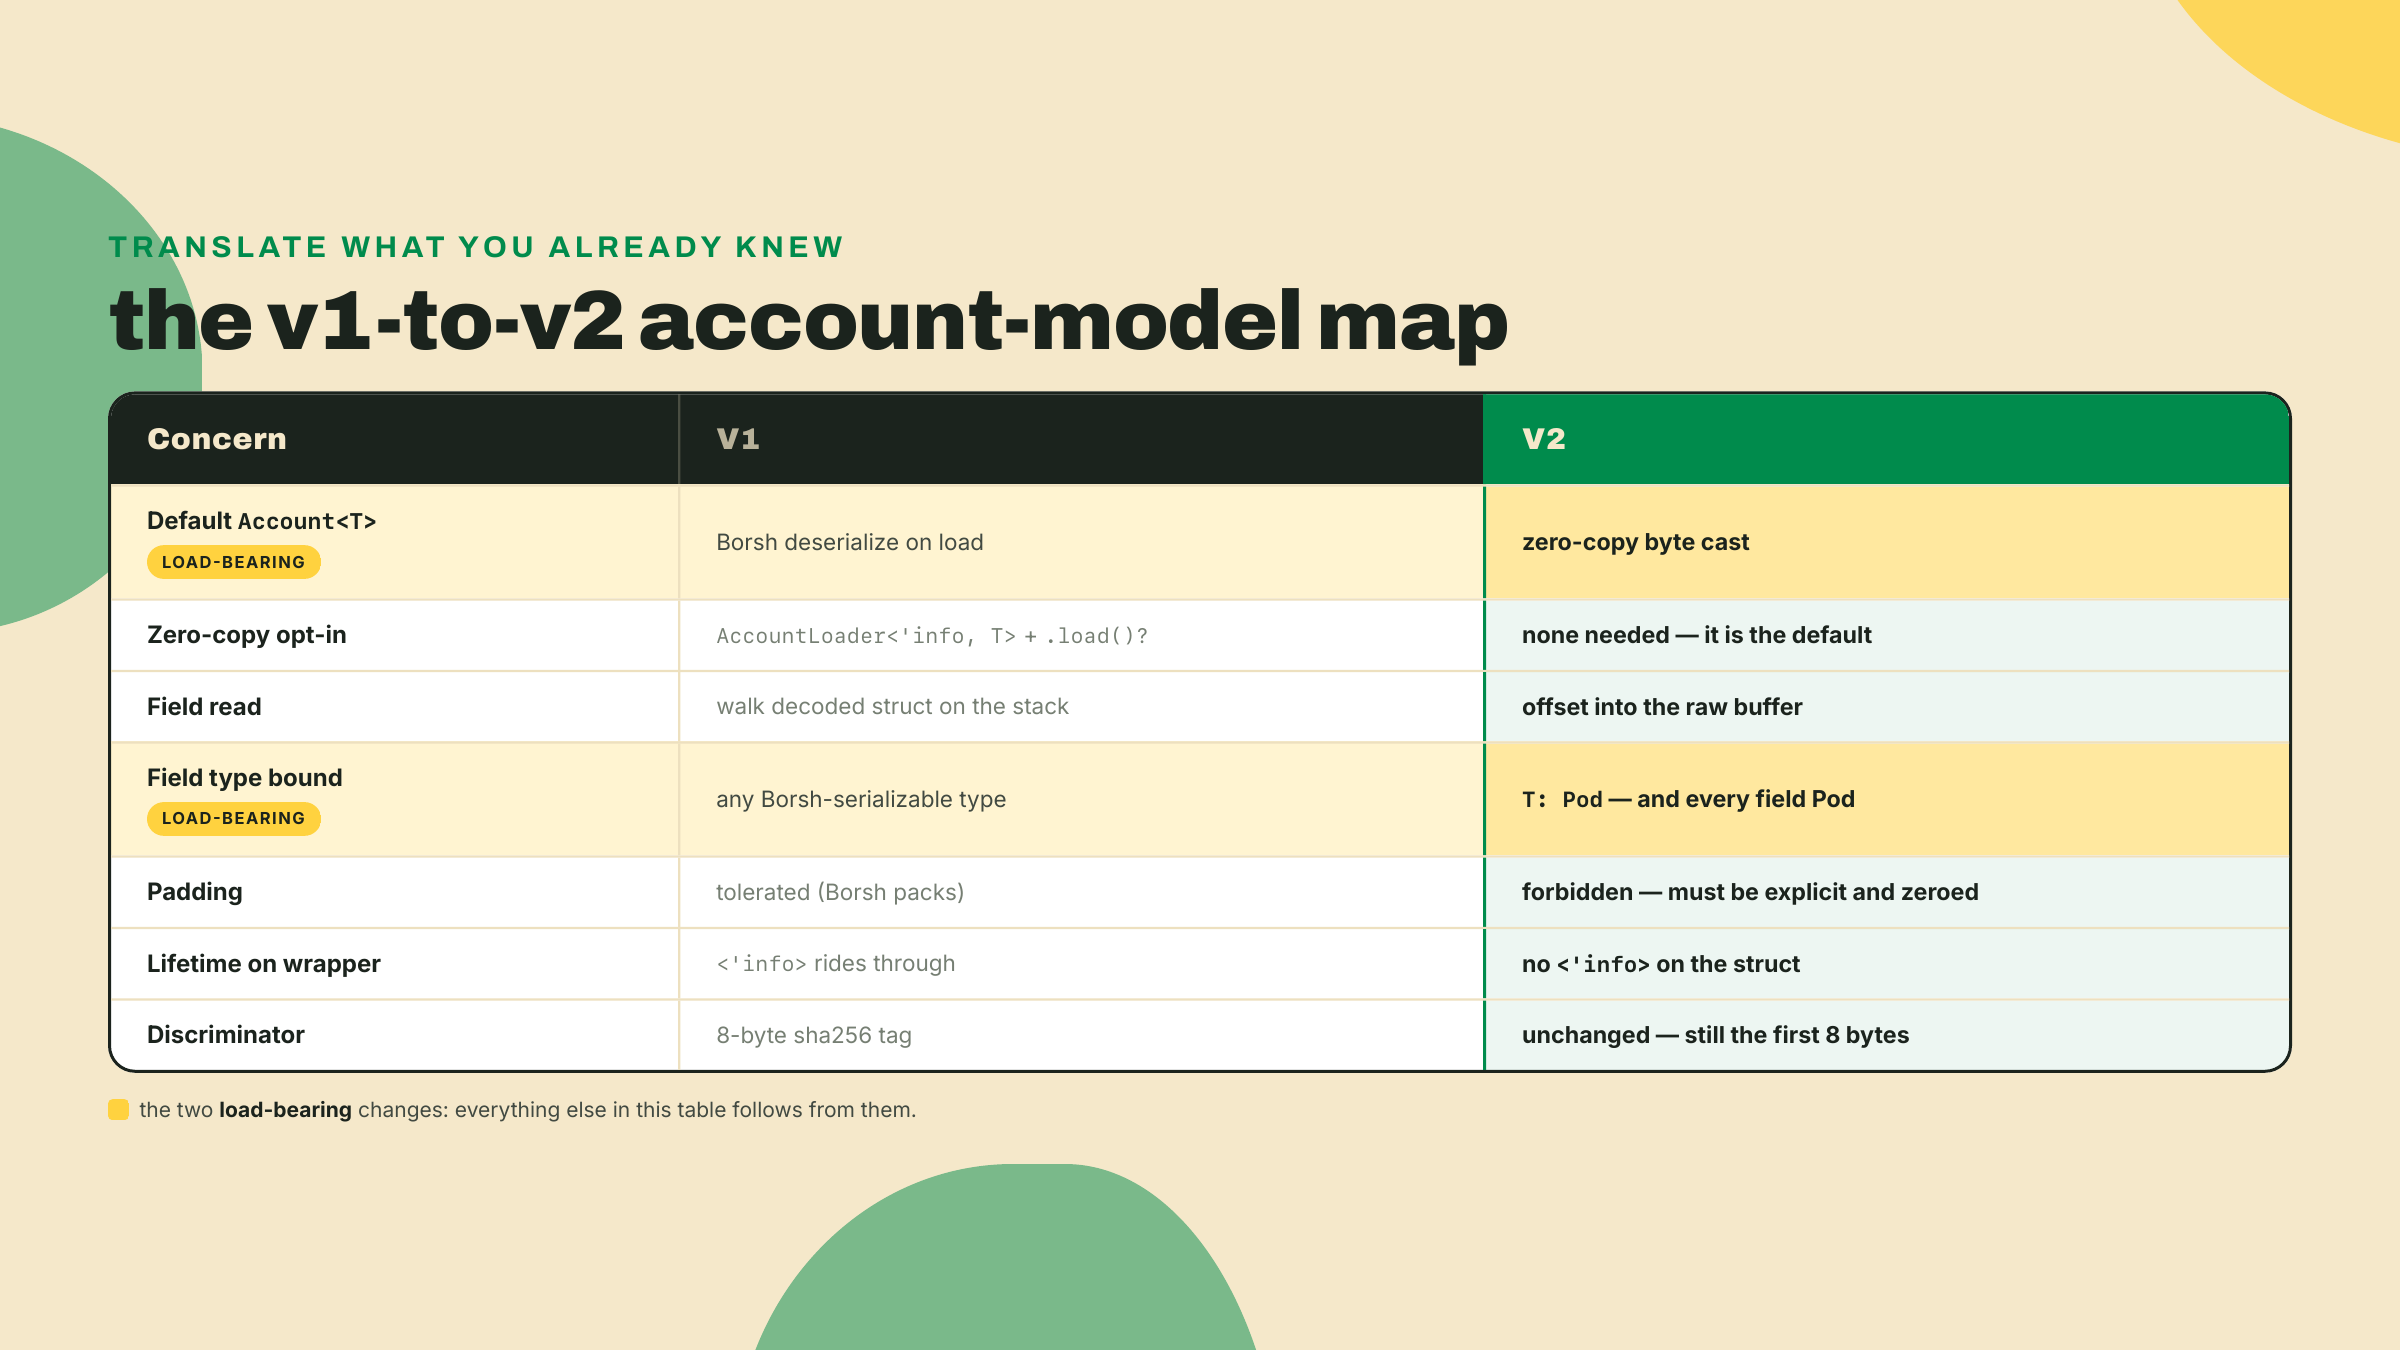
Si escribiste código zero-copy en V1, lo hiciste con AccountLoader<'info, T>: un wrapper explícito y exótico al que recurrías solo cuando un struct era demasiado grande o demasiado caliente para deserializar. Llamabas .load()? y .load_mut()? y andabas cargando el lifetime <'info> a todas partes. Todos los demás usaban Account<'info, T> a secas y se comían el costo de Borsh.
V2 invierte el valor por defecto. Lo que era el caso exótico de AccountLoader es ahora lo que Account<T> hace de fábrica, y el lifetime <'info> ya no monta sobre el wrapper hasta dentro de tu struct. No optas por entrar a zero-copy; optas por salir de él, en el caso raro en que de verdad necesites datos de forma libre que ningún cast puede describir — la escotilla de escape de borsh con la que cierra este módulo. (Una cola acotada no es optar por salir: el Slab que atornillas la lección que viene sigue siendo zero-copy.) La lección general que vale la pena extraer aquí, porque se repite a lo largo de V2, es que el framework movió el costo de tiempo de ejecución a tiempo de compilación. El valor por defecto viejo era permisivo al escribir y caro al ejecutar. El valor por defecto nuevo es estricto al escribir y gratis al ejecutar. Cada lugar en que V2 se siente más exigente de escribir es un lugar donde dejó de cobrarte cuando el programa corre.
Si ya has entregado programas de Solana antes, se te tienen que estar formando tres dudas, y vale la pena contestarlas una por una, porque cada una marca un borde real del diseño.
La primera: ¿mutar el buffer en el lugar no es peligroso? En V1 editabas una copia en el stack, y Anchor la escribía de vuelta solo si el handler retornaba limpio, lo que te daba una especie de transaccionalidad accidental. En V2 escribes los bytes vivos de la cuenta a medida que avanzas. La respuesta es que el runtime de Solana ya te da la garantía de verdad: una instrucción que retorna un error revierte todos los cambios de cuentas de toda la transacción, ediciones del buffer incluidas. La copia en el stack nunca fue lo que te protegía. El runtime sí. Así que escribir en el lugar es exactamente igual de seguro, y una copia menos.
La segunda: ¿y las cuentas que necesitan crecer, un vector que se hace más largo con el tiempo? Ese es el límite honesto de HeaderOnly. Un cuerpo Pod puro es de tamaño fijo por definición, porque un cast necesita conocer los offsets de los campos por adelantado, y un Vec no tiene offset fijo. La respuesta de V2 no es "no puedes tener datos variables," es "los datos variables viven en una región final declarada, no de contrabando dentro del header Pod." Esa región final es una lección posterior. Por hoy, el tamaño fijo es el punto, y es la mayor parte de lo que el estado de una cuenta realmente es.
La tercera: ¿esto rompe a los clientes que leen la cuenta con Borsh? No siempre, y el greeter es el contraejemplo honesto: Borsh codifica un u64 como ocho bytes little-endian, y PodU64 guarda ocho bytes little-endian, así que para un header de enteros simples los dos layouts coinciden y un cliente viejo que corre Greeter.deserialize sigue leyendo el conteo correcto. La ruptura viene de todo lo que Borsh podía expresar y un header Pod no: un Vec con su prefijo de largo, un Option con su byte de etiqueta, un String. Migrar un struct así a V2 quiere decir reestructurarlo — las partes dinámicas se mudan a una región final declarada — y esa reestructuración es lo que le mueve los bytes por debajo a un cliente que sigue decodificando la forma vieja. Así que la regla del cliente es absoluta incluso cuando los bytes coinciden hoy por casualidad: lee de la misma manera en que el programa escribe — haz el cast de los bytes en offsets conocidos, no corras el decoder viejo y esperes que funcione. Ese es un costo de migración real, y pretender lo contrario sería deshonesto. Es también el mismo costo que todo el ecosistema está pagando una sola vez, que es la razón por la que el framework lo hizo el valor por defecto en vez de un opt-in que fragmenta la historia del cliente para siempre.
El zero-copy borra el costo de serialización y te deja mutar campos en el lugar. Esa es la ganancia, y no es chica. Pero heredas la disciplina de layout de C como precio, y esta es la parte honesta de la que el resto del módulo realmente trata.
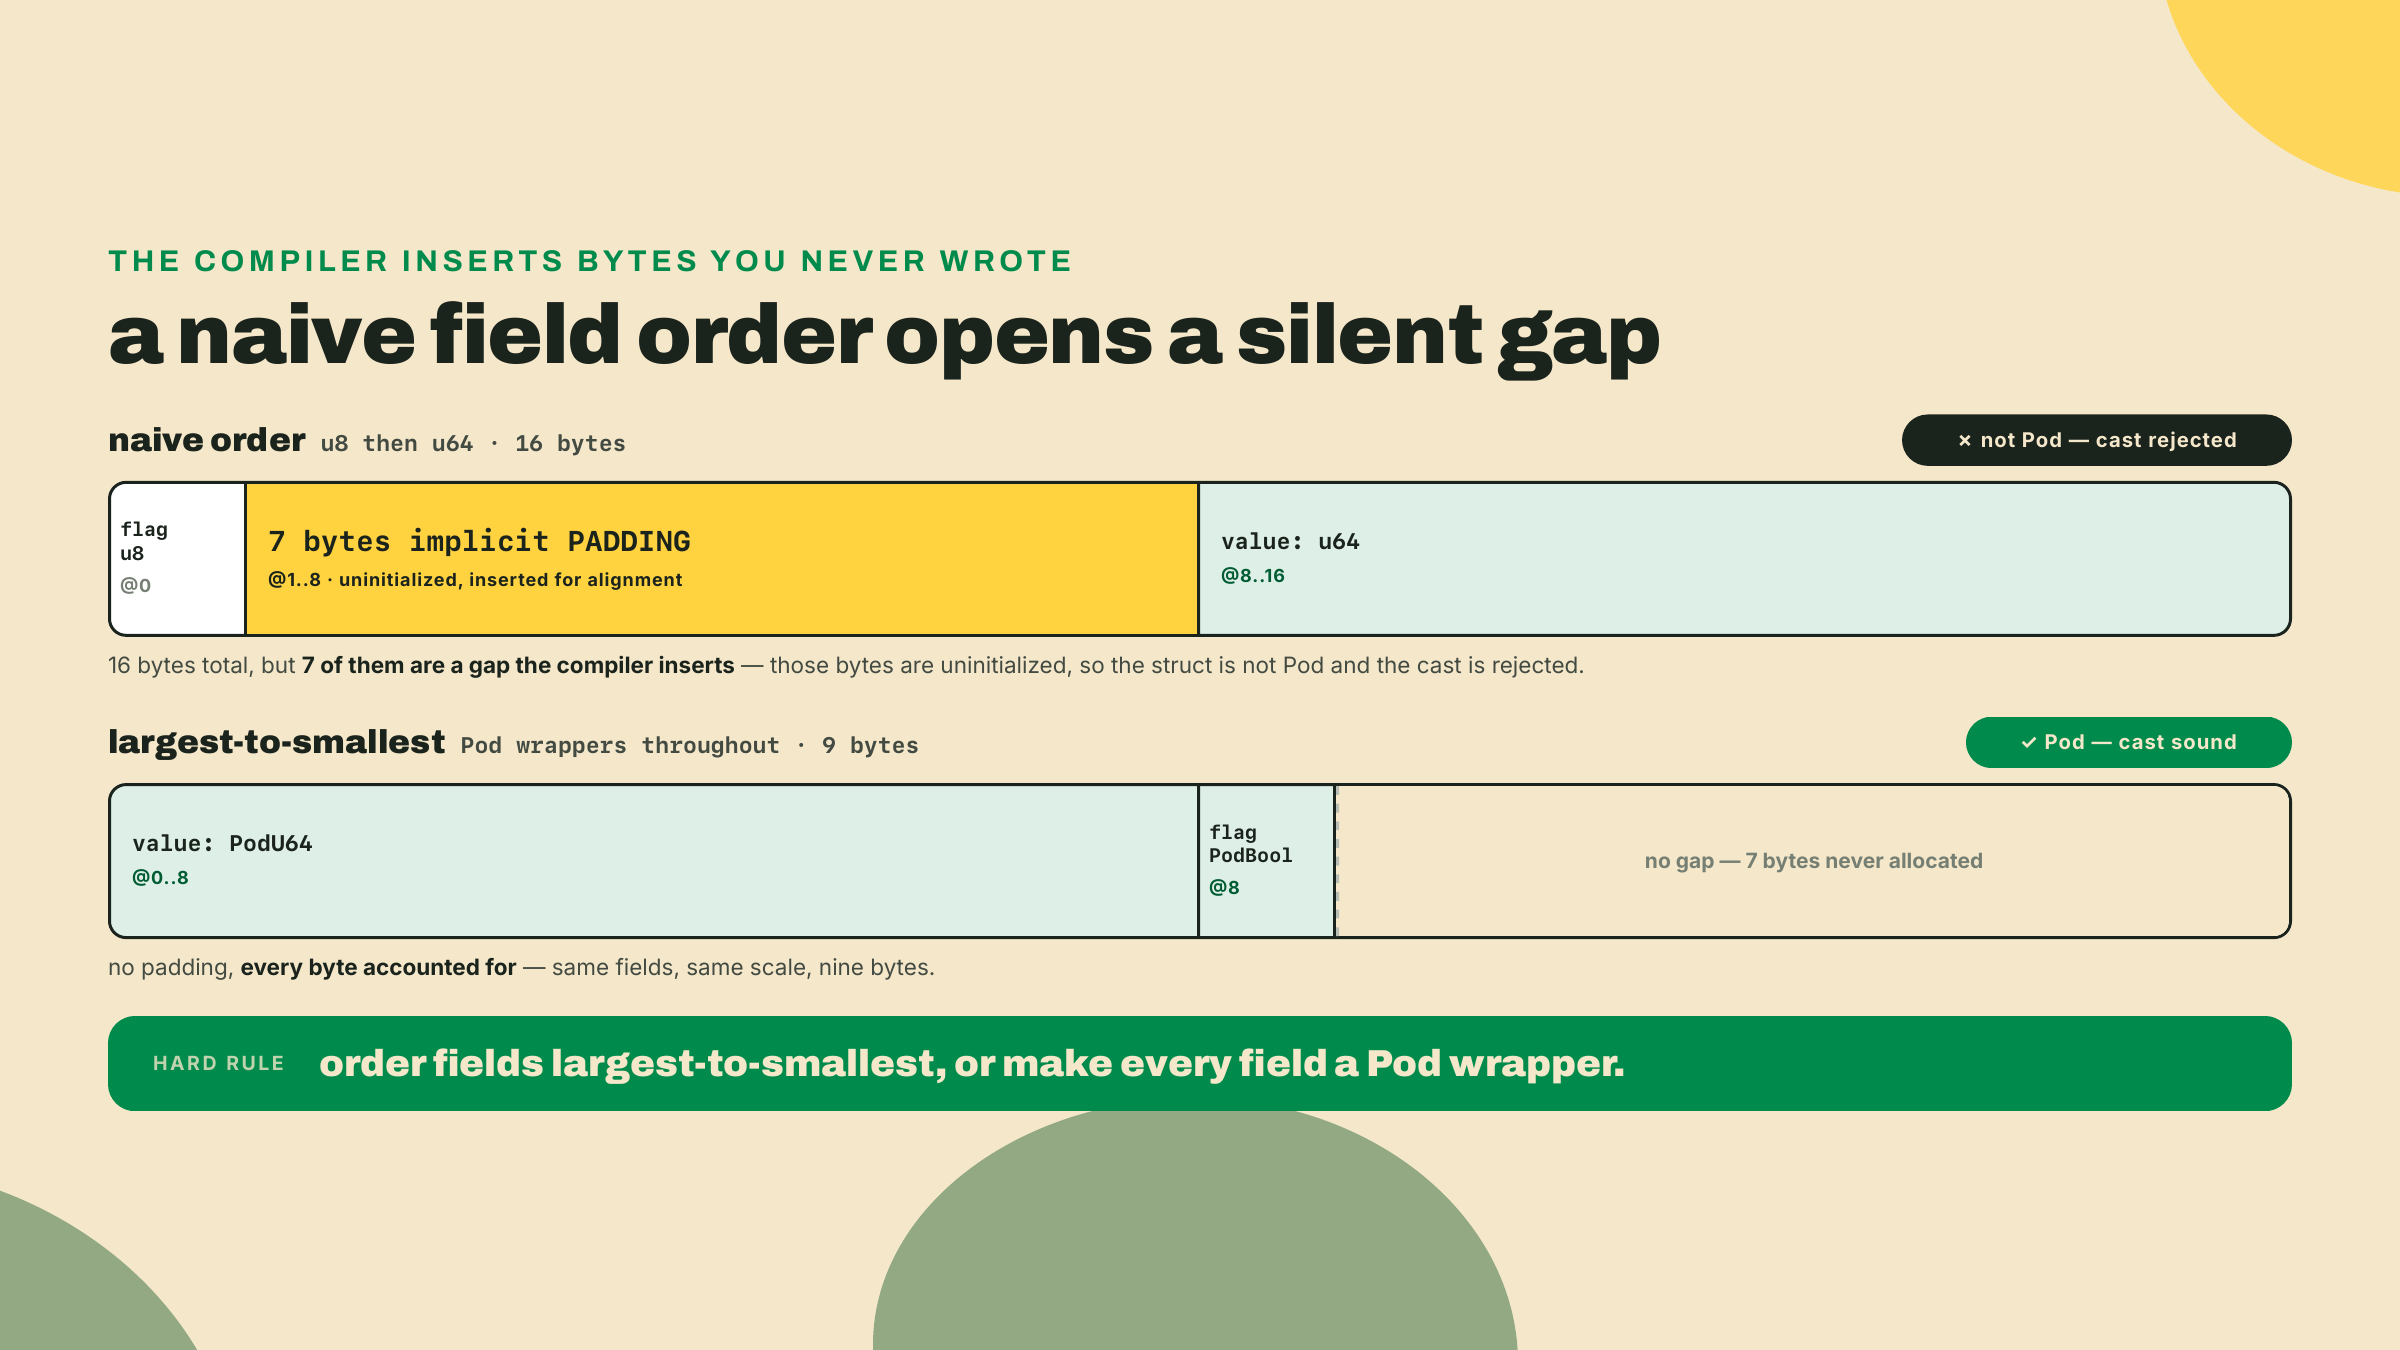
Todo campo tiene que ser Pod, así que un bool desnudo o un Option ingenuo no compilan. El relleno está prohibido, así que ordenas los campos de mayor a menor y el compilador afirma que no hay huecos implícitos entre ellos. La alineación pasa a ser tu problema, que es la razón por la que existen los wrappers Pod. Un orden de campos en el que un desarrollador de Rust normal nunca piensa, campo chico antes de campo grande, puede abrir en silencio un byte de relleno que rompe el cast. En V2 no se rompe en silencio: falla al compilar, que es la versión buena de esa falla. La velocidad se paga en rigor de layout. Estás cambiando "el compilador me deja escribir cualquier struct y pago en tiempo de ejecución" por "el compilador me obliga a escribir un struct legal y no pago nada en tiempo de ejecución."
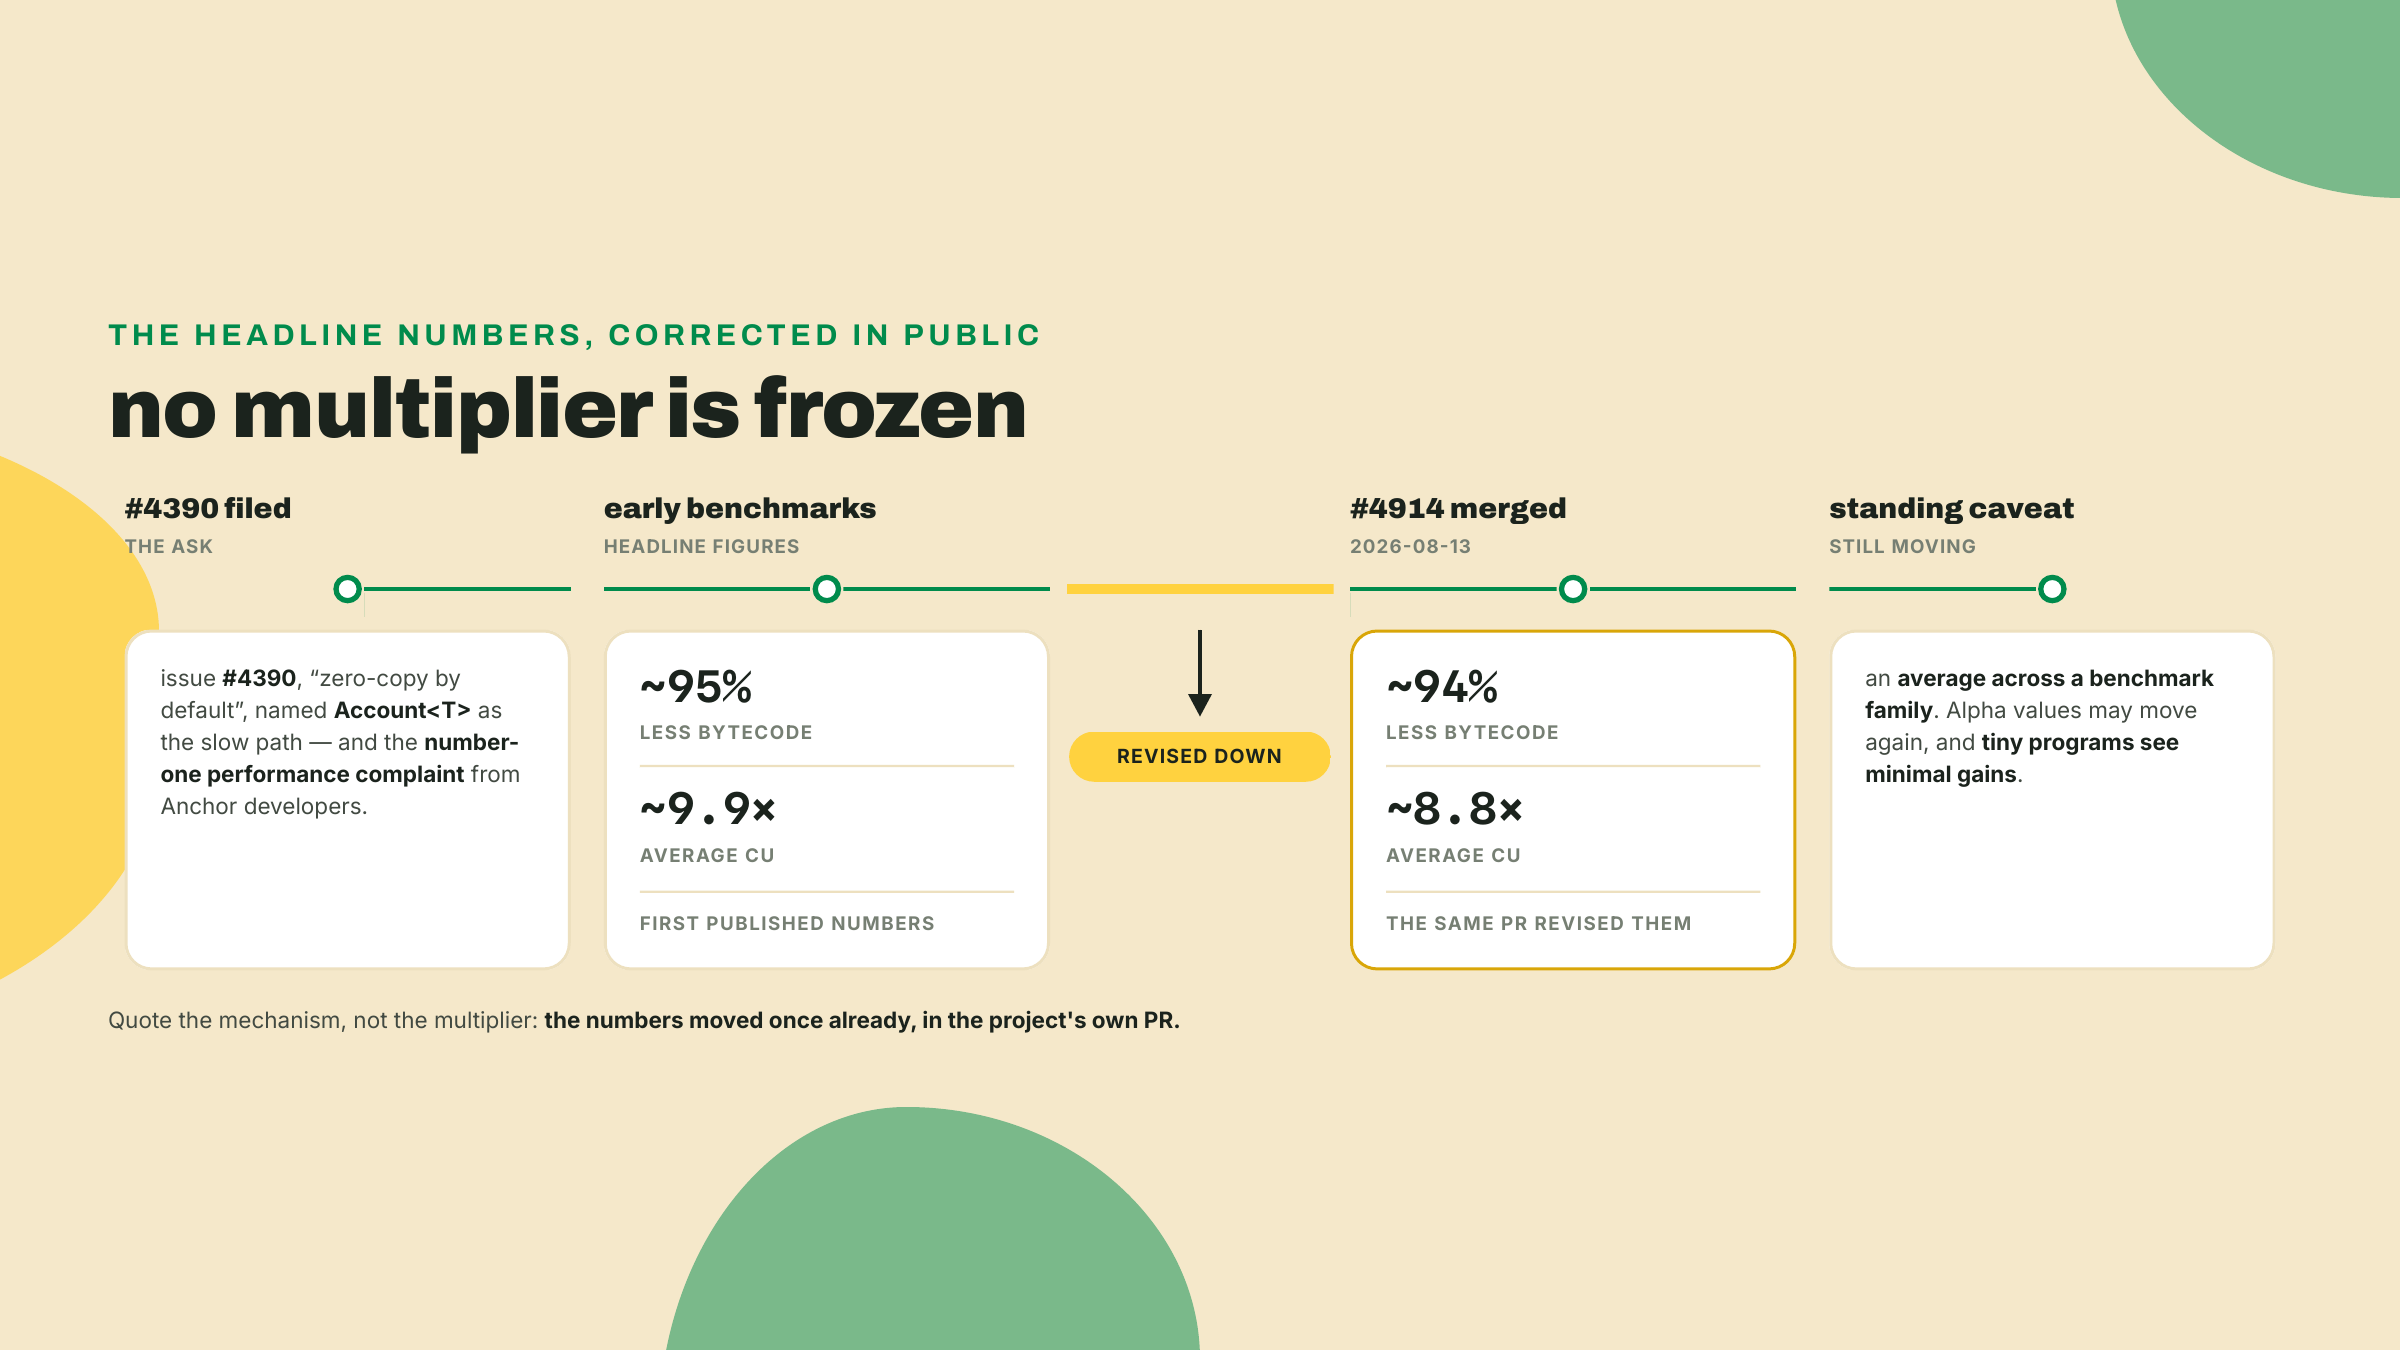
Vas a escuchar un número pegado a V2, y quiero que lo lleves correctamente, porque es un ejemplo vivo de cómo este curso trata toda cifra en movimiento. Los benchmarks de V2 reportan alrededor de 8.8x de reducción promedio de CU y cerca de 94% menos de bytecode desplegado. Cita esos valores como aproximados y en movimiento, nunca como una garantía por programa.
Por qué la cautela. El PR #4914, mergeado el 2026-08-13, revisó los números de titular hacia abajo: de 95% a 94% menos de bytecode, de 9.9x a 8.8x de CU promedio. Eso es algo raro de ver en público, un proyecto corrigiendo su propia cifra de marketing hacia abajo, y es exactamente por lo que este curso nunca congela un multiplicador. El 8.8x es un promedio sobre una familia de benchmarks, y la propia página del benchmark advierte que los valores alpha pueden moverse cuando cambia el codegen. Los programas chicos ven el menor beneficio. Tu cabinet-counter desnudo, dos campos u64, va a mostrar casi nada, porque de entrada apenas había costo de deserialización que borrar. Las ganancias aparecen cuando el struct es grande y caliente. Así que cuando un compañero de equipo dice que V2 hizo su contador diminuto 8.8x más barato, el replanteo honesto es: ese es el promedio aproximado del proyecto, ya revisado hacia abajo una vez y con la expectativa de que siga moviéndose, y un contador de dos campos es el peor caso para él.
Hora de construir R1. Aquí está el repliegue, dicho en voz alta para que sepas qué es tuyo: yo te entrego el struct Pod y el handler init completos, y muestro el cast de bytes una vez en la prueba. Tú llenas el handler increment y la aserción de LiteSVM que lee data[8..] de vuelta. El Challenge después de esto es completamente tuyo, sin apoyo.
Ya confirmaste en la apertura que PATH está sirviendo la RC. Si no lo estaba, o si la RC falta por completo, reinstala desde el canal git documentado ahora, porque avm install baja un binario precompilado desde el GitHub Release del tag y no se cortó ningún Release para el tag v2, así que la descarga da 404 y el build de git es la ruta autorizada:
# freshness note: as of 2026-08-22 the RC is 2.0.0-rc.1, tag v2.0.0-rc.1 on the
# anchor-next branch of the otter-sec fork (commit e4878b6d). m01-l2 installed from
# the branch because the channel was its subject; from here on the course pins the
# tag, because a branch tip moves and a tag does not. Re-verify before you rely on it.
# macOS, if the build trips on LTO: prefix that line with CARGO_PROFILE_RELEASE_LTO=off
cargo install --git https://github.com/otter-sec/anchor.git \
  --tag v2.0.0-rc.1 anchor-cli --locked --force
No verifiques contenido de V2 en el toolchain 1.1.2; el modelo de cuentas es distinto y el código de abajo no se va a comportar igual.
Paso 1. Confirma las dependencias. Tu programs/cabinet-counter/Cargo.toml necesita anchor-lang en la línea de V2, bytemuck, y los pins de wincode/solana-address de m01-l2 — volviste a agregar las cuatro filas en la apertura, porque este es un scaffold recién hecho y saltarse los pins mata el primer build en la expansión de #[program]. Ahora es cuando cada fila se gana su explicación. El scaffold había escrito anchor-lang como una fila git que seguía la branch anchor-next; la editaste a la versión de crates.io, exactamente como hizo m01-l2, porque esa es la única fuente que resuelve contra los dos pins que están debajo. Uno de esos dos pins cambió de forma aquí, y la razón vale una frase ahora en vez de una sorpresa en el módulo 6: el greeter era un workspace desechable de uno solo, pero este crate es el primer peldaño del arcade, y termina compartiendo un workspace con los otros cuatro — R2 arranca ese workspace en m03-l1, R3 y R4 reciben su scaffold directo dentro de él, y m09-l3 mueve este crate al lado de ellos. Un workspace resuelve un solo solana-address para todos sus miembros, así que la fila tiene que ser un techo con el que todos los miembros puedan estar de acuerdo en vez de una igualdad con la que solo uno pueda. La freshness note que importa aquí es bytemuck, actualmente 1.25.2 (publicado 2026-07-19). Cualquier 1.x funciona.
[dependencies]
# crates.io, not the git branch: a published version is immutable, and the branch
# tip now wants solana-address 2.7.0, which will not resolve against the pin below.
anchor-lang = "2.0.0-rc.1"
# The pins from m01-l2 — every program crate in this course carries them (issue #4937's class).
wincode = { version = "0.5", features = ["derive"] }
# A ceiling, not an equality. 2.7.0 is the version that moved to wincode 0.6; 2.6.1 is
# still on 0.5. Every crate in the arcade workspace carries this exact row, because the
# workspace resolves one solana-address for all of them and module 6 adds a Mollusk
# dev-dependency whose SVM stack reaches ^2.6.1. `=2.6.0` in any member refuses it.
solana-address = ">=2.6.1, <2.7"
bytemuck = "1.25"          # you added this in the opener

[dev-dependencies]
# The test harness. This wraps LiteSVM and re-exports what the test file needs,
# so you never depend on `litesvm` by name. The scaffold writes it tracking the
# `anchor-next` branch; repoint it at the tag so the litesvm it carries cannot
# move under you. Add the row outright if your scaffold predates it.
anchor-v2-testing = { git = "https://github.com/otter-sec/anchor.git", tag = "v2.0.0-rc.1" }
Paso 2. Escribe el estado y las cuentas. Esta es la parte que te doy entera. Pégala en src/lib.rs, reemplazando el struct Counter generado y su handler initialize, e incorporando el Cabinet que agregaste en la apertura; el scaffold ya cumplió su propósito. Una línea que no pegas: conserva el declare_id! que anchor init ya escribió. Coincide con el keypair que está en target/deploy/, y sobrescribirlo con una cadena escrita a mano te da un id para el que el deploy no puede firmar. Si en algún momento llegas a perder la coincidencia, anchor keys sync reescribe declare_id! y Anchor.toml a partir del keypair. Resultado esperado después de este paso: anchor build compila, con el handler increment todavía como stub. PodU64 viene del prelude de V2; es el wrapper de array de bytes con alineación 1 que derivamos arriba, leído a través de .get() y escrito asignando un PodU64::from(value).
use anchor_lang::prelude::*;

// Leave the id anchor init generated for you here; do not paste one in.
declare_id!("<your generated program id>");

#[program]
pub mod cabinet_counter {
    use super::*;

    pub fn init(ctx: &mut Context<Init>) -> Result<()> {
        let cabinet = &mut ctx.accounts.cabinet;
        cabinet.play_count = PodU64::from(0);
        cabinet.high_score = PodU64::from(0);
        Ok(())
    }

    // Step 3 is yours: fill this in.
    pub fn increment(ctx: &mut Context<Increment>, score: u64) -> Result<()> {
        // TODO
        Ok(())
    }
}

#[account]
#[repr(C)]
pub struct Cabinet {
    pub play_count: PodU64, // bytes 8..16 of the account
    pub high_score: PodU64, // bytes 16..24 of the account
}

#[derive(Accounts)]
pub struct Init {
    #[account(
        init,
        payer = player,
        space = Cabinet::DISCRIMINATOR.len() + core::mem::size_of::<Cabinet>(),
        seeds = [b"cabinet", player.address().as_ref()],
        bump
    )]
    pub cabinet: Account<Cabinet>,
    #[account(mut)]
    pub player: Signer,
    pub system_program: Program<System>,
}

#[derive(Accounts)]
pub struct Increment {
    #[account(
        mut,
        seeds = [b"cabinet", player.address().as_ref()],
        bump
    )]
    pub cabinet: Account<Cabinet>,
    pub player: Signer,
}

#[error_code]
pub enum CabinetError {
    #[msg("play_count overflowed")]
    Overflow,
}
Dos líneas de ahí no son asunto de esta lección, y prefiero nombrarlas antes que dejarte con la duda. seeds = [b"cabinet", player.address().as_ref()] con un bump desnudo hace del cabinet una dirección derivada de programa, una por jugador, así que un jugador no puede pasarte el cabinet de otro. Copia esas dos líneas por ahora; el módulo 3 trata enteramente de lo que generan y de por qué el bump se guarda. Y player.address() es el accessor de V2 de m01-l3, el reemplazo on-chain de .key(), que devuelve una referencia a un Address en vez de a un Pubkey.
Dos cosas más para notar, porque son la lección en miniatura. El cálculo de space es Cabinet::DISCRIMINATOR.len() + core::mem::size_of::<Cabinet>(), que son 8 + 16 = 24 bytes: el discriminador más el cuerpo Pod exacto, sin constante mágica. Y #[account] sobre un struct de V2 deriva el bound Pod y afirma en tiempo de compilación que Cabinet no tiene relleno. Agrega un campo bool desnudo a Cabinet ahora mismo e intenta hacer el build; el compilador lo va a rechazar con un error de Pod, no con una sorpresa en tiempo de ejecución. Ese es el trade-off haciendo su trabajo.
Paso 3. Llena el handler increment. Esta es tu primera escritura real de un handler, así que escríbela antes de leer el bloque siguiente, y después compara. Tiene que subir play_count en uno con aritmética verificada, y levantar high_score solo si el nuevo score le gana al guardado. Lee a través de .get(); escribe asignando un wrapper nuevo, PodU64::from(value) (no hay .set(), y tampoco hay ::new(), la conversión es un impl de From). Fíjate en que el handler toma &mut Context<T> en V2, no Context<T>. Aquí está el mío, para después de que hayas escrito el tuyo:
pub fn increment(ctx: &mut Context<Increment>, score: u64) -> Result<()> {
    let cabinet = &mut ctx.accounts.cabinet;

    let plays = cabinet
        .play_count
        .get()
        .checked_add(1)
        .ok_or(CabinetError::Overflow)?;
    cabinet.play_count = PodU64::from(plays);

    if score > cabinet.high_score.get() {
        cabinet.high_score = PodU64::from(score);
    }

    Ok(())
}
El checked_add está ahí por una razón. play_count es un u64 que incrementas en cada jugada, y la regla de la casa para la aritmética de programas es verificar todo, así que un desbordamiento se vuelve un error limpio en vez de un reinicio silencioso a cero.
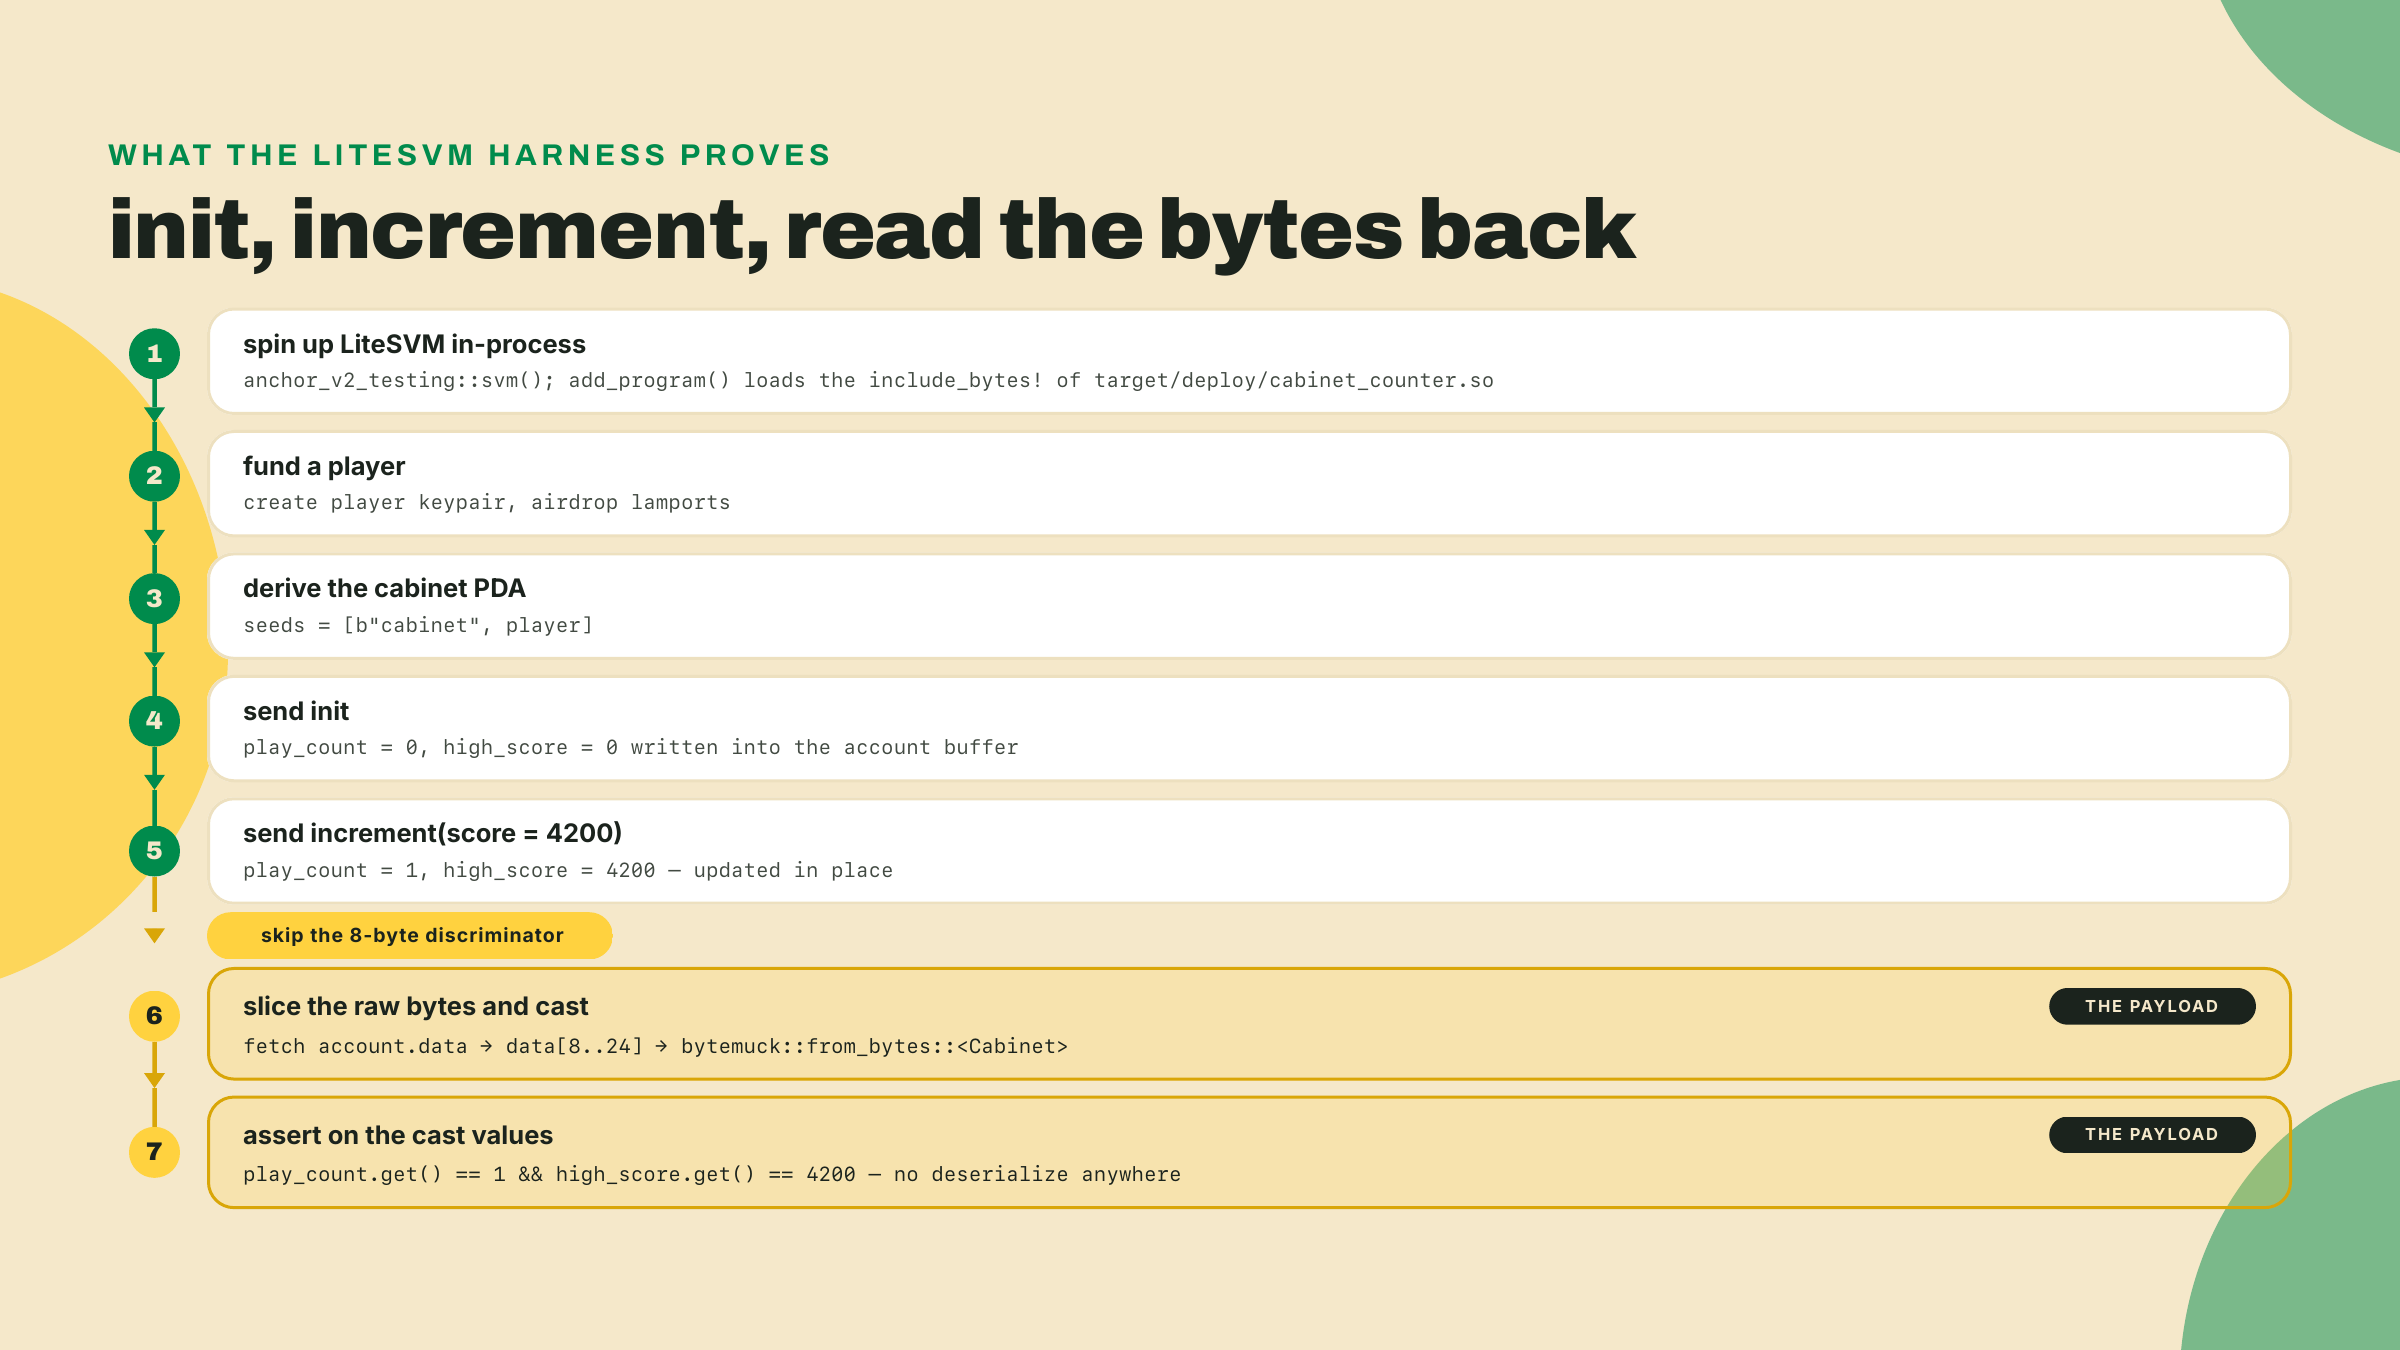
Paso 4. Lee los bytes de vuelta (tu aserción). La prueba vive al lado del crate del programa, en programs/cabinet-counter/tests/cabinet.rs, que es lo que hace que la ruta de include_bytes! de abajo resuelva; ponla en la raíz del workspace en cambio y esa ruta relativa se va caminando fuera del repo. Usa LiteSVM, la VM de Solana en proceso que se vuelve el criterio de aceptación para cada peldaño posterior de este curso. No traes litesvm directamente: la dev-dependency anchor-v2-testing del scaffold lo envuelve y reexporta las piezas que necesitas (Keypair, Signer, Message, VersionedTransaction), que es también cómo anchor test --profile llega a colgar tracing de las mismas pruebas más adelante. Yo te doy el apoyo del banco de pruebas; las tres líneas de assert de abajo son tuyas. Escríbelas a partir del diagrama de flujo de arriba antes de mirar las que están impresas más abajo: ¿cuánto tendría que ser play_count después de un increment, cuánto tendría que ser high_score, y cuántos bytes de largo tiene la cuenta entera?
use {
    anchor_lang::{
        bytemuck, programs::System, solana_program::instruction::Instruction, Id,
        InstructionData, ToAccountMetas,
    },
    anchor_lang::prelude::Address,
    anchor_v2_testing::{Keypair, Message, Signer, VersionedMessage, VersionedTransaction},
    cabinet_counter::{accounts, instruction, Cabinet},
};

fn send(
    svm: &mut anchor_v2_testing::LiteSVM,
    payer: &Keypair,
    ix: Instruction,
) {
    let blockhash = svm.latest_blockhash();
    let msg = Message::new_with_blockhash(&[ix], Some(&payer.pubkey()), &blockhash);
    let tx = VersionedTransaction::try_new(VersionedMessage::Legacy(msg), &[payer]).unwrap();
    svm.send_transaction(tx).unwrap();
}

#[test]
fn cabinet_round_trips() {
    let program_id = cabinet_counter::id();

    // `anchor_v2_testing::svm()` is LiteSVM::new(), plus the profiling
    // callback when the crate is built with --features profile.
    let mut svm = anchor_v2_testing::svm();
    let bytes = include_bytes!("../../../target/deploy/cabinet_counter.so");
    svm.add_program(program_id, bytes).unwrap();

    let player = Keypair::new();
    svm.airdrop(&player.pubkey(), 1_000_000_000).unwrap();

    let (cabinet, _bump) =
        Address::find_program_address(&[b"cabinet", player.pubkey().as_ref()], &program_id);

    // init: play_count = 0, high_score = 0
    let init_ix = Instruction::new_with_bytes(
        program_id,
        &instruction::Init {}.data(),
        accounts::Init {
            cabinet,
            player: player.pubkey(),
            system_program: System::id(),
        }
        .to_account_metas(None),
    );
    send(&mut svm, &player, init_ix);

    // increment with a score of 4200
    let inc_ix = Instruction::new_with_bytes(
        program_id,
        &instruction::Increment { score: 4200 }.data(),
        accounts::Increment {
            cabinet,
            player: player.pubkey(),
        }
        .to_account_metas(None),
    );
    send(&mut svm, &player, inc_ix);

    // read the raw bytes back, skipping the 8-byte discriminator.
    let raw = svm.get_account(&cabinet).unwrap().data;
    let state: &Cabinet = bytemuck::from_bytes(&raw[8..8 + core::mem::size_of::<Cabinet>()]);

    // The three assertions. Write yours first, then check against these.
    assert_eq!(state.play_count.get(), 1);
    assert_eq!(state.high_score.get(), 4200);
    assert_eq!(raw.len(), 24); // 8 discriminator + 16 body
}
Checkpoint. Corre anchor test. Tendrías que ver una prueba que pasa. Si en cambio las aserciones fallan porque los campos se ven corridos, revisa el slice: tiene que ser raw[8..24], más allá del discriminador, no raw[0..16]. Esa es la trampa de offsets de antes, y verla una vez en un assert que falla es la forma más rápida de no olvidarla nunca. Si el programa falla al compilar sobre el struct, tienes un campo no-Pod o un hueco de relleno; relee el orden de los campos.
Esa prueba verde es R1 terminado. Escribiste una cuenta Pod de dos campos, un init, un increment, y el primer banco de pruebas de LiteSVM en el curso, y viste los bytes exactos que escribiste salir de vuelta sin ningún paso de serialización en el camino.
Sin apoyo esta vez. Agrega un handler reset al programa y una segunda prueba que lo demuestre.
El comportamiento: reset pone play_count de vuelta en 0 y deja high_score intacto. Piénsalo como el operador del arcade limpiando el conteo de jugadas al arranque de un turno sin borrar el máximo histórico de la marquesina.
Tu barra de aceptación, las tres tienen que cumplirse:
reset compila y toma la misma cuenta Cabinet validada por PDA, mutable.reset, después lee data[8..] de vuelta y afirma que play_count == 0 y que high_score sigue siendo igual al score que fijaste.cabinet_round_trips existente sigue pasando.La parte interesante es la aserción, no el handler. Un reset que por accidente pone en cero los dos campos va a pasar una prueba perezosa que solo verifica play_count. Escribe la prueba que atraparía ese bug: afirma que el high score sobrevivió. Eso es lo que el ejercicio está poniendo a prueba. Tanto el handler como la prueba van en tu propio checkout de R1, al lado de lo que acabas de construir; una solución de referencia está junto a esta lección — reset-play-count/reset.rs para el handler y el struct de accounts, reset-play-count/cabinet_reset.rs para la prueba — para después de que tengas una corrida verde propia.
Momento de feedback. Antes de seguir, contesta esto en una frase, en voz alta o en un comentario arriba de tu archivo de prueba: ¿qué dos cosas prohíbe el bound T: Pod en tu struct? Si tu frase nombra los campos que no son Pod (el bool desnudo) y el relleno implícito (el hueco silencioso de un mal orden de campos), tienes el modelo. Si nombró solo una, vuelve a leer la sección del trade-off, porque la segunda es la que muerde en silencio.
Un contador por cabinet está bien, pero una máquina arcade de verdad mantiene una tabla de high scores, muchas filas en una sola cuenta, no un número. La lección que viene metemos una lista acotada dentro de una cuenta Pod y leemos cualquiera de sus filas como un cast de bytes, sin que borsh toque nunca los datos. HeaderOnly le da paso a una cola de verdad, PodU64 recoge una familia de hermanos para los campos que se sientan en ella, y la variante #[event(bytemuck)] que m01-l4 estacionó finalmente se vuelve exigible, porque emitirla necesita exactamente la disciplina Pod que acabas de pagar. Feliz construcción.
Pregunta 1 de 3