Cargando...

 BetaBeta
La lección pasada le diste al cabinet-counter una TABLA de puntajes máximos. Atornillaste una cola Slab a R1, metiste puntajes ahí, y viste la cuenta actualizarse en el lugar sin serialización de la lista entera. Eso funcionó por una razón y una sola: cada pieza de ese estado era de tamaño fijo. Un contador de jugadas PodU64, un puntaje máximo PodU64, una corrida acotada de ítems Score con un MAX de tiempo de compilación. El tamaño fijo es exactamente por qué el Slab podía vivir en los bytes propios de la cuenta y leerse con un cast en vez de una deserialización.
Así que rompámoslo. Abre en R1 el header Cabinet, el de cuatro campos que hiciste crecer la lección pasada (authority, play_count, high_score, bump), y agrega un campo que un arcade de verdad obviamente querría, un nombre que provee el jugador:
pub owner_name: String, // <- add this line to Cabinet
Compílalo. No compila, y el texto exacto va a depender de tu rustc, pero la línea estructural es siempre el mismo trait bound:
error[E0277]: the trait bound `String: bytemuck::Pod` is not satisfied
Todo lo demás que imprime el compilador apunta a ese único hecho: Account<T> exige T: Pod, cada campo necesita un layout fijo de tiempo de compilación, y un String es un puntero al heap más un largo en vez de una corrida de bytes. Esa negativa es toda la lección. Pod te compró velocidad prohibiendo la única cosa que la mitad de tus structs termina necesitando: el largo variable. En el momento en que un campo es un String, o un set sin máximo de tiempo de compilación, el cast directo de bytes es una mentira, porque no hay bytes fijos que castear. Anchor V2 sabe esto, y mantiene exactamente un wrapper para el caso en que Pod genuinamente no llega. Esta lección es sobre ese wrapper, cuándo recurrir a él, y las dos aristas filosas que heredas en el momento en que lo haces.
El repliegue esta vez corre sobre el juicio y no sobre el código, porque el entregable es una decisión de diseño, no un build. Yo modelo una cuenta mixta completa para que veas el razonamiento. En el Lab tú decides el nivel de cada campo antes que yo, una línea a la vez, y te chequeas contra el mío. Después en el Challenge tomas una cuenta distinta en frío, resuelves tú mismo el campo ambiguo que tiene, y justificas cada elección en una oración sin nada contra lo que chequear. Worked, después Completion, después Solo, igual que siempre.
Empieza con el encuadre honesto, porque es lo que la mayoría de la gente entiende mal. La escotilla de escape no es una derrota, y Pod no es "la forma buena" contra la "forma mala" de borsh. Son dos niveles de un diseño deliberado, y la habilidad que esta lección entrena es saber a qué nivel pertenece un campo dado.
Acá está la pregunta que motiva todo, la que te fuerza el error de String. Tienes un campo cuyo largo genuinamente no puedes saber en tiempo de compilación. ¿Cuáles son tus opciones?
Descarta primero las respuestas ingenuas, porque descartarlas es lo que hace que la respuesta real se sienta necesaria en vez de arbitraria.
La primera respuesta ingenua: ponerle un tope. Guarda el nombre como un PodVec<u8, 64>, trátalo como sesenta y cuatro bytes como máximo, y quédate en el camino zero-copy. Esto no está mal. Si un techo de sesenta y cuatro bytes es aceptable, esta es la respuesta correcta, y deberías tomarla. Pero lee el requisito otra vez. El campo está especificado como de largo arbitrario. Un PodVec es acotado por definición, así que en el instante en que "arbitrario" es una restricción real y no una salvedad, el tope es una violación de la especificación con un check verde puesto. El tope es la herramienta correcta para un campo acotado mal etiquetado como no acotado, y la herramienta equivocada para uno genuinamente no acotado.
La segunda respuesta ingenua: no guardarlo en absoluto. Hashea el nombre, mantén el digest de 32 bytes on-chain como un [u8; 32] (que sí es Pod), y guarda la cadena real en algún lado off-chain. Para el problema correcto, este es un diseño perfectamente bueno. Pero ahora no puedes renderizar el nombre desde la cuenta, agregaste una dependencia off-chain y una búsqueda, y cambiaste calladamente lo que la cuenta es. Si el programa de verdad necesita los bytes on-chain, esta respuesta resolvió un problema distinto del que tienes.
Así que la pregunta real se reduce a esto: ¿cómo metes un valor genuinamente de largo variable dentro de una cuenta cuando un cast fijo es imposible y no te puedes permitir mover los datos off-chain?
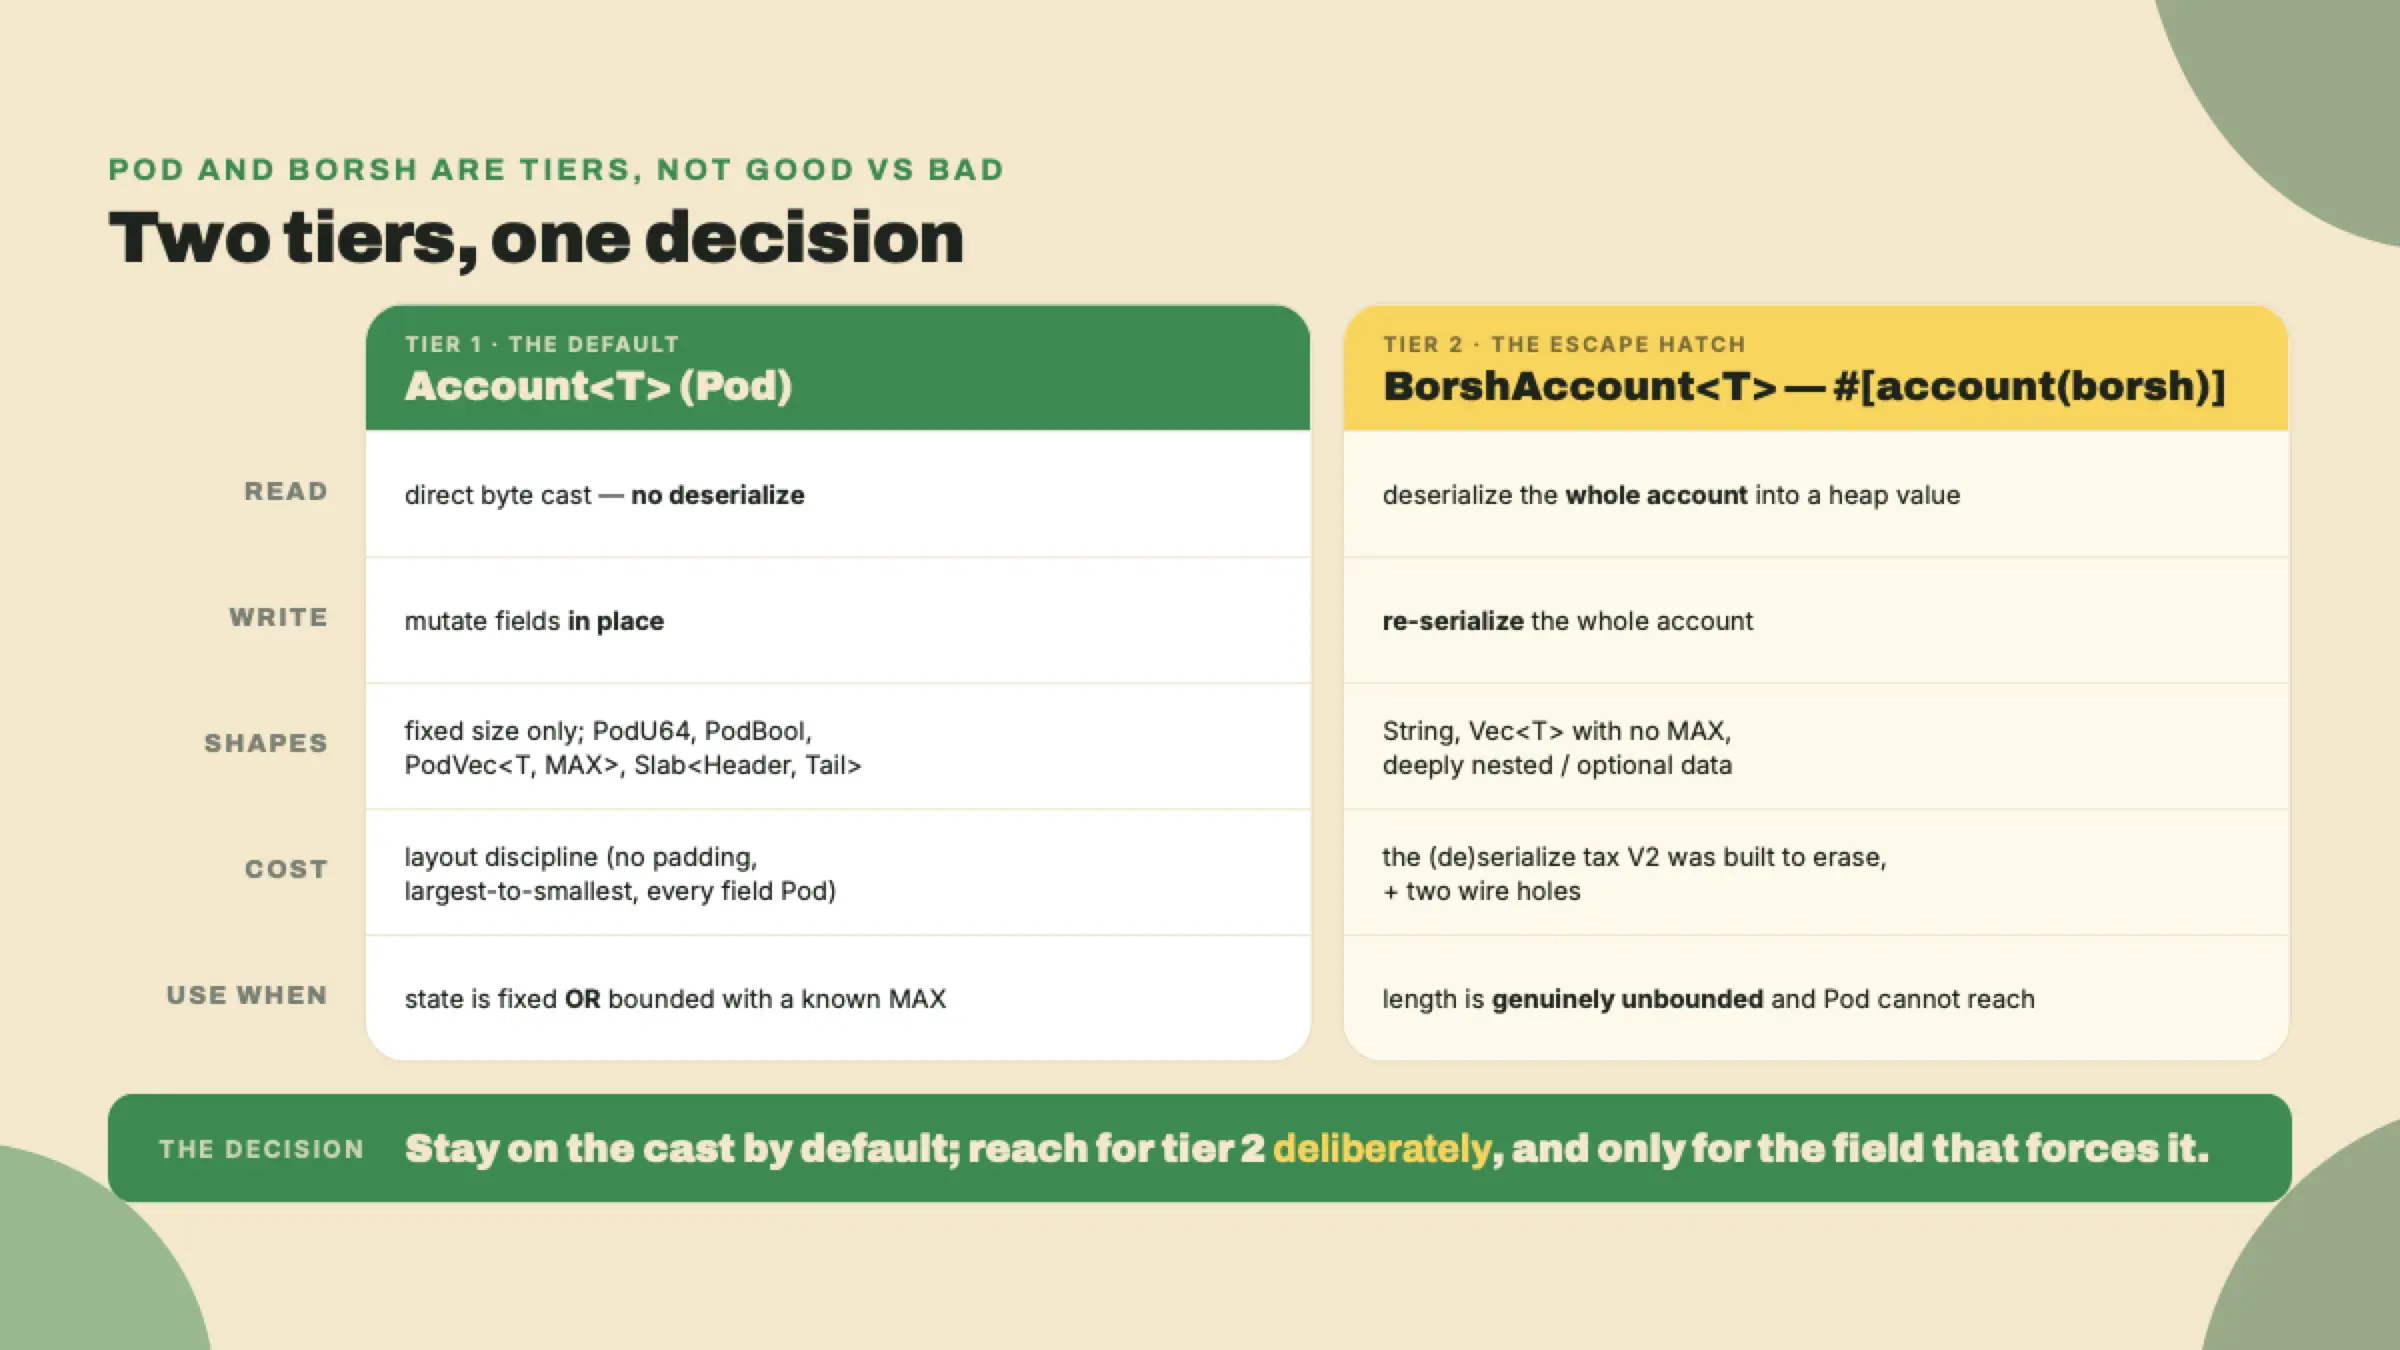
La respuesta de Anchor V2 es el atributo #[account(borsh)] junto con el wrapper BorshAccount<T>. El atributo va en el struct, y hace exactamente una cosa: saca a ese tipo del requisito T: Pod y lo mete en un modelo de deserialización al leer. El wrapper va en la cuenta dentro de tu contexto #[derive(Accounts)], en el lugar donde si no escribirías Account<T>.
// A type that CANNOT be Pod, and doesn't try to be.
#[account(borsh)]
pub struct CabinetProfile {
    pub owner: Address,
    pub description: String, // variable length - the whole reason we're here
}

#[derive(Accounts)]
pub struct EditProfile {
    #[account(mut)]
    pub profile: BorshAccount<CabinetProfile>, // deserializes on read
    pub owner: Signer,
}
Fíjate en lo que hace BorshAccount<CabinetProfile> y que Account<Cabinet> nunca hizo. Cuando tu handler toca profile.description, el wrapper no te entrega una vista sobre los bytes crudos. Lee los datos de la cuenta y deserializa todo el asunto en un valor de Rust asignado en el heap, String incluido. Cuando escribes, vuelve a serializar todo el valor. Eso es exactamente lo que zero-copy fue construido para evitar, y acá lo estás eligiendo a propósito, porque la alternativa es no tener el campo en absoluto.
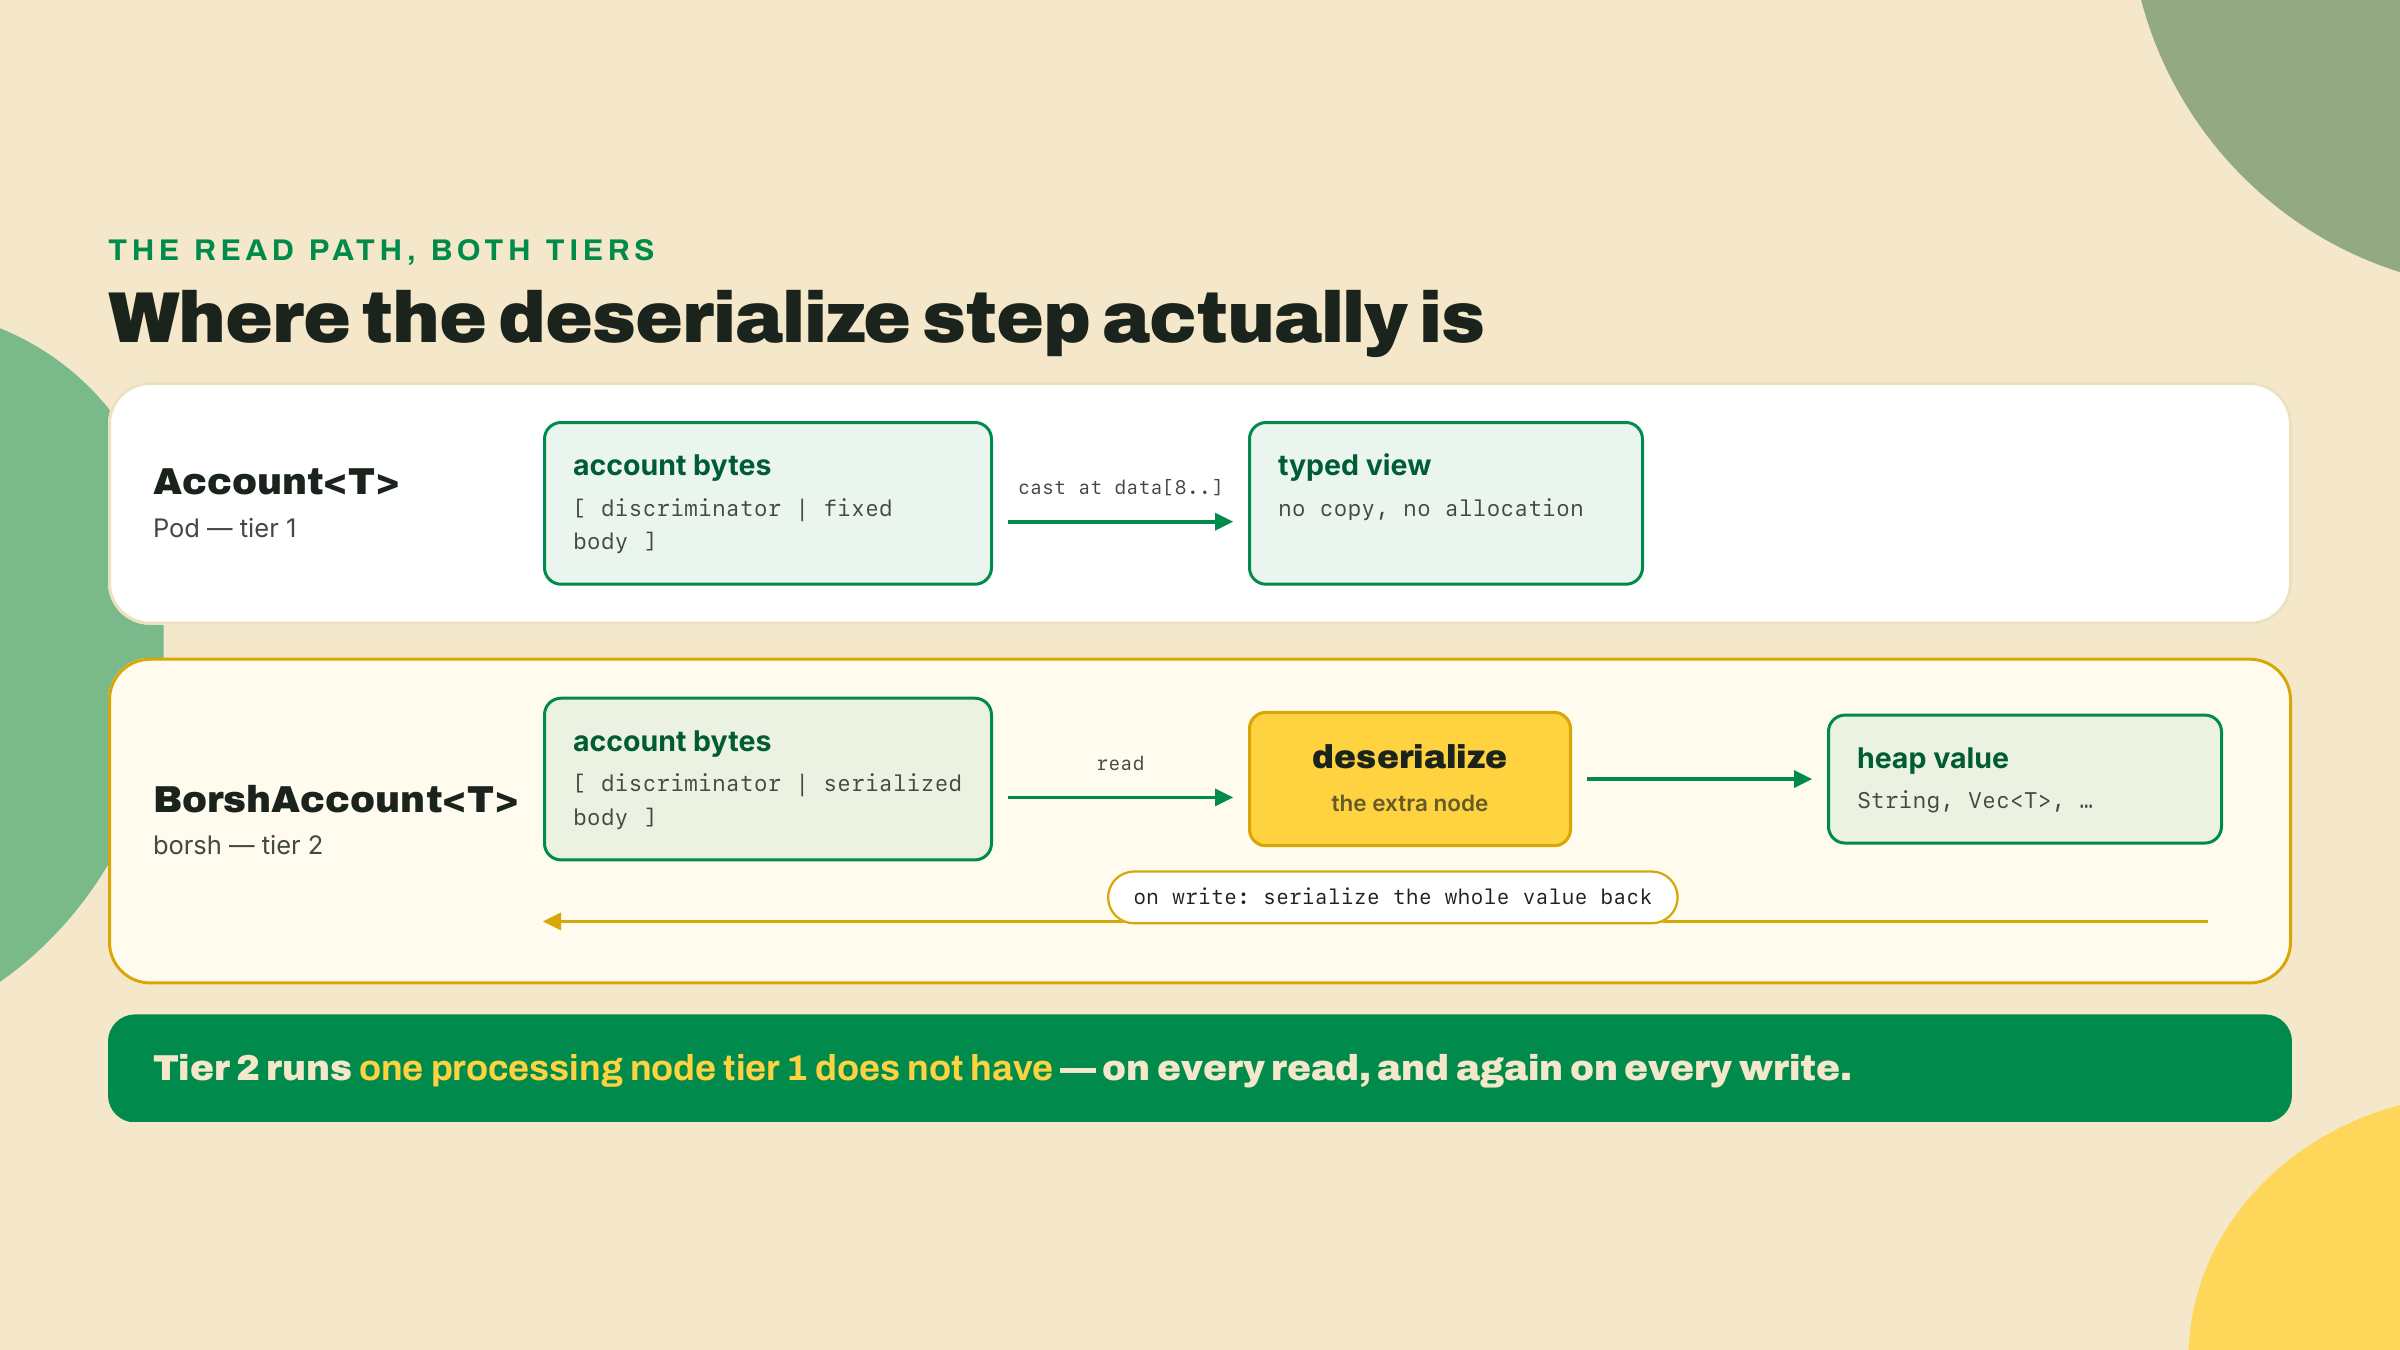
Sé honesto sobre cuánto cuesta, porque la respuesta no es un solo número, y tratarla como uno es como la gente o entra en pánico o se relaja. Separa el caso promedio del peor caso. En un struct borsh chiquito, un solo Address y un nombre de diez caracteres, la deserialización es barata en términos absolutos; te costaría medirla contra el resto de un handler. Ese es el caso promedio, y es por eso que "borsh es lento" es demasiado burdo para ser útil. El peor caso es el que muerde: el costo de deserializar escala con el tamaño de los datos, así que un BorshAccount que guarda una descripción de cuatro kilobytes paga una deserialización de cuatro kilobytes en cada instrucción que lo carga, y una re-serialización de cuatro kilobytes a la salida cuando era escribible. A un cast Pod no le importa si la cuenta tiene cincuenta bytes o cuatro kilobytes; lee el campo que pediste y para. Así que el encuadre honesto no es "borsh es lento" sino "el costo de borsh es proporcional al tamaño de toda la cuenta y se paga en cada acceso, mientras que el de Pod es plano y casi cero". Esa proporcionalidad es exactamente por qué aíslas el campo variable grande en vez de fusionarlo en la cuenta que tocas todo el tiempo.
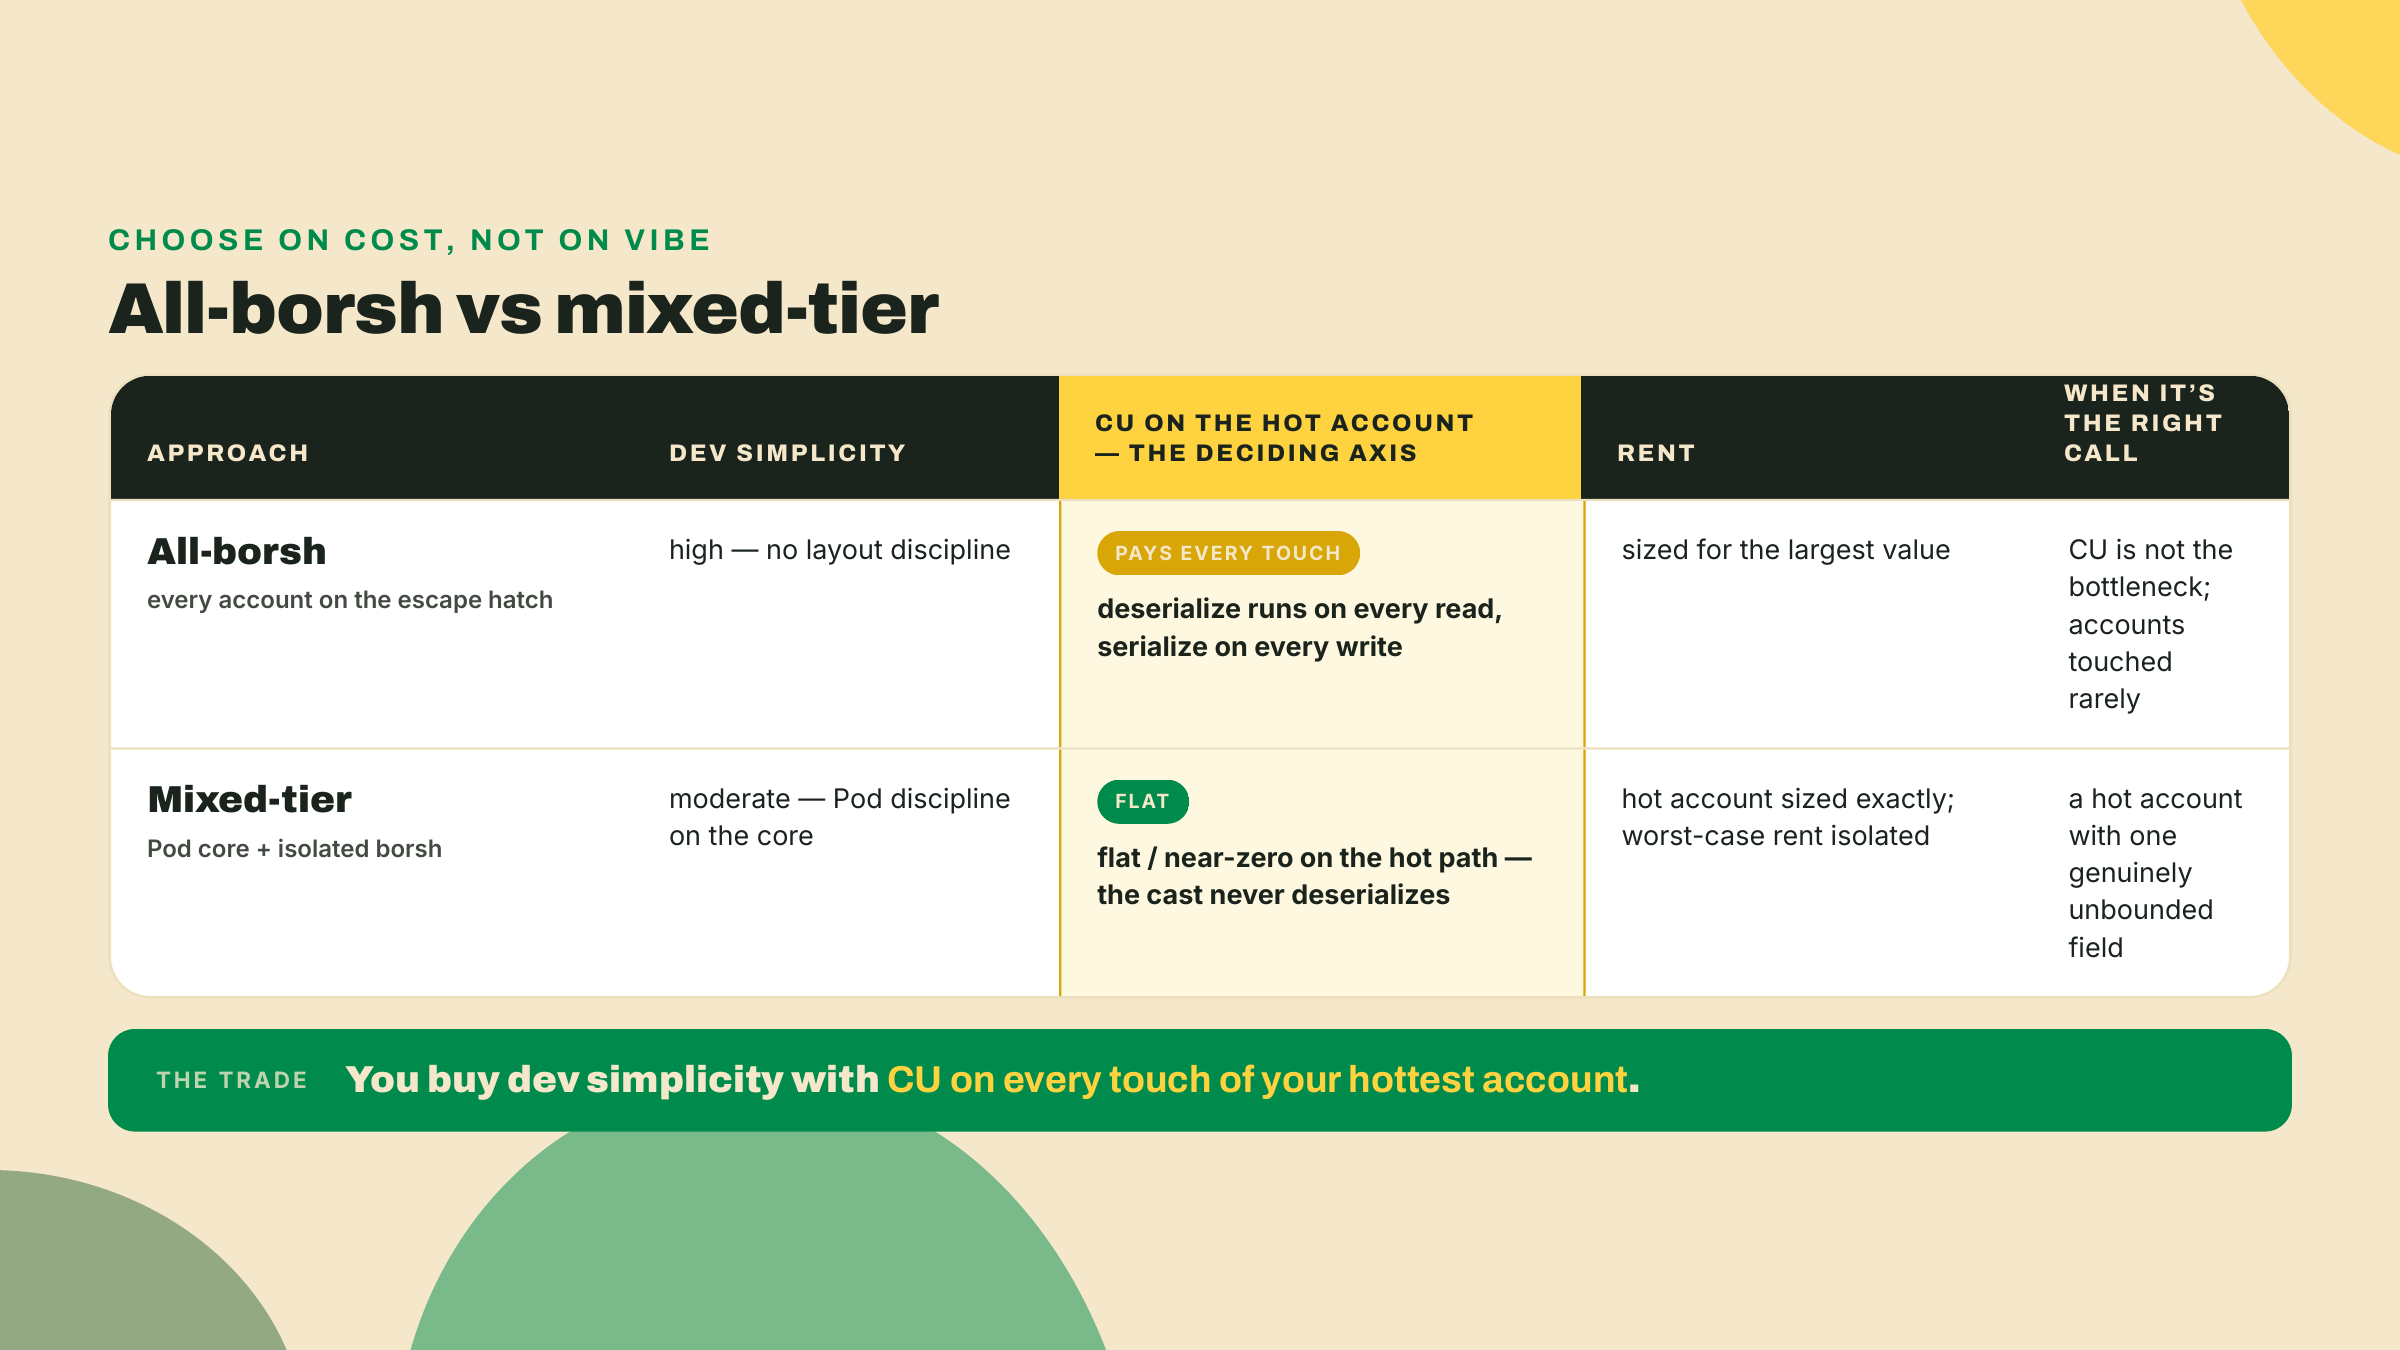
Di el trade-off en voz alta, porque nombrarlo es la jugada de credibilidad y saltearlo es como la gente entrega el nivel equivocado. BorshAccount te compra largo variable y datos anidados u opcionales fáciles. Lo pagas de vuelta en el costo de (de)serialización que toda la tesis de V2 fue construida para eliminar y, como estamos por ver, en dos incompatibilidades de wire documentadas. Se gana su lugar solo donde Pod genuinamente no llega. El corolario es la parte que la gente se pierde: una cuenta mixta, una con algunos campos fijos y un campo no acotado, no debería irse a todo-borsh. Debería mantener sus partes fijas y acotadas en Pod y aislar la parte no acotada. Más sobre eso en el Lab, porque esa es la habilidad real de diseño.
Antes de seguir, ponle el mejor argumento posible a la posición contra la que acabo de argumentar, porque es genuinamente razonable y vas a sentir su tirón. El argumento va así: Pod es un dolor. Disciplina de layout, cero relleno, orden de campos de mayor a menor, wrappers Pod en cada campo, todo el impuesto que te pasaste el módulo 2 aprendiendo a pagar. BorshAccount hace desaparecer todo eso. Mete un String, un Vec, un Option, lo que quieras en un struct, deriva el serializador, y sigue con tu vida. ¿Por qué no hacer simplemente que cada cuenta sea BorshAccount y dejar de pelear con el layout de bytes?
Concede la parte válida, porque es real. Para un programa donde la CU no es el cuello de botella, donde las cuentas se tocan rara vez y los datos son genuinamente irregulares, todo-borsh sí es más simple, y el código más simple tiene menos bugs. Yo he entregado la versión todo-borsh de un programa. Está bien, justo hasta que no lo está. Así que el argumento se sostiene: es un canje real, y en el eje de la simplicidad borsh gana.
Ahora refínalo, porque el eje que ese argumento optimiza no es el eje sobre el que V2 se construyó. ¿Comparado con qué? Comparado con Account<T>, cuya razón entera de existir es que la deserialización por defecto de v1 era, en palabras del propio framework en el issue #4390, "el camino lento" y "la queja de rendimiento número uno entre los desarrolladores de Anchor". Elegir todo-borsh es elegir reintroducir, en cada cuenta, exactamente el costo que toda la reescritura se propuso borrar. En una cuenta que tocas una vez al mes, a quién le importa. En la cuenta caliente de un programa que corre miles de veces por slot, acabas de devolver por completo la optimización estrella del framework, sobre datos que en su mayoría no la necesitaban. La simplicidad era real; también estaba tasada en CU, y no leíste el recibo. Eso es lo que te compra "¿comparado con qué?": convierte "borsh es más simple" de un veredicto en un canje con un costo nombrado, y el costo es exactamente lo que este curso existe para enseñarte a ver.
Ahora la parte que muerde en producción, y la razón de que esta lección exista en un curso de framework en vez de en una nota al pie.
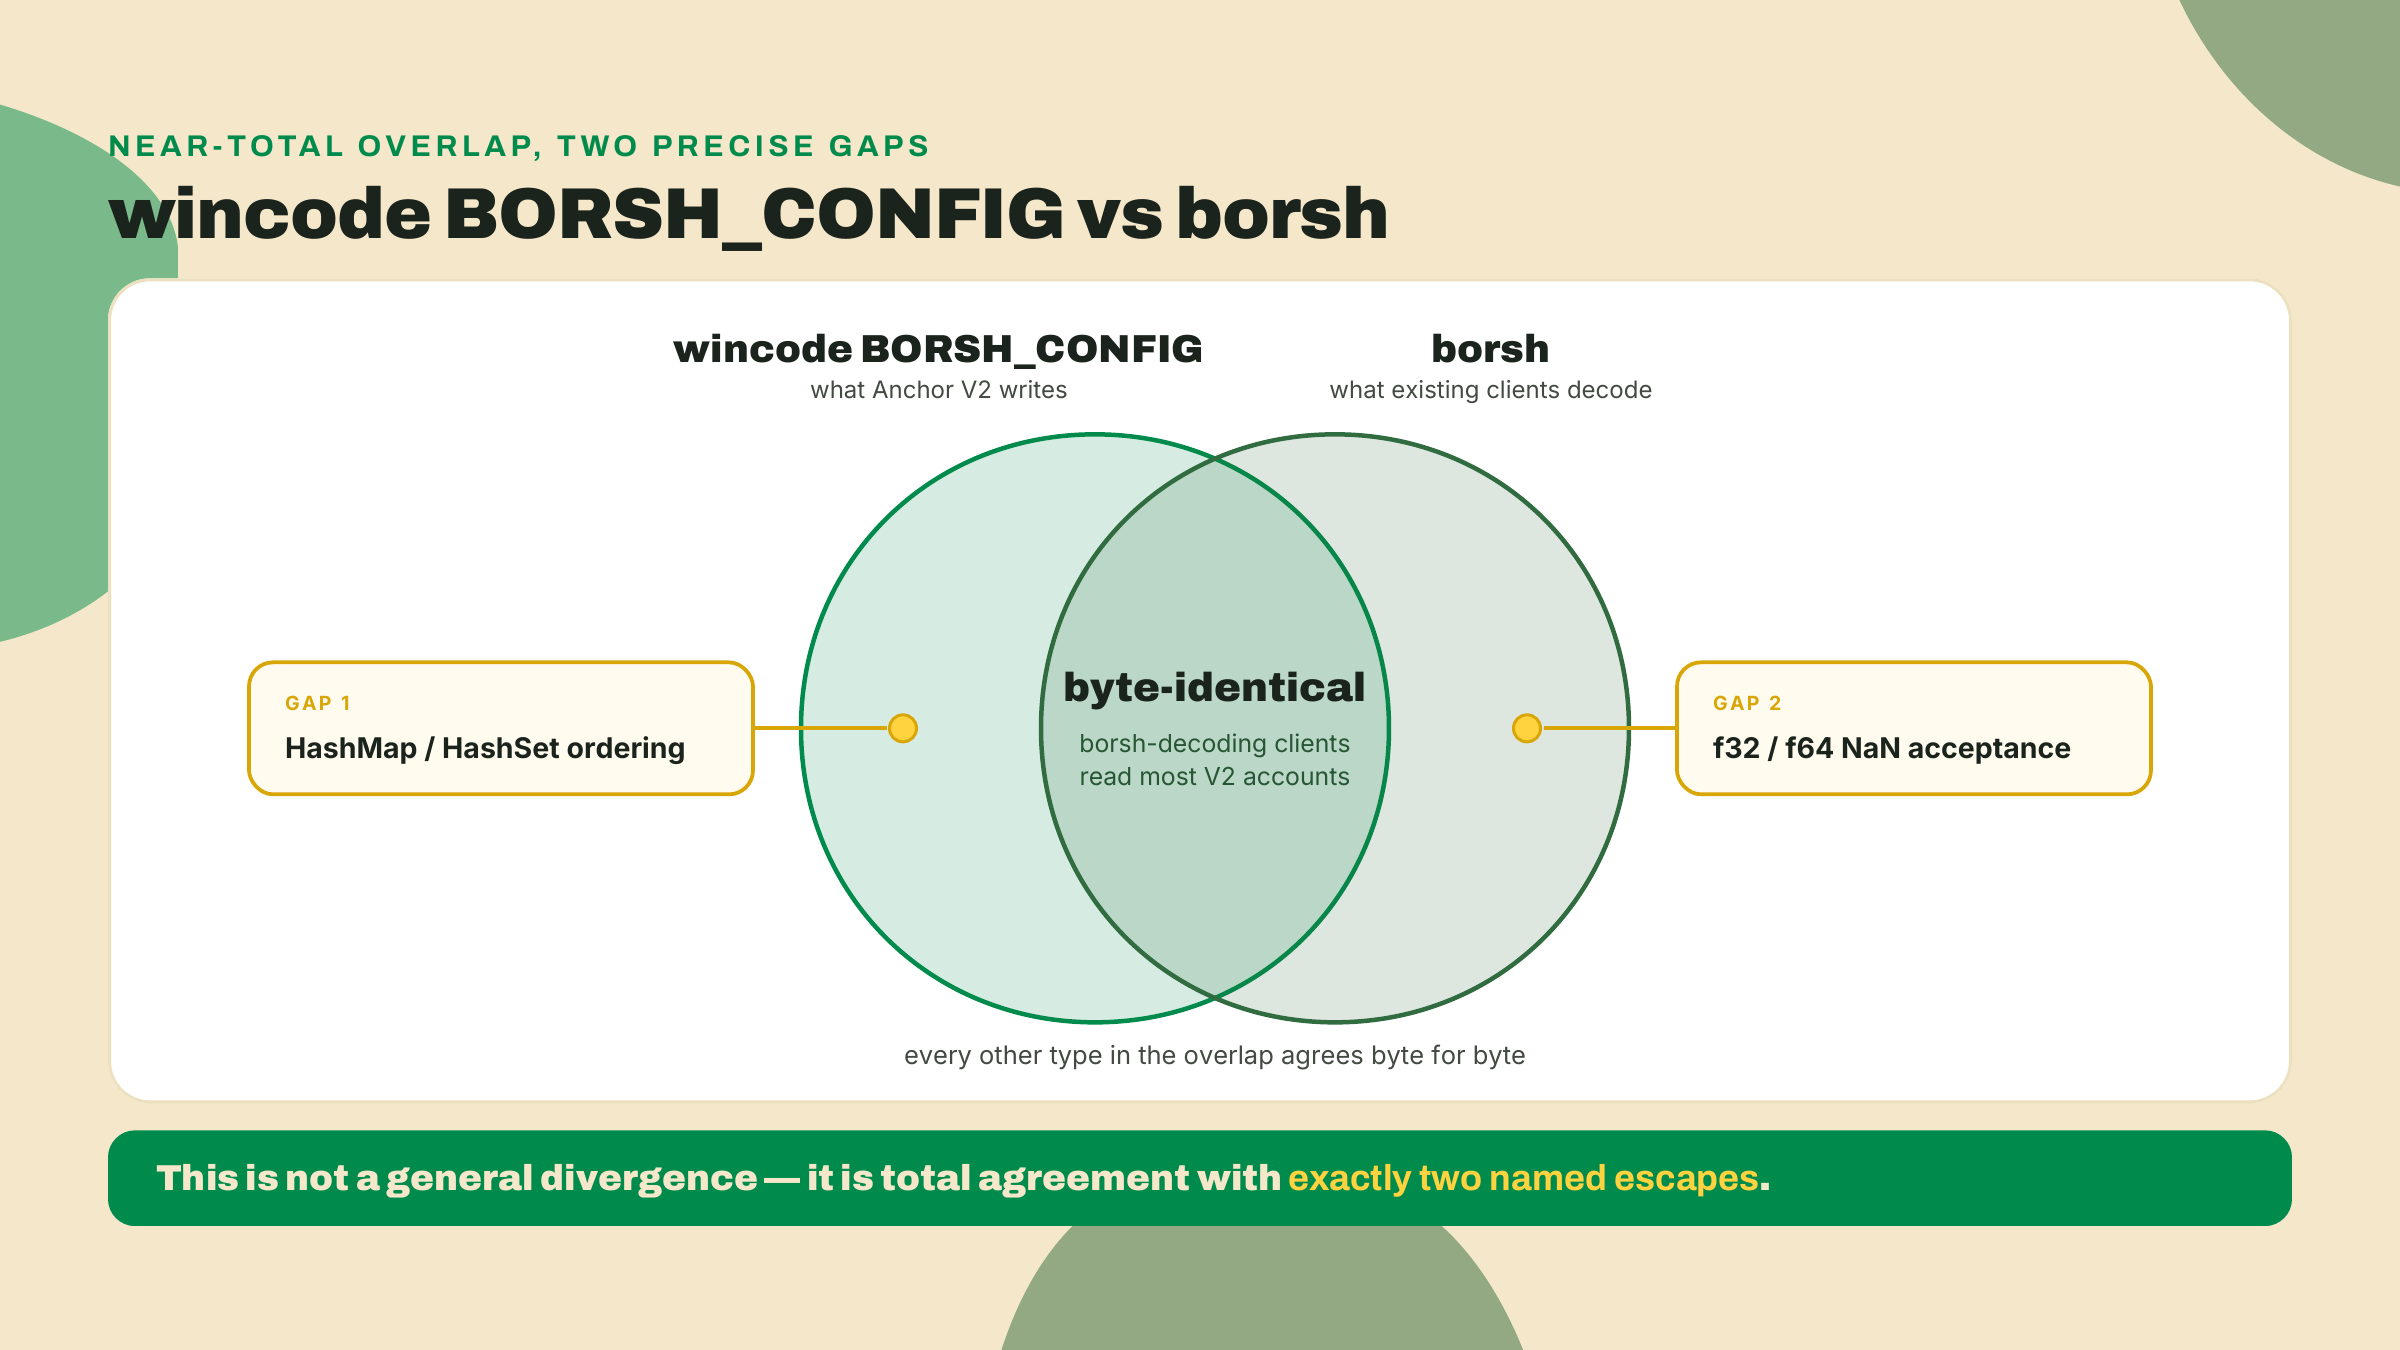
El serializador por defecto de V2 no es borsh clásico. Se llama wincode, y su BORSH_CONFIG es idéntico byte a byte a borsh, con dos excepciones documentadas. Ese "idéntico byte a byte, excepto" es toda la historia, así que seamos precisos sobre las dos mitades.
Empieza con la pregunta que el diseño tenía que responder, porque la respuesta no es obvia. V2 es una reescritura desde cero. Podría haber entregado cualquier formato de wire que quisiera. Hay todo un ecosistema de herramientas allá afuera, indexadores, exploradores, lectores off-chain, que ya habla borsh, porque borsh fue el wire de Anchor por años. Así que la pregunta de diseño era: ¿le haces un fork al formato de wire y obligas a cada uno de esos consumidores a reescribir sus decodificadores, o te quedas compatible y heredas el ecosistema gratis? Dicho así, la respuesta se elige sola. wincode mantiene el layout de bytes de borsh precisamente para que los decodificadores existentes sigan funcionando. Adoptar V2 no le hace un fork al wire. Eso es un regalo de compatibilidad deliberado, y la mayor parte del tiempo llegas a disfrutarlo sin pensar.
Ya conociste este serializador, por cierto. La lección pasada, cuando emitiste un #[event(bytemuck)] y yo señalé que un #[event] simple serializa con wincode bajo una config idéntica a borsh, ese wire de evento simple es exactamente este serializador. El evento por defecto, el cuerpo de cuenta por defecto, el mismo serializador debajo. Así que la historia de compatibilidad no son dos historias: la razón por la que un indexador que lee borsh puede parsear tus eventos de V2 es la misma razón por la que puede parsear tus bytes de BorshAccount. Un formato de wire, compatible con borsh excepto en dos lugares, usado para las dos cosas. Eso vale la pena guardárselo, porque quiere decir que los dos agujeros de abajo aplican a tus eventos también, no solo a tus cuentas.
¿Entonces por qué es "idéntico byte a byte excepto" y no solo "idéntico byte a byte"? Porque hay exactamente dos lugares donde el comportamiento propio de borsh no es determinista para empezar, y un serializador que quiere salida determinista tiene que tomar una decisión ahí, y wincode tomó una decisión distinta de la que tomó borsh clásico. Los dos agujeros son sobre el determinismo, y una vez que ves por qué cada uno es no determinista en primer lugar, la regla se te queda para siempre.
El primer agujero es el orden de campos de HashMap y HashSet. Acá está la causa raíz: un HashMap en Rust no tiene orden de iteración definido. La biblioteca estándar lo aleatoriza a propósito en cada corrida para defenderse de ataques de hash-flooding, así que "itera el map y serializa las entradas en ese orden" es una secuencia de bytes distinta en cada corrida. borsh y wincode resuelven ese no determinismo de manera distinta, así que si un campo de tu cuenta borsh es un HashMap y dependes del orden en que sus entradas caen en el wire, tienes bytes no deterministas: el mismo estado lógico puede serializarse de dos maneras, y un cliente que decodifica borsh y lee una cuenta escrita por wincode puede discrepar sobre el orden. La cuenta no está corrupta. Simplemente no es estable en el orden entre los dos codificadores, y cualquier cosa que hashee o firme sobre los bytes crudos lo va a notar de inmediato.
El segundo agujero es la aceptación de NaN en f32 y f64. La causa raíz acá es que NaN no es un solo valor. El estándar de float IEEE-754 define todo un rango de patrones de bits que todos quieren decir "no es un número", y NaN no es ni igual a sí mismo. Así que "serializa este float" es ambiguo en el momento en que el float puede ser NaN: ¿qué patrón de bits de NaN escribes, y siquiera aceptas uno? Los dos codificadores difieren en si aceptan un valor NaN en absoluto. Si tu struct lleva un float que puede ser NaN, pueden discrepar sobre si el valor es legal en el wire. (Los floats en el estado on-chain son mal olor por otras razones, la matemática financiera determinista quiere enteros y punto fijo, pero si los tienes, este es un caso borde real.)
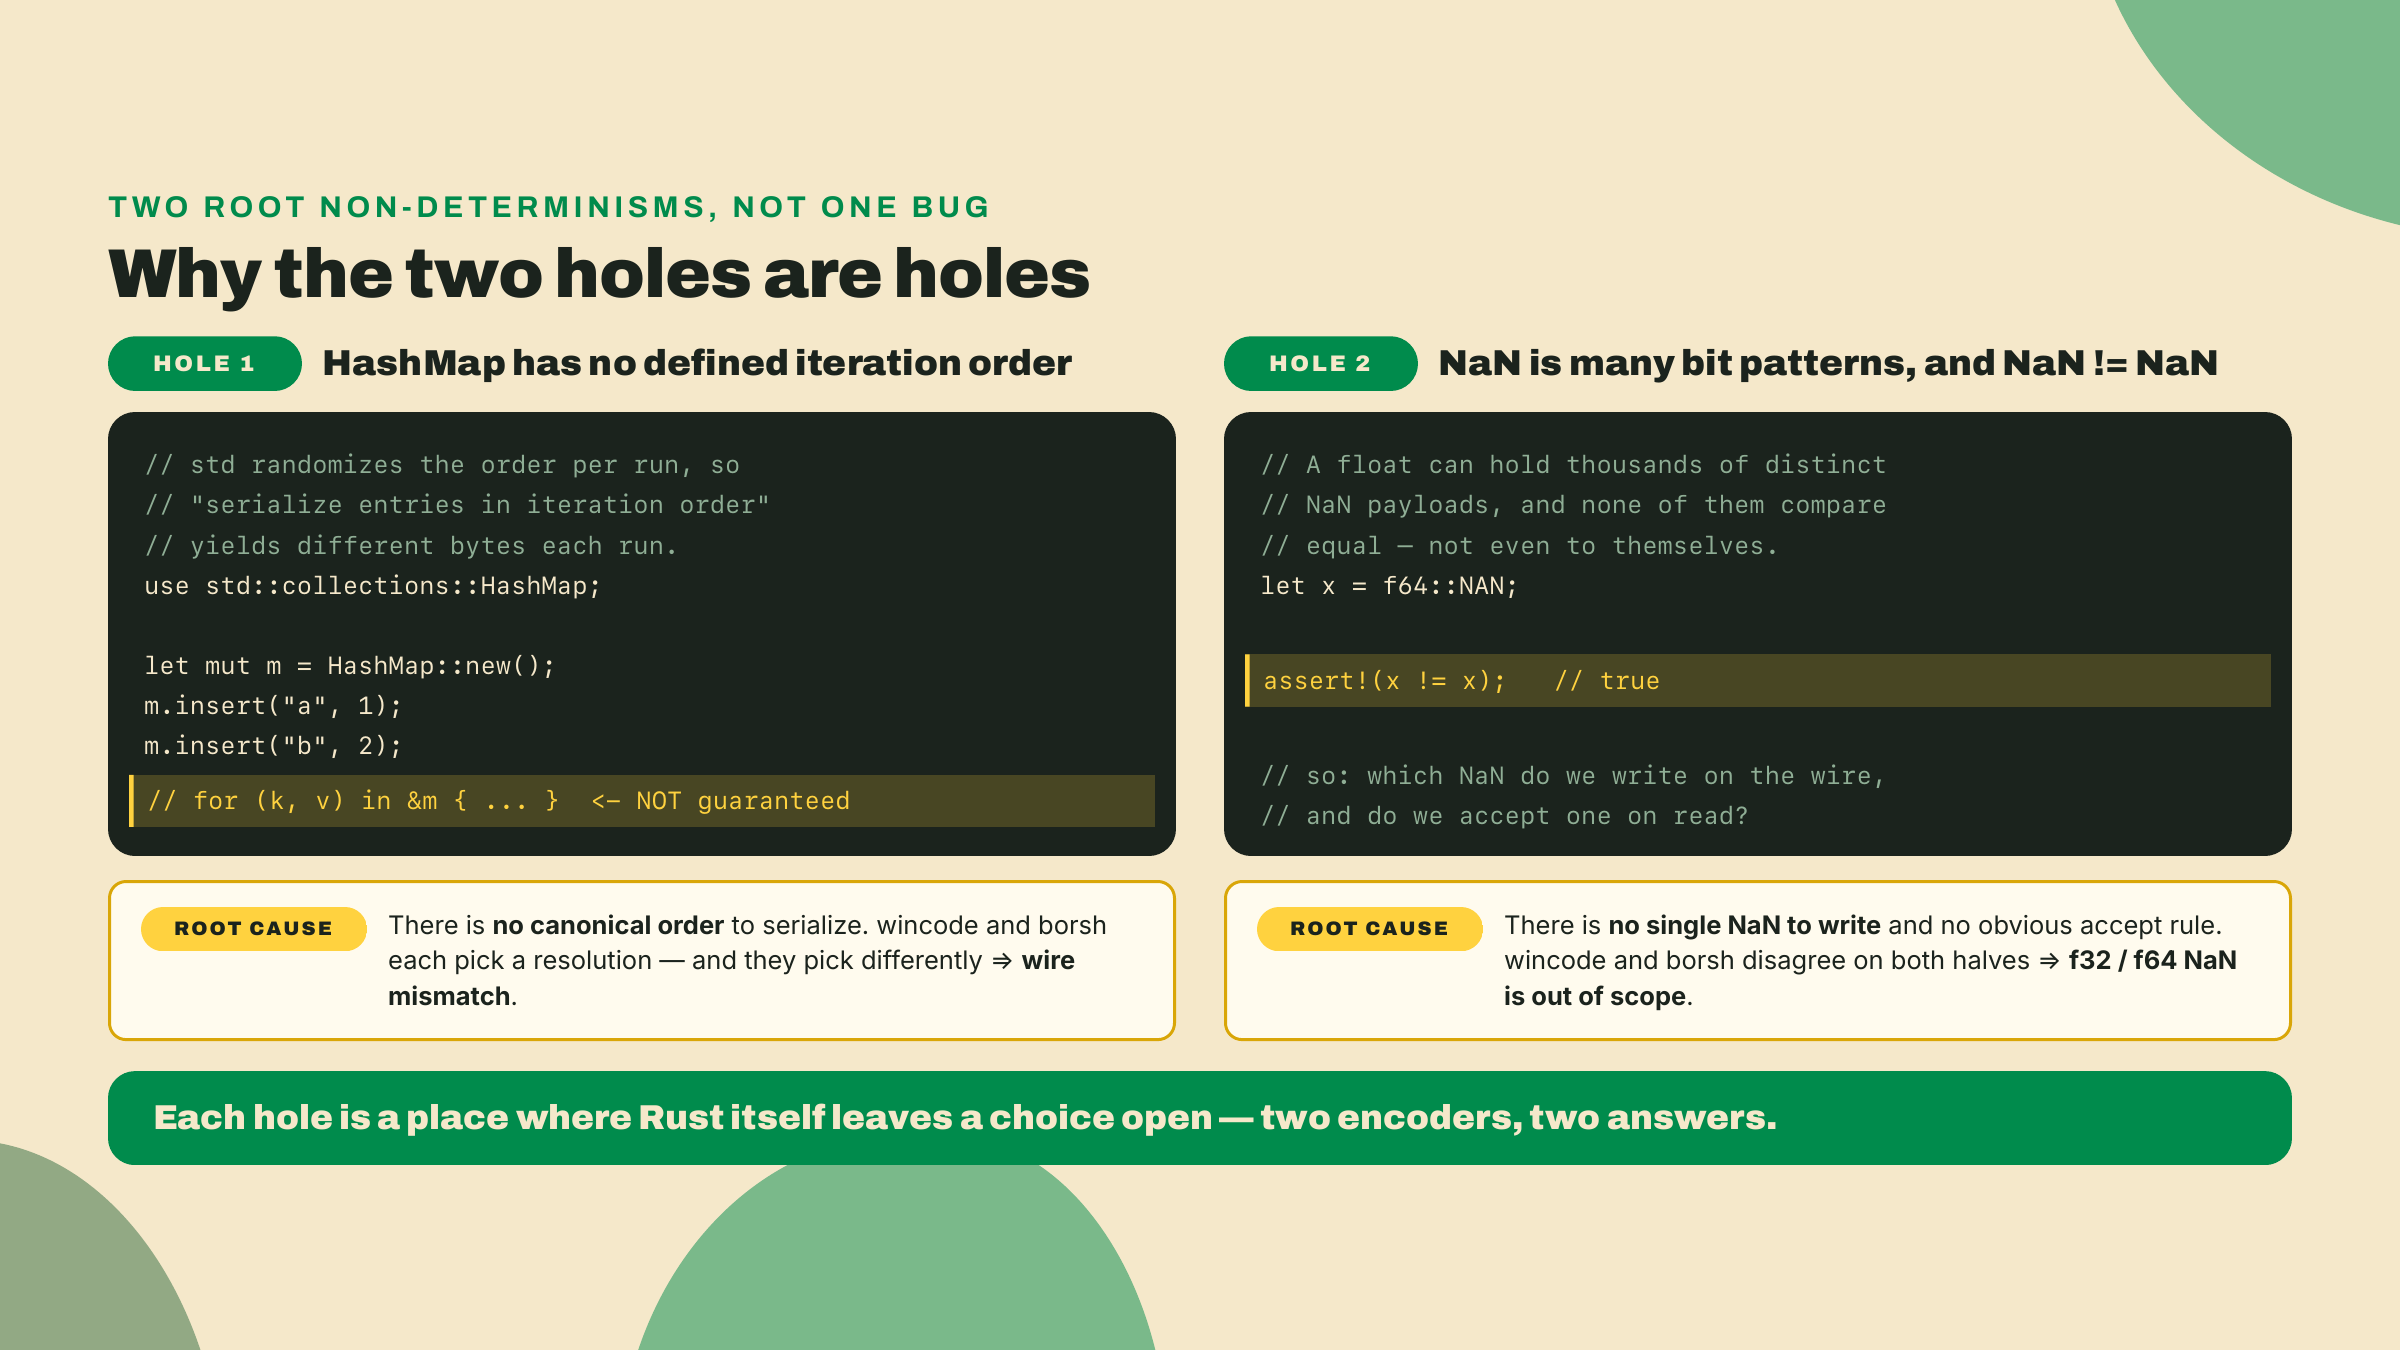
Junta los dos y la regla se desprende limpia. Un cliente que decodifica borsh puede leer la mayoría de las cuentas de wincode, pero no si dependes del ordenamiento de maps o sets, y no si dependes de floats NaN. Si ninguna de las dos es cierta para tu struct, y para la abrumadora mayoría de las cuentas no lo es, la compatibilidad se sostiene y puedes seguir. Si alguna de las dos es cierta, tienes que decidir la historia de la codificación a propósito, porque el wire ya no es una sola cosa.
| Los dos agujeros del wire | Qué difiere | Cuándo te muerde |
|---|---|---|
Ordenamiento de HashMap / HashSet | el orden de iteración en que se serializan las entradas | dependes del orden del map, o hasheas/firmas sobre los bytes crudos de la cuenta |
NaN en f32 / f64 | si un valor NaN se acepta en el wire | tu struct lleva un float que puede ser NaN |
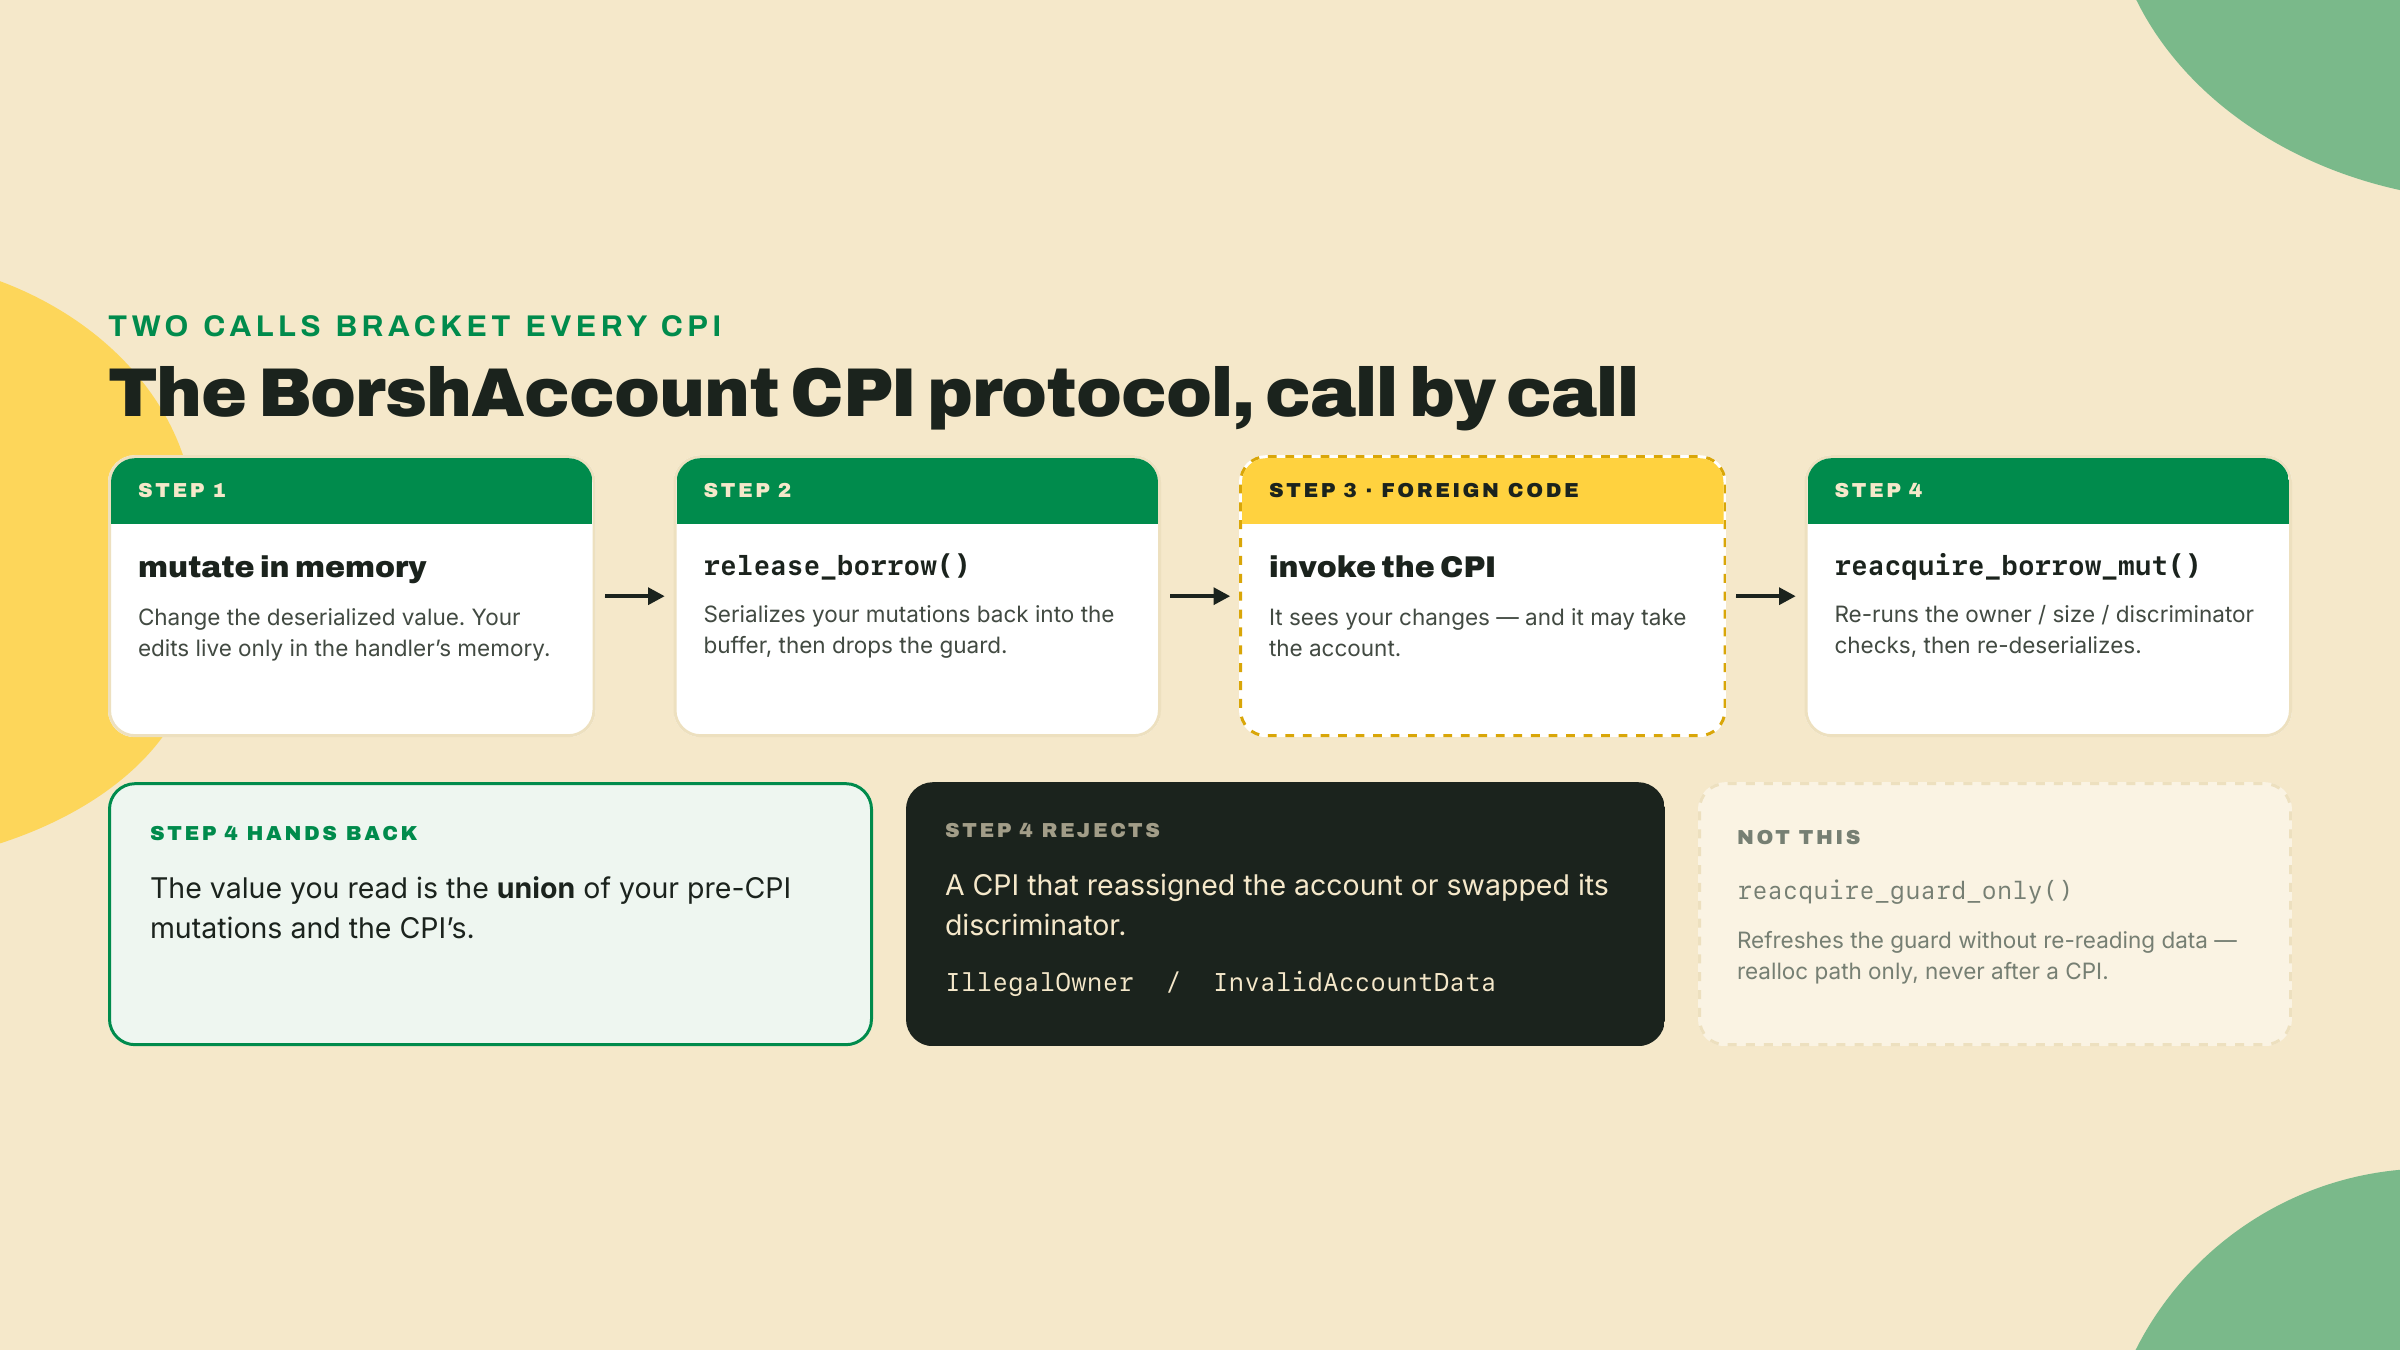
Una pregunta que levanta este nivel merece una respuesta directa y no una evasiva, porque equivocarse es un bug de estado silencioso: ¿cómo se comporta un BorshAccount a través de una CPI?
Acá está por qué la pregunta tiene filo y no es académica. Un BorshAccount guarda un valor deserializado, una copia en el heap del estado de la cuenta, no una vista viva sobre los bytes. Ese es todo el punto del nivel. Pero una copia puede quedar obsoleta. Si tu handler deserializa una cuenta borsh, y después invoca una CPI que muta los bytes de esa misma cuenta on-chain, la copia en el heap que tu handler sigue sosteniendo es anterior a la CPI. Con el Account<T> de camino lento de v1 esta era la trampa clásica de .reload(): si no recargas después de una CPI, razonas sobre estado pre-CPI.
Una nota de nomenclatura antes del protocolo, porque el nombre del tipo y la sección de arriba pueden parecer contradecirse. BorshAccount<T> es un alias de SerializedAccount<T, BorshSerializer>, y BorshSerializer es wincode bajo su BORSH_CONFIG. Así que el nombre es sobre el formato, no sobre el crate: un BorshAccount escribe bytes con forma de borsh, producidos por wincode, que es exactamente por qué los dos agujeros de arriba son los dos lugares donde el nombre deja de ser una promesa. Con eso resuelto: el tipo trae un protocolo explícito de dos llamadas alrededor de una CPI. Antes de la llamada usas release_borrow(), que serializa tus mutaciones en memoria de vuelta al buffer y suelta la guarda de borrow, así la CPI ve tus cambios y además puede tomar la cuenta. Después de la llamada usas reacquire_borrow_mut(), que vuelve a correr todas las verificaciones de carga (dueño, tamaño, discriminador) y vuelve a deserializar el valor desde el buffer vivo. La nota del propio framework sobre lo que recibes de vuelta es precisa: el estado refrescado es la unión de tus mutaciones pre-CPI y las mutaciones de la CPI, y una CPI que reasignó la cuenta o le cambió el discriminador se rechaza con IllegalOwner o InvalidAccountData en vez de aceptarse en silencio. Hay un tercer método, reacquire_guard_only(), que refresca la guarda sin volver a leer los datos; ese es para el camino de realloc y la documentación lo dice explícitamente, así que no recurras a él después de una CPI.
El contraste con el nivel Pod vale la pena tenerlo presente. Para Account<T>, en V2 el modelo de borrow de CpiHandle convierte "te olvidaste de recargar" en un error de compilación, que enfrentas de frente más adelante en el curso. Para BorshAccount<T> la disciplina es un par de llamadas que haces a propósito. Las dos son mejores que el silencio que v1 guardaba, pero solo una de las dos se verifica por ti, que es una razón chica más de que la escotilla de escape siga siendo una escotilla de escape. Si tu diseño deserializa una cuenta borsh, invoca una CPI que la toca, y después lee el valor, igual escribe la prueba de LiteSVM que afirma el valor post-CPI: el protocolo está documentado, pero tu uso de él es lo que vale la pena demostrar.
Hora de la primera historia de guerra del módulo, porque vuelve dolorosamente concreta una disciplina abstracta.
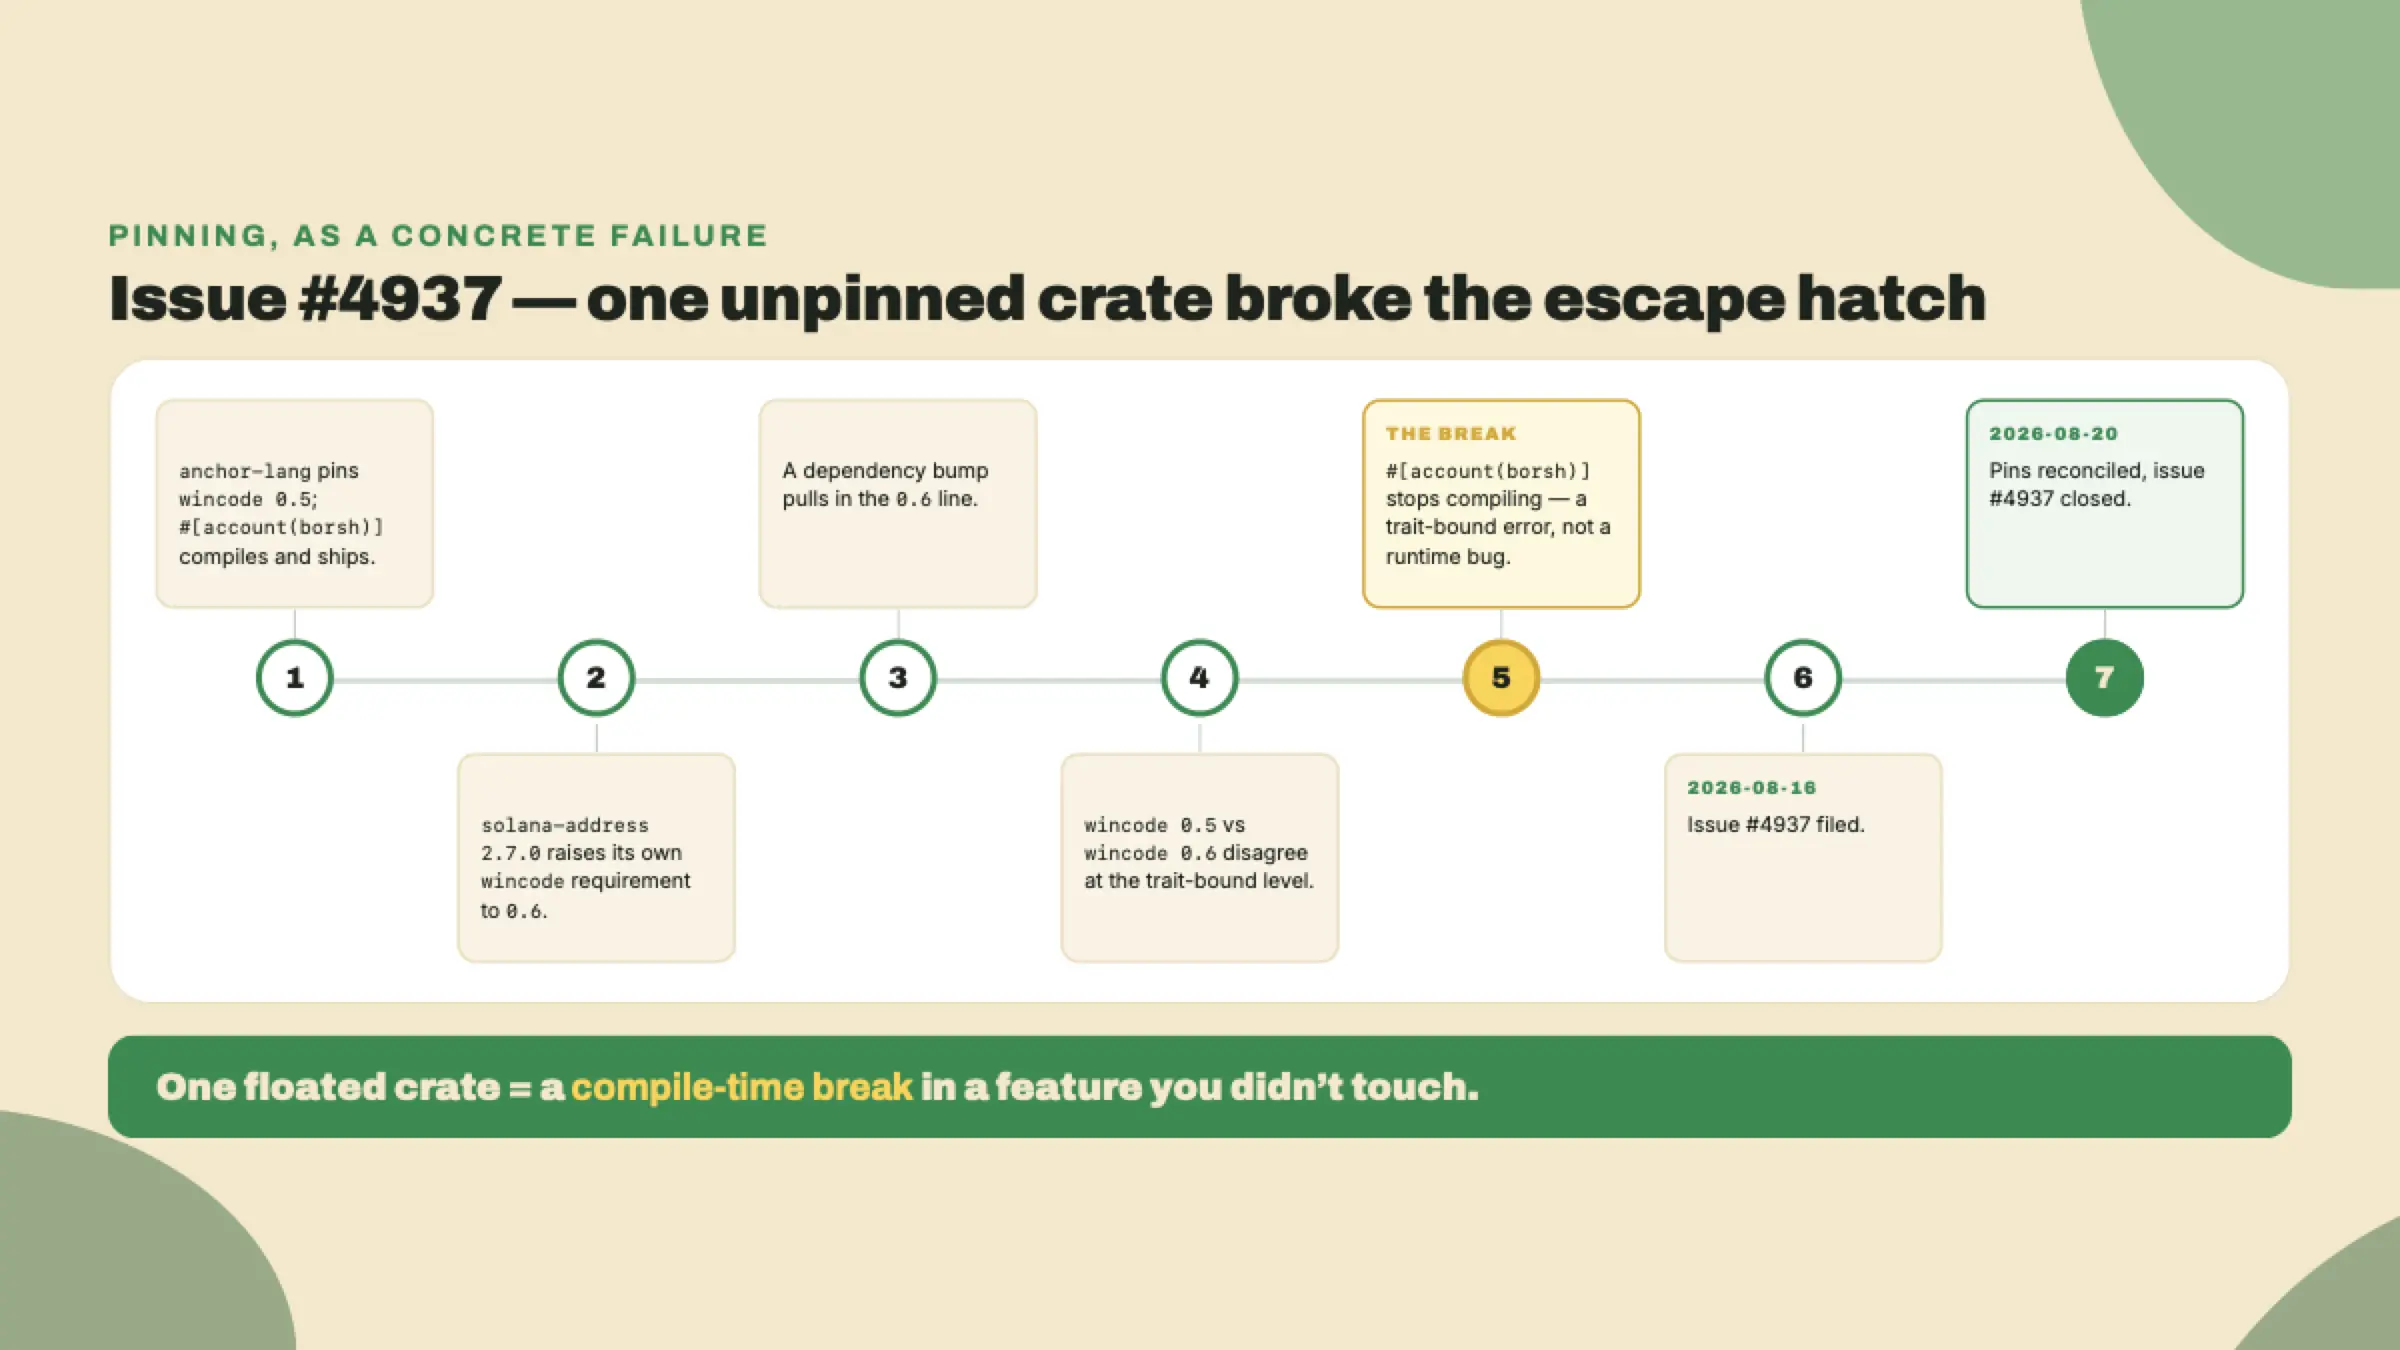
El issue #4937 se abrió el 2026-08-16 y se cerró cuatro días después, el 2026-08-20. El bug: anchor-lang fijaba wincode en 0.5 mientras solana-address 2.7.0 había movido su propio requisito de wincode a 0.6. (solana-address en sí nunca ha entregado más que una línea 2.x — no existe un solana-address 0.6; la versión que se movió es la de wincode, y las dos oraciones de abajo lo dicen bien.) Esas dos versiones discrepaban al nivel del trait bound, y el desacuerdo rompió #[account(borsh)]. No con una falla en runtime, no con un bug sutil de wire, sino con un error de compilación, un trait bound que ya no cuadraba, hasta que los pins se reconciliaron. Alguien subió una dependencia, y la escotilla de escape que acabas de aprender dejó de compilar.
Por esto empezaste PINS.md allá en m01-l2, una tabla con una columna verified, y por esto cada pin de estas lecciones lleva una etiqueta "esto se va a mover, re-verifica al escribir". Agrégale una fila de wincode ahora si no lo hiciste. V2 es una RC de semanas, y el ref en el que estás decide la respuesta acá: wincode está en 0.5 en el crate 2.0.0-rc.1 publicado y en el tag v2.0.0-rc.1, y ya se movió a 0.6 en la punta de la branch anchor-next. Tu crate de programa fija wincode = "0.5" a mano, así que el tag es el ref que está de acuerdo con él — que es exactamente por qué cada bloque de instalación desde m02-l1 fija --tag v2.0.0-rc.1 en vez de la branch. Sigue la branch en cambio y el anchor-lang de la punta exige solana-address 2.7.0, tu techo < 2.7 se niega, y cargo falla la resolución antes de que compile una sola línea. solana-address va a su propia cadencia. Fijas todo junto y no dejas flotar ningún crate solo, porque #4937 es cómo se ve dejar flotar un crate: un build verde el lunes, un error de trait bound el martes, y una tarde haciendo bisect en un grafo de dependencias en vez de entregar.
La línea de instalación en sí no se repite acá — el Lab de esta lección nunca invoca el toolchain. Si de verdad necesitas reinstalar, usa el mismo bloque de m02-l1 sin cambios, --tag v2.0.0-rc.1 y --locked: el tag, nunca la branch.
Acá está el problema de diseño, y es el que vas a enfrentar de verdad. El arcade quiere una cuenta de perfil por máquina que guarde tres cosas:
[u8; 32], que nunca cambia de largo.Score.La jugada perezosa es ver un campo no acotado y hacer toda la cuenta BorshAccount. Resístela. Eso abandonaría el zero-copy en la clave fija y en la tabla de posiciones acotada sin razón, pagando el impuesto de deserialización sobre dos tercios de la cuenta que nunca lo necesitaron. La jugada disciplinada es modelar cada campo en el nivel al que pertenece y, cuando un campo fuerza borsh, aislarlo.
Paso 1, etiqueta cada campo antes de escribir una línea. Decide los tres ahora, en voz alta o en un comentario, antes de leer el resto de este párrafo; el punto es detectar en cuál dudas. Resultado esperado: tres etiquetas, una de las cuales te tomó más tiempo que las otras dos. Estas son las mías. La clave de 32 bytes es de tamaño fijo, así que es Pod, un [u8; 32] simple. La tabla de posiciones está acotada en diez, así que es un Slab o un PodVec<Score, 10>, todavía Pod, todavía zero-copy, exactamente lo que construiste la lección pasada. Solo la descripción es no acotada, así que solo la descripción fuerza la escotilla de escape.
Paso 2, divide la cuenta por la frontera entre niveles. La estructura limpia mantiene juntas las dos partes Pod y aísla la parte borsh. Una forma razonable: una cuenta core Pod para la clave y la tabla de posiciones, y un BorshAccount separado para la descripción, así el estado fijo caliente sigue siendo casteable y el estado variable frío paga su propio impuesto solo cuando se lo toca.
Vale la pena señalar dos decisiones de forma en el código de abajo, porque las dos parecen ir en contra de las reglas de la lección pasada y ninguna lo hace. Primero, la tabla es un campo PodVec en vez de una cola Slab. La regla general de la lección pasada era que una lista que es el punto de la cuenta recibe una cola Slab, y una lista que cuelga de un registro más grande recibe un campo PodVec. Acá el punto de la cuenta es el registro core, clave y tabla juntas, y un Slab solo puede tener una cola, así que la tabla va como campo. Segundo, el orden de campos: [u8; 32] está arriba de un PodVec mucho más grande, lo que rompería la regla de mayor a menor si esa regla fuera sobre el tamaño. Es sobre la alineación, y las dos son alineación 1, así que no hay relleno que ningún orden pueda abrir. Ordena libremente cuando todo es alineación 1; ordena a propósito en el momento en que aparece un escalar nativo.
// Tier 1: fixed + bounded, stays zero-copy. Read with a cast.
#[account]
#[repr(C)]
pub struct CabinetCore {
    pub machine_key: [u8; 32],       // fixed - Pod
    pub board: PodVec<Score, 10>,    // bounded MAX=10 - Pod
}

// Tier 2: the ONE unbounded field, isolated behind the escape hatch.
#[account(borsh)]
pub struct CabinetDescription {
    pub text: String,                // unbounded - borsh, deserializes on read
}

#[derive(Accounts)]
pub struct EditCabinet {
    #[account(mut)]
    pub core: Account<CabinetCore>,               // cast, no deserialize
    #[account(mut)]
    pub description: BorshAccount<CabinetDescription>, // deserialize on read
    pub operator: Signer,
}
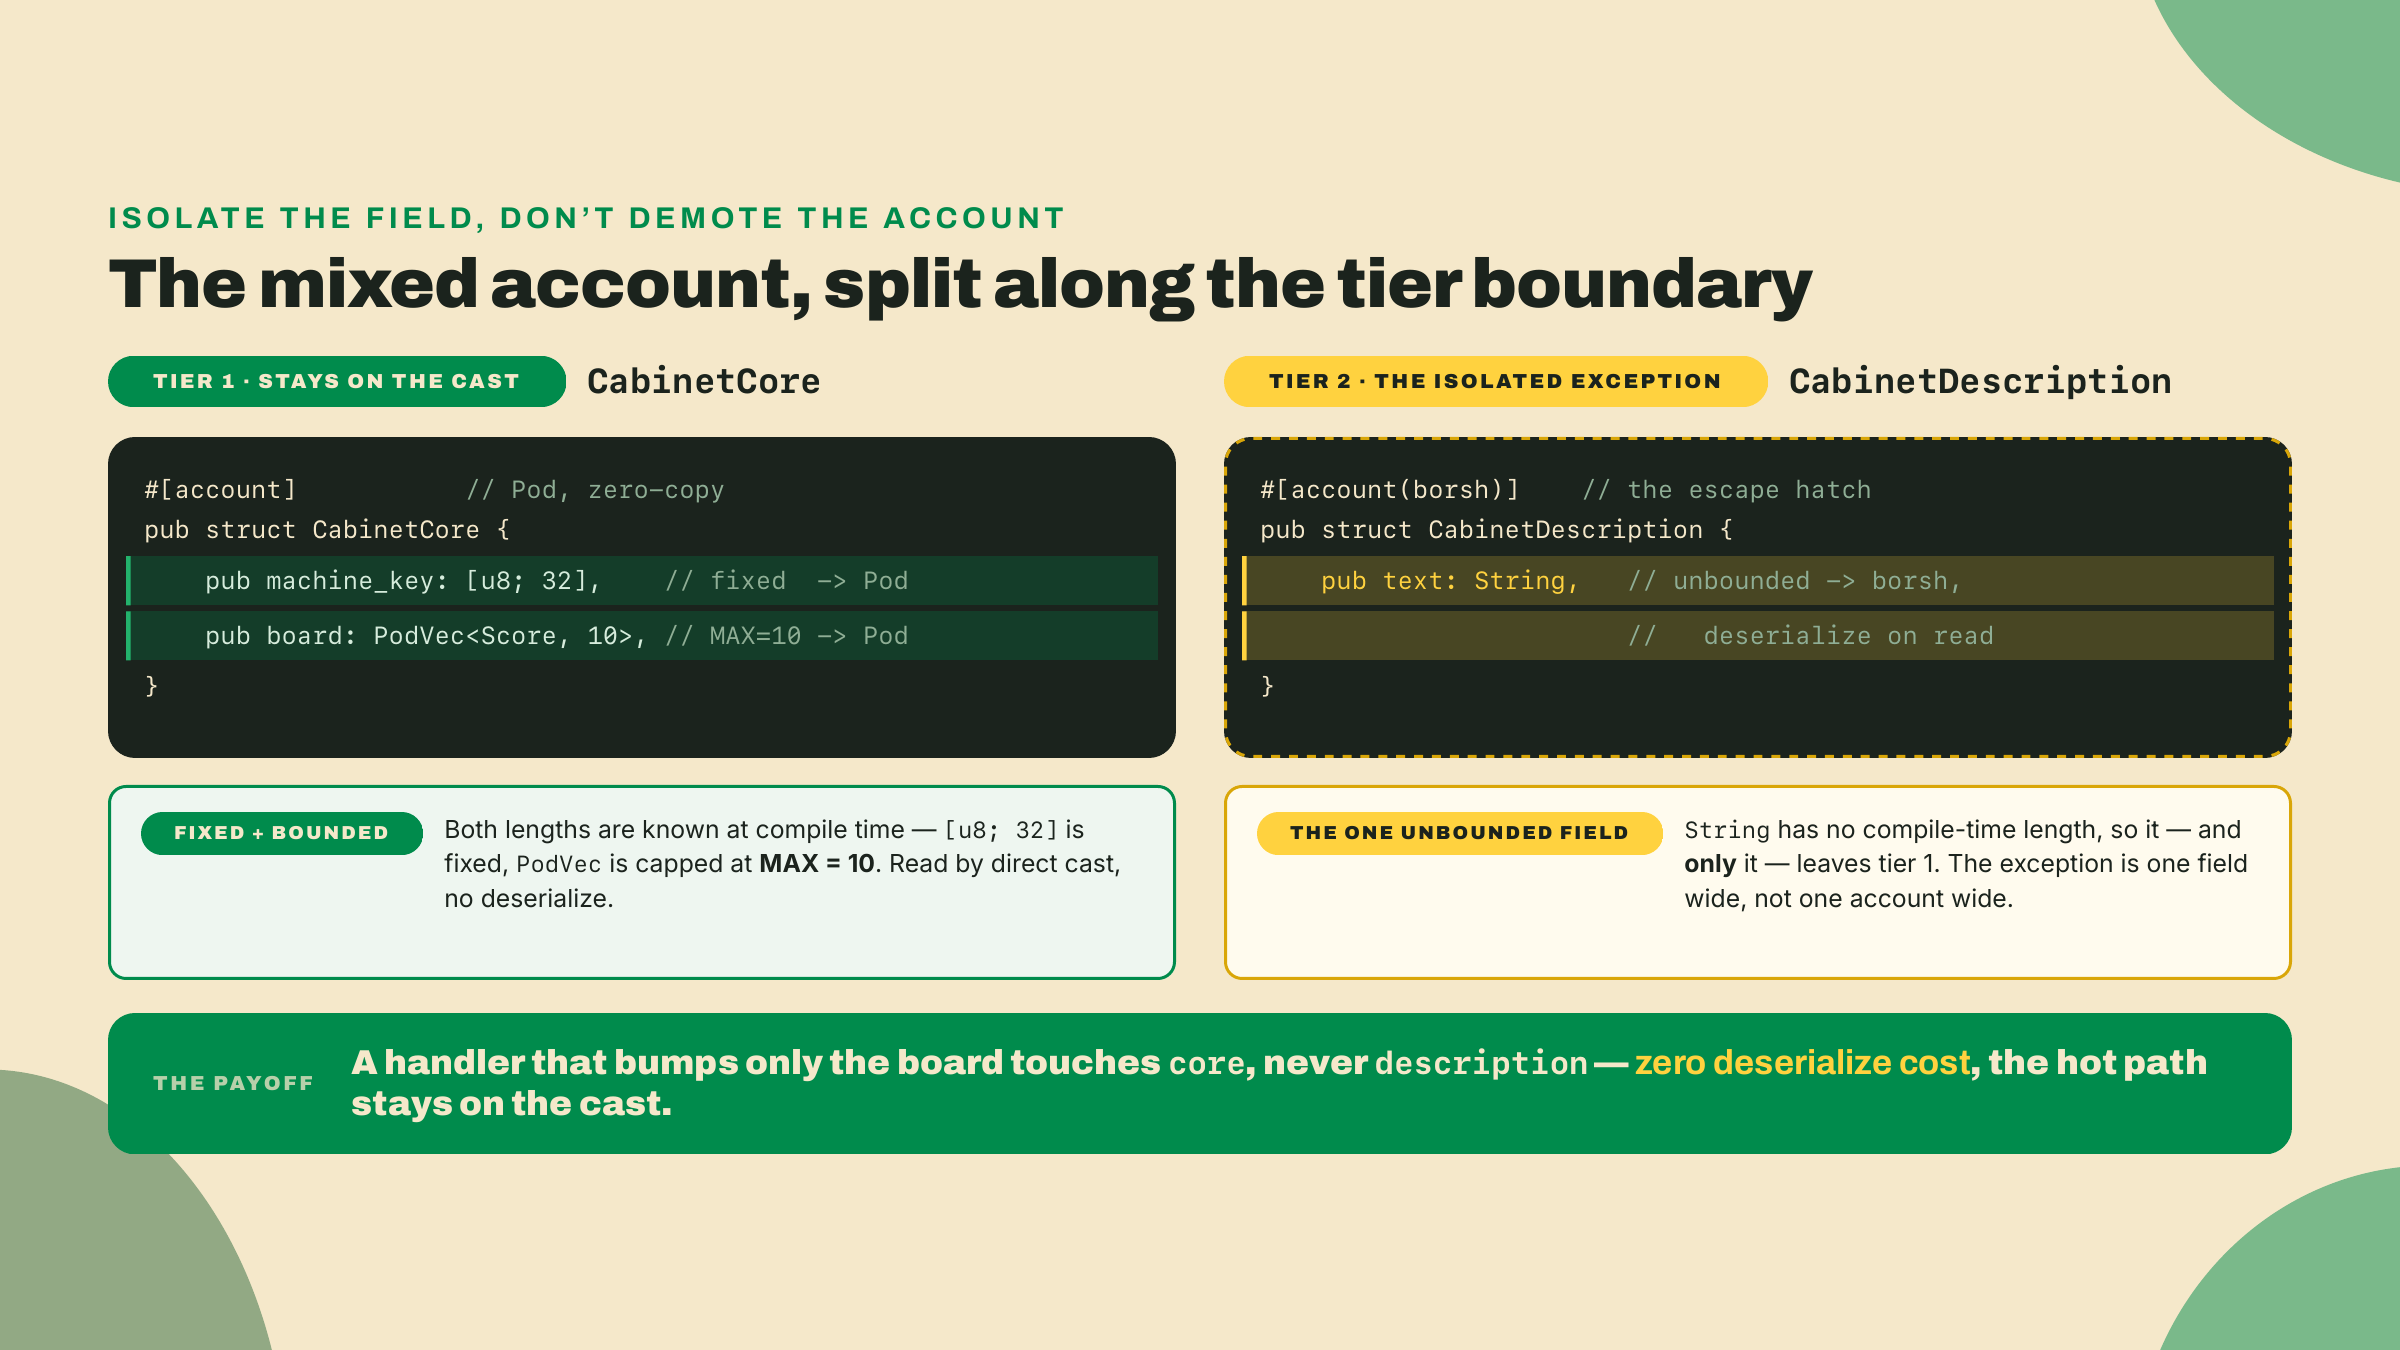
Paso 3, lee el costo que acabas de elegir. En un handler que solo actualiza la tabla de posiciones, tocas core y nunca description, así que pagas cero costo de deserialización: el camino caliente se quedó en el cast. Solo un handler que edita el texto deserializa algo. Esa es la recompensa de dividir por la frontera entre niveles en vez de irse a todo-borsh: acotaste el impuesto al único campo que lo exigía. Hay también un ángulo de rent, y apunta en la misma dirección. Una cuenta Pod se dimensiona exactamente a su layout fijo, pero una cuenta borsh tiene que asignarse lo bastante grande para la cadena más grande que vayas a guardar, así que pagas rent por el peor caso. Dividir mantiene el rent del peor caso aislado en la cuenta de la descripción, en vez de inflar la cuenta que tiene tu tabla de posiciones caliente.
Paso 4, contrasta contra los dos agujeros del wire. Mira CabinetDescription. Es un solo String, sin HashMap, sin HashSet, sin float. Así que los dos agujeros de wincode-contra-borsh son irrelevantes acá, y un cliente que decodifica borsh lo lee limpio. Esa verificación es el hábito: cada vez que un campo se va a borsh, pregunta "¿este struct lleva un map, un set, o un float que pueda ser NaN?" Si no, la compatibilidad se sostiene y sigues. Si sí, le debes una decisión a la codificación.
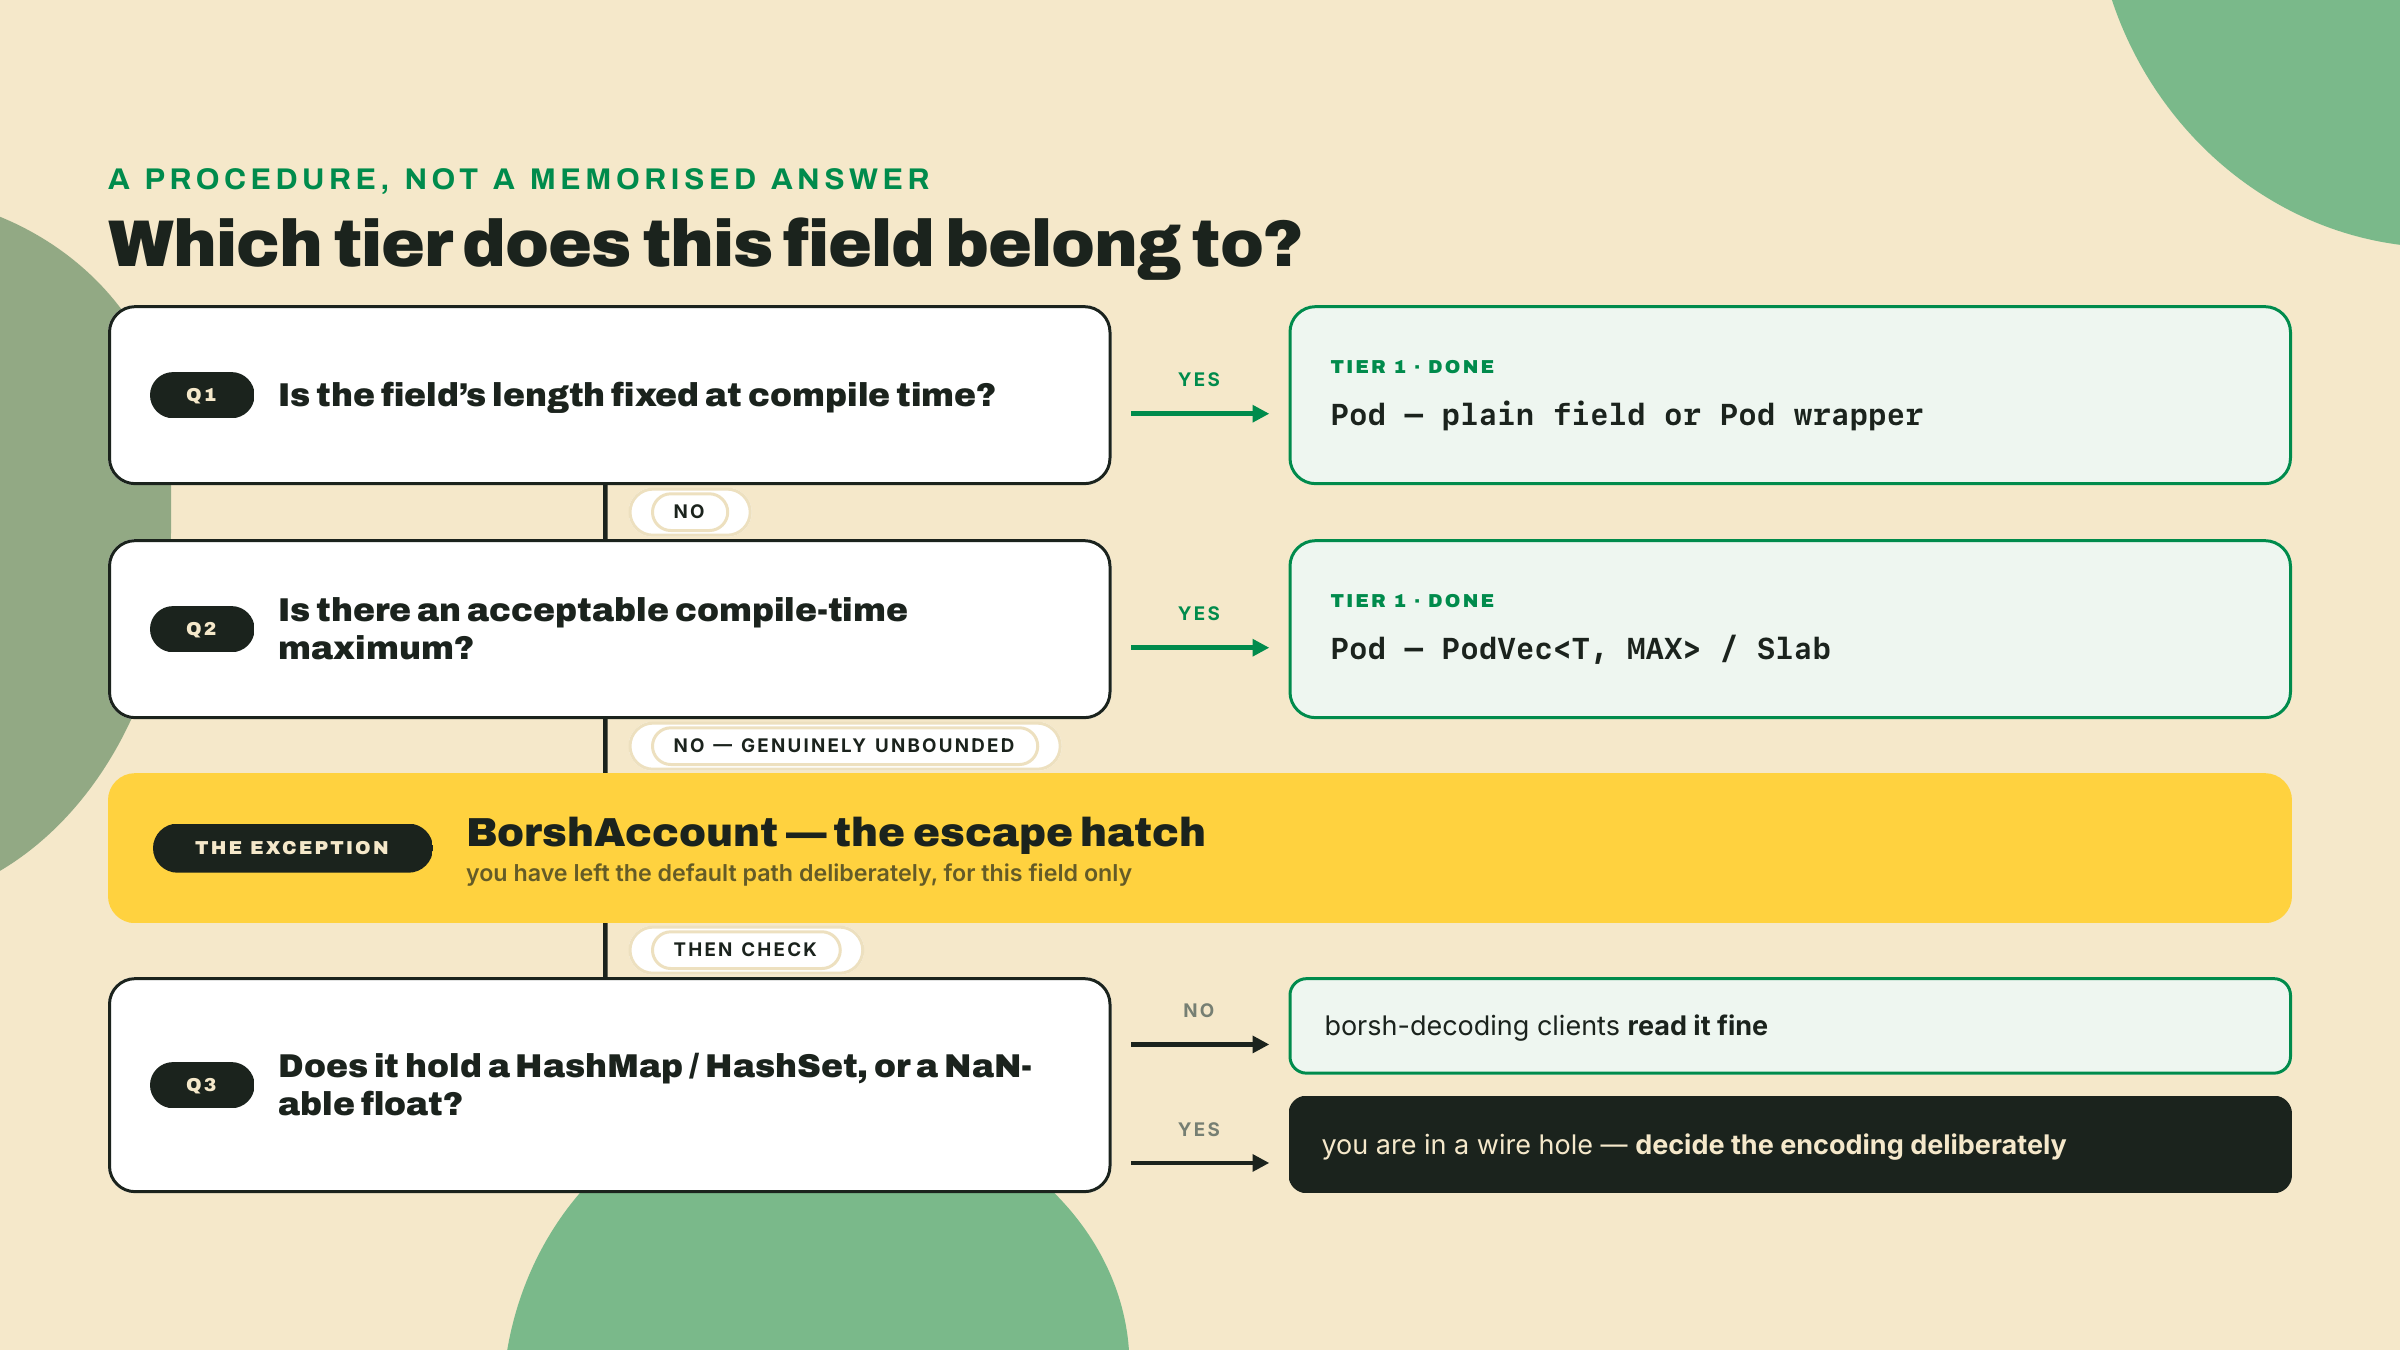
Checkpoint. Ahora deberías poder apuntar a cualquier campo de una cuenta y decir, de un tirón, a qué nivel pertenece y por qué: lo fijo va a Pod, lo acotado con un máximo conocido va a Pod, lo genuinamente no acotado va a BorshAccount, y una cuenta mixta aísla la parte no acotada en vez de degradar todo el conjunto. Si puedes hacer eso con los tres campos de arriba sin dudar, el Lab dio en el blanco.
Acá está el artefacto calificado, y es deliberadamente una decisión escrita en vez de una compilación, porque lo que se pone a prueba es el juicio, no la sintaxis. El perfil de la máquina lo hicimos juntos. Esta es una cuenta distinta, y nadie la etiquetó para ti.
El arcade necesita un libro mayor del operador: una cuenta por operador, tocada en cada pago, que guarda
payout_bps, la parte que se lleva el operador en basis points,machines, las direcciones de las máquinas que maneja este operador, sin ningún techo escrito en la especificación,settings, un HashMap de claves de configuración por máquina a valores,support_note, una nota de formato libre que el operador escribe para el personal del salón.Etiqueta cada campo como Pod o BorshAccount, da exactamente una razón por elección, y después di cuál de los campos borsh, si alguno, necesita la verificación de agujeros del wire y por qué. La forma de la respuesta es cuatro etiquetas, cuatro razones, una oración de agujeros del wire, nada más. Para calibrar la forma sin darte la respuesta, acá hay un campo que no está en la lista: "el machine_key de la máquina es Pod porque [u8; 32] tiene un largo fijo en tiempo de compilación". Una cláusula de hecho, una cláusula de razón. Si una razón tuya corre más larga que eso, probablemente estás justificando el nivel equivocado.
Dos de estos cuatro son el punto. machines es el campo que el diagrama de flujo te hace interrogar en vez de responder: corre Q2 con honestidad, porque "sin techo escrito en la especificación" no es la misma afirmación que "genuinamente no acotado", y cuál de las dos resulte ser decide el nivel. Y este libro mayor se toca en cada pago, lo que quiere decir que es una cuenta caliente, así que de los campos que caigan en el nivel 2 deberías decir además si pertenecen a esta cuenta o a una separada, como el Lab separó la descripción.
Escribe el artefacto; el prompt vive en operator-ledger/prompt.md y mi etiquetado de referencia resuelto en operator-ledger/reference.md. Lee la referencia solo después de tener tus propias cuatro etiquetas en papel, y donde no estés de acuerdo con ella, la pregunta interesante no es quién tiene razón sino cuál de Q1 y Q2 del diagrama de flujo respondieron distinto los dos. Ese desacuerdo es toda la habilidad.
La lección acá nunca fue "borsh es malo". Aprendiste dónde se encuentran los dos niveles, y ahora puedes pararte en esa costura y poner cualquier campo del lado correcto: el estado fijo y acotado casteado directo desde los bytes por la ganancia de CU, el estado genuinamente no acotado aislado detrás de BorshAccount<T>, y los dos agujeros de wire de wincode-contra-borsh verificados cada vez que sale la escotilla de escape. Ese es el modelo completo de estado on-chain que este curso necesitaba que dominaras antes de poder darle una dirección a ese estado.
Porque eso es lo que viene. Ahora puedes modelar cualquier estado, fijo, acotado o no acotado, y elegir el nivel correcto para cada campo. Lo que todavía no puedes hacer es encontrar ese estado de forma determinista, ni decir quién es su dueño. El próximo módulo le da a tus cuentas una dirección y un dueño: direcciones derivadas de programa, bumps canónicos precomputados en tiempo de expansión de macros, y el catálogo completo de constraints de V2. Abre con el quarter-vault, la cuenta de crédito prepago cuya dirección nadie reparte porque el programa la vuelve a derivar, él solo, desde la clave del jugador, todas y cada una de las veces.
Pregunta 1 de 4