Cargando...

 BetaBeta
Acabas de reconstruir el quarter-vault nativo sobre pinocchio: un discriminator manual de un byte, validación con TryFrom, un invoke_signed hecho a mano, y pasó la misma barrera de withdraw en LiteSVM que pasó R2. Los lamports salieron del PDA bajo autoridad del programa, el over-withdraw fue rechazado, y no había Anchor en ninguna parte del crate. Esa era la mitad de construir de constrúyelo-dos-veces. Esta es la mitad de reencuadrar.
Acá está la afirmación estructural, dicha primero para que te vayas con ella aunque no leas nada más. El #[derive(Accounts)] que borraste la lección pasada es exactamente el load, la verificación y el despacho que acabas de escribir a mano, más un recorrido de cuentas duplicadas y una guarda de borrow que no puedes omitir por accidente. Puedes salirte del recorrido, deliberadamente, por campo, y la escritura te hace decirlo en voz alta. Leer la expansión demuestra esa frase, línea por línea, contra tu propio código.
Así que leámosla. La herramienta que imprime el código que genera una macro es cargo-expand. Instálala una vez y apúntala a tu vault de framework:
cargo install cargo-expand   # re-check crates.io for a newer version at build time
# The expansion itself runs under a nightly rustc (-Zunpretty=expanded is a nightly
# flag): `rustup toolchain install nightly` once, and cargo-expand finds it on its
# own. The workspace stays pinned to stable 1.89.0; only the expansion borrows nightly.
cargo expand --package quarter-vault > expanded.rs
Abre expanded.rs y busca bloques impl cerca de tu struct Withdraw. Lo que estás mirando es una función try_accounts que el derive escribió por ti, y está haciendo los mismos trabajos de cargar-y-verificar que hacía tu TryFrom nativo, en un orden que ahora puedes nombrar. Ese archivo, al lado de tu vault nativo, es la lección entera. Todo lo de abajo anota el diff.
Una expectativa que ajustar antes de que mires, porque te va a salvar de cazar algo que no está ahí. Cada bloque generado que se imprime abajo es una versión estilizada de la salida de verdad: la misma estructura y el mismo orden, con el ruido sacado. La expansión de verdad son miles de líneas de rutas completamente calificadas, lifetimes generados y bloques #[automatically_derived], y leerla al pie de la letra te enseña menos que leerla contra un boceto. Así que los bocetos son un mapa, no una transcripción, y los identificadores que traen son descriptivos en vez de exactos. Cuando el Lab te pida encontrar algo en tu propia salida, te va a dar el patrón para grepear en vez de un nombre de símbolo para hacer coincidir, exactamente por esa razón.
El repliegue de la ayuda de esta lección: el recorrido del diff está completamente trabajado, hecho por ti pieza por pieza. El Lab te hace correr cargo expand sobre tu propio vault y anotar la salida de verdad contra tu código nativo. La barrera de tres líneas del final es Solo, sin apoyo.
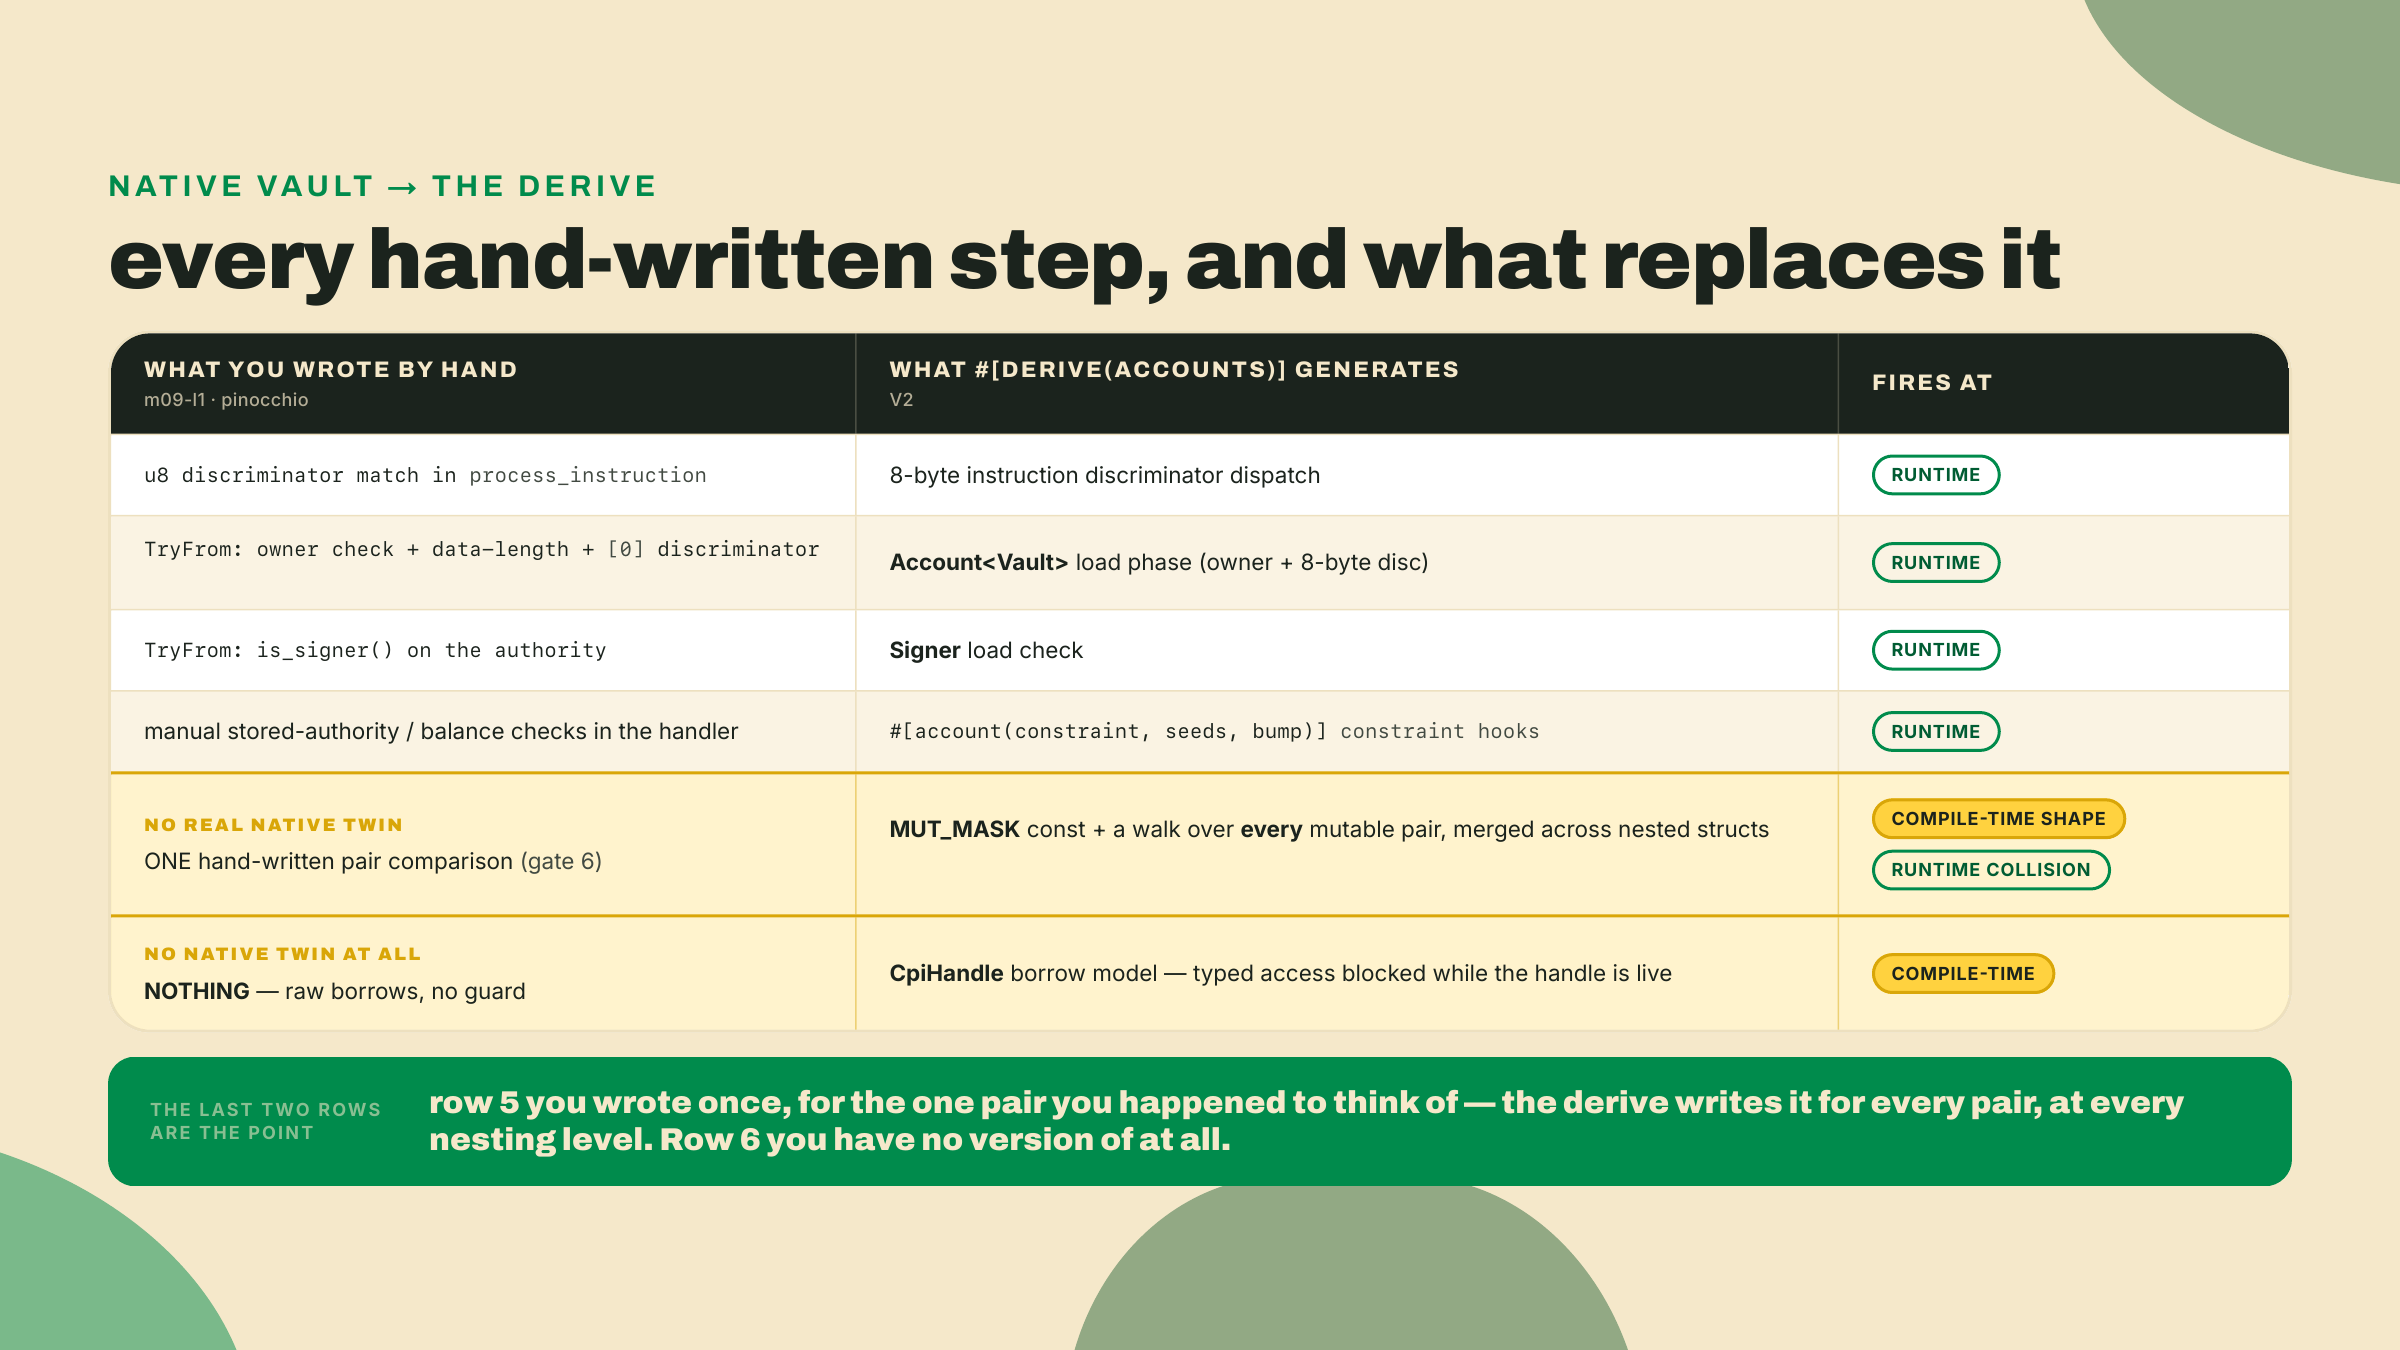
Abre tu TryFrom nativo para el withdraw. Corría seis barreras antes de que corriera el handler, y las corría en un orden que elegiste tú. Acá está la mitad de load de eso, recortada a las cuatro barreras que tienen una gemela generada:
impl<'a> TryFrom<(&'a [u8], &'a [AccountInfo])> for Withdraw<'a> {
    type Error = ProgramError;

    fn try_from(
        (data, accounts): (&'a [u8], &'a [AccountInfo]),
    ) -> Result<Self, ProgramError> {
        let [authority, config, vault, _system_program, ..] = accounts else {
            return Err(ProgramError::NotEnoughAccountKeys);
        };

        // 1. signer check on the authority
        if !authority.is_signer() {
            return Err(ProgramError::MissingRequiredSignature);
        }
        // 2. owner check: the config PDA must be owned by THIS program
        if !config.is_owned_by(&crate::ID) {
            return Err(ProgramError::IncorrectProgramId);
        }

        let cfg = config.try_borrow_data()?;

        // 3. data-length check, then 4. discriminator check
        if cfg.len() != CONFIG_LEN {
            return Err(ProgramError::InvalidAccountData);
        }
        if cfg[0] != VAULT_DISCRIMINATOR {
            return Err(ProgramError::InvalidAccountData);
        }
        // gates 5 (stored authority) and 6 (duplicate-mutable) follow; see m09-l1
        // ...
    }
}
Un puente de nomenclatura, para que el diff se lea limpio, y vale ser exacto porque los dos builds no comparten direcciones. Los dos programas tienen los mismos dos roles: un registro propiedad del programa que sostiene el discriminator, la authority y un bump, y una cuenta propiedad del System que sostiene el SOL de verdad. Nativamente les decías config y vault, con seeds [b"config", authority] y [b"vault", authority]. La versión de framework les dice state y sol_vault, con seeds [b"vault", authority] y [b"sol", authority]. Ids de programa distintos y literales de seed distintos, así que estas son cuatro direcciones distintas, no dos. Lo que mapea a través es el rol, y esa es la única cosa que afirma el diff de abajo. Donde la versión nativa guarda un bump (el del vault de SOL) y deriva el del config a partir de los datos de instrucción, la versión de framework guarda los dos, que es la única diferencia estructural que vale llevarse: es por eso que state.bump y state.sol_bump los dos aparecen en los constraints de abajo y solo un byte aparece en tu layout nativo.
Ahora mira el código V2 que generó el equivalente. Son cuatro campos y dos atributos:
#[derive(Accounts)]
pub struct Withdraw {
    #[account(mut)]
    pub authority: Signer,

    #[account(
        mut,
        seeds = [b"vault", authority.address().as_ref()],
        bump = state.bump,
        constraint = state.owner == *authority.address() @ VaultError::Unauthorized,
    )]
    pub state: Account<Vault>,

    #[account(
        mut,
        seeds = [b"sol", authority.address().as_ref()],
        bump = state.sol_bump,
    )]
    pub sol_vault: SystemAccount,

    pub system_program: Program<System>,
}
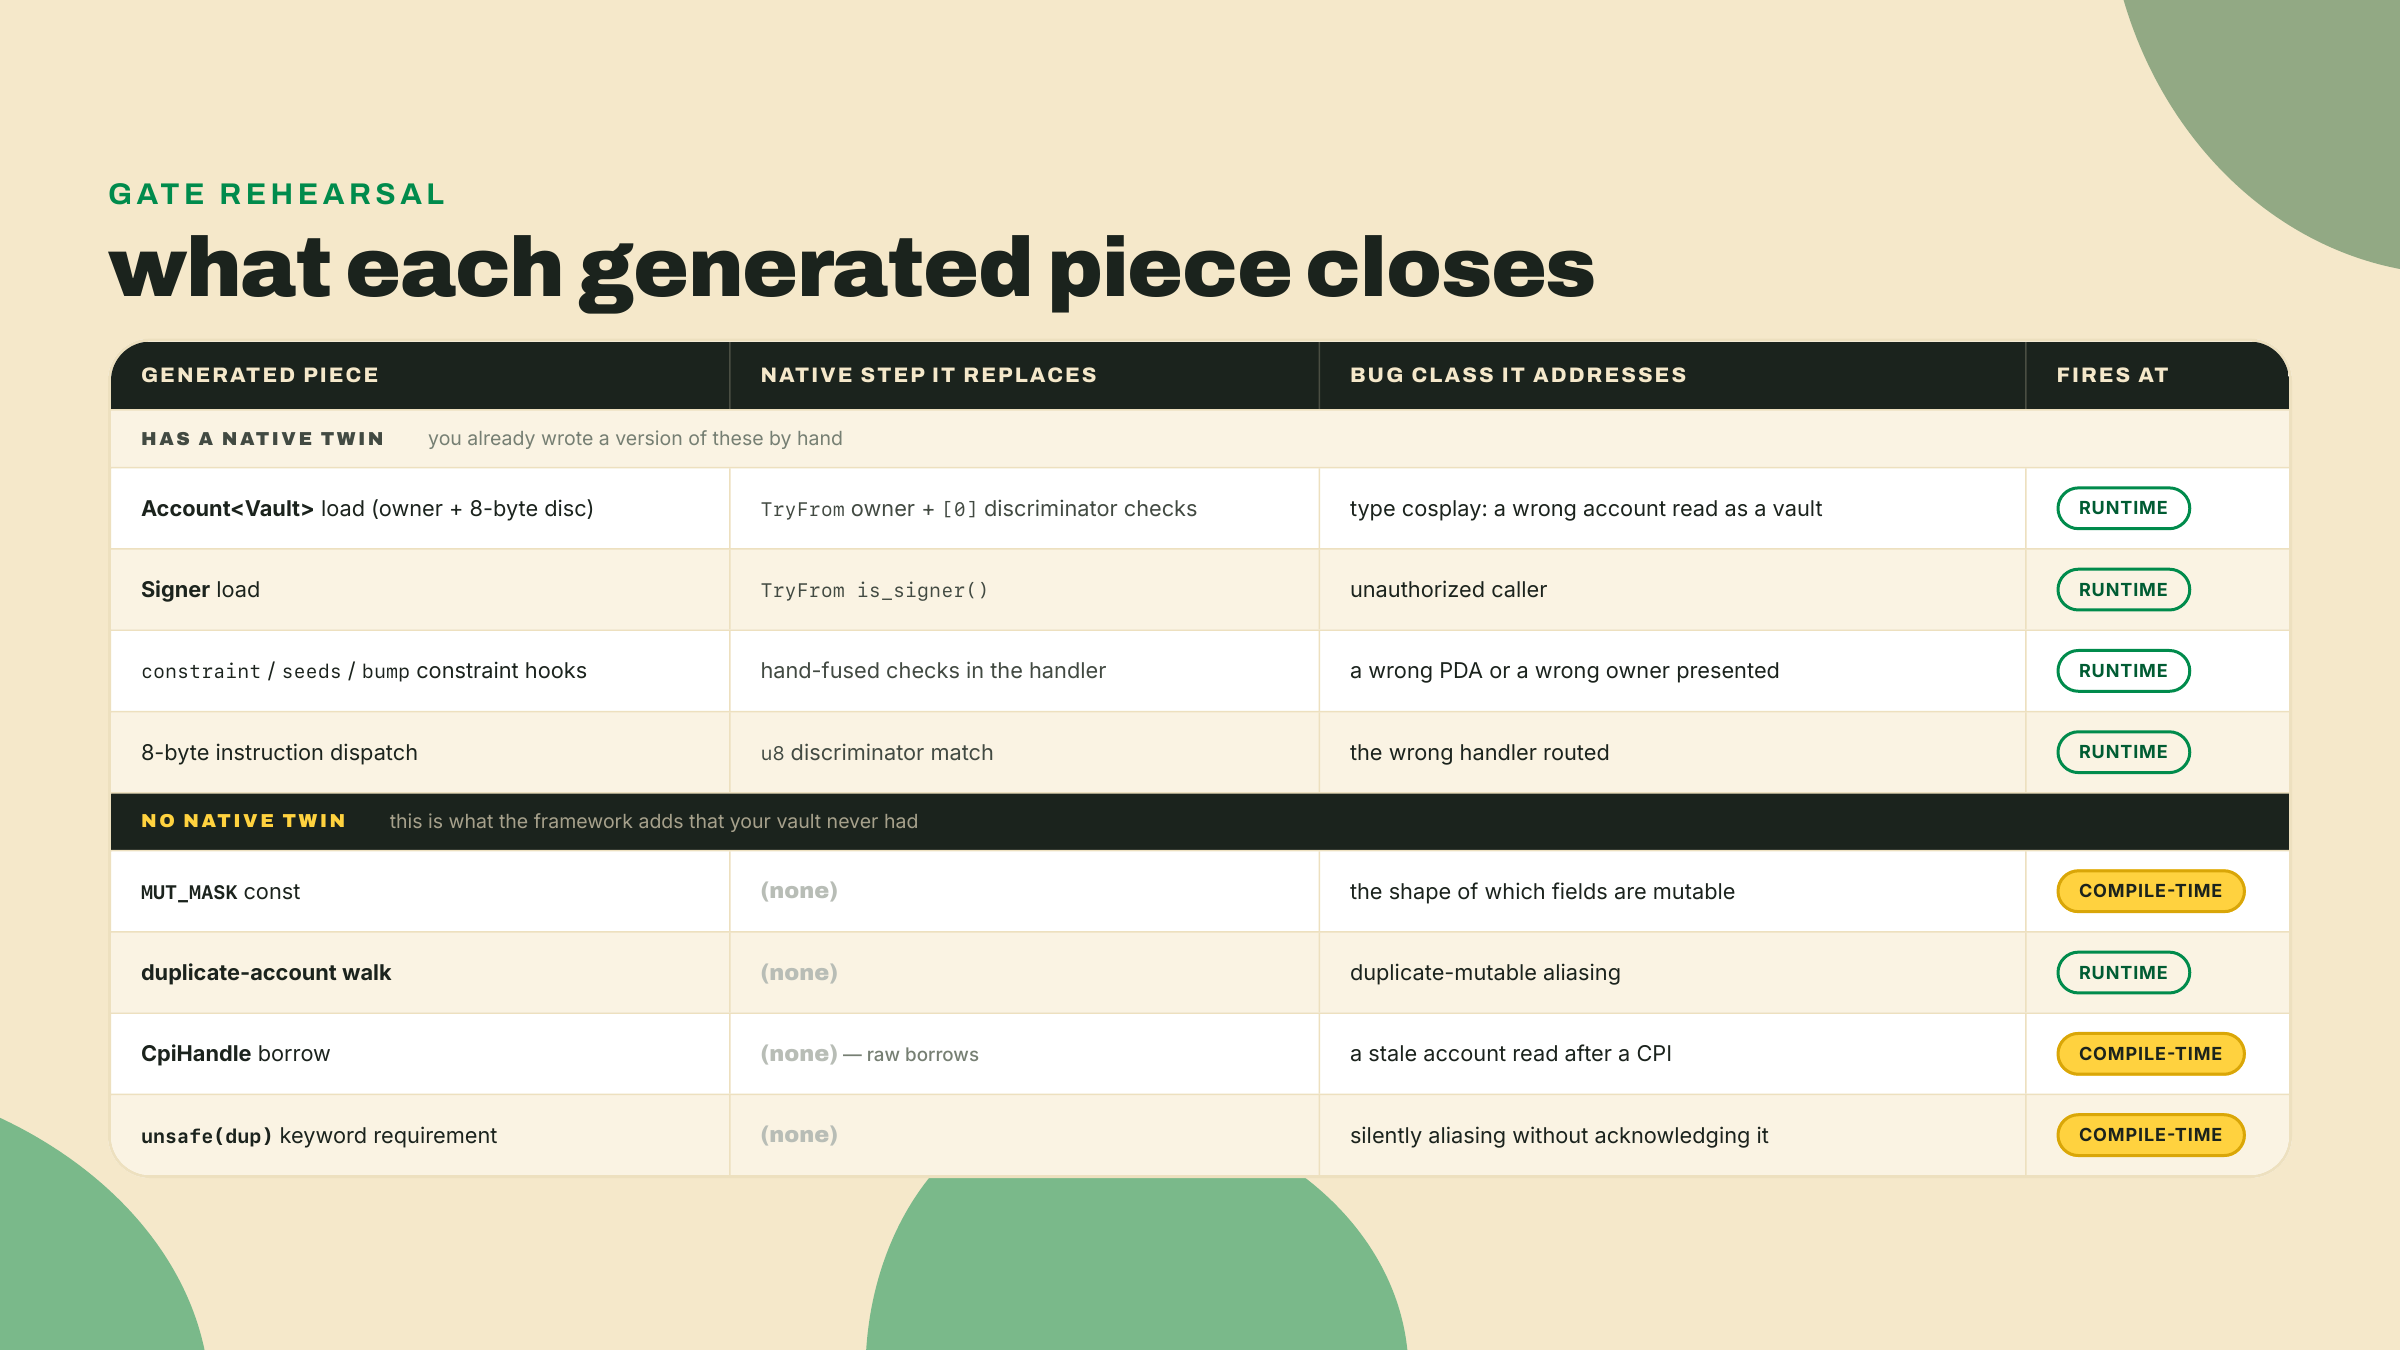
Tus cuatro verificaciones nativas están todas ahí adentro, y la expansión lo vuelve obvio. Abriste esta misma maquinaria de try_accounts en el módulo 1, sobre el greeter, en abstracto. Acá está otra vez, pero ahora cada línea generada tiene una gemela escrita a mano a la que puedes apuntar. Account<Vault> sobre el campo state genera la verificación de dueño (tu verificación 2) y la verificación del discriminator de 8 bytes (tu verificación 4) adentro de su load, antes de que corra cualquier constraint. Signer sobre authority genera tu verificación de firmante (verificación 1). La guarda de data.len() que escribiste a mano (verificación 3) es el load mismo negándose a leer un slice demasiado corto para el tipo. Nota la única asimetría: la tuya era igualdad exacta, cfg.len() != CONFIG_LEN, así que una cuenta propiedad del programa que es demasiado larga falla tu verificación y pasa la del framework. Ninguna de las dos está equivocada, son afirmaciones distintas. La igualdad exacta es una declaración más fuerte sobre la forma de la cuenta; un mínimo es lo que un framework puede prometer para cada tipo de cuenta que no conoce. Cuatro declaraciones if escritas a mano se colapsan en dos anotaciones de tipo, y el tipo es la verificación.
Nota la escritura de los constraints mientras estás acá, porque es un delta de V2 que el módulo de migración te va a hacer aplicar a mano. Sobre la línea v1 esta verificación de clave guardada era la keyword has_one = owner. V2 deprecia has_one a favor de las formas de expresión. Todavía parsea (y el derive deliberadamente mantiene el span de código de la keyword solo para que la generación de código pueda subrayarla con una advertencia), pero las escrituras recomendadas ahora son address = expr para el caso común de "esta cuenta tiene que ser igual a esa clave guardada" y constraint = expr @ err cuando necesitas una comparación que la keyword angosta nunca podría expresar. El módulo 3 enseñó el cambio. Acá solo estás leyendo su salida.
Un hecho estructural que la expansión fija, y es el que la gente se equivoca. El orden de los campos es el orden de load. El derive recorre tu struct de arriba para abajo, así que authority carga antes de state, que es por lo que el constraint sobre state puede comparar con seguridad contra un campo declarado arriba de él. Reordena los campos y genuinamente cambias qué verificación corre contra datos cargados en vez de contra datos no cargados. En tu versión nativa controlabas ese orden a mano, eligiendo dónde poner cada if. El framework lo controla por la posición del campo. El mismo orden, otra palanca.
Vuelve eso concreto, porque es el único lugar donde el orden de los campos no es cosmético. El constraint sobre state lee el campo owner de adentro de la cuenta state cargada y lo compara contra el authority declarado arriba. Si movieras state arriba de authority en la struct, el constraint referenciaría un campo que todavía no había cargado, y el derive rechazaría la struct en tiempo de compilación en vez de correr una verificación contra nada. Nativo, el mismo error es un reordenamiento silencioso de dos bloques if que ningún compilador marcaría jamás. El framework convirtió una disciplina de orden en una garantía de orden.
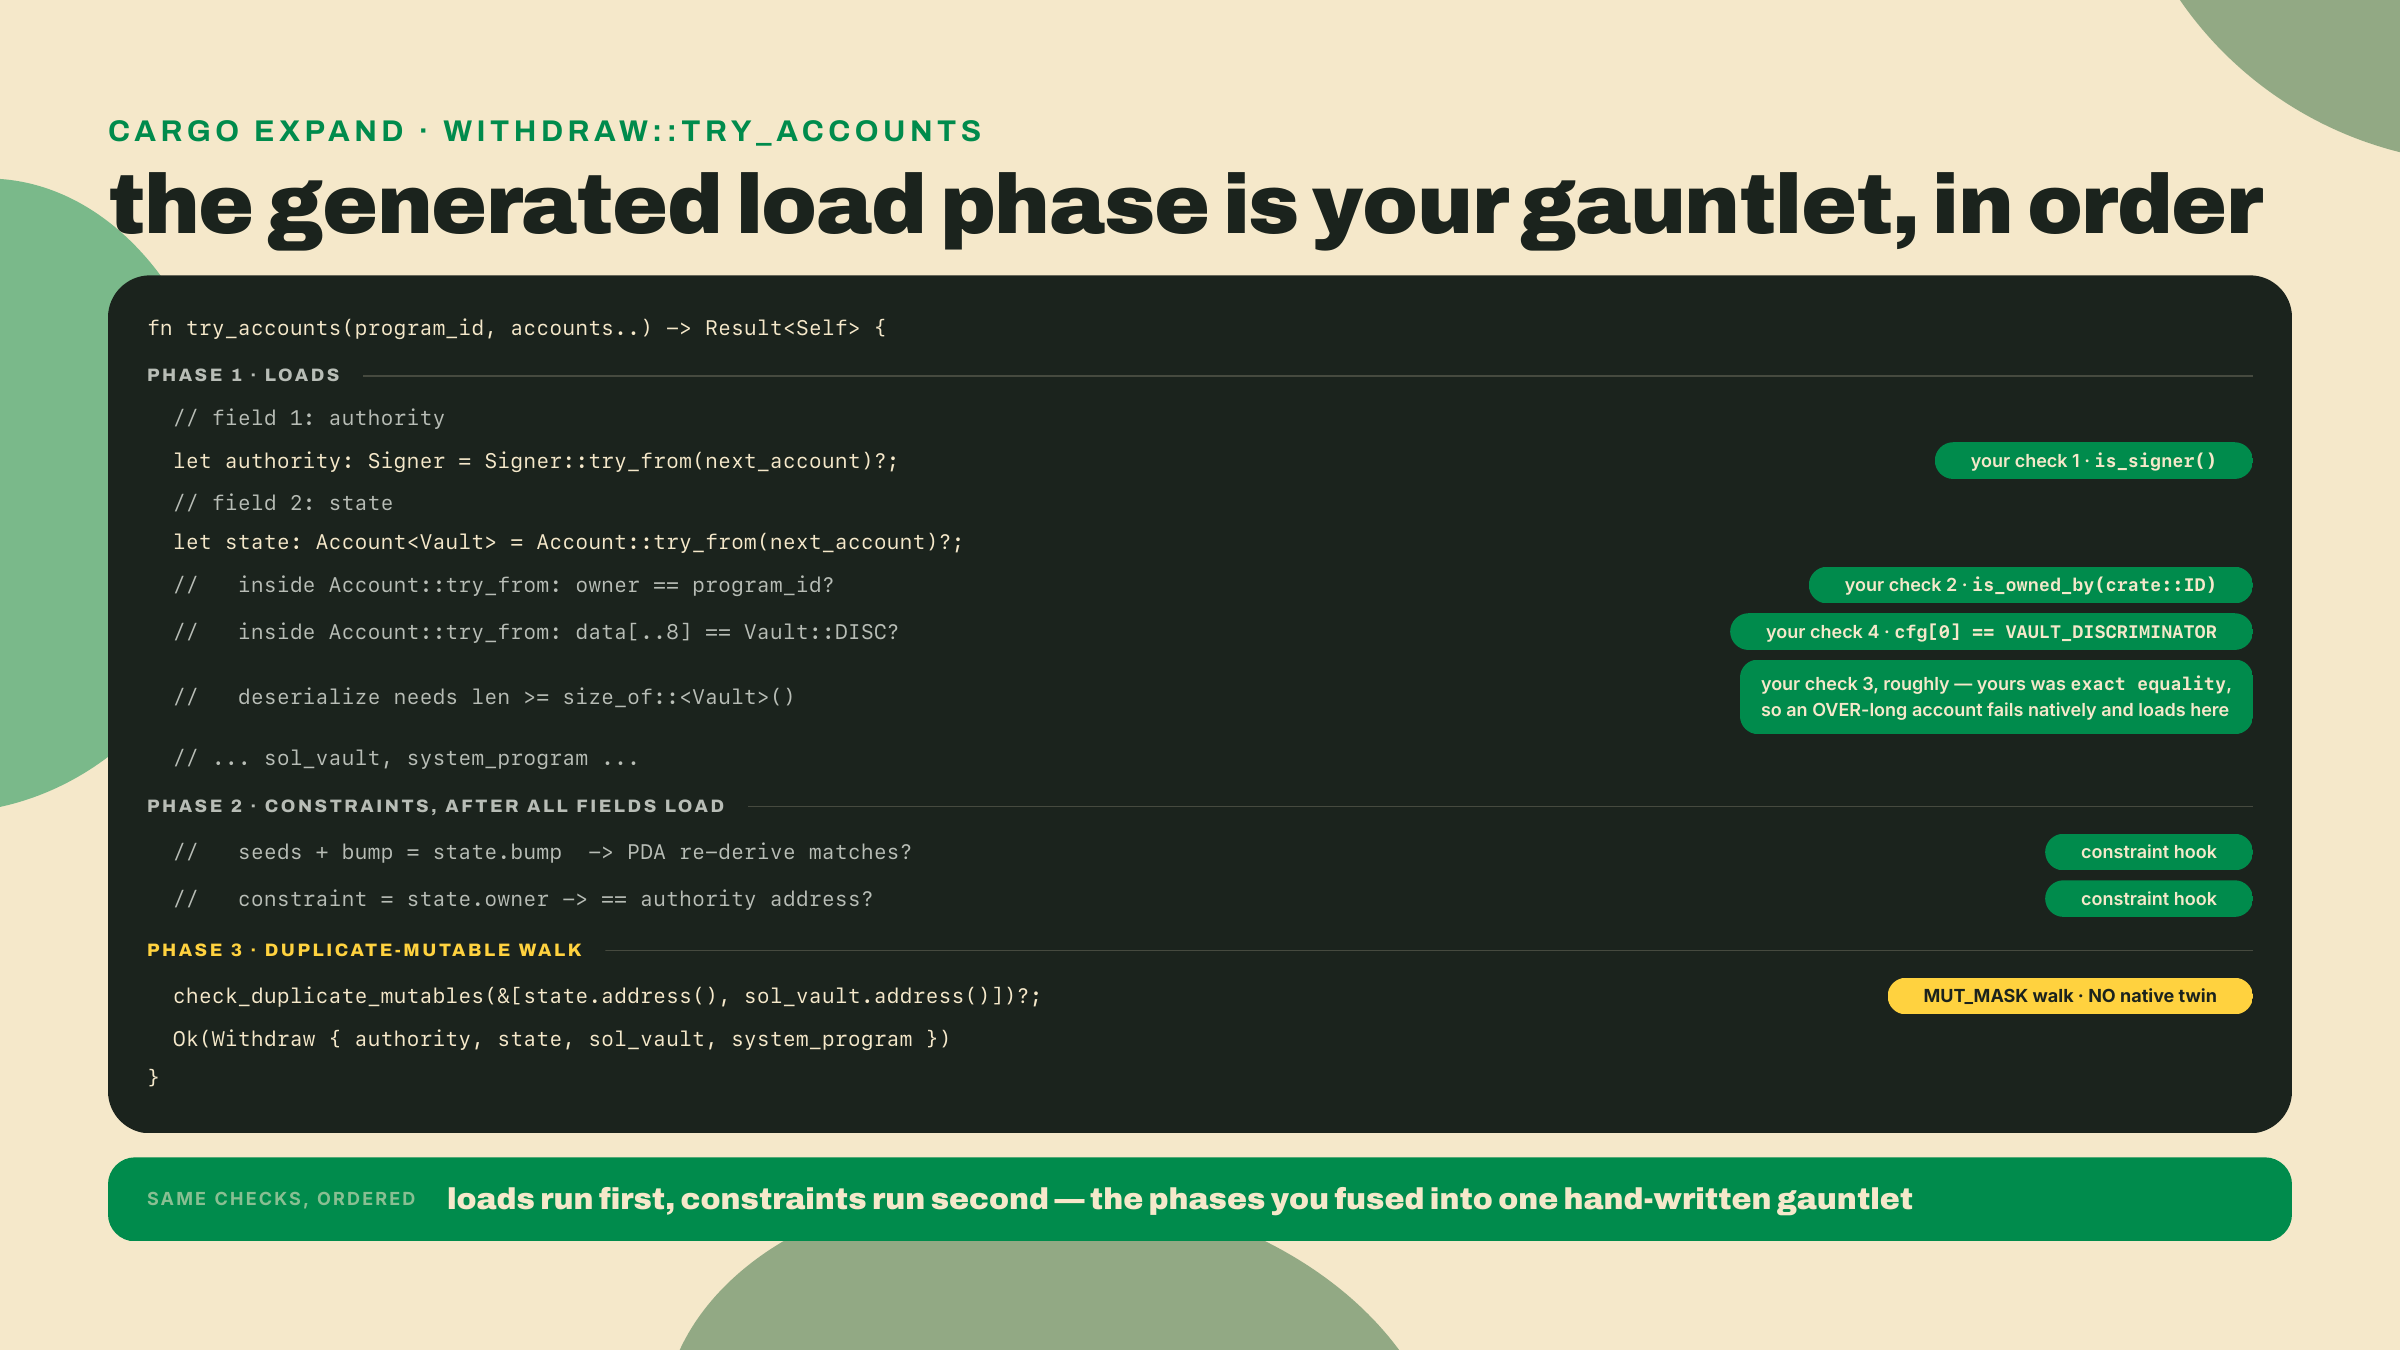
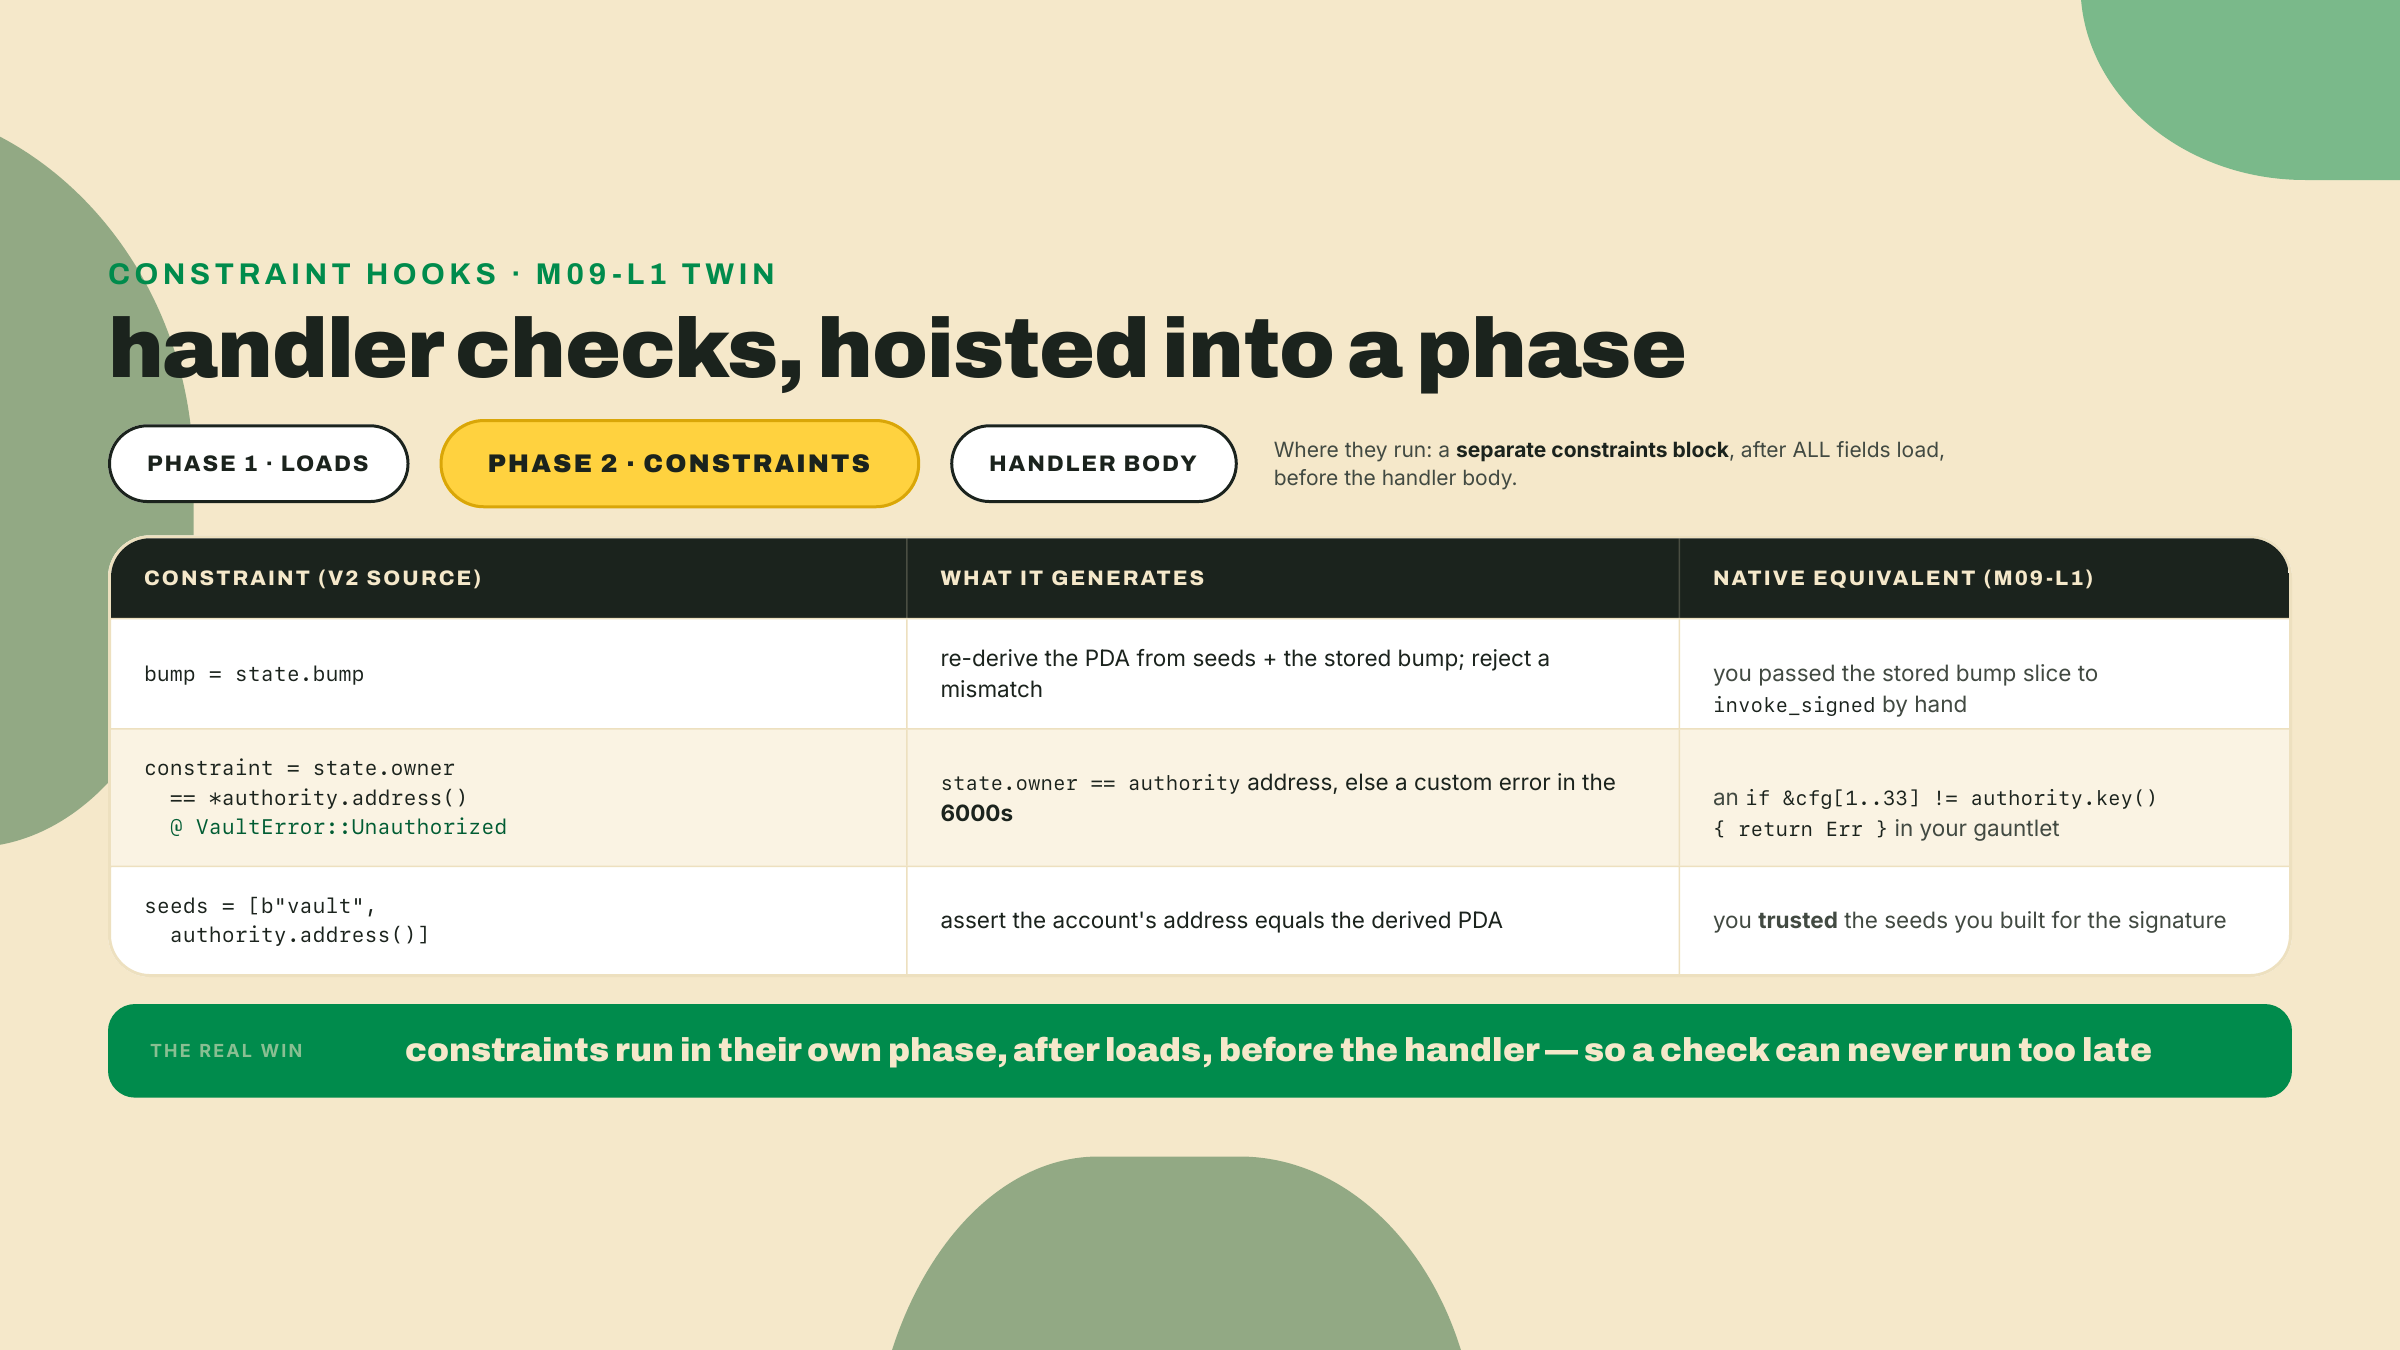
La fase de load demuestra que cada cuenta es lo que dice ser. Los hooks de constraint demuestran que las cuentas se relacionan correctamente entre sí. En el código de arriba, seeds, bump = state.bump, y la cláusula constraint = state.owner == ... son hooks de constraint, y la expansión los pone en un bloque distinto que corre solo después de que cada campo cargó.
Escribiste estas a mano también, solo que fusionadas adentro de tu handler en vez de separadas. Tu withdraw nativo volvía a derivar el PDA y lo comparaba, o confiaba en las seeds que le pasabas a invoke_signed; leía state.owner y rechazaba a un llamador que no coincidiera. El framework saca esa lógica del handler por completo y la corre como una fase separada, que es por lo que un constraint de V2 nunca puede dispararse "demasiado tarde". Físicamente no puede correr después de tu handler, porque vive en una función que termina antes de que empiece tu handler. Nativo, esa garantía era tu disciplina. Generada, es estructural.
Tu programa nativo ruteaba instrucciones con un match sobre el primer byte de los datos de instrucción: 0 era init, 1 era withdraw. Ese era el dispatcher entero. El dispatcher de V2 hace el trabajo idéntico con una etiqueta de 8 bytes en vez de un byte. Lee los ocho bytes iniciales de los datos de instrucción, los hace coincidir contra el discriminator de instrucción de cada handler, y rutea al handler correcto. Después, y solo después, corre try_accounts para esa instrucción.
La diferencia es el ancho, no la clase. Un byte te da 255 instrucciones; ocho bytes de sha256 sobre global:withdraw te dan una etiqueta resistente a colisiones que un cliente puede armar sin coordinar un registro de números contigo. Cambiaste un byte por un hash y compraste compatibilidad de wire. Ese es el upgrade entero. Si internalizaste la trampa del namespace global: sobre el greeter en el módulo 1, ya sabes el único lugar donde esto muerde: no existe ningún namespace instruction:, y una etiqueta armada a mano desde el preimage equivocado rutea hacia nada.
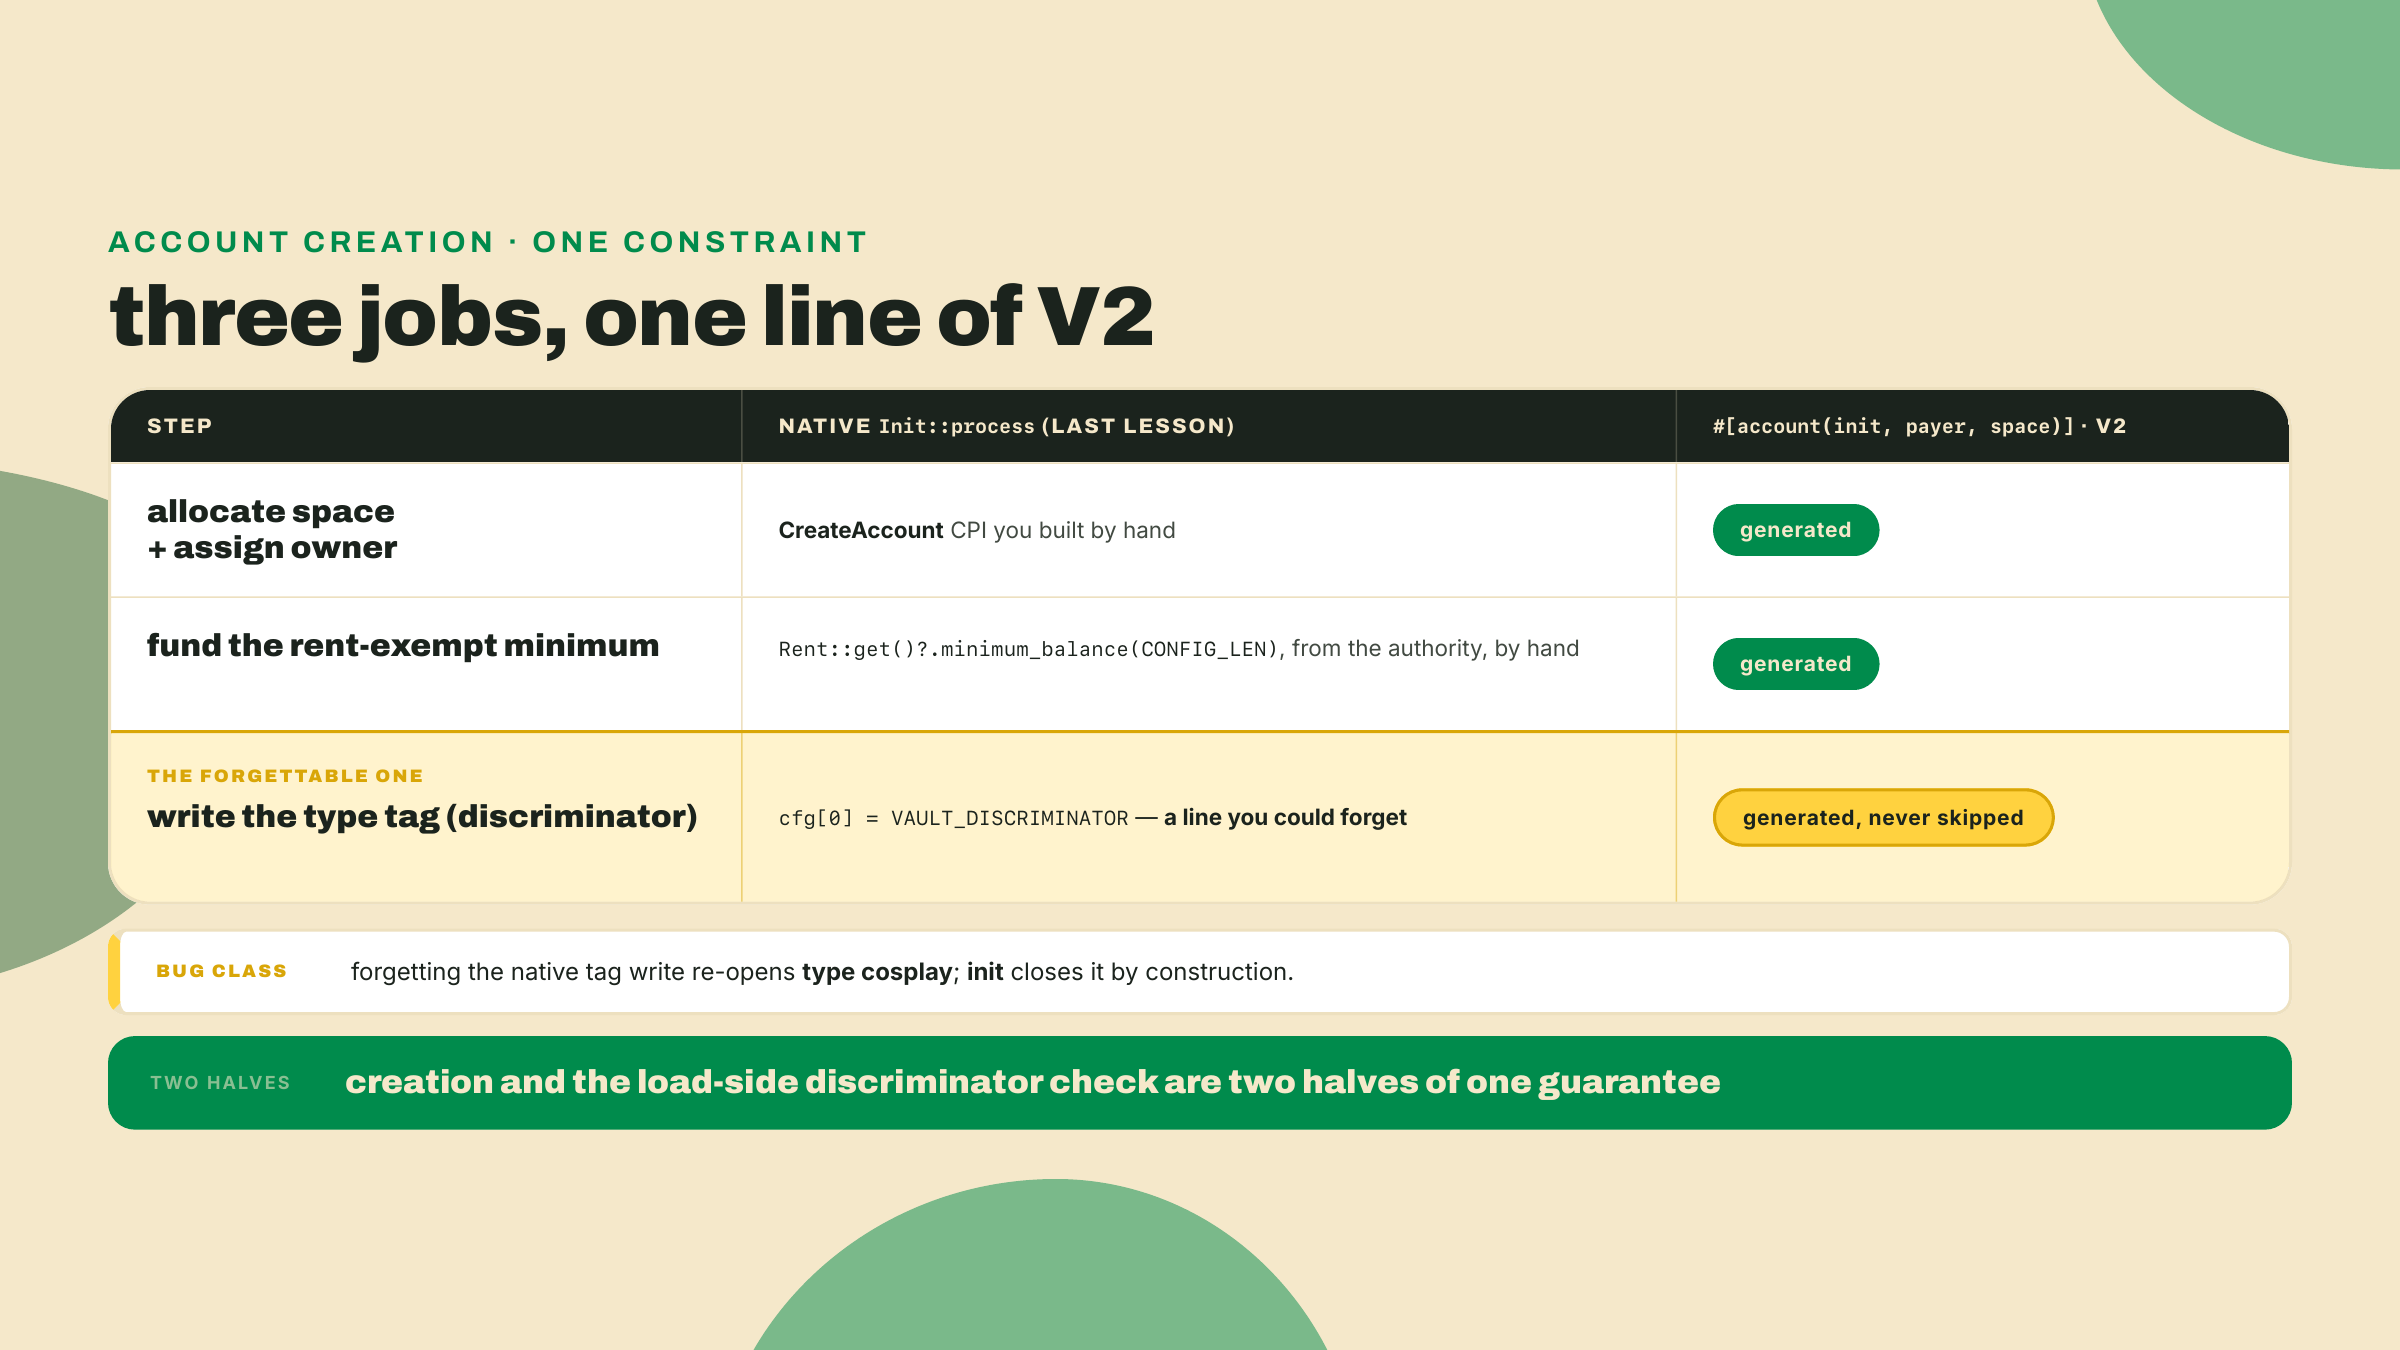
El camino de withdraw muestra load, verificación y despacho. Hay un trabajo que el withdraw nunca toca, y diffearlo es donde la clase de bug del discriminator vuelve a casa: la creación de cuentas. Tu Init::process nativo creaba la cuenta de config a mano. Computabas los lamports exentos de alquiler, corrías una CPI de CreateAccount para asignar el espacio y poner tu programa como dueño, y después, críticamente, escribías la etiqueta de tipo en el byte cero tú mismo:
// native Init::process: fund rent, allocate, assign owner, THEN tag the account by hand
let lamports = Rent::get()?.minimum_balance(CONFIG_LEN);
CreateAccount {
    from: self.authority,
    to: self.config,
    lamports,
    space: CONFIG_LEN as u64,
    owner: &crate::ID,
}
.invoke_signed(&signer)?;
// forget this next line and the account has NO discriminator: type cosplay is now open
let mut cfg = self.config.try_borrow_mut_data()?;
cfg[0] = VAULT_DISCRIMINATOR;
El código V2 que genera todo eso es un solo constraint:
#[account(
    init,
    payer = authority,
    space = Vault::DISCRIMINATOR.len() + Vault::INIT_SPACE,
    seeds = [b"vault", authority.address().as_ref()],
    bump,
)]
pub state: Account<Vault>,
init genera la CPI de CreateAccount, computa y fondea el mínimo exento de alquiler desde payer, y escribe el discriminator en la cuenta nueva, los tres. La única línea que era más probable que olvidaras nativamente, etiquetar el byte cero, es la que el framework nunca va a saltear. Sáltate la etiqueta en tu init hecho a mano y cualquier cuenta propiedad del programa del mismo largo puede después deserializarse como un vault, la clase exacta de type cosplay que la verificación del discriminator del lado del load existe para cerrar. Nativo, la creación y la validación son dos lugares que tienes que mantener de acuerdo a mano. Generado, init a la entrada y la verificación del load a la salida son dos mitades de una sola garantía que el derive escribe juntas.
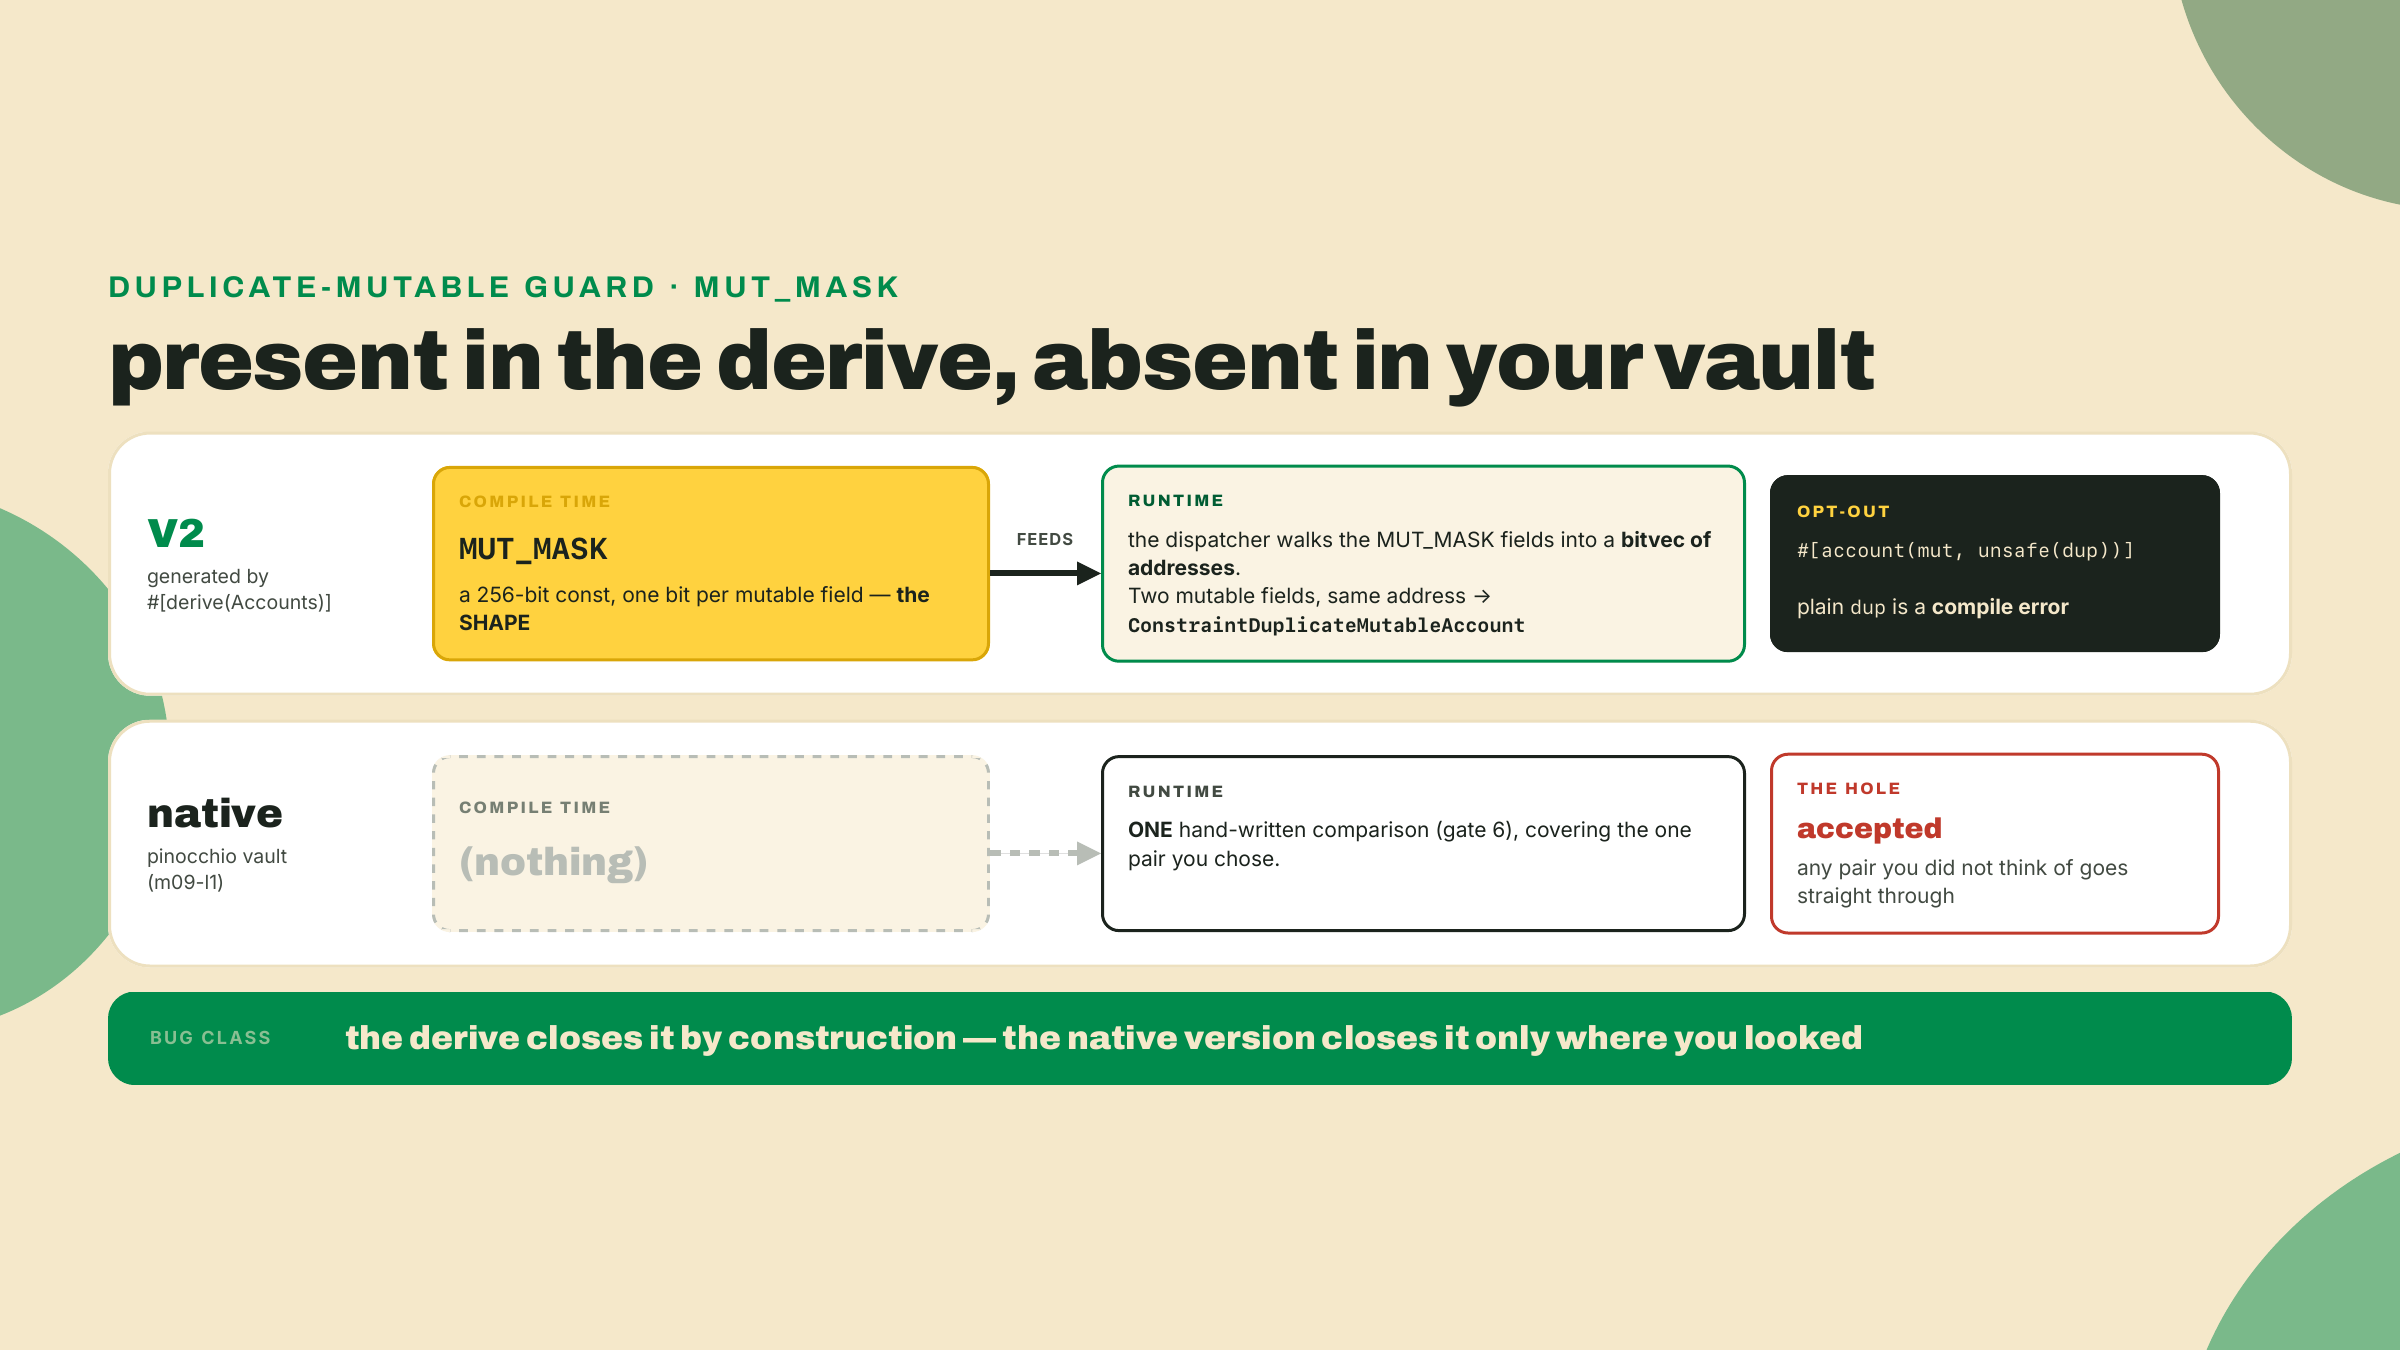
Acá está el primer lugar donde la expansión hace algo que tu código nativo solo gesticula. Busca el try_accounts generado y vas a encontrar un recorrido sobre los campos mutables. Escribiste una línea de esa familia: la barrera 6 de tu TryFrom, la comparación if vault.key() == authority.key(), que cierra exactamente un par porque ese es el par que se te ocurrió.
Esa es la diferencia, y es la diferencia entera. Tu barrera 6 es una comparación elegida a dedo sobre un par de cuentas que elegiste. El recorrido del derive es exhaustivo: cada campo mutable contra cada otro, computado desde la struct en vez de desde tu atención, y fusionado a través de structs anidadas para que una colisión entre un campo directo y uno enterrado en un compuesto también se agarre. Agrega una tercera cuenta mutable a tu struct nativa y la barrera 6 no crece con ella; agrega una a una struct de V2 y la máscara sí, calladamente, en tiempo de compilación. La clase no se cierra acordándose de verificar un par. Se cierra no teniendo nunca que acordarse.
Te encontraste con MUT_MASK en el módulo 1, así que el mecanismo no es nuevo: el derive computa un const asociado de 256 bits en tiempo de compilación que marca qué campos son mutables, y el dispatcher recorre esa máscara contra un bitvec de direcciones en runtime a medida que las cuentas cargan, devolviendo ConstraintDuplicateMutableAccount si dos campos mutables llevan la misma dirección. La forma queda fija cuando compilas; la colisión solo se puede conocer cuando la transacción aterriza. Lo nuevo es ver el hueco en la cobertura. Pon tu barrera 6 nativa al lado de la expansión y la diferencia es el alcance: un par que nombraste, contra cada par que implica la struct.
¿Esa clase es real, o es una guarda cosmética que podrías saltearte? Es real. Imagina un handler de batch que toca dos pools de premio, los dos escribibles. Pasa el mismo pool para los dos y un handler ingenuo lo debita una vez, lo acredita dos veces, y la contabilidad queda mal de una forma que ninguna prueba con cuentas distintas sacaría a la superficie jamás. El framework rechaza esa llamada antes de que corra tu handler. Cuando genuinamente quieres pasar una cuenta dos veces, te sales por campo, y el opt-out está escrito para que lo sientas: unsafe(dup). El dup simple sin el envoltorio unsafe es un error de compilación, a propósito. La keyword es la luz del cinturón.
Hay un detalle acá que importa más la próxima lección de lo que importa ahora, así que archívalo. El recorrido de duplicados no es por struct, es por árbol. El derive emite un trait que reporta las claves mutables que una struct serializa a la salida, y cuando anidas una struct de Accounts adentro de otra, la struct de afuera llama a la implementación de cada struct de adentro y fusiona las claves en un solo conjunto. Así que la guarda agarra una colisión incluso cuando la misma cuenta llega una vez como campo directo y una vez enterrada adentro de un compuesto. Esa es exactamente la forma que tiene el floor-registry del capstone: compone el cabinet-counter, el vault, el escrow y el swap, y una composición ingenua hecha a mano es precisamente donde se esconderá un bug de aliasing de duplicate-mutable. Tu vault nativo nunca tuvo este recorrido en un nivel. Un registry nativo lo necesitaría en cada nivel, fusionado, y lo tendría en ninguno.
La segunda línea sin gemela nativa no es una línea para nada, sino un error de compilación que el framework puede producir y tu código nativo no.
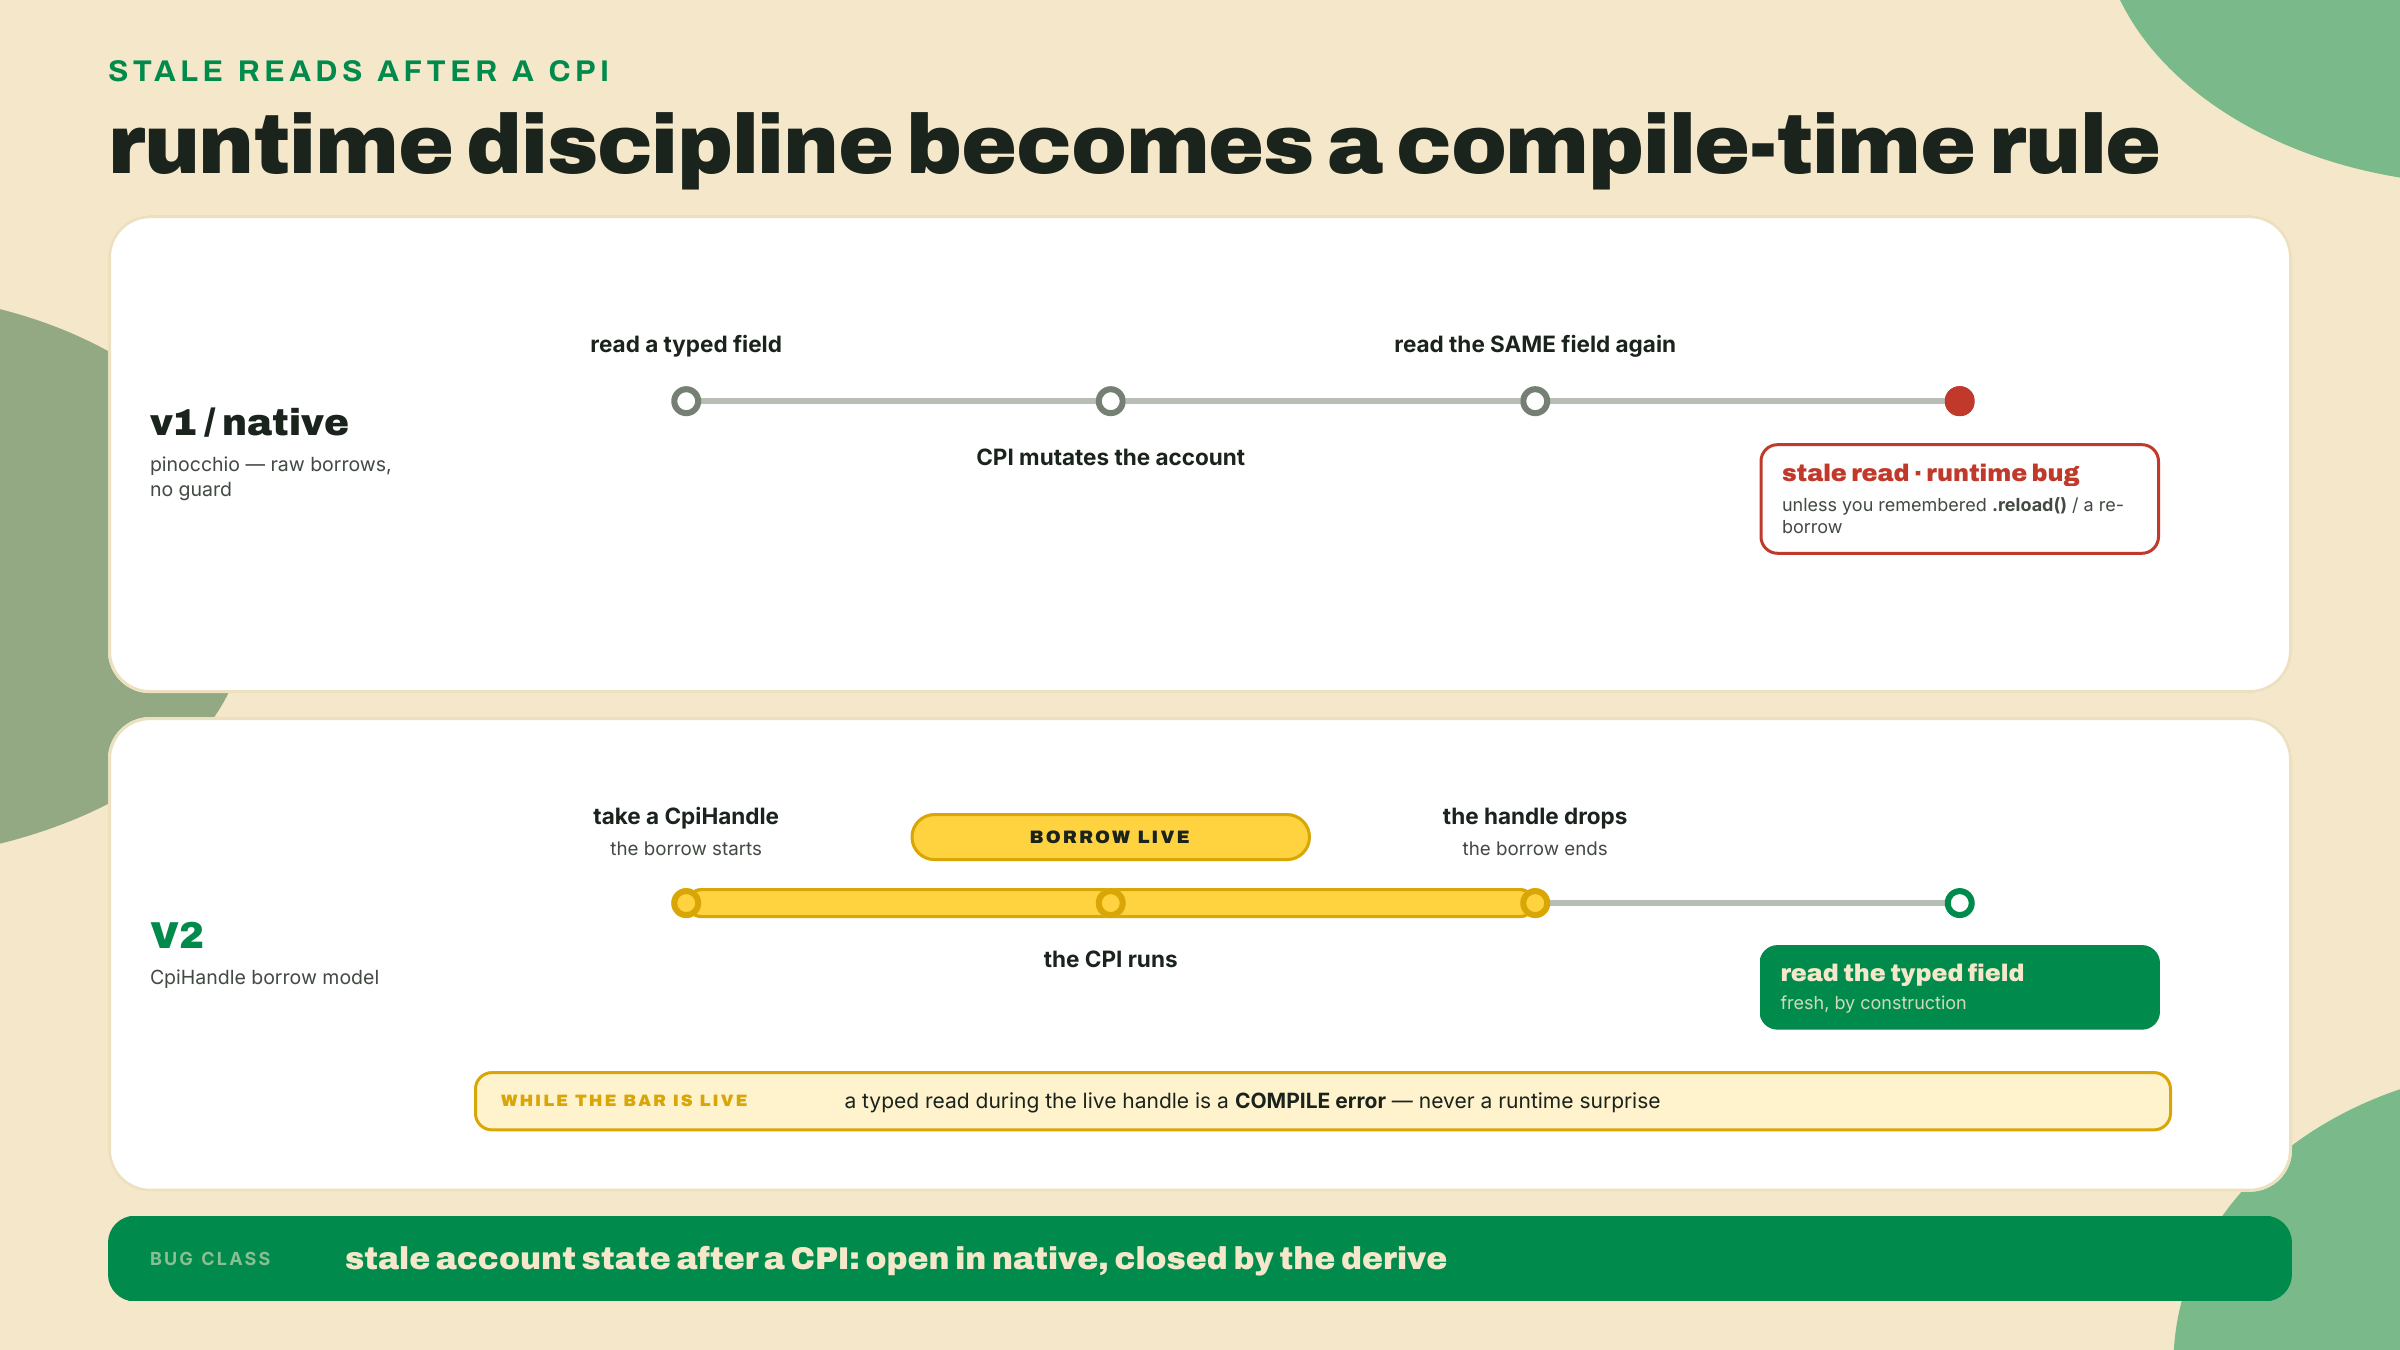
En la línea 0.x, y en v1, podías sostener una cuenta deserializada, invocar una CPI que mutaba los bytes de esa cuenta on-chain, y después leer tu copia obsoleta en memoria como si nada hubiera cambiado. El arreglo era llamar .reload() después de la CPI, y olvidarse era una forma clásica de entregar un bug que razonaba sobre estado pre-CPI. Tu vault nativo tiene la misma exposición con la disciplina arrancada: sostienes borrows crudos, y nada te detiene de volver a leer un valor que capturaste antes de la transferencia como si fuera actual.
V2 vuelve ese error irrepresentable. Ya no le entregas a una CPI un clon de AccountInfo; le entregas un CpiHandle, obtenido con .cpi_handle() o .cpi_handle_mut(), y un CpiHandle es un borrow vivo de Rust de la cuenta sostenido por todo el tiempo en que el handle está en alcance. Mientras está vivo, el borrow checker no te va a dejar formar un segundo borrow de esas mismas cuentas para leer sus datos tipados. La lectura y el handle no pueden coexistir. Te encontraste con esto de frente en el módulo 4, donde reordenar una lectura pasado el drop del handle era el arreglo entero. En el diff, su significado se afila: esta es la guarda que reemplazó .reload(), y vive en tiempo de compilación. Tú no te acuerdas. El compilador sí.
// V2 withdraw: the CpiHandle borrow is live for exactly this call
let owner = *ctx.accounts.authority.address();  // deref: an owned copy, not a borrow
let signer_seeds: &[&[&[u8]]] =
    &[&[b"sol", owner.as_ref(), &[ctx.accounts.state.sol_bump]]];

let cpi = CpiContext::new(
    ctx.accounts.system_program.address(),   // hands back an &Address directly
    Transfer {
        from: ctx.accounts.sol_vault.cpi_handle_mut(),
        to:   ctx.accounts.authority.cpi_handle_mut(),
    },
).with_signer(signer_seeds);
transfer(cpi, amount)?;
// only after `transfer` consumes `cpi` and the handles drop
// can you read ctx.accounts typed data again, and it is live.
Tu equivalente nativo firmaba el mismo withdrawal a mano, en el vocabulario de seeds que usaba tu propio programa, y el runtime lo aceptaba exactamente de la misma forma:
// From Withdraw::process last lesson. `self.vault_bump` is the byte you read out
// of config[33]; `b"vault"` is the SOL PDA's seed literal in the native build,
// which is `b"sol"` in the framework build. Same role, different word.
let bump = [self.vault_bump];
let seeds = [
    Seed::from(b"vault"),
    Seed::from(self.authority.key().as_ref()),
    Seed::from(&bump),
];
let signers = [Signer::from(&seeds)];
Transfer {
    from: self.vault,
    to: self.authority,
    lamports: self.amount,
}
.invoke_signed(&signers)?;
Los dos mueven lamports fuera de un PDA sin clave bajo autoridad del programa. La diferencia es invisible en el camino feliz y decisiva en el que tiene bug: la versión nativa no tiene ningún compilador parado entre ti y una lectura obsoleta post-CPI. El framework construyó uno con el sistema de tipos.
Lo que está en juego con esa guarda sube en el momento en que los programas componen, que es el asunto entero de la próxima lección. Un vault de una sola instrucción lee su propio estado, transfiere y retorna; la ventana para una lectura obsoleta es angosta. El floor-registry del capstone le hace CPI al vault, al escrow y al swap, y después de que cada una de esas llamadas retorna, cualquier campo tipado que estuvieras sosteniendo es candidato a la obsolescencia. Esa es precisamente la situación en la que v1 entregaba bugs, porque el reload que debías estaba una llamada más adentro de una composición sobre la que también estabas tratando de razonar. En V2 el modelo de borrow escala con la composición gratis: cada CpiHandle que tomas presta exactamente las cuentas que esa llamada toca, por exactamente su alcance, y el compilador los rastrea todos a la vez. Cuanto más profundo compones, más está haciendo la guarda, y más te habría estado pidiendo recordar la versión nativa.
Ahora la parte honesta, porque esta lección se puede leer mal. Puedes leer la expansión. Eso es una habilidad de verdad y desmitifica la macro para siempre. Pero no confundas "puedo leerlo" con "debería escribirlo". Las verificaciones generadas son el punto. El recorrido de MUT_MASK y el borrow de CpiHandle no son overhead que el framework te impone; son dos clases de bug que el framework vuelve imposibles de olvidar, y tu vault nativo, elegante como es, olvidó las dos. La versión nativa es un espejo didáctico, no un objetivo de entrega. El valor entero del framework es la guarda que no te va a dejar omitir.
Que es también por lo que confiar en el código generado es razonable en vez de perezoso. El pegamento que recorre tus cuentas está él mismo fuzzeado y verificado contra comportamiento indefinido, de la misma forma en que verificarías un programa detrás del que estuvieras a punto de poner dinero. Lo viste en el módulo 1: la suite de pruebas del propio framework carga los testigos. El código que el derive escribe por ti está verificado, no afirmado. Tu vault nativo, en contraste, es confiable solo en la medida en que lo probaste personalmente, y probaste una instrucción sobre un camino feliz más un rechazo. El try_accounts del derive está ejercitado a través del ecosistema entero y verificado por herramientas que no tuviste que escribir. Esa asimetría es el argumento callado a favor del framework: no que no puedas escribir las verificaciones, sino que la versión del framework está probada más duro de lo que la tuya lo estará jamás.
Un número mantiene honesta esa confianza. El código generado tiene un costo medido y en movimiento, y el equipo de V2 lo mide a la vista. El PR #4914, mergeado el 2026-08-13, revisó a la baja los benchmarks del titular de V2, de 95% a 94% de reducción de bytecode y de 9.9x a 8.8x de mejora de CU. Un framework que corrige su propio marketing a la baja es un framework del que puedes confiar en los números hacia arriba. El código que estás diffeando es rápido, y es honestamente rápido.
¿Entonces cuándo es el nativo de verdad la decisión correcta, y no solo un ejercicio? La respuesta honesta es angosta pero real: un camino caliente donde perfilaste una instrucción específica, demostraste que el overhead por cuenta del framework es tu cuello de botella, y decidiste que la CU que compras de vuelta vale poseer cada verificación a mano para siempre. Esa es una decisión rara y medida, no un default. Y nota la pista en el propio diseño de V2: el framework es él mismo una reescritura no_std sobre pinocchio, y ofrece asm-v2 para exactamente esos caminos calientes, así que puedes bajar al metal por una instrucción sin abandonar las guardas en todas las otras. El framework no es el enemigo de la CU que quieres de vuelta; es la forma de gastar ese presupuesto donde importa y mantener los cinturones en todo lo demás. Leer la expansión es lo que te gana ese juicio. Ahora puedes mirar un try_accounts generado, ver cuánto cuesta cada línea y qué bug cierra, y decidir, con números, qué líneas querrías poseer tú mismo alguna vez. Para casi todas, la respuesta es no.
Dos notas al pie antes del Lab, porque las dos son trampas.
Primera, AccountLoader. Si grepeas la documentación de V2 todavía lo vas a encontrar, y es tentador leer eso como "nada cambió". Equivocado del otro lado también: no leas la reescritura del modelo de cuentas como "AccountLoader desapareció". No es ni una ni otra. En V2 AccountLoader se repropone como un cursor secuencial de cuentas, y la documentación advierte que ahora quiere decir otra cosa que lo que quería decir en la línea 0.x. El mismo nombre, otro trabajo. Lleva eso con cuidado.
Segunda, el piso de este curso tiene una trampilla, y te toca exactamente una mirada a través de ella. Anchor V2 puede linkear sBPF escrito a mano: asm-v2 te deja bajar un camino caliente a assembly y hacer que el framework lo linkee adentro del programa que corre la VM. Mira una vez. Te dice que el framework tiene una salida de emergencia hasta el fondo, hasta la instrucción que ejecuta la máquina. Después detente, porque perseguir profundidad de sBPF acá es el curso equivocado. Por qué la VM lo corre de esa forma — el loader, las syscalls, el verificador, programas sin ningún framework — le pertenece al curso de Low-Level Solana, no a este. Si quieres ir debajo de sBPF, esa es la puerta. Acá nos quedamos al nivel del framework: en qué expande la macro, y por qué.
El repliegue de la ayuda: los pasos 1 a 4 están trabajados, corres los comandos y lees la salida; el paso 5 escribes las anotaciones tú mismo contra tu archivo de verdad.
Genera la expansión. Desde el crate de tu quarter-vault de framework, corre los dos comandos del principio de la lección. Si cargo expand da error en una macro, no vayas a mirar tu binario anchor — cargo expand nunca consulta el CLI de Anchor para nada. La expansión es rustc corriendo las proc macros del grafo de dependencias de este crate, así que la única cosa que decide qué gramática expande es la fila anchor-lang del Cargo.toml. Si esa fila lee una versión 1.x, el código de CpiHandle y de Account Pod no puede expandir no importa qué CLI esté en tu PATH; fija anchor-lang = "2.0.0-rc.1" desde crates.io, exactamente como mostró m01-l2 (2.0.0-rc.1 al 2026-08-22; vuelve a verificar si hay una rc más nueva o un tag estable), y vuelve a correrlo. Esa inversión — el pin del crate selecciona el framework, nunca el CLI — es la lección de macros reformulada como una regla de herramientas, y vuelve como el remate de m10.
Encuentra la fase de load. Busca en expanded.rs try_accounts cerca de Withdraw. Marca la línea que carga state como un Account<Vault>. Abre tu TryFrom nativo al lado y traza una línea desde ese único load generado hasta tus dos verificaciones escritas a mano: la verificación de dueño y la verificación del discriminator. Confirma que cargan antes de que corra cualquier constraint.
Encuentra el bloque de constraint. Debajo de los loads, encuentra dónde se imponen las cláusulas constraint, seeds y bump. Mapea cada una a la verificación fusionada a mano que reemplazó en tu handler nativo. Confirma que el bloque corre después de que todos los campos cargan y antes del handler.
Encuentra las guardas que faltan. Grepea la expansión por MUT_MASK, que es un const asociado de verdad y va a estar ahí al pie de la letra, y después lee hacia afuera desde ahí para encontrar dónde se lo prueba contra las cuentas que mandó el llamador. No grepees por un nombre de función; los bocetos de arriba nombraron uno por legibilidad y el código emitido de verdad puede inlinearlo o llamarlo de otra forma. Después pon tu barrera 6 nativa al lado y confirma la diferencia de alcance: la tuya compara un par, esta compara cada par que marca la máscara. Después mira tu invoke_signed nativo y confirma que no hay ninguna guarda de compilador que impida una lectura obsoleta post-CPI, el trabajo que hace el borrow de CpiHandle en V2.
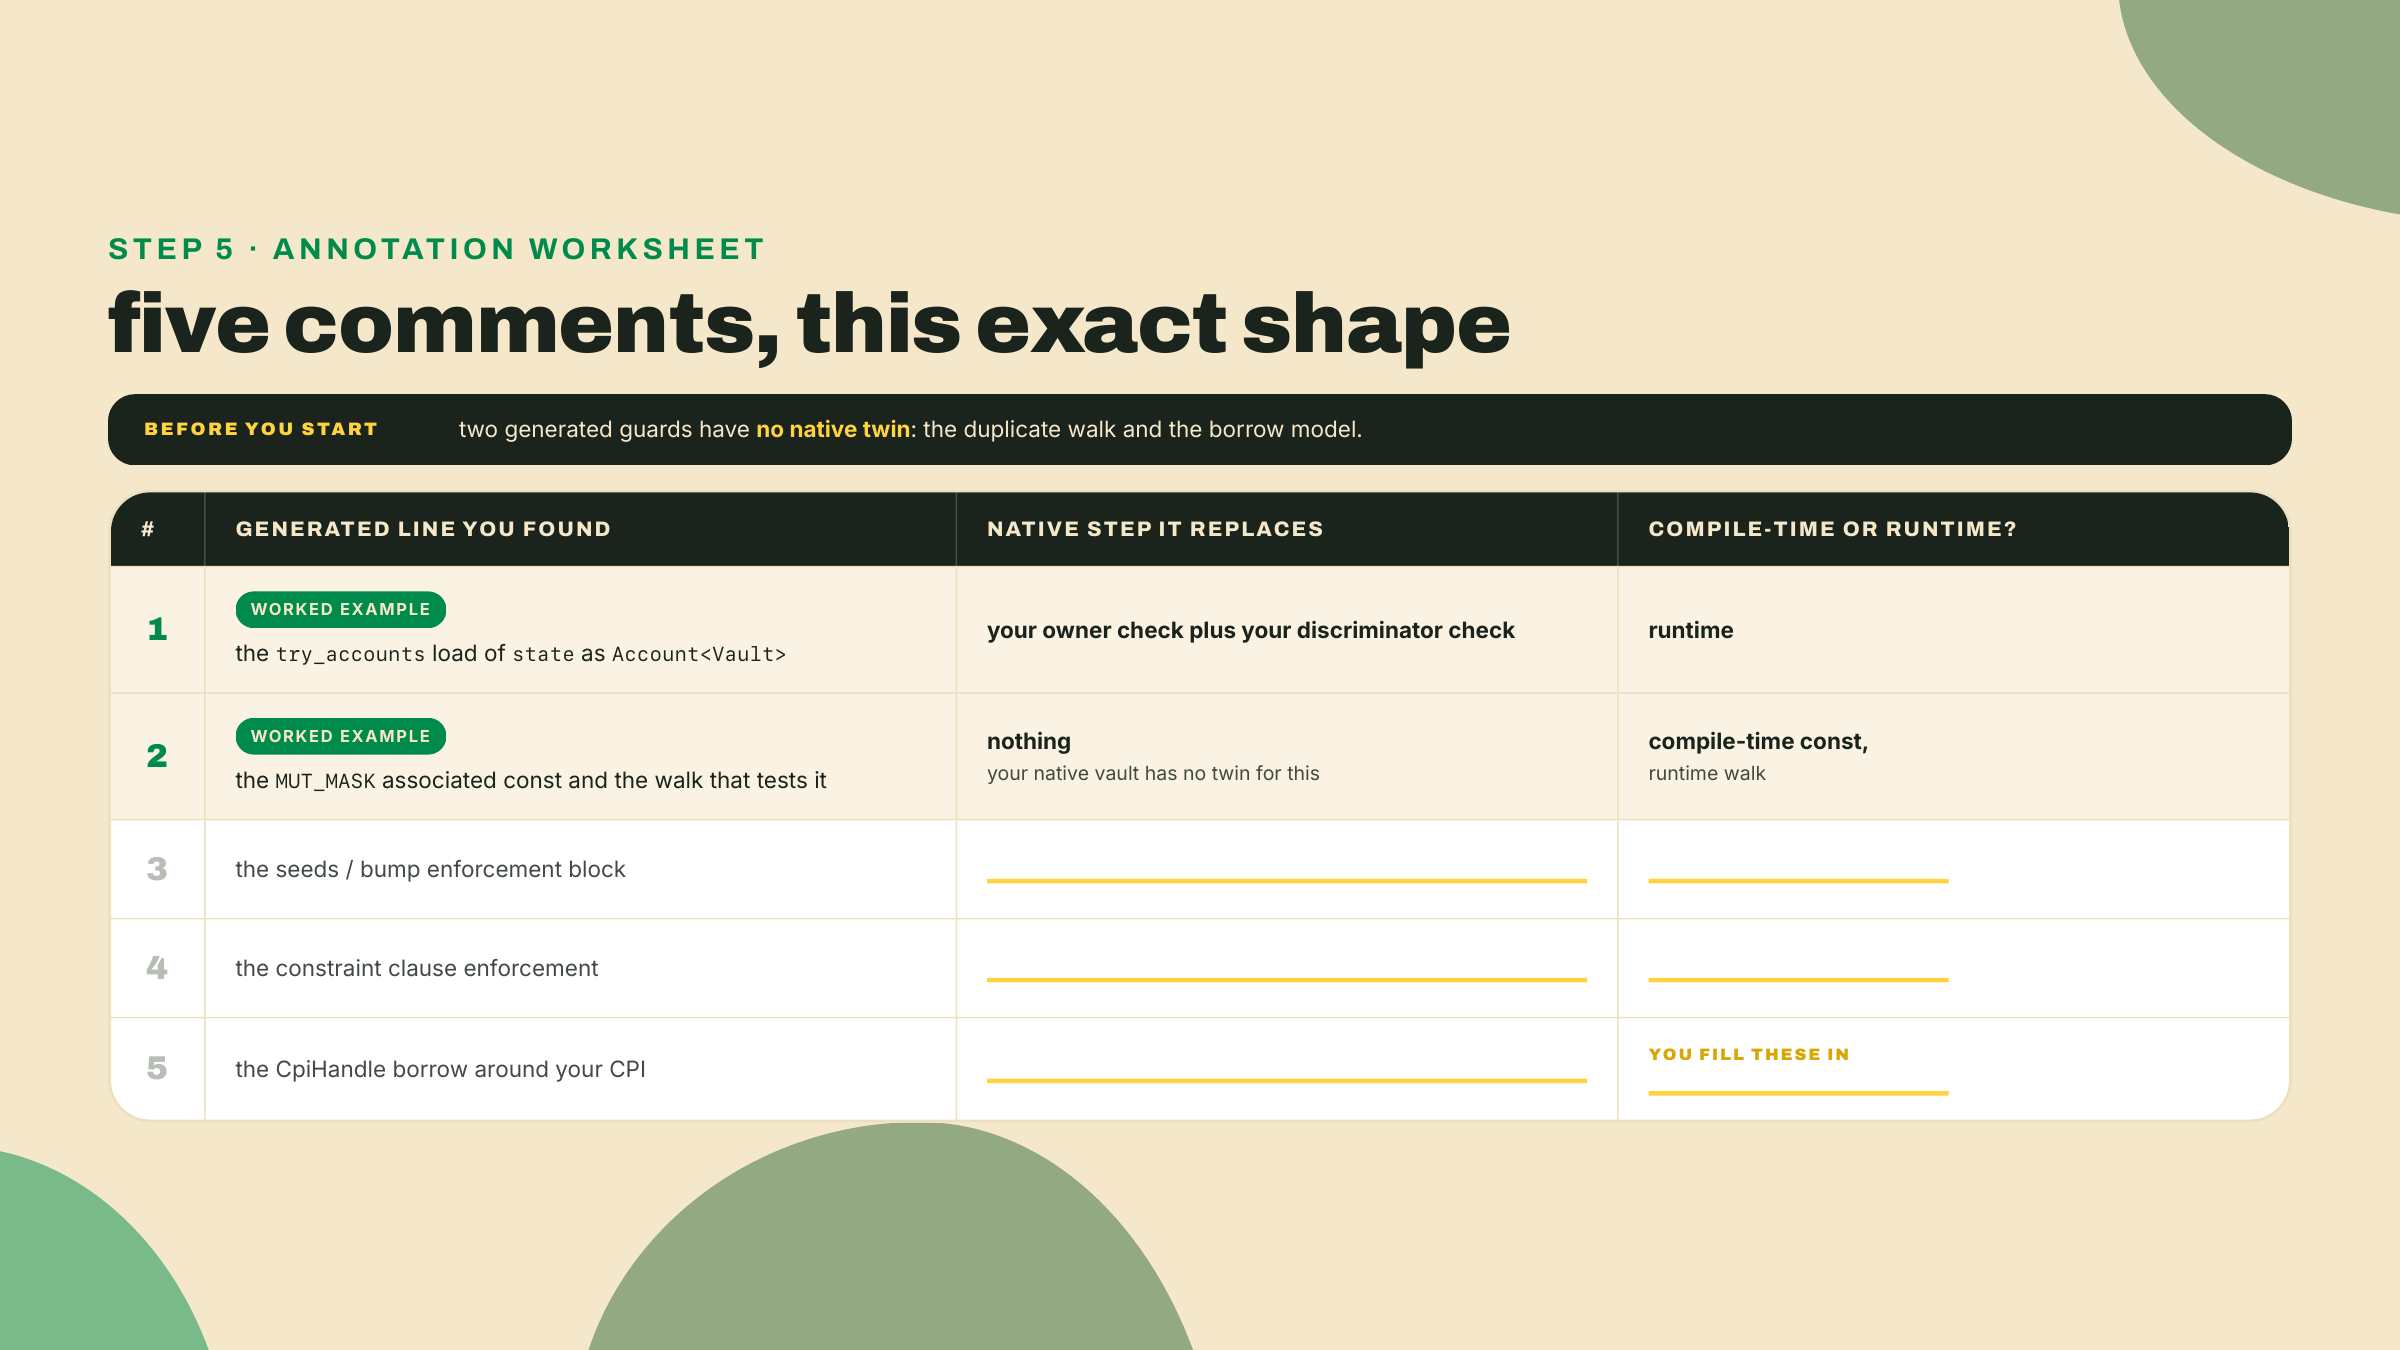
compile-time o runtime al lado. Checkpoint: deberías poder apuntar a cada línea de tu TryFrom y de tu despacho nativos y encontrar su gemela generada, y apuntar a exactamente dos guardas generadas, el recorrido de duplicados y el modelo de borrow, que no tienen gemela ninguna. Si puedes hacer eso, leíste el framework.Solo, sin apoyo. Toma estas tres líneas de una expansión de V2. Para cada una, declara qué paso nativo reemplaza (una verificación de orden de load, un hook de constraint, o un despacho o recorrido de duplicados) y si se dispara en tiempo de compilación o en runtime.
(a)  let state: Account<Vault> = Account::try_from(next_account_info)?;
(b)  const MUT_MASK: [u64; 4] = /* bits set for state, sol_vault, authority */;
(c)  /* the walk over every mutable pair, run in the dispatcher */
Escribe una frase por línea. La distinción sobre la que gira la barrera es la que hay entre (b) y (c): son la misma feature en dos momentos distintos. Si tus tres respuestas se sostienen, y puedes decir por qué (b) es de tiempo de compilación y (c) es de runtime sin borronearlas, posees el diff.
Sin clave de respuestas acá. Tres pruebas, si quieres verificarte sin que te lo digan: por cada línea, ¿puedes nombrar el archivo y más o menos el número de línea de tu propio vault nativo donde vive el equivalente, o decir honestamente que no hay ninguno? ¿Puedes decir de qué información depende la línea, la definición de la struct o las cuentas de verdad del llamador? Y para (b) y (c) específicamente, ¿puedes explicar por qué no pueden dispararse las dos en el mismo momento? Si las tres respuestas vienen fácil, posees el diff. Si la tercera es la que se te traba, vuelve a leer la sección de MUT_MASK, porque esa costura es el punto entero de la barrera.
Esa es la mitad de reencuadrar de constrúyelo-dos-veces, cerrada. Construiste el vault a mano, lo diffeaste contra la máquina que lo genera, y ninguno de los dos es una caja negra ya. Ahora puedes predecir qué escribe el derive y por qué, que quiere decir que finalmente puedes hacer que el framework cargue su peso entero en vez de una instrucción a la vez. La próxima lección armas el salón de arcade entero, un programa que corre el counter, el vault, el escrow y el swap por CPI, y lo llevas por el ciclo de vida entero hasta un deploy verificado en devnet. Ahora anda a hacer que cargue el salón entero.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.