Cargando...

 BetaBeta
Hoy termina con un check verde en una ejecución que no arrancaste. Revisa la línea de salida primero: abre la terminal de la lección pasada y corre:
git --version
Si imprime una versión, la mitad del toolchain de hoy ya está en tu máquina. Si da error, la primera sección lo instala en un comando. De cualquier forma, deja la terminal abierta; todo lo que sigue pasa ahí, y para el final una máquina que no es tuya va a estar sondeando internet cada media hora en tu nombre.
La lección pasada construiste pulse v0: una sonda de TypeScript en modo strict que imprime una latencia de verdad para una URL de verdad, pero solo mientras te quedas ahí corriéndola. Esa es la falla fatal que arreglamos hoy. Un latido que se detiene cuando cierras la laptop es una toma de pulso, no un monitor. Así que esta lección hace el primer ship del curso: tu repo se vuelve público en GitHub, un archivo YAML va en él, y GitHub corre tu sonda cada 30 minutos, de noche, los fines de semana, en época de exámenes, haciendo commit de cada resultado de vuelta como status.json. En el camino te llevas git y GitHub flow a nivel de dev que trabaja, la anatomía de un workflow, y la física honesta de la plataforma: por qué el CI de repo público es genuinamente gratis, por qué el calendario se desvía, qué mata en silencio un cron inactivo, y por qué el propio commit del workflow no se dispara a sí mismo hacia un loop infinito.
Cómo se reparte el trabajo: este sigue siendo el tier completamente resuelto. Cada comando y el archivo de workflow completo aparecen anotados en la página; tus TODOs son exactamente tres líneas dentro de ese archivo (la expresión cron, el bloque permissions, la guarda de sin cambios), y el challenge del final, una barrera de verificación de tipos que construyes solo, es tu primer pequeño paso en solitario. Las rueditas empiezan a salir en el próximo módulo.
Una nota de honestidad: el primer ship es la ejecución programada, no una URL. La dirección web pública de la estación llega en el módulo 3, renderizando el status.json exacto que esta lección empieza a producir. La victoria de hoy es más callada y, yo diría, más grande: un check verde en una ejecución que no arrancaste.
Nada de teoría todavía. Primero el check verde, después el entendimiento. Necesitas git y la CLI de GitHub, gh. En macOS:
# git ships with the Xcode command line tools
xcode-select --install

# gh via Homebrew
brew install gh
En Ubuntu/Debian: sudo apt install git gh. En Windows: winget install Git.Git GitHub.cli. Después dile a git quién eres (esta identidad va en cada commit que hagas):
git config --global user.name "Your Name"
git config --global user.email "you@example.com"
Ahora, en tu directorio pulse-station de la lección pasada, tres jugadas: ignorar la basura, tomar una instantánea de todo lo demás, y ponerlo en GitHub. El .gitignore va ANTES del primer commit. Hacer commit de node_modules es el error clásico de la primera semana, y deshacerlo después es mucho más molesto que prevenirlo ahora:
cd pulse-station
git init -b main

printf "node_modules/\n.env\n" > .gitignore

git add .
git commit -m "pulse v0: strict-mode latency probe"
git init -b main arranca el repo con main como branch por defecto. Acuérdate de esa frase, branch por defecto. Vuelve con dientes en la sección del cron. Después autentica gh y crea el repo, público a propósito:
gh auth login
gh repo create pulse-station --public --source=. --push
Ese nombre de repo es estructural, así que escríbelo exacto: raw.githubusercontent.com/<user>/pulse-station/main/status.json es la URL que el panel de m03-l2 consulta y que el script de demo de m10-l1 revisa. Renómbralo después y te toca actualizar los dos.
La flag --public es economía, no idealismo. Los propios docs de facturación de GitHub lo dicen sin rodeos: "El uso de GitHub Actions es gratis para los repositorios públicos que usan runners estándar alojados por GitHub". Sin medición. Sin cuota, sin contador de minutos, sin tarjeta. Esta es la razón por la que la lección m01-l1 (este curso nombra las lecciones módulo primero: m01-l1 es módulo uno, lección uno, la primera lección que lees; de acá en adelante las referencias cruzadas usan esa abreviatura) convirtió "tu repo es público" en un prerrequisito declarado: estamos a punto de correr una sonda 48 veces al día para siempre, y en un repo público eso cuesta exactamente nada. Vamos a hacer la aritmética completa de la alternativa privada en un minuto.
Ahora el primer workflow. Crea el archivo que GitHub Actions busca. La ruta es una convención que la plataforma tiene hardcodeada:
mkdir -p .github/workflows
Pon esto en .github/workflows/pulse.yml:
name: pulse

on: push

jobs:
  probe:
    runs-on: ubuntu-latest
    steps:
      - run: echo "a machine that is not yours ran this"
Haz commit y push:
git add .github
git commit -m "ci: first trivial workflow"
git push
Abre tu repo en github.com y haz clic en la pestaña Actions. En segundos deberías ver una ejecución girando y, poco después, un check verde al lado del mensaje de tu commit. Entra y lee el log: una máquina Ubuntu nueva arrancó en algún datacenter, ejecutó tu echo y se apagó. Esa es toda la lección, comprimida en una sola ejecución. Todo lo que sigue es hacer que esa máquina haga algo que valga la pena, en un calendario, sin ti.
Checkpoint: la pestaña Actions muestra una ejecución completada llamada pulse con un check verde. Si no muestra nada, el archivo probablemente no está exactamente en .github/workflows/pulse.yml; la ruta es estructural.
Seis líneas de YAML acaban de requisar una computadora, así que cada una merece su nombre. Un workflow es el archivo entero: una receta disparada por eventos. Un job es una unidad con nombre dentro de él (probe) que recibe su propia máquina virtual nueva. Un step es un comando o una action reutilizable dentro de un job, que corre en orden. Un runner es la máquina que ejecuta el job; runs-on: ubuntu-latest pide un runner estándar alojado por GitHub, el tipo gratis. Esa palabra estándar está haciendo un trabajo silencioso: GitHub también alquila runners más grandes con más núcleos y RAM, y esos, textualmente de los docs de facturación, "siempre se cobran, incluso cuando los usan repositorios públicos". La afirmación de CI gratis que acabas de cobrar se sostiene solo en las máquinas estándar, que para una sonda que busca tres URLs son más computadora de la que vamos a necesitar.
on: push es el trigger: qué eventos arrancan el workflow. Ahora mismo, cada push. Pronto, también un reloj.
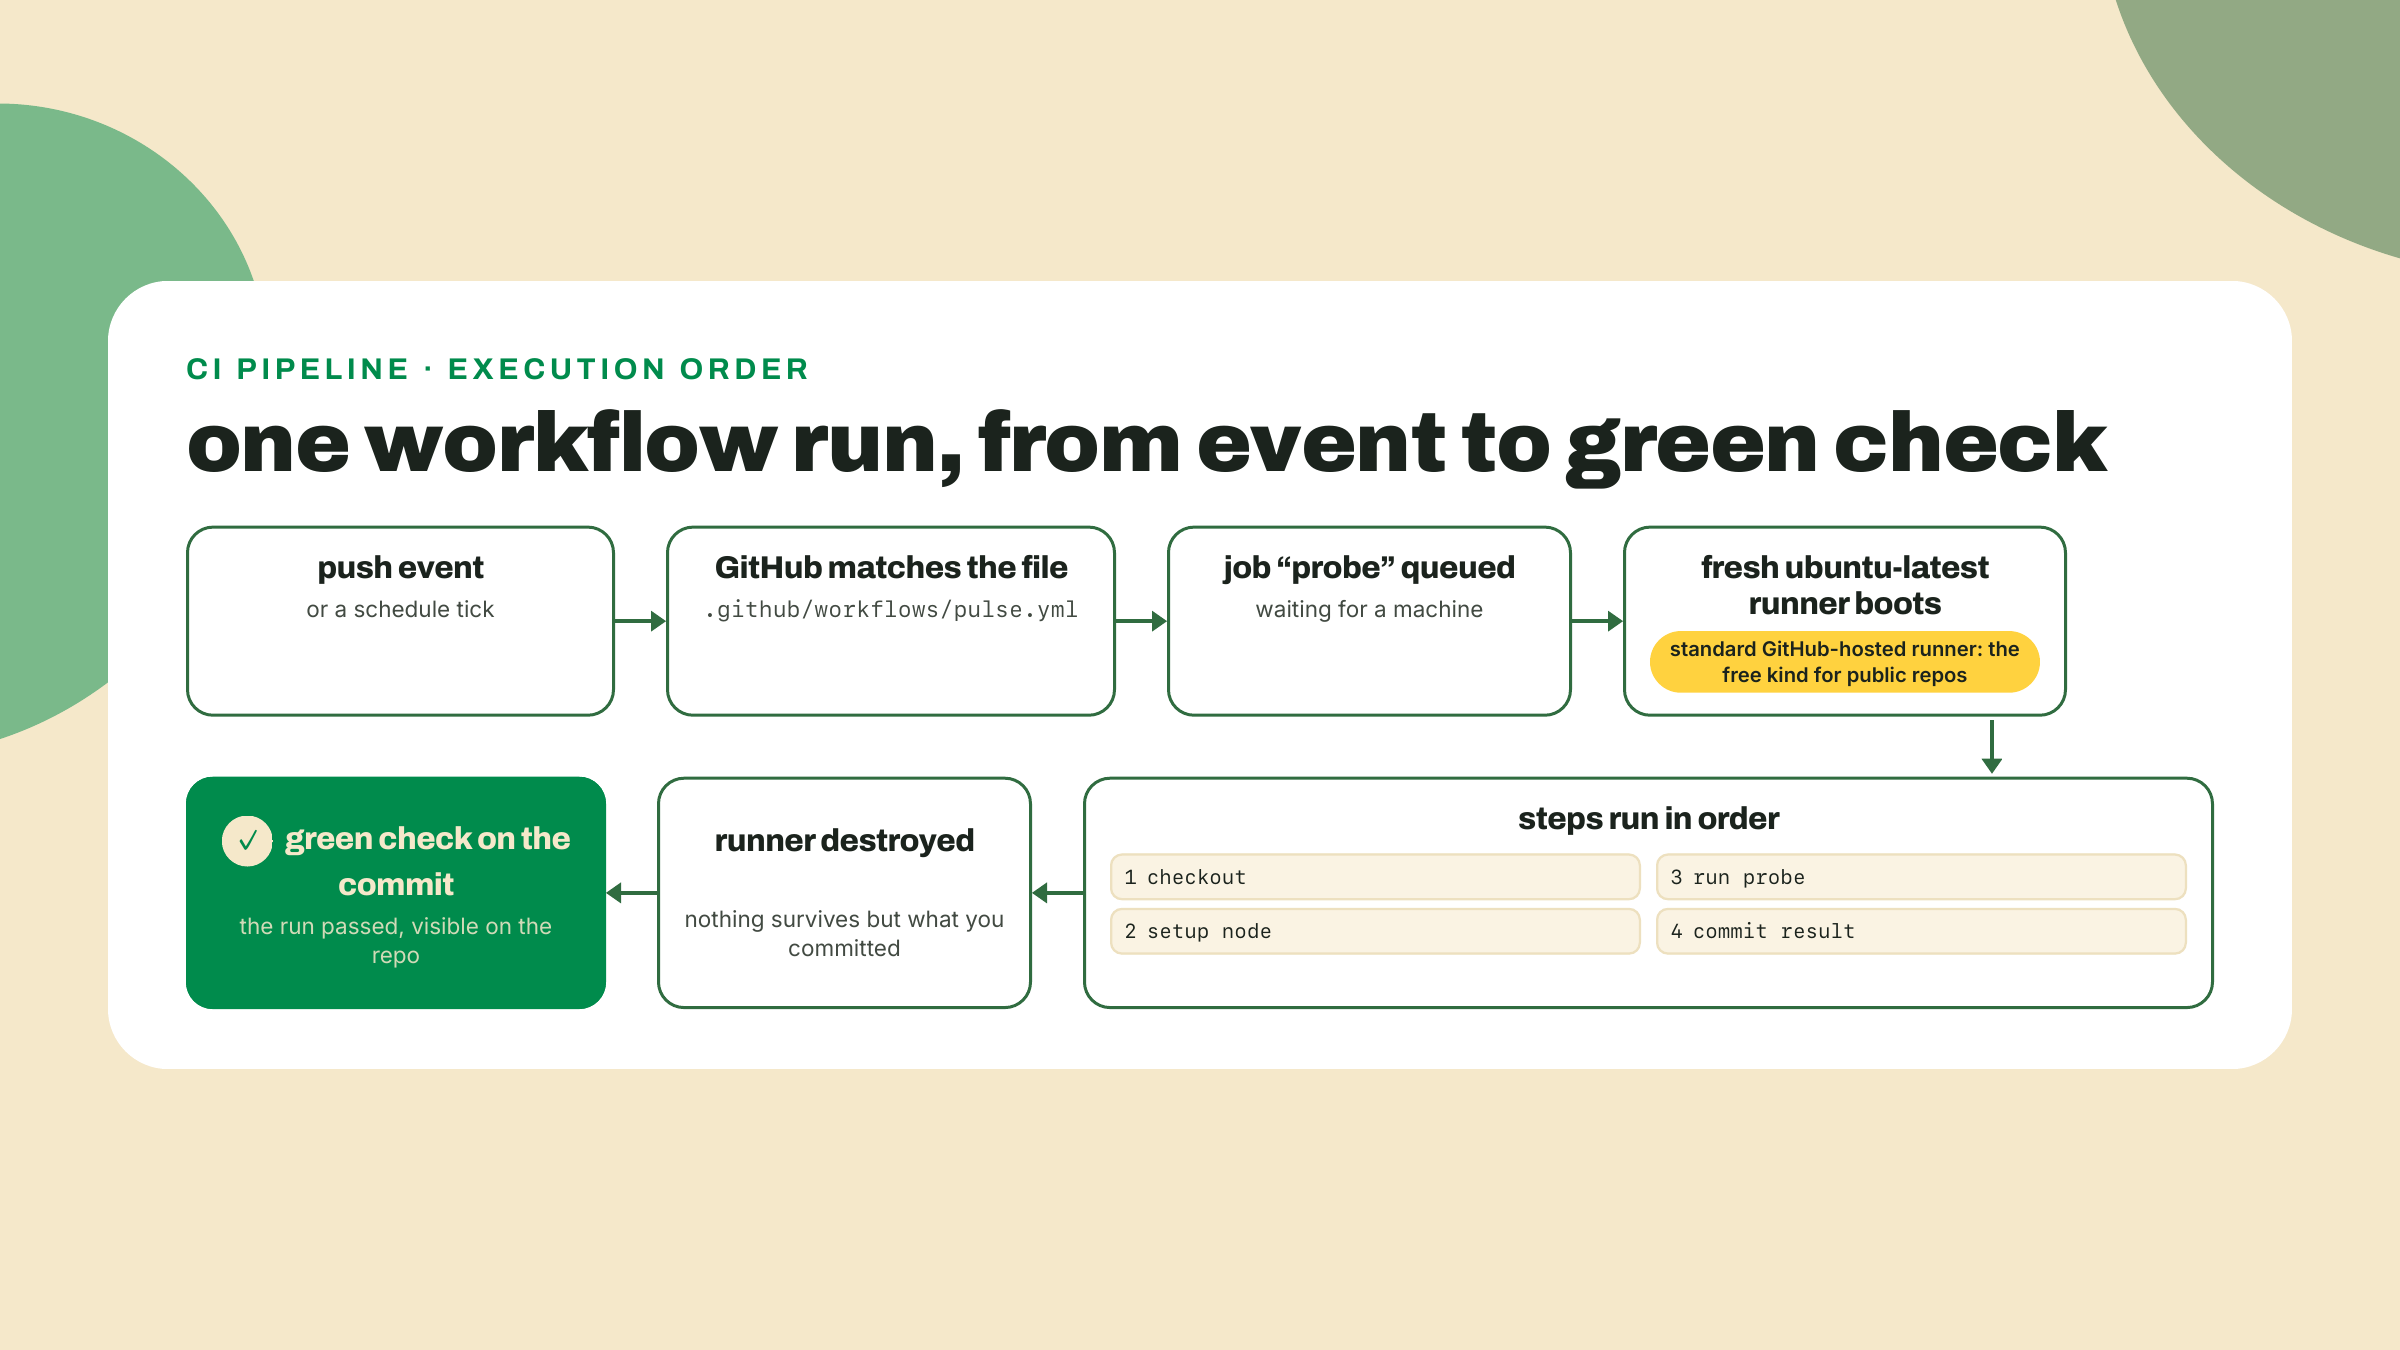
Una pieza más de anatomía antes de que se gane el sueldo en el lab: la mayoría de los workflows de verdad empiezan con - uses: actions/checkout@v7. Un runner nuevo arranca sin nada encima, ni siquiera tu código. La action checkout clona tu repo en la máquina. uses: trae una action reutilizable del marketplace en vez de correr un comando de shell; @v7 fija su versión mayor. Los pins de versión de esta lección (checkout v7, setup-node v7) eran las versiones mayores actuales al 2026-09-02; las actions se mueven más despacio que npm, pero revisa la página del marketplace cuando leas esto.
Tu amigo en un repo privado de equipo mira un medidor de minutos de Actions. Tú nunca lo vas a mirar, y vale la pena precisar la distinción, porque "CI es gratis" y "CI es gratis para ti" son afirmaciones distintas.
El sistema de minutos incluidos mide los repositorios PRIVADOS: el plan Free incluye 2,000 minutos por mes y, pasado eso, los builds privados se detienen o se cobran. Los repositorios públicos en runners estándar simplemente no se miden. No hay ninguna cuota que generosamente no se esté consumiendo; el contador no existe para ti. Dos peros, los dos ya nombrados: la palabra estándar (los runners más grandes siempre cobran, público o no), y el hecho de que esta es la postura actual del proveedor, citada de sus docs de facturación, no una ley de la física.
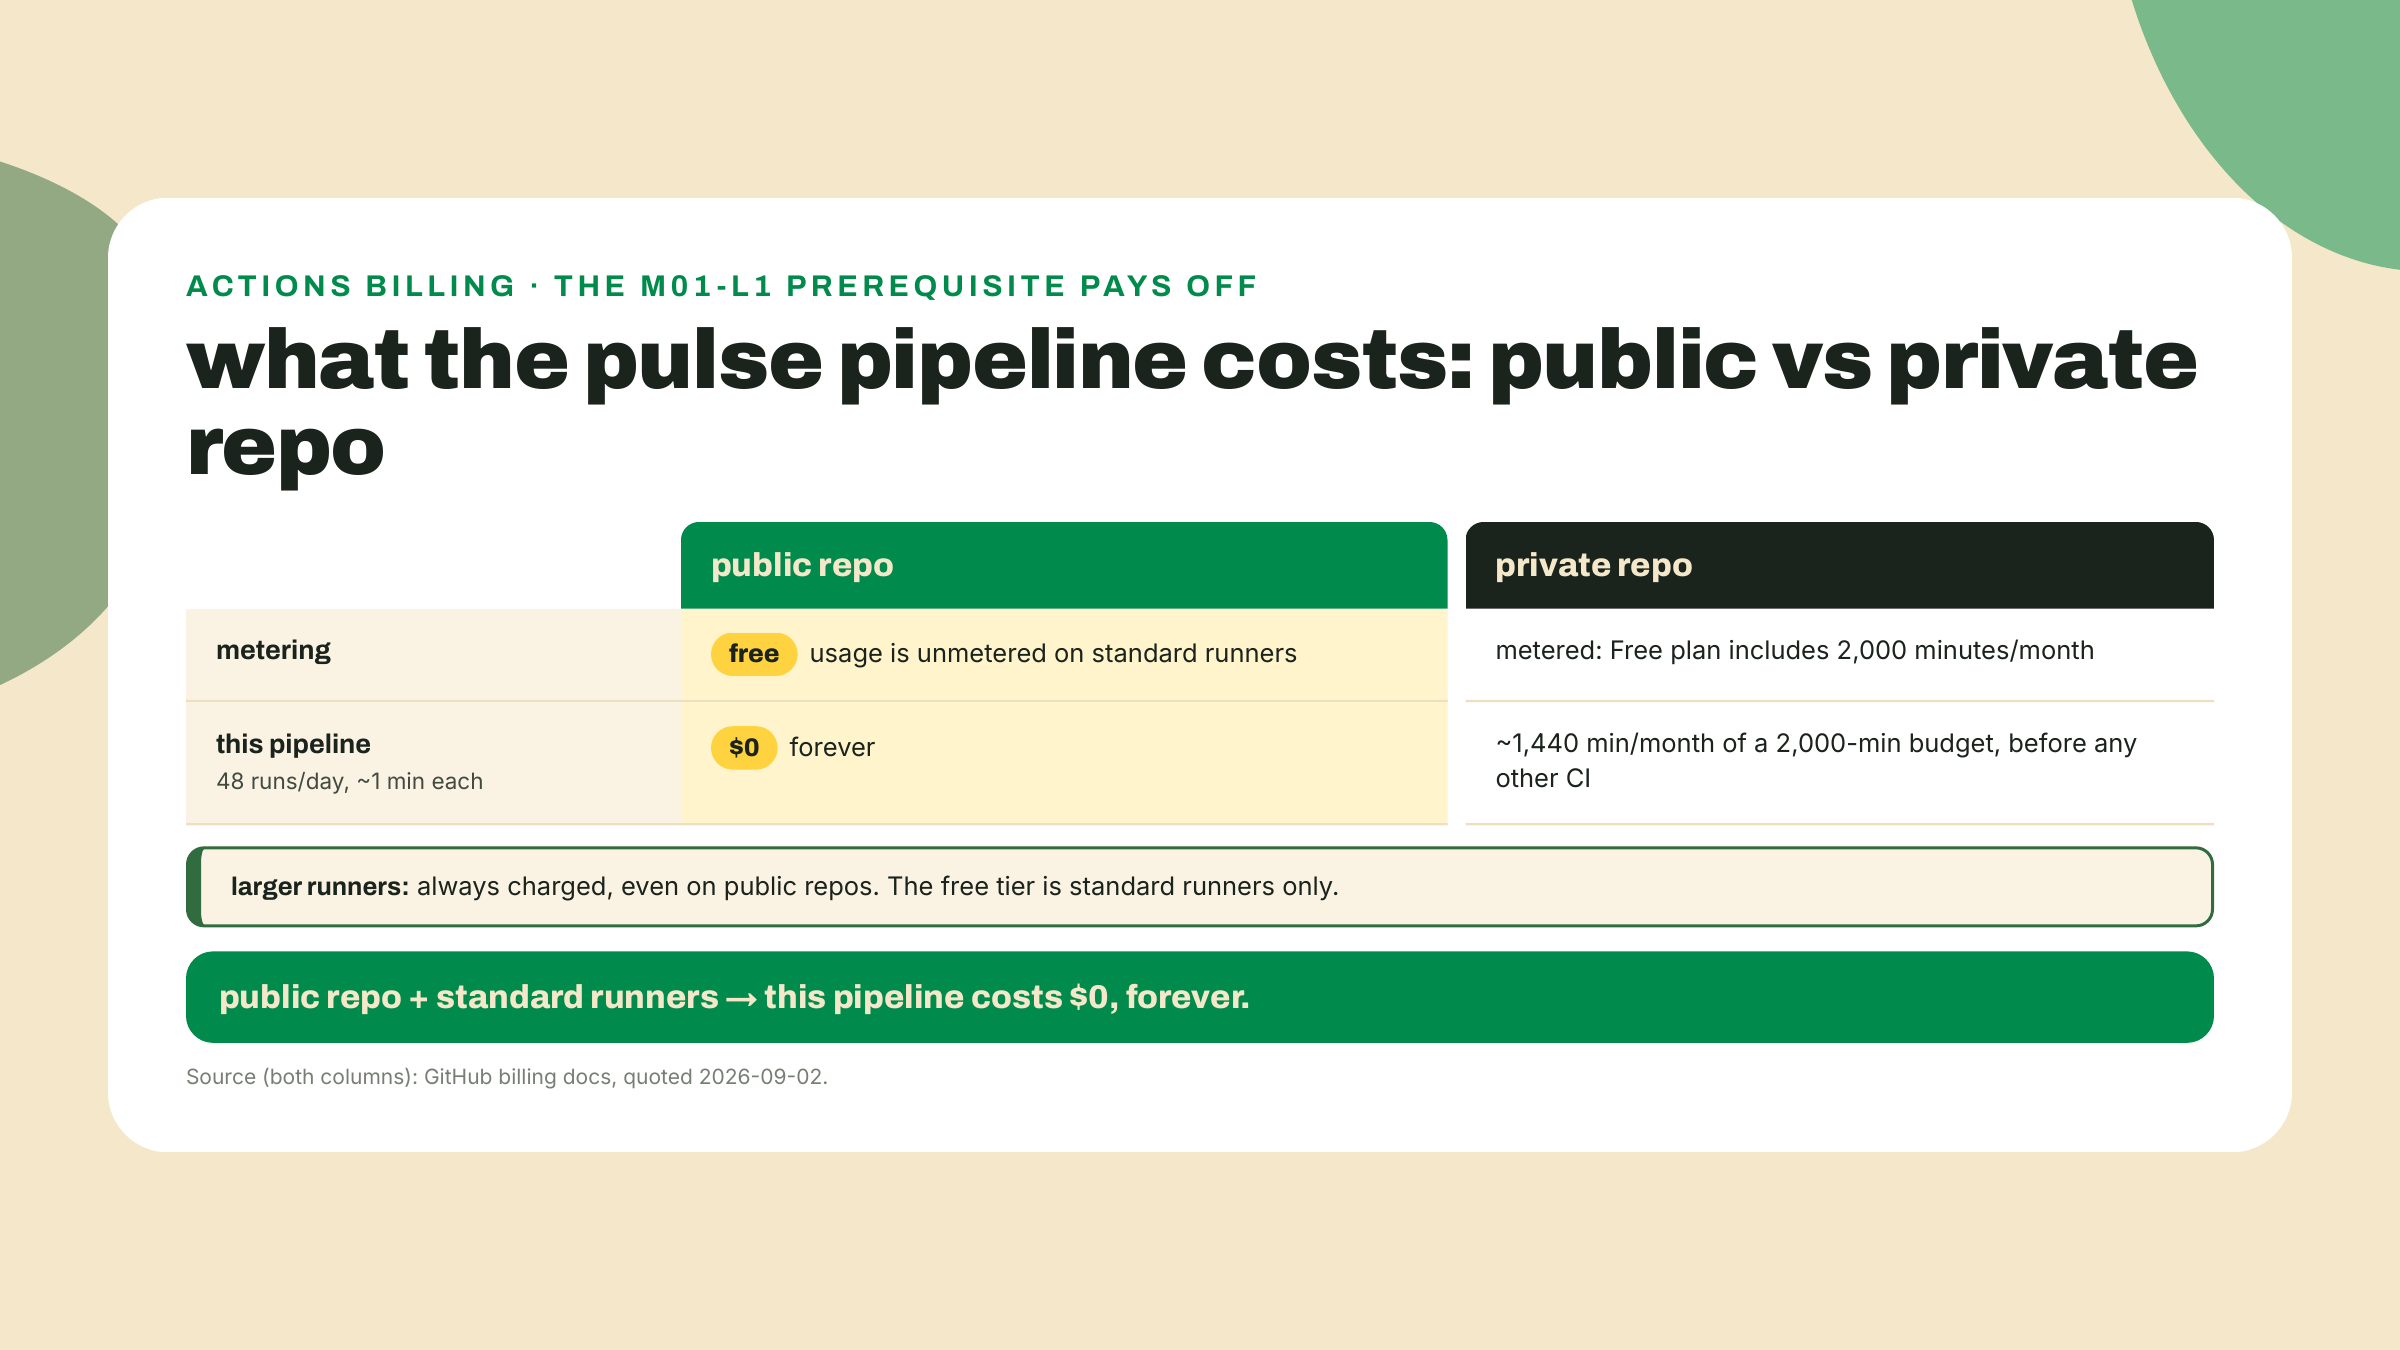
Haz la aritmética de repo privado una vez y nunca vas a olvidar por qué el repo es público: 48 ejecuciones programadas al día, aunque sean de un minuto cada una, son alrededor de 1,440 minutos al mes, casi tres cuartos del presupuesto que el plan Free reserva para repos privados, gastados en un latido. En el repo público: cero, y el medidor que lo contaría no existe.
Acá está la línea que convierte tu sonda en un monitor. En el bloque de triggers del workflow:
on:
  push:
    branches: [main]
  schedule:
    - cron: "*/30 * * * *"
Una expresión cron son cinco campos: minuto, hora, día del mes, mes, día de la semana. */30 * * * * se lee "cada minuto 30, cada hora, cada día": :00 y :30, a toda hora. El piso de la plataforma está documentado: "El intervalo más corto con el que puedes correr workflows programados es una vez cada 5 minutos", así que nuestro 30 es cómodamente legal. Los horarios son UTC por defecto; la zona horaria se activa a mano con una cadena IANA si alguna vez necesitas una, y para un monitor no la necesitas. UTC es la única zona horaria en la que una flota debería pensar.
Dos realidades sobre este calendario, las dos de los propios docs de GitHub, las dos cosas que los tutoriales aman omitir.
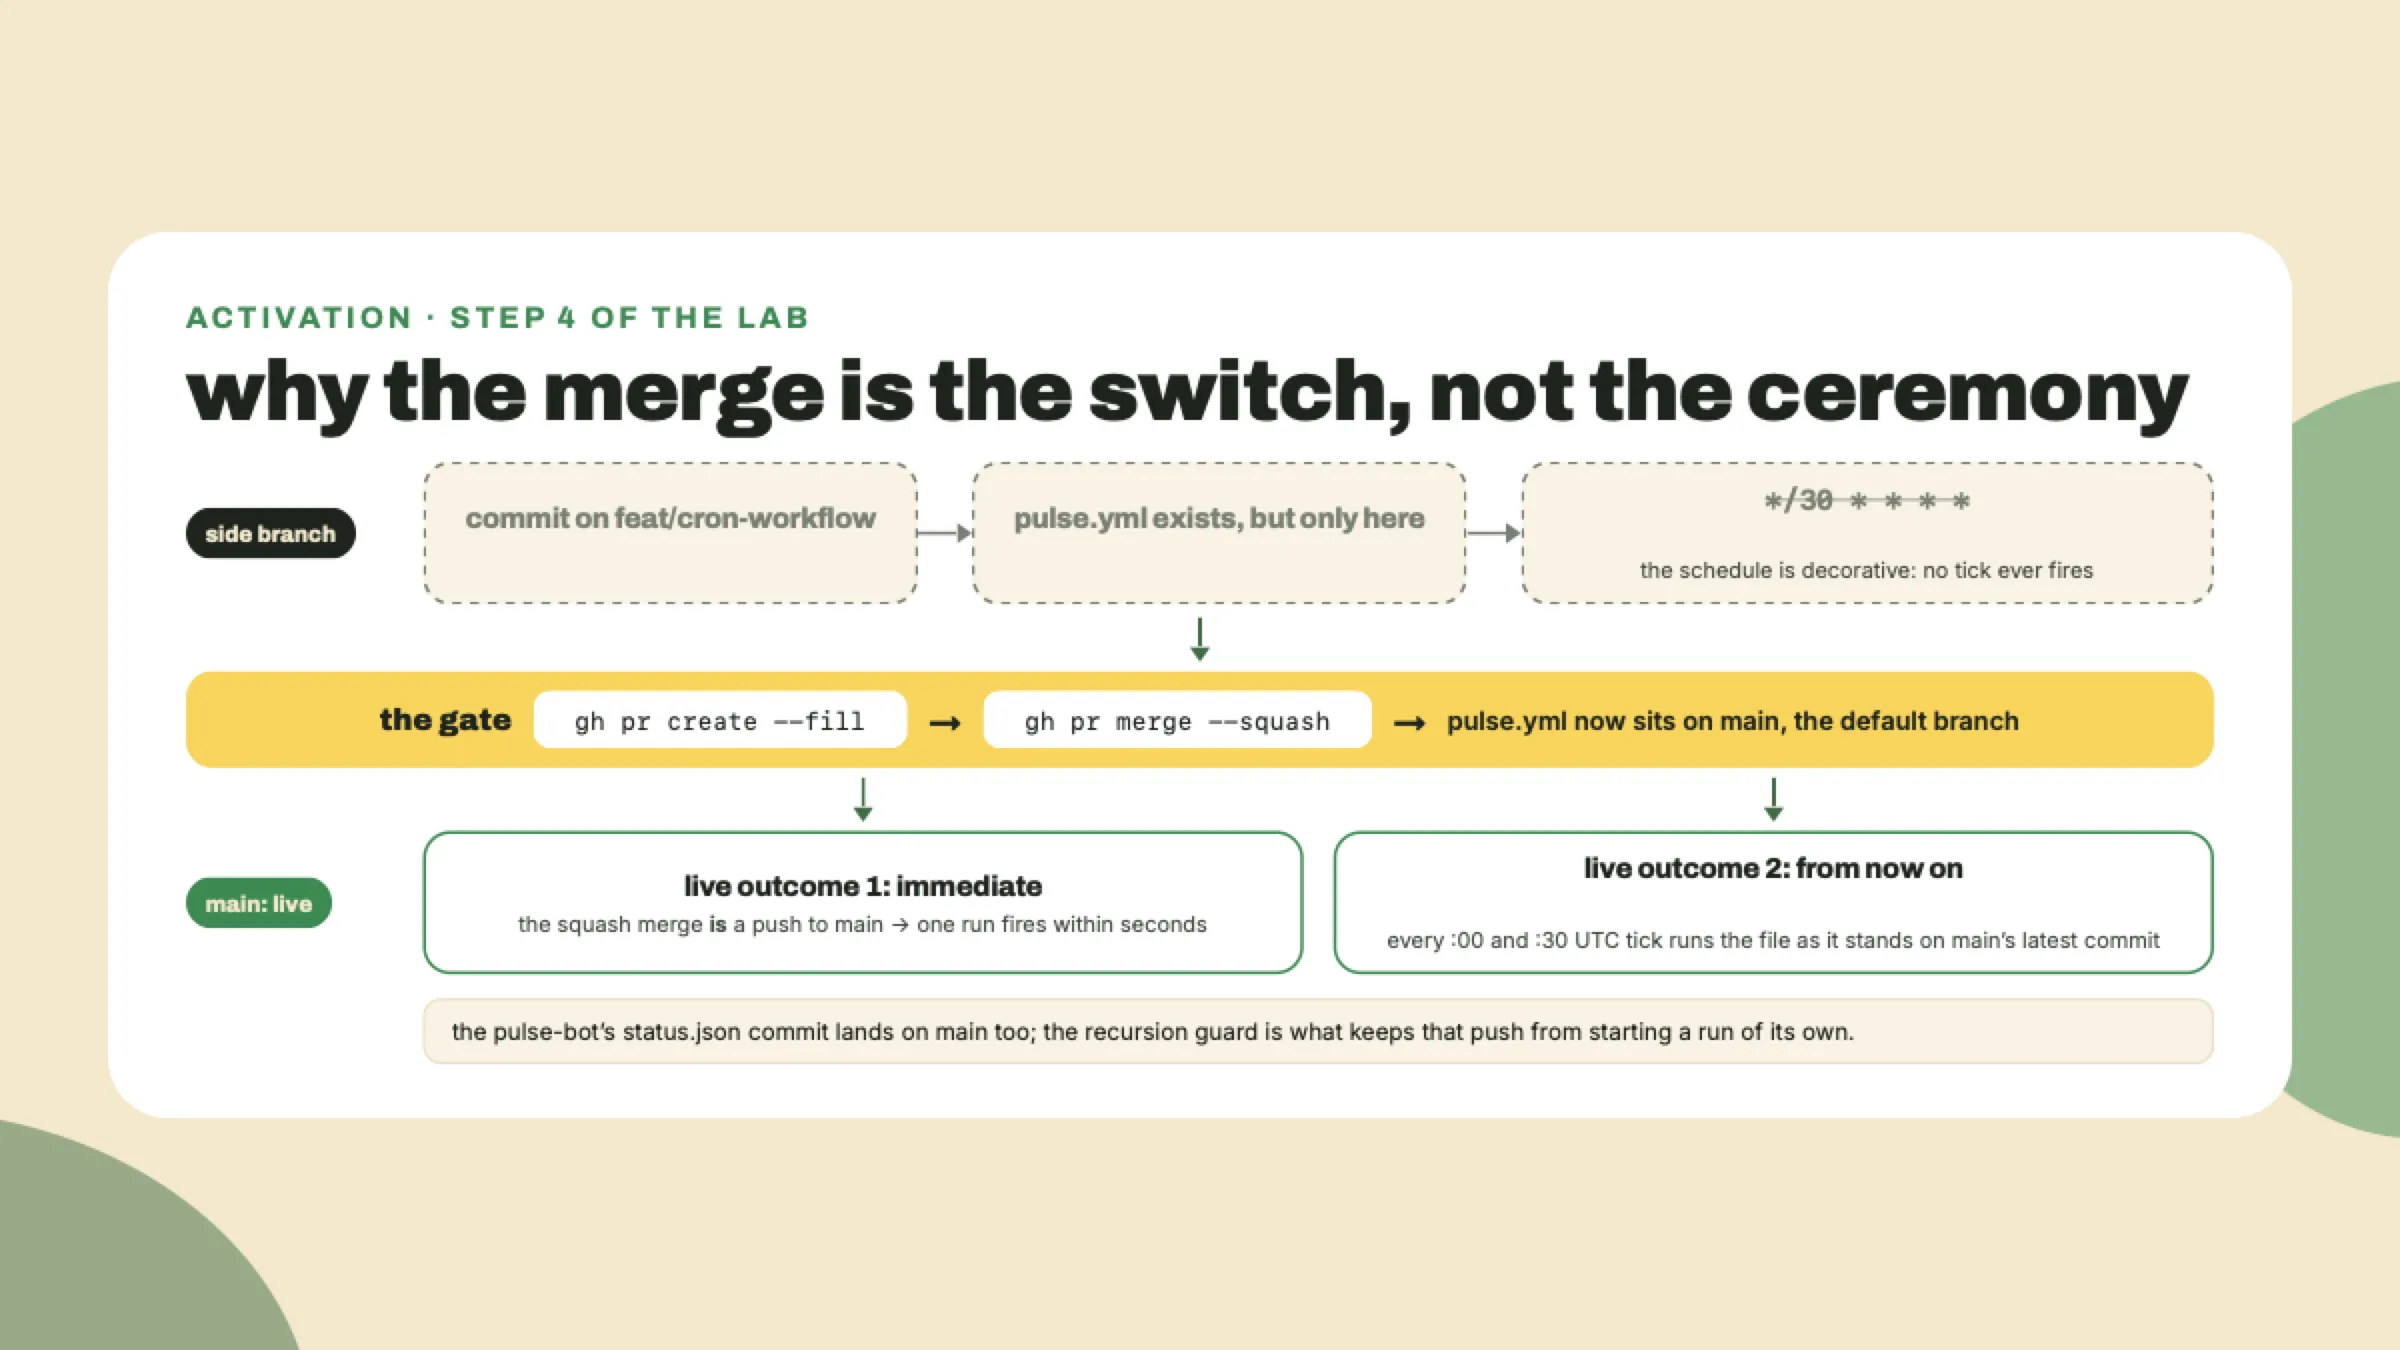
Primero, el gotcha: "Los workflows programados corren sobre el último commit del branch por defecto". El cron de tu branch de feature no existe en lo que al scheduler respecta. Puedes hacer push de un branch con un calendario hermoso y esperar para siempre. Y fíjate que nuestro trigger de push está filtrado a branches: [main], así que hacer push del branch en sí tampoco arranca nada; una pestaña Actions vacía en un branch de feature es el filtro funcionando, no un bug. El flujo es: construir en un branch, hacer merge a main y dejar que el push del propio merge a main dispare el workflow para feedback instantáneo; solo entonces arranca el reloj también. Por eso el lab hace merge antes de mirar.
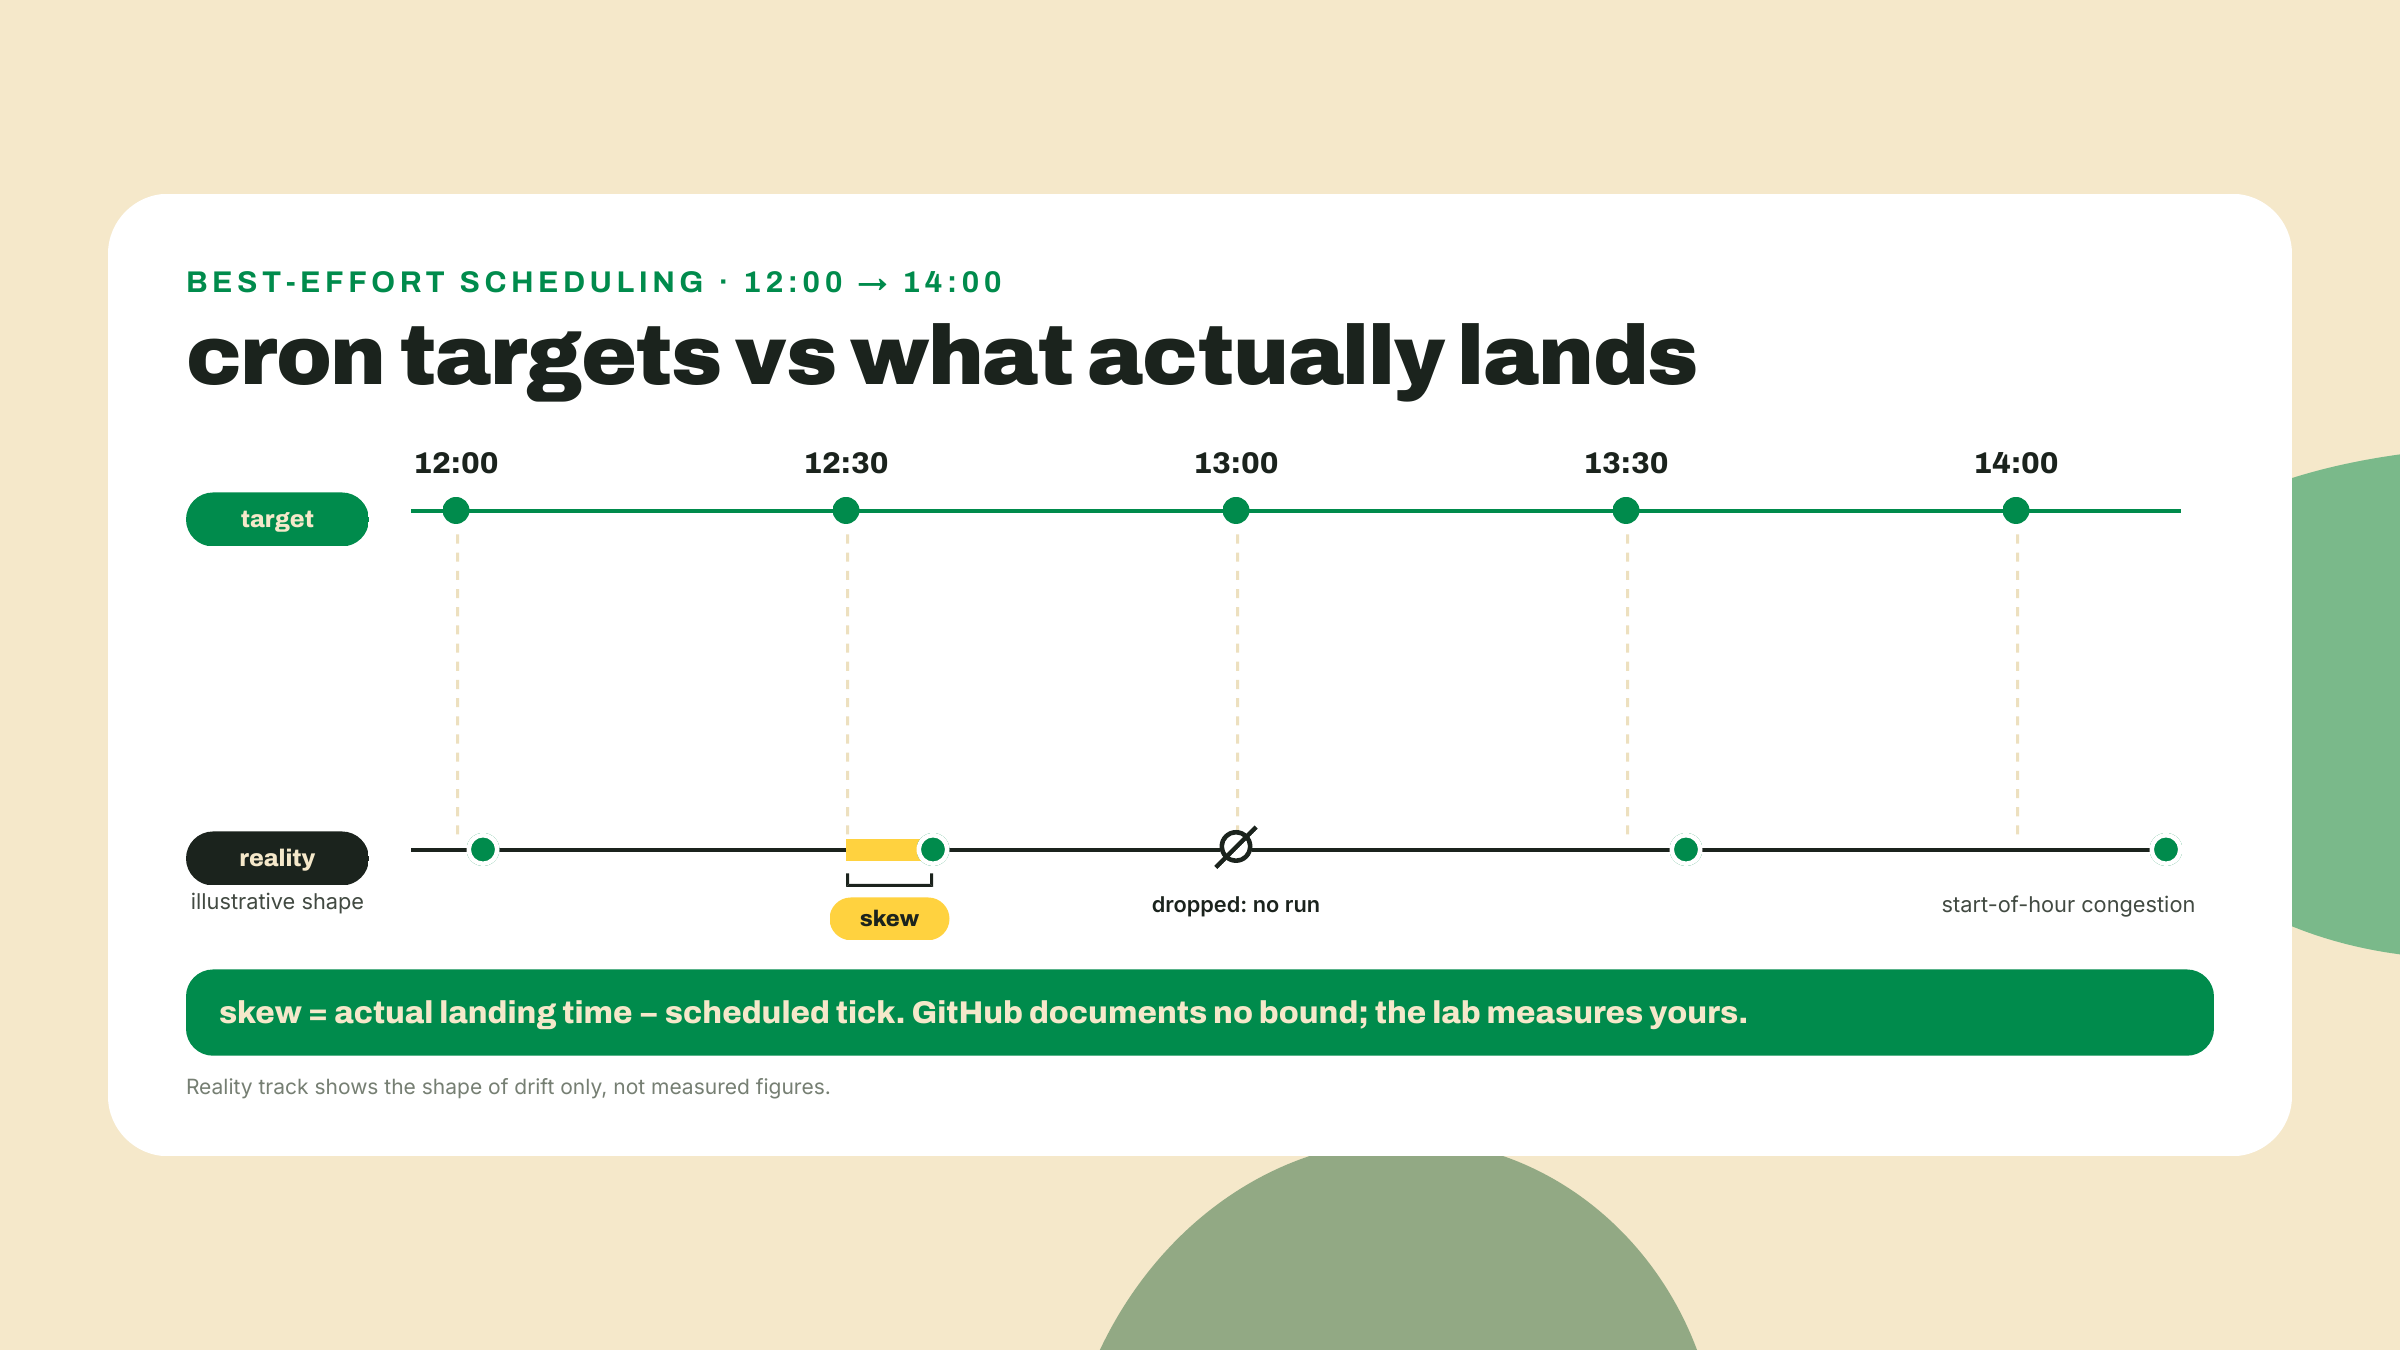
Segundo, la física: el calendario es best-effort. Textualmente, de dos páginas de docs distintas: "Los eventos programados pueden retrasarse durante periodos de alta carga en ejecuciones de workflows de GitHub Actions. Los momentos de alta carga incluyen el comienzo de cada hora. Si la carga es suficientemente alta, algunos jobs en fila pueden descartarse". Lee eso dos veces. No solo retrasados. Descartados. Tu ejecución de :30 puede caer a las :34 y, de vez en cuando, puede no caer para nada.
¿Cuánto tarde, en promedio? Nadie te lo puede decir, y lo digo literalmente: GitHub documenta la existencia del retraso y su causa, y ningún límite en ninguna parte. Los hilos de la comunidad reportan de todo, de minutos a horas, y se contradicen entre sí por órdenes de magnitud, que es exactamente el tipo de número que deberías negarte a repetir. Así que no lo haremos. Vamos a medir. La jugada característica de este curso, y acá está su primera aparición, es targets contra realidad: Solana, la blockchain hacia la que construye este curso, apunta a slots de 300ms (un slot es el latido de la blockchain, el intervalo en el que produce bloques), y una sonda de 20 muestras el 2026-09-01 midió 316ms. La misma física acá. Tu cron tiene un target (:00:30) y una realidad (cuando la fila lo permita), y el lab te hace comparar los dos y reportar TU desfase, igual que la lección m08-l1 te va a hacer medir el tiempo de slot de la blockchain en vez de citar su target. Un latido de 30 minutos se encoge de hombros ante una deriva de cuatro minutos y sobrevive a una ejecución descartada. Un bot de trading no. Elegir cargas de trabajo que toleran la holgura de la plataforma es una decisión de diseño, y la estás tomando ahora mismo, a propósito.
El workflow que vas a terminar en el lab termina haciendo commit de status.json de vuelta al repo. Dos preguntas deberían molestarte sobre eso, y las dos tienen respuestas de una palabra escondidas en la plataforma.
Pregunta uno: ¿puede el workflow hacer push siquiera? No por defecto. Cada ejecución recibe una credencial integrada llamada GITHUB_TOKEN, creada automáticamente, con alcance a tu repo, que expira con la ejecución. La política por defecto reciente le da permiso de contents de solo lectura, así que un push con ella falla con un 403 a menos que pidas más. Lo pides en el archivo del workflow, y el pedido es visible, revisable y versionado:
permissions:
  contents: write
Ese bloque es el workflow declarando, a la vista, "tengo la intención de escribir en este repositorio". Cualquiera que audite tu repo puede ver exactamente qué puede tocar la automatización. Olvidarlo es la forma más común en que este lab falla; el síntoma es un 403 en el step de push.
Pregunta dos, la divertida: nuestro workflow se dispara con push, y el workflow mismo hace push. ¿Por qué esto no es un loop infinito, 48 ejecuciones recursivas de profundidad para la hora del almuerzo? Porque GitHub lo pensó, textualmente: "Los eventos disparados por el GITHUB_TOKEN no van a crear una nueva ejecución de workflow", con exactamente dos excepciones, workflow_dispatch y repository_dispatch, ninguna de las cuales usamos. Los docs dan la razón en el mismo aliento: "te impide crear accidentalmente ejecuciones recursivas de workflow". El commit de status es datos, no una señal. Cae en el repo, no despierta el pipeline. Para nuestra estación esta guarda es un regalo discreto: el único comportamiento que habríamos tenido que construir nosotros mismos ya viene por defecto.
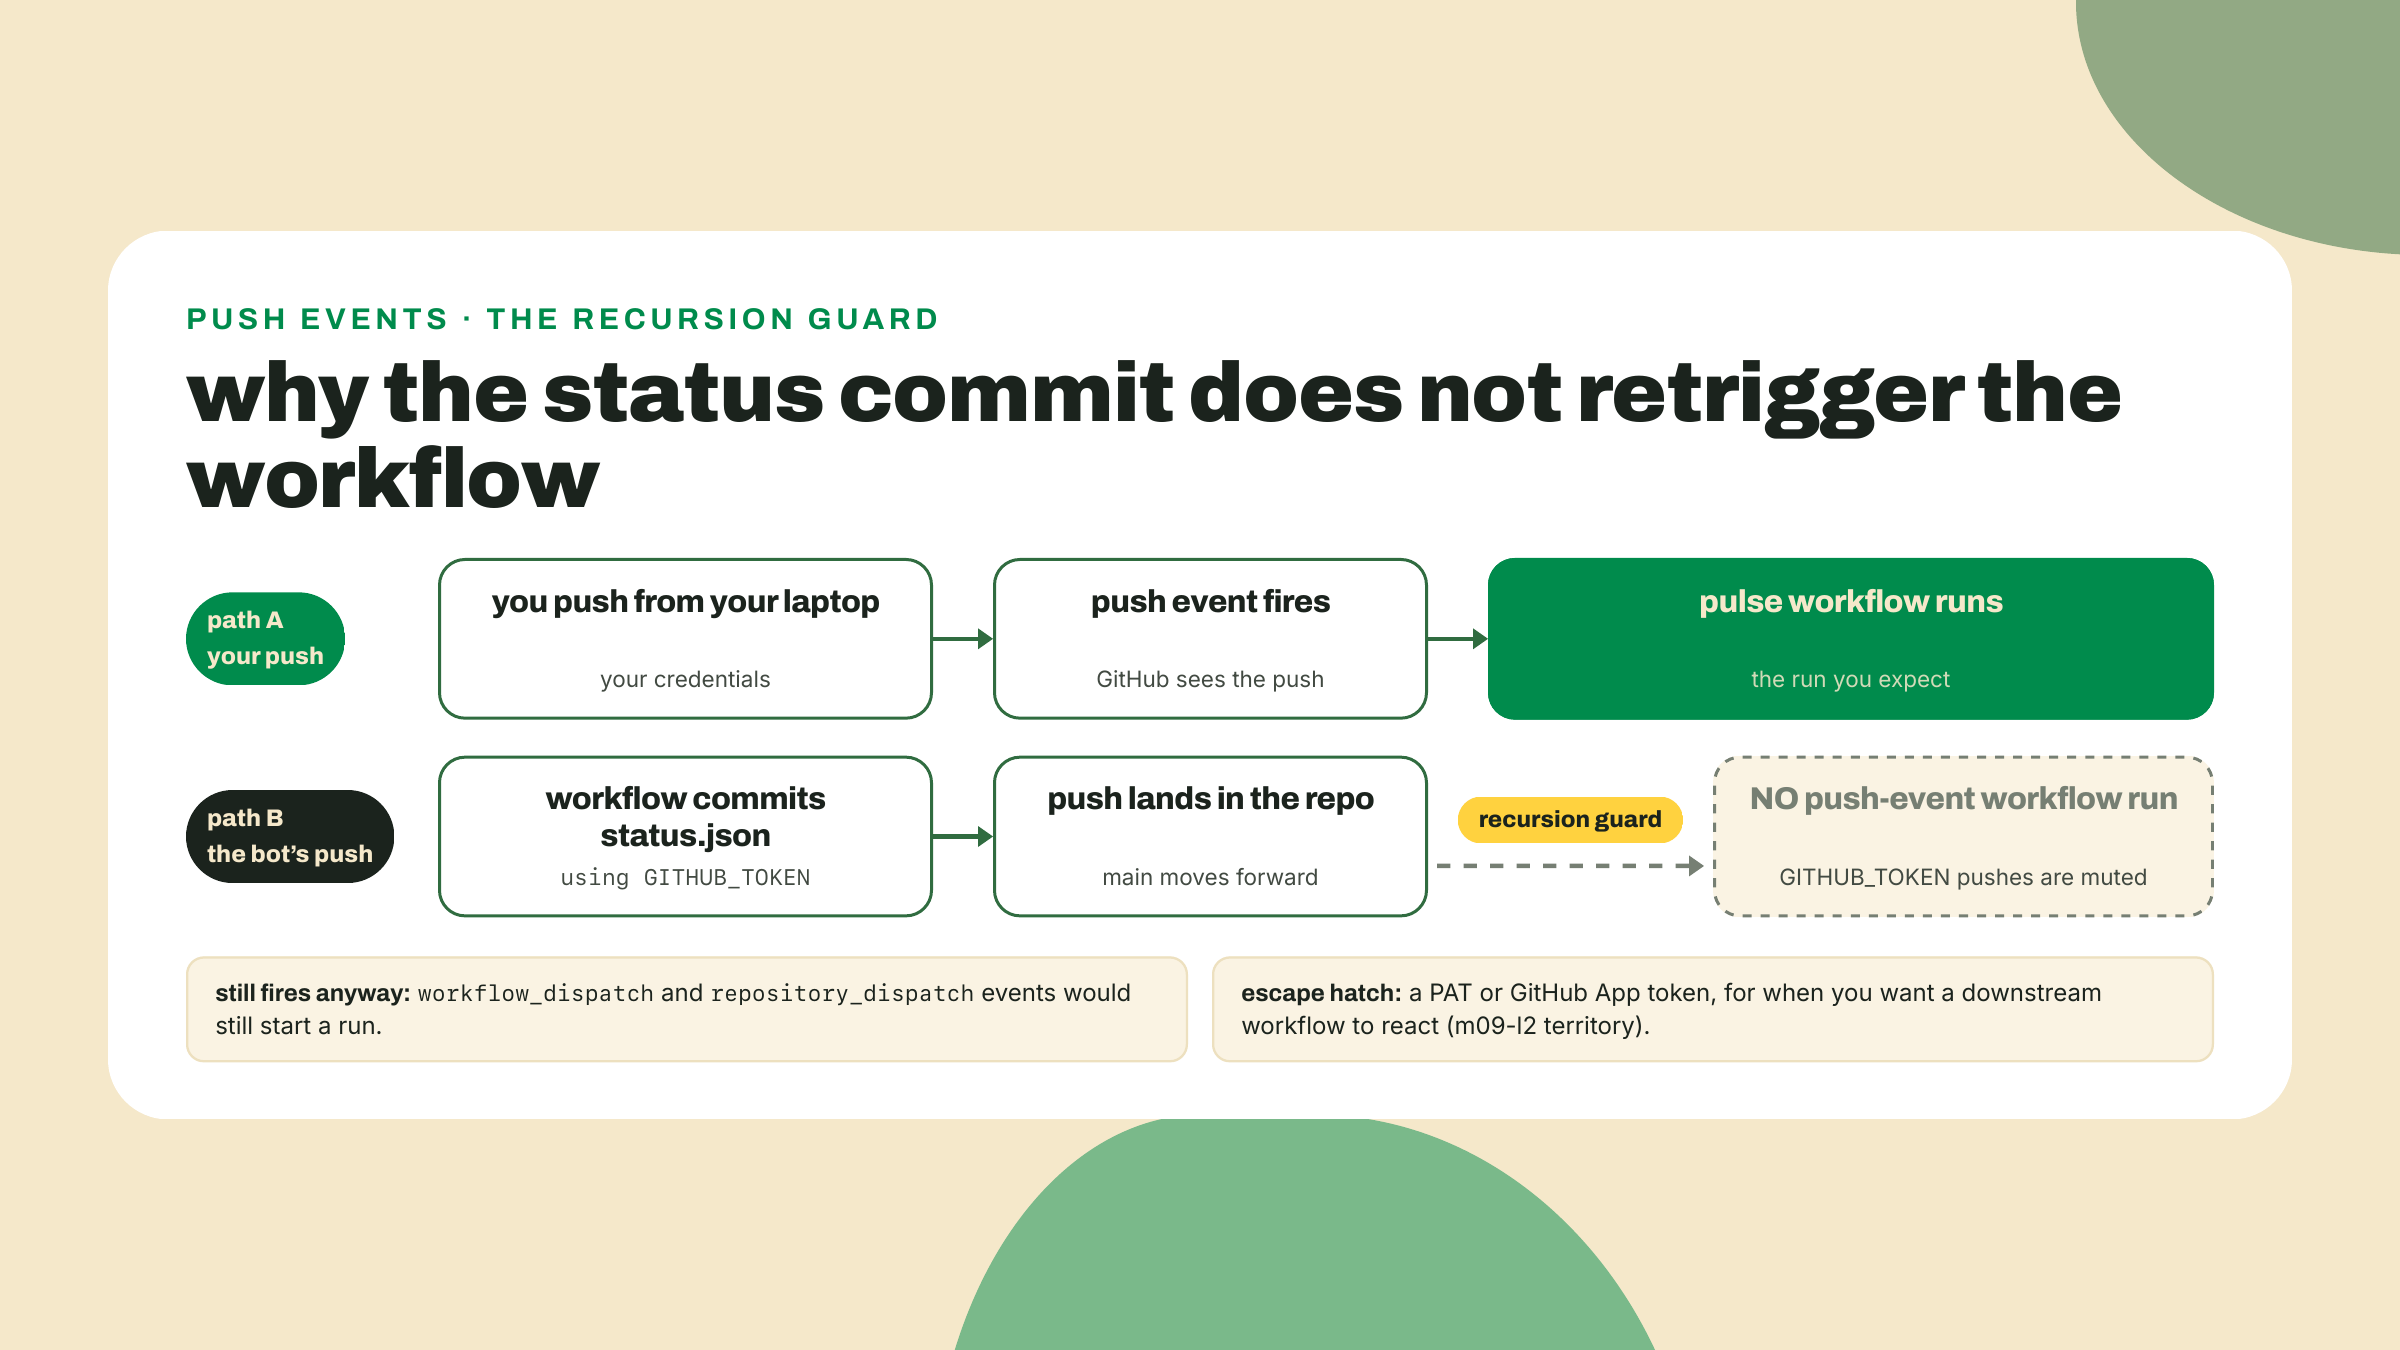
Un adelanto para que la guarda no te sorprenda después: algún día QUERRÁS que un commit despierte un segundo workflow, y el camino documentado es autenticarte con un personal access token o un token de GitHub App en vez de GITHUB_TOKEN. Ese puente vuelve en el ensamblaje del capstone del módulo 10, donde vuelves a leer esta misma guarda como operador; hoy, la guarda funcionando contra la propagación es exactamente lo que queremos.
Ahora la trampa que a todos les llega tarde o temprano, a mí incluido. Volví de unas semanas afuera a uno de mis propios repos de estación y encontré sus datos congelados a mitad de mes: sin error, sin email, sin X roja. Solo silencio, de semanas. La primera vez que pasa vas a jurar que la plataforma se rompió. No se rompió. Lo documentó.
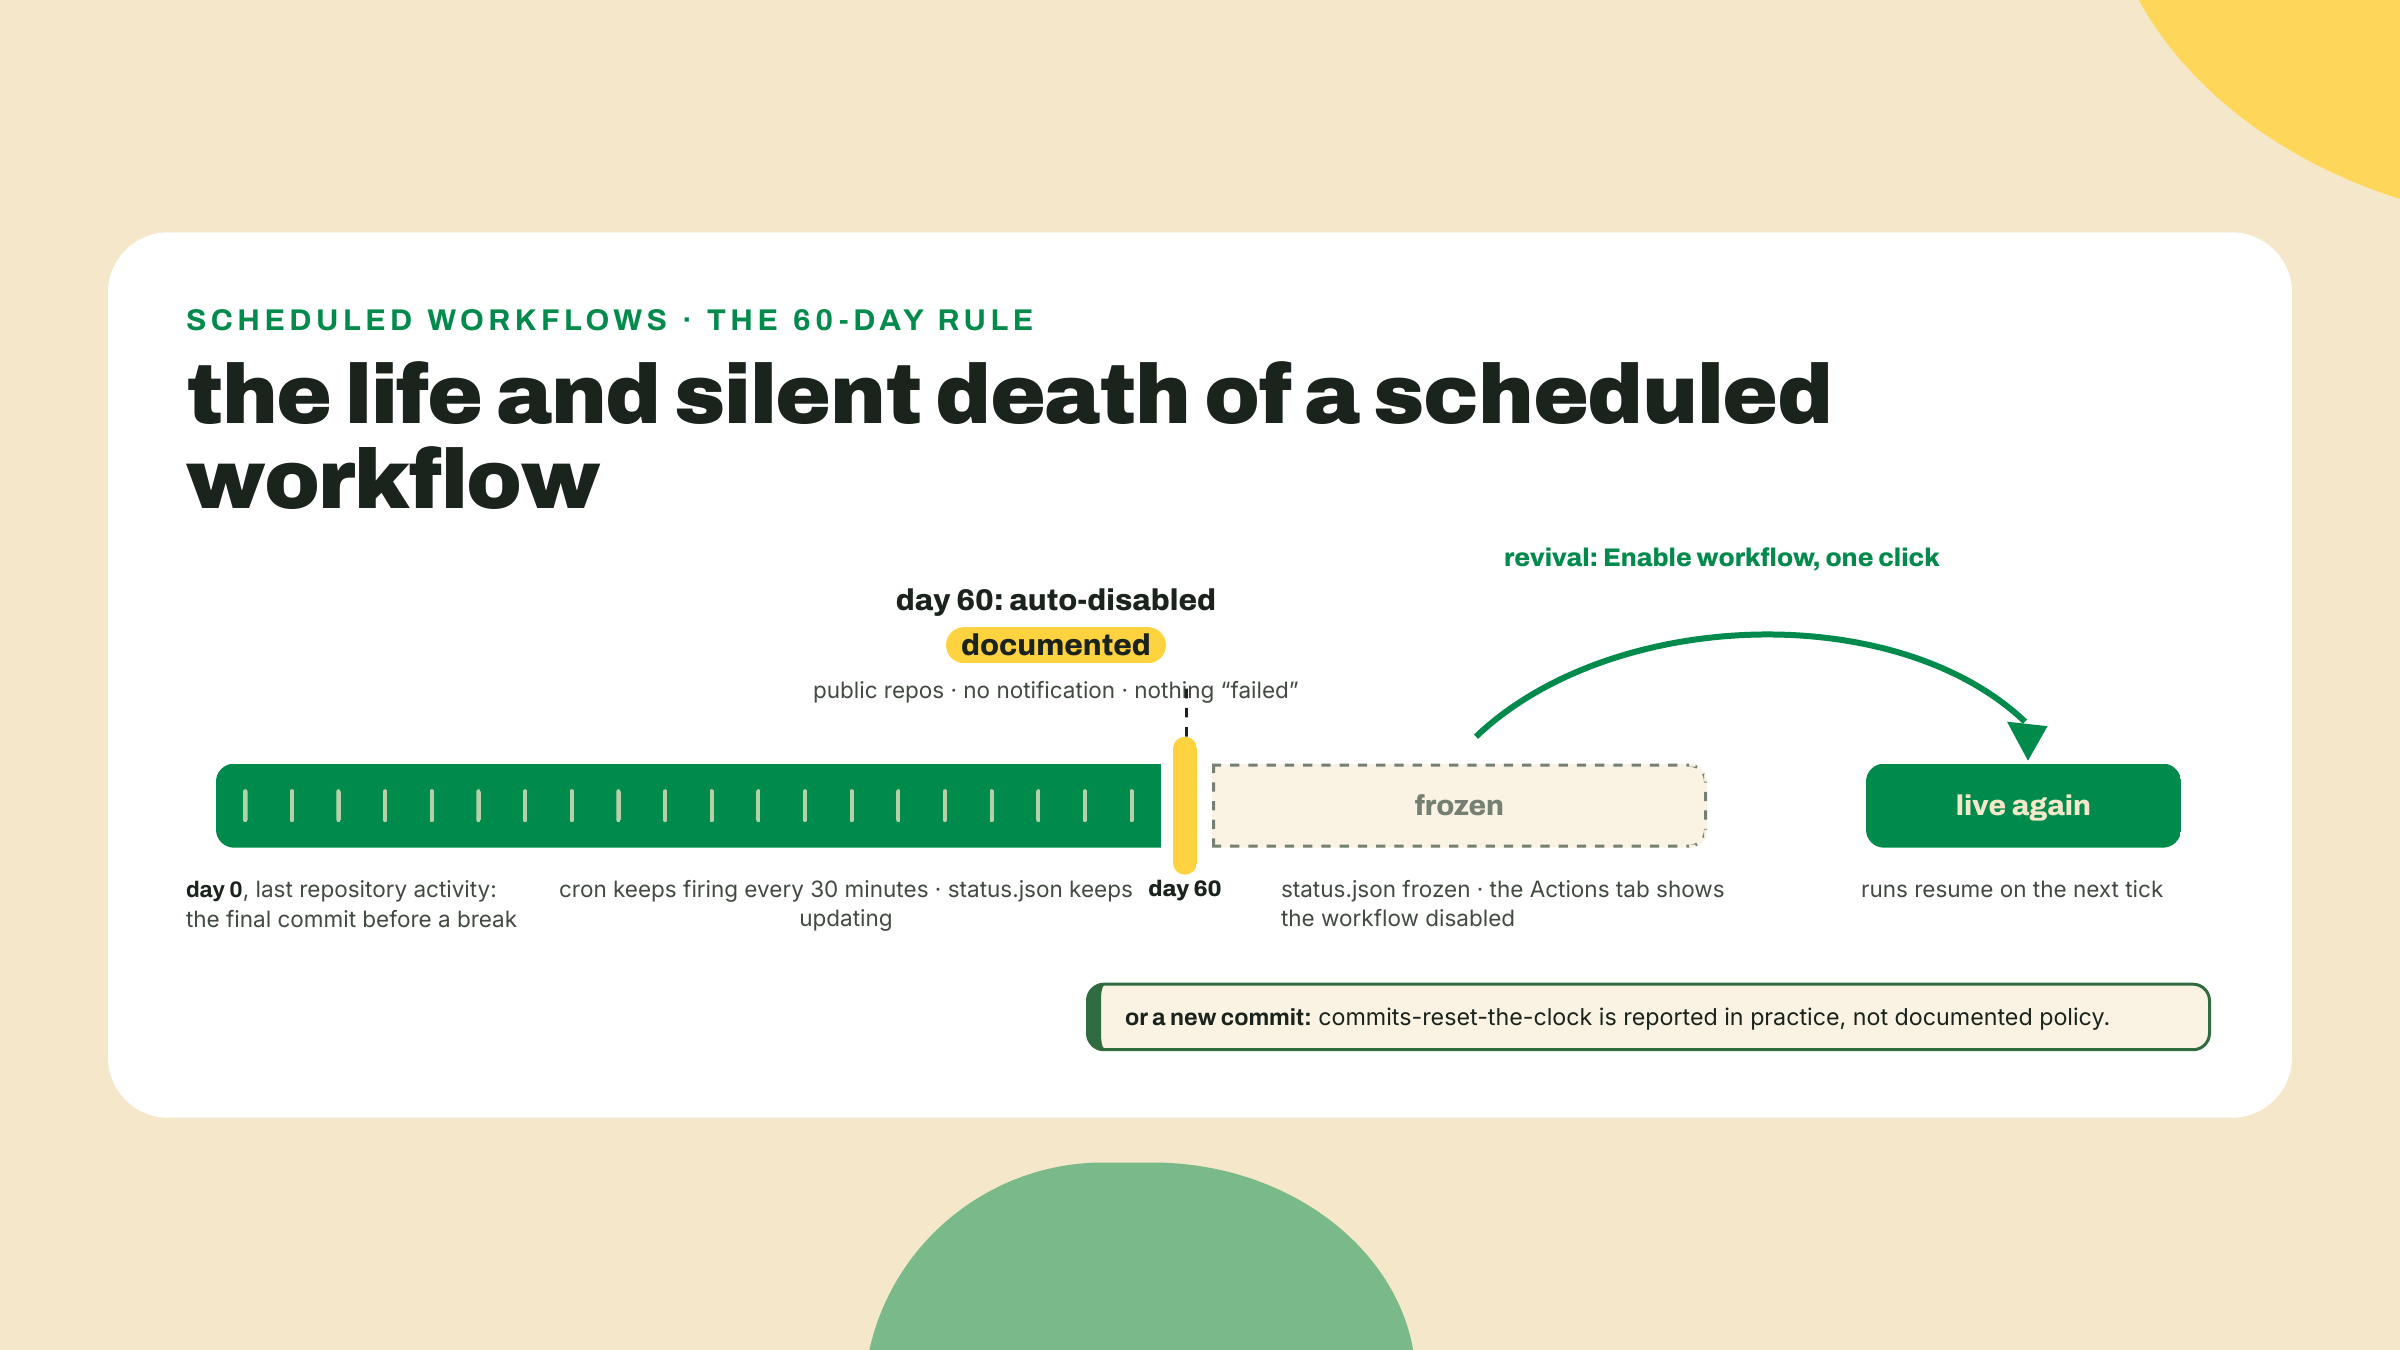
Textualmente: "En un repositorio público, los workflows programados se desactivan automáticamente cuando no ha habido actividad en el repositorio en 60 días". Sesenta días inactivos y GitHub apaga tu cron. Nada falló, así que no se dispara ninguna notificación de falla; el calendario simplemente se detiene. Reactivarlo es un clic: pestaña Actions, selecciona el workflow en la barra lateral, Enable workflow.
La contramedida que todos usan es el commit keepalive: actividad automática o manual que reinicia el reloj. Acá te debo una salvedad, porque es donde los docs se quedan callados: GitHub nunca define qué quiere decir "actividad en el repositorio". La práctica de la comunidad, y la existencia de actions keepalive hechas para eso, dice que los commits reinician el reloj de 60 días, y así es como yo lo jugaría. Pero eso es reportado-en-la-práctica, no política de GitHub, y este curso no va a disfrazar lo uno de lo otro. Para tu estación, la lectura práctica es más suave de todos modos: un repo en el que estás construyendo activamente reinicia su propio reloj todo el tiempo, y una estación terminada que tiene que sobrevivir a tu atención es precisamente el caso para el que existe la lección de alarma del módulo 9.
Trampa adyacente, misma familia: los forks. Textualmente: "Cuando se hace un fork de un repositorio público, los workflows programados quedan desactivados por defecto". Si un colega hace un fork de tu estación esperando un latido que corre, recibe uno muerto hasta que visite su propia pestaña Actions y lo active. Hacer-un-fork-y-esperar-para-siempre es un rito de iniciación; ahora no va a ser el tuyo.
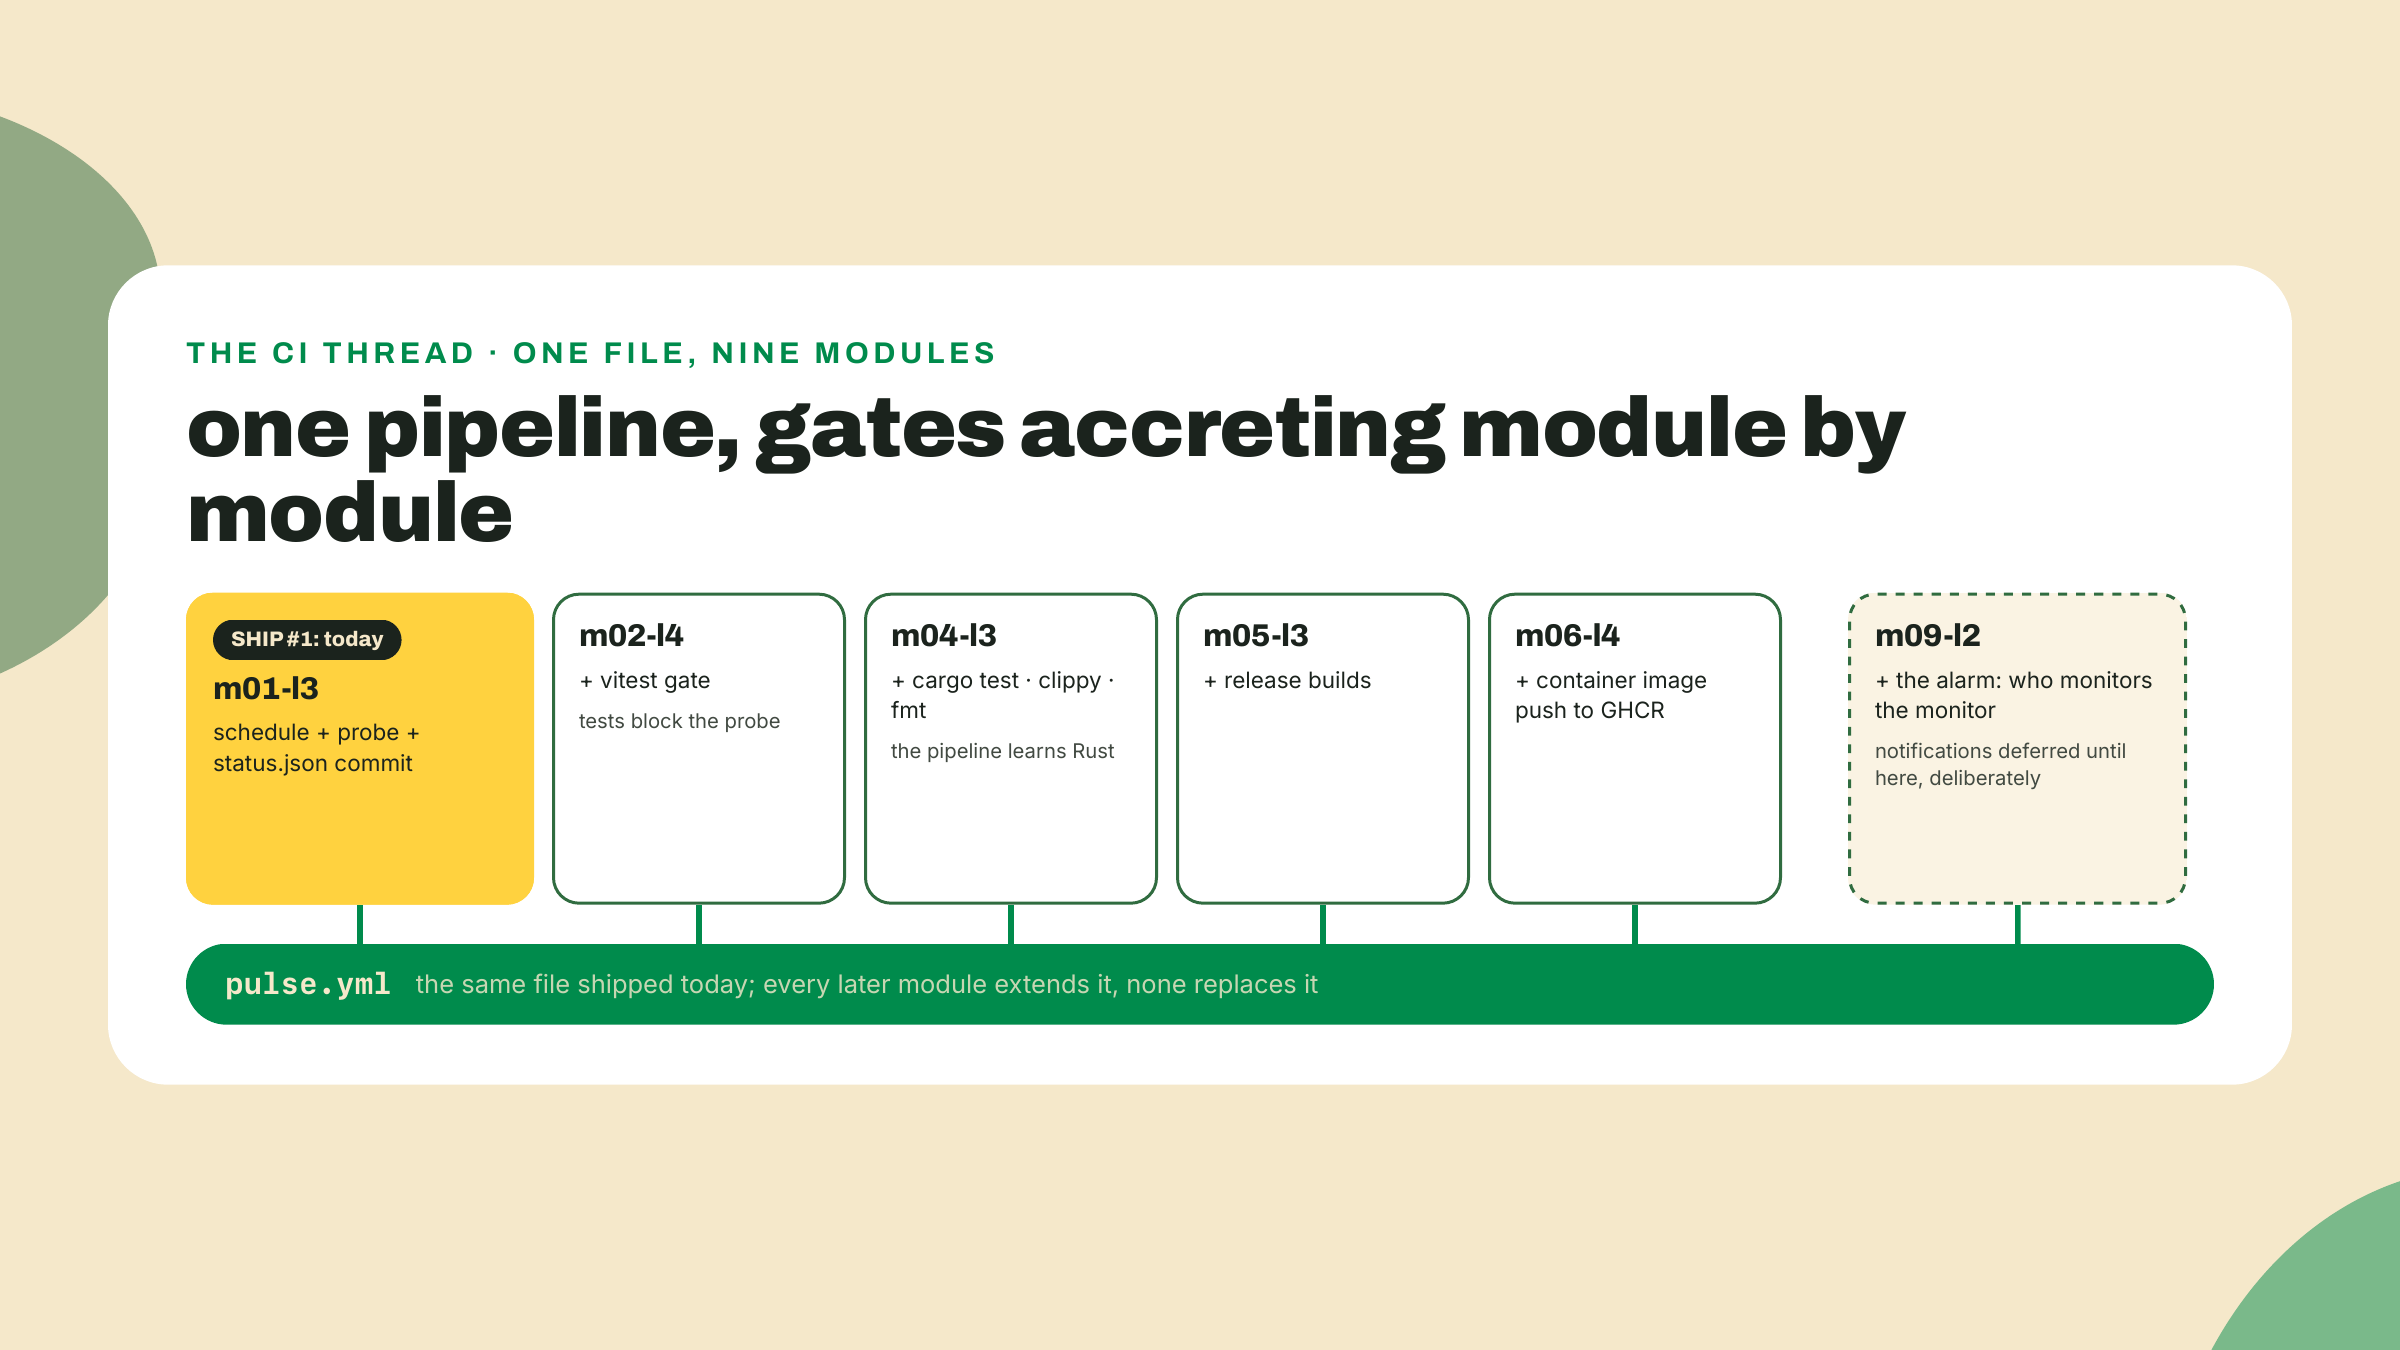
Toma distancia una vez antes del lab, porque este archivo YAML no es un decorado de una sola lección. Es la columna vertebral del curso, y quiero ese contrato por escrito.
CI no es un test runner. Es la primera máquina que no es tuya para correr tu código. Las pruebas son solo una de las cosas que puedes ponerle. Hoy la máquina corre tu sonda en un reloj. En m02-l4 este mismo archivo crece una barrera de vitest, y de ahí en adelante el código que falla sus pruebas no puede llegar a main. En m04-l3 aprende Rust: cargo test, clippy, fmt como no negociables. En m05-l3 construye binarios de release; en m06-l4 hace push de imágenes de contenedor a un registro. Cada módulo que sigue agrega una barrera a ESTE pipeline, el que entregas hoy. Para el capstone, "está en main" y "una máquina lo verificó" van a querer decir lo mismo, y esa equivalencia es, por lejos, el hábito más transferible que instala este curso.
El trade-off que estás aceptando merece la misma luz. En tu laptop la sonda corrió exactamente cuando dijiste. En la infraestructura compartida del tier gratis el calendario es best-effort: las ejecuciones se desvían y, bajo carga, algunas se descartan, lo cual es sobrevivible para un latido de 30 minutos y descalificante para cualquier cosa que necesite tiempos exactos. La plataforma también puede detenerte en silencio, como acaba de mostrar la regla de los 60 días. Cambiaste control por permanencia, y CI gratis en las máquinas de alguien más quiere decir hacer ingeniería para SUS modos de falla. Esa habilidad, diseñar alrededor de la holgura documentada de una plataforma en vez de resentirla, es el hilo de ops de todo este curso.
Profundiza (el 20%). esta lección enseñó la porción de GitHub Actions que la estación necesita: los triggers, una forma de job, el token y la física del calendario de la plataforma. El resto, builds de matriz, estrategias de caché, workflows reutilizables, environments, secrets, runners self-hosted, vive en la documentación de GitHub Actions en https://docs.github.com/en/actions (verificado en vivo 2026-09-02). Guárdalo como bookmark ahora; cuando la barrera de un módulo posterior necesite una feature que no enseñamos, ahí es a donde vamos a apuntar, capítulo por capítulo. Nada del lab de hoy depende de eso.
Hora de hacer que el check verde pase sin ti. Pipeline completo: un runner de flota que escribe status.json, el workflow adulto con tus tres TODOs, un branch-y-merge como se debe, y después la espera por una ejecución que no arrancaste.
Haz que la sonda escriba un archivo, no solo una línea. Tu probe.ts imprime en una terminal que nadie va a estar mirando a las 3 a.m.; la flota necesita evidencia en disco. Crea fleet.ts al lado:
import { writeFile } from "node:fs/promises";

const TARGETS = [
  "https://www.rust-lang.org",
  "https://www.typescriptlang.org",
  "https://solana.com",
];

type ProbeResult = {
  url: string;
  status: number;
  latencyMs: number | string; // deliberate v0 sin, see below
  checkedAt: string;
};

async function probeOne(url: string): Promise<ProbeResult> {
  const checkedAt = new Date().toISOString();
  const start = performance.now();
  try {
    const res = await fetch(url, { signal: AbortSignal.timeout(10_000) });
    const latencyMs = Math.round((performance.now() - start) * 10) / 10;
    return { url, status: res.status, latencyMs, checkedAt };
  } catch {
    return { url, status: 0, latencyMs: "timed out or unreachable", checkedAt };
  }
}

const results: ProbeResult[] = [];
for (const url of TARGETS) {
  results.push(await probeOne(url));
}

const report = {
  generatedAt: new Date().toISOString(),
  targets: results,
};

await writeFile("status.json", JSON.stringify(report, null, 2) + "\n");
console.log(`wrote status.json: ${results.length} targets`);
El mismo par de tiempos que probe.ts, tres targets en secuencia, un archivo JSON de salida. Esa forma de reporte, generatedAt más un array targets de { url, status, latencyMs, checkedAt }, es un contrato: el panel del módulo 3 renderiza exactamente este archivo, así que trata los nombres de los campos como congelados desde hoy. Y sí, latencyMs: number | string es una mentira esperando a pasar: un timeout queda registrado como prosa y un consumidor aguas abajo que haga matemática con eso se lleva una sorpresa. Ese pecado es deliberado, el módulo 2 es enteramente sobre hacer que esta flota falle a gritos en vez de cortésmente, y necesita algo que arreglar. Córrelo una vez localmente:
npx tsx fleet.ts
cat status.json
Esperado: tres latencias de verdad (o una cadena honesta si un target dio timeout) en JSON formateado. La instalación de la lección pasada fijó tsx en devDependencies; confirma que está listado en package.json, porque el npm ci del runner está a punto de necesitar una instalación reproducible. Si de alguna forma falta, npm i -D tsx lo arregla.
Haz crecer el workflow. Reemplaza la versión con echo de .github/workflows/pulse.yml por la de verdad. Tres TODOs son tuyos; todo lo demás está dado. Llénalos antes de espiar el paso 3:
name: pulse

on:
  push:
    branches: [main]
  schedule:
    # TODO 1: a cron expression that fires every 30 minutes
    - cron: "TODO"

# TODO 2: the permissions block that lets GITHUB_TOKEN push
#         (without it, the final step dies with a 403)

jobs:
  probe:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: 24
          cache: npm
      - run: npm ci
      - run: npx tsx fleet.ts
      - name: Commit status.json if it changed
        run: |
          git config user.name "pulse-bot"
          git config user.email "pulse-bot@users.noreply.github.com"
          git add status.json
          # TODO 3: skip the commit when status.json is unchanged
          #         (hint: git diff --staged --quiet exits 0 when staged is empty)
          git commit -m "pulse: scheduled probe"
          git push
Leyendo las partes dadas: checkout pone tu código en el runner en blanco, setup-node instala Node 24 (la línea LTS actual; Node 26 toma el relevo como LTS el 2026-10-28, y el 24 de acá se va a subir cuando el hilo de ops del curso lo revise) con caché de npm, npm ci hace una instalación limpia desde tu lockfile, y el step de commit le da un nombre al robot para que el historial de status.json se lea con honestidad.
Los TODOs llenos. Compara, no copies primero:
on:
  push:
    branches: [main]
  schedule:
    - cron: "*/30 * * * *"

permissions:
  contents: write
Y la guarda, dentro del bloque run: del step de commit, reemplazando el comentario TODO y las dos líneas que le siguen:
if git diff --staged --quiet; then
  echo "status.json unchanged, nothing to commit"
  exit 0
fi
git commit -m "pulse: scheduled probe"
git push
La guarda es práctica defensiva, y voy a ser franco al respecto: como está fleet.ts, generatedAt es un timestamp nuevo en cada ejecución, así que status.json siempre cambia y la guarda nunca se dispara. Pero en el momento en que una edición futura quite o vuelva más gruesos los timestamps, una ejecución con latencias idénticas intentaría un commit vacío y haría fallar el step. git diff --staged --quiet sale con 0 exactamente cuando nada en staged cambió, así que el step termina limpio y la ejecución se queda verde.
Entrégalo a la manera de un dev que trabaja: branch, PR, merge. Podrías hacer push directo a main; agarra la costumbre de no hacerlo, porque cada barrera que este pipeline crece después asume que los cambios llegan como pull requests. Un branch es una etiqueta movible para una línea de commits; un pull request es la unidad de cambio: un diff con nombre que alguien (hoy: tú) revisa y mergea.
git checkout -b feat/cron-workflow
git add .github fleet.ts package.json package-lock.json
git commit -m "ci: probe fleet on a 30-minute schedule"
git push -u origin feat/cron-workflow
gh pr create --fill
gh pr merge --squash
Hacer merge no es burocracia acá, es activación: acuérdate, los workflows programados corren sobre el último commit del branch por defecto. Hasta que esto caiga en main, tu cron es decorativo.
Mira la ejecución disparada por push, después revisa el commit del robot. El merge a main dispara el trigger de push, así que consigues feedback instantáneo sin esperar al reloj. En la pestaña Actions, mira cómo la ejecución se pone en verde. Todavía estás en el branch de feature, y la ejecución local del paso 1 dejó un status.json sin trackear que el commit del workflow ahora también agrega, así que git se negaría al pull para no sobrescribirlo. Vuelve a main, borra el archivo local y haz pull:
git checkout main
rm -f status.json
git pull
git log --oneline -3
Esperado: un commit con autor pulse-bot que toca status.json, sentado encima de tu merge. Ahora clava la vista en la pestaña Actions un segundo más: ese commit del bot NO arrancó otra ejecución. La guarda de recursión de la sección teórica, en vivo en tu propio repo. Si en cambio el step final de tu ejecución falló con un 403, es TODO 2 faltante o mal indentado; arregla, haz push, vuelve a correr.
El momento por el que de verdad entregaste: una ejecución que no arrancaste. La próxima frontera :00 o :30 UTC está a 30 minutos como máximo. Cierra la laptop si quieres; ese es el punto. Cuando vuelvas:
gh run list --workflow pulse.yml --limit 2
Esperado: al menos una ejecución completada cuya columna de evento dice schedule, verde, con un commit nuevo de pulse-bot en status.json detrás. Tu sonda corrió en una máquina que no es tuya, en un reloj que nadie mira, e hizo commit de la evidencia. Ese es SHIP #1. Saboréalo por diez segundos completos.
Mide tu desfase. Targets contra realidad, tu propia edición. Saca los timestamps de tus ejecuciones programadas:
gh run list --workflow pulse.yml --event schedule --limit 3 \
  --json createdAt,status,conclusion
Toma el createdAt de una ejecución, anota el tick :00/:30 al que le estaba apuntando, y resta. Escribe la frase: "programada :30, cayó :3X, desfase Xm". Esa frase es la barrera de la lección, y te convierte en la única persona en la sala con un número de verdad para un retraso que GitHub documenta solo como existente. Mantén el hábito; vas a hacer lo mismo con el tiempo de slot de una blockchain en el módulo 8.
Checkpoint, todo: el historial de Actions muestra una ejecución verde disparada por el calendario que no arrancaste; status.json lleva un commit con autor el workflow; ese commit visiblemente no volvió a disparar el pipeline; y puedes decir tu desfase medido para una ejecución. Cuatro casillas, y el primer ship es real.
El pipeline corre tu código, pero todavía nada impide que el código malo llegue a él. Arregla eso tú mismo.
Agrega a pulse.yml un segundo job llamado typecheck que haga checkout del código, prepare Node de la misma forma, instale, y corra npx tsc --noEmit. Después haz que el job probe dependa de él, así un error de tipos en cualquier parte del repo impide que el job probe llegue a correr. Dos pistas y no más: los jobs corren en paralelo salvo que uno declare needs: sobre otro, y todo lo que el job typecheck necesita ya está demostrado en los primeros tres steps del job probe.
Aceptación, en orden: mete un error de tipos a propósito en fleet.ts y haz push (sí, directo a main, solo esta vez: el trigger de push del workflow solo mira main, así que un push a un branch no dispararía nada; el hábito del paso 4 sigue en pie para cambios de verdad). Mira la ejecución fallar en typecheck con probe salteado por completo. Después revierte el error, haz push de nuevo, y mira todo el pipeline ponerse en verde. Cuando m02-l4 formalice las barreras de CI con una suite de pruebas de verdad, ya habrás construido una de la nada.
Si tu ejecución programada se niega tercamente a aparecer, o tu número de desfase se ve descabellado, lleva la salida de gh run list a la comunidad del curso; una docena de desfases medidos uno al lado del otro enseñan más sobre el calendario best-effort que cualquier página de docs, y yo leo esos hilos.
Tu latido ahora late sin ti: una máquina que no es tuya sondea internet cada media hora y hace commit de la evidencia. Pero lee una semana de status.json y vas a encontrar mentiras corteses, las que plantamos a sabiendas hoy: timeouts registrados como cadenas, targets basura sondeados sin queja. El módulo 2 hace que la flota falle a gritos, empezando por darle a tu v0 un target malformado y verlo encogerse de hombros. Trae un target malformado; no va a saber qué lo golpeó.
Pregunta 1 de 4