Cargando...

 BetaBeta
m05-l3 cerró el módulo de Rust-que-se-entrega: una CLI de clap con su primer brazo de sonda de verdad sobre reqwest blocking, debug contra release medidos con números reales, y CI adjuntando un binario de release a un GitHub Release. Ese binario sondea, imprime y sale. Hoy deja de salir. Vas a hacer crecer un tercer crate en el workspace, pulse-pollerd, que sondea cada target configurado en un intervalo para siempre y contesta GET /status con JSON mientras lo hace. El contrato de repliegue, en voz alta: el loop de poll de tokio es lo único difícil que escribes tú en la lección y lo recibes como un esqueleto de completion con dos huecos. El endpoint de axum (axum es el crate de servidor HTTP de Rust que sirve la única puerta JSON del daemon) es lo opuesto: un drop-in completamente trabajado que lees y editas pero nunca escribes, un paso atrás deliberado en autonomía en un pico real, y lo voy a decir otra vez cuando lleguemos ahí. Todo lo demás es músculo que ya tienes.
Tu CLI sondea y sale. Un monitor que solo corre cuando te acuerdas de invocarlo no es un monitor. Es un rumor con línea de comandos. La estación necesita un proceso que sobreviva a la invocación: un loop que sondea para siempre, y una puerta a la que golpear para preguntar cómo está todo, ahora mismo.
Podrías construir la primera mitad de eso en noventa segundos con lo que ya sabes. Lee esta forma (y si quieres sentirla correr, hazlo en un branch descartable, envolviendo adentro tu probe de m05-l3; NO lo dejes en el main entregado de pulse-cli, que el job de release de m05-l3 publicaría y que el paso 1 del lab necesita intacto):
use std::time::Duration;

fn main() {
    let interval = Duration::from_secs(30);
    loop {
        // your m05-l3 blocking probe(url, timeout), called for each URL you care about
        std::thread::sleep(interval);
    }
}
Eso es un daemon: un proceso de primer plano de larga vida que hace su trabajo en un cronograma sin que se lo pidan dos veces. Sin crates nuevos, sin runtime, sin async. Ctrl+C lo mata. Para un puñado de targets esto está legítimamente bien, y quiero que te quedes con esa sensación, porque la lección entera se trata de saber exactamente cuándo deja de estar bien. (Si lo corriste en un branch, borra el branch ahora; el hogar de verdad para el loop es el crate nuevo que construye el lab.)
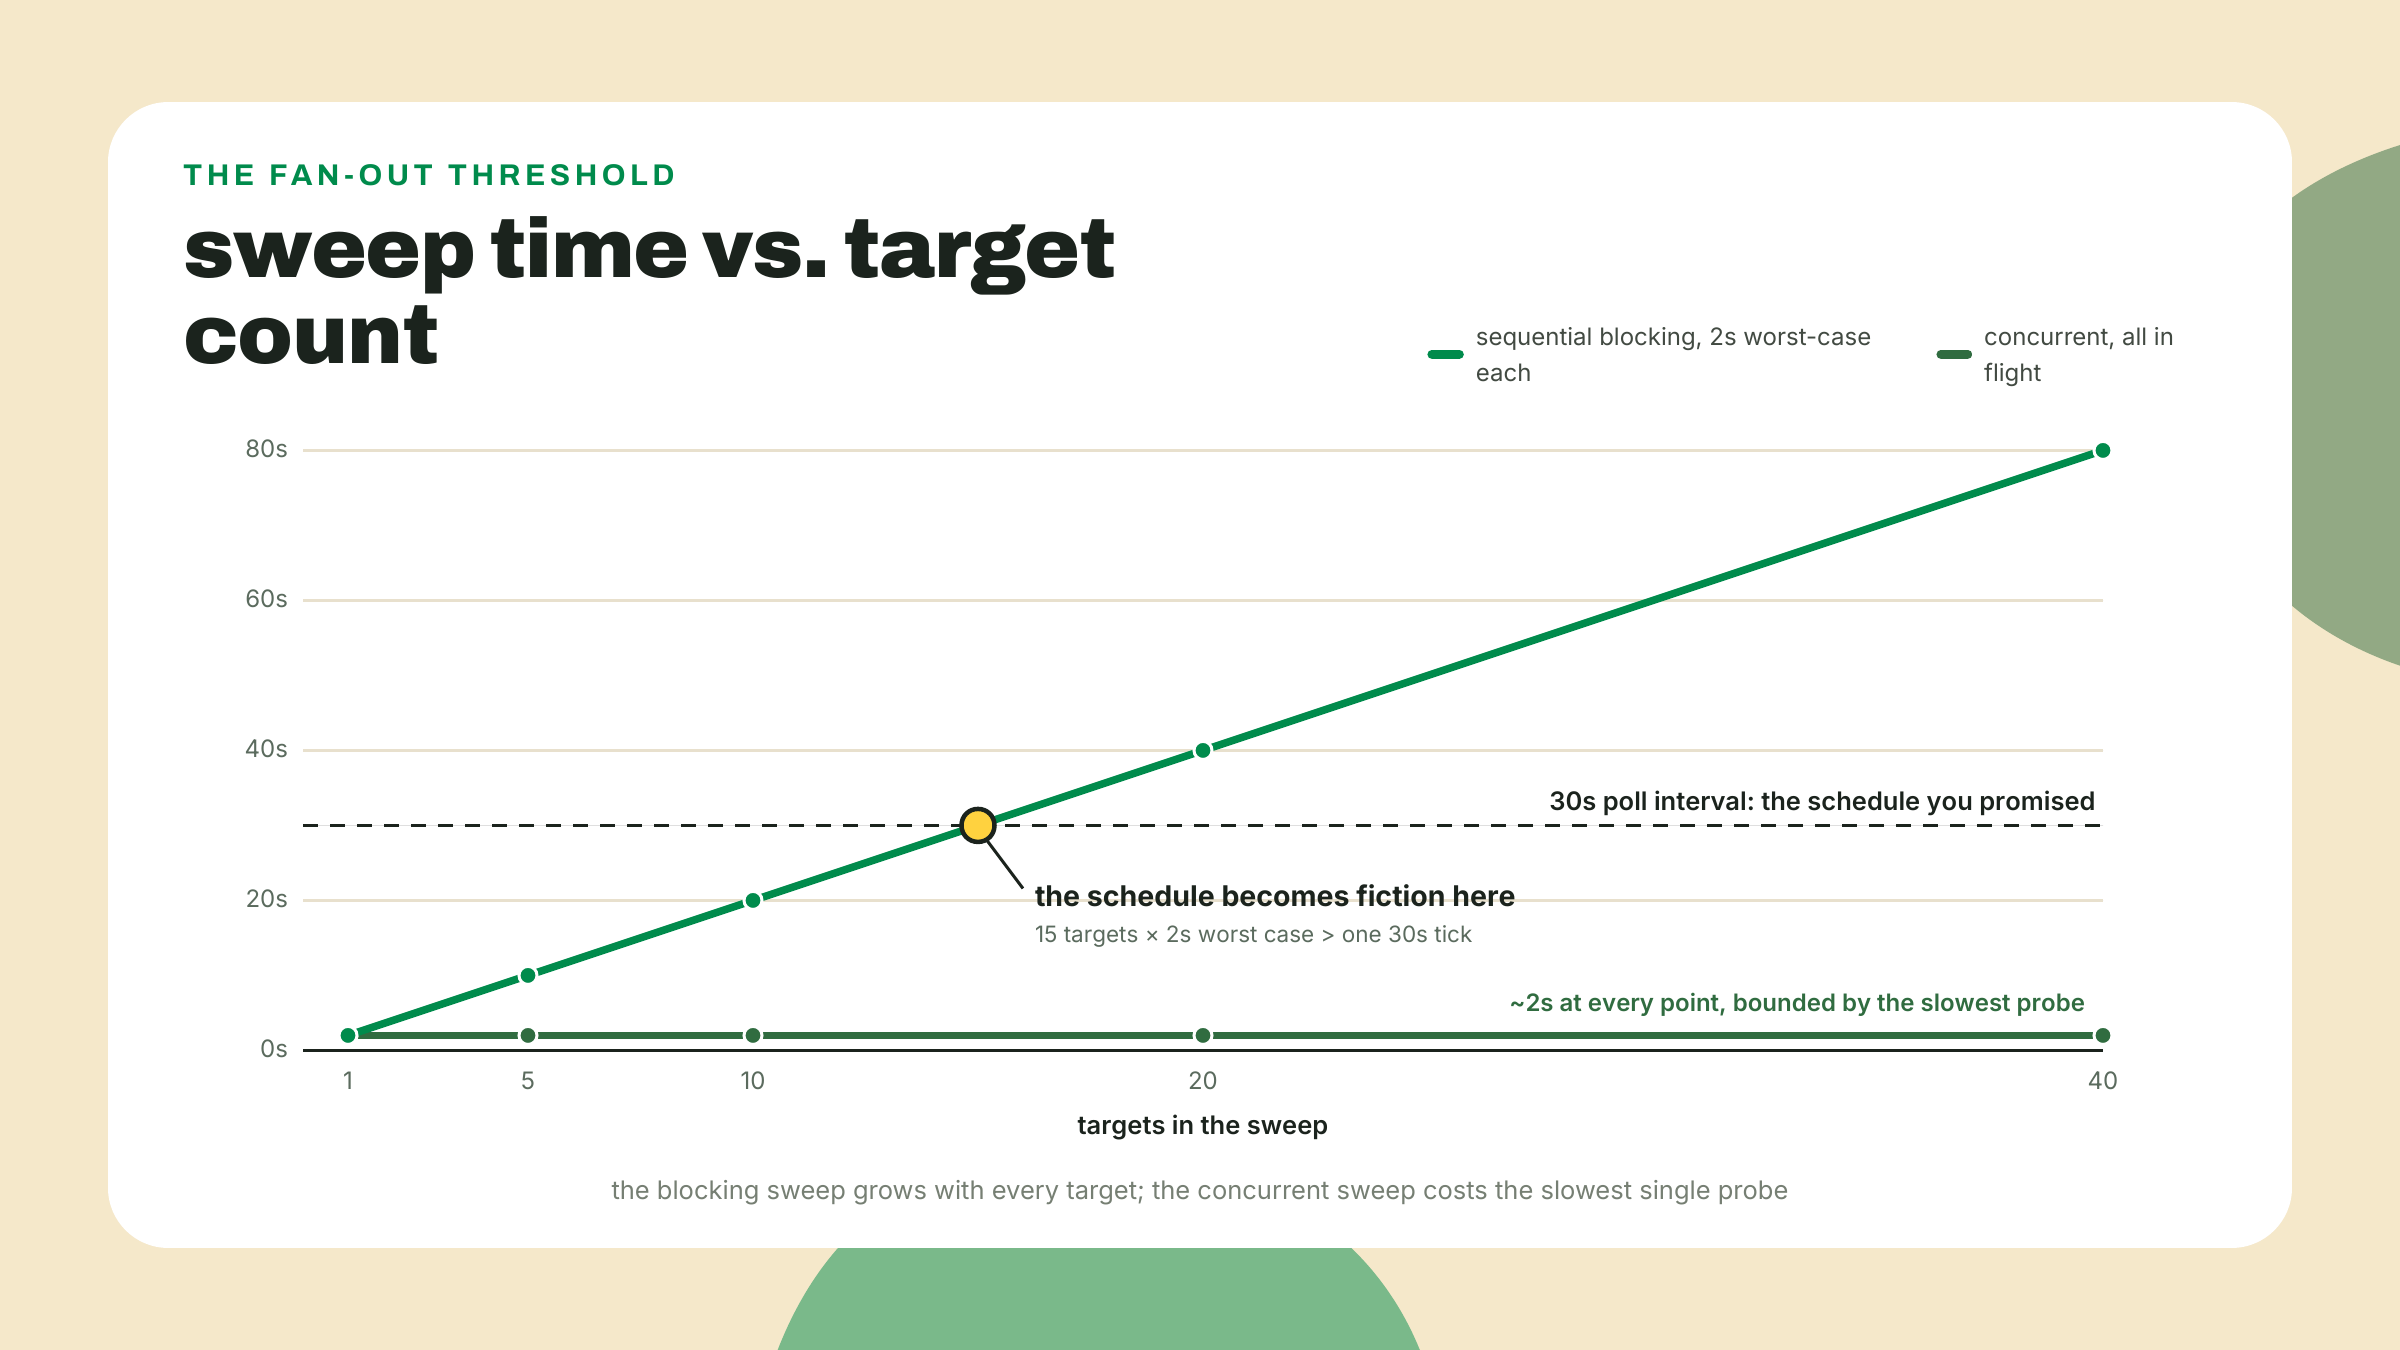
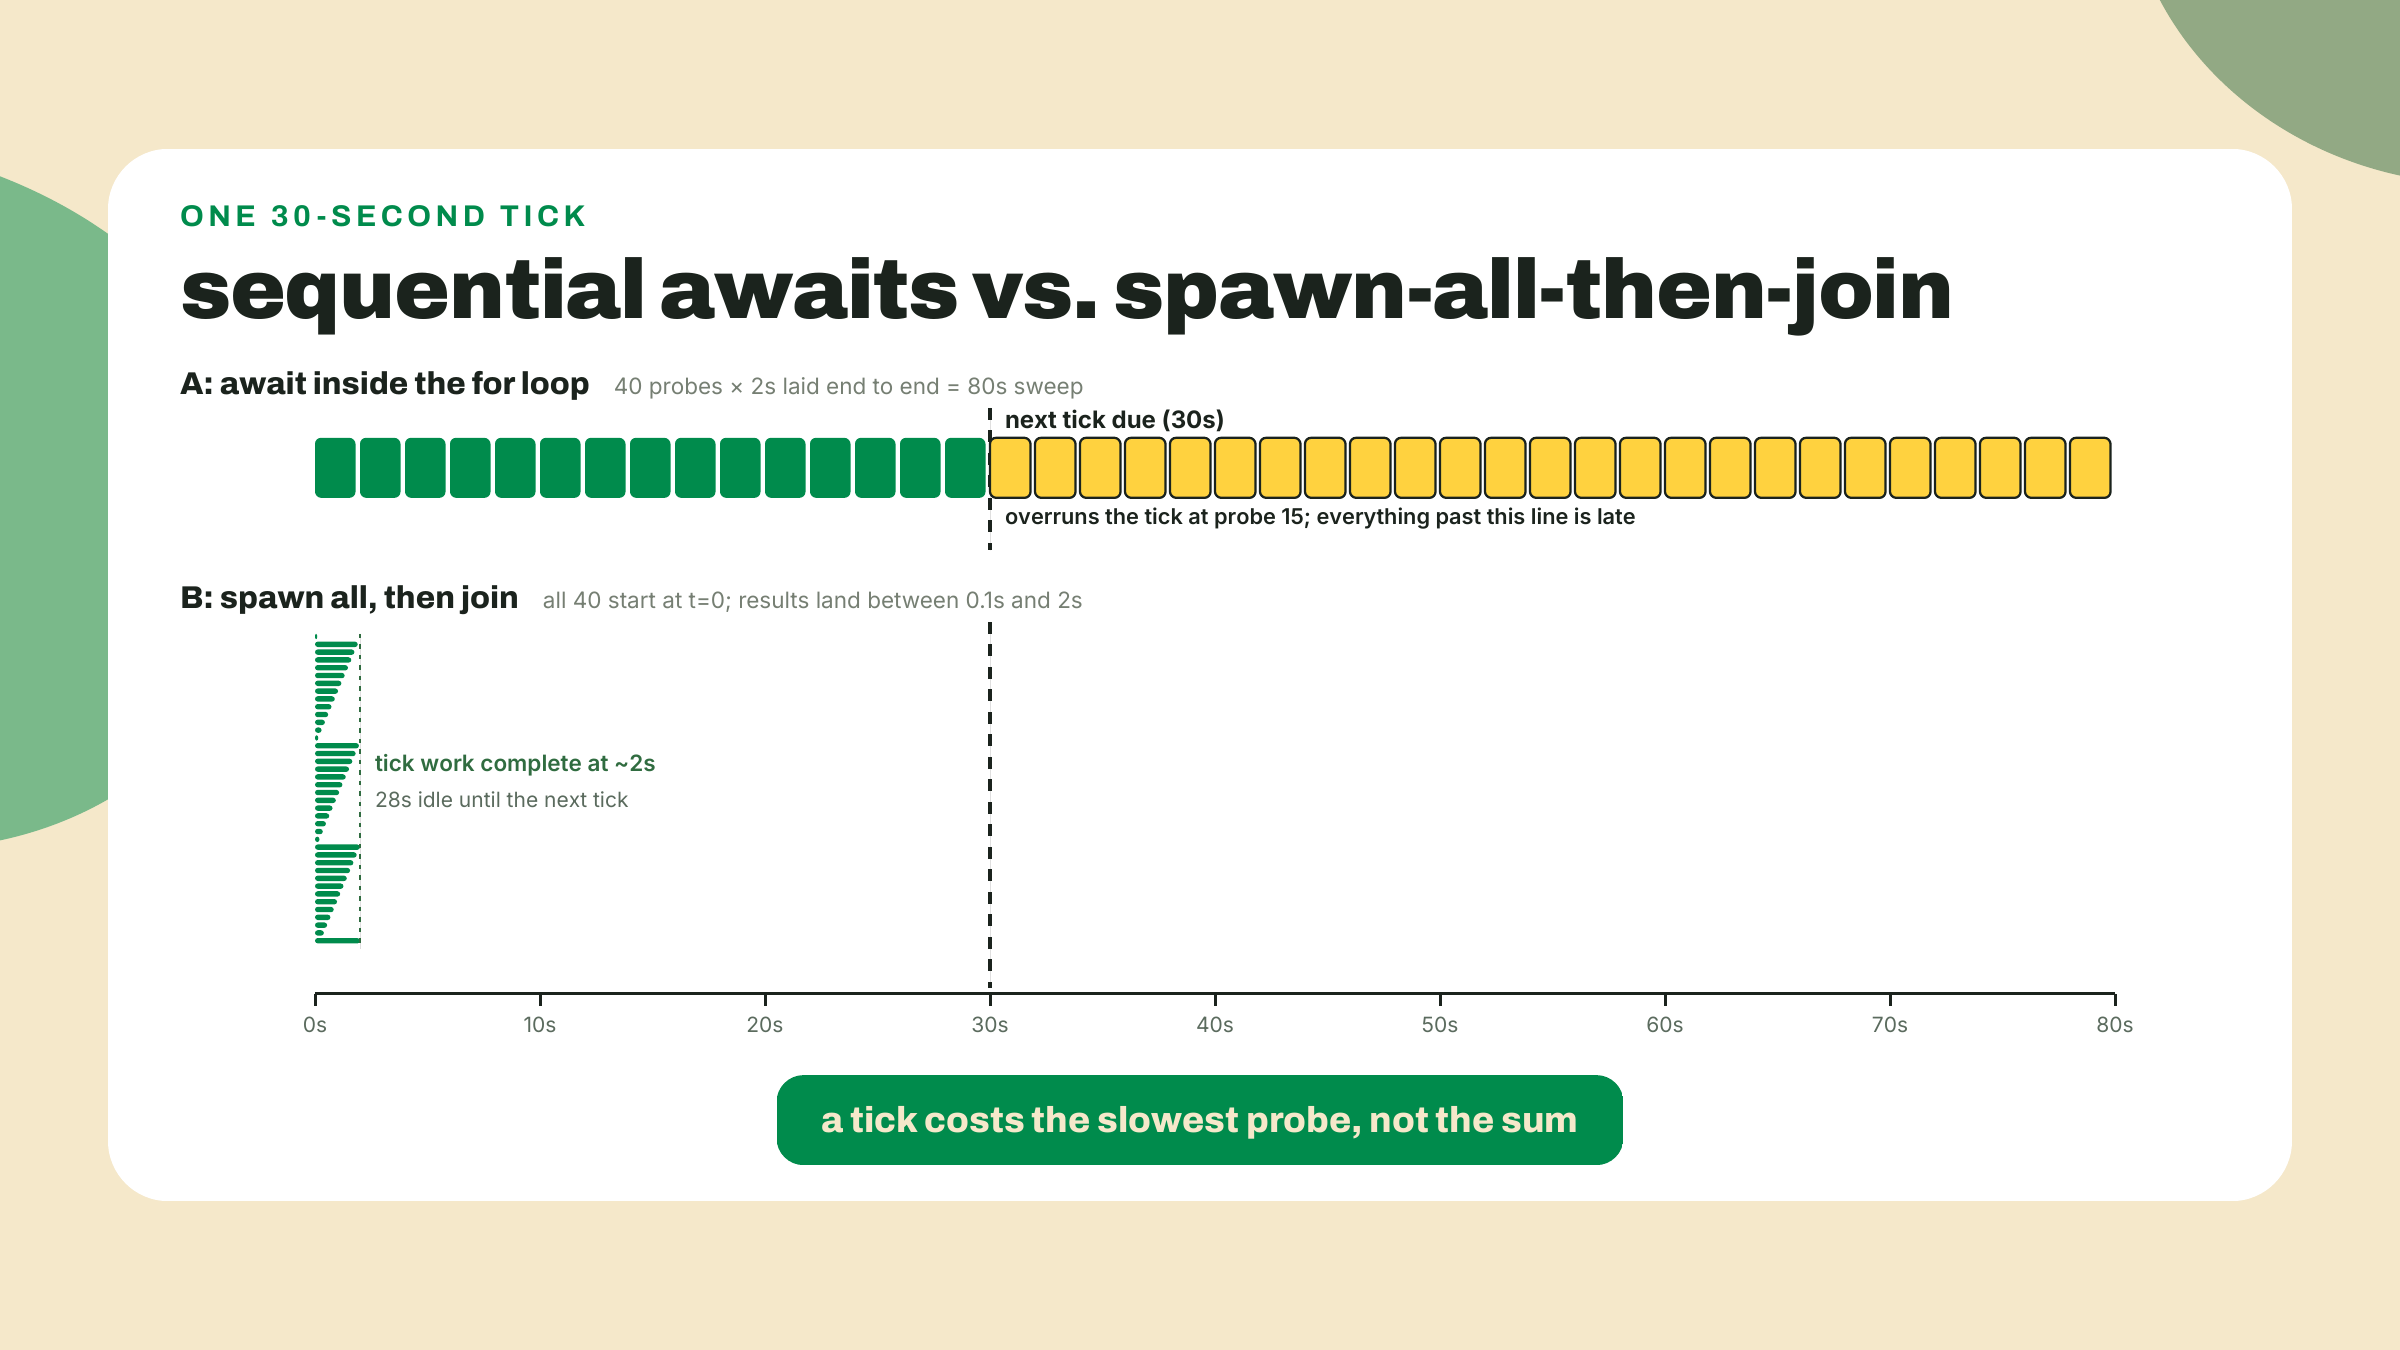
Así que hagamos que deje de estar bien. El barrido adentro de ese loop es el fetch blocking de m05-l3, un target a la vez. Cada sonda retiene el thread hasta que la red responde. Ahora haz la aritmética para una estación adulta: 40 targets, y digamos que uno lento tarda 2 segundos en hacer timeout. En el peor caso tu barrido tarda 40 por 2, que son 80 segundos, adentro de un loop que prometió correr cada 30. El cronograma es ficción. El thread pasa casi todo ese tiempo sin hacer nada: estacionado en un syscall, esperando bytes que están en algún lugar arriba del Atlántico. Esperar no es trabajar. No necesitas más CPU. Necesitas una forma de que un solo thread sostenga muchas esperas a la vez.
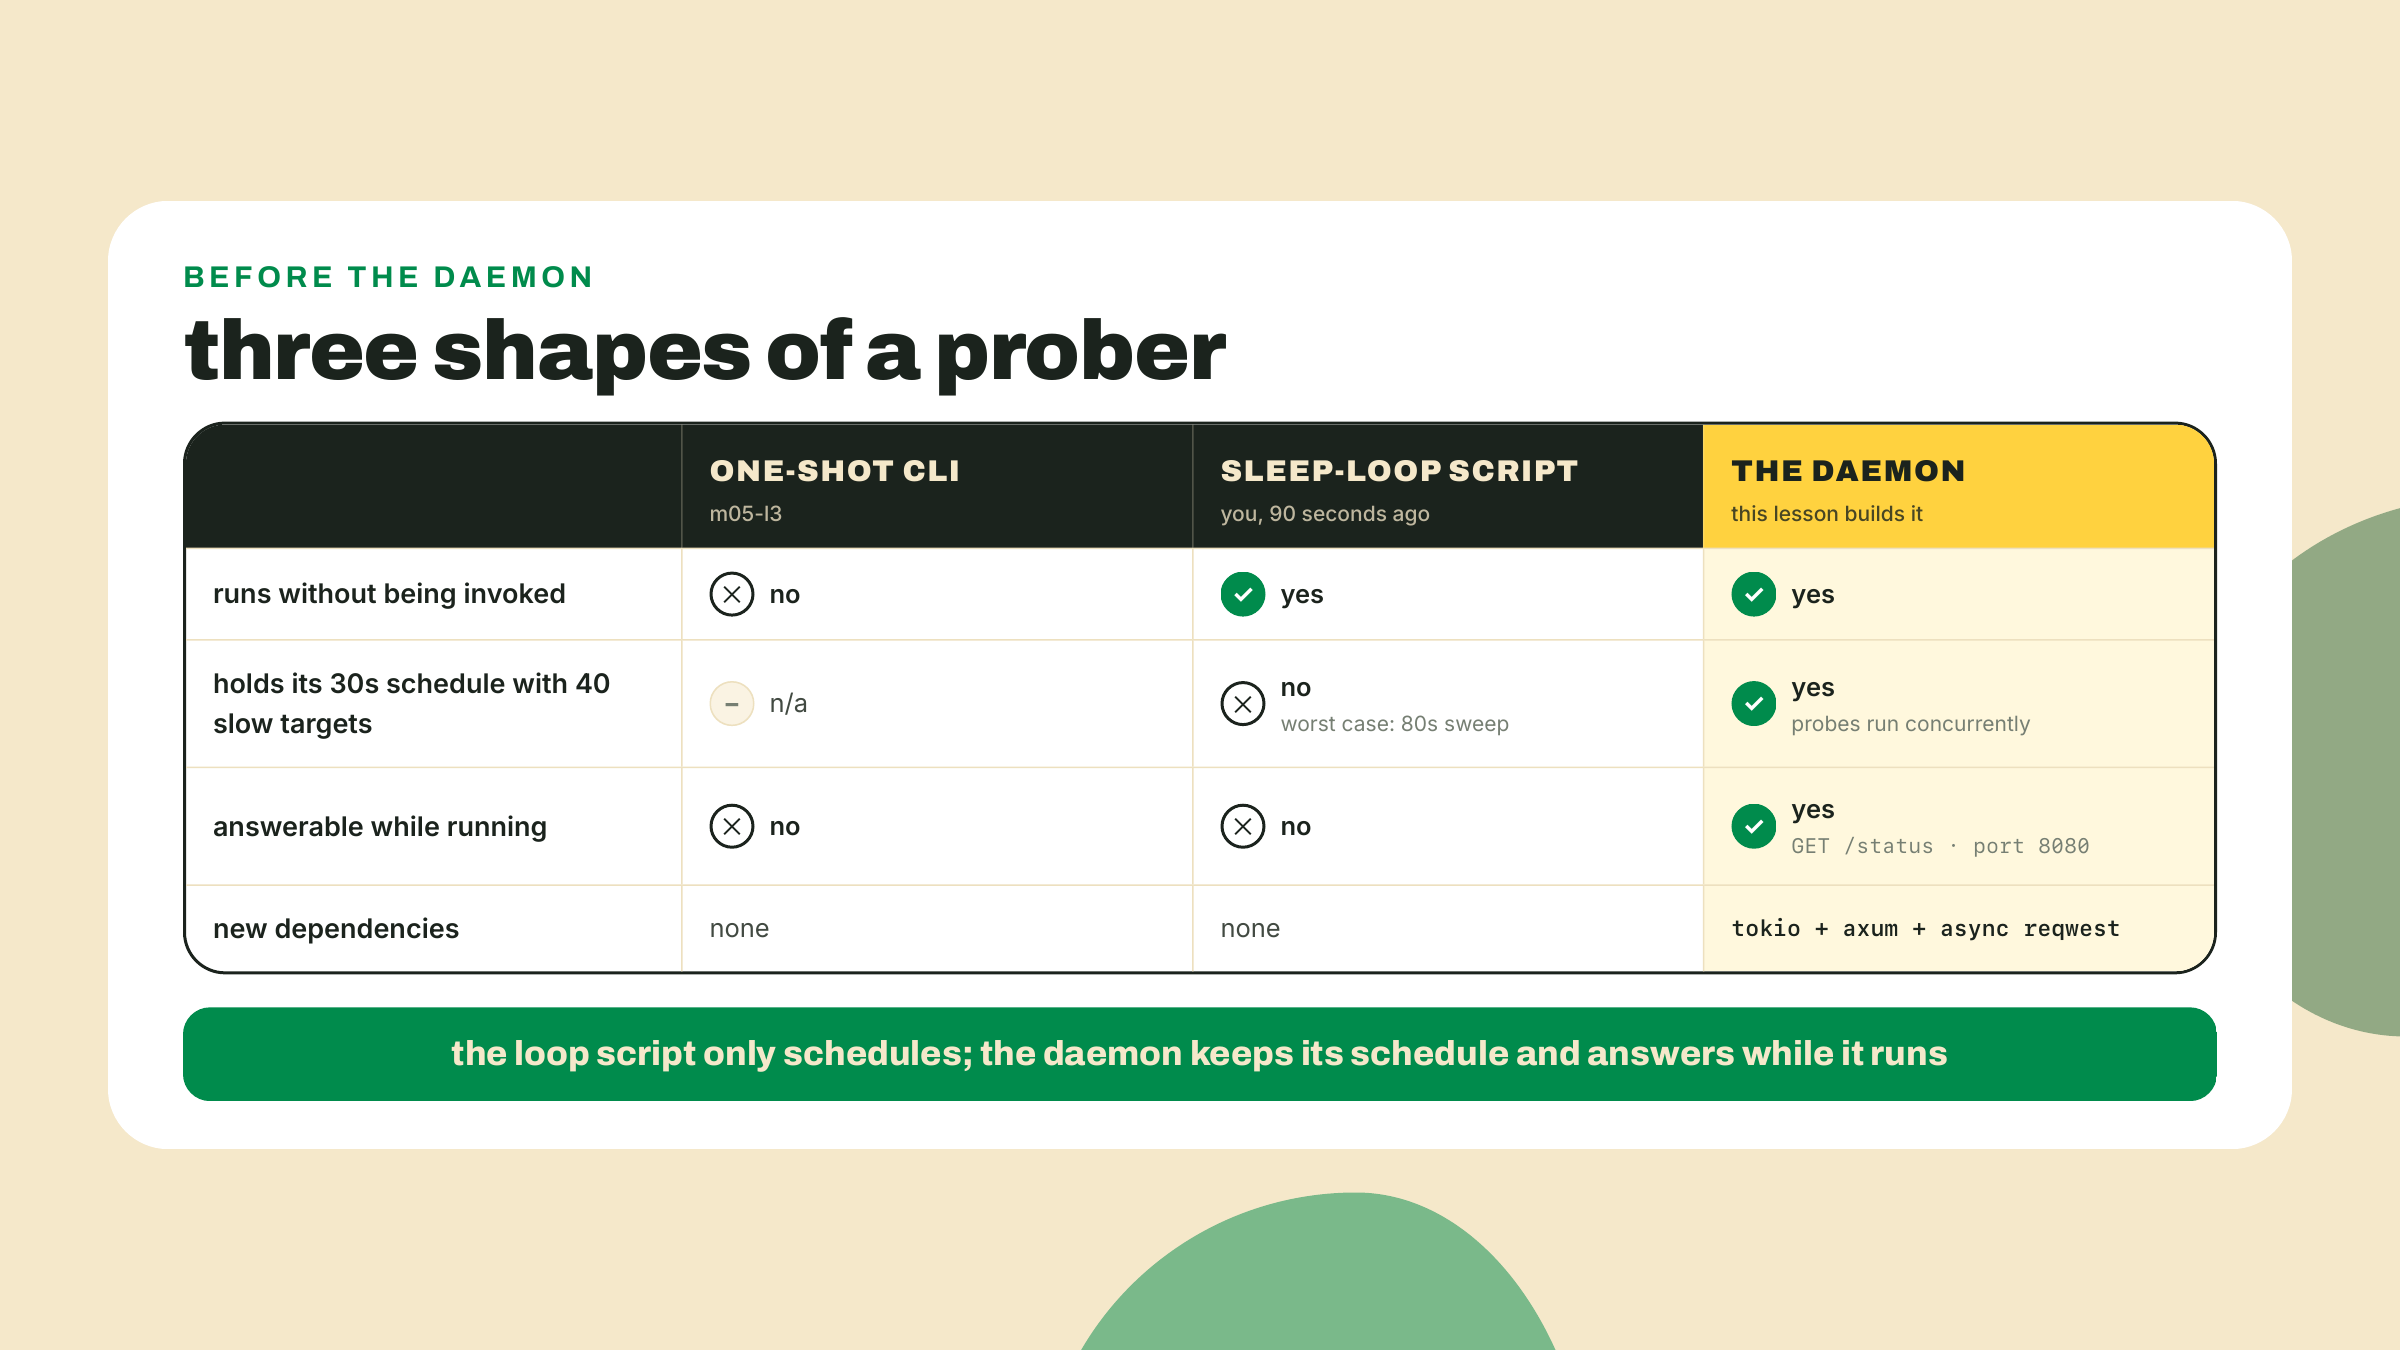
Ese es el argumento entero a favor de Rust async, y ya usaste el modelo.
Allá en m02-l3 escribiste la flota de TS: probeAll disparaba un pool de fetches, y cada await suspendía una función a mitad de cuerpo hasta que su promise se asentaba, liberando al event loop para correr a otro. El modelo mental era la suspensión: await es un bookmark, no una pared. El async de Rust es el mismo modelo con una diferencia honesta. En Node el event loop es ambiente, siempre está, invisible en tu package.json. En Rust el runtime es una dependencia que puedes ver: agregas tokio a Cargo.toml, anotas main, y el scheduler que estaciona y reanuda tus tareas es un crate con número de versión. La misma suspensión, ahora con un nombre en el lockfile. Un párrafo, esa es toda la espiral. Todo lo que aprendiste sobre await en TypeScript se transfiere; lo que cambia es que la maquinaria deja de ser parte del mobiliario.
Lo que tokio le compra a un sondeador ligado a I/O, en concreto: una tarea es una función pausada, unos cientos de bytes de estado, y un solo thread puede sostener miles de ellas. Cada sonda corre hasta que pega un .await sobre la red, se estaciona, y el thread pasa a la siguiente tarea. Cuando el socket tiene noticias, el runtime reanuda la tarea correcta donde la dejó. Cuarenta sondas en vuelo cuestan alrededor de un thread. La grafía alternativa de concurrencia que ya conoces, un thread del SO por sonda, compra la misma victoria en tiempo de reloj al precio de una stack completa por thread y un cambio de contexto del kernel por cada traspaso. Para 40 esperas funcionaría honestamente. Para 40,000 no, y un indexador que mira cada cambio de cuenta en Solana vive mucho más cerca del segundo número.
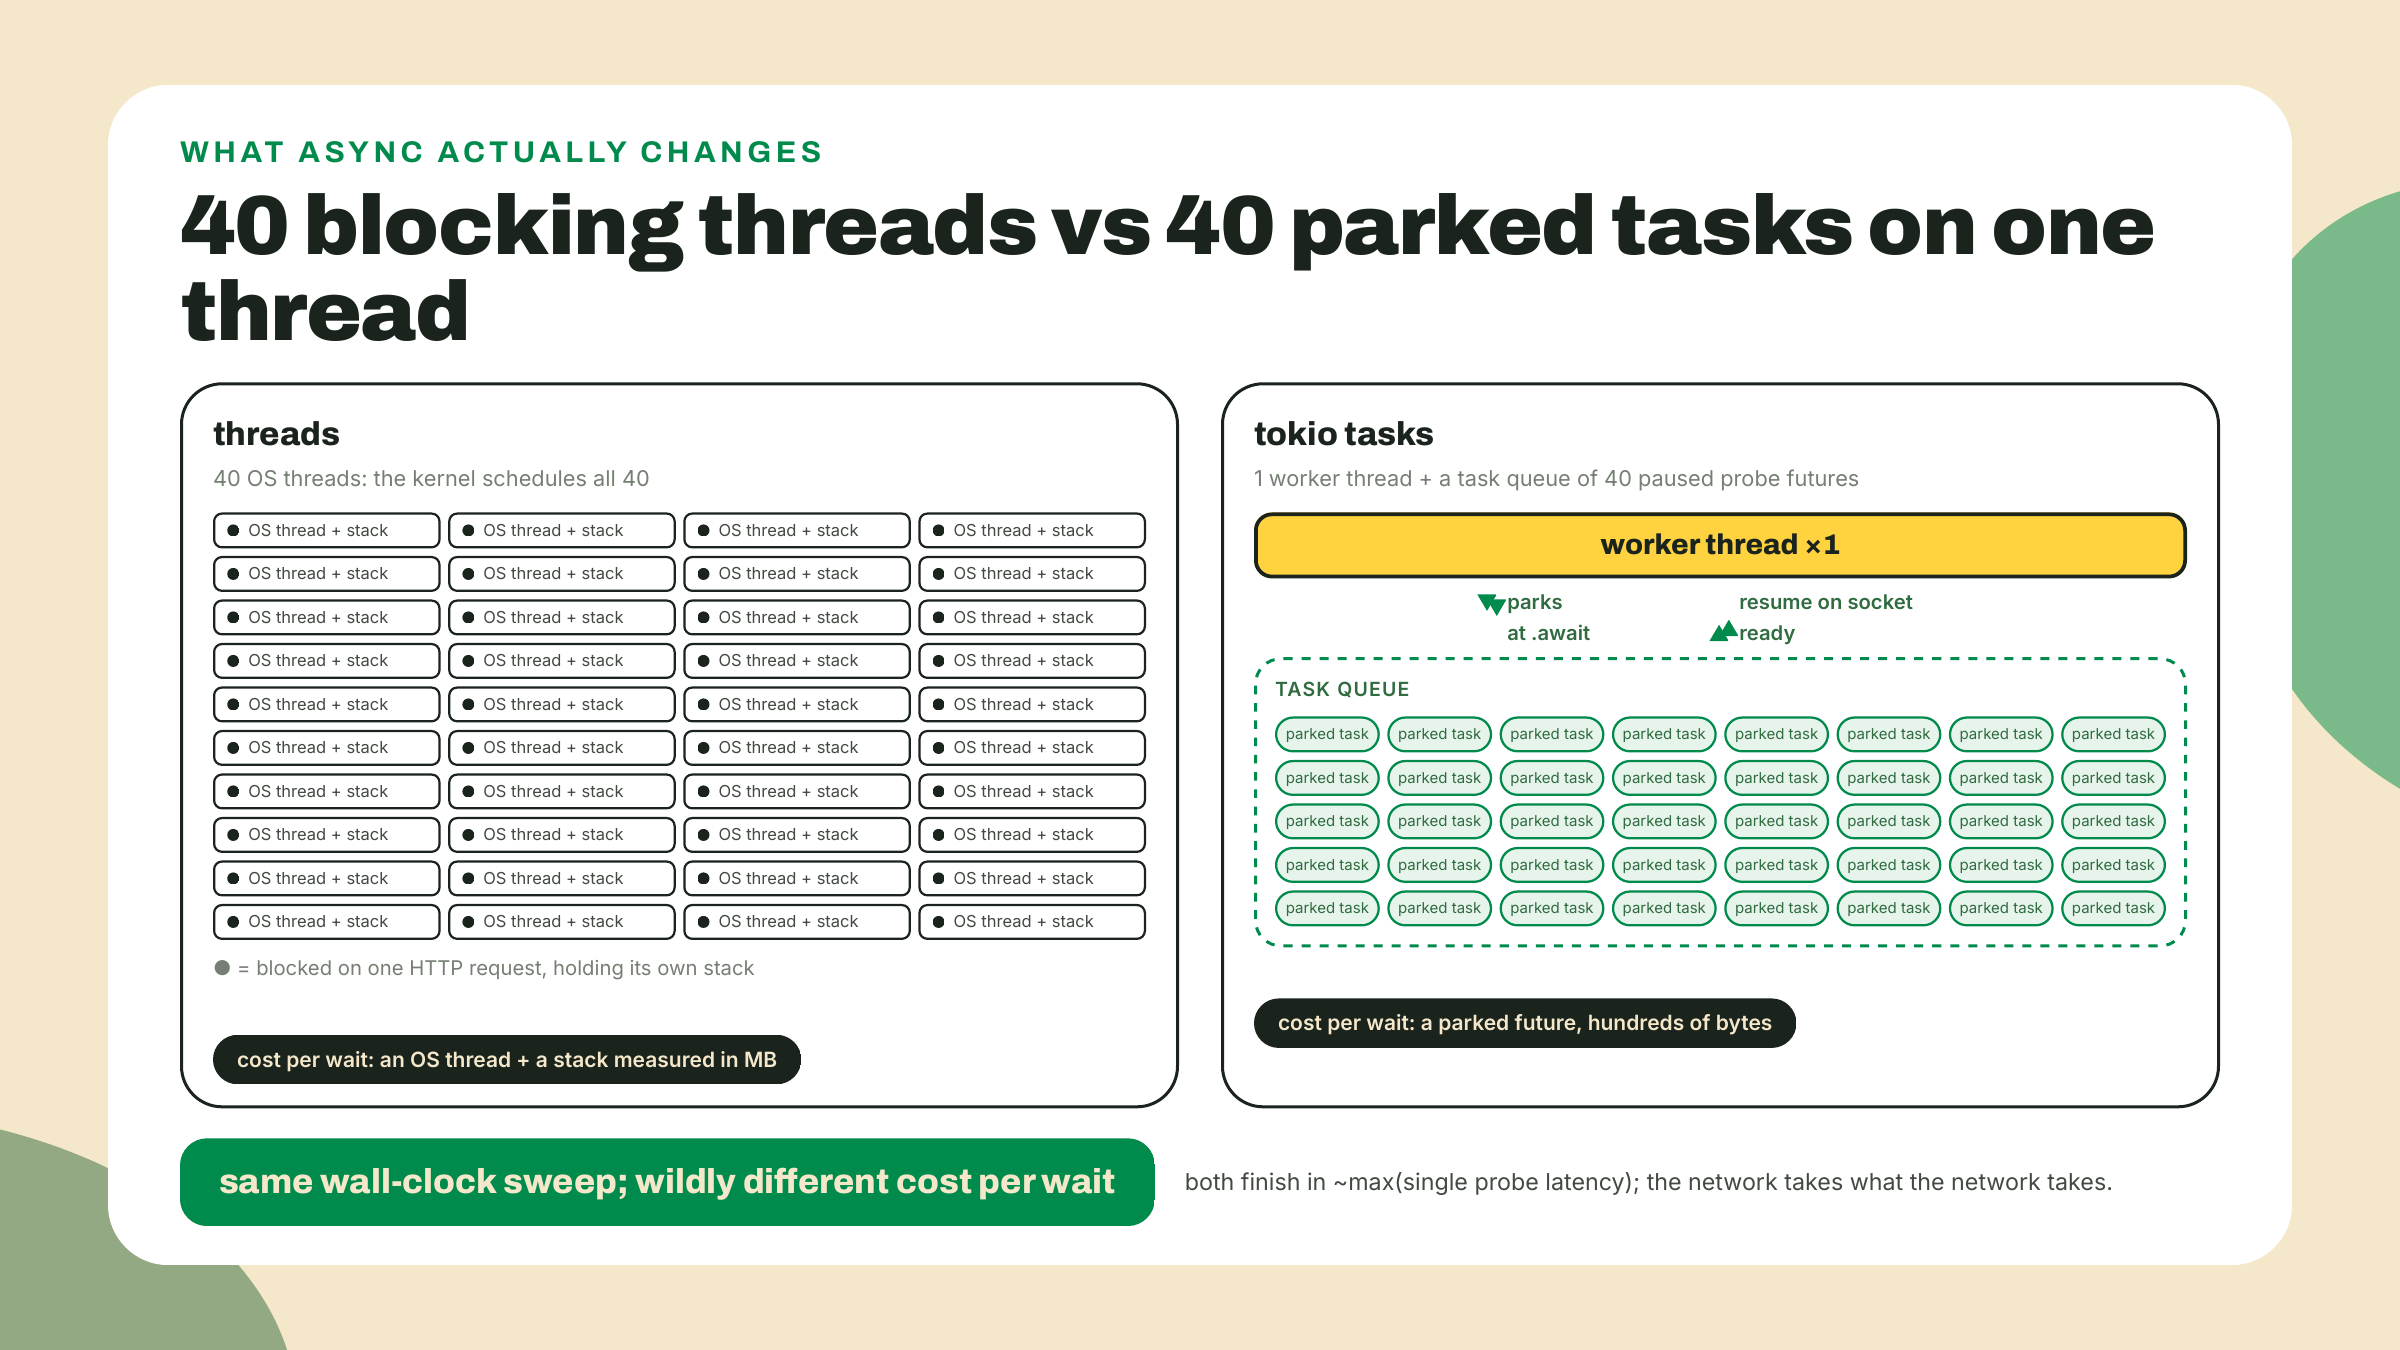
Fíjate en lo que no está en ese diagrama: la latencia. Async no hace más rápido un request solo. La red tarda lo que la red tarda. Si un colega propone migrar una CLI de una sola corrida a tokio por performance, la respuesta honesta es que un fetch solo que bloquea una vez y sale no tiene fan-out para que un runtime lo explote, así que la migración compra una dependencia y una anotación nueva y nada más. La llamada blocking de m05-l3 era la llamada correcta. Sigue siendo la llamada correcta para ese binario. Async paga en el fan-out, y hoy, por primera vez, tenemos fan-out.
Acá es donde la secuenciación del curso te devuelve el favor. Conociste reqwest en m05-l3 vistiendo su feature blocking, precisamente para que la jugada de hoy fuera un diff chico y visible en vez de un primer contacto enredado con un runtime. El mismo crate. El cliente blocking que usaste es un wrapper que vive detrás de una feature adentro de reqwest; async es la cara por defecto del crate. La migración son tres ediciones.
En Cargo.toml, la flag de feature se va:
# m05-l3, in pulse-cli:
reqwest = { version = "0.13", features = ["blocking"] }
# today, in pulse-pollerd:
reqwest = "0.13"
En el sitio de llamada, el path del módulo pierde blocking y las llamadas ganan .await:
// m05-l3, blocking:
let client = reqwest::blocking::Client::new();
let resp = client.get(url).send()?;

// today, async:
let client = reqwest::Client::new();
let resp = client.get(url).send().await?;
Y alrededor de todo, un runtime, porque un .await necesita un scheduler al que cederle el control. Esa es la tercera edición y la única genuinamente nueva: #[tokio::main] sobre un async fn main. Vale desmitificarla antes de que la escribas, porque el atributo parece magia y en realidad es un ahorrador de tecleo. Se expande más o menos a esto:
fn main() {
    tokio::runtime::Builder::new_multi_thread()
        .enable_all()
        .build()
        .expect("failed to build the tokio runtime")
        .block_on(async {
            // the body of your async main goes here
        });
}
Léelo sin adornos: construye un scheduler, pásale tu async main como una sola tarea grande, corre esa tarea hasta el final. Una async fn en Rust no corre cuando la llamas; llamarla construye un valor que describe el trabajo, y algo tiene que manejar ese valor. En la flota de TS el conductor era el event loop que Node arrancó antes de que se ejecutara tu primera línea. Acá el conductor son cinco líneas de código de builder que podrías escribir tú, y una vez que las viste, "a dónde va mi await" deja de ser un misterio para siempre. El resto queda intacto tras la migración: la forma del request, el tipo de error que alimenta tu taxonomía de thiserror, el status y la latencia que mides. Flag de feature afuera, .await adentro, runtime alrededor. Cuando alguien te diga que las migraciones a Rust async son una reescritura, este es tu contraejemplo; cuando alguien te diga que son gratis, la sección que viene es suya.
Una trampa antes de seguir, porque es la clásica: el cliente blocking y el runtime son enemigos. Si llamas a reqwest::blocking desde adentro de una tarea de tokio, estacionas un thread worker entero del runtime mientras dure, y las propias tripas del cliente blocking pelean con el runtime sobre el que están sentadas. No tienes que creerme; este programa da panic antes de siquiera tocar la red:
#[tokio::main]
async fn main() {
    // the footgun: the BLOCKING client inside the tokio runtime
    let resp = reqwest::blocking::get("http://127.0.0.1:9");
    println!("{resp:?}");
}
thread 'main' panicked at .../tokio-1.53.1/src/runtime/blocking/shutdown.rs:51:21:
Cannot drop a runtime in a context where blocking is not allowed. This happens
when a runtime is dropped from within an asynchronous context.
Corrí eso en esta máquina para darte el mensaje textualmente, porque te lo vas a encontrar en el mundo real tarde o temprano y nunca dice la palabra reqwest. Adentro de pulse-pollerd, el cliente async, siempre. El cliente blocking se queda en pulse-cli, donde sigue siendo correcto.
Hora de nombrar el trade-off, porque tokio no es gratis y este curso no hace almuerzos gratis. Un runtime async es una dependencia sobre un scheduler que ahora tienes que entender. Y lo primero que hay que entender de él es que su planificación es cooperativa: el runtime solo puede cambiar entre tareas en los puntos .await, porque un punto de suspensión es el único lugar donde una tarea devuelve el control. Un thread puede ser desalojado por el kernel en medio de cualquier cosa; una tarea no. Ese único hecho de diseño es de donde viene la clase de bug nueva, la que no existía en tu CLI blocking: bloquear el runtime. Cualquier tramo sincrónico largo adentro de una tarea, un parseo gigante de JSON, un std::thread::sleep que alguien pega por memoria muscular, un mutex tomado y sostenido demasiado tiempo, nunca llega a un .await, nunca cede, y frena no solo esa tarea sino cada tarea estacionada en ese thread worker. El kernel te habría rescatado; tokio, por diseño, no lo va a hacer. Tus stack traces también empeoran: un panic ahora sale a la superficie a través de capas de plomería del runtime, y la función que lógicamente lo causó puede estar a tres puntos de suspensión del frame que lo muestra. Estos son costos reales que equipos reales pagan cada semana.
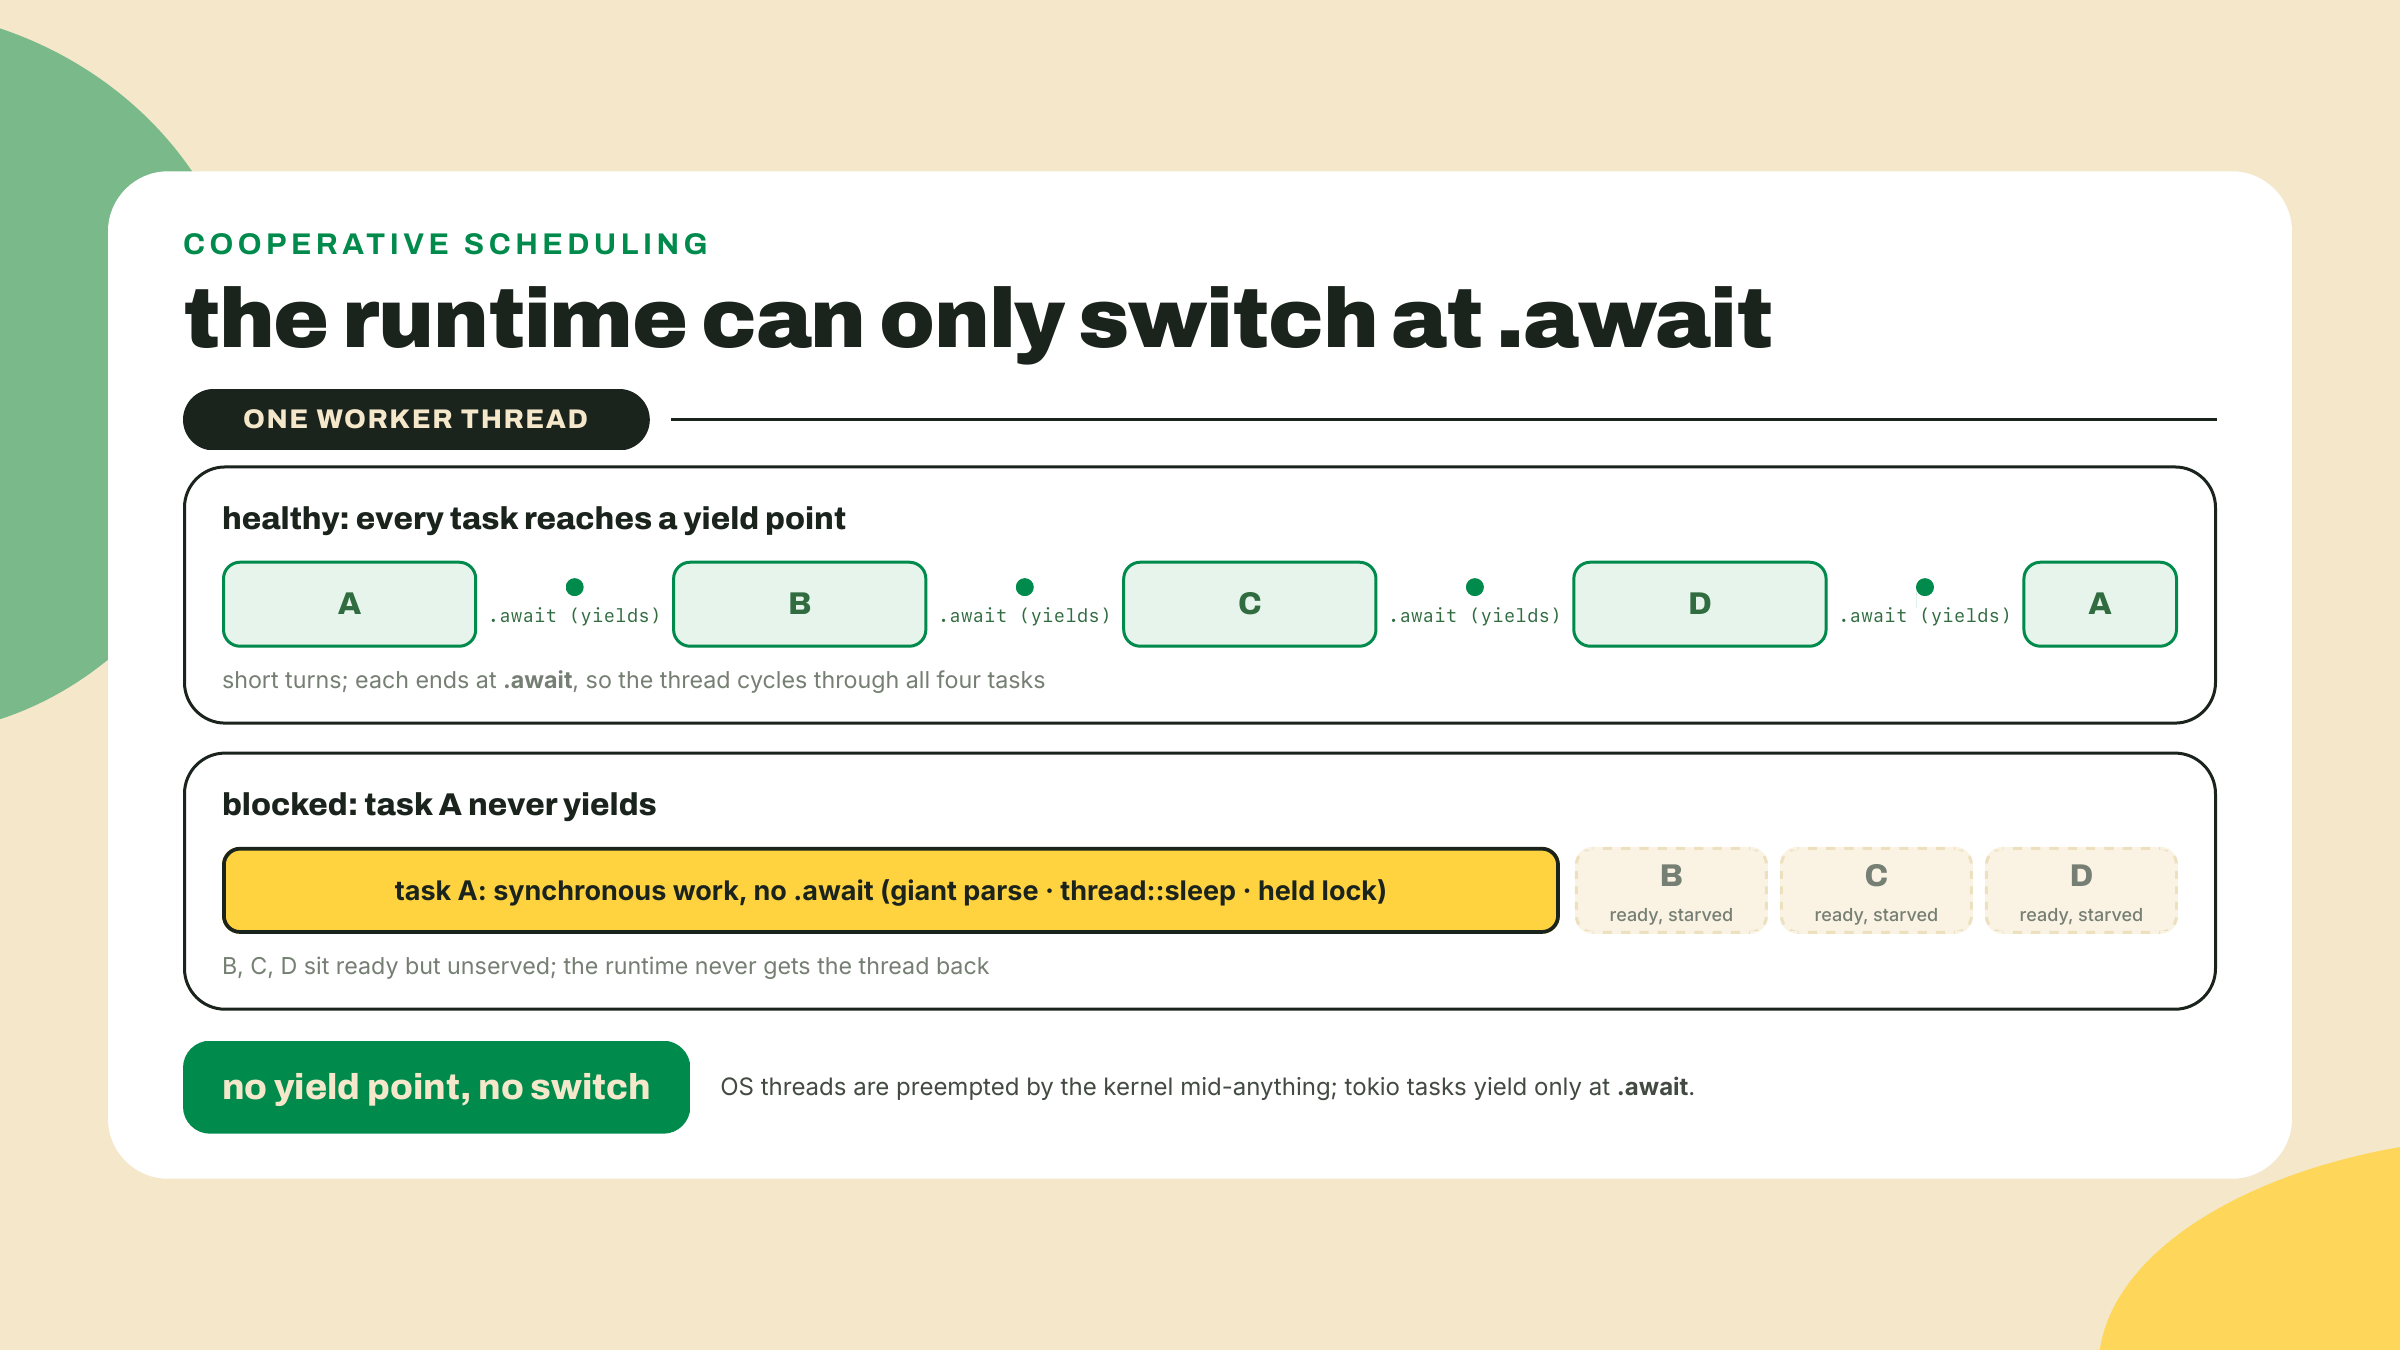
Así que la regla de decisión, y la voy a poner tan sin adornos como pueda. Un puñado de tareas, casi todas esperando, sin fan-out: un thread pelado o una llamada blocking es el tamaño honesto, y agarrar tokio ahí es ingeniería guiada por el currículum. Trabajo ligado a I/O con fan-out de verdad, muchos sockets en vuelo en un cronograma: el runtime se gana su complejidad, y nada más escala más allá de él. La CLI de una sola corrida se sienta del primer lado. Un poller de 40 targets se sienta del segundo. El mismo codebase, las dos respuestas correctas, una capa de distancia.
Este es un argumento vivo en la ingeniería de 2026 en general, no parroquialismo de Rust. El 2025-11-19, Prisma 7 borró su motor de queries en Rust a favor de un compilador de queries en TypeScript, la misma temporada en que el propio compilador de TypeScript estaba siendo portado a Go por una aceleración de build de alrededor de 10x. Dos proyectos emblemáticos cruzando el puente de los lenguajes en direcciones opuestas, y los dos tenían razón, porque "cuál lenguaje" nunca fue la pregunta. Cuál herramienta para la capa sí lo era. Nuestra regla de tokio-cuando-tienes-fan-out, thread-cuando-no es la misma disciplina una capa más abajo.
Ya que estoy siendo honesto sobre dimensionar bien: axum, el crate de servidor HTTP que esta lección usa para darle al daemon su única puerta JSON, es nuestro tamaño correcto, no el default del ecosistema. Releva la plomería de la infraestructura real de Solana y domina gRPC vía tonic; de cinco repos de Rust adyacentes a Solana que relevamos, cuatro hablan tonic, y axum aparece en dos. Para un curso de fundamentos que necesita una puerta JSON a la que le puedas hacer curl, axum 0.8 es la elección honesta correcta, y cuando después leas la fuente de un indexador y encuentres tonic donde esperabas axum, vas a saber que es el barrio, no un error. Esa plomería de datos en streaming es territorio de infraestructura más profundo del que llega este curso; cuando la fuente de un indexador te mande para allá, los docs propios de tonic son la puerta. La misma honestidad sobre observabilidad: println! es donde estamos, tracing es la respuesta adulta, y se queda como bookmark hasta que m09-l2 haga logging como se debe.
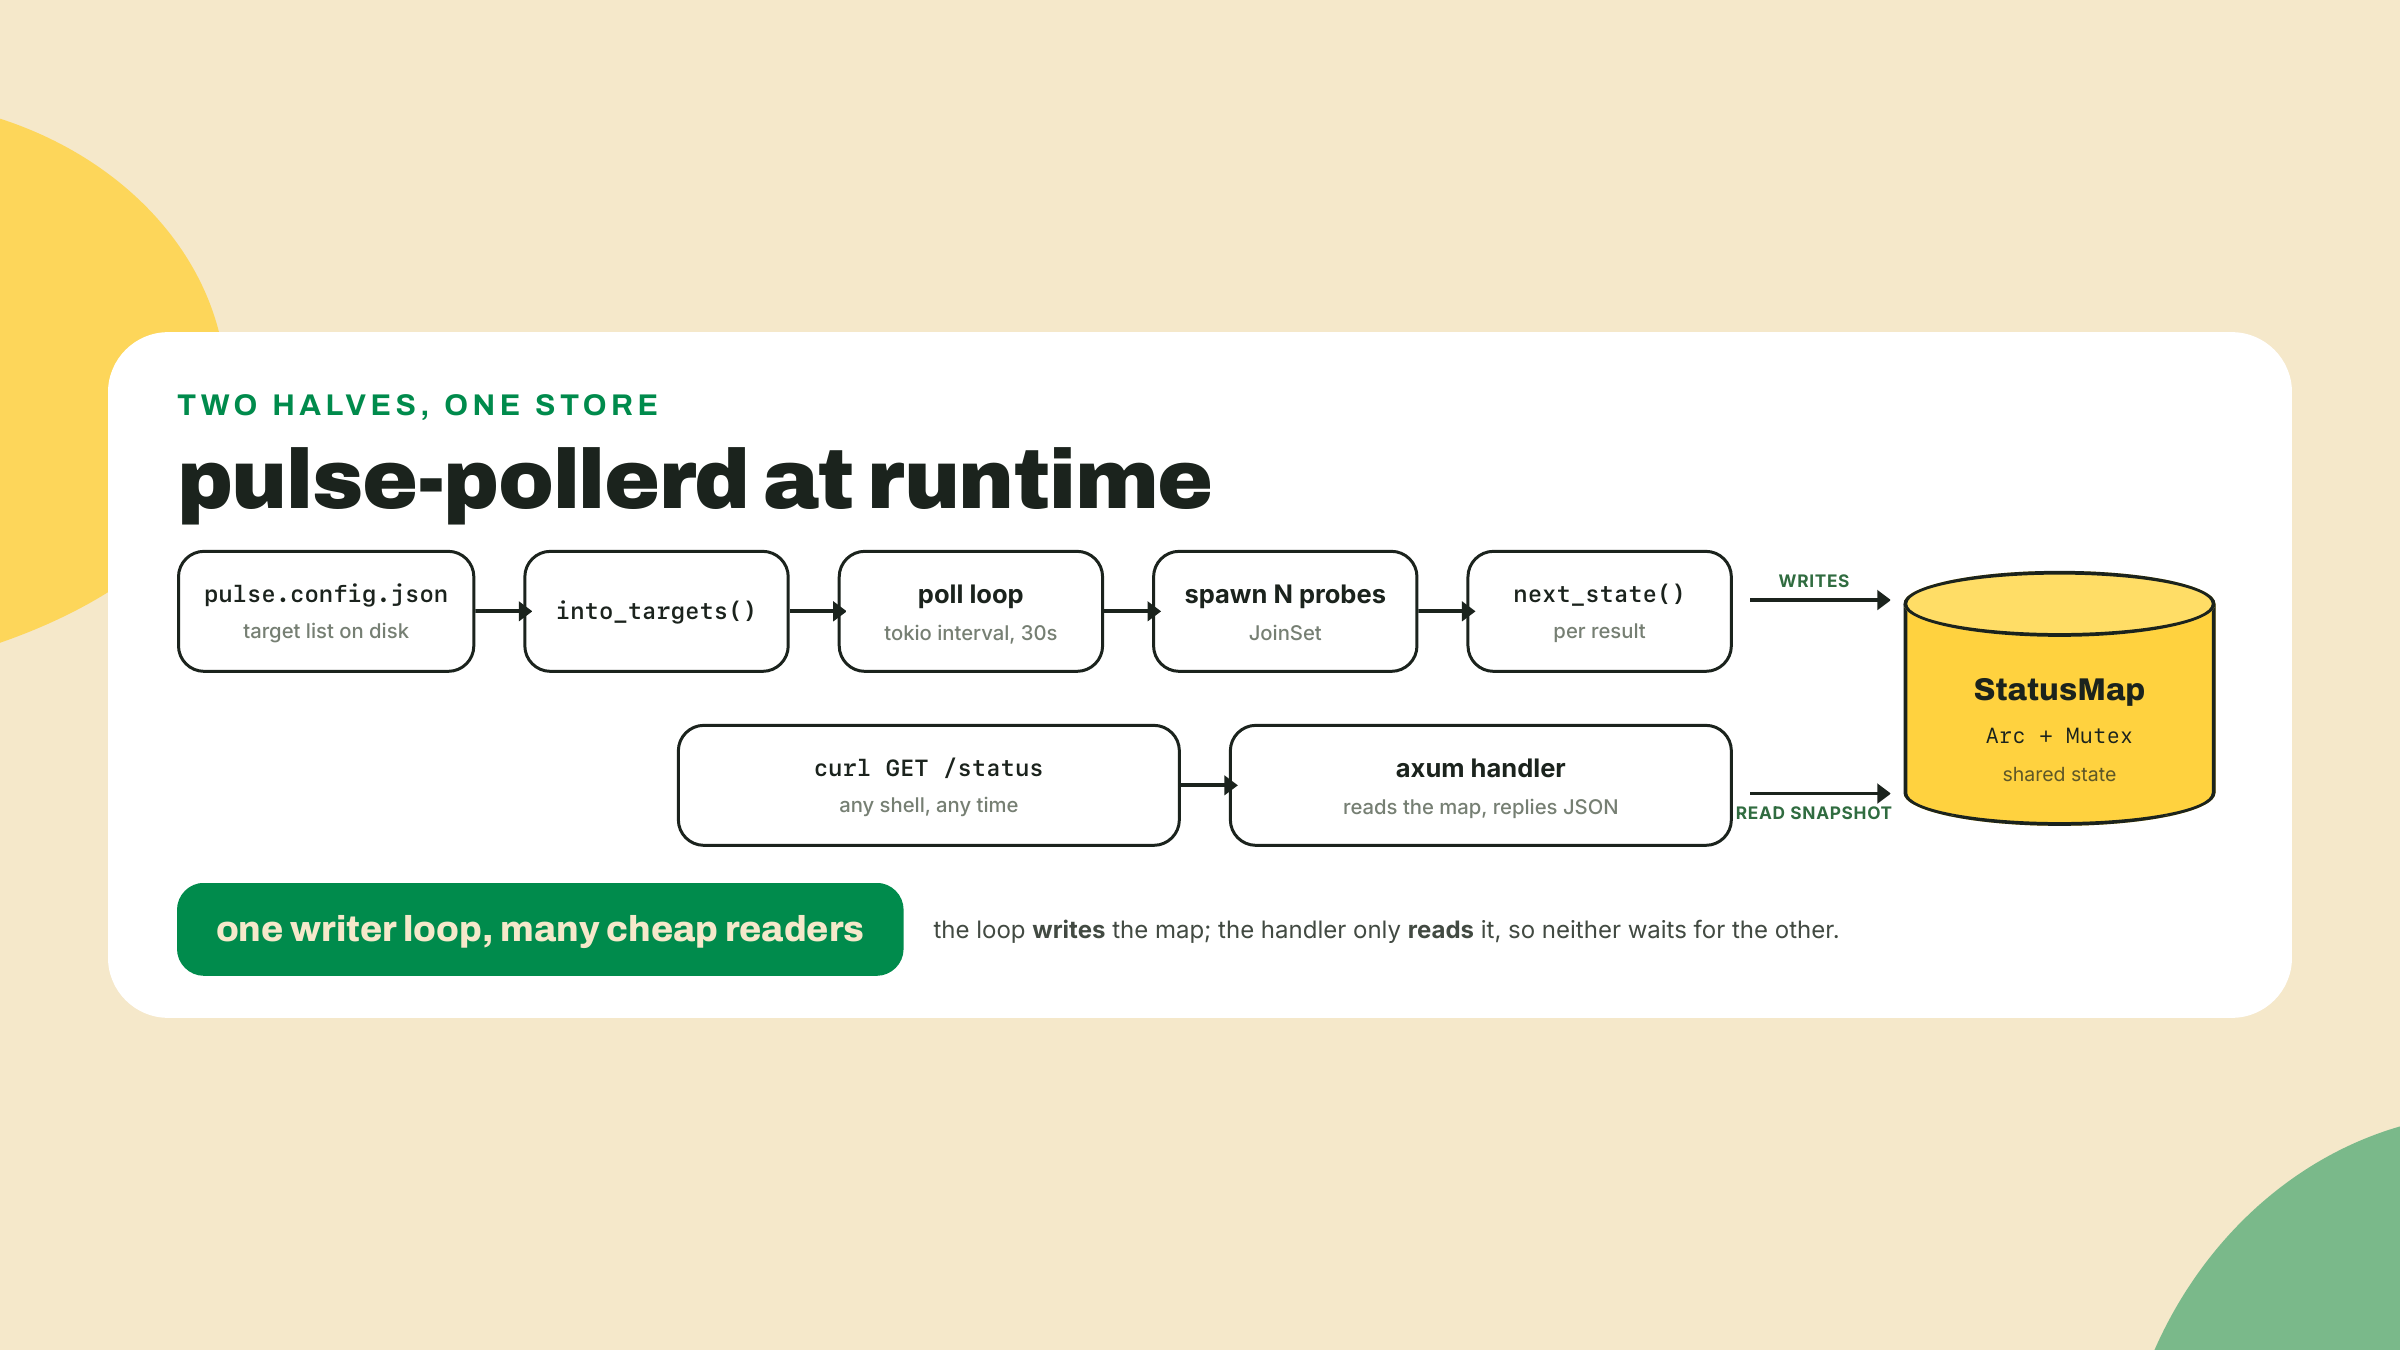
Un servicio, condensado a su forma verdadera, es solo esto: un loop, más una pregunta que se puede contestar. El loop es el poll; la pregunta es /status. Cada orquestador, cada balanceador de carga, cada página de uptime que hayas visto alguna vez es este patrón vestido de capas. Construye la versión desnuda una vez y las capas dejan de ser magia.
Profundiza (el 20%). esta lección enseña tokio al nivel de saber-cuándo-lo-necesitas: lo que un runtime le compra a un sondeador ligado a I/O, el delta de blocking a async, y un loop de poll honesto. Cómo funcionan de verdad los futures por debajo, Pin, los executors, los streams, select!, y los patrones de concurrencia más profundos viven en el capítulo de async del Book, que ahora cubre async de forma nativa: https://doc.rust-lang.org/book/ch17-00-async-await.html (URL chequeada el 2026-09-02). Déjalo como bookmark, léelo después de este módulo. El lab de abajo no necesita nada del material que quedó como bookmark.
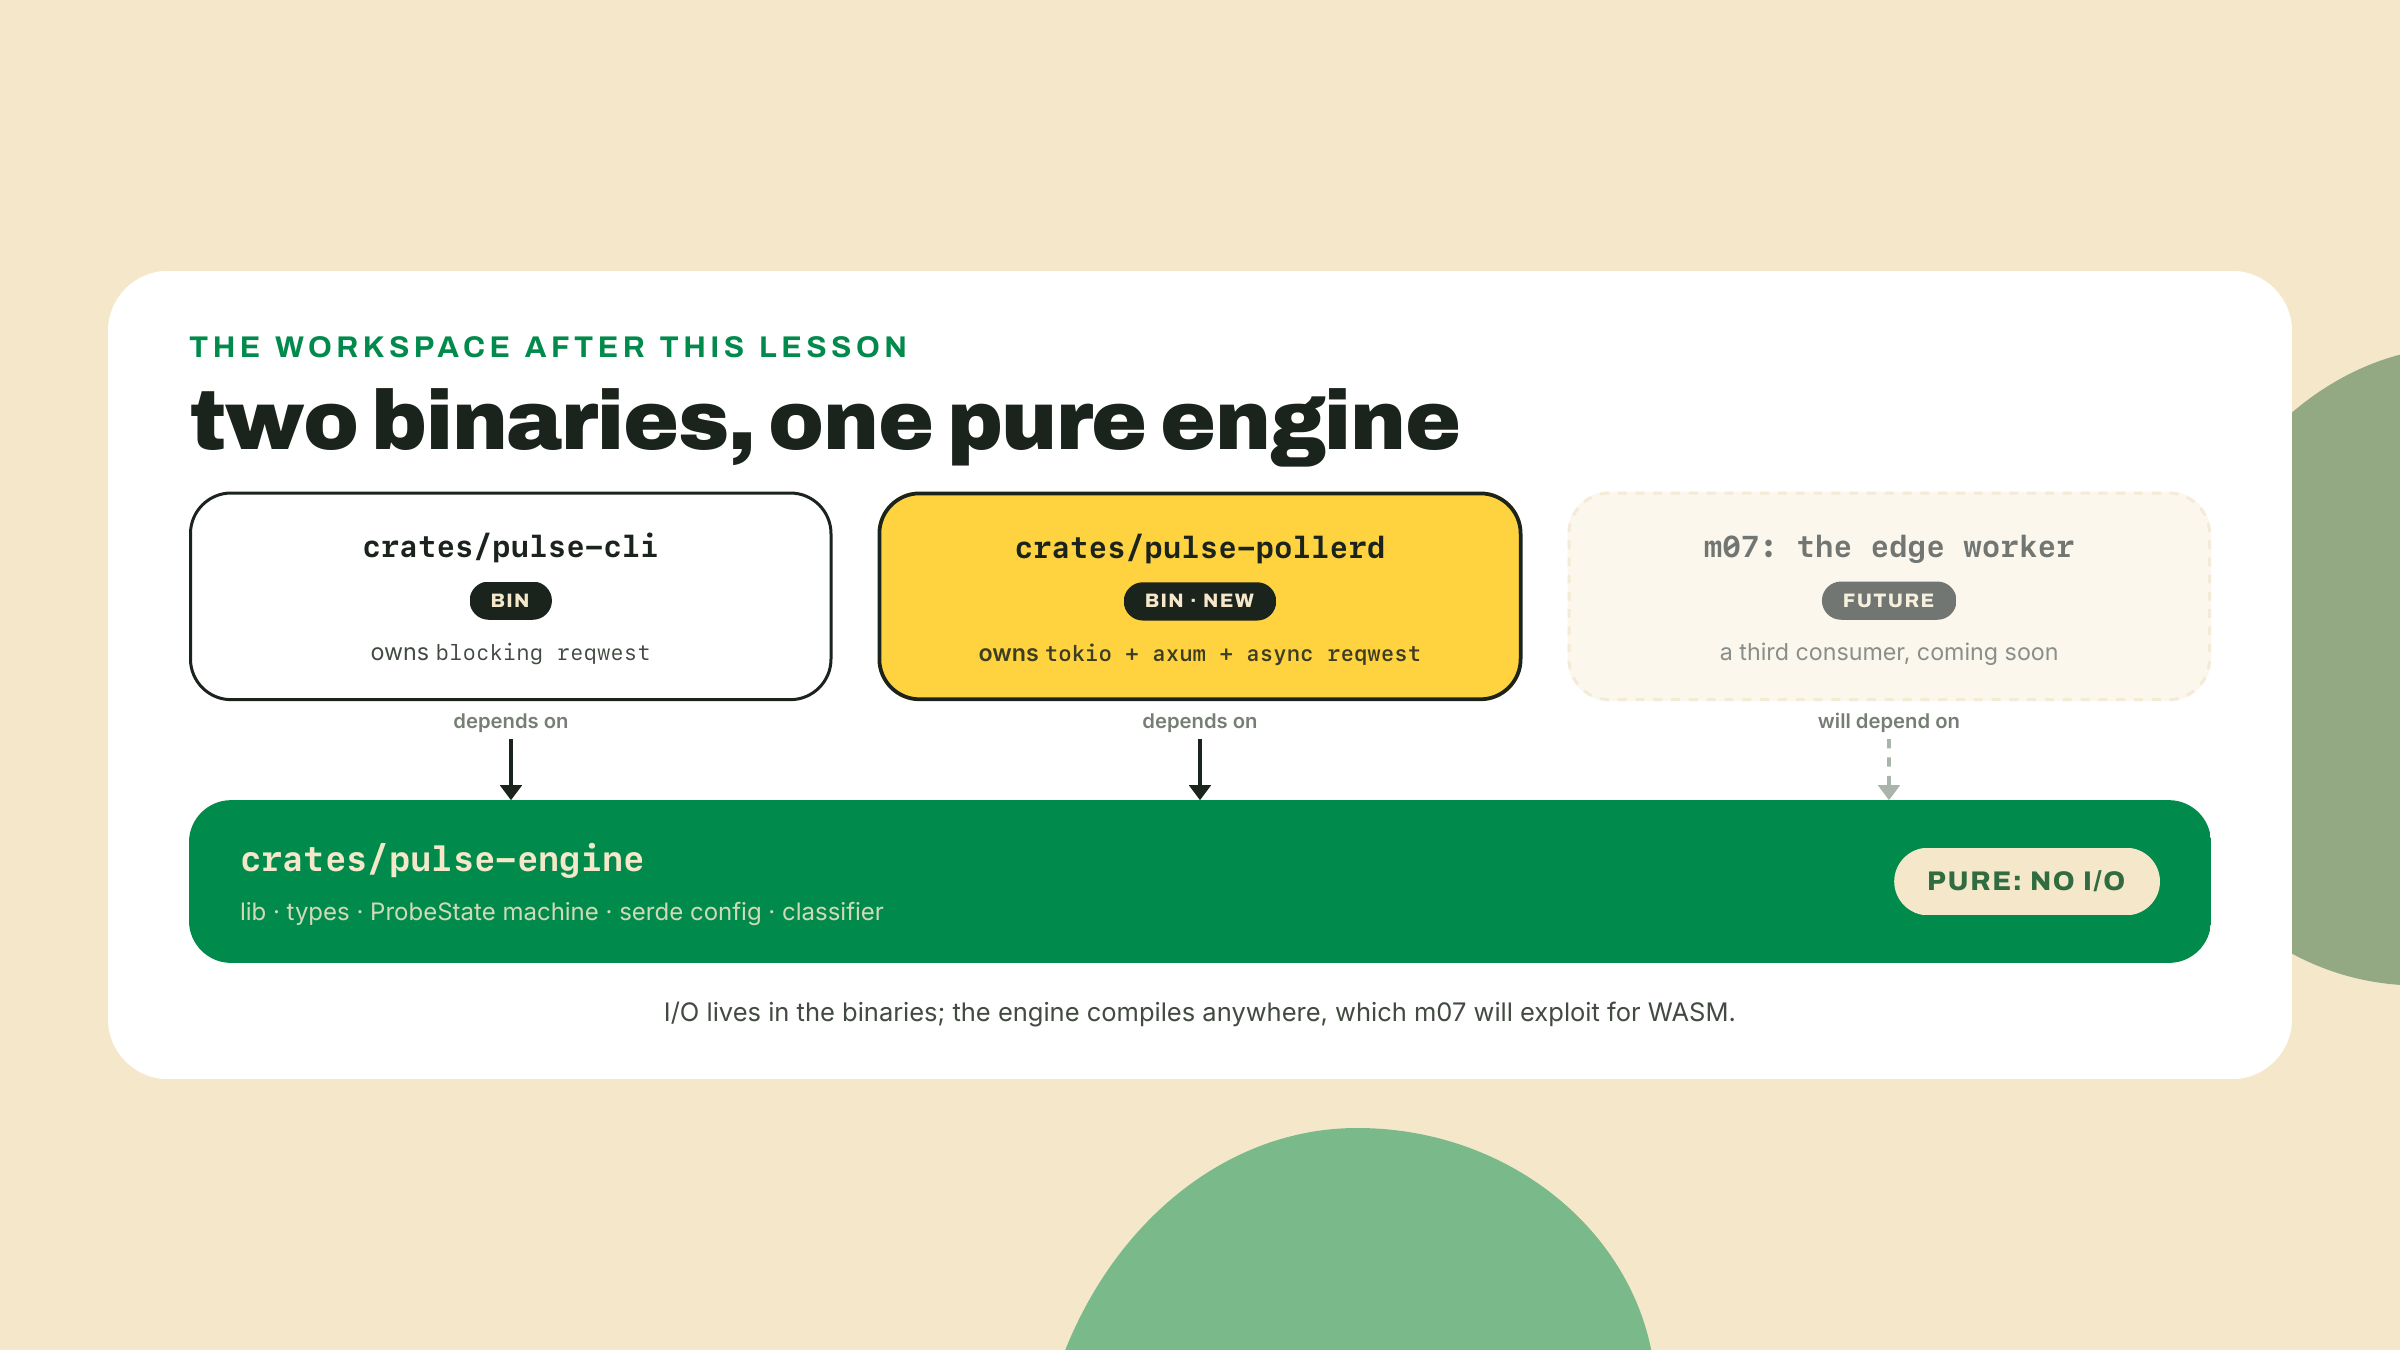
El plan, para que veas todo el tablero antes del primer comando: un crate binario nuevo se suma al workspace, depende de pulse-engine, corre un loop de intervalo de tokio que sondea cada target de pulse.config.json, mantiene el último ProbeState por target en memoria compartida, y lo sirve en el puerto 8080.
Haz crecer el workspace. Desde la raíz del workspace:
cargo new crates/pulse-pollerd
Agrega el member al Cargo.toml raíz al lado de los dos crates de m05-l2:
[workspace]
resolver = "3"
members = ["crates/pulse-engine", "crates/pulse-cli", "crates/pulse-pollerd"]
Después el manifest del crate nuevo. Este es otro de los momentos de construye-sobre-lo-que-ya-tienes del curso aterrizando: un segundo binario consumiendo el mismo motor puro, que es la razón entera por la que m05-l2 te hizo partir el workspace. La inversión en pureza empieza a pagar el alquiler hoy.
[package]
name = "pulse-pollerd"
version = "0.1.0"
edition = "2024"

[dependencies]
pulse-engine = { path = "../pulse-engine" }
serde = { workspace = true }
serde_json = { workspace = true }
tokio = { version = "1.53", features = ["macros", "rt-multi-thread", "time", "net"] }
axum = "0.8"
reqwest = "0.13"
Pins verificados contra crates.io el 2026-09-02: tokio 1.53.1, axum 0.8.9, reqwest 0.13.4; la línea 1.x de tokio viene siendo estable en semver desde 2020, así que tus dígitos de patch pueden estar más arriba y eso está bien. Fíjate en la línea de features de tokio: después de m05-l2 puedes leerla. Optamos por las macros, el runtime multi-thread, los timers y TCP, en vez de la feature full que trae todo, porque ahora sabes lo que cuesta y compra una flag de feature. Solo el daemon paga por tokio; el motor y la CLI se quedan exactamente como estaban.
Promueve tu pipeline de config. El daemon necesita config-a-targets, y el pipeline de filter-map que escribiste en m05-l1 ahora mismo no tiene hogar: la reescritura con clap de m05-l3 reemplazó el main de pulse-cli por completo, y el pipeline se fue con él. Reconstrúyelo donde debería haber vivido desde siempre, en el motor, como un método sobre Config, para que cada binario presente y futuro comparta una sola definición. Va en crates/pulse-engine/src/config.rs, al lado de los structs que transforma (no en lib.rs, que es el shim de re-export de cinco líneas y no lleva lógica):
// crates/pulse-engine/src/config.rs
impl Config {
    pub fn into_targets(self) -> Vec<ProbeTarget> {
        self.targets
            .iter()
            .filter(|t| t.enabled)
            .map(|t| t.to_probe_target())
            .collect()
    }
}
Esa es la cadena de m05-l1, textualmente, con un método de profundidad. Corre cargo test --workspace, verde. Así se debería sentir un refactor de workspace.
Una línea de derive. La respuesta de /status serializa ProbeState a JSON, y serde ya es una dependencia del motor, así que agrega el derive al enum de estado en el motor, que ahora debería leerse #[derive(Debug, Clone, Copy, PartialEq, Eq, serde::Serialize)]. El path serde:: está haciendo un trabajo callado: engine.rs no tiene ninguna línea use serde::Serialize; (el módulo de config lo importa, este módulo nunca lo necesitó), así que el token Serialize pelado sería un error de no-se-encuentra-la-macro-de-derive; la forma totalmente calificada no necesita import. Una línea, sin deps nuevas, y una auditoría ya que estás: el Clone y el Copy que tu enum de m04-l3 viene cargando desde que nació son estructurales hoy, porque el esqueleto del paso 4 copia estados fuera del mapa compartido (map.get(&name).map(|s| s.state)) y deriva Clone sobre un struct que guarda uno. Si tu lista de derives alguna vez se desvió de ese canon, restaura esos dos ahora, o el paso 4 te recibe con E0507s que el enmarcado de "una línea" no prometía.
El loop de poll: lo único difícil que escribes tú. Nombrado en el resumen, entregado acá como un esqueleto de completion. Dos huecos. Todo lo demás en este archivo viene dado, porque la idea difícil es la forma del loop, no su plomería. Reemplaza pulse-pollerd/src/main.rs por:
use std::collections::HashMap;
use std::sync::{Arc, Mutex};
use std::time::{Duration, Instant, SystemTime, UNIX_EPOCH};

use pulse_engine::{Config, ProbeState, ProbeTarget, next_state, parse_config};
use serde::Serialize;
use tokio::task::JoinSet;

const POLL_INTERVAL_SECS: u64 = 30;

#[derive(Clone, Serialize)]
struct TargetStatus {
    state: ProbeState,
    latency_ms: u64,
    last_poll: u64,
}

type StatusMap = Arc<Mutex<HashMap<String, TargetStatus>>>;

async fn poll_loop(targets: Vec<ProbeTarget>, statuses: StatusMap) {
    let client = reqwest::Client::new();
    let mut ticker = tokio::time::interval(Duration::from_secs(POLL_INTERVAL_SECS));
    // consecutive failures per target: the third argument your m04-l3 machine demands
    let mut failures: HashMap<String, u32> = HashMap::new();

    loop {
        // TODO(1): wait for the next tick of `ticker`.

        let mut probes = JoinSet::new();
        for target in &targets {
            let client = client.clone();
            let name = target.name.clone();
            let url = target.endpoint.clone();
            let timeout = Duration::from_millis(target.budget_ms);
            probes.spawn(async move {
                let started = Instant::now();
                let ok = matches!(
                    client.get(&url).timeout(timeout).send().await,
                    Ok(resp) if resp.status().is_success()
                );
                (name, ok, started.elapsed().as_millis() as u64)
            });
        }

        while let Some(joined) = probes.join_next().await {
            let Ok((name, ok, latency_ms)) = joined else {
                continue; // a probe task panicked; skip it, keep draining
            };
            let count = failures.entry(name.clone()).or_insert(0);
            *count = if ok { 0 } else { *count + 1 };
            let count = *count;
            let now = SystemTime::now()
                .duration_since(UNIX_EPOCH)
                .expect("system clock is set before 1970")
                .as_secs();
            let mut map = statuses.lock().expect("status lock poisoned");
            let prev = map
                .get(&name)
                .map(|s| s.state)
                .unwrap_or(ProbeState::Pending);
            // TODO(2): insert the fresh TargetStatus for `name` into `map`,
            // running `prev`, `ok`, and `count` through the engine's next_state.
        }
    }
}
Recórrelo antes de llenarlo, porque la forma es la lección. tokio::time::interval te da un ticker que dispara en el cronograma, y es la herramienta correcta frente a la alternativa tentadora, dormir 30 segundos al final del loop, por dos razones que puedes verificar: el primer tick dispara de inmediato, así que tu daemon sondea al arrancar en vez de mirar la pared por medio minuto, y el intervalo mide de tick a tick en vez de desde el fin del trabajo, así que dos segundos de sondeo no estiran calladamente tu período a 32. El TODO(1) es genuinamente una línea, esperar ese tick, y el punto de hacerte escribirlo es que sientas dónde respira el loop.
Después el bloque de spawn: la sonda de cada target se vuelve una tarea en un JoinSet, y spawn quiere decir exactamente lo que quería decir conceptualmente en la sección de teoría, pásale este future al runtime y déjalo correr concurrentemente con todo lo demás. Las 40 salen en vuelo antes de que esperes a ninguna. Este es el arreglo para la trampa que muerde el primer loop de poll de casi todo el mundo, esperar las sondas de a una adentro del for, que compila bien, corre bien con tres targets, y calladamente reconstruye el barrido secuencial de 80 segundos sobre el que hiciste la aritmética antes, solo que con pasos extra. Spawnéalas todas, después drena el set con join_next a medida que aterrizan los resultados, en el orden que decida la red. El tick te cuesta la sonda más lenta sola en vez de la suma.
Y lee el drenaje con cuidado, porque join_next te pasa un Result y eso no es ceremonia. Una tarea spawneada es una unidad de falla aparte: si su cuerpo da panic, el runtime atrapa el panic y te vuelve acá como un Err, en vez de derribar el daemon. Nuestro cuerpo de sonda no puede dar panic de forma realista, no hay ningún unwrap adentro, pero el let ... else { continue } (léelo como destructura-o-saltea) es igual la postura de grado daemon: una sonda envenenada debería costarte un solo punto de datos, nunca el resto del tick. Un monitor que se muere de aquello que estaba monitoreando es un chiste malo.
El TODO(2) es la escritura de estado: construye un TargetStatus a partir de next_state(prev, ok, count), la latencia medida y now, e insértalo bajo name. Tu máquina de estados de m04-l3, alimentada por resultados de red reales al fin, y alimentada directo: un loop que ya es dueño de cada resultado simplemente se lo pasa a next_state, sin trait en el medio. El trait ProbeSource de esa lección no se está quedando atrás, se está pagando en el paso 7, un crate más allá, donde finalmente entra el plug vivo que prometió m04-l3. El mapa failures arriba del loop existe porque la firma de esa máquina exige su tercer argumento: next_state solo deja que Degraded caiga a Down cuando el conteo de fallas consecutivas supera el umbral, así que el loop tiene que acordarse del conteo entre ticks, en cero cuando hay éxito, incrementado cuando hay falla. Fíjate también en que el estado previo cae por defecto a Pending para un target que el mapa nunca vio; primer poll después del arranque, todo es Pending hasta que llega evidencia, que es la respuesta honesta.
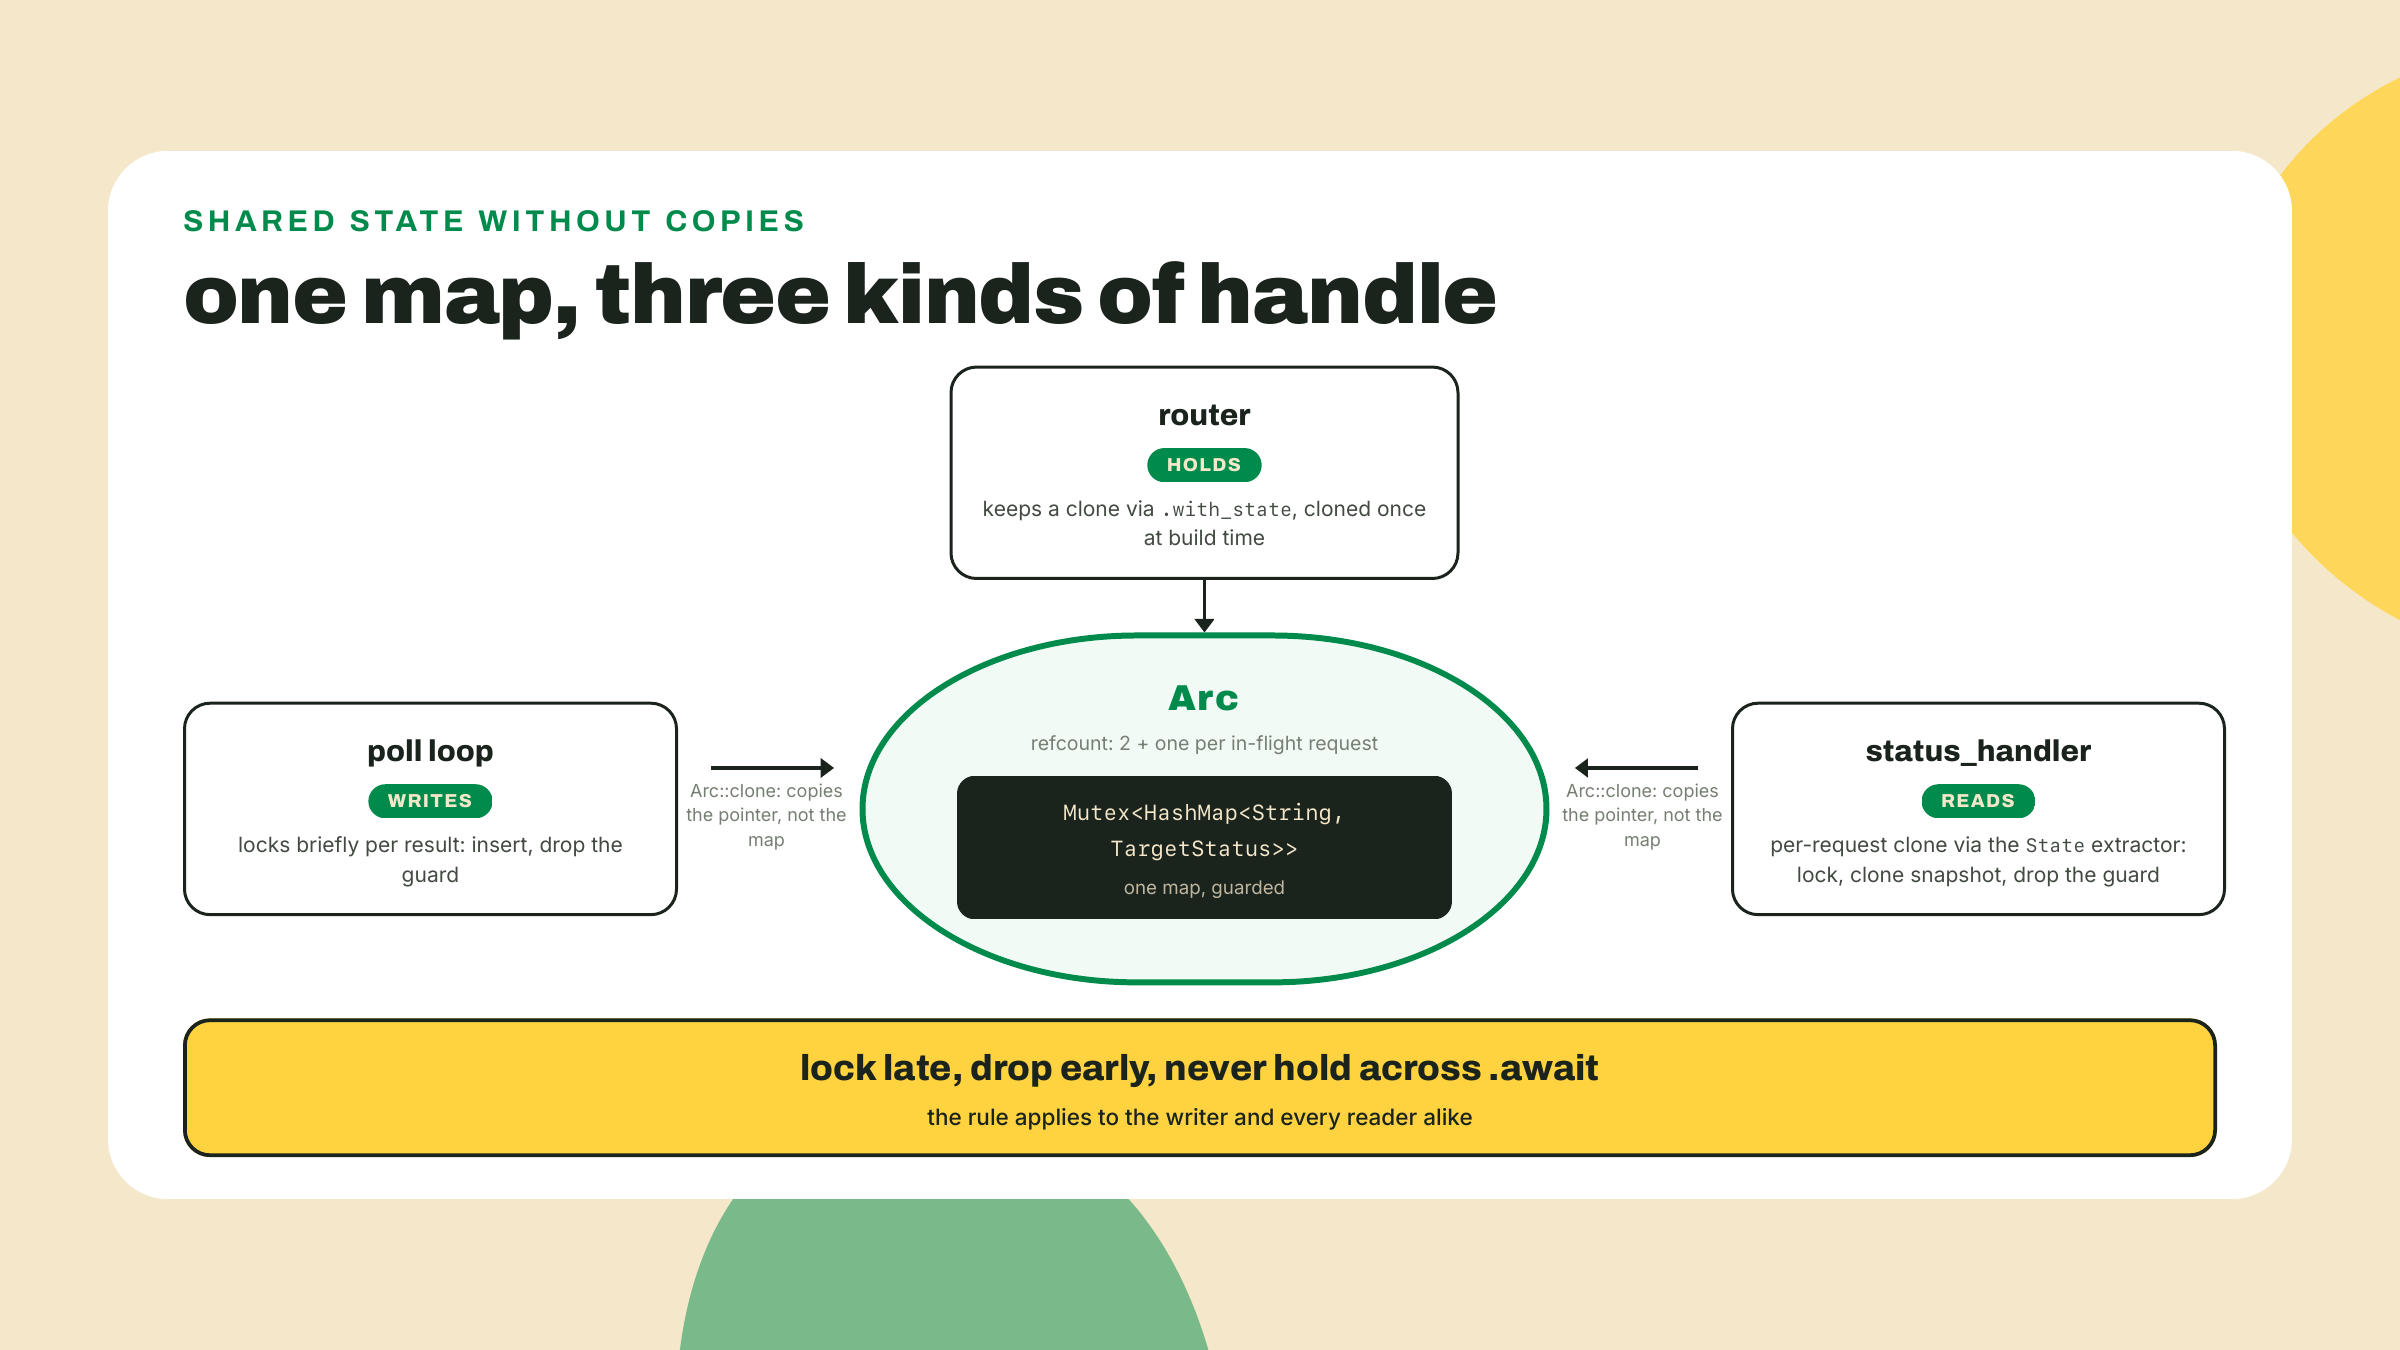
Y mira bien las dos líneas alrededor del lock. El mutex acá es std::sync::Mutex, el común, y la sección crítica es diminuta: toma el lock, lee el estado viejo, inserta, y la guarda se libera al final de la iteración. No hay ningún .await entre el lock y el unlock. Eso no es un accidente, es la regla: sostén un lock de std cruzando un .await y la tarea puede quedar estacionada a mitad de sección crítica mientras otras tareas del mismo thread tratan de tomar el mismo lock. En el mejor caso contención, en el peor caso deadlock. Cierra tarde, suelta temprano, nunca hagas await mientras la sostienes. Dilo una vez en voz alta; te va a ahorrar una noche antes de que pase el año.
La puerta /status: un drop-in trabajado. Acá está la regresión declarada del resumen, y acá está por qué existe. Los servidores HTTP son un pico: routing, extractors, inyección de estado, binding elegante, cada uno su propia madriguera chica, y ninguno es la pelea de este curso. En Rust de producción te vas a encontrar con los servidores sobre todo como cosas que extiendes, no cosas que escribes desde un archivo en blanco. Así que el endpoint llega completamente trabajado y anotado, lees cada línea, y tu costura de edición son exactamente dos lugares: el estado compartido y la forma del JSON. Agrega al final de main.rs:
use axum::{Json, Router, extract::State, routing::get};

async fn status_handler(State(statuses): State<StatusMap>) -> Json<HashMap<String, TargetStatus>> {
    // Lock, clone a snapshot, unlock. The response is built AFTER the guard drops.
    let snapshot = statuses.lock().expect("status lock poisoned").clone();
    Json(snapshot)
}

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let raw = std::fs::read_to_string("pulse.config.json")?;
    let config: Config = parse_config(&raw)?; // m05-l3's parked promise, called at last
    let targets = config.into_targets();

    let statuses: StatusMap = Arc::new(Mutex::new(HashMap::new()));

    // The loop gets its own handle on the state...
    let poller_state = Arc::clone(&statuses);
    tokio::spawn(async move {
        poll_loop(targets, poller_state).await;
    });

    // ...and the router gets another. Clones of the Arc, one shared map underneath.
    let app = Router::new()
        .route("/status", get(status_handler))
        .with_state(Arc::clone(&statuses));

    let listener = tokio::net::TcpListener::bind("0.0.0.0:8080").await?;
    println!("pulse-pollerd listening on http://localhost:8080/status");
    axum::serve(listener, app).await?;
    Ok(())
}
La única idea de verdad en este drop-in es la compartición. Arc es un puntero con conteo de referencias: clonarlo copia el puntero e incrementa un contador, no el mapa. El loop de poll es dueño de un clon, el router es dueño de otro vía .with_state, y axum le pasa al handler un clon barato por request a través de ese extractor State de la firma. Un mapa, muchos dueños, y el Mutex de adentro arbitra las escrituras. Mira las dos llamadas a Arc::clone en main: si haces move del original adentro del loop spawneado en vez de clonarlo, al router no le queda nada que sostener, y el compilador te lo va a decir con esa voz E0382 que conoces de m04-l1. El handler en sí son cuatro líneas y el comentario es estructural: snapshot bajo el lock, serializa afuera, para que un cliente lento descargando JSON nunca te tenga de rehén el loop de poll. Fíjate también en lo que el handler no hace: no sondea. El loop es dueño de producir estado; la puerta solo lo reporta. Un endpoint que volviera a sondear a demanda martillaría tus targets cada vez que alguien hace curl, y haría /status tan lento como un barrido.
Tu único TODO en este drop-in es una edición de forma para que hayas tocado la costura: la respuesta ahora mismo devuelve lo que sea que serialice TargetStatus. Confirma que last_poll está en el JSON, y renombra o rediseña un campo a tu gusto, quizá latency_ms a latencyMs con un rename_all de serde, tu músculo de atributos de m05-l1. La forma del JSON es tuya para poseer; la plomería no, todavía.
Córrelo y golpea la puerta. Desde la raíz del workspace, con pulse.config.json presente:
cargo run -p pulse-pollerd
El daemon imprime su línea de escucha y después parece no hacer nada, que es cómo se ve un daemon desde afuera. Desde una segunda terminal, golpea dos veces, con un intervalo de poll de distancia:
curl -s http://localhost:8080/status
sleep 30
curl -s http://localhost:8080/status
La primera respuesta se ve así, con los nombres de tus targets y números honestos donde los míos son placeholders:
{
  "docs": { "state": "Up", "latency_ms": 143, "last_poll": 1788350402 },
  "api": { "state": "Down", "latency_ms": 611, "last_poll": 1788350402 }
}
Cada target HABILITADO de tu config está presente, cada uno con un estado que tu máquina de m04-l3 asignó a partir de un resultado de red real, una latencia medida, y un timestamp last_poll en segundos unix. Cuenta las claves contra la config antes de seguir: la config de la estación lleva tres targets, y la entrada tcp rpc deshabilitada está legítimamente ausente, porque into_targets filtra por enabled antes de que el loop siquiera la vea. Dos de tres en el JSON es el pipeline funcionando, no un bug. El estado exacto en el que aterriza un target que falla depende de a dónde rutea tu tabla de transición una falla desde su estado previo, que es asunto de tu máquina, no del poller; el poller solo reporta el veredicto. La segunda respuesta muestra los mismos targets con last_poll avanzado alrededor de 30 segundos, y esa palabra alrededor es honesta, porque los timers tictaquean cuando el scheduler llega a ellos, así que espera un segundo o algo de desfase en vez de precisión de metrónomo. Ese timestamp que avanza es tu prueba de vida: el loop sondeó mientras nadie miraba, que es toda la descripción del puesto. Este par de salidas, tomadas con un intervalo de distancia y mostrando el timestamp avanzar con estados por target poblados para cada target de la config, es la barrera de la lección. Guarda las dos.
Una expectativa más puesta a propósito, y es más filosa que "empezar de cero": mata el daemon, reinícialo, y hazle curl a /status antes de que termine el primer tick. No recibes cada target en Pending. Recibes {}, porque el mapa se crea vacío y las únicas escrituras pasan abajo, en el loop de drenaje. Después aterriza el primer tick y cada target aparece ya juzgado, Up o Down, porque tu tabla de m04-l3 no tiene ningún brazo que DEVUELVA Pending: (Pending, true) => Up y (Pending, false) => Down. Pending es la suposición interna del loop sobre un target que el mapa nunca vio, no un estado que /status pueda pasarte alguna vez. El estado vive en un HashMap en memoria de proceso. La persistencia todavía no es promesa de nadie, y nada en la estación afirmó lo contrario; cuando el poller merezca una memoria que sobreviva a los reinicios, esa va a ser su propia decisión con sus propios trade-offs.
Cobra la promesa de m04-l3: HTTP en vivo detrás del trait. Un pagaré del tier de Rust vence en esta lección, y el daemon deliberadamente no es el crate que lo paga. m04-l3 congeló el trait ProbeSource y prometió que HTTP en vivo algún día se enchufaría detrás de él; m05-l3 construyó el brazo de HTTP como una llamada independiente y te dijo que aguantaras las ganas. El poller que acabas de construir también saltea el trait, con fundamentos que ahora puedes defender por partida doble: su loop ya es dueño de cada resultado, así que se los pasa directo a next_state, y el cliente blocking está prohibido adentro de su runtime igual, como demostró el panic al principio de esta lección. Así que el plug aterriza un crate más allá, en pulse-cli, donde blocking es legal y el cliente de m05-l3 ya vive. Primero dale al trait un nombre público: nunca entró en la lista de re-export de m05-l2 porque ningún consumidor se había ganado un lugar ahí, y uno acaba de hacerlo, así que agrega ProbeSource a la línea de re-export del lib.rs del motor. Después extiende crates/pulse-cli/src/main.rs:
use pulse_engine::{ProbeSource, drive};

struct LiveSource {
    client: reqwest::blocking::Client,
    urls: Vec<String>,
    cursor: usize,
}

impl LiveSource {
    fn new(urls: Vec<String>, timeout_secs: u64) -> Result<Self, ProbeError> {
        let client = reqwest::blocking::Client::builder()
            .timeout(std::time::Duration::from_secs(timeout_secs))
            .build()
            .map_err(|e| ProbeError::Unreachable {
                reason: e.to_string(),
            })?;
        Ok(Self {
            client,
            urls,
            cursor: 0,
        })
    }
}

impl ProbeSource for LiveSource {
    fn next_latency(&mut self) -> Option<u64> {
        let url = self.urls.get(self.cursor)?;
        self.cursor += 1;
        let started = Instant::now();
        match self.client.get(url).send() {
            Ok(_) => Some(started.elapsed().as_millis() as u64),
            // A request that never came back is not the source running dry;
            // it is one infinitely slow sample, and drive's budget check
            // turns it into a failure.
            Err(_) => Some(u64::MAX),
        }
    }
}
Lee el impl contra el FixtureSource de m04-l3 y mira al contrato absorber una segunda fuente sin una sola edición a drive: la misma firma, el mismo Option, solo cambió el origen de la respuesta, de un vector a un socket. El brazo Err es la única decisión de diseño del archivo: None querría decir "fuente agotada" y terminaría el drive temprano, así que un request fallido reporta u64::MAX en cambio, una latencia infinita que ningún presupuesto deja pasar. Ahora haz del plug una superficie entregada en vez de un comentario de código: dale a la CLI un tercer subcomando al lado de Probe y Report, una variante Sweep que lleva un posicional urls: Vec<String> y un #[arg(long, default_value_t = 1500)] budget: u64, todo músculo de clap de m05-l3, con este brazo de match:
    Command::Sweep { urls, budget } => {
        let mut source = LiveSource::new(urls, 10)?;
        let state = drive(&mut source, budget);
        println!("sweep verdict: {state:?} (alerting: {})", state.is_alerting());
    }
cargo run -p pulse-cli -- sweep https://www.rust-lang.org https://www.typescriptlang.org
# sweep verdict: Up (alerting: false)
Esa línea impresa cierra el loop que abrió m04-l3: el trait que pasó dos módulos alimentando drive con fixtures ahora lo alimenta con mediciones en vivo, el socket del diagrama de esa lección al fin sostiene su segundo plug, y cada frontera que dibujó este módulo se quedó donde estaba: el daemon se queda con su camino directo, la CLI se queda con su cliente blocking, y el motor sigue sin contener nada de I/O.
El daemon corre, la CLI barre, y el motor del medio está siendo consumido por dos binarios a la vez. Ese es el momento de cobrar una promesa: m04-l2 te hizo marcar pub los ítems movidos y dijo que la privacidad de módulos recibiría su tour como corresponde con Cargo en M6. Este es ese tour, y esperó hasta justo ahora a propósito, porque la visibilidad solo quiere decir algo una vez que hay gente de afuera, y acabas de terminar de construir al segundo. Nada de lo de abajo cambia la estación; son quince minutos con el compilador, y lo reviertes cuando terminas.
El default de Rust es privado, y tu propio layout ya recorre los niveles que importan:
pub más un re-export en lib.rs: drive, next_state, parse_config, total_latency, la puerta de entrada curada. Los consumidores llegan a estos como nombres pulse_engine:: pelados sin ningún path de módulo a la vista, que es el punto entero de curar la lista: el main del poller llama a parse_config, su loop llama a next_state, y la CLI llama a total_latency en su brazo report y a drive en el barrido que acabas de escribir. parse_config es el que vale notar, porque estuvo en esa lista desde m05-l2 sin que nadie lo llamara: m05-l3 dejó estacionado el cableado de config de la CLI y prometió que el poller de m06 retomaría la firma congelada. El paso 4 es donde venció esa promesa, y la puerta de entrada dejó de ser aspiracional.pub sin el re-export: parse_state. Sigue siendo alcanzable, en el path completo pulse_engine::engine::parse_state, que es exactamente la espeleología de paths de módulo de la que la lista de re-export de m05-l2 existe para ahorrarles a los consumidores. Alcanzable y anunciado son promesas distintas.cursor de FixtureSource. Ningún path lo alcanza desde afuera del motor; escribe FixtureSource::new(vec![1]).cursor en cualquier parte del poller y error[E0616]: field `cursor` of struct `FixtureSource` is private es toda la conversación.Entre esos polos se sienta pub(crate): visible en todas partes adentro del crate del motor, invisible para todo consumidor. Demuéstralo con el compilador en vez de creerme. Pasa el parse_state del motor a pub(crate) fn parse_state, mete let _ = pulse_engine::engine::parse_state("Up"); como primera línea del main del poller, y corre cargo check --workspace:
warning: function `parse_state` is never used
 --> crates/pulse-engine/src/engine.rs
  |
  | pub(crate) fn parse_state(raw: &str) -> Option<ProbeState> {
  |               ^^^^^^^^^^^
  |
  = note: `#[warn(dead_code)]` (part of `#[warn(unused)]`) on by default

error[E0603]: function `parse_state` is private
  --> crates/pulse-pollerd/src/main.rs
   |
   |     let _ = pulse_engine::engine::parse_state("Up");
   |                                   ^^^^^^^^^^^ private function
Dos mensajes, y el warning no es ruido, es el mismo hecho contado desde adentro. El motor sigue compilando y sus pruebas unitarias seguirían pasando, pero en el momento en que parse_state dejó de ser alcanzable desde afuera, los únicos llamadores que quedaban eran los #[cfg(test)], que un cargo check pelado no construye, así que dead_code reporta correctamente una función que nadie usa. Eso es estructural, no un error del ejercicio: cualquier ítem pub(crate) cuyo único llamador fuera de pruebas vivía en otro crate avisa exactamente así, y el arreglo en código real es o bien un llamador adentro del crate o #[allow(dead_code)] con una razón escrita. El error de abajo es el de afuera siendo rechazado, y esa división, callada adentro, freno duro afuera, es el significado entero del setting. pub(crate) es la marca honesta para helpers que los módulos del motor comparten pero a los que ningún consumidor debería acoplarse, porque un pub que no quisiste poner es una API pública que ahora mantienes. Revierte las dos ediciones y corre cargo check --workspace una vez más para confirmar que volviste al silencio; el residuo del tour es el reflejo, no el código.
Solo, pura lógica de estado, sin conceptos async nuevos: saca a la superficie en /status el contador de fallas consecutivas de cada target. El loop ya lleva uno por target, porque el tercer argumento de next_state lo exige; lo que el JSON todavía no muestra es el conteo mismo. Agrega un campo a TargetStatus, llénalo desde la entrada de failures en el vecindario del TODO(2), y viaja al JSON gratis, porque a los derives de serde no les importa cuántos campos agregues.
No tienes que romper nada para verlo funcionar, porque la config de la estación ya trae un target que no puede tener éxito: api apunta a https://example.org/health, que contesta 404, y el poller le pone barrera a ok con resp.status().is_success(), así que api viene fallando en cada tick desde que arrancaste el daemon. Por eso la muestra del paso 6 lo muestra en Down. Aceptación: reinicia el daemon para que los contadores empiecen desde cero (viven en failures, un HashMap pelado en memoria de proceso, así que un proceso nuevo arranca vacío), deja pasar tres ticks, que es alrededor de un minuto porque el primer tick dispara de inmediato, después hazle curl a /status y lee api en 3 mientras docs se sienta en 0. Si prefieres manejarlo tú, apunta una segunda entrada a una URL que no pueda tener éxito y mira a las dos trepar juntas en los mismos ticks.
Si quieres saber por qué un monitor se molesta en contar fallas consecutivas en vez de alertar a la primera, lee los dos números uno al lado del otro: docs se mantiene en 0 en cada tick porque un target sano se resetea cuando tiene éxito, así que un solo parpadeo ahí mostraría un 1 y ya no estaría para el minuto siguiente, que es clima. El conteo que trepa de api es la forma de una noticia. El contador es lo que distingue esos dos, y es por eso que la tabla de m04-l3 pone la caída a Down detrás de una guarda de consecutive_failures >= 3 en vez de un solo false.
Corre el auto-chequeo: convierte una herramienta de una sola corrida en un daemon y di con precisión qué te compró tokio por encima de la versión con thread::sleep que escribiste primero, cuarenta esperas estacionadas en un thread en vez de un cronograma ficticio; migra una llamada blocking de reqwest a async y nombra el delta completo, flag de feature afuera, .await adentro, runtime alrededor, el mismo crate; y argumenta las dos direcciones de la decisión de dimensionar bien, porque ahora ya entregaste la CLI blocking donde async sería overhead y el poller donde blocking sería una mentira.
La recuperación de 30 segundos antes de cerrar la terminal: ¿qué le compra async a 40 sondas ligadas a I/O? (Un thread sostiene las 40 esperas, estacionadas y reanudadas al completarse; cada sonda no es más rápida.) Y la regla del lock, ¿en siete palabras? (Cierra tarde, suelta temprano, nunca cruzando un await.)
Un pedido de calibración, porque esta lección hizo dos apuestas opuestas sobre ti: el loop de poll como lo único difícil que escribes tú, el endpoint como un drop-in de solo lectura. Si los dos TODOs del loop se sintieron demasiado delgados o el drop-in te dejó con ganas de escribir el servidor tú mismo, dilo en el feedback; el repliegue se ajusta exactamente con esta señal.
Tu poller ahora corre para siempre, pero solo en tu máquina, contra tu SO, tu glibc, tu suerte. El binario que CI construyó en m05-l3 ya te enseñó que entregar quiere decir pasarle software a máquinas que nunca vieron tu fuente. La lección que viene metemos el daemon en una caja que corre igual en todas partes, y empezamos siendo honestos sobre qué es siquiera un contenedor. Trae el daemon.
Pregunta 1 de 4