Cargando...

 BetaBeta
m09-l1 auditó el árbol: npm audit y cargo audit corrieron en las dos raíces de workspace, AUDIT.md aterrizó con veredictos de keep, upgrade, replace o accept-risk, y los dos lockfiles recibieron una lectura de filosofía de pins. Las dependencias de la estación ahora tienen un rastro en papel. Hoy la estación misma recibe el suyo. Vas a hacer que el poller emita eventos de log JSON estructurados en sus fronteras, le vas a dar a la flota de TS y al edge worker la misma forma de evento, vas a aprender la realidad de los logs del tier gratis en cada plataforma como una restricción de diseño, vas a prender la única alarma que se dispara cuando falla una ejecución programada (y vas a conocer las tres muertes silenciosas que estructuralmente no puede oír), y vas a terminar el barrido de secretos de cuatro plataformas como una sola tabla. El contrato de repliegue, en voz alta: este es el peldaño de checklists-sobre-walkthroughs, el último apoyo del curso. La forma del evento se da una sola vez como lista de campos, un grep de incidente se trabaja completo, y el cableado del poller, el cableado del worker, la configuración de notificaciones y la tabla del barrido son tuyos para manejarlos desde checklists, sobre superficies que ya entregaste. Después de esto, m10-l1 te pasa una página en blanco y te pide la estación entera de memoria.
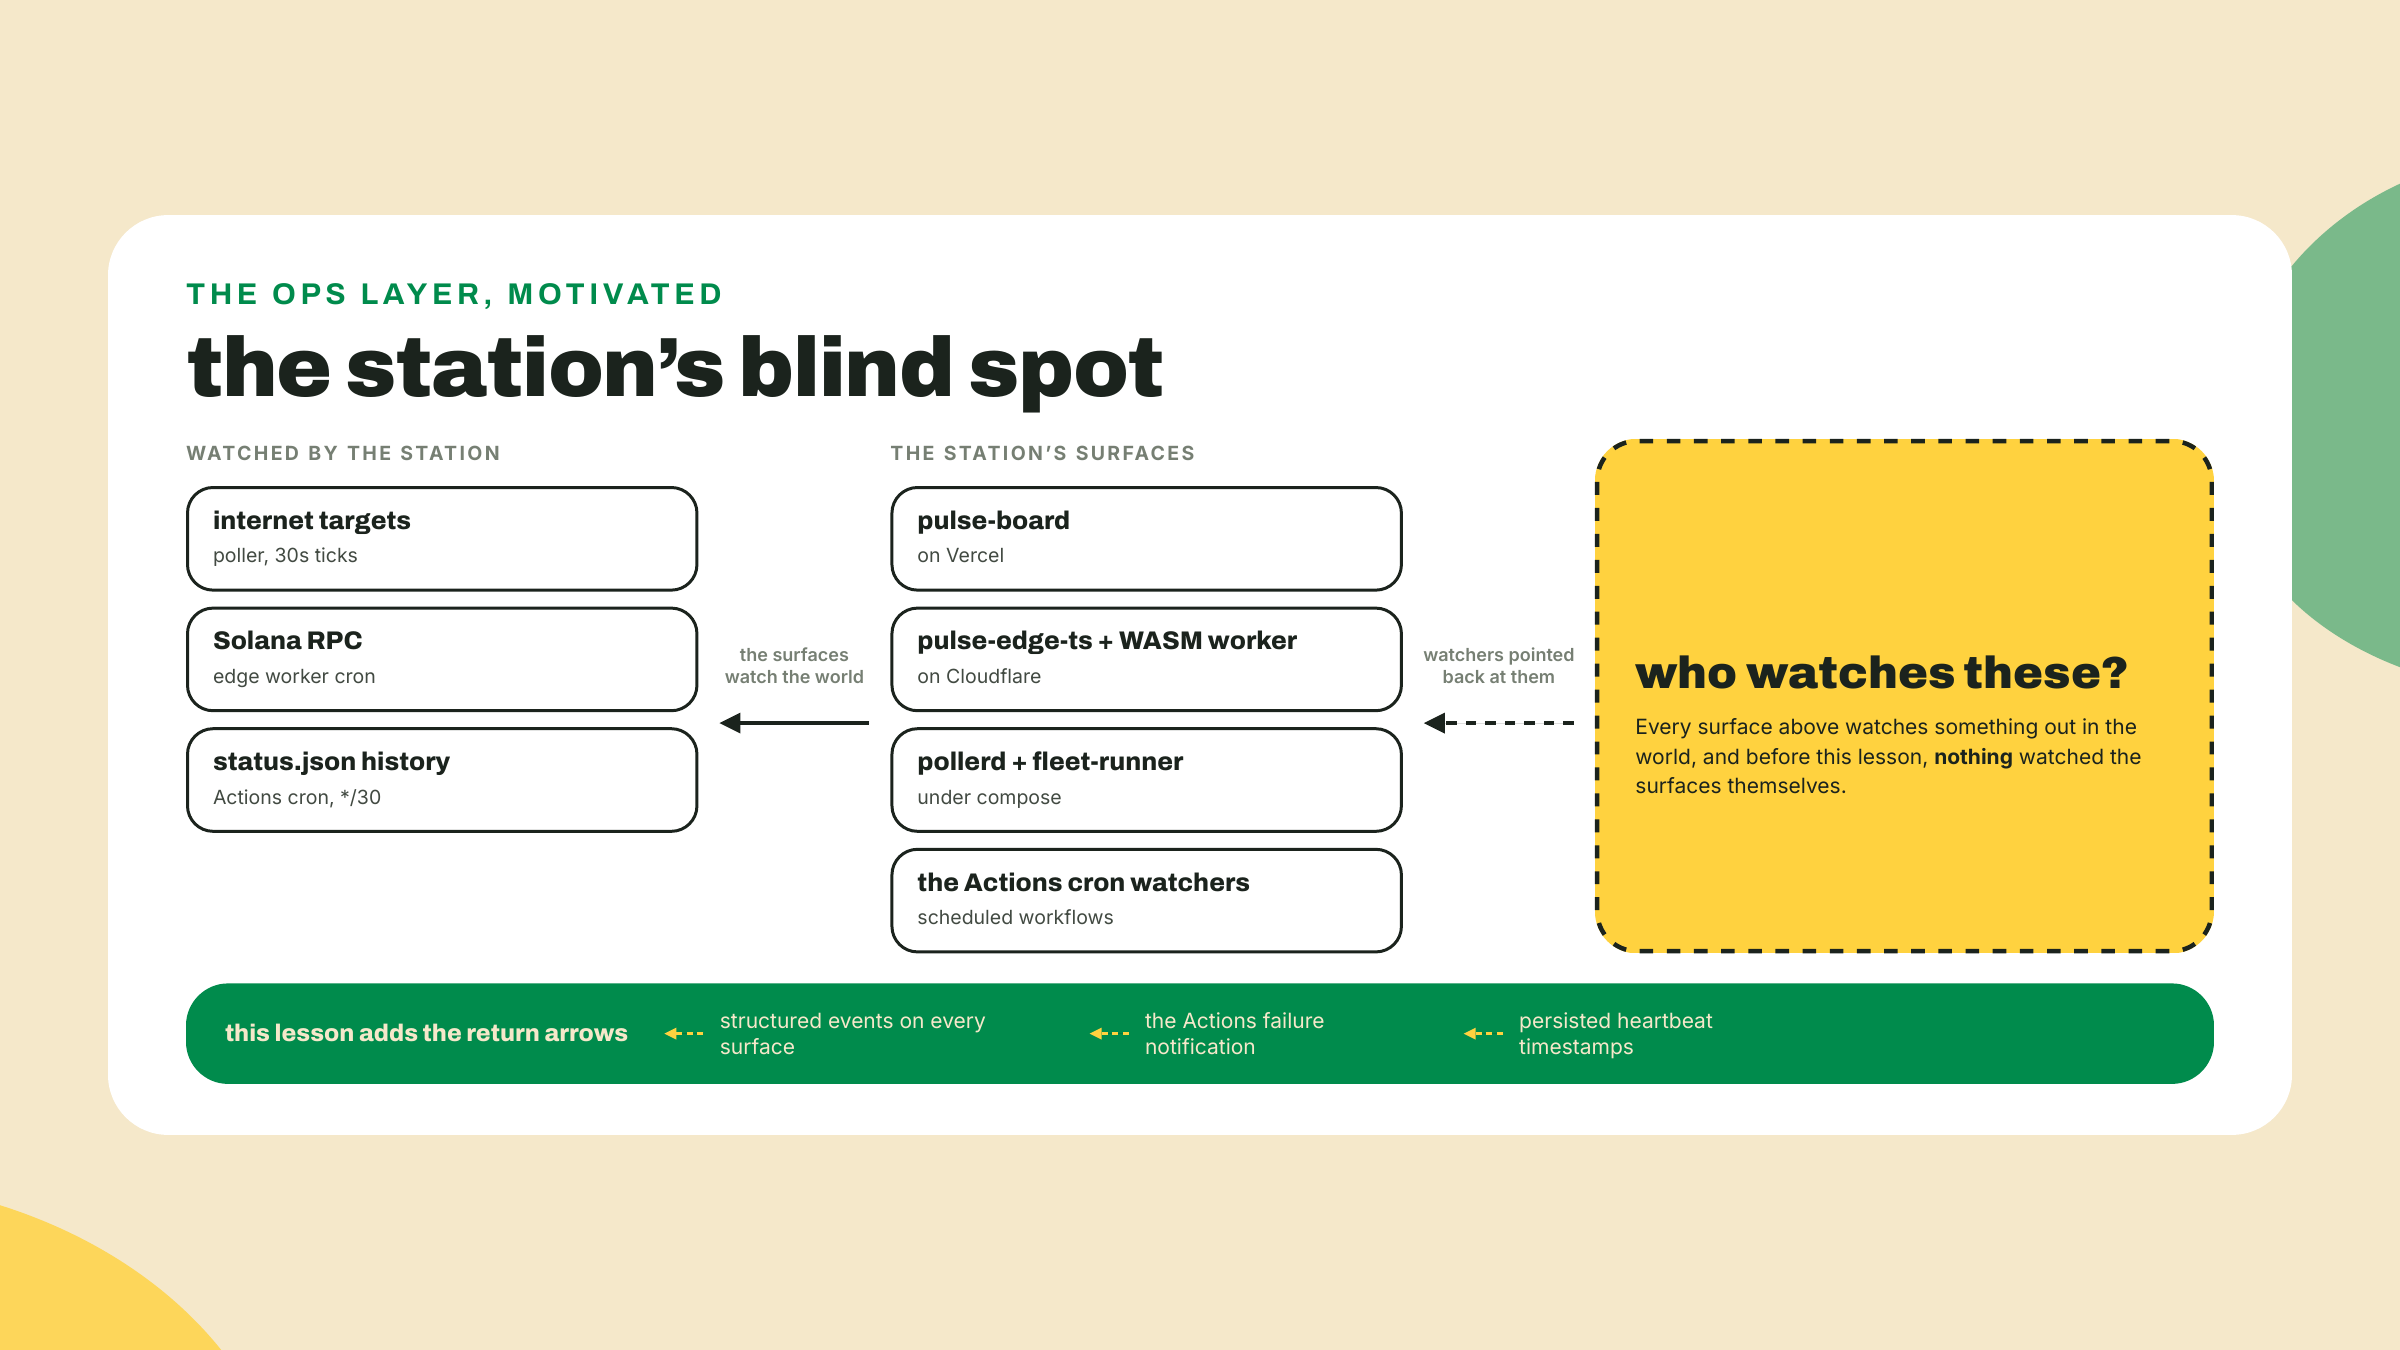
Tu estación vigila un panel de Vercel, dos edge workers, un poller de Docker y una blockchain. Cuenta los vigilantes apuntados de vuelta hacia ella: cero. Si el poller se muere a las 3 a.m., o el cron deja de dispararse en silencio, el único testigo es una ausencia, y las ausencias no mandan emails. El módulo 6 llamó rumor con línea de comandos a un monitor que tienes que acordarte de invocar. El mismo cuchillo, un nivel más arriba: un monitor no observado es apenas un rumor.
Hagamos que el poller hable primero y teoricemos después. Abre crates/pulse-pollerd/src/main.rs y agrega un helper arriba de poll_loop (serde_json ya es una dependencia desde m06-l1, no hay nada que instalar):
use serde_json::json;

fn log_event(value: serde_json::Value) {
    println!("{value}");
}
Después, en el loop de drenaje, justo después del punto donde se computa now y antes del map.insert que escribe el status del target, emite un evento por cada resultado de sonda:
let outcome = if ok { "up" } else { "down" };
log_event(json!({
    "event": "probe_result",
    "target": name,
    "outcome": outcome,
    "latency_ms": latency_ms,
    "ts": now,
}));
Corre cargo run -p pulse-pollerd, dale un tick de 30 segundos, y mira cómo las líneas crudas aterrizan entre el resto de la salida. Después dale Ctrl-C (un daemon a la vez; es dueño del puerto 8080) y córrelo de nuevo, filtrado:
cargo run -p pulse-pollerd 2>/dev/null | grep '"event":"probe_result"'
Una línea JSON por sonda, filtrable por máquina, cada una cargando quién, qué, qué tan rápido y cuándo. Ese es todo el truco de esta lección, hecho en los primeros diez minutos. El resto es hacerlo deliberadamente, en cada superficie, y después asegurarse de que la muerte de la estación misma sea al menos tan ruidosa como la de sus targets.
Acá está la pregunta de las 3 a.m. a la que esta lección vuelve una y otra vez: "¿cuándo fue la última vez que el target api giró de up a degraded?" Ahora mira los dos estilos de logging que podrían intentar responderla. El primero es el que la mayoría escribimos por instinto, y yo he sido culpable de eso por años: println!("probe had a problem, retrying soon"). Prosa. Cálida, legible de arriba a abajo, e inútil a las 3 a.m., porque "un problema" coincide con todo y no ancla nada. El segundo estilo trata la pregunta como el schema: un cambio de estado es un evento, con un target, un from, un to y un timestamp, así que la consulta de incidente es un grep con el nombre del campo adentro.
La forma de evento de la estación, dada una sola vez, acá, como el contrato que comparten las tres superficies de logging:
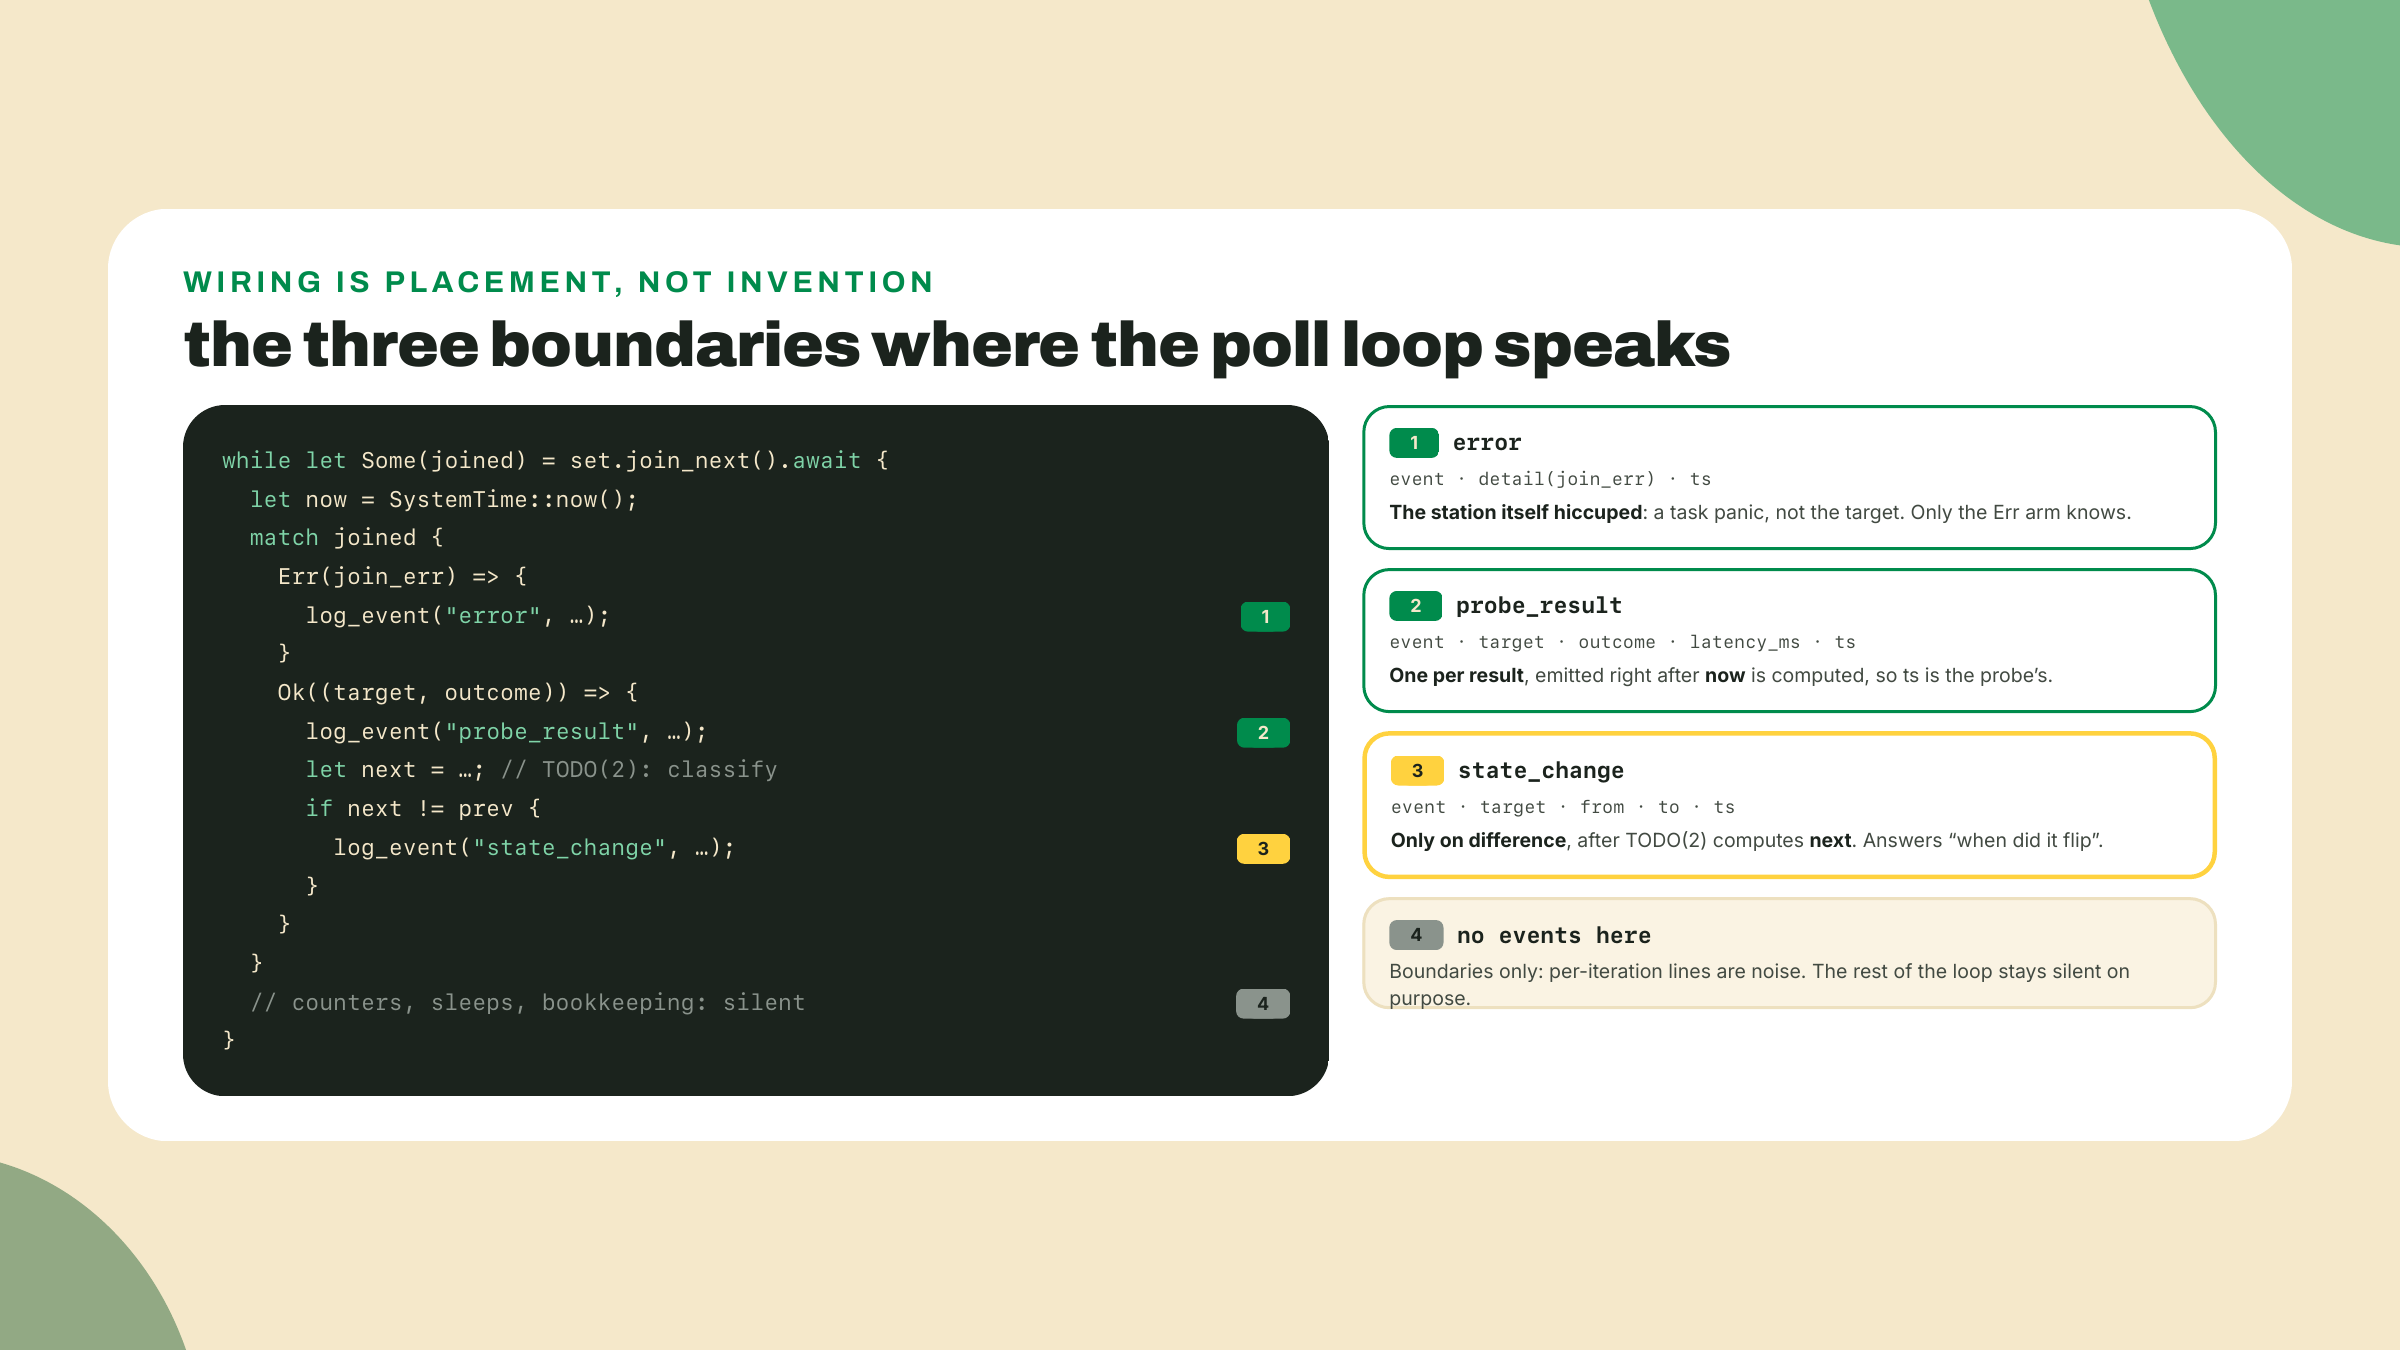
event (uno de probe_result, state_change, error), target y ts (segundos unix).probe_result agrega outcome (up o down) y latency_ms.state_change agrega from y to, escritos en el vocabulario propio de la superficie que emite: nombres del motor (Pending, Up, Degraded, Down) en el poller, nombres de variante de ProbeResult en la flota, nombres de veredicto en el edge; nombres estables dentro de una superficie, no un enum compartido.error agrega message, y quiere decir que la estación misma tuvo un hipo, no que un target se haya caído. Un target caído es un probe_result; una tarea de sonda que dio panic es un error. Mantener eso separado es lo que hace que valga la pena poner una alarma sobre el stream de errores. Cuando la superficie que falla es una lectura de blockchain, error también lleva plane, el string de cuatro veredictos del método plane() que m08-l3 te hizo escribir, porque una lectura de blockchain se sienta justo en la costura entre estación-con-hipo y target-caído, y el plano es lo que le deja al lector de las 3 a.m. dictaminar de qué lado está.Una línea por evento, a stdout, y nada más. En el poller de Rust eso es escritura de líneas con serde_json pelado, a través del helper que acabas de agregar, a propósito no un framework. En la flota y en el worker es console.log(JSON.stringify(...)). El stdout importa más de lo que parece: el pipeline de logging de Docker, wrangler tail y el log de ejecución de Actions son todos apenas lectores de la salida estándar, así que al escribir líneas ahí heredas gratis la plomería de logs de tres plataformas.
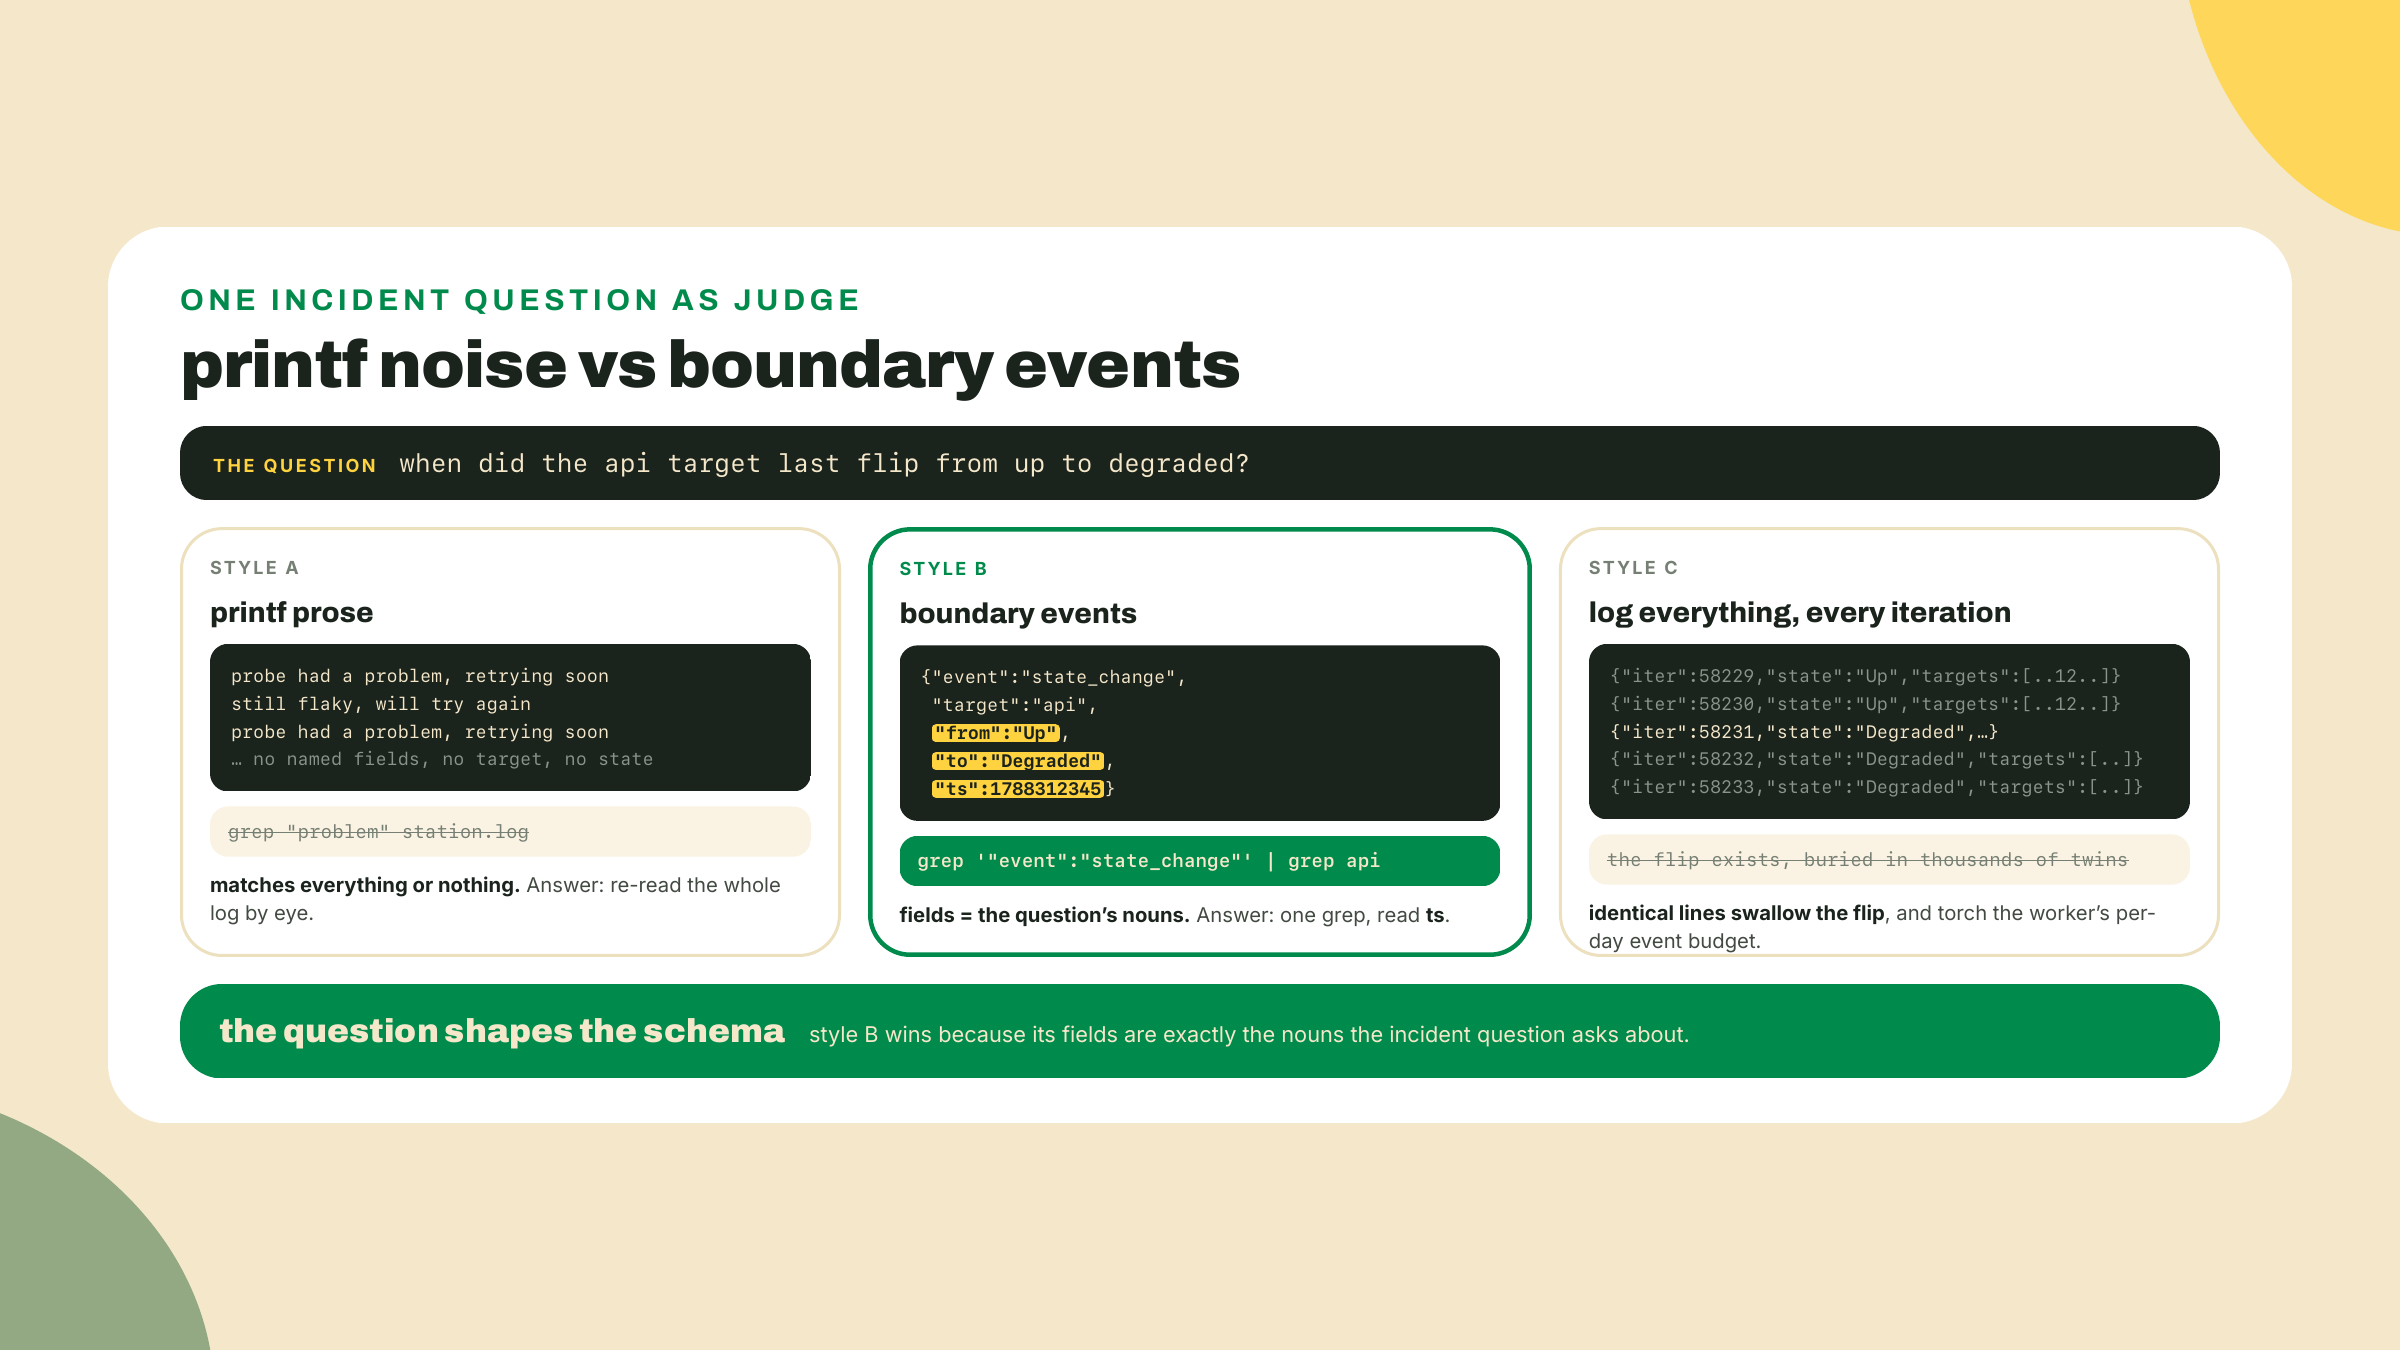
¿Por qué fronteras y no todo? Porque un evento de log es una afirmación de que algo cambió en un borde que vale la pena recordar: volvió un resultado, un estado giró, la estación misma falló. Una línea por iteración del loop registra que pasó el tiempo. El volumen no es capacidad de responder. Vas a sentir la diferencia en el momento en que grepees una semana de logs de compose, y tu billetera lo va a sentir del lado del worker. El nombre es más viejo que la computación: el log de a bordo, el cuaderno de bitácora, toma su nombre del log literal, el leño que los marineros tiraban por la borda para medir la velocidad, una medición de frontera con un timestamp. Los marineros no llevaban diario de cada ola.
Puede que hayas notado lo que la lista de campos deja afuera: los niveles de log. Ninguna perilla de debug, info, warn en ninguna parte. Eso es una decisión, no un descuido. Los niveles responden "qué tan fuerte debería decir esto", y para una estación con tres clases de frontera el nombre del evento ya lo responde: probe_result es rutina, state_change es notable, error es la estación pidiendo atención. Una perilla de severidad se gana su lugar cuando un proceso emite docenas de clases de evento desde diez subsistemas y necesitas bajar categorías enteras sin volver a desplegar. Hasta que la estación sea ese mundo (el crate tracing en el cuadro de Profundiza), un campo de nivel sería una decisión más por call site que no compra nada que un grep sobre event no te dé ya.
El logging estructurado también tiene un costo, y nombrarlo es lo justo: ceremonia. log_event(json!({...})) es más feo que un print, cada campo es una decisión chica, y nada de eso hace que el camino feliz corra mejor. Pagas ese impuesto precisamente para que el grep de las 3 a.m. funcione. La observabilidad es un seguro, y un seguro es aburrido justo hasta la noche en que no lo es.
La estación ahora escribe logs. A dónde van esos logs, y cuánto viven, cambia según la plataforma, y los tiers gratis son honestos sobre lo parciales que son. Restricciones, no quejas:
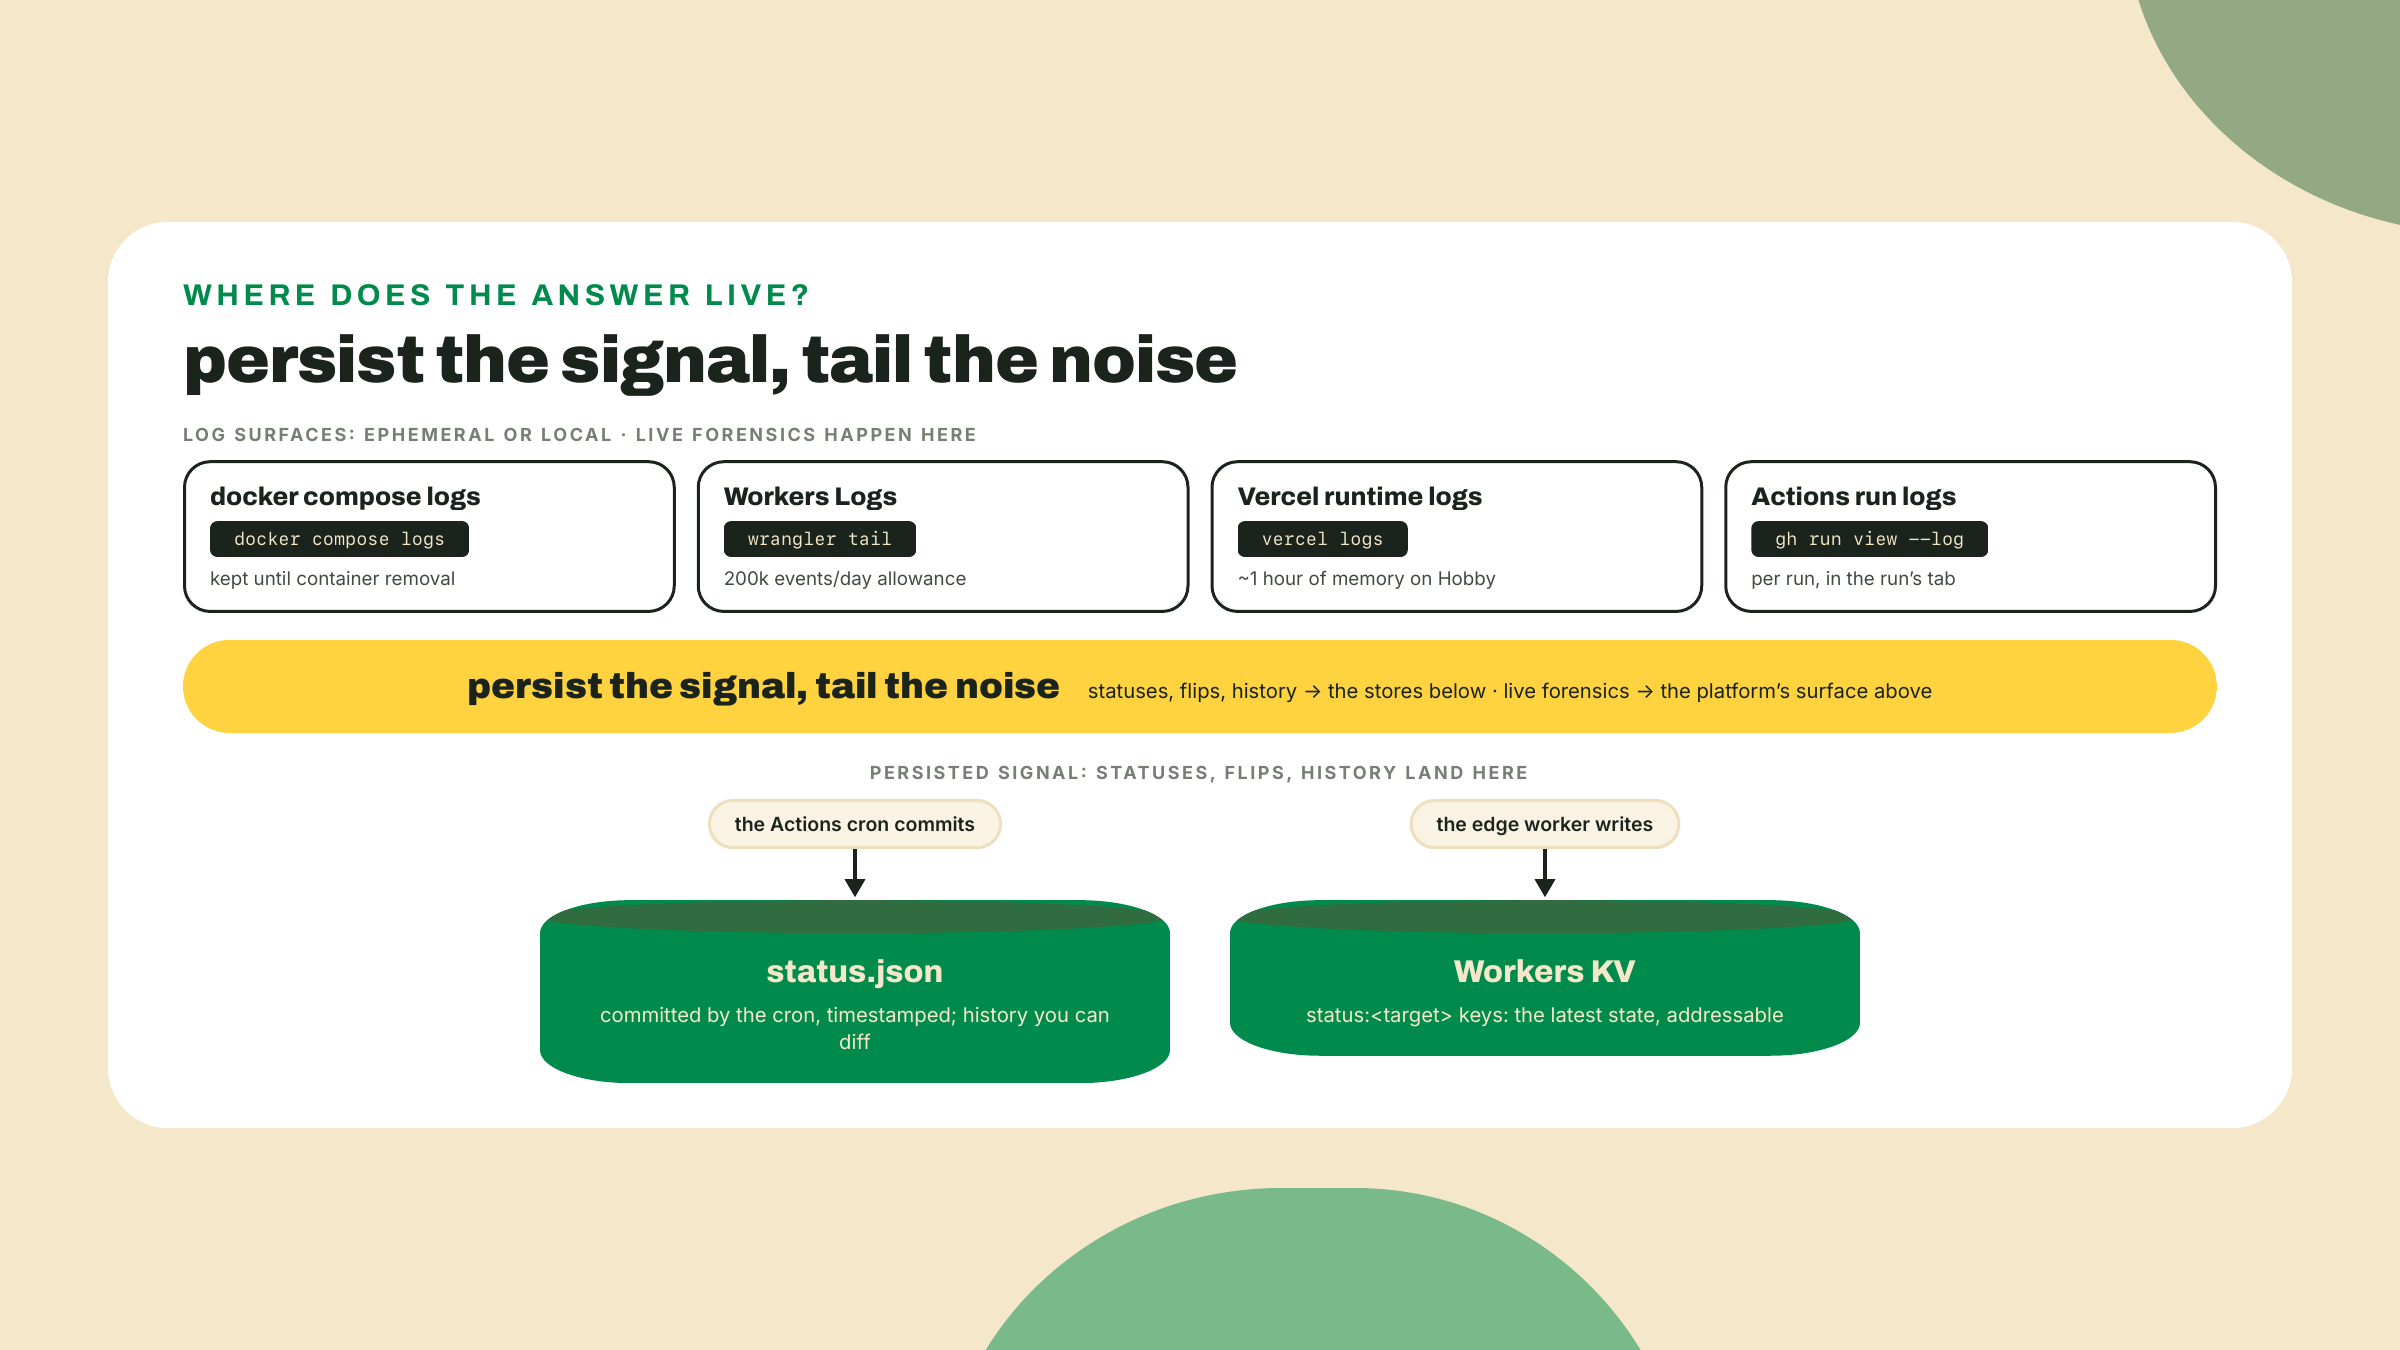
Docker, local. docker logs <container> y docker compose logs <service> leen todo lo que un contenedor escribió alguna vez a stdout, guardado hasta que se elimina el contenedor. Agrega -f para seguirlo en vivo. Esta es tu memoria local más larga y la superficie contra la que corre el ejercicio de grep de incidente que viene abajo.
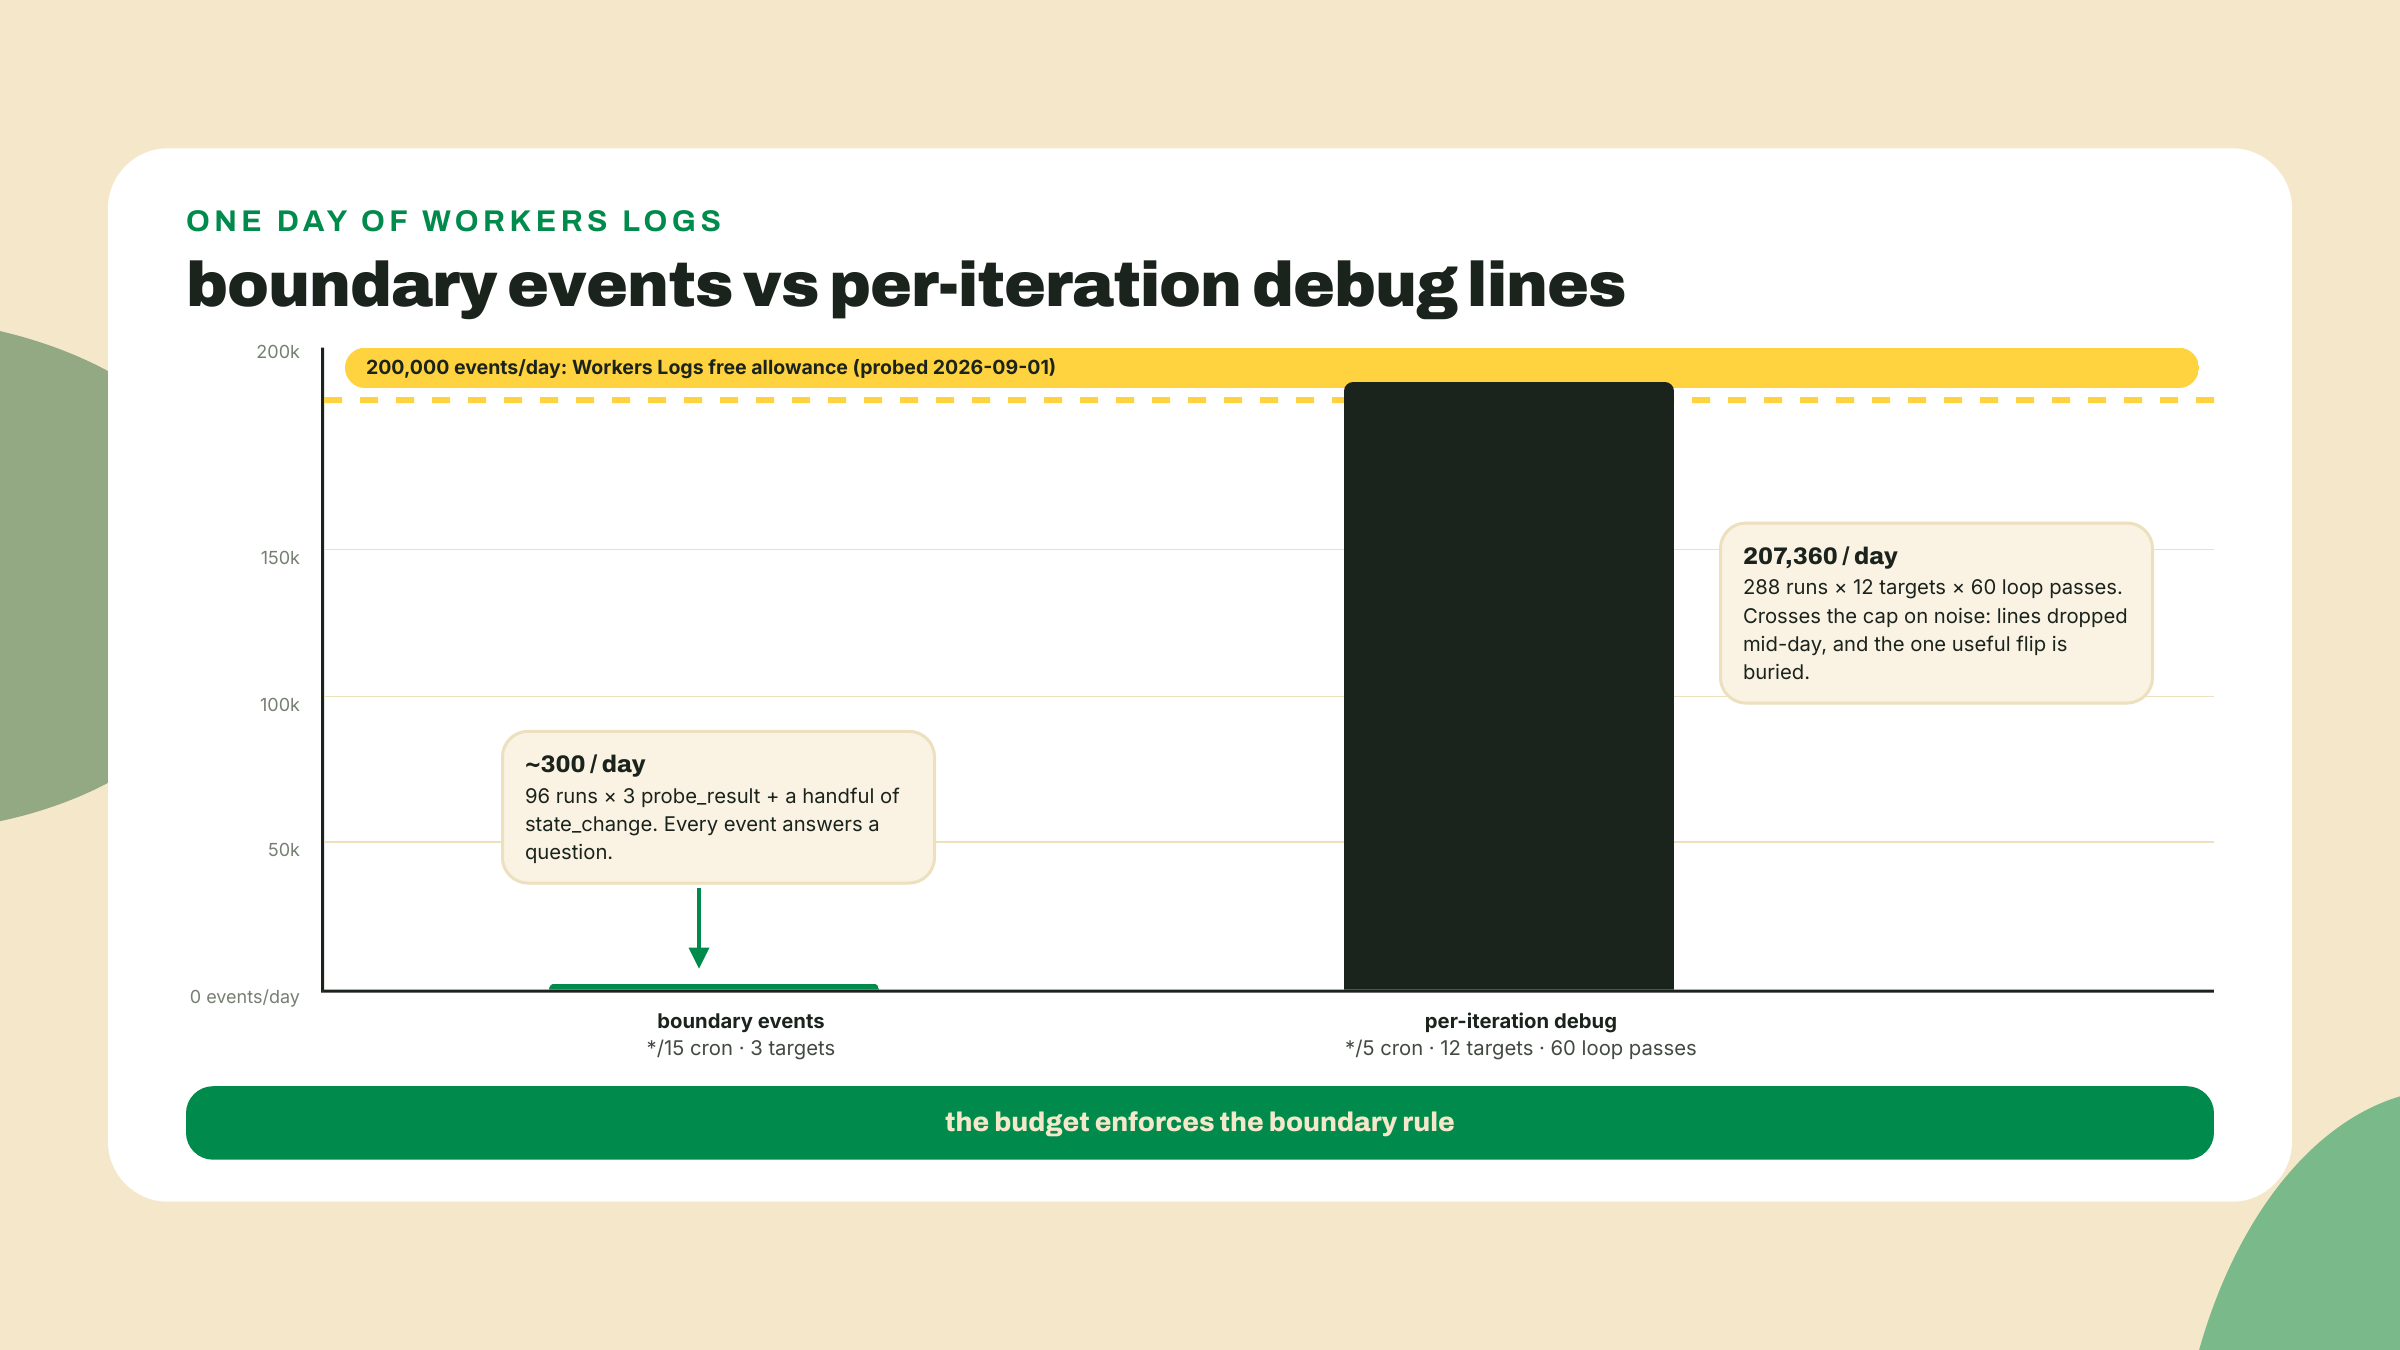
Cloudflare Workers. Dos herramientas. npx wrangler tail transmite eventos en vivo desde cada ciudad en la que corre tu worker, tu único análisis forense en tiempo real en una plataforma sin ssh. Y Workers Logs recolecta eventos con una asignación gratuita de 200,000 eventos por día (según la página de precios de Cloudflare, sondeada el 2026-09-01). Ese número suena enorme hasta que haces la matemática de los loops. Un worker hipotético y hablador con un cron de 5 minutos hace 288 ejecuciones al día; dale una docena de targets y una línea de debug por target por pasada del loop interno, digamos 60 pasadas, y 288 × 12 × 60 es 207,360 líneas. Pasado de presupuesto, en ruido. Los requests y los eventos de log son medidores distintos, así que tu tráfico puede estar lejísimos de su techo mientras tus logs se descartan a media tarde. El presupuesto es la plataforma haciendo cumplir la propia regla de esta lección: loguea en las fronteras y el mismo día cuesta unos cientos de eventos.
Vercel. En Hobby, los logs de runtime se retienen alrededor de una hora (según los docs de límites de Vercel, chequeados el 2026-09-01). Quédate con eso un momento: un usuario reporta que tu función falla el sábado por la mañana, abres el panel el lunes, y no encuentras casi nada. Por diseño. Nuestro panel son archivos estáticos hoy, así que lo que la estación tiene en Vercel ahora mismo son logs de build, pero esta restricción se hereda el día en que al panel le crece su primera función, y replantea para qué sirven los logs de plataforma. Desde el 2025-04-23, cuando Vercel prendió Fluid compute por defecto, serverless ahí ha querido decir, en silencio, "servidores que no manejas": concurrencia adentro de las instancias, facturación por Active CPU, y el mismo trato con el historial. La plataforma corre tu función. No archiva tu pasado.
GitHub Actions. Cada ejecución guarda su log completo en la pestaña Actions, por ejecución, navegable después del hecho. Acá es donde aterriza el stdout de tu cron, step por step, y donde vas a leer la ejecución roja del ejercicio de alarma. Es también la única de las cuatro superficies que registra cuándo arrancó de verdad una ejecución contra cuándo estaba programada, lo que la vuelve el dato crudo para la medición de desfase del lab. Un hábito se transfiere sin cambios: si tu workflow imprime eventos estructurados, el log de la ejecución los hereda, y un grep sobre un log descargado responde preguntas igual que docker compose logs.
La oración-costura que organiza las cuatro, y el diseño que tu estación ya sigue sin haberlo nombrado: persiste la señal, tailea el ruido. Todo lo que la estación tiene que recordar vive en status.json y en KV, escrito ahí a propósito, desde el módulo 1. Los logs son para la pregunta del momento, taileados en vivo o grepeados recientes. Si te agarras necesitando una línea de log del sábado pasado, esa línea era una señal disfrazada de log, y va en el estado persistido en cambio. Hacer arqueología el lunes por la mañana sobre el incidente del sábado, solo desde logs de plataforma del tier gratis, es imposible a propósito.
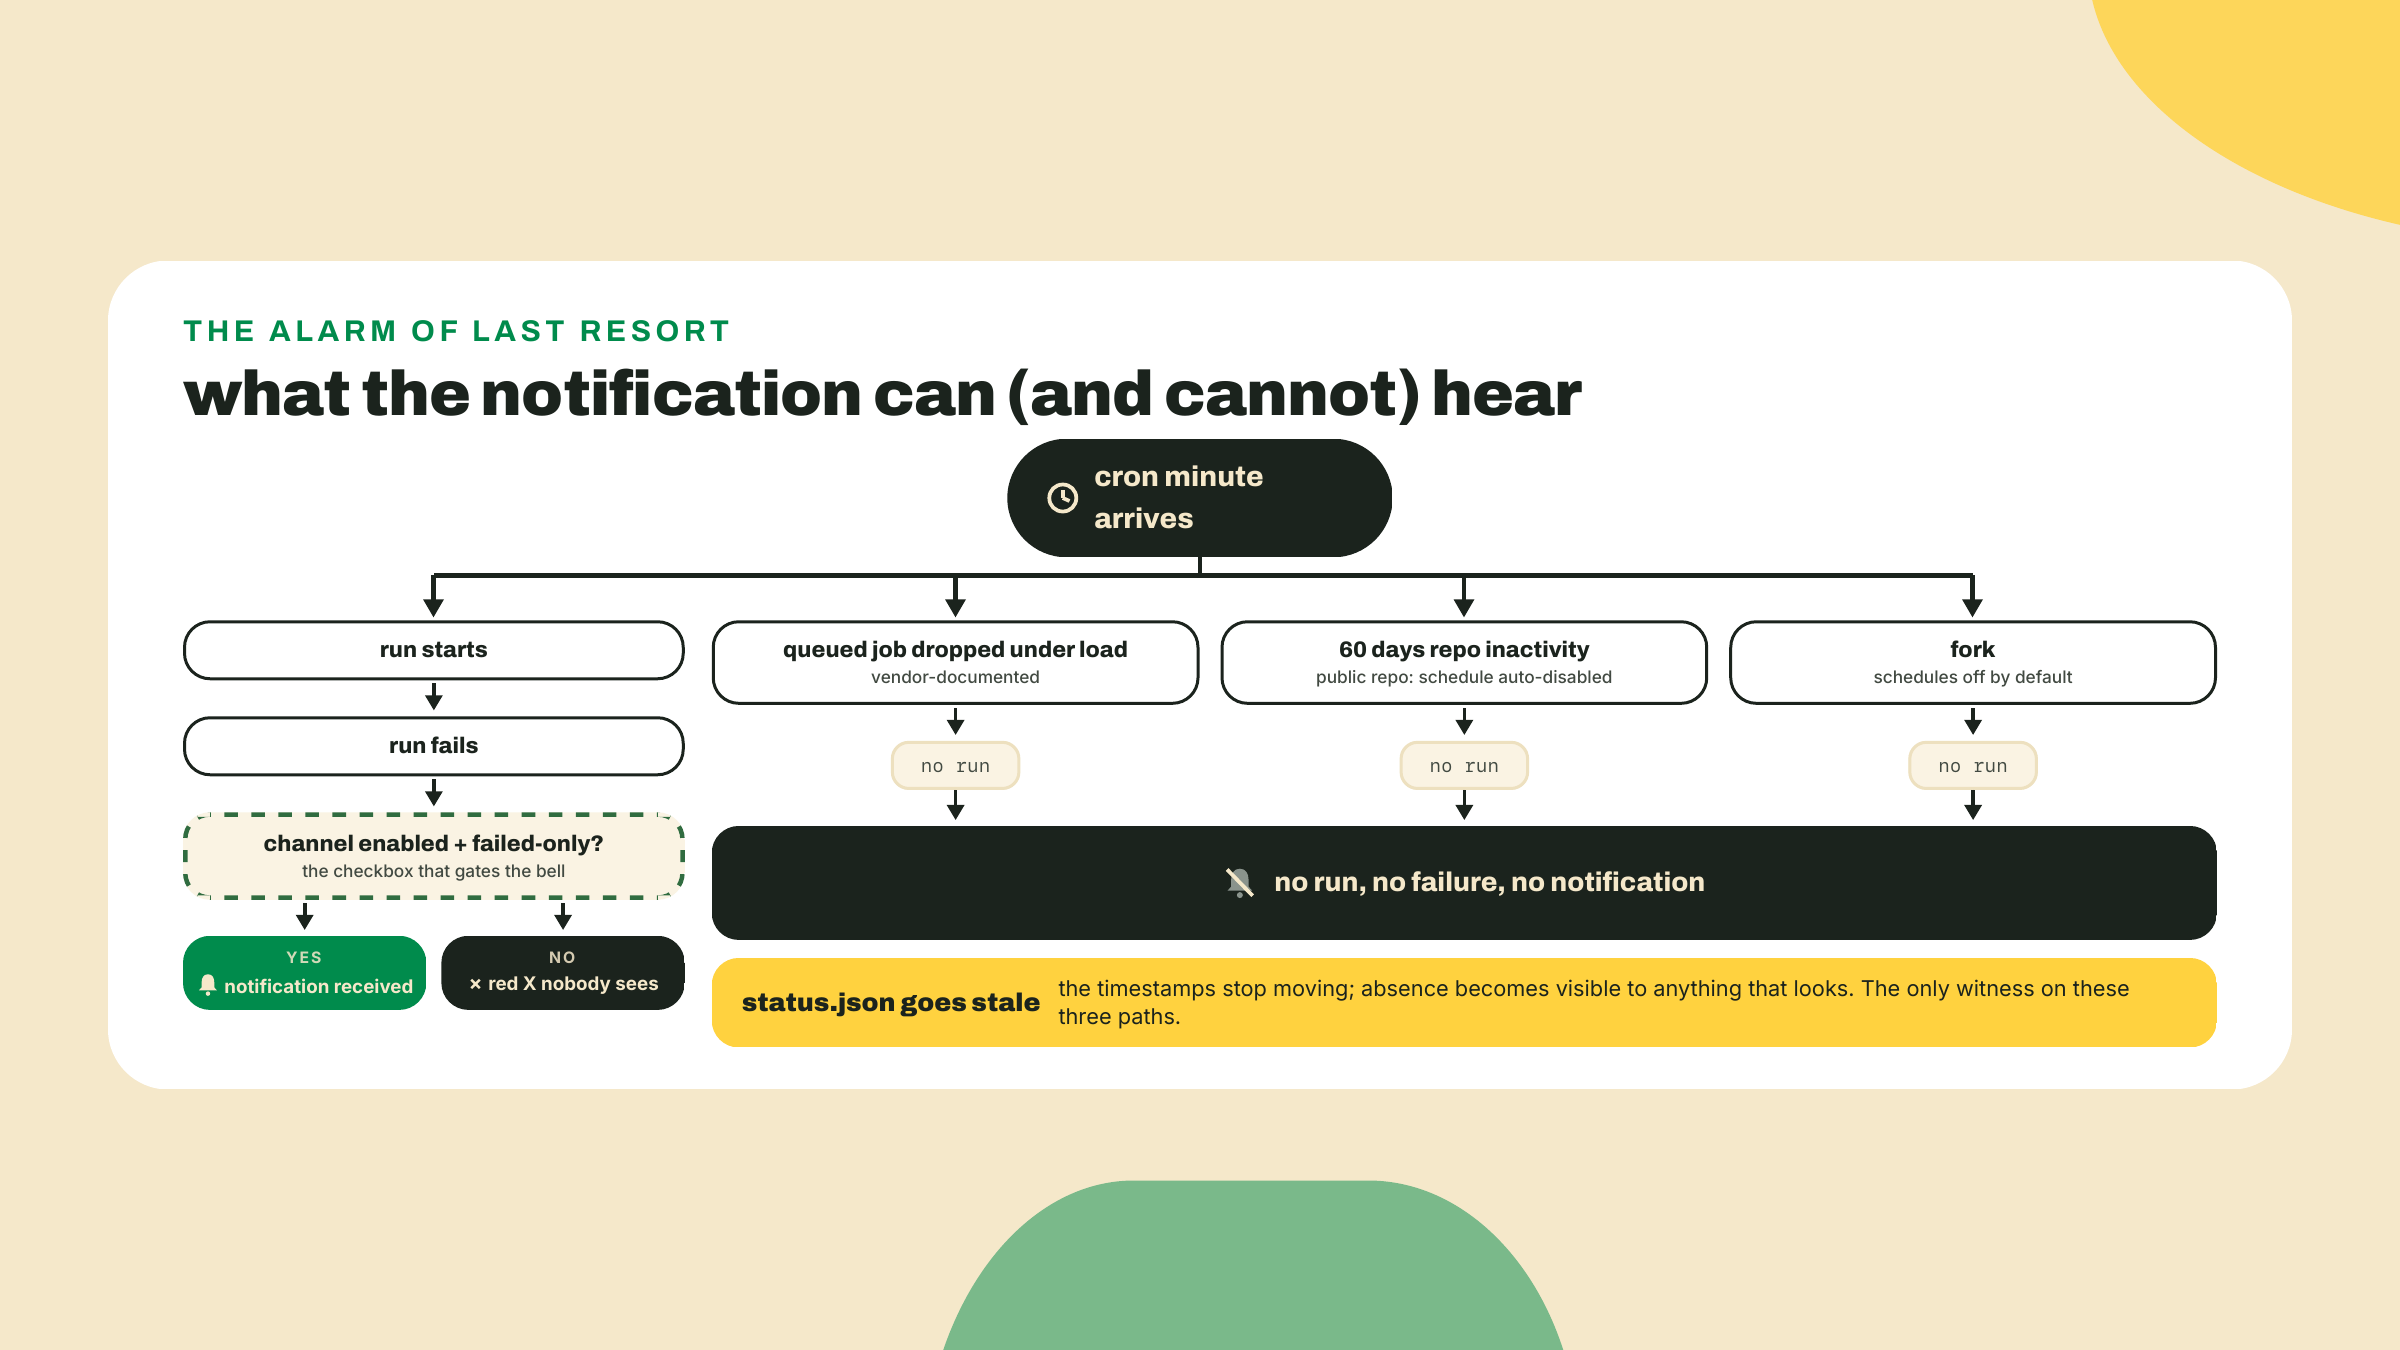
Ahora el momento más filoso de la lección. Supón que tu workflow de cron falla esta noche a las 3 a.m., con todo en sus valores por defecto. ¿Qué hace GitHub? Probablemente nada que vayas a ver. El canal de notificaciones de Actions viene por defecto en "Don't notify". Hay una X roja en una pestaña que no estás mirando, y esa es toda la alerta. Una alarma sin configurar no es una alarma; es una decoración con opinión.
Prenderla es un recorrido por settings, requerido en el lab de abajo: Notification settings, después System, después Actions, elige un canal de entrega (On GitHub, Email, o los dos), y marca Only notify for failed workflows, porque un email de ejecución verde cada 30 minutos te entrena para borrar exactamente el mensaje que algún día va a importar.
Dos comportamientos de este canal vale la pena conocer antes de que seas dueño de un repo compartido. Las notificaciones de workflows programados van al creador del workflow, la cuenta que hizo el primer commit del cron. Y según los docs de GitHub, si un workflow programado se desactiva y después se reactiva, las notificaciones van al usuario que lo reactivó y no al usuario que modificó por última vez la sintaxis del cron. En una estación de una sola persona eso es anécdota. En cualquier repo compartido, quiere decir que el pager puede cambiar de manos en silencio con un toggle inocente, así que ten claro quién es su dueño.
Y ahora la parte honesta, la razón por la que esta alarma es "de último recurso" y no simplemente "la alarma". Una notificación de falla requiere una ejecución que corra y falle. Los propios docs de GitHub, textualmente: "Los eventos programados pueden retrasarse durante periodos de alta carga en ejecuciones de workflows de GitHub Actions. Los momentos de alta carga incluyen el comienzo de cada hora. Si la carga es suficientemente alta, algunos jobs en fila pueden descartarse". Best effort, por escrito, del vendor. Una ejecución descartada no produce ninguna X roja ni ningún email. Tampoco la trampa de los 60 días que conociste en m01-l3: en un repo público, 60 días sin actividad en el repositorio y el calendario se apaga, limpiamente, sin que nada falle. El commit keepalive que aprendiste ahí como contramedida mantiene acá su salvedad de m01-l3 en plena vigencia: la práctica de la comunidad dice que los commits reinician el reloj, existen actions keepalive hechas a propósito porque suficiente gente lo cree, y GitHub nunca definió qué quiere decir "actividad", así que se queda en reportado-en-la-práctica, nunca política. Los forks arrancan con los calendarios apagados del todo. Tres formas documentadas de que el latido se detenga en puro silencio, y el canal de notificaciones es estructuralmente sordo a las tres.
¿Qué tan grande es el retraso del calendario cuando los jobs sí corren? No cité un número, y no lo voy a hacer: GitHub documenta que el retraso existe y nunca documenta su tamaño. Esta es la misma disciplina que la blockchain que vigila la estación. Solana apunta a slots de 300ms; el 2026-09-01 una sonda de 20 muestras de la red real midió 316ms. Los sistemas tienen metas, y tú mides igual. Tu cron tiene un minuto meta (y un piso: el intervalo más corto que GitHub programa es de 5 minutos), así que el lab te hace medir tu propio desfase desde el historial de ejecuciones en vez de confiar en un número que nadie publicó.
Así que la alarma recibe un respaldo que la plataforma no puede descartar: el latido persiste donde la ausencia es visible. Cada ejecución del cron hace commit de status.json con timestamps. Una ejecución que nunca pasa deja el archivo desactualizado, y la desactualización es un hecho que cualquier cosa puede verificar: tú, mirando de reojo la edad de los datos del panel; o una sonda futura, tratando tu propio repo como un target. La notificación atrapa las muertes ruidosas. Los timestamps atrapan las silenciosas. Nombrar lo que la alarma no puede atrapar no es una salvedad sobre la lección de ops; es la lección de ops.
Una sola regla ata el momento del logging al momento de los secretos, y es lo bastante corta como para memorizarla: nunca loguees el entorno. Ni process.env, ni std::env::vars(), ni un objeto de error que servicialmente incruste su contexto de config. El barrido que estás por completar existe para mantener los secretos fuera de git; una línea de log que serializa el entorno los copia a logs retenidos en cambio, que en algunas plataformas sobreviven al incidente y en todas las plataformas viajan más lejos de lo que crees. Tu schema de eventos es tu aliado acá: las cuatro listas de campos de arriba no contienen ningún campo que pudiera cargar un secreto, así que mientras las fronteras emitan solo el schema, el barrido y los logs se mantienen de acuerdo.
El barrido mismo es el cuarto momento de la lección y el entregable más callado del lab: una tabla, cuatro plataformas, respondiendo "dónde vive cada secreto para que nunca aterrice en git ni en una línea de log". Ya conociste cada fila, una plataforma a la vez: secretos de repo alimentando el env del workflow en el módulo 1, vercel env pull en el módulo 3, .dev.vars más npx wrangler secret put en el módulo 7 con la promesa de que m09-l2 lo iba a barrer a lo largo de las cuatro. Este es ese barrido. Nuevo en la tabla son solo las notas de operación, incluido un límite duro que vale la pena anotar: Vercel le pone un techo de 64KB al tamaño total de tus variables de entorno, nombres y valores. El formato de la tabla está en el lab; debería leerse como algo que pegarías con cinta al monitor, porque esa es más o menos su función.
Profundiza (el 20%). esta lección enseña logging estructurado como escritura de líneas con serde_json pelado, que es el tamaño correcto para un daemon con un solo stdout. La respuesta más profunda del ecosistema de Rust es el crate tracing: spans, niveles, subscribers, campos estructurados que atraviesan stacks de llamadas async, la cosa a la que recurres cuando un request toca diez funciones y quieres la historia rearmada. Su puerta de entrada es https://docs.rs/tracing/latest/tracing/ (URL chequeada el 2026-09-02). Guárdalo como bookmark, léelo cuando la estación crezca más allá de la historia que cabe en un solo proceso. Nada en el lab de abajo depende de él.
El repliegue, dicho una vez más para que nadie se sorprenda a mitad del lab: un ejercicio se trabaja completo (el grep de incidente del paso 3). Todo lo demás es una checklist contra código y plataformas de las que ya eres dueño. Presupuesta la mitad de tu tiempo para los pasos 5 al 7; uno de ellos espera un cron a propósito.
Termina los eventos del poller. Emitiste probe_result en la apertura. Quedan tres emits, guiados por la lista de campos que está en la sección de teoría: dos fronteras nuevas y una deuda que m08-l3 pagó por adelantado:
state_change: tu loop de drenaje computa el próximo estado inline, adentro de la llamada a map.insert (state: next_state(prev, ok, count)), así que primero súbelo: let next = next_state(prev, ok, count); arriba del insert, con next en el struct literal. El emit va entre la línea que subiste y el insert, solo si hay diferencia con prev. El fragmento, donde next es el estado que subiste:if next != prev {
log_event(json!({
"event": "state_change",
"target": name,
"from": prev,
"to": next,
"ts": now,
}));
}
Si el compilador objeta que ProbeState no se puede comparar con !=, agrega PartialEq a la lista de derives en el enum del motor, la misma jugada de una palabra que agregar Serialize en m06-l1.
error: el skip con let ... else del loop de drenaje hoy se traga sin dejar rastro la única falla genuina a nivel de estación que ve, una tarea de sonda que dio panic. Cámbialo por un match para que el brazo Err pueda hablar antes de saltarse el resto:let (name, ok, latency_ms) = match joined {
Ok(result) => result,
Err(join_err) => {
log_event(json!({
"event": "error",
"message": join_err.to_string(),
"target": "pollerd",
"ts": SystemTime::now()
.duration_since(UNIX_EPOCH)
.expect("system clock is set before 1970")
.as_secs(),
}));
continue;
}
};
(No hacen falta imports nuevos para ese brazo: SystemTime y UNIX_EPOCH están sentados en la línea use std::time::{...} de este archivo desde el esqueleto de m06-l1.)
error de chain, la frontera que m08-l3 pagó por adelantado: tu chain_loop ya pliega el plano de cada falla adentro de last_error para /status; dales a esas mismas fallas una voz en stdout. En el camino de falla, después de que los dos awaits terminaron y antes de que se tome el lock, emite un evento por cada Err que tengas en la mano. Los nombres de tus variables son tuyos; la forma es un emit por lectura fallida, y la lectura de balance recibe el gemelo de este bloque:if let Err(e) = &slot {
log_event(json!({
"event": "error",
"target": "chain",
"plane": e.plane(),
"message": e.to_string(),
"ts": now,
}));
}
Este es el momento que m08-l3 prometió cuando te hizo escribir plane(): cuatro strings estáticos, ahora nombres grepeables en el stream de logs. Apunta el poller a la URL de RPC irresoluble de esa lección y un tick imprime (tu propio mensaje de las 2 a.m. donde está el mío; el plano adelante es la parte que el enum garantiza):
{"event":"error","message":"could not reach the RPC endpoint: error sending request for url (https://rpc.invalid/)","plane":"transport","target":"chain","ts":1788350402}
Y la diferencia de las 3 a.m. entre "el RPC estaba caído" y "lo estábamos parseando mal" es ahora grep '"plane":"transport"' contra grep '"plane":"shape"': un grep en vez de una tarde, tal como se anunció.
cargo run -p pulse-pollerd y confirma que las líneas de sonda siguen fluyendo. Checkpoint: un tick produce una línea probe_result por target, el primer tick después del arranque produce líneas state_change anunciando targets Pending que despiertan, y una URL de RPC saboteada produce eventos error con su plano puesto.
Reconstruye bajo compose. Desde la raíz del repo: docker compose up --build -d, después prueba el pipeline de punta a punta:
docker compose logs pollerd | grep '"event":"probe_result"' | tail -n 3
Tres líneas JSON de evento, cada una cargando target, outcome y latency_ms. Ese comando es también la barrera de verificación de esta lección, así que hazlo pasar antes de seguir. Fíjate en lo que no construiste: el poller escribe stdout, y el pipeline de logging de Docker hace la recolección, el almacenamiento y la reproducción gratis.
El grep de incidente, trabajado. Monta un incidente real sin tocar una línea de código: córtale el cable al poller. Encuentra tu red y tu contenedor de compose, después desconecta:
docker network ls          # note the <project>_default network name
docker network disconnect <project>_default $(docker compose ps -q pollerd)
Dale dos ticks (65 segundos es cómodo), reconecta con el mismo comando y connect, y dale un tick más para que se recupere. Tus targets acaban de vivir un episodio completo: up, degraded, up. Ahora responde la pregunta de las 3 a.m. con un solo pipeline:
docker compose logs pollerd | grep '"event":"state_change"' | grep '"to":"Degraded"'
Cada hit es un giro, con su timestamp. Lee el ts del último y conviértelo (macOS: date -r <ts>; Linux, la grafía GNU: date -d @<ts>). El grep más su única línea que coincide es un reporte de incidente completo. Después corre tú mismo la pregunta de recuperación, mismo pipeline, "to":"Up", y verifica que la recuperación siguió a la reconexión. Treinta segundos, sin panel, sin ssh. Grep es el motor de consultas entero, que es exactamente el punto de los eventos JSON de una línea.
La misma forma, superficies de TS. Checklist, sin walkthrough:
probe_result por reporte, y un state_change cuando la variante de un target difiere de la pasada anterior (from/to llevan nombres de variante de ProbeResult; la flota no tiene estados de motor). El helper entero es una línea: const logEvent = (e: Record<string, unknown>): void => { console.log(JSON.stringify(e)); };pulse-edge-ts, reemplaza la línea de veredicto de m07-l1 (console.log(`${target.name}: ${entry.verdict}`), prosa, culpable de los cargos) con la forma del evento: event, target, outcome mapeado desde el veredicto de tu entry (up se queda up; cualquier otra cosa mapea a down; el veredicto completo ya vive en el snapshot de KV), latency_ms si tu entry midió una, y ts: Math.floor(Date.now() / 1000) para que coincida con los segundos del poller.npx wrangler tail, fuerza el cron una vez en local o espera a que pase el cuarto de hora, y confirma que los eventos llegan como JSON, no como prosa.logEvent diciéndolo, para el tú del futuro tentado a agregar una línea de debug adentro de un loop.Primero reconstruye, o el Checkpoint falla sin causa declarada: fleet-runner todavía corre la imagen del paso 2. docker compose up --build -d fleet-runner, después un tick. Checkpoint: docker compose logs fleet-runner | grep '"event":"probe_result"' ENCUENTRA líneas de evento que coinciden (que haya coincidencias es la condición de aprobación acá, la imagen espejo del grep de secretos más adelante, donde lo es el silencio), y wrangler tail muestra la misma forma desde el edge.
Prende la alarma. GitHub, Notification settings, System, Actions: define la entrega (On GitHub, Email, o los dos) y marca Only notify for failed workflows. Dos notas al pie de la sección de teoría van en tu cabeza mientras haces clic: este canal venía por defecto en "Don't notify" hasta hace un momento, y las notificaciones de ejecuciones programadas se atan al creador del workflow, hoy tú; anótalo en la tabla para cualquier repo compartido futuro.
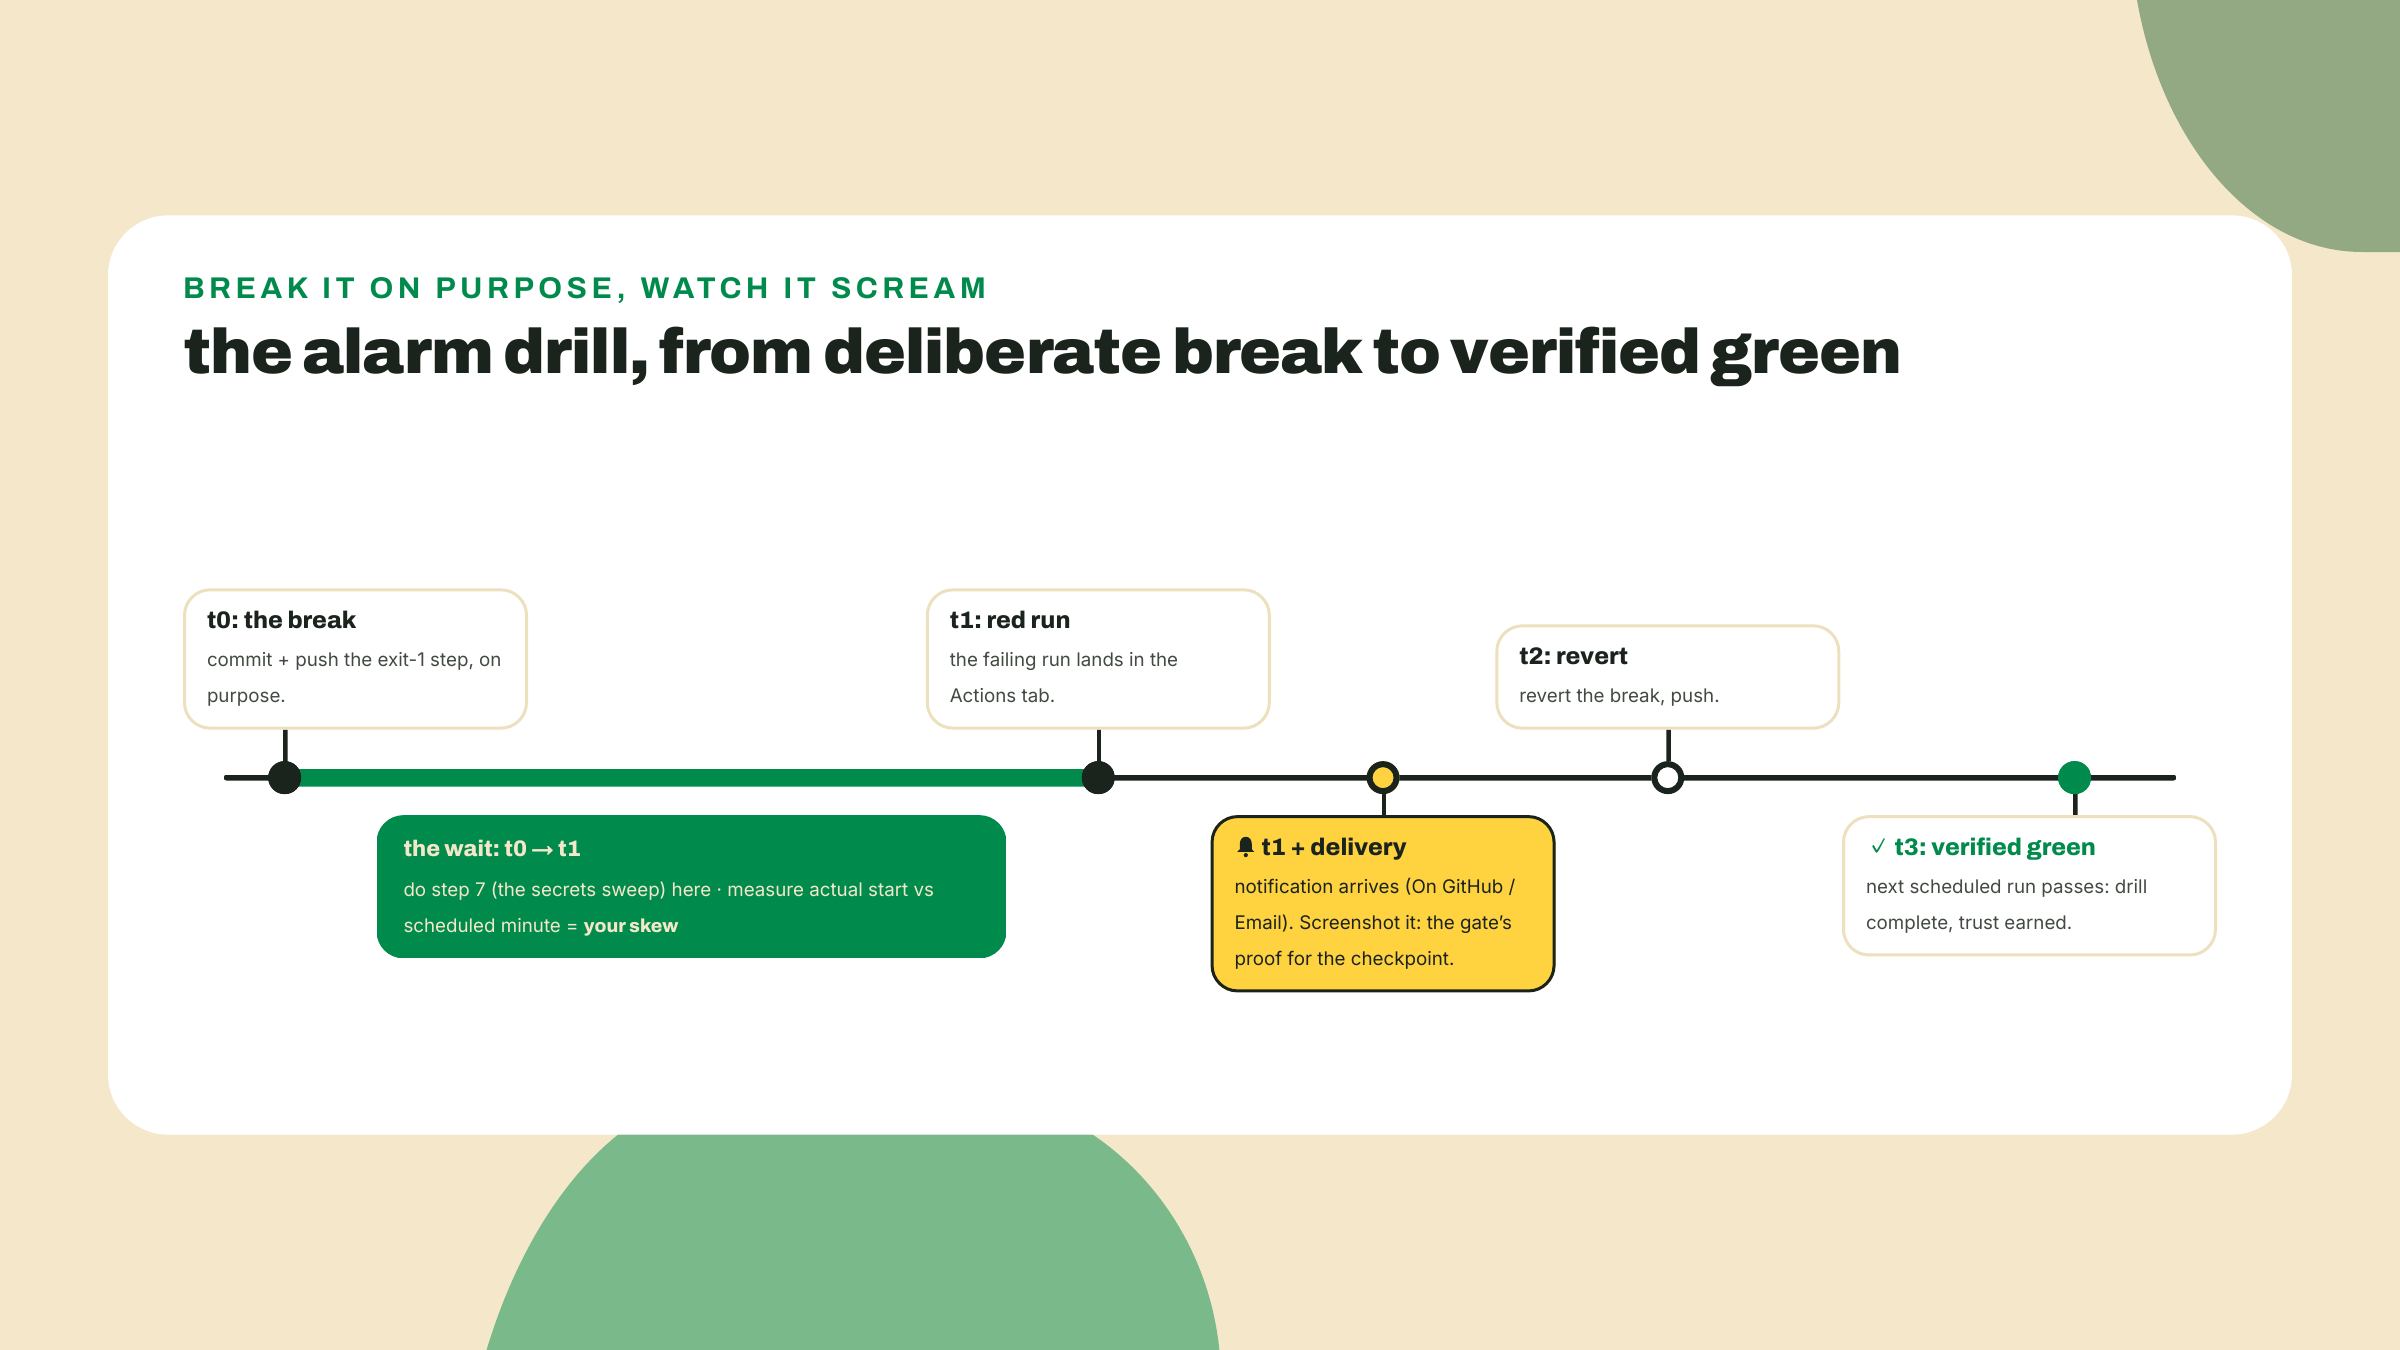
El ejercicio de alarma. Una alarma que nunca escuchaste es una hipótesis. Rompe el cron a propósito: agrega un step con run: exit 1 arriba de todo en el job del workflow de la estación, haz commit, push. Después deja que la dispare el calendario, no tu push, porque el camino programado es aquel para el que existe la alarma. Espera un señuelo primero: tu workflow también se dispara con push, así que el commit del exit-1 en sí produce una ejecución roja inmediata y, con las notificaciones recién prendidas, seguramente un email en minutos. Esa NO es la prueba; la evidencia de la barrera es la falla programada, y la columna de evento de la pestaña Actions (schedule contra push) es como las distingues. Mientras esperas, haz el paso 7. Cuando aterrice la ejecución roja, tres cosas para juntar: la notificación misma (pantalla o email, esta es la prueba de la barrera), el log de la ejecución en la pestaña Actions mostrando tu falla deliberada, y una medición. Compara la hora real de arranque de la ejecución contra el minuto programado del cron, para las últimas ejecuciones ya que estás ahí, y escribe el desfase en un comentario en el archivo del workflow. Ese número es tuyo, medido. Después revierte el commit que rompió, y mira cómo la próxima ejecución se pone en verde. Rota, escuchada, arreglada, verificada: ese ciclo es el ejercicio, y solo confías en las alarmas que escuchaste.
El barrido de secretos. Crea SECRETS.md en el repo de la estación (o una sección de tu runbook, m10-l1 lo va a absorber de todas formas) y completa esta tabla para tu estación de verdad, una fila honesta por plataforma:
| Plataforma | Config commiteada | Dev local | Secretos de producción | Notas de operación |
|---|---|---|---|---|
| GitHub Actions | el YAML del workflow, sin valores | n/a, corre remoto | secretos de repo, inyectados vía env: | las notificaciones se atan al creador del workflow; desactivar y después reactivar las reasigna; los calendarios de repos públicos se auto-desactivan después de 60 días inactivos |
| Vercel | vercel.json | vercel env pull hacia un .env.local que está en el gitignore | env vars por entorno, panel o CLI | tamaño total de las env vars, nombres y valores, con techo de 64KB; los valores con prefijo VITE_ quedan horneados en el bundle público por diseño |
| Cloudflare | config de wrangler, vars solo para config pública | .dev.vars, en el gitignore | npx wrangler secret put <KEY> | solo escritura después de fijarlo; visible como nombre, nunca como valor |
| Docker / local | compose.yaml, Dockerfile, sin secretos en ENV | --env-file / env_file de compose, node --env-file para Node pelado | acá no es plataforma de prod; las imágenes se quedan sin secretos | docker history imprime cada capa de la imagen, incluido cualquier ENV que hayas horneado |
Después verifica mecánicamente la afirmación central de la tabla: git grep -i de los nombres y valores reales de tus secretos encuentra solo nombres de binding, nunca un valor, en el repo, en la config de wrangler y en cada Dockerfile. Contrasta la regla anti-fuga de la teoría: revisa por encima tus tres call sites de logEvent/log_event y confirma que ninguna llamada serializa un entorno, un objeto de config, ni el contexto completo de un error capturado.
Haz commit de la capa de ops. Nada de lo de arriba hizo commit solo, y m10-l1 asume que este estado está en el repo:
git add -A
git commit -m "ops layer: structured events, alarm drill, secrets sweep"
git push
Todo tuyo. Elige una pregunta de incidente que tus eventos actuales no puedan responder. El ejemplo trabajado del género: "¿cuánto duró el último episodio degradado?", que hoy requiere mirar a ojo dos greps y hacer aritmética de timestamps a mano. Elige tu pregunta, después agrega el único evento o campo que la vuelve respondible con un solo grep (para el ejemplo: un campo recovered en el giro a up que lleve los segundos desde el degradado, o un evento episode dedicado en la recuperación). Vuelve a montar el incidente de desconexión de red y demuestra el grep respondiendo tu pregunta en una línea. Aceptación: el campo o evento nuevo aparece en el emit de exactamente una frontera, el schema se queda sin secretos, y el pipeline que responde es un solo comando que pegas en SECRETS.md bajo un encabezado nuevo ## Incident queries, la primera entrada de una lista que va a crecer (el runbook de m10-l1 absorbe el archivo entero; vuelve a hacer commit después de pegarlo).
La barrera, tres pruebas, que corresponden a las tres promesas de la lección. Uno: el grep de incidente, docker compose logs pollerd pasado por un filtro de state_change, responde "cuándo fue la última vez que el target X pasó a degraded" con una línea JSON que coincide. Dos: el ejercicio de alarma produjo una notificación real desde una ejecución programada que falló a propósito, y la ejecución después del arreglo está verde. Tres: SECRETS.md cubre las cuatro plataformas y el repo grepea limpio de valores de secretos. Si las tres se sostienen, la estación está observada, alarmada e higiénica.
La recuperación de 30 segundos antes de que cierres la pestaña: ¿de qué tres formas puede detenerse el cron sin ninguna notificación de falla, y dónde vive la defensa de la estación contra la muerte silenciosa? Estás buscando: descartada bajo carga, auto-desactivación a los 60 días, forks apagados por defecto; y el latido persistido, los timestamps de status.json, donde la ausencia es visible para cualquier cosa que mire.
Si la superficie de logs de una plataforma se comportó distinto de lo que afirmó esta lección (las ventanas de retención y las asignaciones son los hechos más cambiantes de este curso, y los vendors los mueven sin ceremonia), manda la plataforma y lo que viste por el feedback del curso; los cuadros de restricciones de arriba se vuelven a sondear exactamente desde esos reportes.
Cada peldaño de la escalera ya está construido: la estación está auditada, observada y alarmada. Una cosa nunca pasó. Todo eso, armado y verificado de punta a punta, como un solo sistema, de memoria. Ese es el capstone, y abre contigo dibujando la estación entera, cada componente y cada arista, en una página en blanco antes de que cablees el panel final. Trae una página en blanco.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.