Carregando...

 BetaBeta
Na lição passada você apontou o read-any-asset.ts para tudo o que a Overgrowth possui e ele voltou com a prateleira inteira: o mint do SPROUT, os ativos do Almanac e um cNFT de Harvest-crate que não tem conta nenhuma em lugar nenhum on-chain. Essa leitura teve que passar por um RPC de DAS, porque não havia nada para getAccountInfo. Você já pagou o imposto de leitura da compressão uma vez, sabendo o que fazia.
O que prepara o pensamento que eu quero matar hoje. Se um milhão de NFTs cabe em uma árvore por trocados, por que não colocar os saldos de SPROUT em uma árvore também? Por que alguém ainda trava quase dois milhões de lamports de rent por conta de token?
A resposta é aritmética, e você pode rodá-la antes de ler mais um parágrafo. Os dois fatores de cara mágica são uma contagem de bytes e uma taxa de rent: uma conta de token clássica tem 293 bytes (165 de dados mais o cabeçalho de conta de 128 bytes), e a mainnet precificava um byte em 6,333 lamports quando eu li em 2026-09-06:
node -e "console.log('break-even:', Math.floor((293 * 6_333 - 5_000) / 5_300), 'lifetime writes')"
break-even: 349 lifetime writes. Dois nomes antes da aritmética, já que os dois são novos: a Light Protocol é o time por trás da compressão ZK, o segundo trilho de compressão que esta lição apresenta (contas provadas em vez de armazenadas, a prima fungível do truque do Bubblegum), e a geração atual do programa dela se chama V2, o V2 da própria Light, nada a ver com o Bubblegum v2. O número compara uma conta de token comprimida nesse trilho (5,000 lamports para criar, cerca de 5,300 lamports de custo de estado por transferência) contra uma conta de token SPL clássica: 293 × 6,333 = 1,855,569 lamports de rent naquela taxa datada da mainnet, e nada por transferência. A taxa é a metade viva do produto. A SIMD-0437 está descendo a taxa em etapas e os clusters não estão em sincronia — a devnet já lia 5,080 no mesmo dia, o que coloca o mesmo break-even em 279 — então o rent é algo que você re-deriva no seu cluster, nunca uma constante que você cita. Escreva essa conta 349 vezes e a compressão já gastou tudo o que a conta clássica apenas travou. Escreva 4,000 vezes e você queimou mais de onze vezes o rent que estava tentando evitar.
Essa é a lição inteira em uma linha, e o resto dela é por que a linha é verdadeira, de onde ela vem e o que a segunda metade do custo (compute, não lamports) faz com o quadro. Esta é uma lição de raciocínio, não uma lição de construção. Você não vai comprimir um token hoje; você vai decidir se deve.
O recuo da ajuda, dito sem rodeios: o modelo de custo e os três primeiros veredictos de carga de trabalho são trabalhados por completo, as duas regras desqualificadoras você escreve sozinho, e a quarta carga de trabalho mais o texto final são inteiramente solo. O que você leva é uma ferramenta pequena, o compression-verdict.ts, e uma resposta defensável para uma pergunta que um colega vai te fazer de verdade.
O módulo 7 foi um longo argumento de que guardar estado por ativo em contas é uma escolha, não uma lei. O Bubblegum v2 provou isso para NFTs: um milhão de Harvest crates, uma árvore, uma raiz on-chain, e as próprias crates vivendo como folhas com hash que um indexador reconstrói sob demanda. O colapso de custo ali é real e você mediu.
Então a pergunta natural, a que um leitor atento faz no instante em que o mint do cNFT dá certo, é por que o truque tem formato de NFT. Nada em "faça hash do estado, guarde a raiz, prove o pertencimento quando precisar escrever" se importa se o estado são os metadados de um NFT ou um saldo de token ou um PDA arbitrário. Se o truque generaliza, o modelo de contas inteiro é negociável.
Ele generaliza, sim. É isso que a compressão ZK é. Mas ele generaliza por um mecanismo diferente do que você acabou de usar, e a diferença de mecanismo é exatamente onde a economia vira.
Comece pela prova, porque todo o resto sai dela.
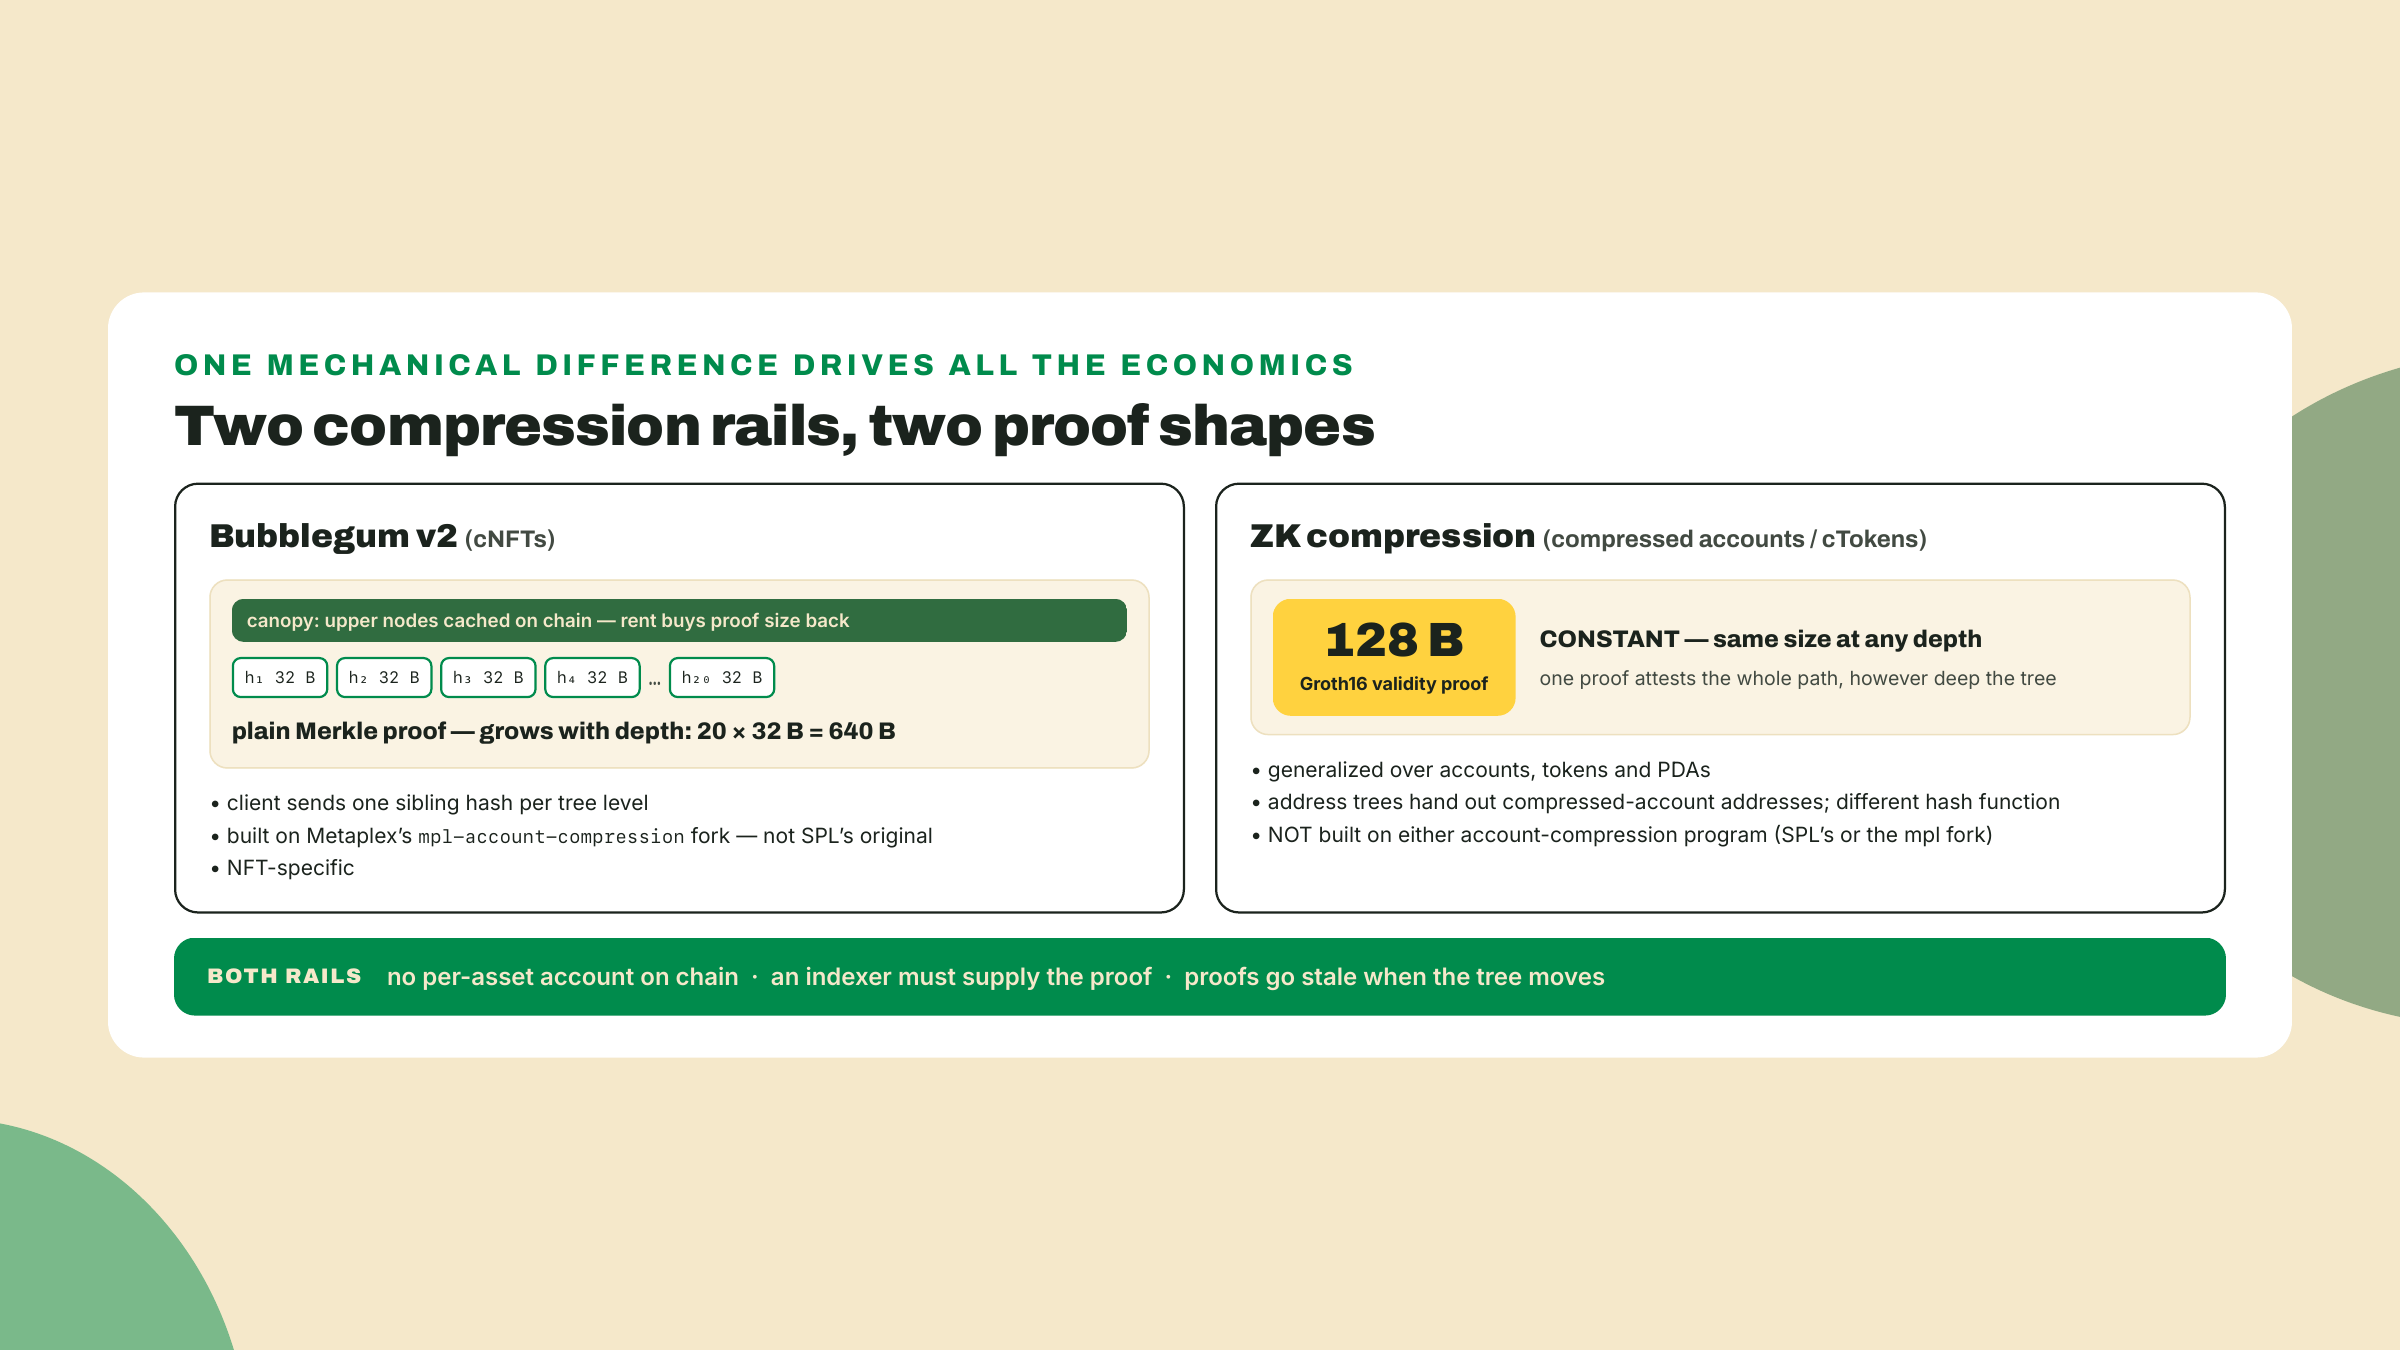
Uma escrita de cNFT no Bubblegum é uma prova de Merkle simples. Para transferir uma folha você entrega ao programa os hashes irmãos ao longo do caminho da sua folha até a raiz, e o programa refaz os hashes subindo e verifica se chegou na raiz que ele já guarda. O tamanho da prova é a profundidade da árvore. Profundidade 20, para escolher um tamanho comum, significa 20 hashes irmãos de 32 bytes cada, ou seja, 640 bytes de prova pegando carona na sua transação antes de qualquer outra coisa. É por isso que o canopy existe: guardar em cache os níveis de cima da árvore on-chain, e o cliente só manda a parte de baixo do caminho. Você compra provas de cliente mais curtas com rent, nível por nível.
A compressão ZK não manda o caminho. Ela manda uma prova de validade: uma prova Groth16, 128 bytes, que afirma que o estado que você alega está na árvore, sem caminhar por nada. Constante. Uma árvore rasa e uma árvore profunda produzem os mesmos 128 bytes, porque uma prova sucinta é uma declaração sobre uma computação, não uma transcrição dela.
Compare com papelada. A prova de Merkle é a cadeia inteira de recibos, e um histórico mais longo significa uma pasta mais grossa. A prova de validade é uma declaração reconhecida em cartório de que a pasta confere, e o carimbo do cartório tem o mesmo tamanho para uma pasta de dez páginas ou de dez mil. Onde a analogia quebra, e isso importa: o cartório aqui é um prover, off-chain, e alguém tem que rodá-lo e te entregar o carimbo a cada transação. Tamanho constante não é a mesma coisa que de graça.
Agora a definição, bem na hora.
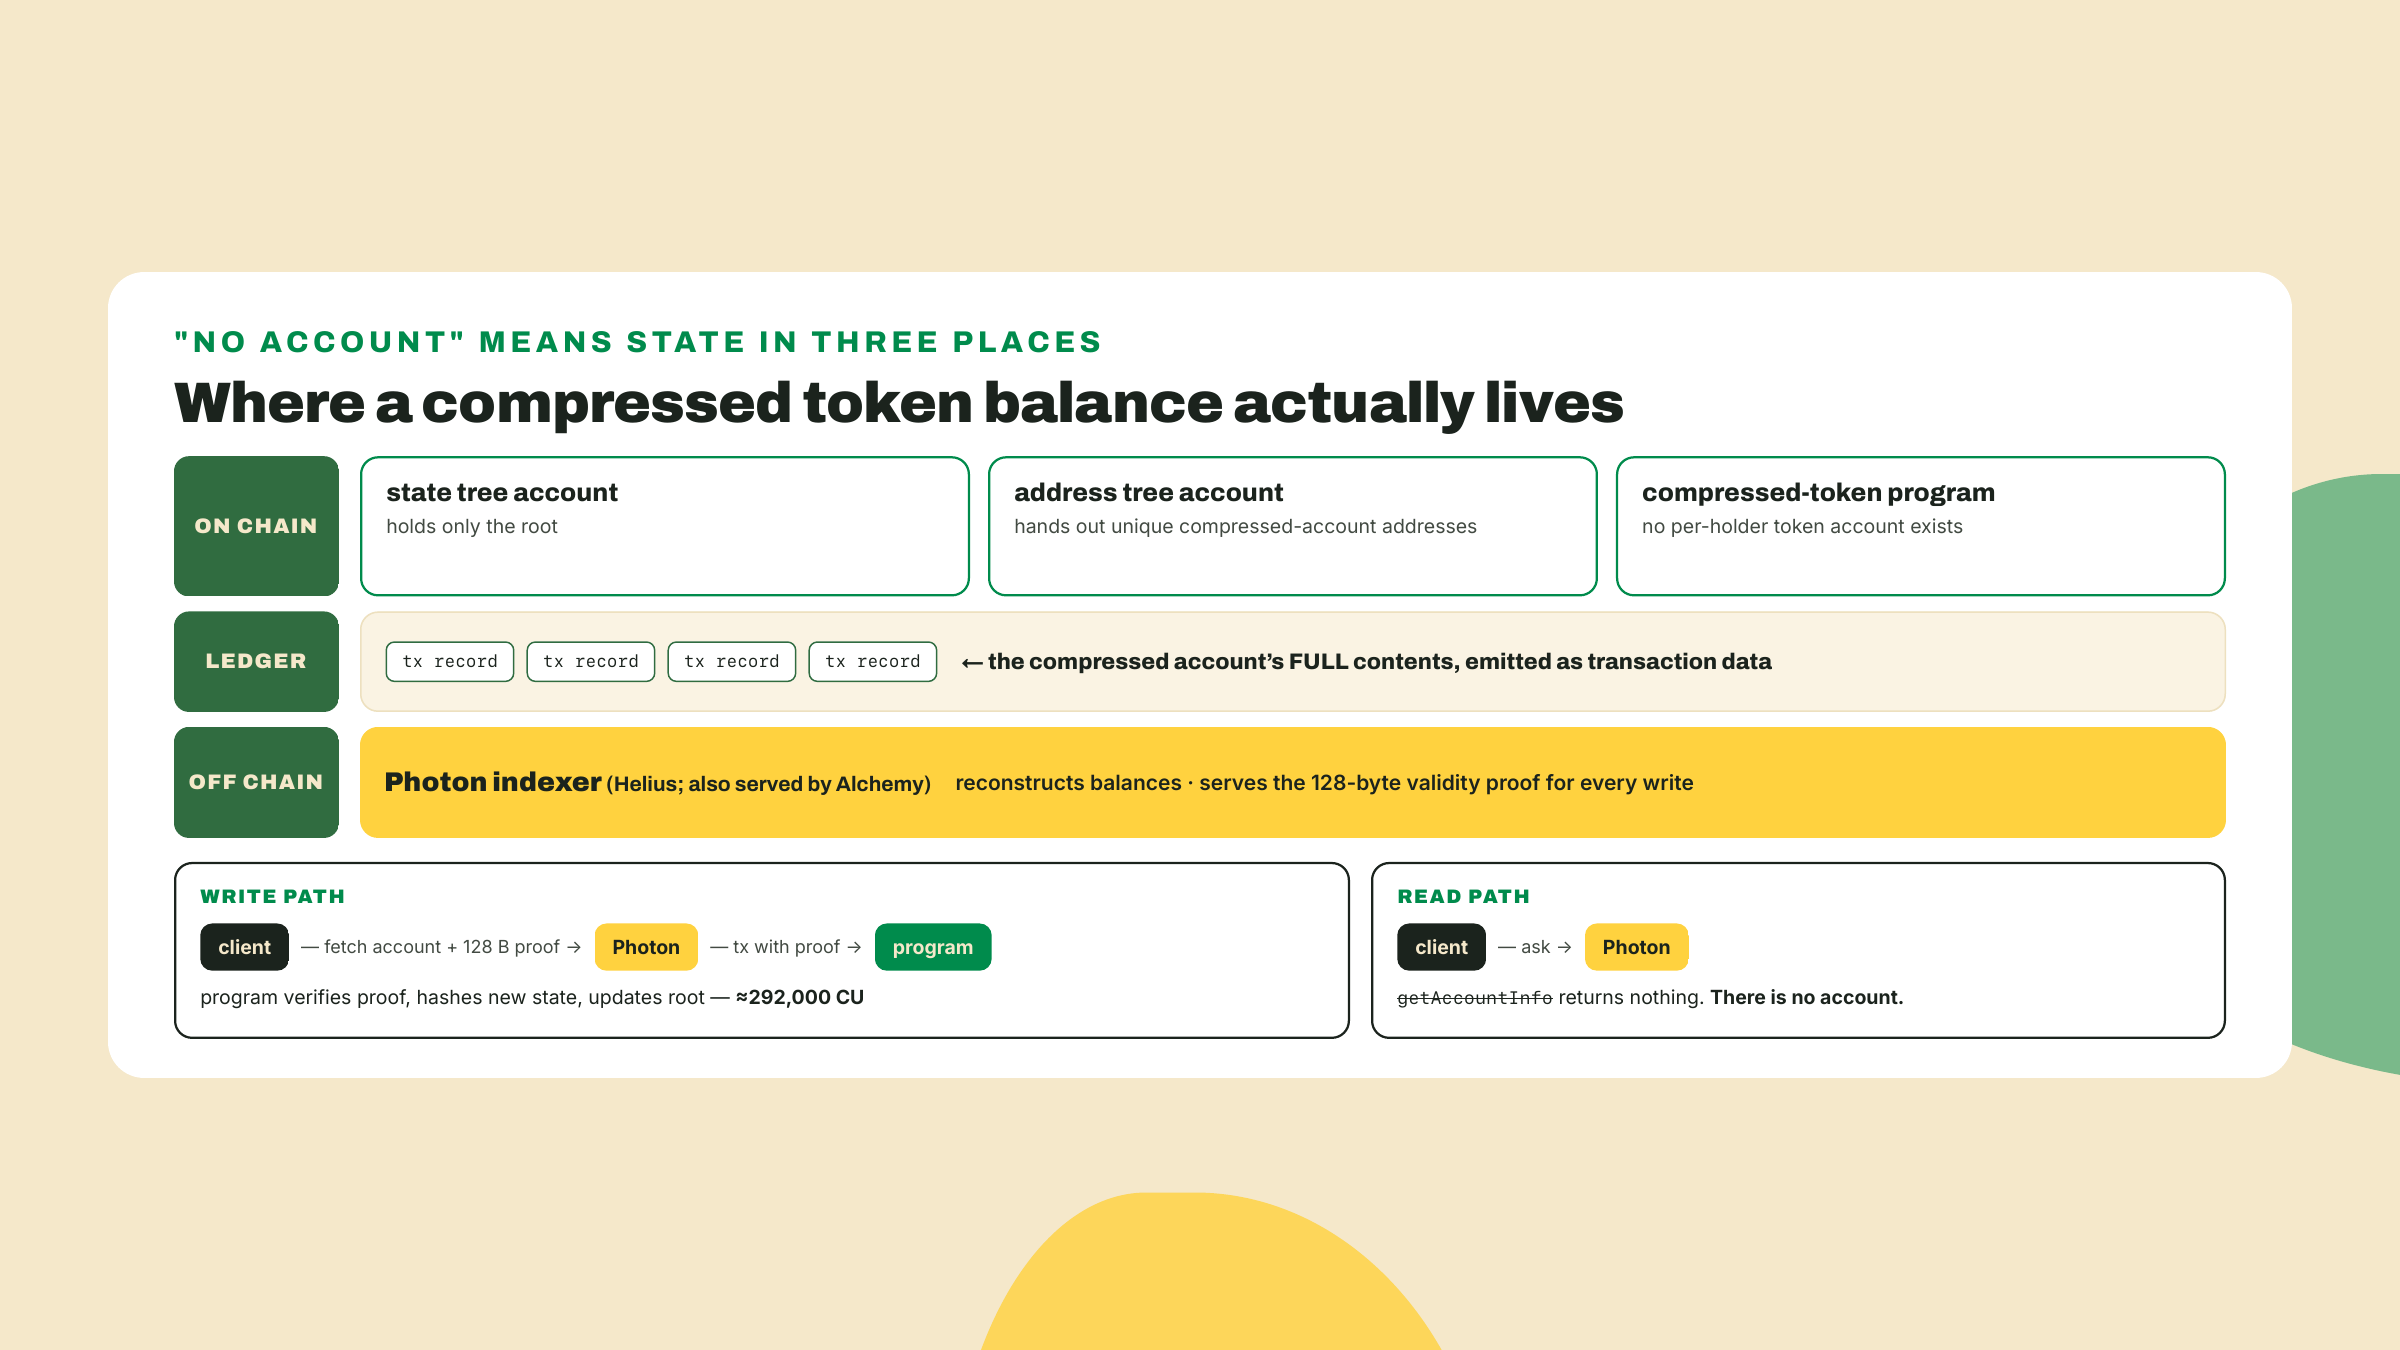
Uma conta comprimida guarda as mesmas coisas que uma conta normal da Solana guarda: um programa dono, um saldo em lamports, um blob de dados, um endereço. O que ela não tem é um lugar no banco de dados de contas do validador. O hash dela vive como uma folha em uma árvore de estado, a raiz da árvore vive em uma conta on-chain, e o conteúdo de fato da conta vive no ledger, reconstruído por um indexador. Os endereços vêm de árvores de endereços, que existem para que uma conta comprimida possa ter um endereço estável, único e derivável em vez de ser identificada só pela posição dela em uma árvore.
Um cToken é essa maquinaria aplicada a um saldo de token: uma conta comprimida cujos dados são um layout de conta de token, de propriedade do programa de tokens comprimidos.
A parte que as pessoas pulam, e a parte que faz dos dois trilhos sistemas genuinamente diferentes em vez de duas configurações de um sistema só: a compressão ZK não é construída sobre account compression em nenhum dos dois sabores, nem a original da SPL nem o fork mpl em que o Bubblegum v2 roda. Programa diferente, maquinaria de árvore diferente, função de hash diferente da que as árvores do Bubblegum usam. Conhecer o Bubblegum não quer dizer que você conhece isto. Quer dizer que você tem a intuição e nenhuma das interfaces.
Dois números vendem a compressão e um número deveria te parar.
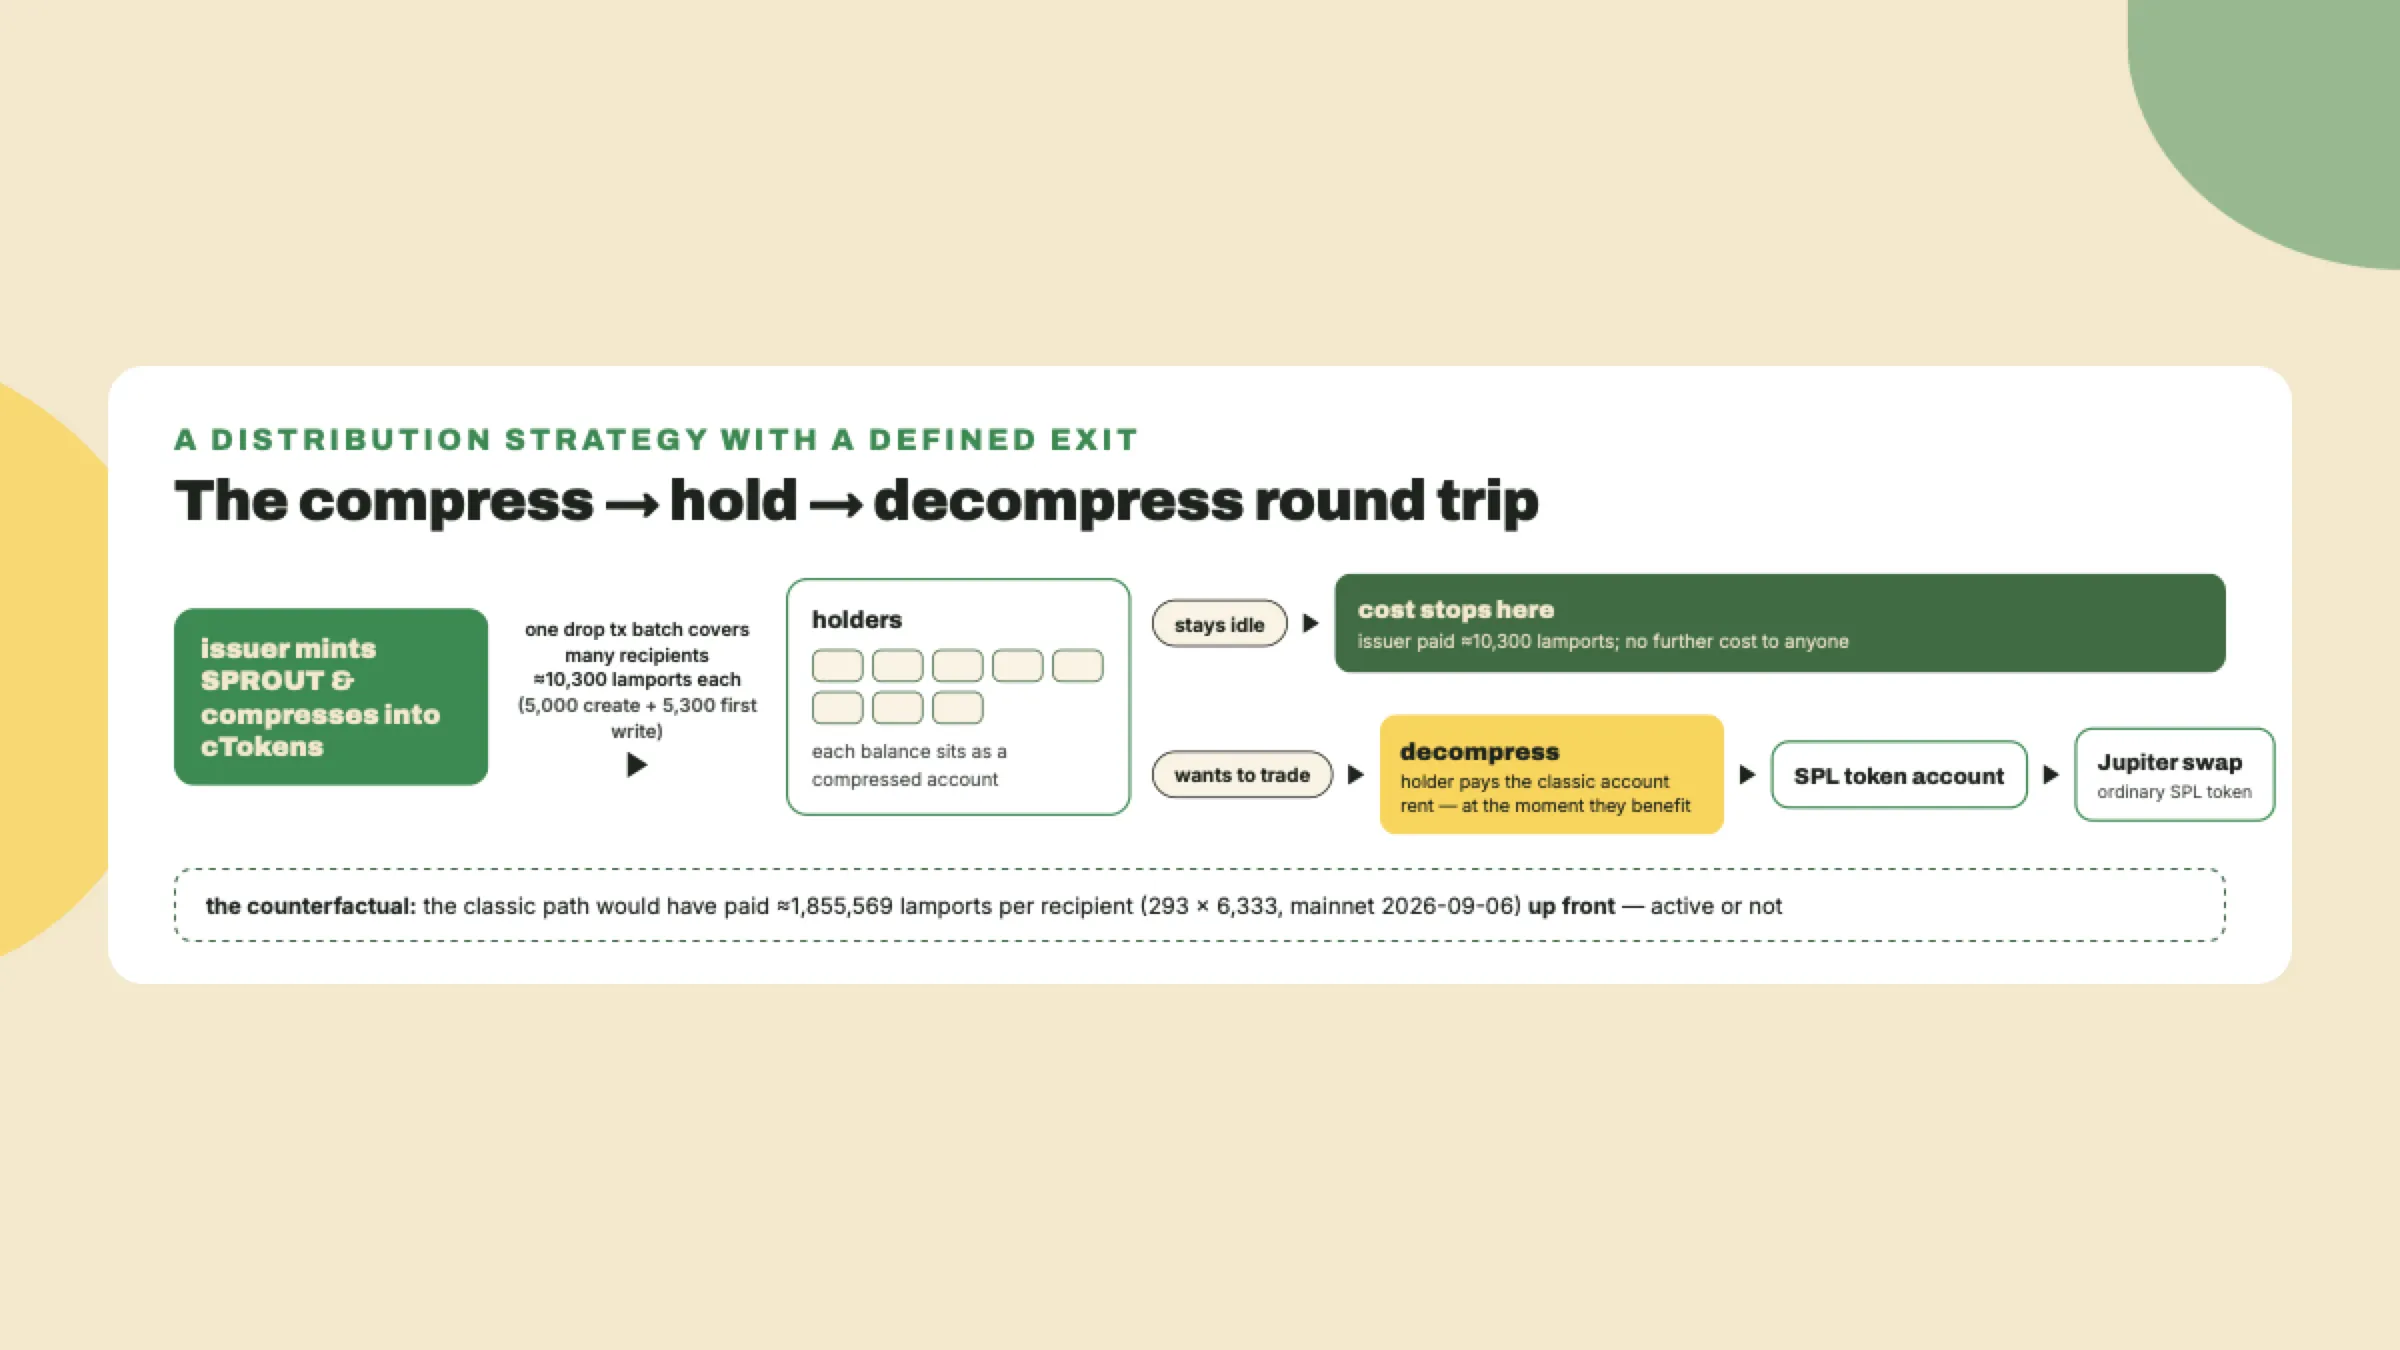
Criar uma conta de token comprimida custa cerca de 5,000 lamports. Criar uma conta de token SPL clássica trava 1,855,569 lamports de rent — os 293 bytes × 6,333 lamports/byte do resumo, mainnet, 2026-09-06. Essa proporção, mais ou menos 370x naquela taxa, é o motivo inteiro pelo qual alguém faz airdrop com compressão, e a lição de drop do módulo 8 transforma isso em uma tabela por destinatário que você vai usar de verdade para orçar, junto com a sonda de uma linha (solana rent 165 --url <cluster>) que relê a taxa no dia em que você orçar.
Aí o terceiro número. Uma transferência de token comprimido consome cerca de 292,000 CU. Verificar a prova e fazer hash da árvore não é de graça, e você paga isso por escrita. Coloque isso ao lado da transferência clássica que você conheceu na m01-l3, onde o motor p-token levou a instrução Transfer a 76 CU. Mesma ação visível para o usuário, cerca de 3,800 vezes o compute.
Discrimine o custo, por conta, ao longo de uma vida de W escritas:
| Caminho | Criação | Por escrita (lamports) | Por escrita (CU) |
|---|---|---|---|
| Conta de token SPL clássica | 1,855,569 de rent (293 × 6,333, mainnet 2026-09-06; um depósito reembolsável) | 0 | 76 |
| Conta de token comprimida | ~5,000 | ~5,300 (custo de estado da V2) | ~292,000 |
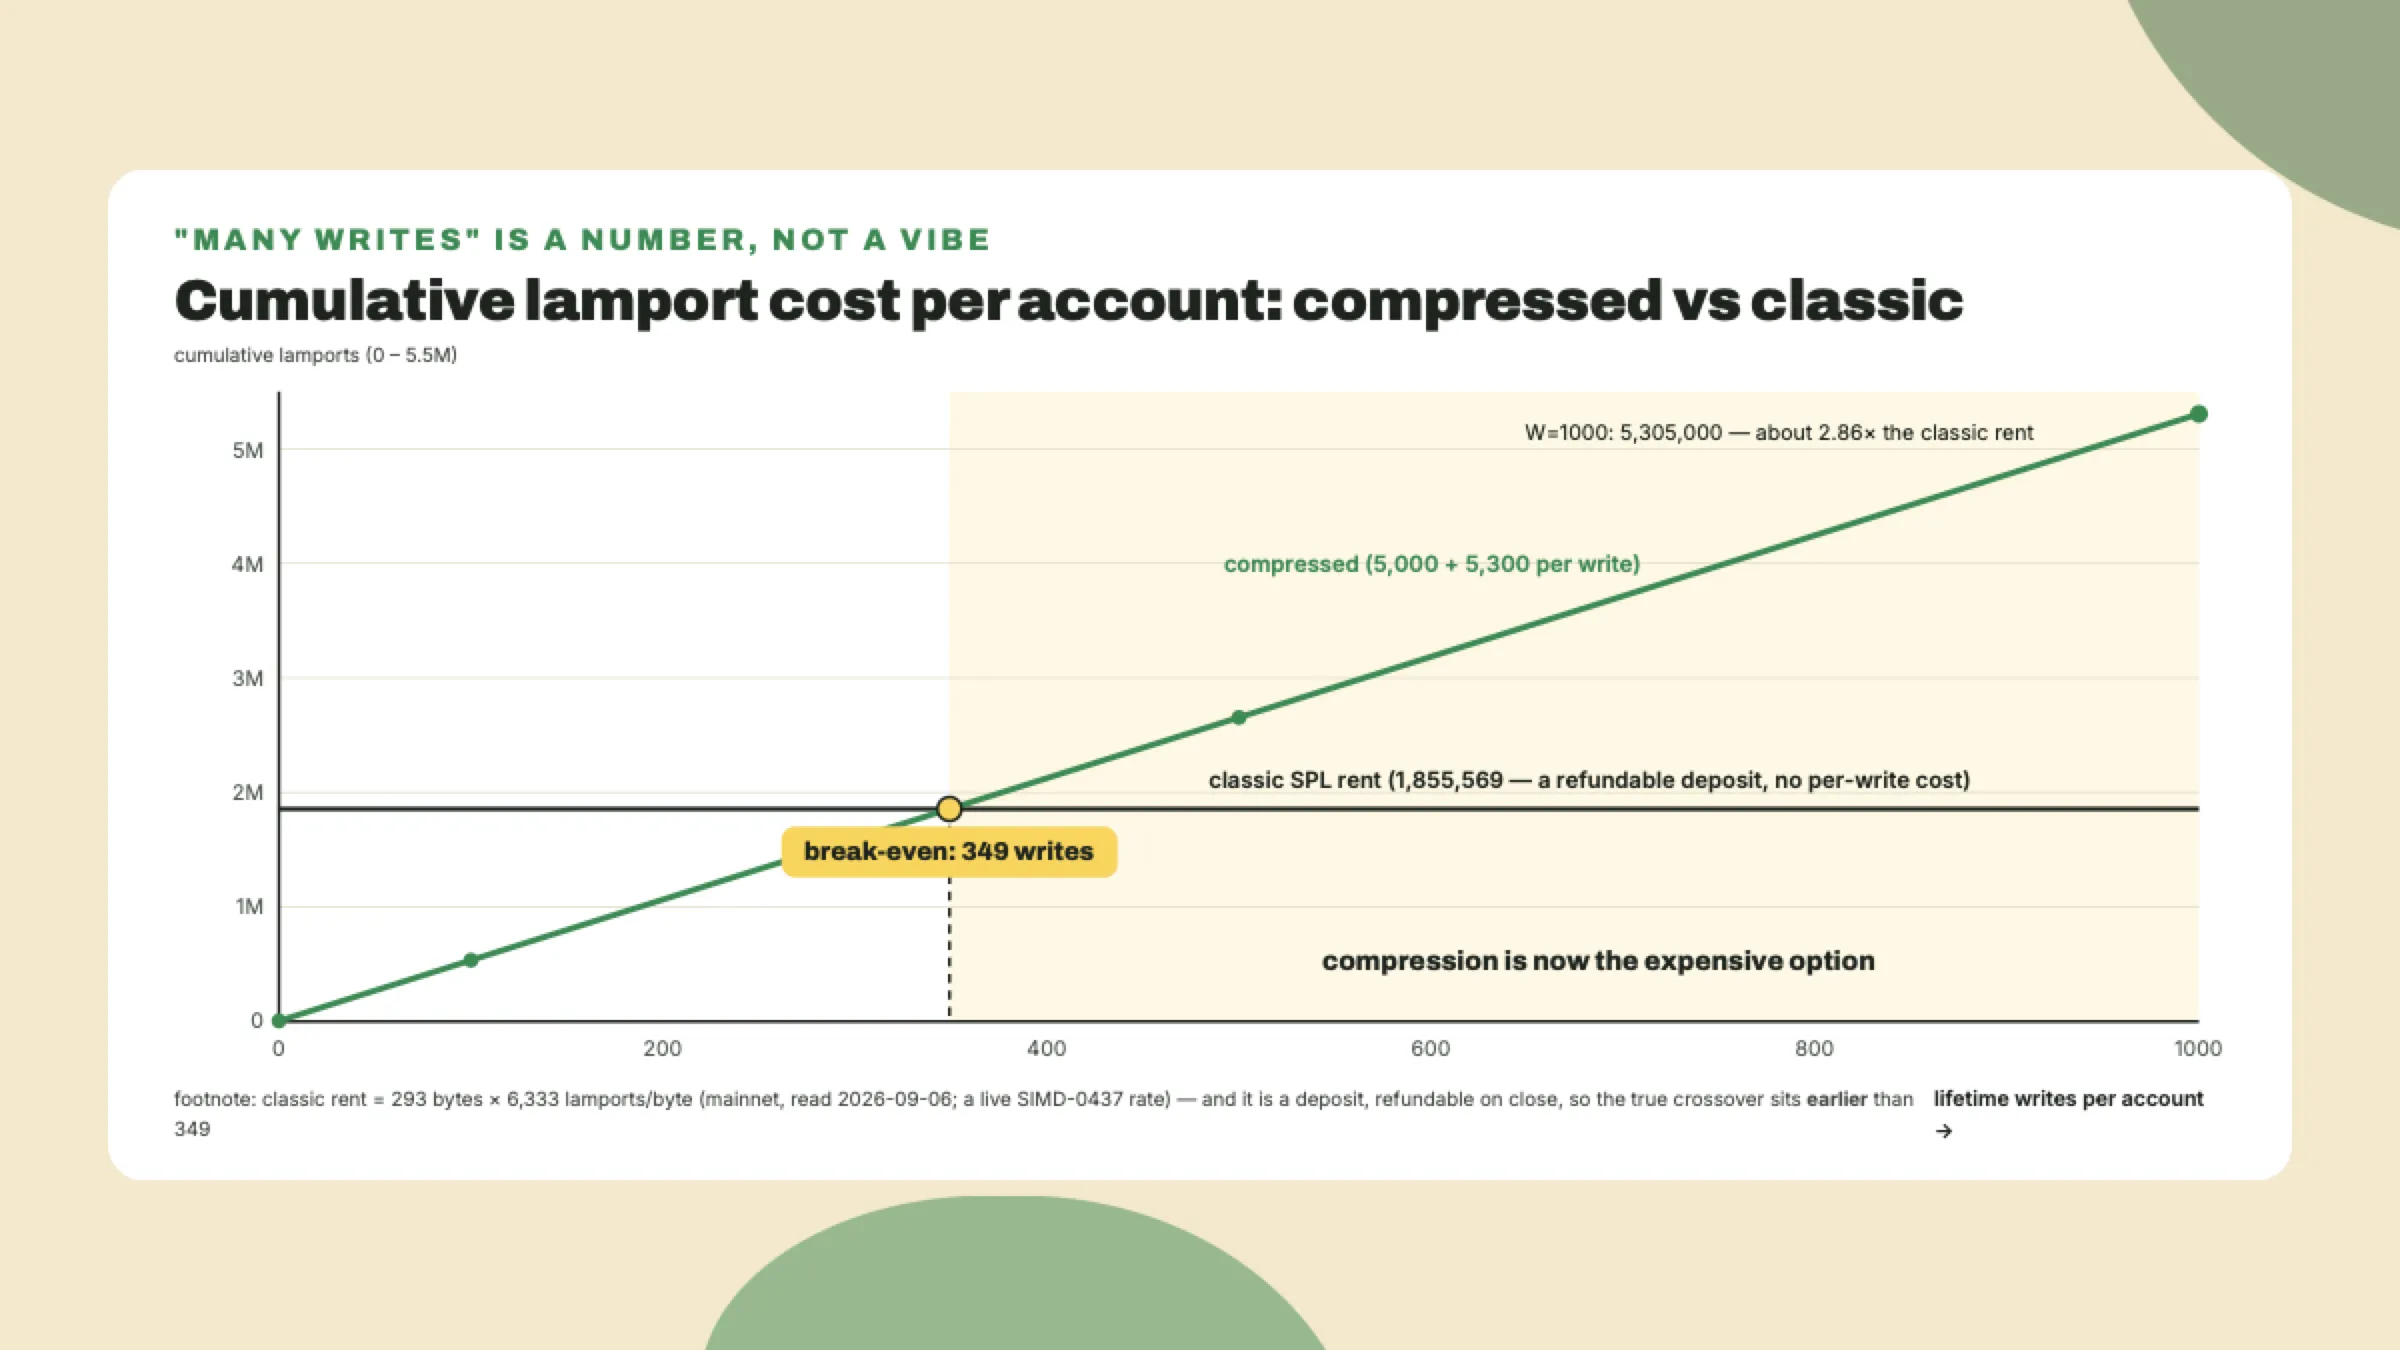
Iguale as duas colunas de lamports e você chega no número que o comando de uma linha imprimiu: 5,000 + 5,300W cruza 1,855,569 em W = 349. Abaixo de 349 escritas ao longo da vida, a compressão é mais barata em lamports. Acima disso, a compressão é mais cara, e a distância só aumenta dali em diante, porque um lado tem um termo por escrita e o outro não. E como o lado clássico é uma contagem de bytes vezes uma taxa viva, o cruzamento se move quando a taxa desce um degrau: os 5,080 da devnet o colocam em 279 hoje, e o próximo passo da SIMD-0437 move os dois. O break-even é uma saída do modelo, nunca uma constante dele.
Existe uma versão mais afiada desse argumento. Os 1,855,569 lamports da conta clássica são rent, e rent é um depósito: feche a conta e você recebe de volta. Os 5,300 lamports por escrita da conta comprimida são gastos. Então o break-even honesto é mais cedo que 349, e o motivo para ainda citar 349 é que a maioria das pessoas nunca fecha as contas de token e por isso nunca sente o reembolso. A orientação que você vai ver citada no ecossistema é de mais ou menos mil escritas ao longo da vida como a linha onde a compressão para de compensar. Nossa aritmética cruza bem antes disso. Trate mil como um teto generoso, não como um alvo.
Com o custo na mesa, percorra as posições óbvias e veja cada uma falhar.
"Comprima tudo." Falha só na coluna de CU. Qualquer conta escrita mais do que algumas centenas de vezes paga mais lamports e cerca de 3,800 vezes o compute, para sempre. Também falha em uma restrição que a tabela não mostra: toda escrita precisa de uma prova fresca de um indexador, então você converteu uma transação capaz de rodar offline e autocontida em uma com dependência viva de terceiros no caminho de construção dela.
"Não comprima nada, rent é barato." Falha em escala. 1,855,569 lamports não é nada para uma conta e são cerca de 186 SOL para cem mil delas. Um drop que custa 186 SOL clássico custa cerca de 1.03 SOL comprimido, e essa é a diferença entre entregar uma distribuição e cancelá-la.
"É só usar o Bubblegum para os tokens também." Tentador depois do módulo passado, e não funciona, por um motivo que vale enunciar com precisão em vez de acenar para ele. As árvores do Bubblegum têm formato de NFT: uma folha é um ativo com um dono, e as instruções do programa são mint, transfer, burn, delegate. Um saldo de token não é um ativo, é um número que recebe somas e subtrações, e não existe esquema de folha naquele programa para "aumente isto em 40". Você estaria reconstruindo o programa de tokens comprimidos dentro de um programa de NFTs comprimidos. Que é mais ou menos o que a compressão ZK é, só que feito direito e generalizado para qualquer conta, não só saldos de token.
"Comprima e depois descomprima sempre que ficar quente." Essa é a mais próxima de certa, o que a torna a perigosa. A descompressão é real e tem suporte, e você vai usá-la. Ela falha como política geral porque você não consegue prever quais contas ficam quentes, e as contas que ficam quentes costumam ser quentes desde o começo: a pool, a tesouraria, o livro-razão compartilhado do jogo. Uma política que exige que você acerte o palpite da frequência futura de escrita por conta não é uma política.
O que estreita a pergunta de um jeito útil. Não "a compressão é boa" e sim: para esta conta específica, ao longo da vida esperada dela, quantas vezes ela vai ser escrita, e qual o tamanho de cada acesso? Essas duas variáveis decidem, e nenhuma delas é "quantos holders você tem". A contagem de holders é o que as pessoas procuram, e é o eixo completamente errado. Uma árvore escala para holders numa boa. O que mata você é escrita por holder.
A partir dessas duas variáveis, três formatos concretos de falha:
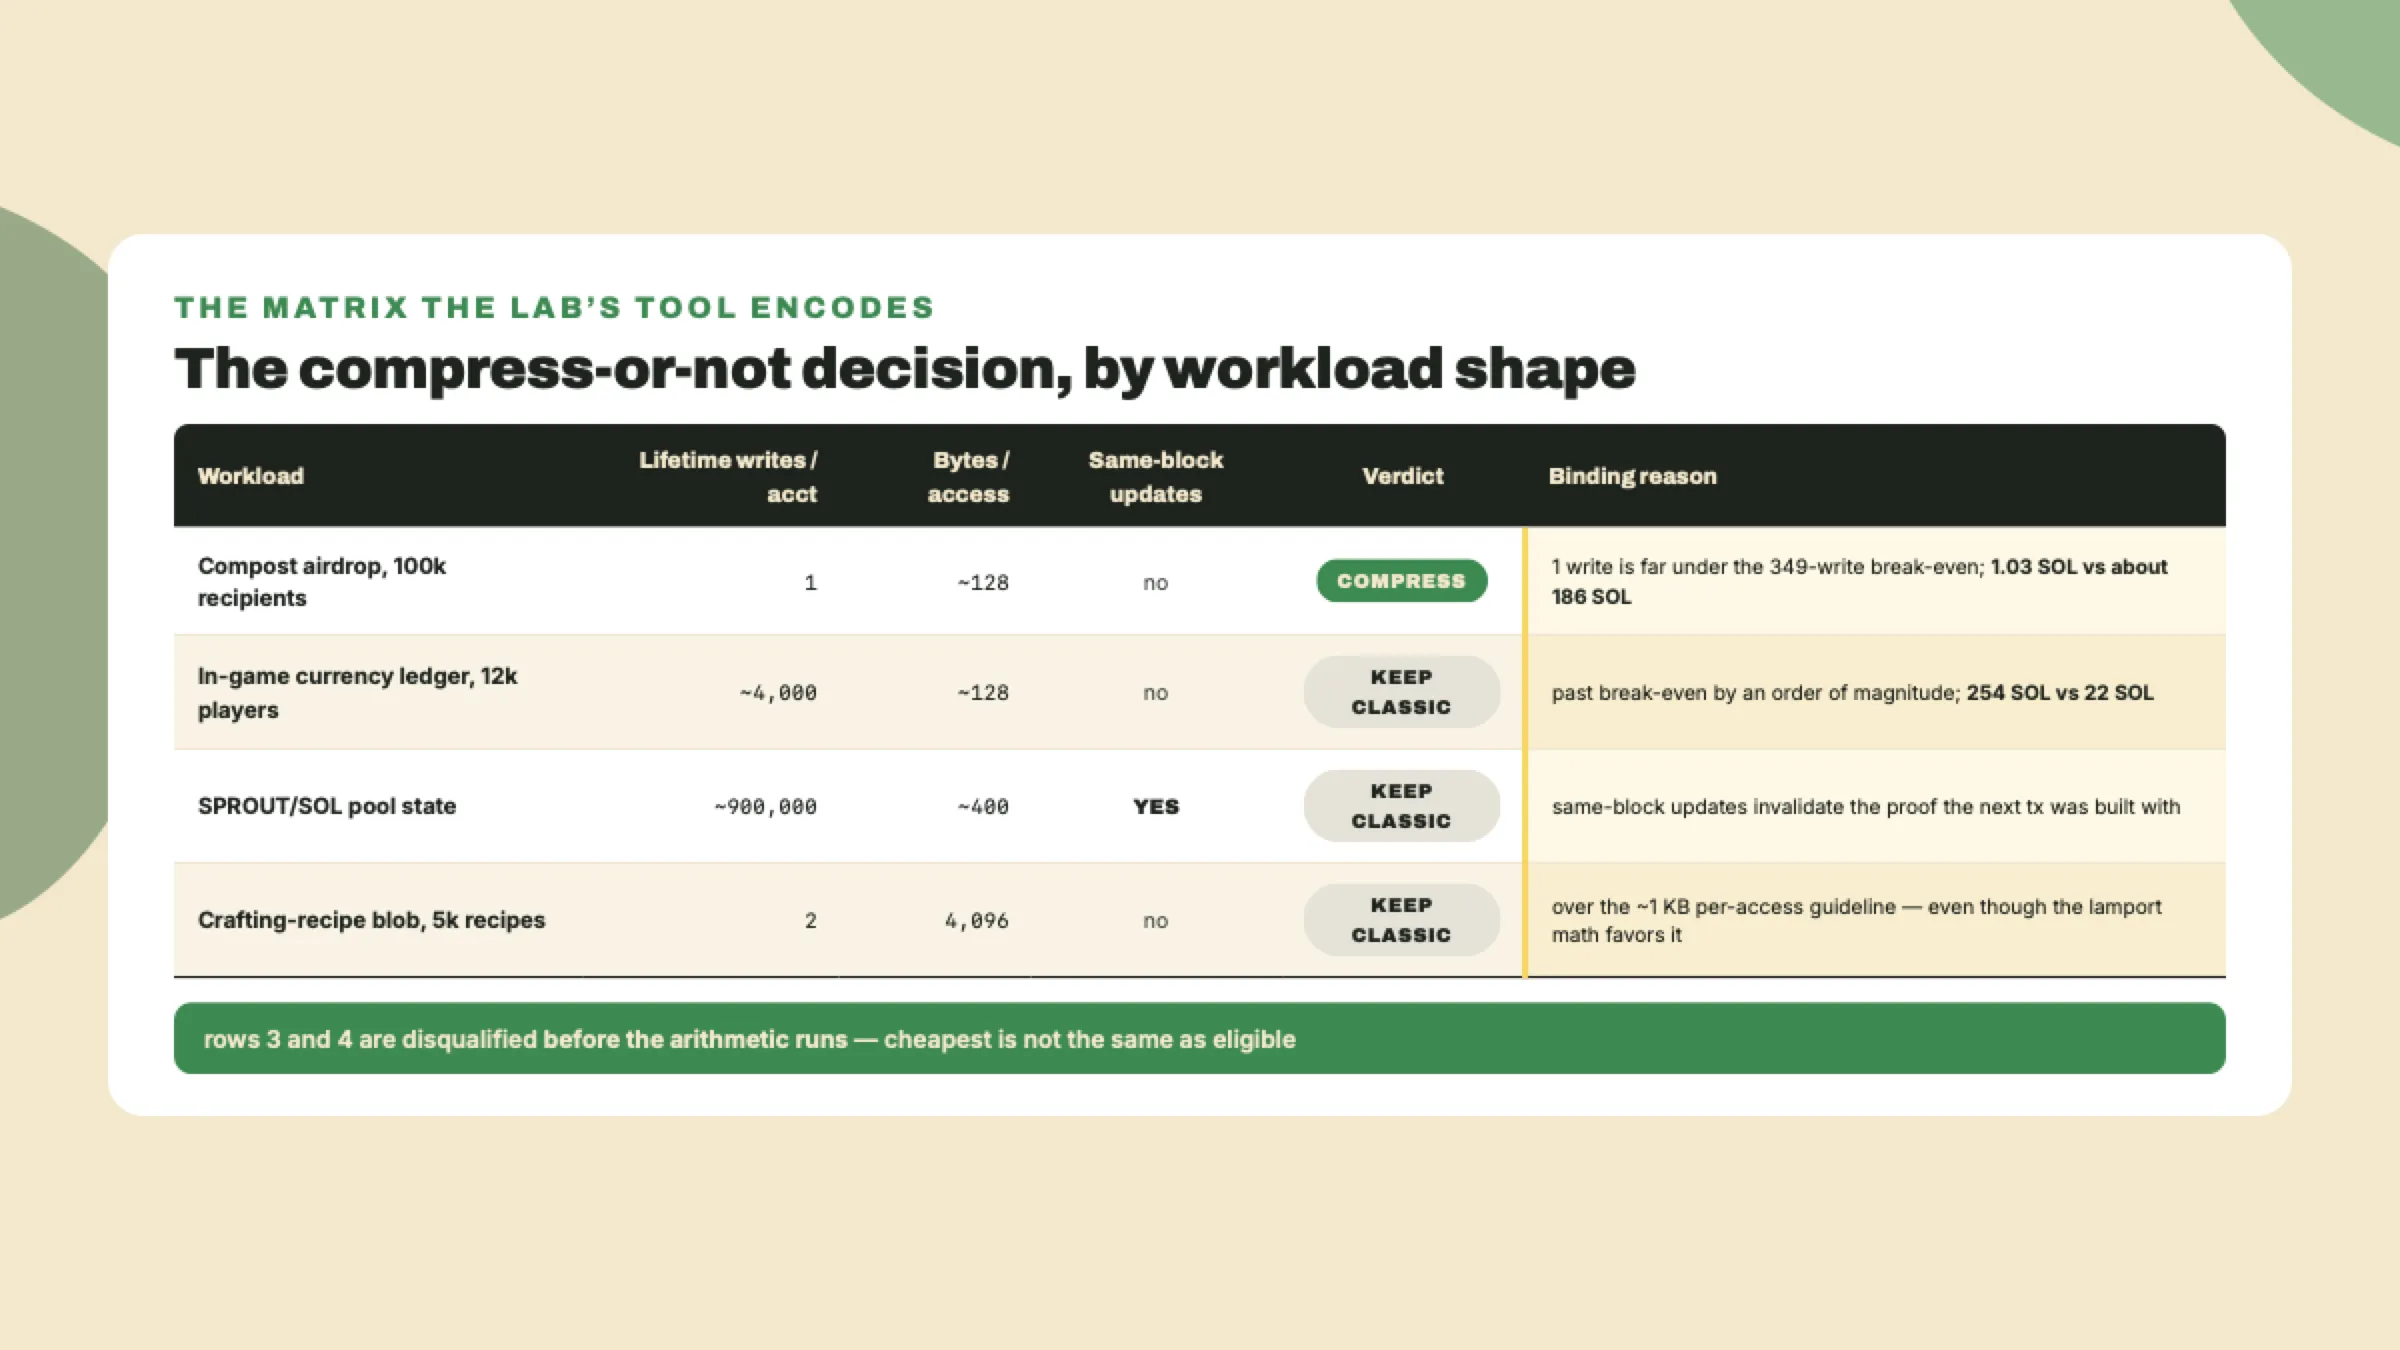
Contas com muita escrita. Qualquer coisa bem além daquela faixa de algumas centenas a mil escritas ao longo da vida. Um livro-razão de moeda dentro do jogo que debita a cada craft. Um saldo de pontos que avança a cada ação. Essas são as contas cujo trabalho inteiro é serem escritas, e a compressão põe preço em escrita.
Atualizações repetidas no mesmo bloco. Isto é pior do que caro, é mecanicamente hostil. O estado de uma pool de AMM é atualizado muitas vezes dentro de um único bloco, e toda atualização invalida a prova com que a próxima transação foi montada. Você não está pagando mais pelo mesmo comportamento, você está brigando numa corrida que não dá para vencer. O estado da pool continua sendo uma conta normal. Não "deveria", simplesmente não dá.
Acessos grandes. Passando de mais ou menos 1 KB por acesso, o custo de leitura e de hash de mover esse blob pela maquinaria de compressão deixa de valer o rent que você economizou. Blobs grandes querem uma conta simples, ou querem nem estar on-chain.
E o formato que ganha, dito com a mesma clareza: estado criado uma vez, escrito uma ou duas vezes, mantido por um número enorme de donos distintos. Airdrops. Distribuições. Direitos de claim. Artefatos de uso único. Que é exatamente o formato do compost drop que a Overgrowth roda no módulo 8 (uma distribuição em massa de pontos de compost para todo jogador, primeira aparição dele aqui como prévia), e exatamente por que aquele módulo usa este trilho em vez de pagar cerca de 186 SOL para criar contas de token para pessoas que talvez nunca as toquem.
Nada disso faz dos tokens comprimidos um beco sem saída. A descompressão é de primeira classe: um saldo de token comprimido pode ser convertido de volta em uma conta de token SPL normal, e essa é a jogada padrão no instante em que um holder quer fazer algo que o ecossistema mais amplo entende. Fazer swap na Jupiter é o exemplo canônico. O roteador não sabe da sua conta comprimida, então você descomprime e depois roteia.
Leia a ida e volta como um padrão de design em vez de uma saída de emergência. Distribuição barata para muitas carteiras, a maioria das quais fica parada, e a minoria que age paga uma descompressão única para entrar na vida normal de token. O custo cai sobre os usuários que de fato apareceram em vez de cair sobre você na hora do drop, por destinatário, adiantado. Essa realocação é o ponto do trilho inteiro.
A lição passada nomeou esse imposto para leituras, com detalhes: o DAS é um índice alugado, com a própria fronteira de confiança. Aqui está a versão da mesma lei para o caminho de escrita, e ela generaliza para os dois trilhos de compressão: se o estado não está em uma conta, alguém tem que reconstruí-lo, e esse alguém é um indexador que você não roda.
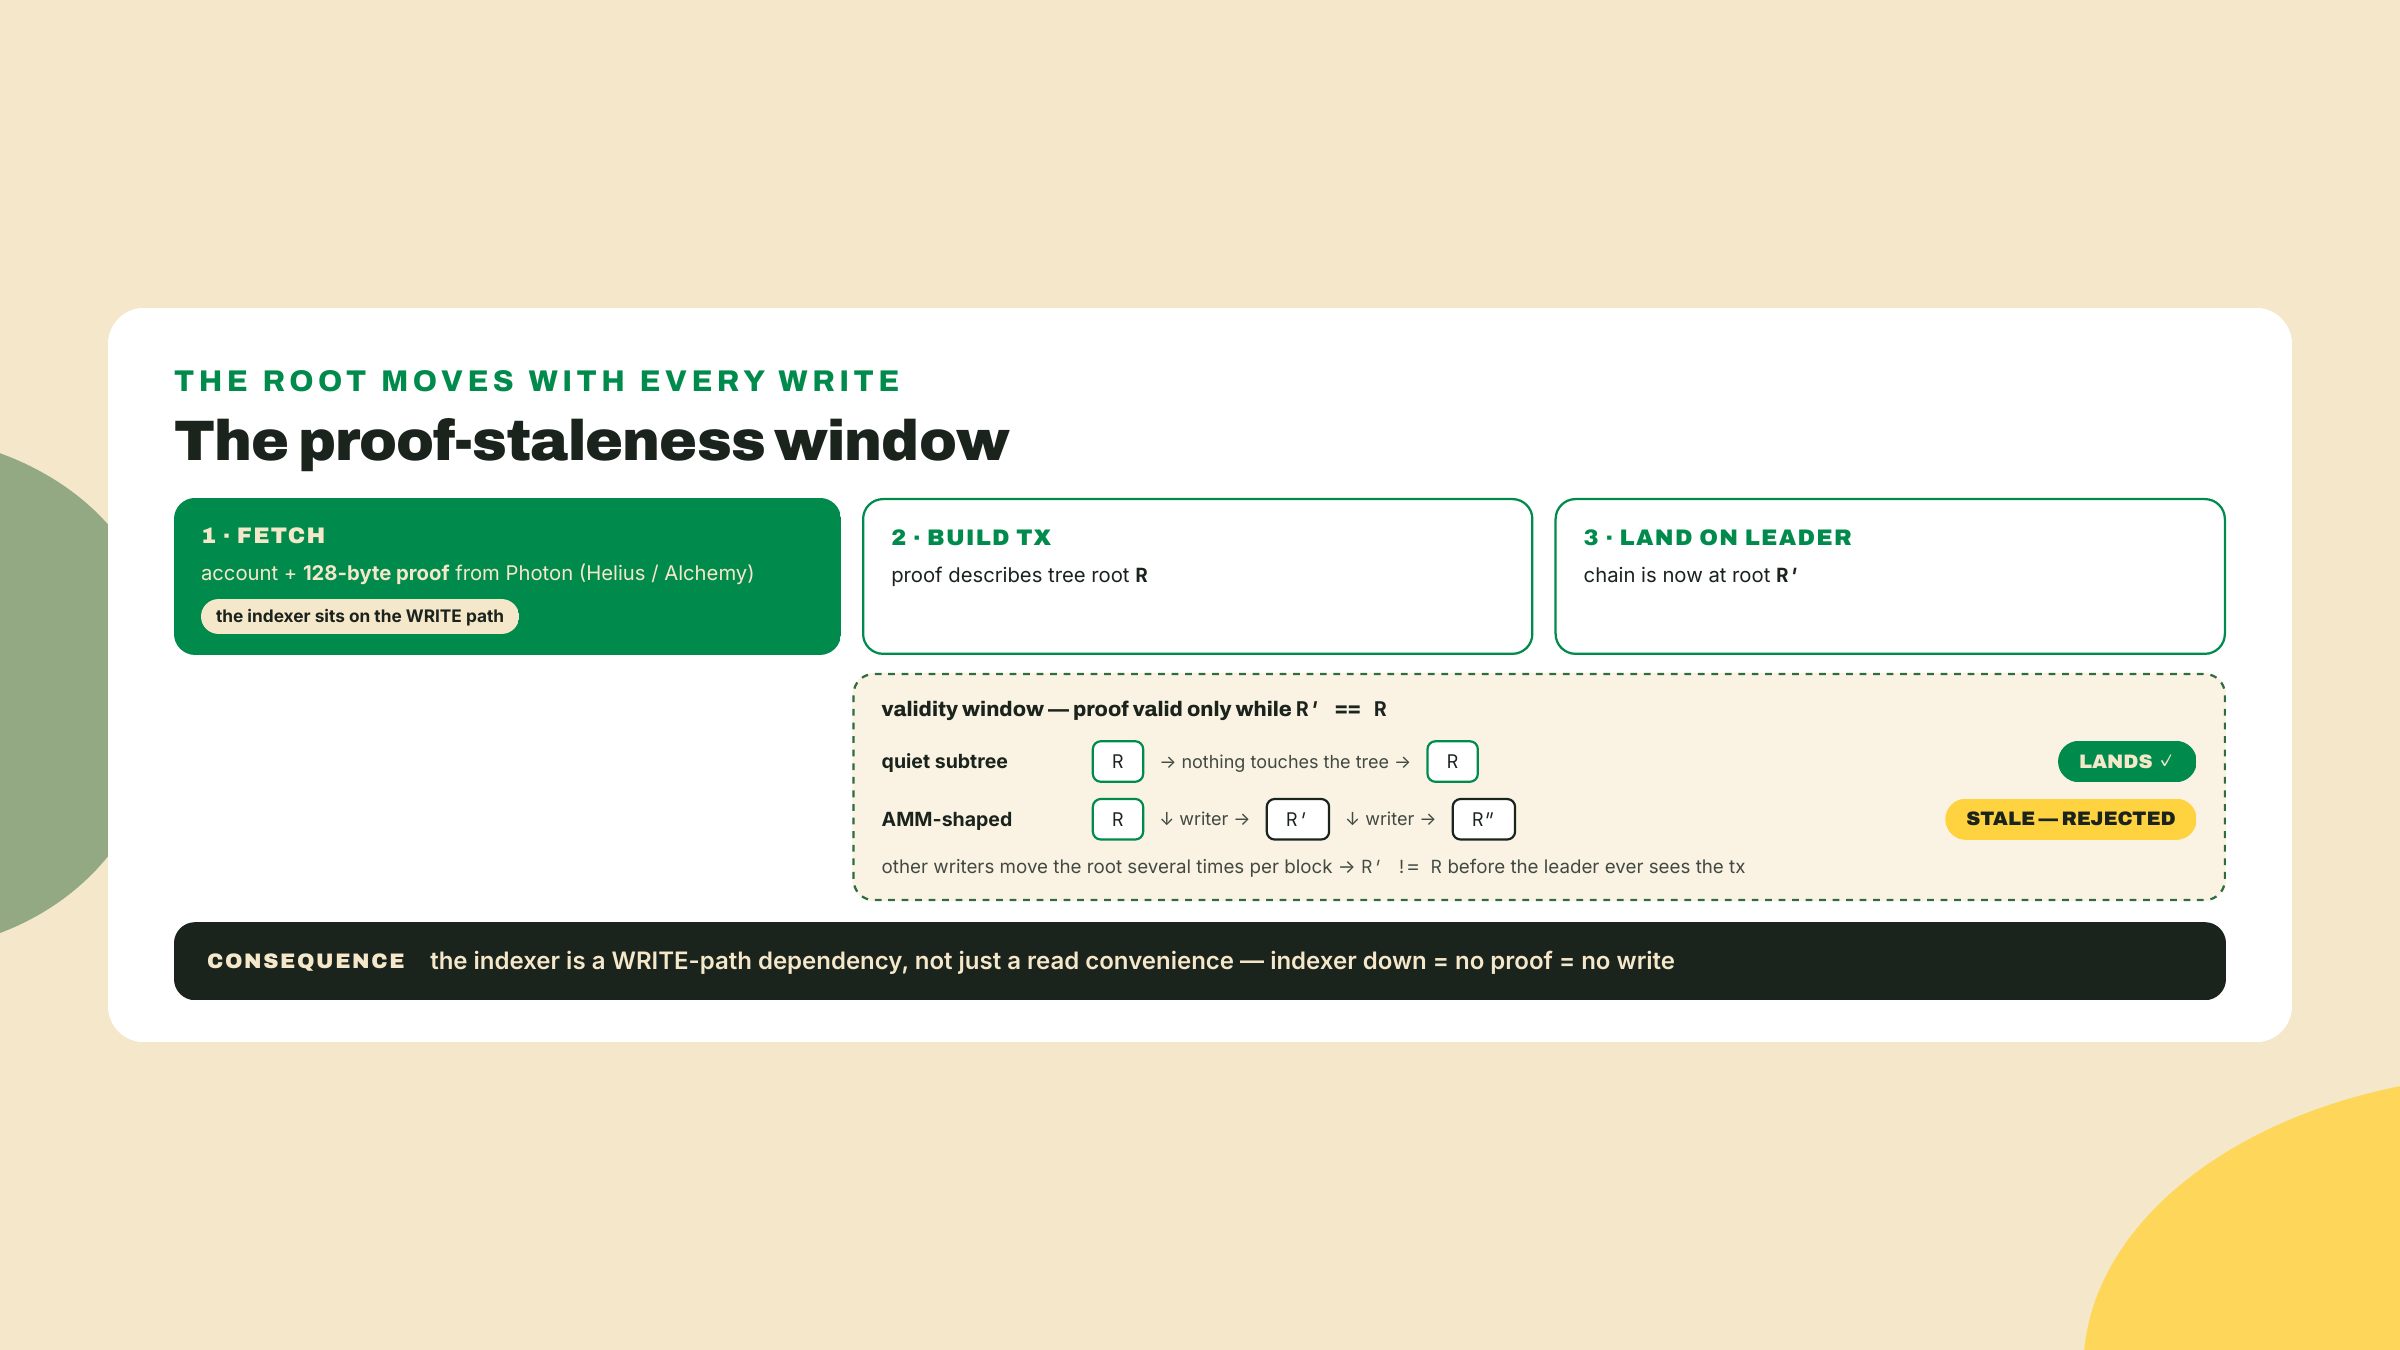
Para cNFTs esse indexador fala DAS. Para a compressão ZK é o Photon, construído pela Helius e servido também pela Alchemy. O Photon é onde você busca uma conta comprimida, e o Photon é onde você busca a prova de validade de 128 bytes que cada escrita precisa. Mesmo formato de dependência, interface diferente, e não, a sua escolha de provedor de DAS não vale automaticamente aqui.
Encanamento de provedor em escala, backfills, firehoses gRPC, rodar seu próprio índice, isso é território do curso planejado Client-Side Mastery, e ele trata do assunto direito. O que cabe aqui é a consequência de design: escolher compressão significa escolher uma dependência de indexador no seu caminho de escrita, não só no seu caminho de leitura. Uma transferência do Bubblegum precisa de uma prova. Uma transferência de cToken precisa de uma prova. Se o indexador estiver fora do ar, você não está escrevendo.
E essa dependência tem um relógio em cima dela, que é de onde o desqualificador do mesmo bloco vem mecanicamente, e não como uma regra que eu pedi para você decorar. Uma prova é uma declaração sobre uma raiz de árvore específica. Qualquer escrita que toca a árvore move a raiz, e toda prova buscada contra a raiz anterior agora descreve uma árvore que não existe mais. No caso comum isso não é problema, porque você busca, monta e confirma dentro de uma janela em que nada mais tocou a sua subárvore. No caso do AMM é fatal, porque a conta está sendo escrita várias vezes por bloco por gente que não é você, e a sua prova já estava velha antes de a sua transação chegar no leader. A aritmética de lamports nunca tem chance de importar ali. Note que essa é a mesma falha que o changelog buffer do Bubblegum absorve mas não remove (o canopy só encurta as provas que vão na rede; o buffer é o botão de concorrência, conforme a m07-l1), e é por isso que a pressão de escrita concorrente é uma propriedade da família de compressão como um todo e não de uma implementação.
Agora a fronteira, e a parte em que eu preciso que você segure uma linha.
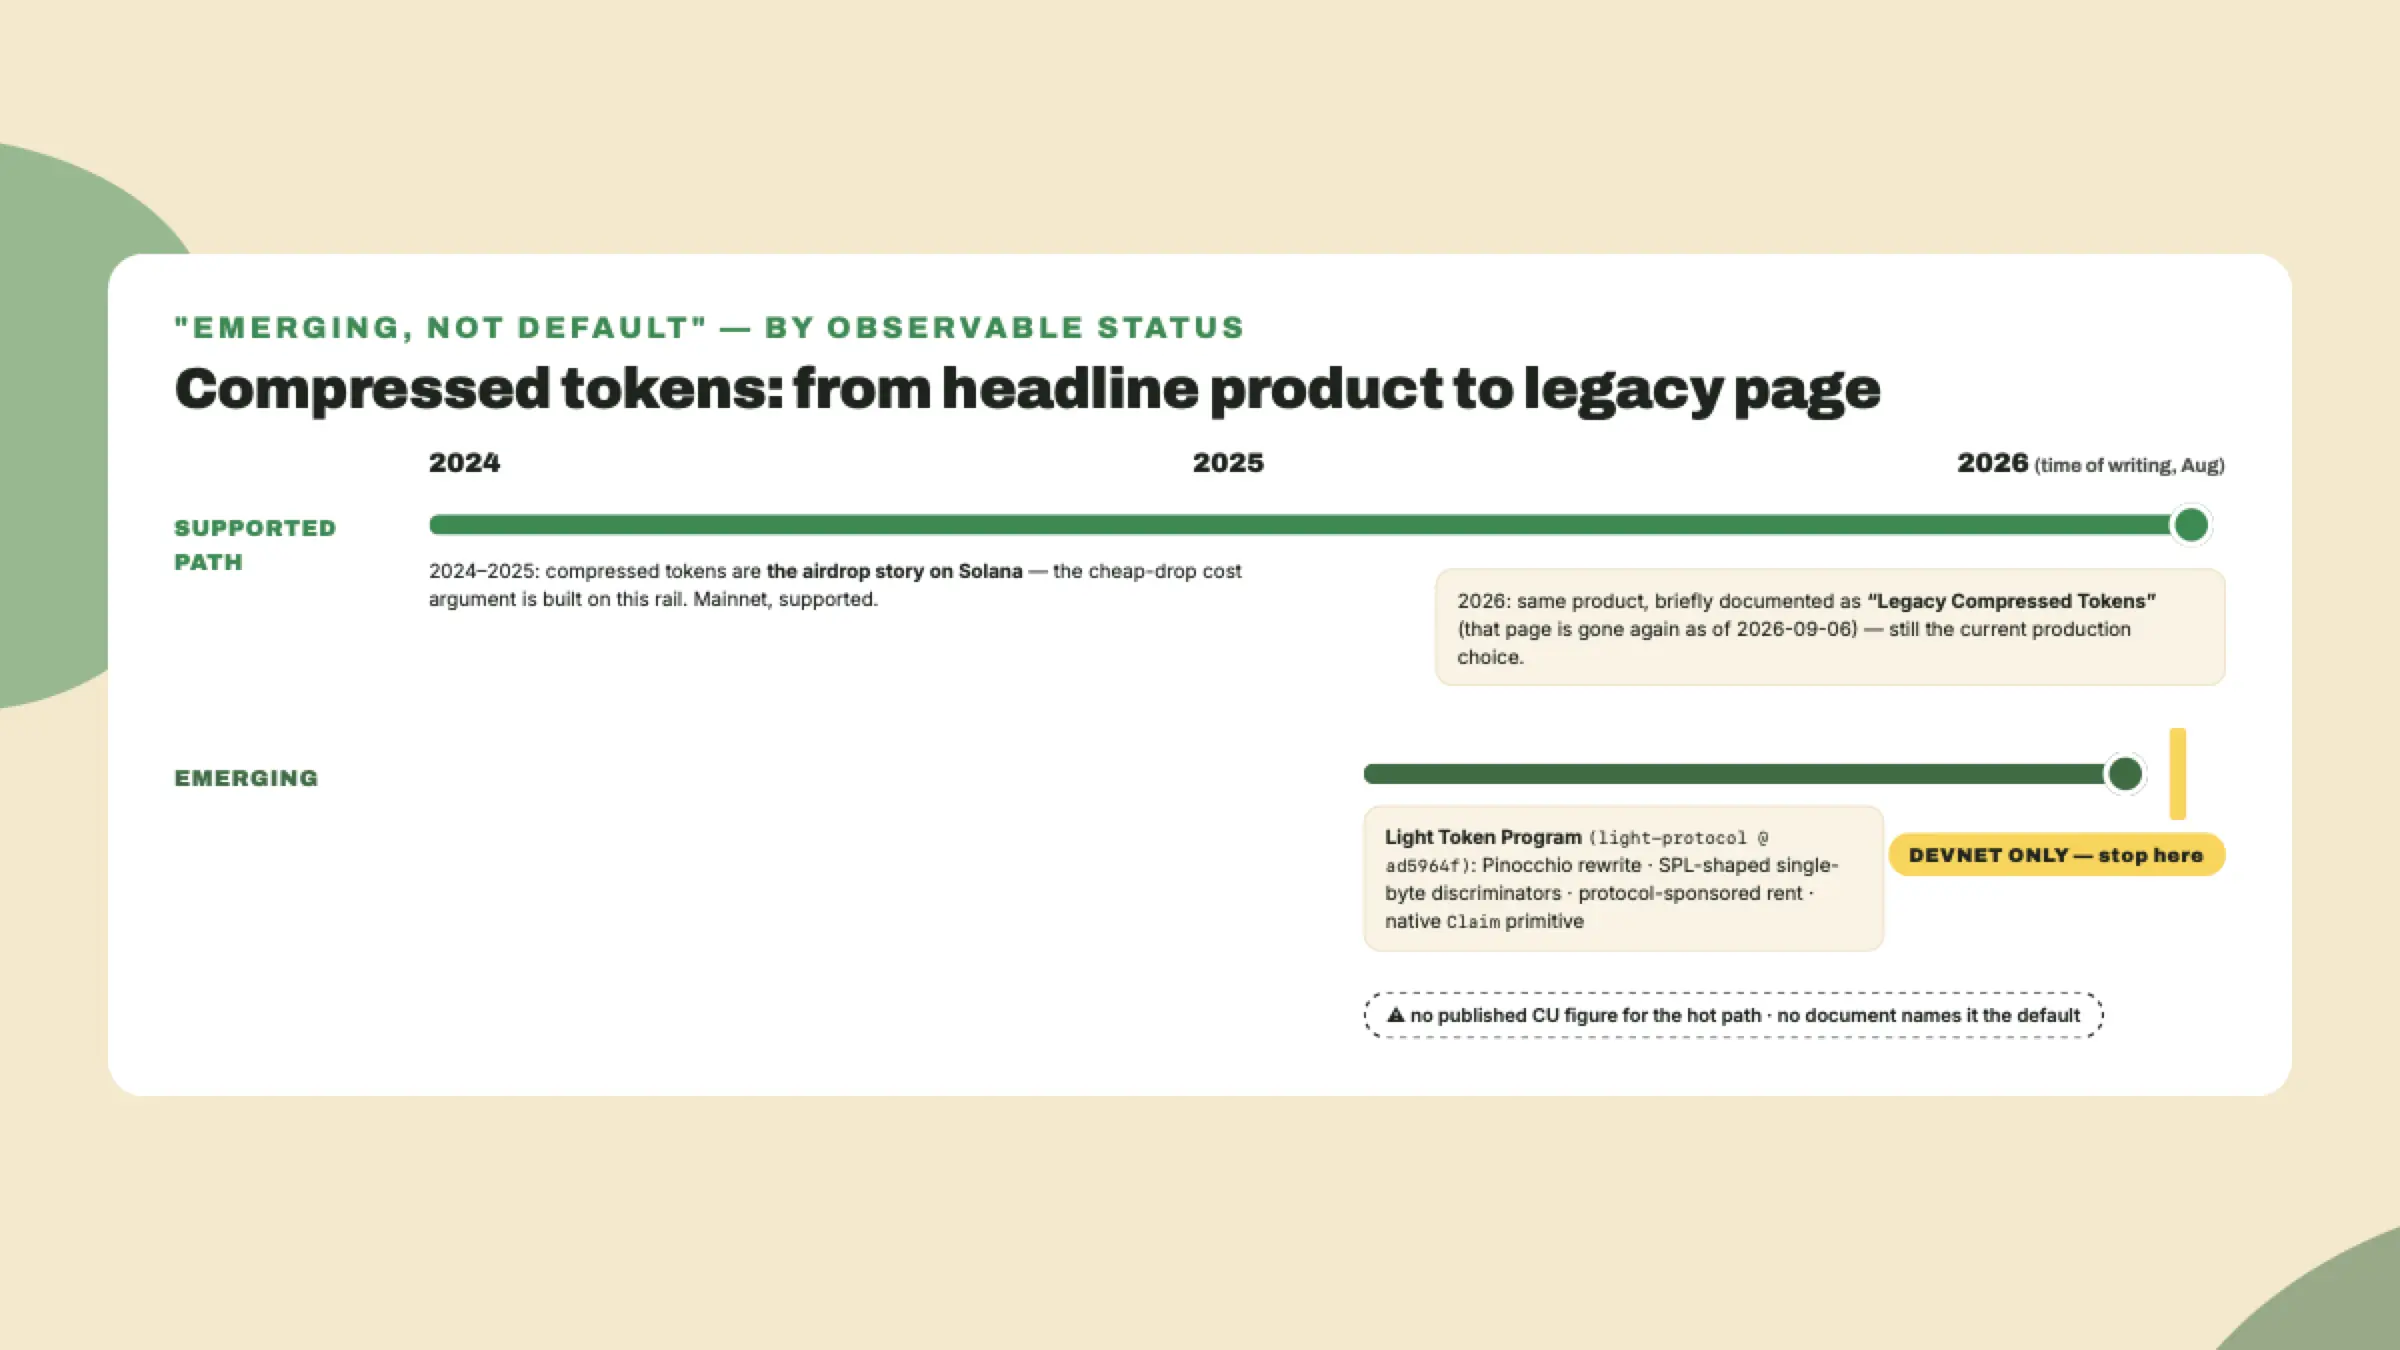
A Light Protocol está reconstruindo o próprio produto principal. Os tokens comprimidos foram o queridinho dos airdrops de 2024 e 2025, a coisa para a qual todo mundo apontava ao argumentar que distribuição na Solana podia ser barata. Um sucessor chamado Light Token Program está crescendo ao lado dele.
Uma nota de atualidade que você deveria ler antes do resto desta seção, porque é a seção com maior chance de estar desatualizada quando você chegar aqui. Quando esta lição foi rascunhada, o zkcompression.com arquivava o produto existente sob uma página intitulada "Legacy Compressed Tokens", e foi desse enquadramento que veio o formato da seção. Re-sondando a documentação em 2026-09-06: aquela página dá 404, as 67 URLs do sitemap não contêm nenhuma entrada "legacy" nem "light-token", e o llms.txt não menciona nenhum dos dois. A documentação agora apresenta compressed-tokens sem mais nada, sem rótulo de legacy e sem página de sucessor ao lado. Eu não sei se isso significa que o sucessor foi incorporado, renomeado ou engavetado, e não vou chutar. O que vem a seguir é o que aquelas páginas diziam quando eu as li; trate toda afirmação de status nele como datada, e vá ler o site você mesmo antes de repetir qualquer coisa dele.
O sucessor é genuinamente interessante. É uma reescrita em Pinocchio, então herda a mesma postura de zero-copy e sem overhead de framework que levou o transfer do SPL Token clássico a 76 CU. Ele usa discriminadores de um byte no formato do SPL em vez de discriminadores de oito bytes, o que é uma decisão pequena com uma consequência real: dados de instrução parecidos com os do SPL Token fazem da integração uma questão de apontar para um programa diferente em vez de aprender um protocolo diferente.
As outras duas escolhas soam como respostas diretas a reclamações que esta lição vem fazendo. O rent patrocinado pelo protocolo tira o custo da conta de cima do usuário, o que ataca o meio incômodo da ida e volta que você acabou de mapear, onde um destinatário que quer agir tem que bancar a própria saída. E uma primitiva Claim nativa importa porque "fazer claim do seu drop" é a coisa mais comum que alguém faz com tokens comprimidos, e todo drop existente parafusa um programa distribuidor separado em cima para isso. Os dois são os instintos certos. Nenhum dos dois é motivo para mover dinheiro de produção hoje.
Aqui está a linha, do jeito que a documentação a traçava na época daquela leitura: o Light Token Program rodava só na devnet da Solana, não na mainnet, e nenhum documento o posicionava como o substituto do caminho de tokens comprimidos com suporte. É um trilho emergente, que vale acompanhar, que vale prototipar contra ele, e não é nele que você entrega a moeda da Overgrowth neste trimestre.
E aqui está a metade durável, que sobrevive à documentação se mexendo debaixo de nós dois. A afirmação que decide a sua arquitetura é "este trilho tem suporte no cluster em que eu entrego", e essa afirmação tem um dono: a documentação do protocolo e os próprios deploys do programa dele, não um colega de equipe, não um post de blog, e não esta página. Vá conferir, anote a data ao lado do que você encontrar, e se um colega de equipe te disser que o default virou, peça as mesmas duas coisas a ele. Uma afirmação de status sem fonte e sem data é boato, não importa com quanta confiança seja entregue.
Mais uma coisa, e esta é uma confissão, não um fato. Um rascunho inicial desta lição trazia um número de compute units para o caminho quente do Light Token. Ele veio da minha memória, lia lindamente, e não sobreviveu à revisão, porque não aparece em nenhuma fonte publicada. Não existe número de CU publicado para esse caminho. Não cite nenhum, nem de mim, nem de um post de blog, nem de um assistente que soa confiante. Em um programa tão novo, um número sem fonte é um número que alguém inventou.
A compressão inverte o modelo de custo. Ela não revoga a física.
Você troca uma criação de conta mais ou menos 370x mais barata por um compute por escrita muito mais alto, mais uma prova que o cliente tem que buscar e manter fresca, mais uma dependência viva de indexador no caminho de escrita. Para distribuição de uma tacada só para muitos donos, essa troca é esmagadoramente boa. Para estado com muita escrita, estado grande, ou estado tocado repetidamente dentro de um único bloco, a mesma troca se inverte e leva a sua economia junto.
O trilho mais novo compra elegância ao custo de ser só de devnet hoje. Isso também é uma troca, e hoje não é uma que você faz com dinheiro de produção.
Você vai codificar o raciocínio acima como um programa pequeno, porque um veredicto que você pode rodar de novo em uma nova carga de trabalho vale mais do que um veredicto que você lembra. Sem rede, sem SDK, sem carteira. Só o modelo de custo, quatro cargas de trabalho e saída honesta.
Preparação. Um diretório, duas dependências de dev, nenhum pacote da Solana.
mkdir -p labs/m07-l3 && cd labs/m07-l3
npm init -y
npm install -D tsx@4.23.12 typescript@5.9.3
Pins exatos, os mesmos do versionStamp desta lição (re-checados em 2026-09-05); confira de novo antes de fixar qualquer coisa de vida longa. O tsx roda um arquivo TypeScript direto, que é tudo de que a gente precisa aqui.
O modelo de custo (trabalhado por completo). Toda constante neste arquivo é ou um número congelado do curso ou um valor lido de uma fonte pública numa data declarada, e cada comentário diz qual é o caso. Os valores derivados saem direto delas. Nada aqui é chute.
// labs/m07-l3/model.ts

/** Lamports to create one compressed token account. */
export const COMPRESSED_CREATE_LAMPORTS = 5_000;
/** Lamports of state cost per compressed transfer (Light's V2 program line). */
export const COMPRESSED_WRITE_LAMPORTS = 5_300;
/** A classic SPL token account: 165 bytes of data plus the 128-byte account header. */
export const CLASSIC_ACCOUNT_BYTES = 293;
/**
 * Rent-exemption price of one byte. THE ONLY NUMBER IN THIS FILE THAT
 * BELONGS TO THE NETWORK RATHER THAN TO A LAYOUT OR A PROGRAM: mainnet-beta,
 * read 2026-09-06; devnet was a step further down at 5,080 the same day.
 * SIMD-0437 is stepping the rate down over several releases, so re-read it
 * before you budget: solana rent 0 --url <cluster>, then divide by 128.
 */
export const LAMPORTS_PER_BYTE = 6_333;
/**
 * Rent locked by one classic SPL token account. DERIVED, not pasted: at
 * 6,333 this is 1,855,569, which is what `solana rent 165 --url
 * mainnet-beta` printed on 2026-09-06. Refundable on close.
 */
export const CLASSIC_RENT_LAMPORTS = CLASSIC_ACCOUNT_BYTES * LAMPORTS_PER_BYTE;
/** Compute units for one compressed token transfer: proof verification + hashing. */
export const COMPRESSED_TRANSFER_CU = 292_000;
/** Compute units for a classic Transfer on the p-token engine (see m01-l3). */
export const CLASSIC_TRANSFER_CU = 76;
/** Guideline ceiling on bytes touched per compressed-account access. */
export const MAX_ACCESS_BYTES = 1_024;

/**
 * Highest lifetime write count at which the compressed path is still cheaper
 * in lamports than one classic account's rent. An output of the model, not a
 * constant of it: 349 at mainnet's 6,333, 279 at devnet's 5,080, and it moves
 * again at the next rate step.
 */
export const BREAK_EVEN_WRITES = Math.floor(
  (CLASSIC_RENT_LAMPORTS - COMPRESSED_CREATE_LAMPORTS) / COMPRESSED_WRITE_LAMPORTS,
);

export function compressedLamports(writes: number): number {
  return COMPRESSED_CREATE_LAMPORTS + COMPRESSED_WRITE_LAMPORTS * writes;
}

export function classicLamports(): number {
  return CLASSIC_RENT_LAMPORTS;
}

export function sol(lamports: number): string {
  return `${(lamports / 1e9).toFixed(4)} SOL`;
}
A função de veredicto (você preenche duas lacunas). O formato está dado; as duas regras desqualificadoras são suas. Escreva-as antes de olhar o passo 4.
// labs/m07-l3/verdict.ts
import {
  BREAK_EVEN_WRITES,
  MAX_ACCESS_BYTES,
  classicLamports,
  compressedLamports,
} from "./model";

export interface Workload {
  name: string;
  accounts: number;
  lifetimeWritesPerAccount: number;
  bytesPerAccess: number;
  sameBlockUpdates: boolean;
}

export interface Verdict {
  workload: string;
  compress: boolean;
  reason: string;
  compressedTotalLamports: number;
  classicTotalLamports: number;
}

export function decide(w: Workload): Verdict {
  const compressedTotalLamports = w.accounts * compressedLamports(w.lifetimeWritesPerAccount);
  const classicTotalLamports = w.accounts * classicLamports();
  const base = { workload: w.name, compressedTotalLamports, classicTotalLamports };

  // TODO(you): disqualifier 1. Same-block repeated updates lose regardless of
  // lamports, because each update invalidates the proof the next transaction was
  // built with. Return { ...base, compress: false, reason: ... }.

  // TODO(you): disqualifier 2. Accesses above MAX_ACCESS_BYTES lose even when the
  // lamport math favours compression. Mention the actual byte count in the reason.

  const plural = w.lifetimeWritesPerAccount === 1 ? "" : "s";
  if (w.lifetimeWritesPerAccount > BREAK_EVEN_WRITES) {
    return {
      ...base,
      compress: false,
      reason: `${w.lifetimeWritesPerAccount} lifetime write${plural} per account is past the ${BREAK_EVEN_WRITES}-write break-even`,
    };
  }
  return {
    ...base,
    compress: true,
    reason: `${w.lifetimeWritesPerAccount} lifetime write${plural} per account is under the ${BREAK_EVEN_WRITES}-write break-even`,
  };
}
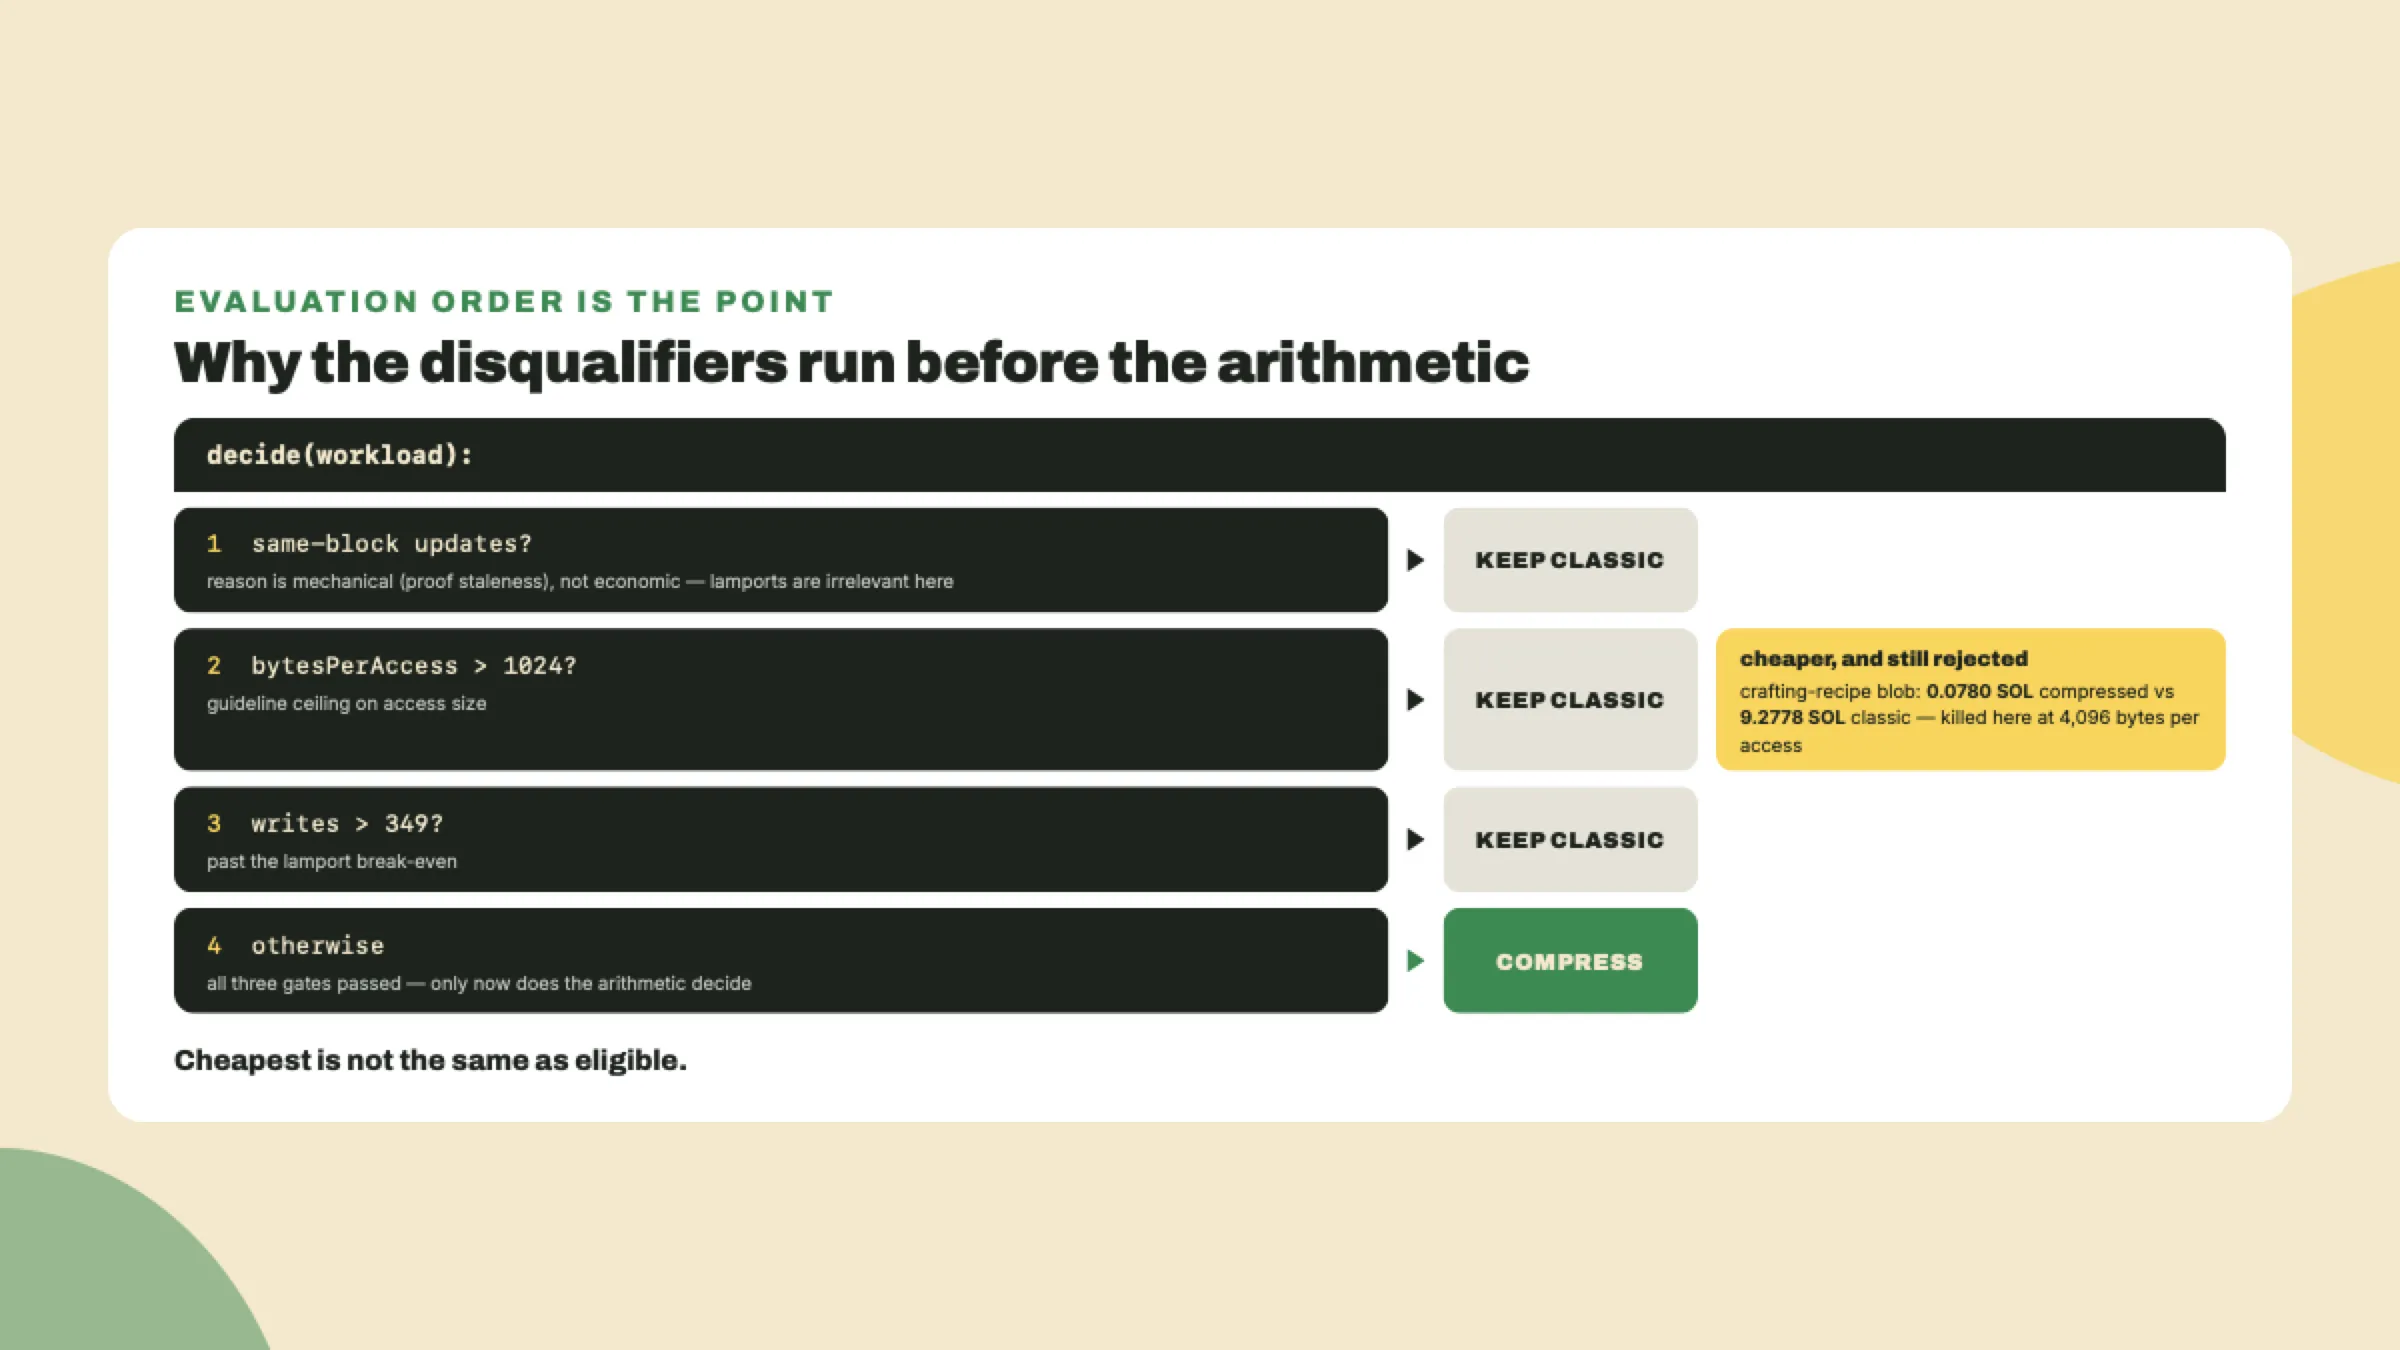
A ordem importa aqui, e é a única decisão de design do arquivo. Os dois desqualificadores rodam antes da aritmética, porque uma carga de trabalho pode ser mais barata em lamports e ainda assim ter o formato errado. A linha 4 da tabela de decisão é exatamente esse caso.
Os preenchimentos. Este é o gabarito dos dois TODOs do passo 3, e em uma página renderizada nada fica fisicamente entre o enunciado e este bloco, então a cancela é comportamental e é sua: se você rolou até aqui sem escrever as suas duas regras antes, volte, escreva-as, depois faça o diff. A lição só sabe o que as suas mãos fizeram. Desqualificador 1:
if (w.sameBlockUpdates) {
  return {
    ...base,
    compress: false,
    reason: "same-block repeated updates: each update invalidates the next transaction's proof",
  };
}
Desqualificador 2:
if (w.bytesPerAccess > MAX_ACCESS_BYTES) {
  return {
    ...base,
    compress: false,
    reason: `${w.bytesPerAccess} bytes per access is over the ${MAX_ACCESS_BYTES}-byte guideline`,
  };
}
Se você escreveu a cancela de tamanho como uma penalidade suave em vez de uma rejeição dura, você não estava errado sobre a realidade, só sobre esta ferramenta. A linha de 1 KB é um gradiente íngreme e não um penhasco, e eu a codifiquei como uma cancela para que a ferramenta dê uma resposta em vez de dar de ombros. Diga isso no seu texto se você discordar, essa é uma posição legítima de se ter e defender.
As cargas de trabalho (rode). Três das quatro da Overgrowth estão trabalhadas; você adiciona a quarta no challenge.
// labs/m07-l3/run.ts
import { COMPRESSED_TRANSFER_CU, CLASSIC_TRANSFER_CU, sol } from "./model";
import { decide, type Workload } from "./verdict";

const workloads: Workload[] = [
  {
    name: "compost-drop (100k recipients)",
    accounts: 100_000,
    lifetimeWritesPerAccount: 1,
    bytesPerAccess: 128,
    sameBlockUpdates: false,
  },
  {
    name: "currency-ledger (12k players)",
    accounts: 12_000,
    lifetimeWritesPerAccount: 4_000,
    bytesPerAccess: 128,
    sameBlockUpdates: false,
  },
  {
    name: "sprout-sol-pool-state",
    accounts: 1,
    lifetimeWritesPerAccount: 900_000,
    bytesPerAccess: 400,
    sameBlockUpdates: true,
  },
];

for (const w of workloads) {
  const v = decide(w);
  console.log(v.workload);
  console.log(`  verdict: ${v.compress ? "COMPRESS" : "KEEP CLASSIC"}`);
  console.log(`  reason: ${v.reason}`);
  console.log(`  compressed: ${sol(v.compressedTotalLamports)}   classic: ${sol(v.classicTotalLamports)}`);
}

console.log(`\ncompute ratio per transfer: ${Math.round(COMPRESSED_TRANSFER_CU / CLASSIC_TRANSFER_CU)}x`);
O npx tsx run.ts imprime:
compost-drop (100k recipients)
  verdict: COMPRESS
  reason: 1 lifetime write per account is under the 349-write break-even
  compressed: 1.0300 SOL   classic: 185.5569 SOL
currency-ledger (12k players)
  verdict: KEEP CLASSIC
  reason: 4000 lifetime writes per account is past the 349-write break-even
  compressed: 254.4600 SOL   classic: 22.2668 SOL
sprout-sol-pool-state
  verdict: KEEP CLASSIC
  reason: same-block repeated updates: each update invalidates the next transaction's proof
  compressed: 4.7700 SOL   classic: 0.0019 SOL

compute ratio per transfer: 3842x
Olhe com atenção para a linha do meio. Doze mil jogadores, e a versão comprimida do livro-razão de moeda deles custa mais de onze vezes a versão clássica. É o mesmo mecanismo que faz da linha um uma economia de 180x, rodado na direção contrária. Um número, dois sinais, e a frequência de escrita é a única coisa que mudou.
Faça a checagem de sanidade da linha do drop contra o próximo módulo. A sua linha de compost-drop diz cerca de 10,300 lamports por destinatário. A lição de airdrop do módulo 8 orça mais ou menos 10,300 comprimido contra um número clássico derivado exatamente do jeito que este modelo deriva: (128 + 165) bytes na taxa de rent por byte do seu cluster, 6,333 na mainnet em 2026-09-06, dando 1,855,569 — a mesma taxa e a mesma data que este arquivo fixa. Os seus números deveriam bater exatamente dos dois lados. Se o lado comprimido discordar, você mudou uma constante. Se o lado clássico discordar, os dois arquivos estão fixando taxas de rent ou datas de leitura diferentes, e a leitura mais recente vence — recompute, não tire média.
Solo. Adicione a quarta carga de trabalho e escreva o memorando.
Adicione crafting-recipe-blob ao run.ts: 5,000 contas, 2 escritas ao longo da vida cada, 4,096 bytes por acesso, sem atualizações no mesmo bloco. Antes de rodar, escreva qual veredicto você espera e por quê. Depois rode e confira se o seu motivo bate com o motivo da ferramenta, não só o veredicto. Acertar a resposta pelo motivo errado é o modo de falha que esta lição existe para evitar.
Depois o memorando, e esta é a parte avaliada. Alguém do seu time propõe mover a moeda dentro do jogo da Overgrowth para contas de token comprimidas para economizar rent, e acrescenta que você deveria entregá-la no Light Token Program porque esse é o novo default. Escreva seis frases para essa pessoa: o veredicto de comprimir ou não com o motivo da frequência de escrita e um número da sua própria rodada da ferramenta, a única carga de trabalho da Overgrowth que genuinamente deveria comprimir, e o status correto do Light Token Program.
Aceito quando o memorando nomear a frequência de escrita (não a contagem de holders) como a restrição determinante, citar um número que a sua ferramenta realmente imprimiu, e declarar o status do Light Token Program com a fonte e a data em que você leu em vez de repetir os desta lição. A minha leitura dizia emergente e só de devnet; a página de onde ela veio já sumiu, que é exatamente por que o entregável é uma frase com fonte e não uma decorada. Um memorando que diz "só de devnet, segundo esta URL, lida nesta data" está certo seja qual for a resposta. Se o seu memorando tiver um número de compute units para o caminho quente do Light Token, apague, seja lá o que a sua fonte tenha dito.
O critério é o npx tsx run.ts imprimir quatro cargas de trabalho com um COMPRESS e três KEEP CLASSIC, mais um memorando que você mandaria de verdade.
A resposta de uma frase que você deveria conseguir dar com o terminal fechado: a compressão troca uma criação de conta mais ou menos 370x mais barata por um custo por escrita em lamports e em compute, então ela ganha para estado criado uma vez e mantido por muitos, e perde para estado que é escrito, o que quer dizer que a frequência de escrita e o tamanho do acesso decidem, nunca a contagem de holders.
Os erros que eu espero. Primeiro, a cilada da contagem de holders: se o seu memorando argumenta a partir do número de jogadores, releia a tabela de decisão, porque uma árvore não se importa com a largura dela. Segundo, a surpresa da linha quatro: o blob de crafting-recipe é mais barato comprimido e ainda assim é rejeitado, e se isso pareceu um bug na ferramenta em vez de uma lição sobre cancelas, sente com isso de novo. Terceiro, o número de CU confiante, que é o que realmente me preocupa, porque é o erro que eu quase cometi ao escrever isto e o que um assistente vai cometer de bom grado no seu lugar.
Chega de raciocinar sobre tokens comprimidos. No próximo módulo você usa um de verdade: a lição de airdrop abre com um aquecimento de dez minutos que comprime um único token e o lê de volta pelo Photon, o seu primeiro contato prático com um cToken, antes de construir o compost drop da Overgrowth em cima da mesma aritmética por destinatário que você acabou de codificar. A ferramenta que você escreveu hoje é o que te diz que o drop é o lugar certo para gastar isso.
Pergunta 1 de 3