Carregando...

 BetaBeta
Esta é a lição um, então nada foi construído ainda. Você chega com o modelo mental da Solana já na cabeça: contas, PDAs, transações, taxas. Talvez alguma memória muscular de Anchor 0.x ou 1.0 também. Bom. A gente vai mexer exatamente no pedaço dessa memória muscular que o Anchor V2 arranca e reconstrói.
Antes de eu definir uma única coisa, faça isto. Abra um terminal com a CLI solana que você já tem e confirme uma transação que eu já aterrissei na devnet para você:
# Landed and verified on devnet 2026-09-02; the Lab pins all four values below.
export V1_TWIN_SIG="2BYB5oU12EfJjPTuQjaZCcxwMjWxSBUQ7WjeucW6V35Ge1PRFUda39nV4dU8NnDvt8ZfbN8H4fpAEoYpsEYysR43"

solana confirm -v "$V1_TWIN_SIG" --url devnet | grep -i "compute units"
Uma linha de grep, um número, tirado de um log de verdade em vez de entregue numa tabela. O gêmeo daquele programa te dá um segundo número, e a diferença entre os dois é toda a razão de este curso existir.
Dois programas. Mesma chamada, mesmas contas, mesmas checagens de signer e owner. Um construído sobre o Anchor como você o conhece, um construído sobre o Anchor V2. Você vai medir o custo em unidades de computação de cada um direto dos logs da transação, prever qual gêmeo ganha antes de olhar, e depois nomear a única decisão de design que produziu a diferença. Essa decisão é a tese do curso inteiro: Account<T>, o tipo que você pega em todo programa Anchor, é o caminho lento, e o V2 o torna rápido por padrão.
Algumas regras da casa, porque valem para todas as trinta lições:
solana que você já tem. A lição dois instala o toolchain do V2, e ele vai brigar com você.Mais uma coisa, dita em voz alta porque importa: esta lição segura a sua mão em cada tecla. Isso é deliberado, e a ajuda recua. Na lição dois você instala o toolchain você mesmo e entrega o seu primeiro deploy. Mais para dentro, eu te entrego um teste que falha e uma indicação de uma linha e saio do seu caminho. As rodinhas saem num cronograma. Agora elas estão firmes no lugar.
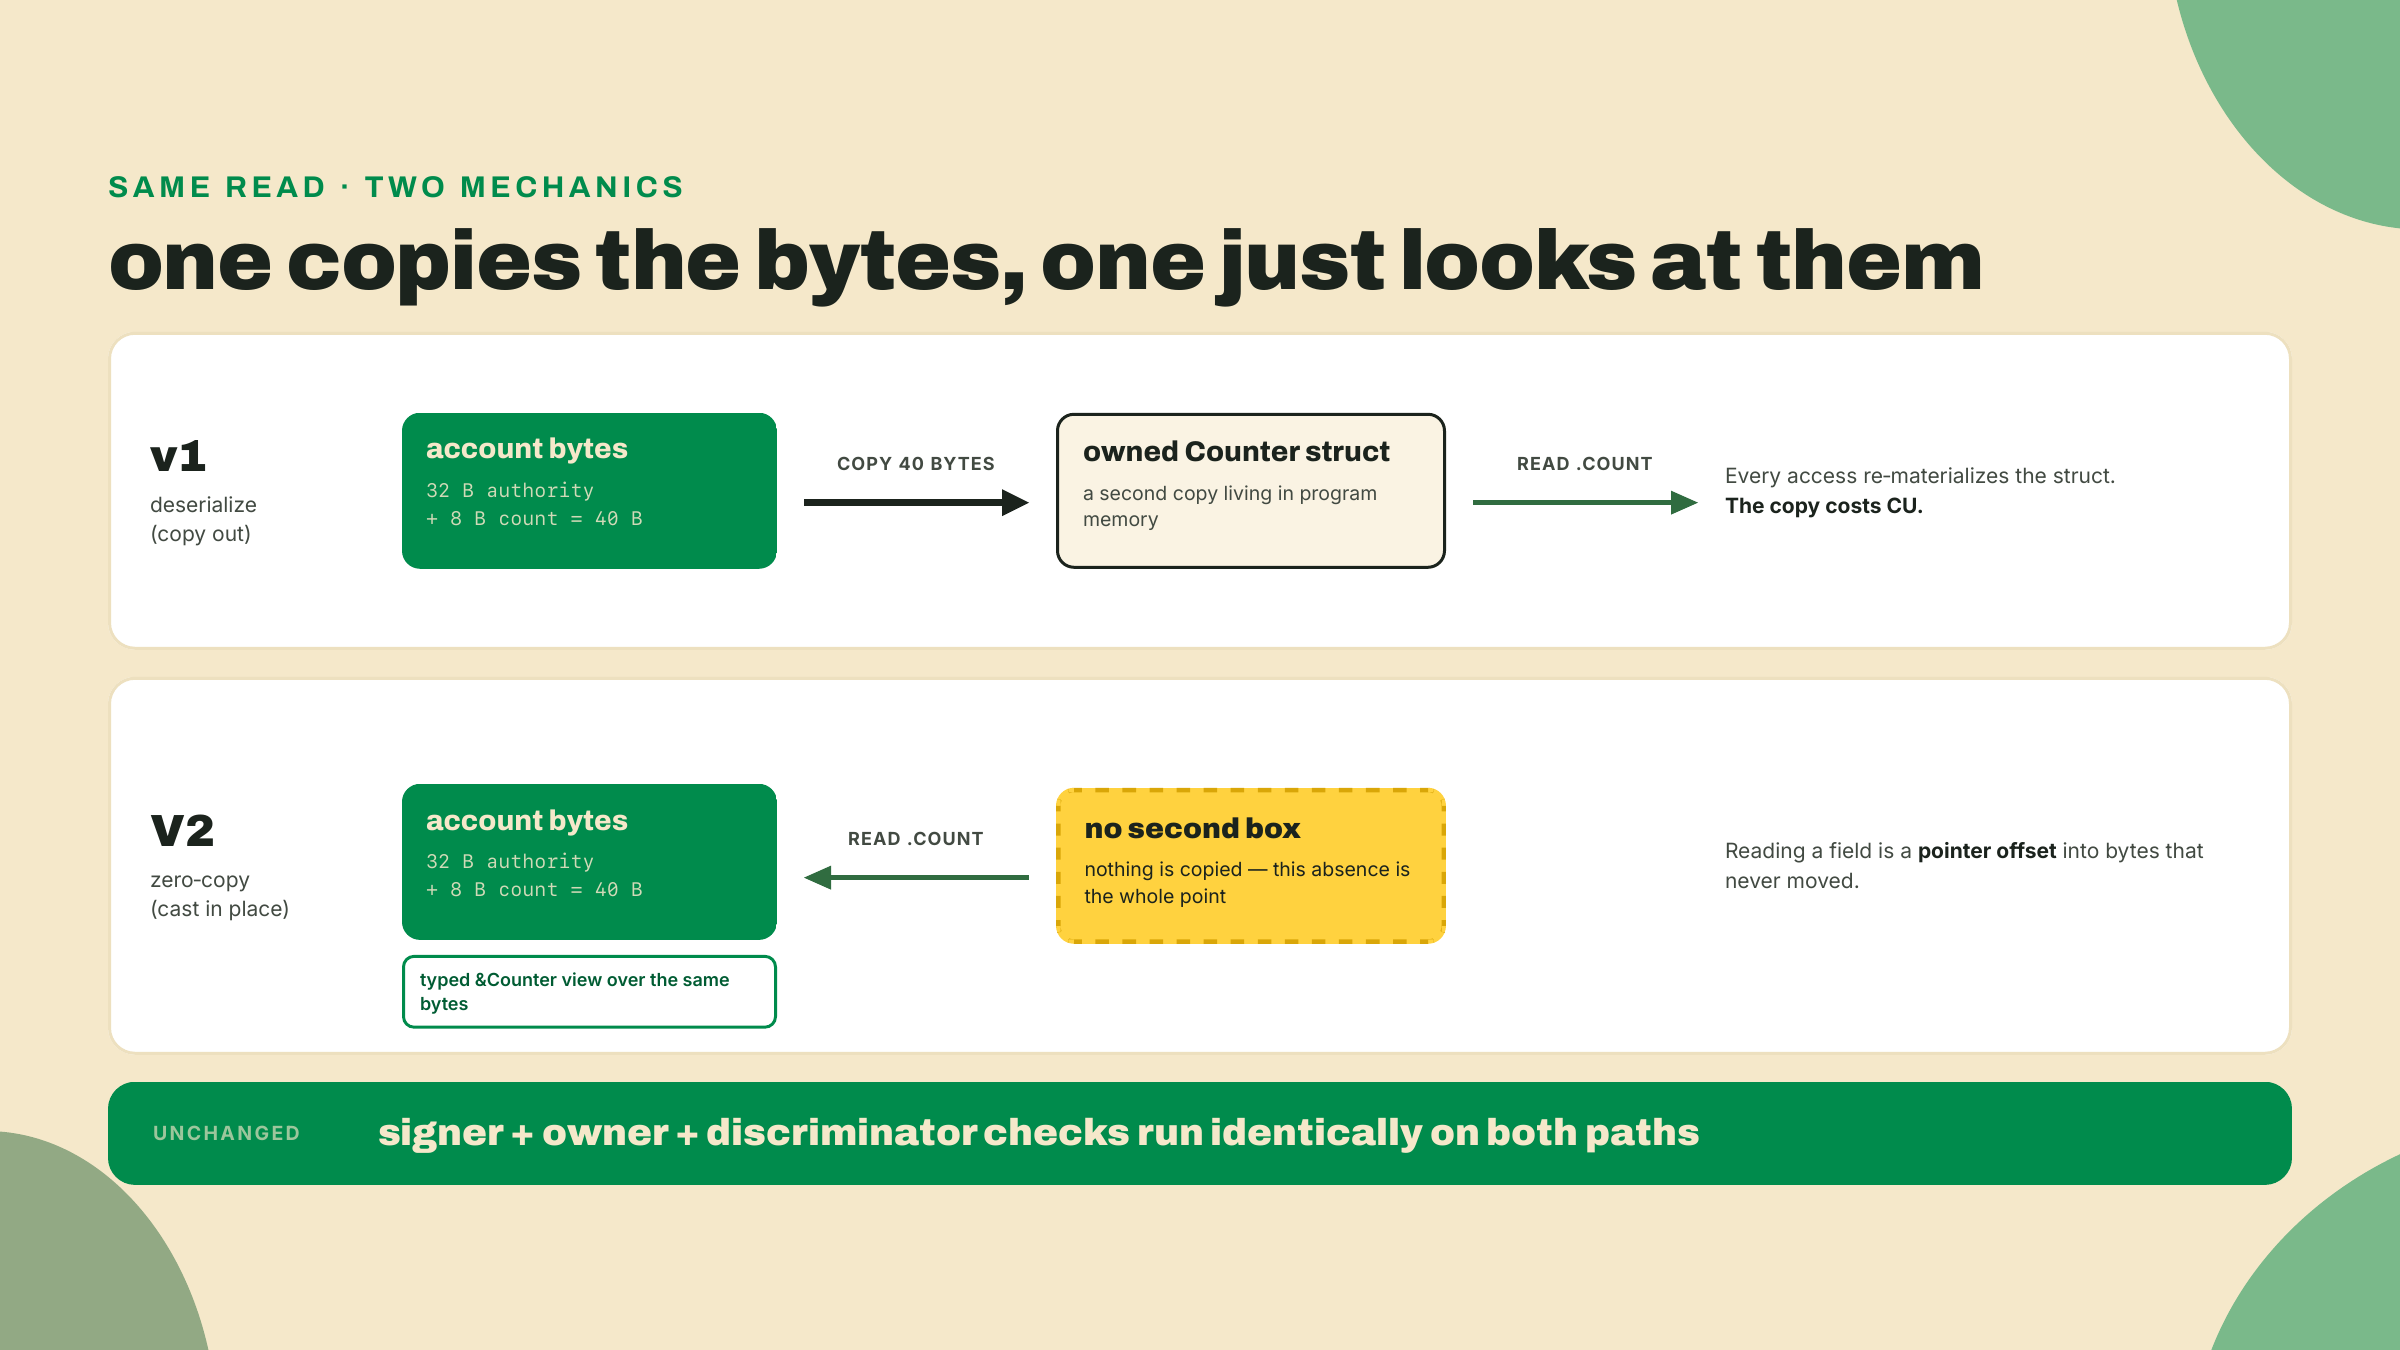
Aqui está a coisa sobre Account<T> no Anchor que você conhece. Toda vez que você toca em ctx.accounts.counter.count, o framework já fez algo em seu nome que você provavelmente nunca imaginou: ele leu os bytes crus de dentro da conta e os desserializou num struct Rust novinho, parado na memória do seu programa. Desserializar é uma palavra polida para cópia. Ele percorreu o buffer da conta campo por campo e te construiu um Counter novo de fábrica que é seu.
Essa cópia é invisível e não é de graça. Ela custa unidades de computação, o medidor da Solana para trabalho on-chain. Toda instrução roda sob um orçamento de CU, e quando você passa dele o runtime mata a sua transação. A CU é a moeda desta lição inteira, então mantenha a imagem mental simples: mais cópia, mais CU, menos folga para a lógica de verdade que você queria rodar.
Quanta folga? Uma instrução sozinha recebe 200,000 CU por padrão, que é exatamente o of 200000 que você vai ver do lado direito daquela linha de log em um minuto. Você pode levantar o teto com uma instrução de compute budget, até um limite rígido por transação, mas você nunca ganha isso de graça e você está sempre gastando contra uma parede. Então a cópia é um imposto em cada acesso a conta, descontado do mesmo orçamento de que a sua lógica de negócio precisa, não um erro de arredondamento que você pode ignorar até doer. Num counter pequeno é um incômodo. Num programa que lê uma dúzia de contas gordas por chamada, é a diferença entre caber no orçamento e ser revertido.
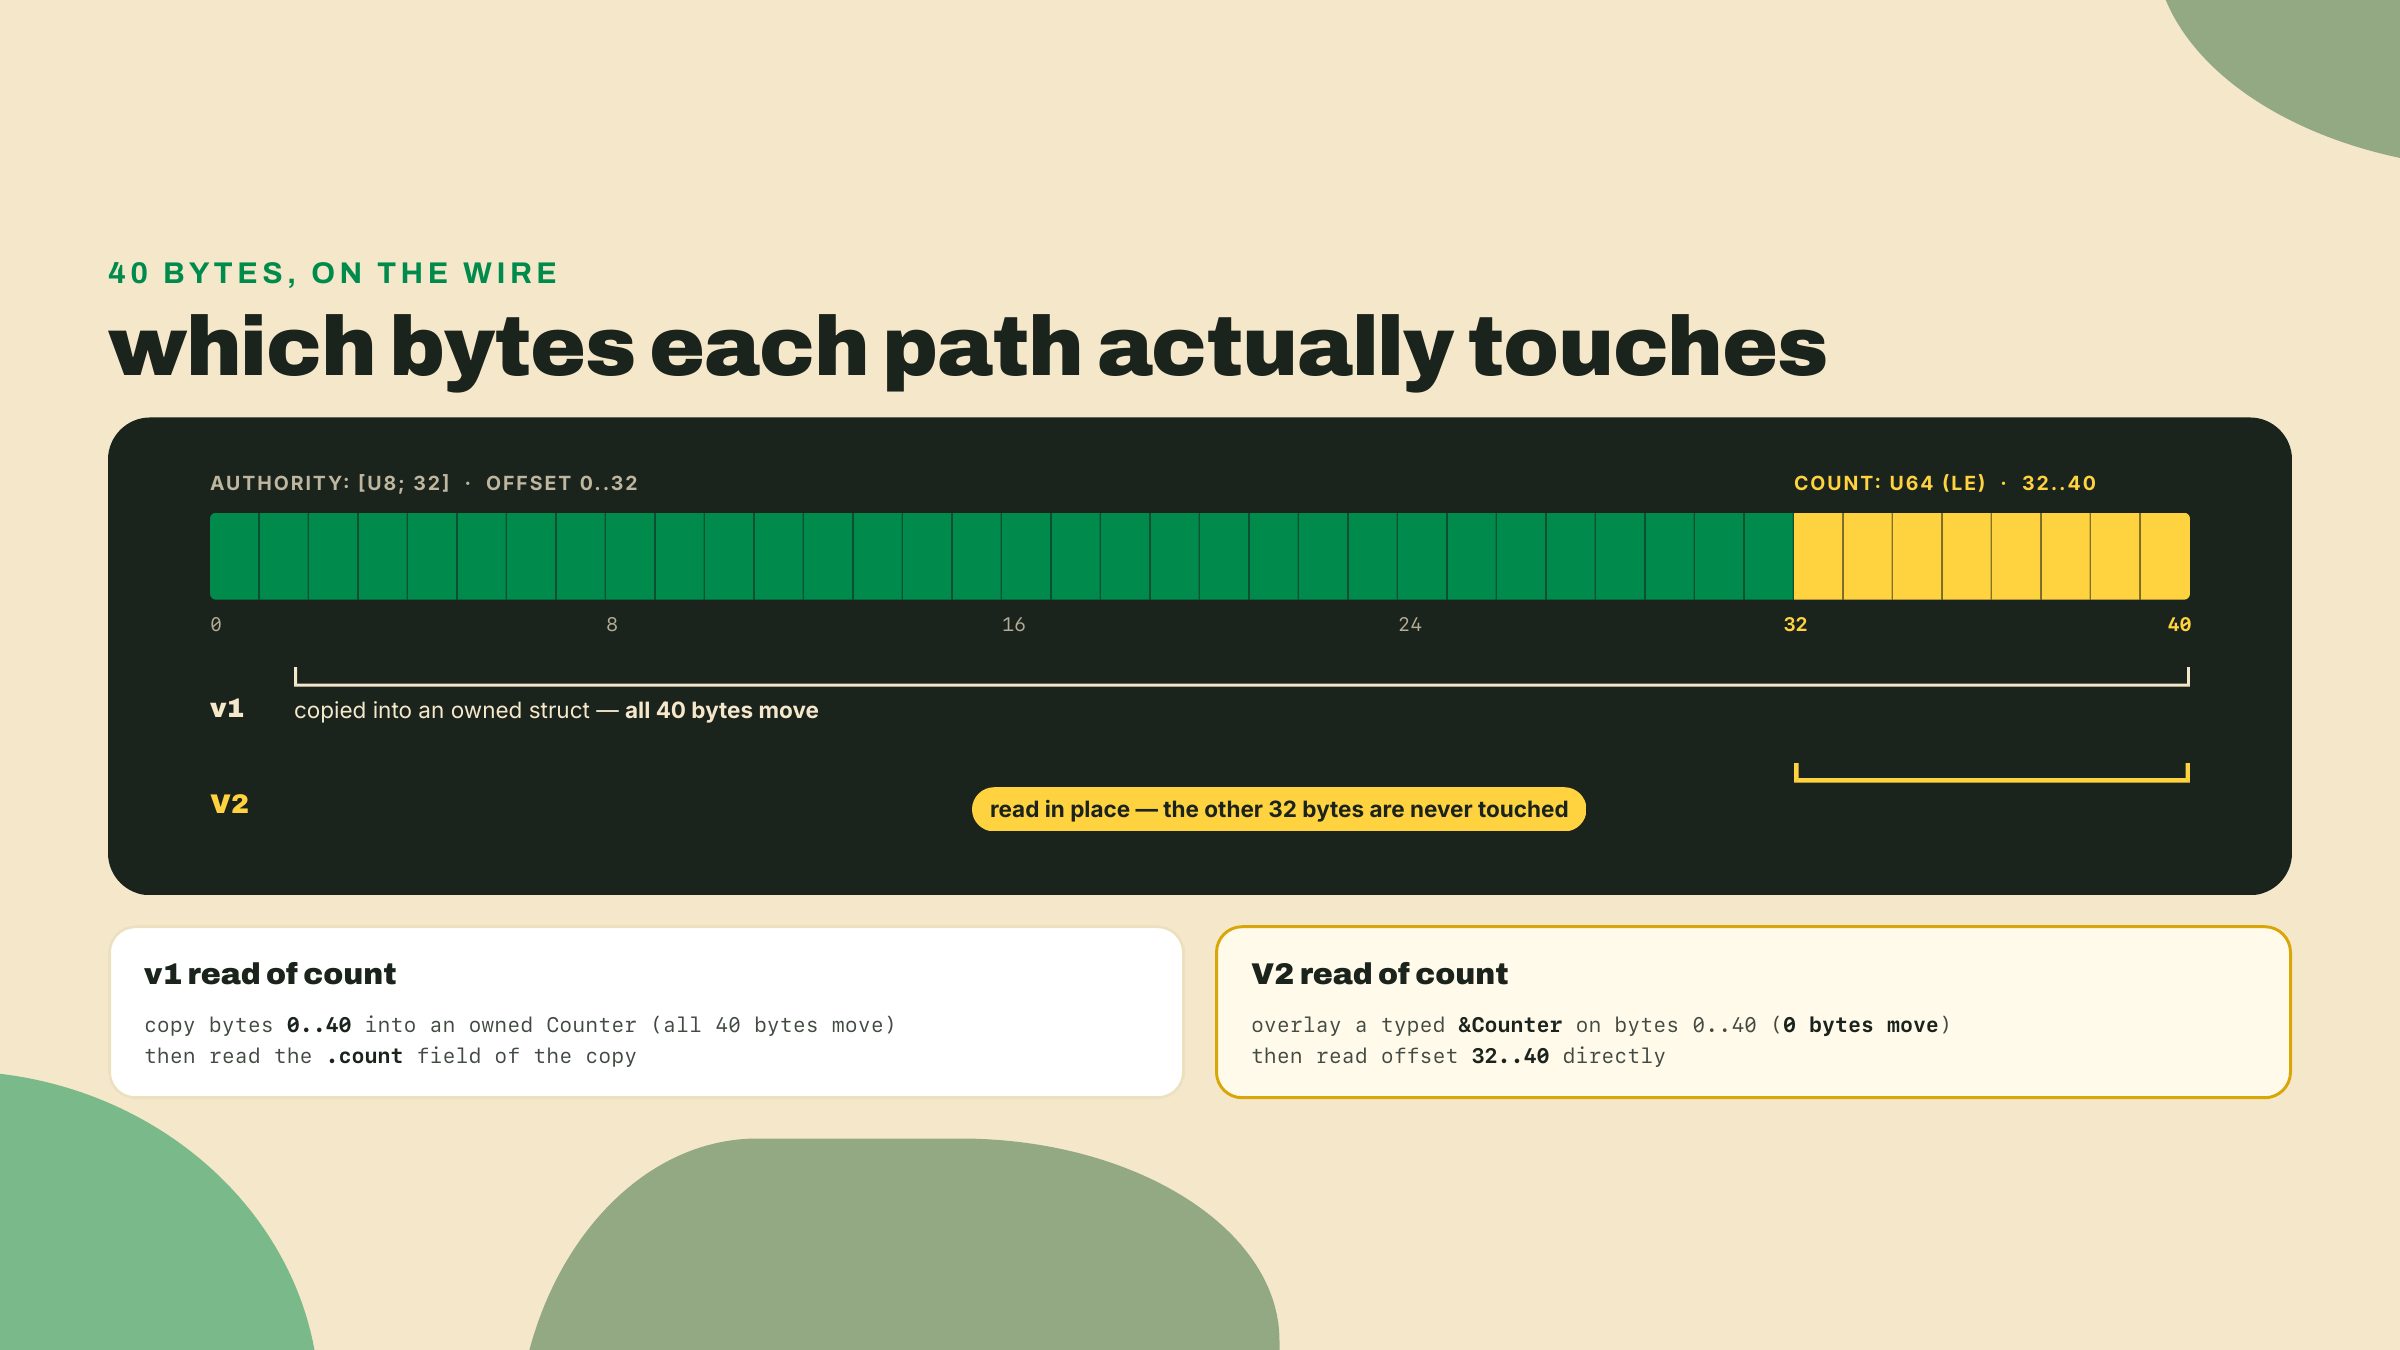
Deixa eu tornar a cópia concreta. Digamos que a sua conta é uma authority de 32 bytes e um counter de 8 bytes, 40 bytes no total. Aqui está como "desserializar" contra "ler no lugar" de fato se parece, em Rust puro que você pode rodar com nada além de rustc:
use std::mem::size_of;

#[repr(C)]
#[derive(Clone, Copy)]
struct Counter {
    authority: [u8; 32],
    count: u64,
}

fn main() {
    // A real account buffer: 32-byte authority, then a u64 counter = 40 bytes.
    let mut account = [0u8; 40];
    account[32..40].copy_from_slice(&7u64.to_le_bytes());

    // v1 shape: to read `count`, deserialize the WHOLE account into an owned
    // struct first. You copy all 40 bytes even though you wanted 8 of them.
    let owned = Counter {
        authority: {
            let mut a = [0u8; 32];
            a.copy_from_slice(&account[0..32]);
            a
        },
        count: u64::from_le_bytes([
            account[32], account[33], account[34], account[35],
            account[36], account[37], account[38], account[39],
        ]),
    };
    println!("v1 copied {} bytes to read count = {}", size_of::<Counter>(), owned.count);

    // v2 shape: read `count` straight out of the buffer, in place, no owned
    // struct, no 40-byte copy. This is the idea zero-copy generalizes.
    let count_in_place = u64::from_le_bytes([
        account[32], account[33], account[34], account[35],
        account[36], account[37], account[38], account[39],
    ]);
    println!("v2 read {} bytes in place: count = {}", size_of::<u64>(), count_in_place);
}
Rode e você vê o enquadramento em uma linha cada: 40 bytes copiados para chegar ao counter, contra ler o campo onde ele já está. Esse trecho redecodifica para ficar claro; o truque de verdade do V2 é mais afiado. Ele te entrega uma view tipada &Counter deitada direto sobre os bytes da conta, então ler qualquer campo é um deslocamento de ponteiro, não uma decodificação. Zero-copy quer dizer exatamente isso: zero cópias do buffer da conta. Os bytes na conta e o struct no seu código são os mesmos bytes.
Agora, a pergunta justa que um leitor cuidadoso faz: você já não podia fazer isso no Anchor que você conhece? Sim, mais ou menos. O Anchor antigo entregava um opt-in zero_copy exatamente para os casos de conta grande em que a cópia doía mais. E essa é precisamente a lição que os autores do V2 tiraram de anos de programas de verdade: um opt-in que resolve o custo comum só quando alguém lembra de pegar ele não resolve o custo comum. Quase ninguém pegou. Eu vou confessar a minha própria parte nisso. Eu já entreguei programas 0.x e nunca uma vez peguei o zero_copy, porque o Account<T> pelado estava ali e funcionava. Esse é o ponto todo. O default é o que se entrega em dez mil programas.
Percorra as correções ingênuas e veja elas falharem, porque o raciocínio é a parte interessante. Correção um: documentar o zero_copy melhor, escrever um guia bonito. Não muda nada, porque um default que ninguém tem motivo para sobrescrever continua sendo o default. Correção dois: adicionar um lint que te cutuca na direção do zero_copy em contas grandes. Mais perto, mas ainda deixa o caminho rápido como a estrada menos percorrida, e não faz nada pelas mil contas pequenas que copiam sem necessidade o dia inteiro. A única correção que de fato move o programa mediano é inverter qual caminho é o default. Então o V2 inverte. Zero-copy deixou de ser um modo especial que você pede; é o que o Account<T> é, e o opt-in que você agora pega, raramente, é a cópia.
Essa inversão tem um nome e um rastro de papel. A issue de design #4390 do Anchor é intitulada, sem enfeite, "Zero-copy account deserialization by default," e dentro dela o Account<T> de hoje é chamado de caminho lento e de reclamação de performance número um dos desenvolvedores do Anchor. A tese inteira do V2 cabe em um título de issue. Alguém olhou o tipo mais usado do framework e disse: a coisa que todo mundo toca é a coisa mais lenta, então faça a coisa rápida ser a coisa que todo mundo toca.
Essa frase, o caminho lento, é a linha condutora deste curso inteiro, então eu vou continuar usando ela. Todo degrau que você constrói daqui para frente é um pequeno argumento sobre se você está no caminho lento ou no rápido, e a resposta do V2 está embutida nos defaults que você herda de graça. Aqui está por que você deveria se importar além do direito de se gabar de um benchmark. Os seus programas ficam maiores. O counter vira um vault, o vault compõe com um escrow, o escrow chama um swap, e cada uma dessas chamadas lê contas. No caminho lento cada uma dessas leituras paga o imposto da cópia, e os impostos se acumulam até uma chamada que antes cabia no orçamento de repente não caber mais e começar a reverter em produção. No caminho rápido essa classe inteira de problema de "por que a minha CU subiu de fininho conforme eu adicionava features" é mais quieta por padrão. O que você ganha com isso é folga para gastar na coisa que você realmente queria construir.
Existe uma segunda ideia de design por baixo de tudo isso, e vale nomear ela mesmo que você não vá tocar nela até módulos mais adiante. O V2 é uma reescrita no_std do zero construída sobre o pinocchio. no_std quer dizer que ele abre mão da biblioteca padrão do Rust, a grande camada de runtime que a maioria dos programas assume, e em vez disso trabalha contra o bare metal do runtime da Solana. Menos maquinaria entre o seu struct e os bytes da conta é um pedaço de onde vem a economia. Você não precisa internalizar o pinocchio hoje. Você precisa saber que a economia é estrutural, não um truque.
Você vai querer um multiplicador de manchete. "O V2 é N vezes mais barato." Eu vou me recusar a te dar um congelado, e aqui está a história que explica por quê.
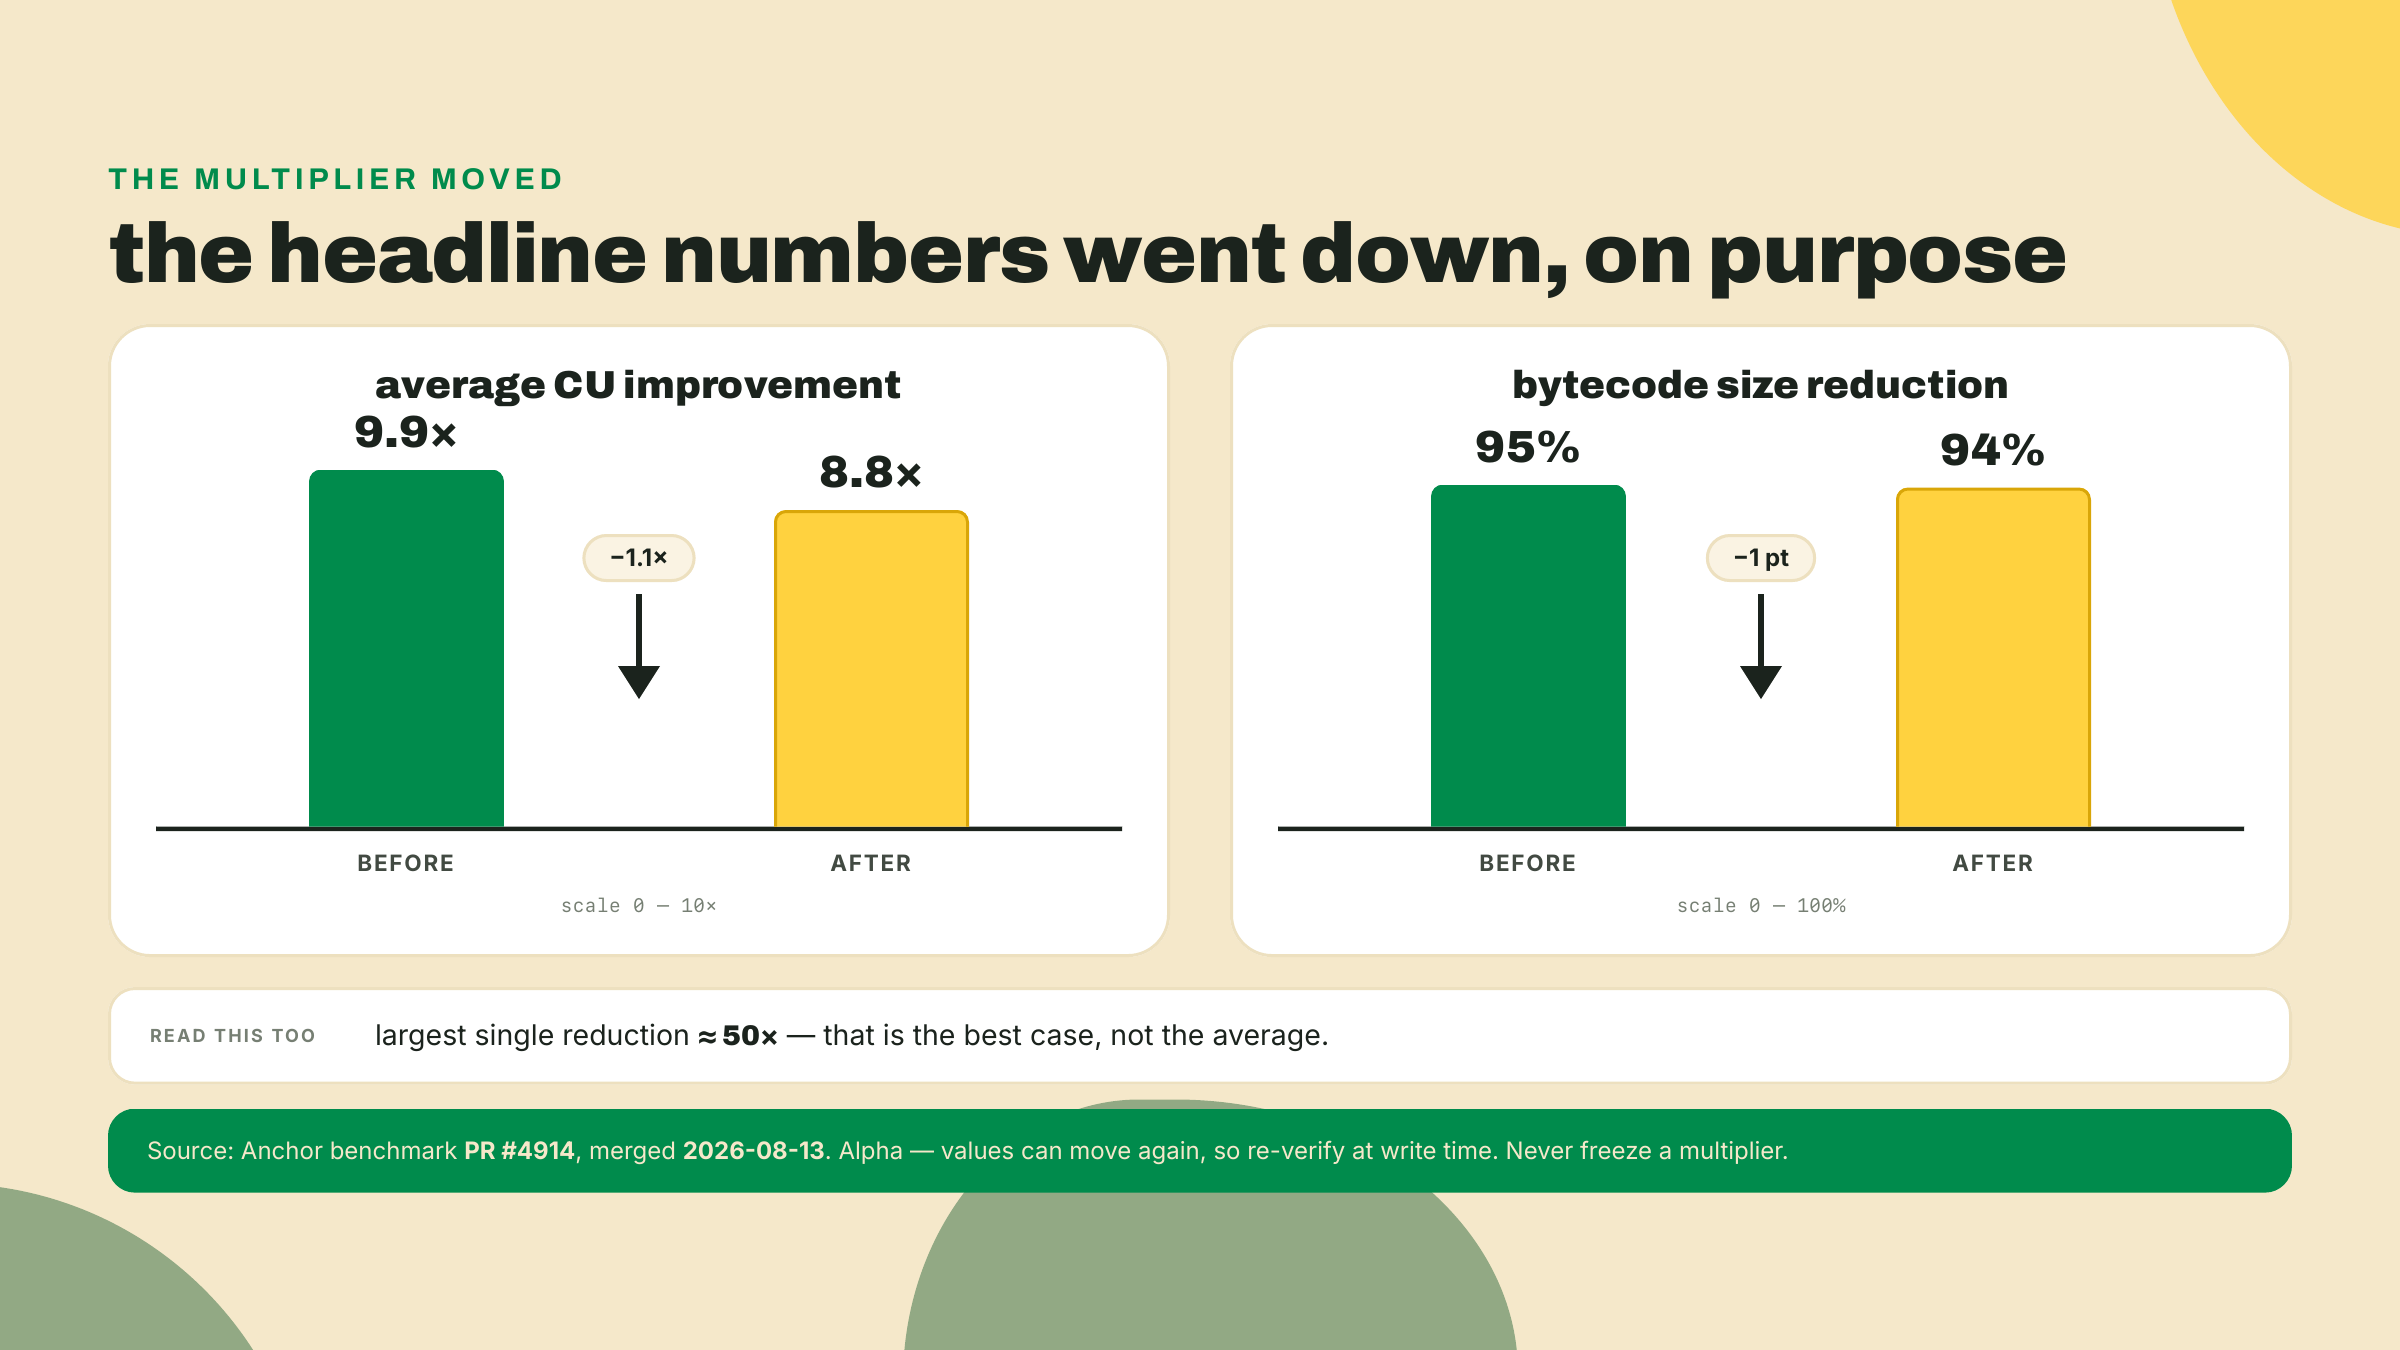
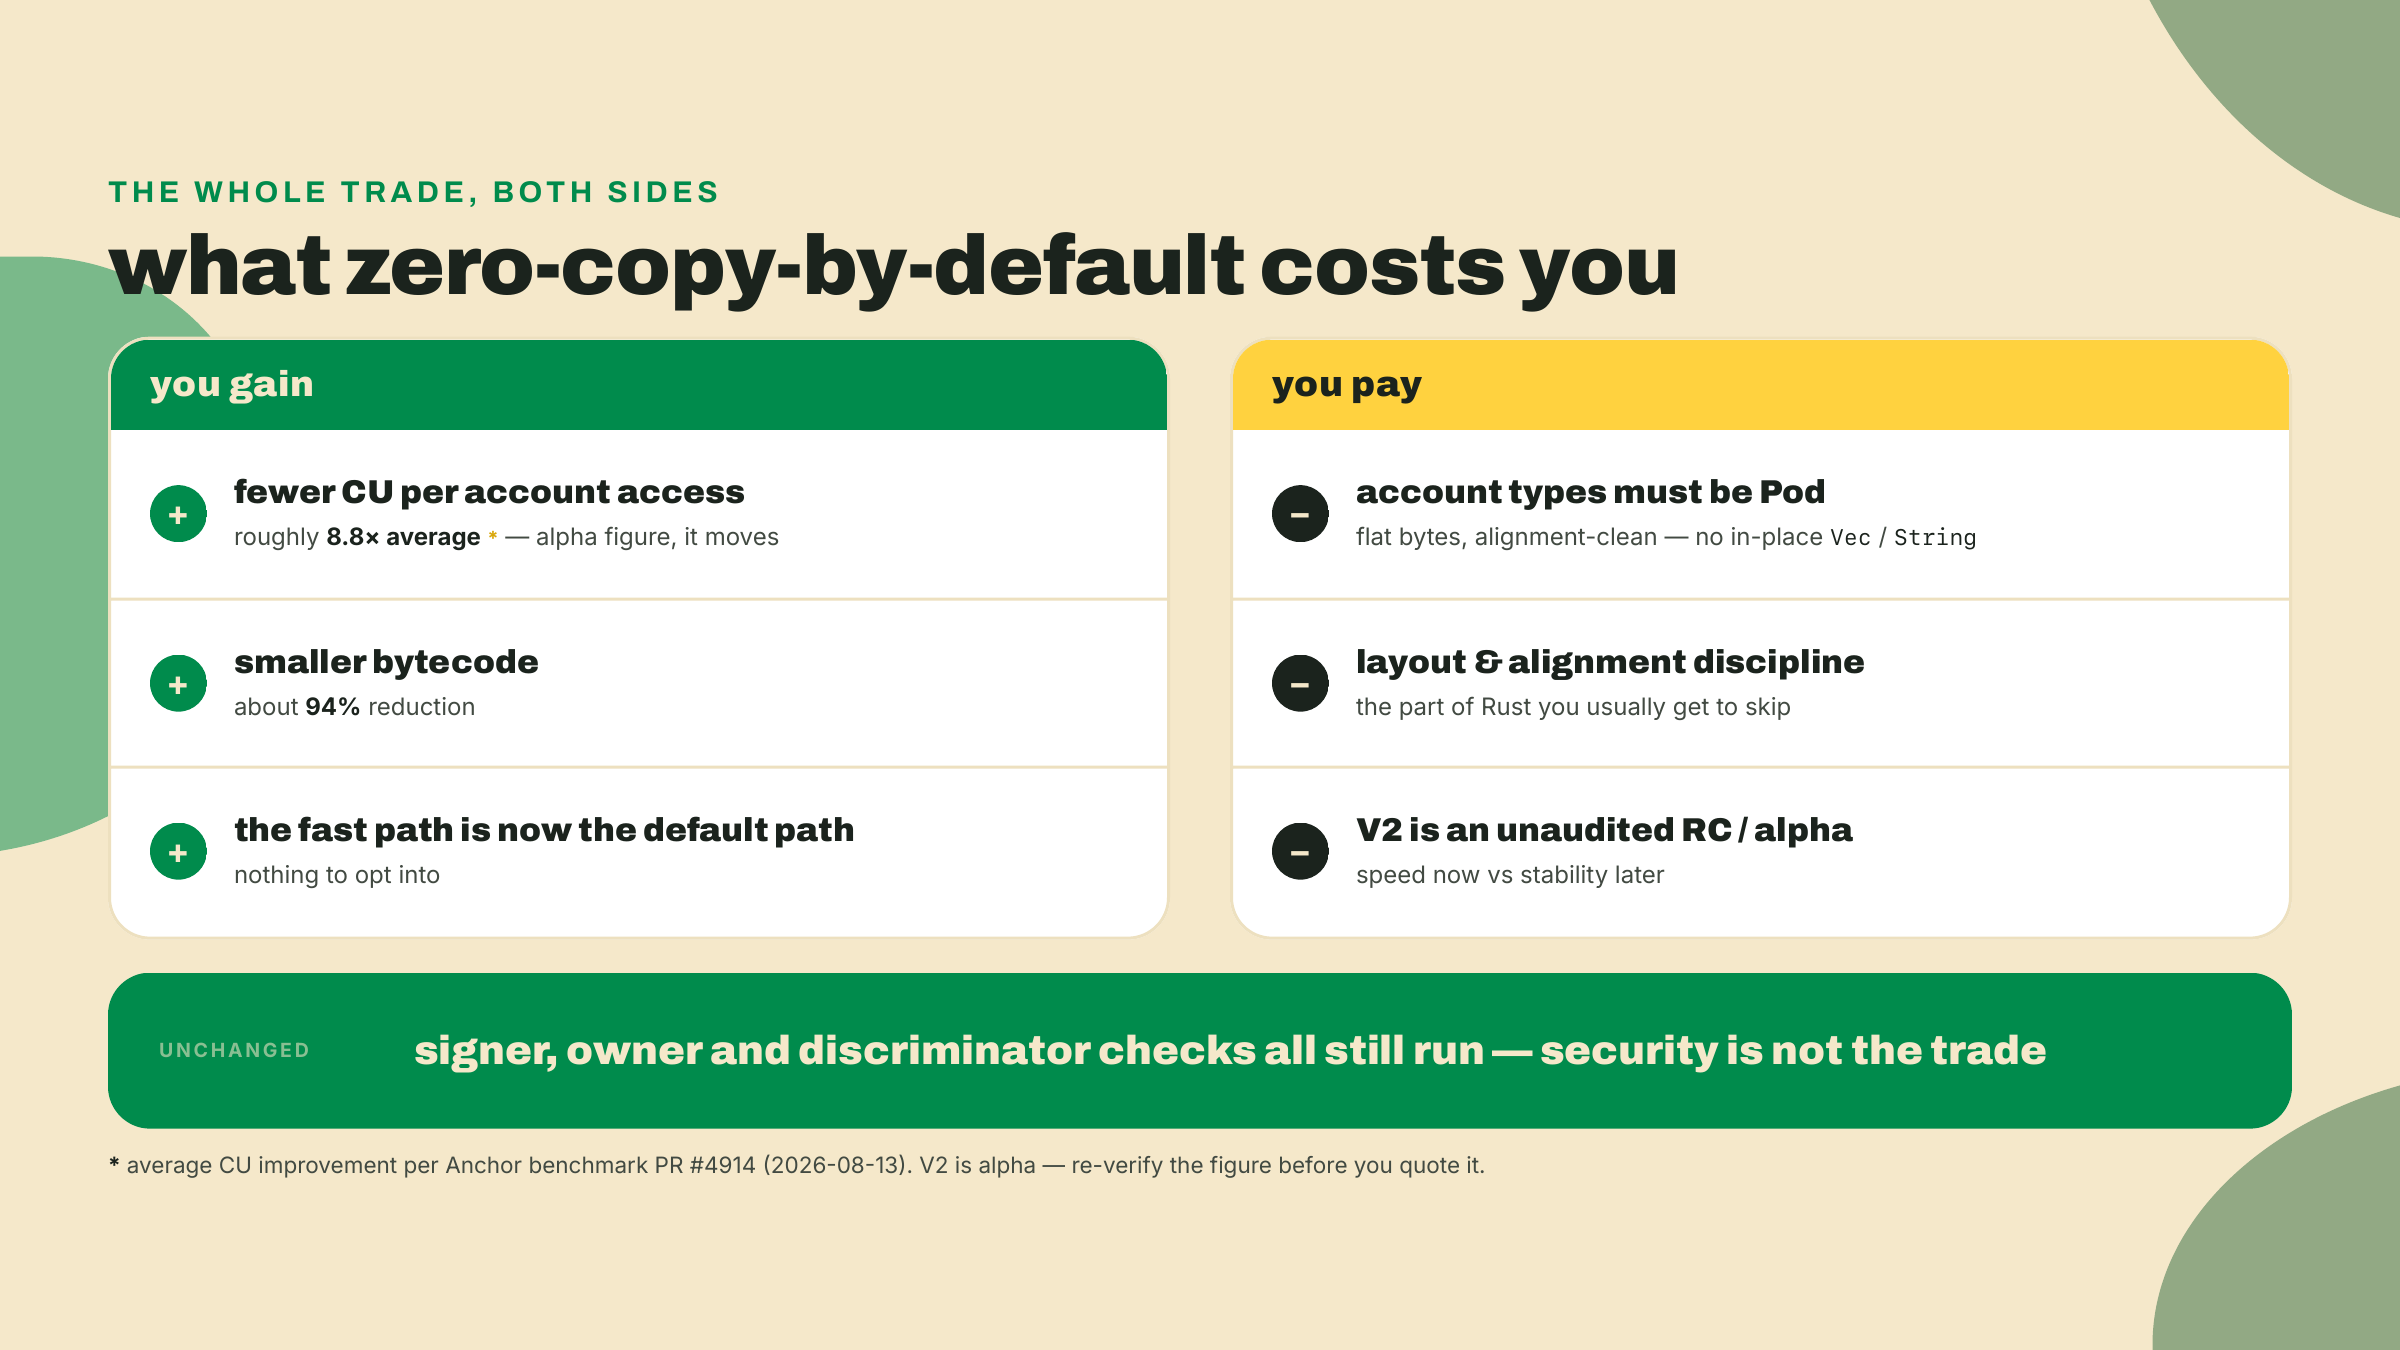
Os benchmarks do V2 originalmente anunciavam afirmações grandes e redondas. Então, em 2026-08-13, o PR de benchmark #4914 entrou e revisou os números de manchete para baixo: a afirmação sobre o tamanho do bytecode foi de 95% para 94%, e a melhora média de CU foi de 9.9x para 8.8x. Isso não é uma retratação para ter vergonha. Isso é um mantenedor olhando o marketing dele mesmo e fazendo ele casar com as medições. A maior redução isolada desse conjunto é de uns 50x, mas esse é o melhor caso, não a média, e citar o melhor caso como o caso típico é exatamente o tipo de coisa que o PR #4914 estava corrigindo.
Então o formato honesto da coisa, na revisão de 2026-08-13: mais ou menos 8.8x de redução média de CU, mais ou menos 94% de bytecode menor. Os dois são números alpha num framework alpha, e os dois podem se mexer de novo antes de você ler isto. Trate qualquer multiplicador isolado como um retrato com uma data em cima, nunca como uma promessa. Essa é a cilada número um, e é o motivo de o seu Lab não te entregar um número para decorar. Ele te entrega um comando solana confirm para você medir a diferença nos programas de verdade, hoje, você mesmo.
Mais dois fatos com o pé no chão, para você saber o chão em que está pisando. Primeiro, o trade-off, porque eu não vou te vender velocidade sem a conta. O zero-copy por padrão compra a vitória em CU, mas impõe uma disciplina que desenvolvedores Rust normalmente conseguem pular. Os seus tipos de conta têm que ser Pod, plain-old-data: bytes de layout fixo, com alinhamento limpo e nenhum ponteiro escondido dentro. Isso descarta jogar um Vec ou uma String direto dentro de uma conta e esperar que simplesmente funcione, porque esses tipos não são bytes planos, são um comprimento e um ponteiro para outro lugar no heap, e não existe heap dentro de uma conta.
Torne isso concreto. Um placar que você modelaria em Rust normal como Vec<Score> não entra numa conta Pod como está escrito. Você o remodela: um array de capacidade fixa mais um comprimento, dimensionado de antemão. Isso é mais premeditação do que o Vec te pede, e às vezes um teto fixo genuinamente não serve para o problema. O V2 mantém uma saída de emergência exatamente para esses casos, um tipo de conta baseado em borsh para quando o Pod não basta, e você o encontra no próximo módulo, na lição sobre quando o Pod acaba. Por enquanto, só registre o formato da conta: você troca um pouco de liberdade em tempo de execução pela vitória em CU, paga adiantado em disciplina de layout. E o V2 em si é um release candidate não auditado, de grau alpha. RC quer dizer release candidate, os mantenedores acham que está perto de pronto. Alpha quer dizer trate como cedo e em movimento, independente do rótulo. Velocidade agora contra estabilidade depois é uma escolha de verdade, e este curso mantém isso honesto em cada degrau em vez de fingir que o RC é à prova de produção.
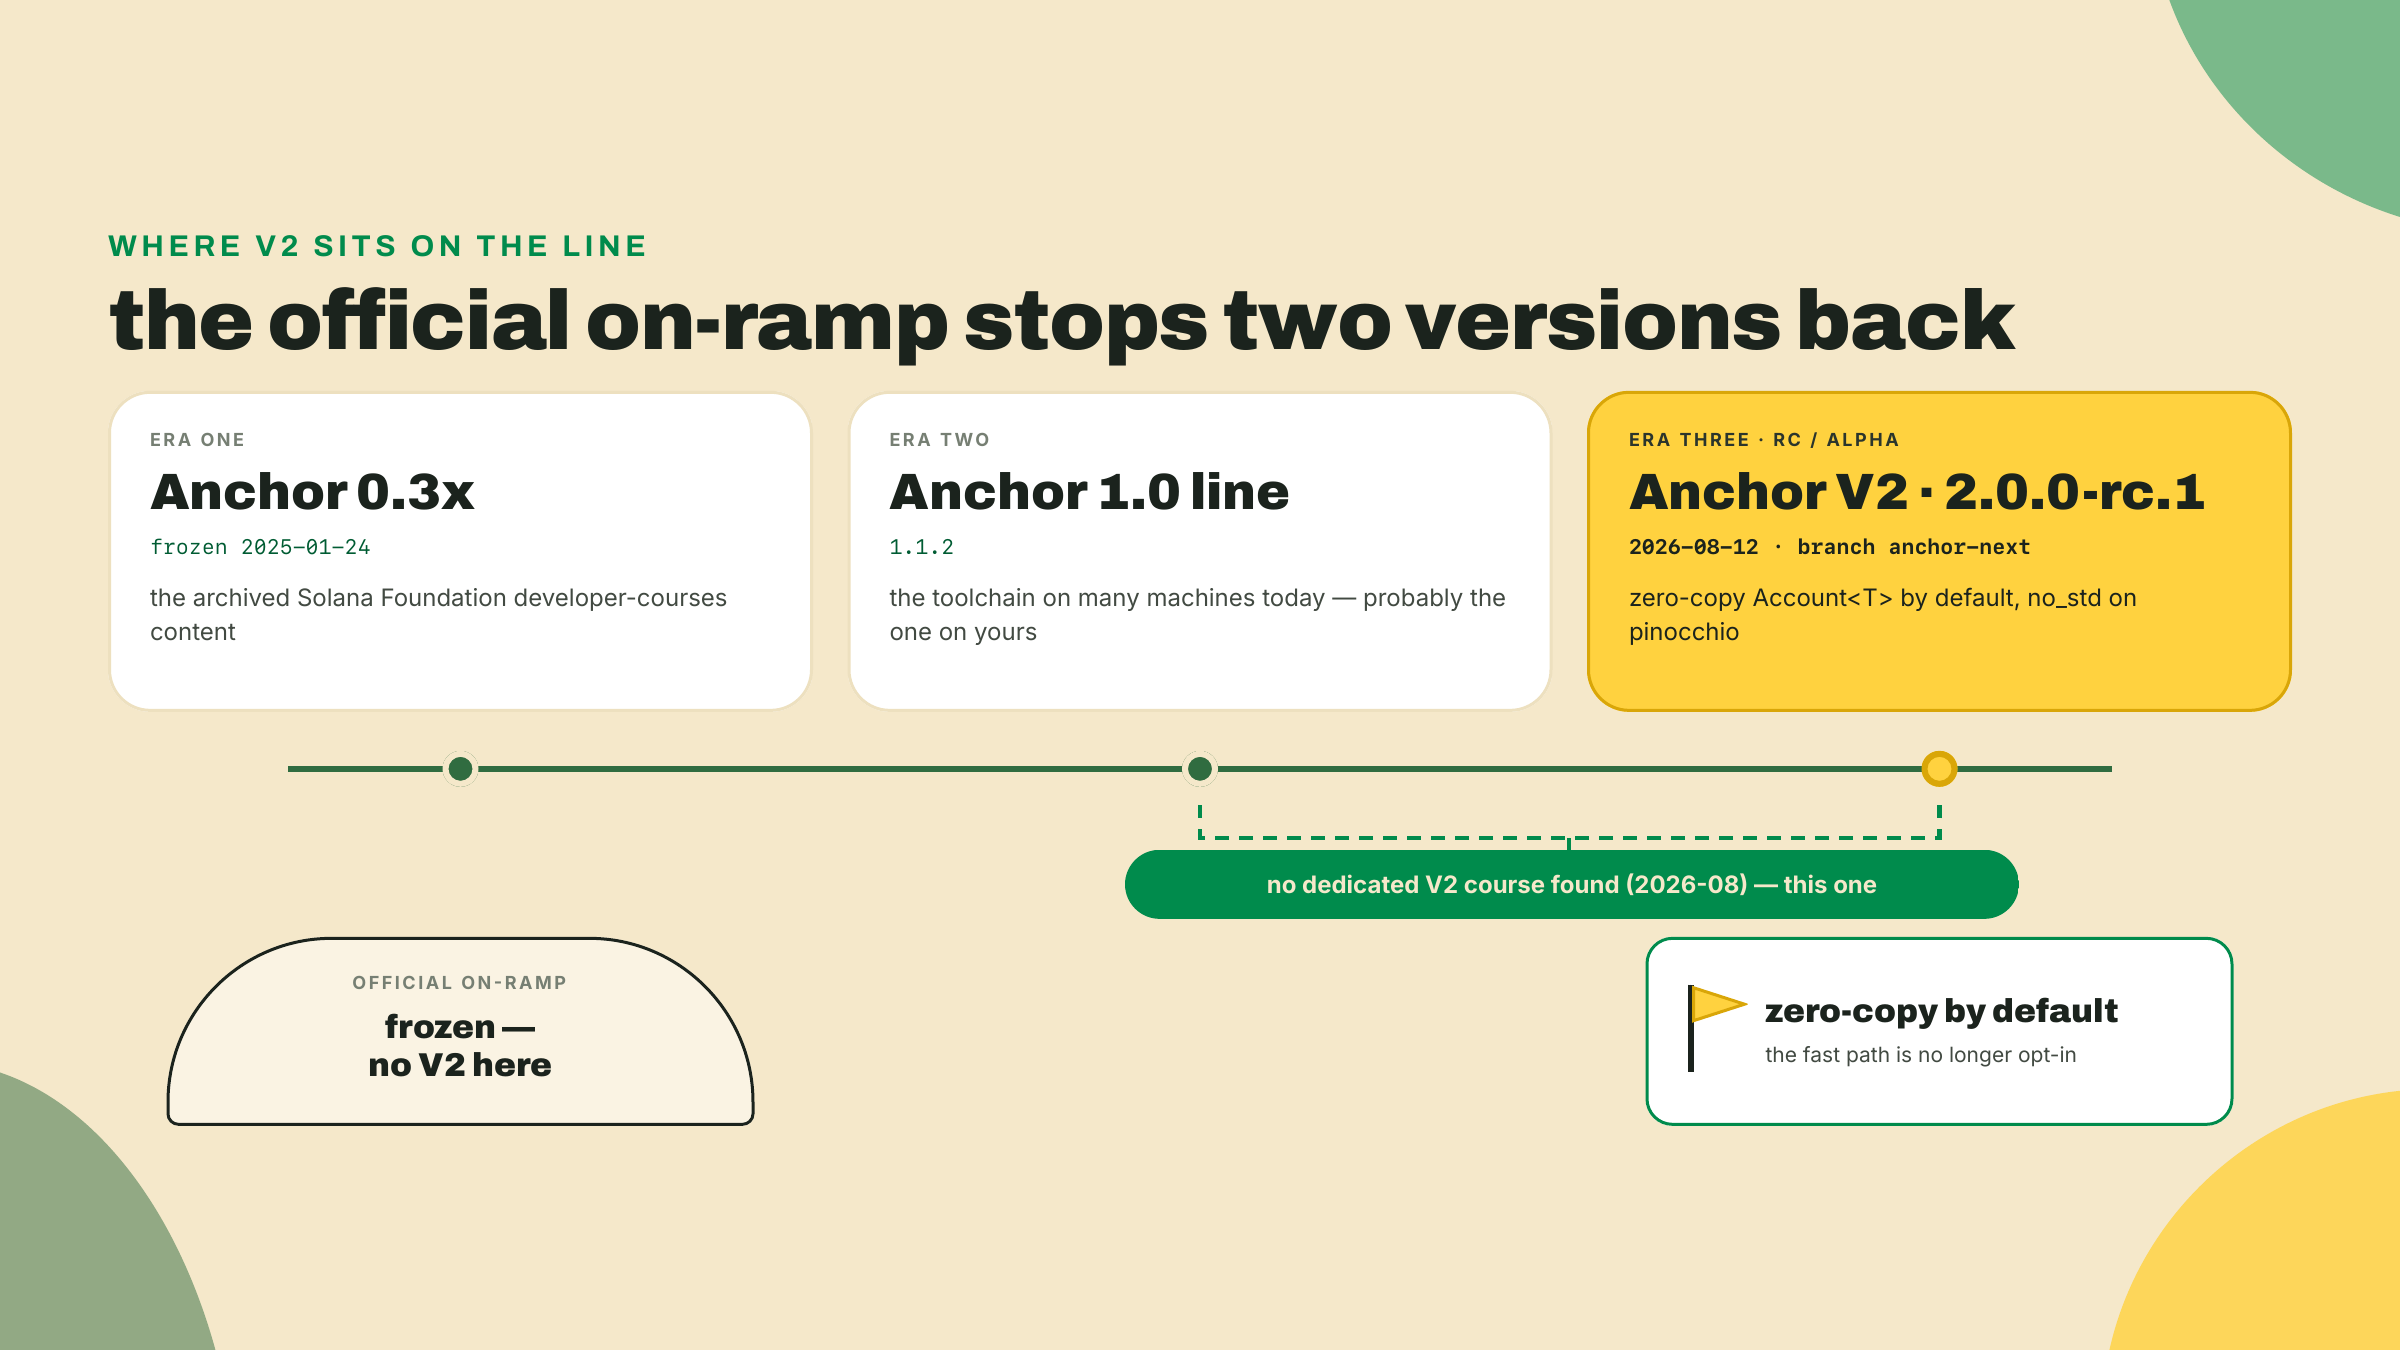
Segundo, por que este curso existe, afinal. Em agosto de 2026 eu fui procurar um curso dedicado de Anchor V2 ou um guia longo, e não achei nenhum. Não "não existe nenhum," eu não consigo comprovar uma negativa, mas uma busca de verdade não trouxe nada. O caminho oficial de cursos para desenvolvedores da Solana Foundation é pior que vazio: ele agora redireciona para um repositório de conteúdo arquivado, congelado em 2025-01-24, Anchor mais ou menos da era 0.30, um túmulo com uma lápide bonita. Então isto não está competindo com a rampa de entrada. Está substituindo uma que parou de respirar.
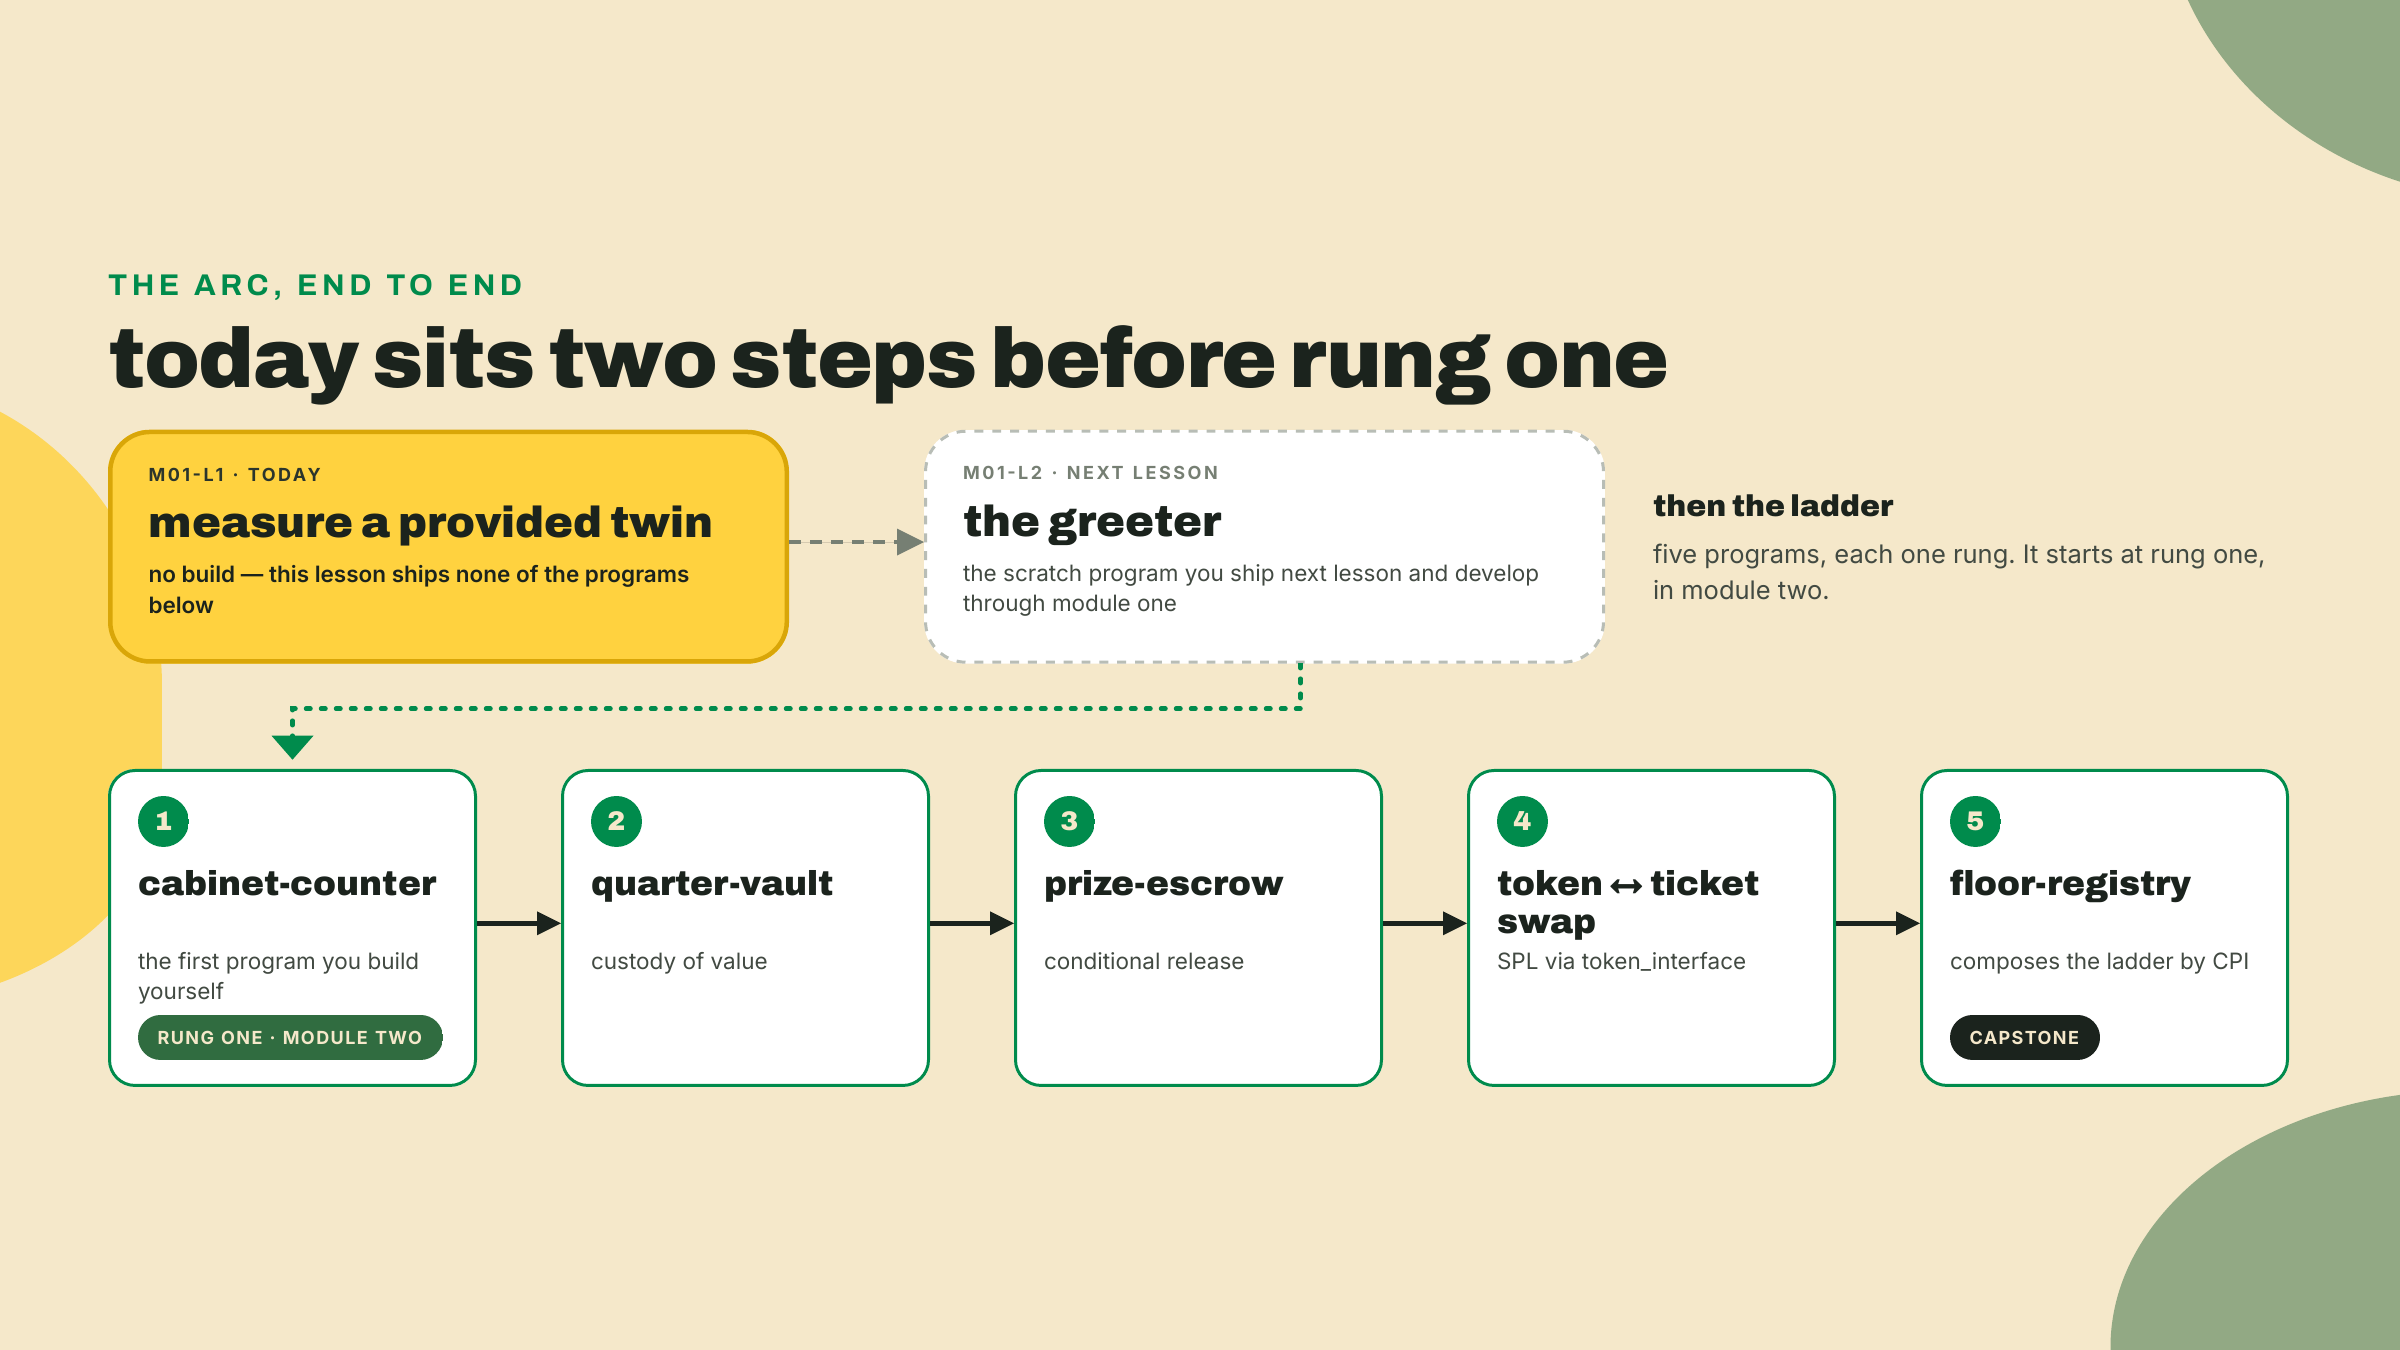
Antes do Lab, olhe a estrada. Você não vai construir gêmeos. Você vai construir um fliperama. O domínio do curso é uma economia de token de um barcade retrô chamada Quarters, e ao longo dos módulos você escreve uma escada de programas de verdade: primeiro um cabinet-counter, depois um quarter-vault que guarda valor, um prize-escrow, um swap de token para ticket, e um floor-registry capstone que compõe a escada inteira por CPI. Todo degrau é Rust contra o V2 RC. Os degraus que encaram o cluster são entregues na devnet — o greeter de rascunho, o swap de token para ticket, o floor capstone — e os que ficam no meio se comprovam em processo, sob a bancada de teste que você levanta no módulo dois. Esta lição é o único degrau que você não constrói você mesmo, para você sentir o destino antes de dar o primeiro passo.
Mãos no teclado agora. Esta é a parte que você não pula. Sem instalação: tudo aqui roda na CLI solana que você já tem, apontada para a devnet. Os dois IDs de programa dos gêmeos e as assinaturas de transação de referência deles estão fixados aqui mesmo no passo 1 — aterrissados na devnet e verificados em 2026-09-02, na disciplina de freshness deste curso — e os seis passos rodam exatamente como escritos.
A jogada que você vai usar é solana confirm -v <SIGNATURE>, que imprime as mensagens de log completas de uma transação. Enterrada nesses logs está uma linha que o runtime escreve para todo programa que ele roda: Program <id> consumed X of Y compute units. Aquele X é a leitura do medidor. É essa a medição inteira.
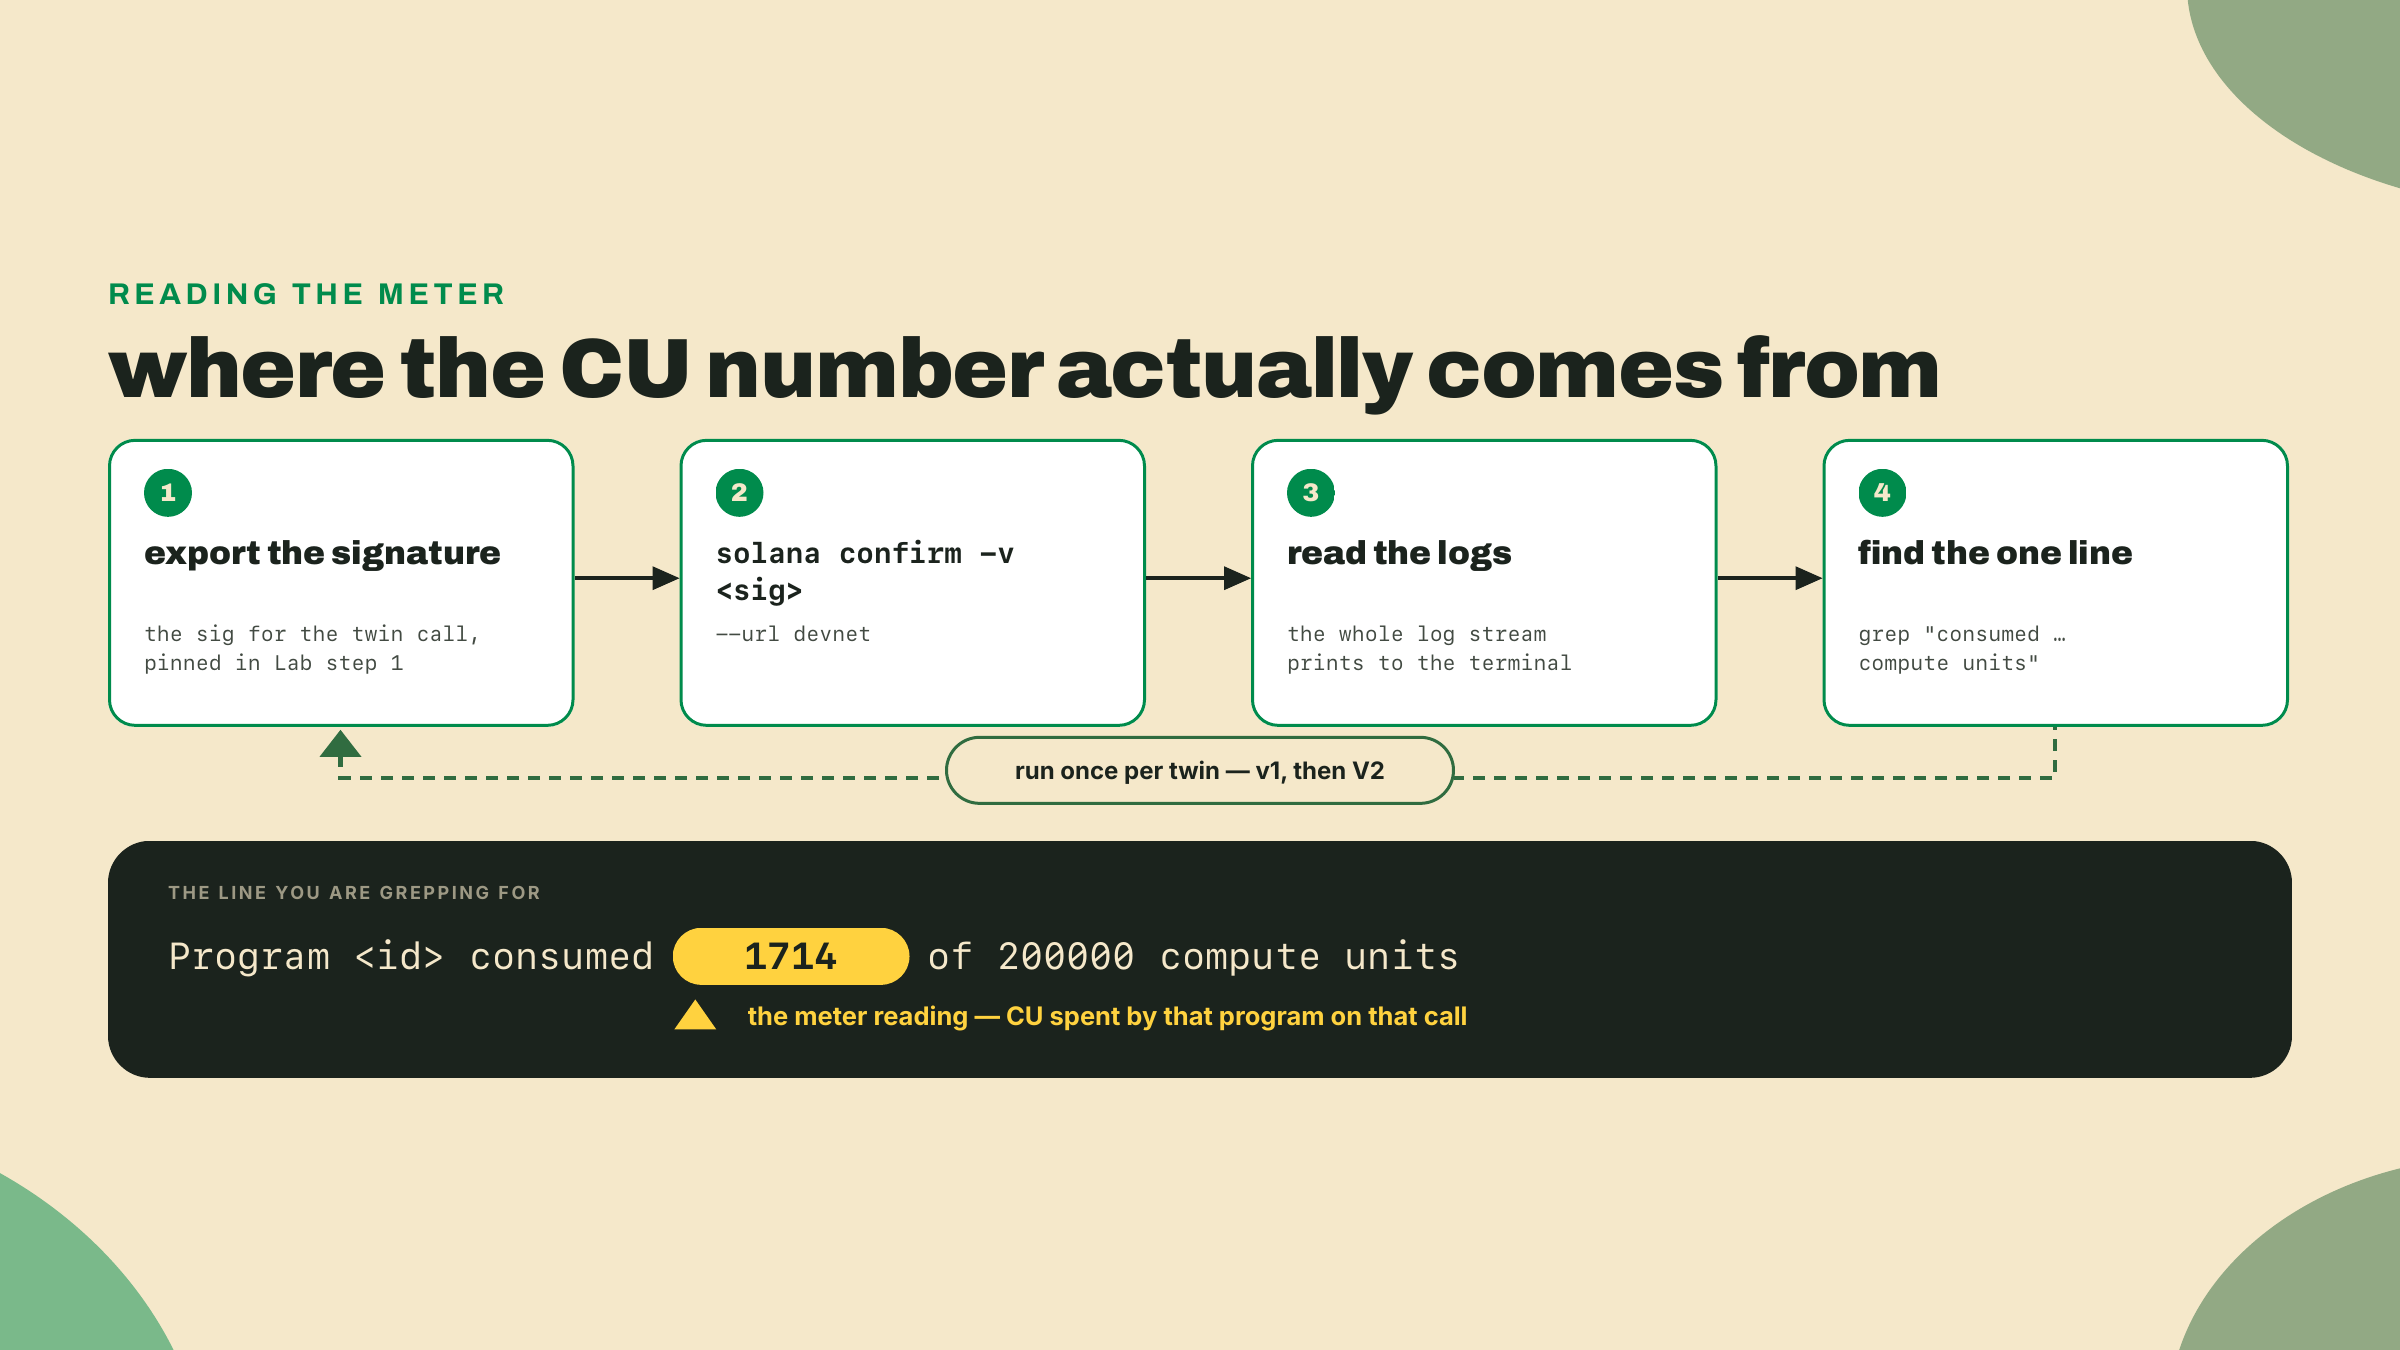
Aponte para a devnet e ponha os pins. Exporte todos os quatro valores. Estes são os gêmeos que eu aterrissei para você, verificados em 2026-09-02. Se você quiser conferir que os programas realmente receberam deploy, solana account "$V1_TWIN_ID" --url devnet mostra cada um como uma conta executável.
export V1_TWIN_ID="8bhX52w9mGGaAFJwsoWLpv3nrZsXzc3ZfE2P622uGt3z"
export V2_TWIN_ID="2fLbW1PG2CeyAgR5krLF9okkqCXRmqy1o3srBh4E26WT"
export V1_TWIN_SIG="2BYB5oU12EfJjPTuQjaZCcxwMjWxSBUQ7WjeucW6V35Ge1PRFUda39nV4dU8NnDvt8ZfbN8H4fpAEoYpsEYysR43"
export V2_TWIN_SIG="43beWNMwXpC24VqRf2uVspVDgBgKEMG75brR7LMeLeH3EcuLa9NVibJb9JAGqbe8pUDckPhtTqKRFhuzDtoZpCRs"
Leia o medidor do gêmeo v1. Confirme a transação de referência dele e puxe a linha de compute units:
solana confirm -v "$V1_TWIN_SIG" --url devnet | grep -i "compute units"
O meu imprimiu duas linhas — o grep que ignora maiúsculas e minúsculas pega o resumo da própria CLI além da linha de log do runtime — e a assinatura de referência repete a mesma leitura para você:
Compute Units Consumed: 1714
  Program 8bhX52w9mGGaAFJwsoWLpv3nrZsXzc3ZfE2P622uGt3z consumed 1714 of 200000 compute units
Sempre que esse par for reaterrissado — pelos mantenedores depois de um reset da devnet, ou por você mais adiante no curso sob a sua própria carteira — o número exato vai diferir; o formato não. Anote o consumed X do gêmeo v1 — é a mesma leitura que a abertura te fez tirar.
Se o grep voltar vazio, conserte isso antes de seguir. Três causas de sempre, na ordem em que você deve conferir. Você está apontado para o cluster errado, então reconfira o --url devnet. Ou o export foi mutilado na colagem, então o shell está segurando uma assinatura truncada. Ou, se o solana confirm reportar a assinatura como não encontrada em vez de imprimir logs vazios, a transação de referência envelheceu e saiu do histórico de transações da devnet, que é podado e não guarda assinaturas velhas para sempre. Essa terceira é a disciplina de freshness deste curso mordendo o próprio curso, e a recuperação já vem nesta mesma página: a saída de log esperada para os dois gêmeos está impressa nos passos 2 e 4, então a medição ainda aterrissa — e uma assinatura podada é exatamente o tipo de pin desatualizado que este curso te treina a sinalizar, então reporte e os mantenedores reaterrissam o par e fixam esses quatro valores de novo. Um resultado em branco aqui é um problema de setup, não um problema seu.
Pare e preveja. Antes de rodar o gêmeo v2, se comprometa com uma resposta em voz alta ou no papel: qual gêmeo você espera que consuma menos CU, e mais ou menos quanto? Você tem a tese e você tem o contexto da média honesta de 8.8x. Faça a chamada agora. Prever antes de olhar é como você descobre se você entendeu a visão geral de verdade ou só concordou com a cabeça.
Leia o medidor do gêmeo v2. Mesma chamada, programa gêmeo:
solana confirm -v "$V2_TWIN_SIG" --url devnet | grep -i "compute units"
Para registro, a leitura de referência, no mesmo formato de duas linhas:
Compute Units Consumed: 200
  Program 2fLbW1PG2CeyAgR5krLF9okkqCXRmqy1o3srBh4E26WT consumed 200 of 200000 compute units
Anote o consumed X do gêmeo v2.
Calcule o delta. Subtraia e tire a razão. Dois números de verdade de dois logs de verdade na mesma devnet, fazendo o mesmo trabalho com as mesmas contas. O número do v2 deve ser materialmente mais baixo. Se a sua razão medida cai perto da vizinhança da média de 8.8x ou em outro lugar, isso é o ponto de medir em vez de decorar: você agora segura um número com a data de hoje em cima, não um slogan.
Não se assuste se a sua razão não for 8.8x. Ela não deveria ser, exatamente, e isso é saudável. O 8.8x é uma média ao longo de uma suíte de benchmark, e a vitória escala com quanta cópia o programa estava fazendo em primeiro lugar: um programa que lê contas grandes, ou lê elas muitas vezes por chamada, economiza proporcionalmente mais que um programa que encosta de raspão em uma conta pequena. Os gêmeos são deliberadamente simples, então a sua razão reflete uma chamada simples. Um multiplicador congelado teria escondido isso. A sua medição mostra.
Diagnostique antes de seguir lendo. Em uma frase, nomeie a causa raiz da diferença. Não espie o próximo parágrafo até ter escrito ela.
Aqui está a resposta, para você conferir a sua. O gêmeo v2 gasta menos CU porque o Account<T> do v1 desserializa, isto é, copia, os bytes da conta para um struct em cada acesso, enquanto o V2 faz cast dos mesmos bytes no lugar e lê eles onde eles estão. Essa é a cilada número dois antecipada: a vitória não é que o V2 pulou alguma checagem. Os dois gêmeos rodaram a mesma validação de signer, owner e discriminator. Um discriminator é a pequena tag que o Anchor escreve na frente de uma conta para que um load possa rejeitar o tipo de conta errado de cara; você deriva um na mão em m01-l4. Abrir mão disso seria uma regressão de segurança, não uma otimização. A economia são as cópias que não estão mais acontecendo, nada mais e nada menos.
A trava desta lição é pequena e está inteiramente nas suas próprias palavras. Em três pedaços curtos:
Se a sua frase única aterrissar em "o V2 faz cast dos bytes da conta no lugar em vez de copiá-los para um struct em cada acesso," você tem a tese deste curso inteiro numa forma que você consegue defender. Se ela aterrissar em "o V2 é mais rápido porque pula checagens," volte e releia o passo seis do Lab, porque essa é exatamente a leitura errada que o design tomou cuidado para não fazer.
Em vez de ler uma afirmação sobre unidades de computação, você tirou uma leitura, duas vezes, em programas que outra pessoa já entregou, e você atribuiu a diferença a uma decisão de design específica em vez de a um achismo. É esse o músculo que o curso inteiro treina: medir, depois explicar, depois nunca congelar um número que se move.
Você sentiu a diferença rodando os gêmeos de outra pessoa. Na próxima lição você para de pegar emprestado e começa a entregar. Você instala o toolchain do V2, o que genuinamente briga com você, um RC com arestas afiadas e uma solução de contorno ou duas, e você empurra o seu primeiro deploy para a devnet: o greeter R0. Os R-números são como este curso nomeia os degraus da escada Quarters — R1 até R4, com o floor-registry capstone no topo — e o R0 é o que fica abaixo do degrau mais baixo: o programa de rascunho que comprova o seu toolchain, que você então continua estendendo pelo resto do módulo um. O primeiro degrau de verdade, o cabinet-counter, vem no módulo seguinte. O acompanhamento começa a afinar a partir dali. Traga o terminal.
Pergunta 1 de 3