Carregando...

 BetaBeta
Resumo. No V1, no instante em que o seu programa guarda um u64 de verdade, o Anchor cobra um imposto de desserialização em cada load: ele percorre os bytes da conta e reconstrói uma struct Rust na pilha antes mesmo do seu handler rodar. O V2 apaga esse passo. Account<T> agora é uma janela tipada direto sobre os bytes crus da conta, então ler um campo é um cast de ponteiro, não um decode. Você paga essa velocidade em disciplina de layout: todo campo tem que ser um tipo plain-old-data, e nenhum preenchimento escondido é permitido. Esta lição constrói o R1, o cabinet-counter, para você sentir exatamente onde essa conta cai.
Em m01-l4 você leu o que #[derive(Accounts)] de fato gera: a ordem load-then-constraints-then-dispatch, os discriminators sha256, o layout de erros. Você rodou isso no R0, o greeter, e deu a ele uma conta Marquee de um campo só para ter uma superfície de observação. O R0 fica onde está; ele cumpriu o papel dele. O que aquela lição fechou foi a promessa de que a disciplina de layout por trás do plays: u64 puro do Marquee, que já era um campo Pod legal sem você perceber, para de ser invisível agora. O estado que você guarda de verdade começa aqui, num programa novo. A variante #[event(bytemuck)] ficou estacionada com um bilhete: "espere até Pod existir." Pod chega nesta lição, e a próxima cobra essa promessa.
Então vamos fazer ele existir para você nos próximos dois minutos, nenhum toolchain novo: o RC do V2 que você construiu a partir do git lá em m01-l2 é o que compila tudo isto. Confirme que o PATH ainda está servindo ele antes de digitar qualquer coisa, porque a sua máquina também carrega a linha estável 1.x e o modelo de contas abaixo se comporta de outro jeito nela:
which anchor       # ~/.cargo/bin/anchor either way — the avm shim lives at the same path, so this only proves it's on PATH
anchor --version   # the real check: expect the v2 line, not 1.1.2
Não se apoie no which para distinguir o shim da instalação via git: o shim do avm é ~/.cargo/bin/anchor (um link para ~/.avm/bin/avm), e o build via git escreve o mesmo caminho, então os dois são indistinguíveis pela localização. A linha de versão é a única checagem capaz de pegar o toolchain errado.
O R1 é um programa novo, então gere o scaffold dele ao lado do greeter:
anchor init cabinet-counter
cd cabinet-counter
Dependências primeiro, e um scaffold novo precisa de mais de uma. O derive de Pod em que você está prestes a se apoiar é checado pelo bytemuck, que o scaffold não puxa — e o scaffold também não tem os pins de wincode/solana-address de m01-l2, então construir ele como está morre na expansão de #[program] com o mesmo E0433 que aquela lição te ensinou a esperar. Abra programs/cabinet-counter/Cargo.toml, mude a linha git de anchor-lang do scaffold para a versão do crates.io, e faça [dependencies] ficar assim:
anchor-lang = "2.0.0-rc.1"
bytemuck = "1.25"
wincode = { version = "0.5", features = ["derive"] }
solana-address = ">=2.6.1, <2.7"
O passo 1 do lab volta em cada uma dessas linhas e explica por que ela está do jeito que está — incluindo por que aquele último pin é um teto e não a igualdade =2.6.0 que m01-l2 usou. Por ora elas só precisam existir para que o build possa.
Agora abra programs/cabinet-counter/src/lib.rs e adicione esta struct abaixo do Counter gerado, deixando o resto do scaffold em paz por enquanto. PodU64 vem do anchor_lang::prelude::* que o scaffold já importa; é o wrapper que esta lição passa a seção do meio derivando, e nos próximos dois minutos você pode ler ele como "um u64 que é seguro fazer cast a partir de bytes":
#[account]
#[repr(C)]
pub struct Cabinet {
    pub play_count: PodU64, // 8 bytes
    pub high_score: PodU64, // 8 bytes
}
Depois faça o build:
anchor build
Resultado esperado: compila. Agora quebre de propósito. Mude high_score para um pub high_score: bool puro e faça o build de novo. Resultado esperado: um erro de compilação dizendo que bool não satisfaz o bound Pod. Dois campos que aceitam cast de bytes compilam; um campo que não aceita cast de bytes impede o programa de existir. Essa recusa é a tese inteira do V2 aparecendo como mensagem de compilador, e o resto desta lição é por que esse é um bom negócio. Ponha PodU64 de volta antes de seguir lendo.
Aqui está a frase que começou toda essa reescrita do framework. A issue #4390 do Anchor, intitulada "Zero-copy account deserialization by default," chama o Account<T> de hoje de o caminho lento e a reclamação de performance número um dos desenvolvedores de Anchor. O modelo de contas inteiro do V2 é a resposta a essa única issue, então vale desacelerar e derivar por que o caminho antigo é lento antes de comemorar o novo.
Imagine o greeter R0 da lição passada, só que agora ele guarda um contador. No V1, quando uma instrução toca aquela conta, o Anchor faz mais ou menos isto: ele faz borrow do buffer de bytes crus da conta, checa o discriminator de 8 bytes, depois chama o Borsh (o formato de serialização do Anchor) para percorrer os bytes restantes campo a campo e construir um valor Greeter { count: u64 } novo na pilha. O seu handler modifica esse valor na pilha. Na saída, o Anchor serializa a struct inteira de volta no buffer.
Para um u64 o custo é pequeno. Mas nunca fica em um u64. Programas de verdade guardam um config com quinze campos, um vetor de entradas, um par de pubkeys. Cada um deles é decodificado na entrada e recodificado na saída, tenha o seu handler lido ele ou não. É esse o imposto. Ele escala com o tamanho da struct, não com o trabalho que você de fato fez.
Divida a conta em partes e fica fácil ver por que ela virou a reclamação número um. Tem o decode em si, uma passada sobre o buffer alocando e populando uma struct nova. Tem o espaço de pilha que essa struct ocupa enquanto o seu handler roda, que o runtime SBF mede. Tem o encode na saída, uma segunda passada completa escrevendo a struct de volta. E tem a cópia que você nunca pediu: um handler que só queria incrementar um contador ainda pagava para reconstruir os catorze campos que ele nunca tocou. Nenhum desses quatro custos está fazendo o trabalho real do seu programa. Eles são o preço da abstração, e a alegação do V2 é que o preço deveria ser zero.
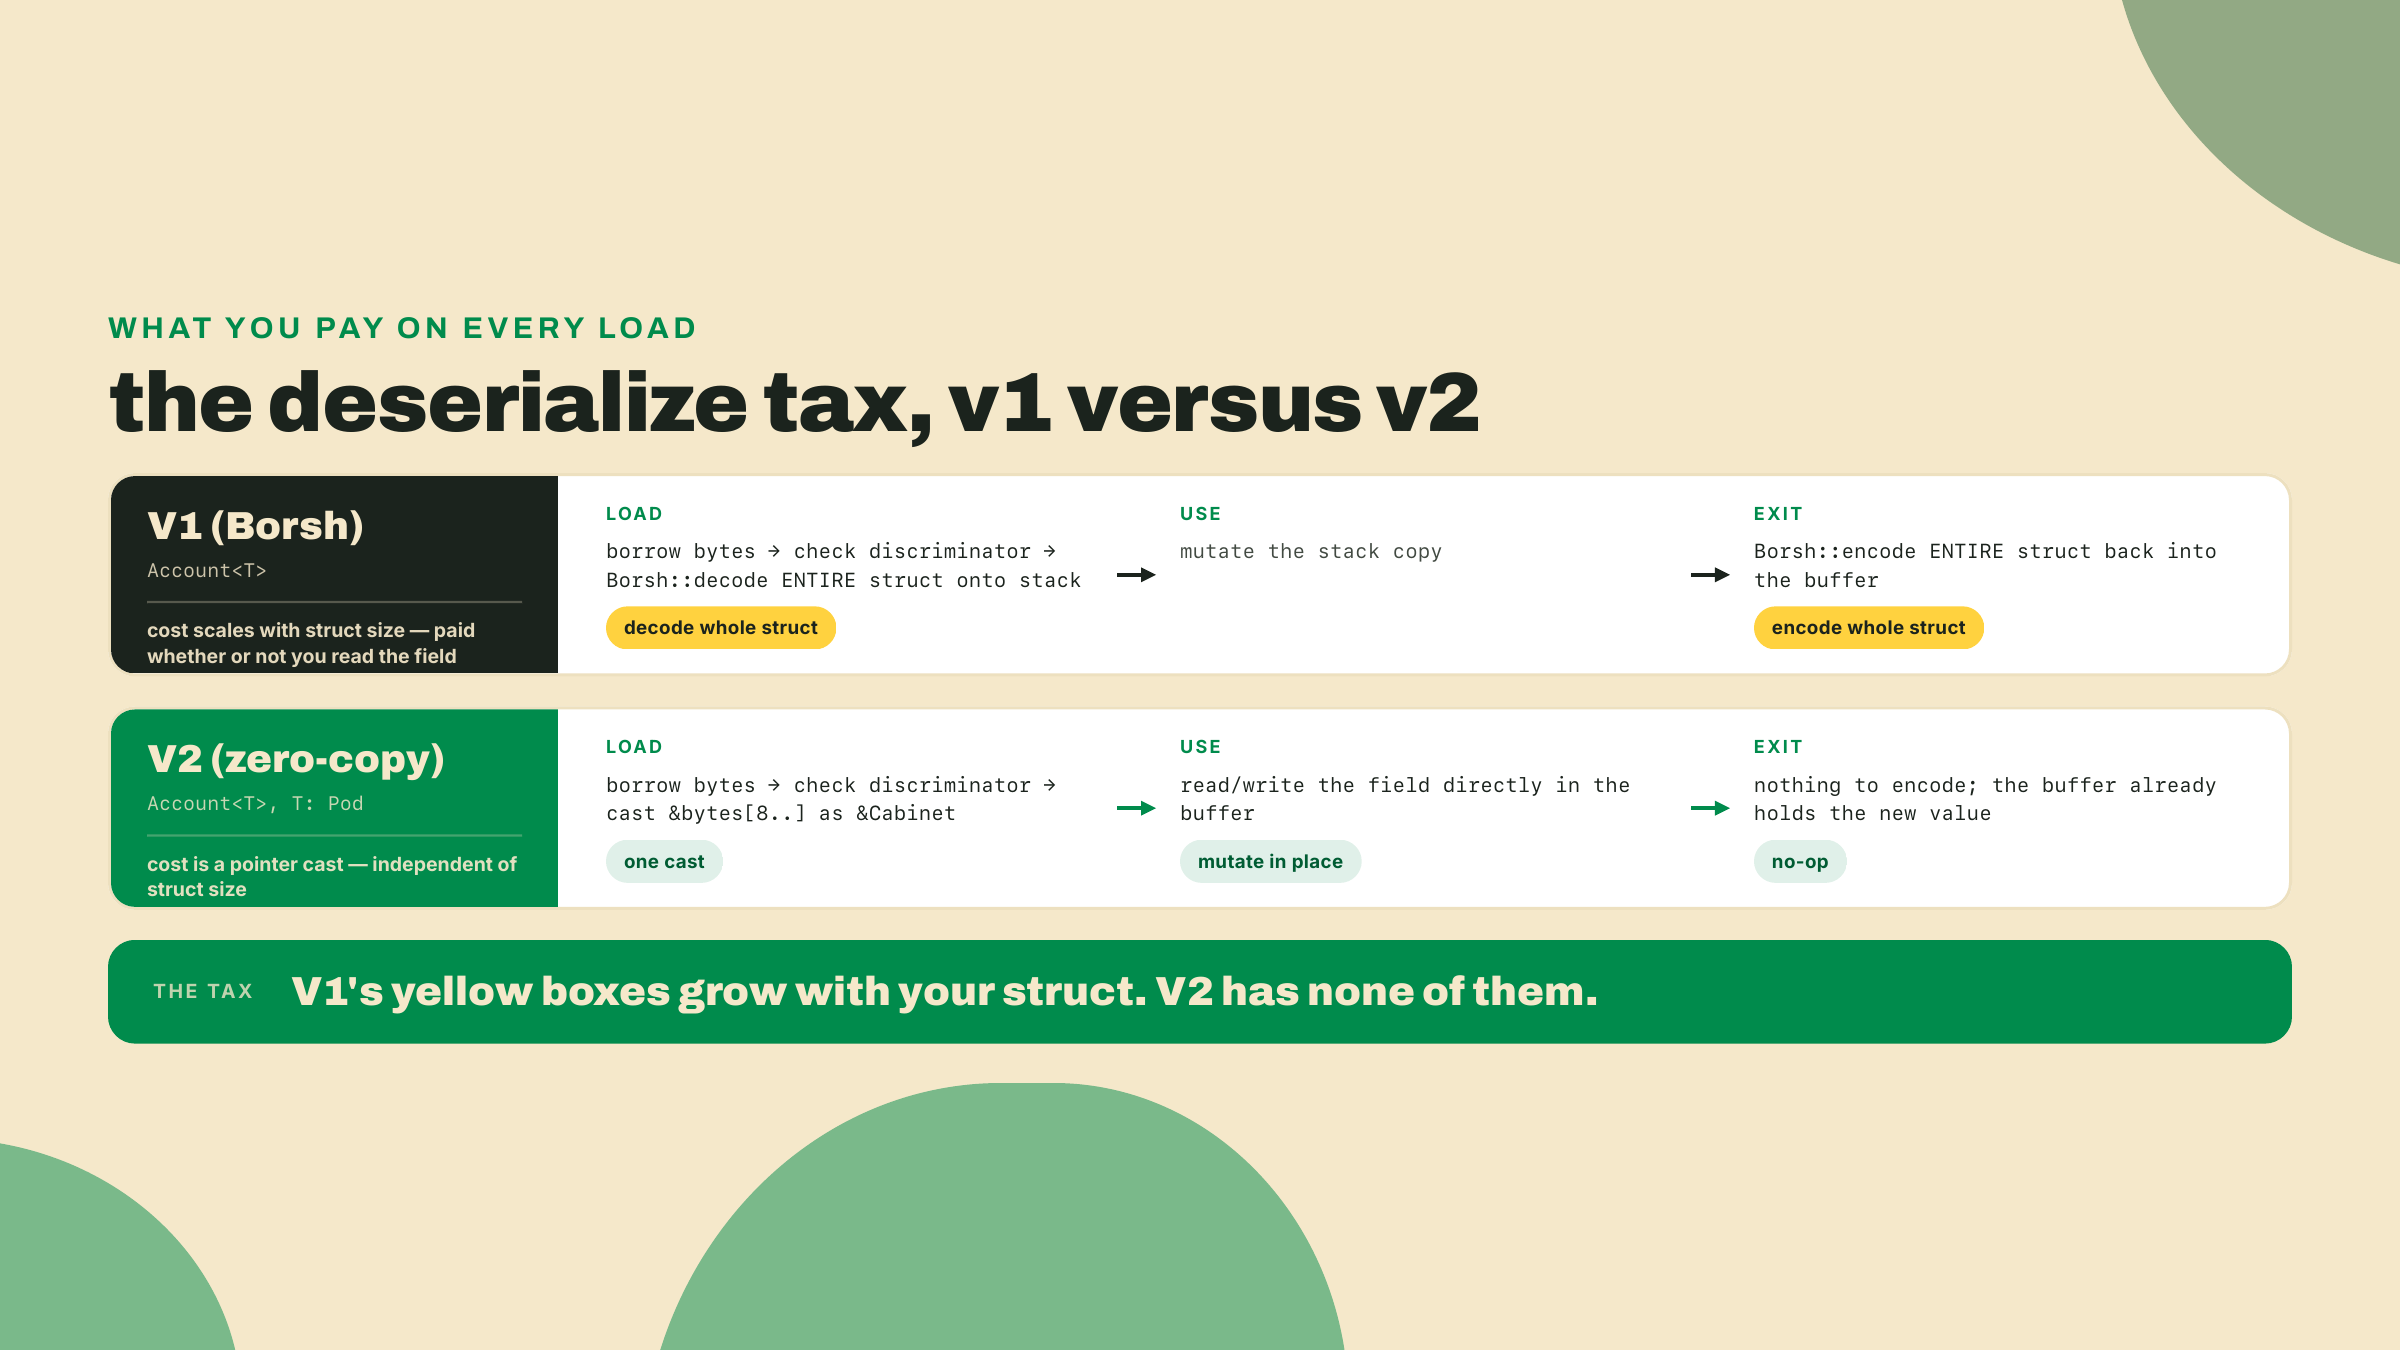
Antes de partir para o zero-copy (sem cópia), repare que um engenheiro cuidadoso tentaria correções mais baratas primeiro, e vale ver por que cada uma falha, porque são as falhas que forçam o design real.
A correção mais ingênua é "decodifique só os campos que você de fato toca." O Borsh não consegue fazer isso. É um formato sequencial: para achar o campo cinco você tem que percorrer os campos um a quatro, porque o comprimento de cada campo pode depender dos bytes antes dele. Um vetor no meio não tem offset fixo. Então decode parcial não é de graça, é a maior parte do decode.
A correção seguinte é "faça cache da struct decodificada para que leituras repetidas saiam baratas." Isso ajuda dentro de uma única instrução, mas o custo que nos interessa é o decode uma-vez-por-load e o encode uma-vez-por-saída, e cache não faz nada por eles. Você continua pagando as duas pontas.
A terceira correção é "deixe o Borsh mais rápido." Gente já deixou. Continua sendo um decode. Você está otimizando a constante de uma operação que não deveria acontecer.
Então a pergunta de verdade afia para isto: o que faria o runtime entregar ao seu programa uma view tipada da conta sem passo de decode no meio? E a resposta impõe uma restrição à sua struct, que é todo o resto deste módulo.
Um cast de bytes crus para uma referência tipada só é sólido se todo arranjo possível desses bytes for um valor válido do tipo. Essa propriedade tem nome: Pod, de "plain old data." Um tipo é Pod quando qualquer padrão de bits do comprimento certo é uma instância legal dele, sem estados inválidos e sem lacunas não inicializadas.
bytemuck é o crate que codifica essa regra no sistema de tipos. (bytemuck é uma biblioteca pequena e auditada para reinterpretar bytes como valores tipados e de volta; o V2 puxa ela para que o compilador, e não você, cheque que o cast é sólido.) O trait Pod dele é a trava. bytemuck::from_bytes::<Cabinet>(&data[8..]) compila só se Cabinet: Pod, e Cabinet: Pod só vale se todo campo for ele mesmo Pod e a struct não tiver preenchimento.
Repare onde isso morde. Um u64 é Pod: todos os 2^64 padrões de bits são valores u64 válidos. Um bool não é. Um bool ocupa um byte mas só dois dos seus 256 padrões são definidos, 0 e 1; os outros 254 são comportamento indefinido se você tratar eles como um bool. Então o bytemuck recusa bool de saída. A correção é PodBool, um wrapper de um byte cujos padrões são todos valores definidos. Mesma história para enums, Option, qualquer coisa com estados inválidos.
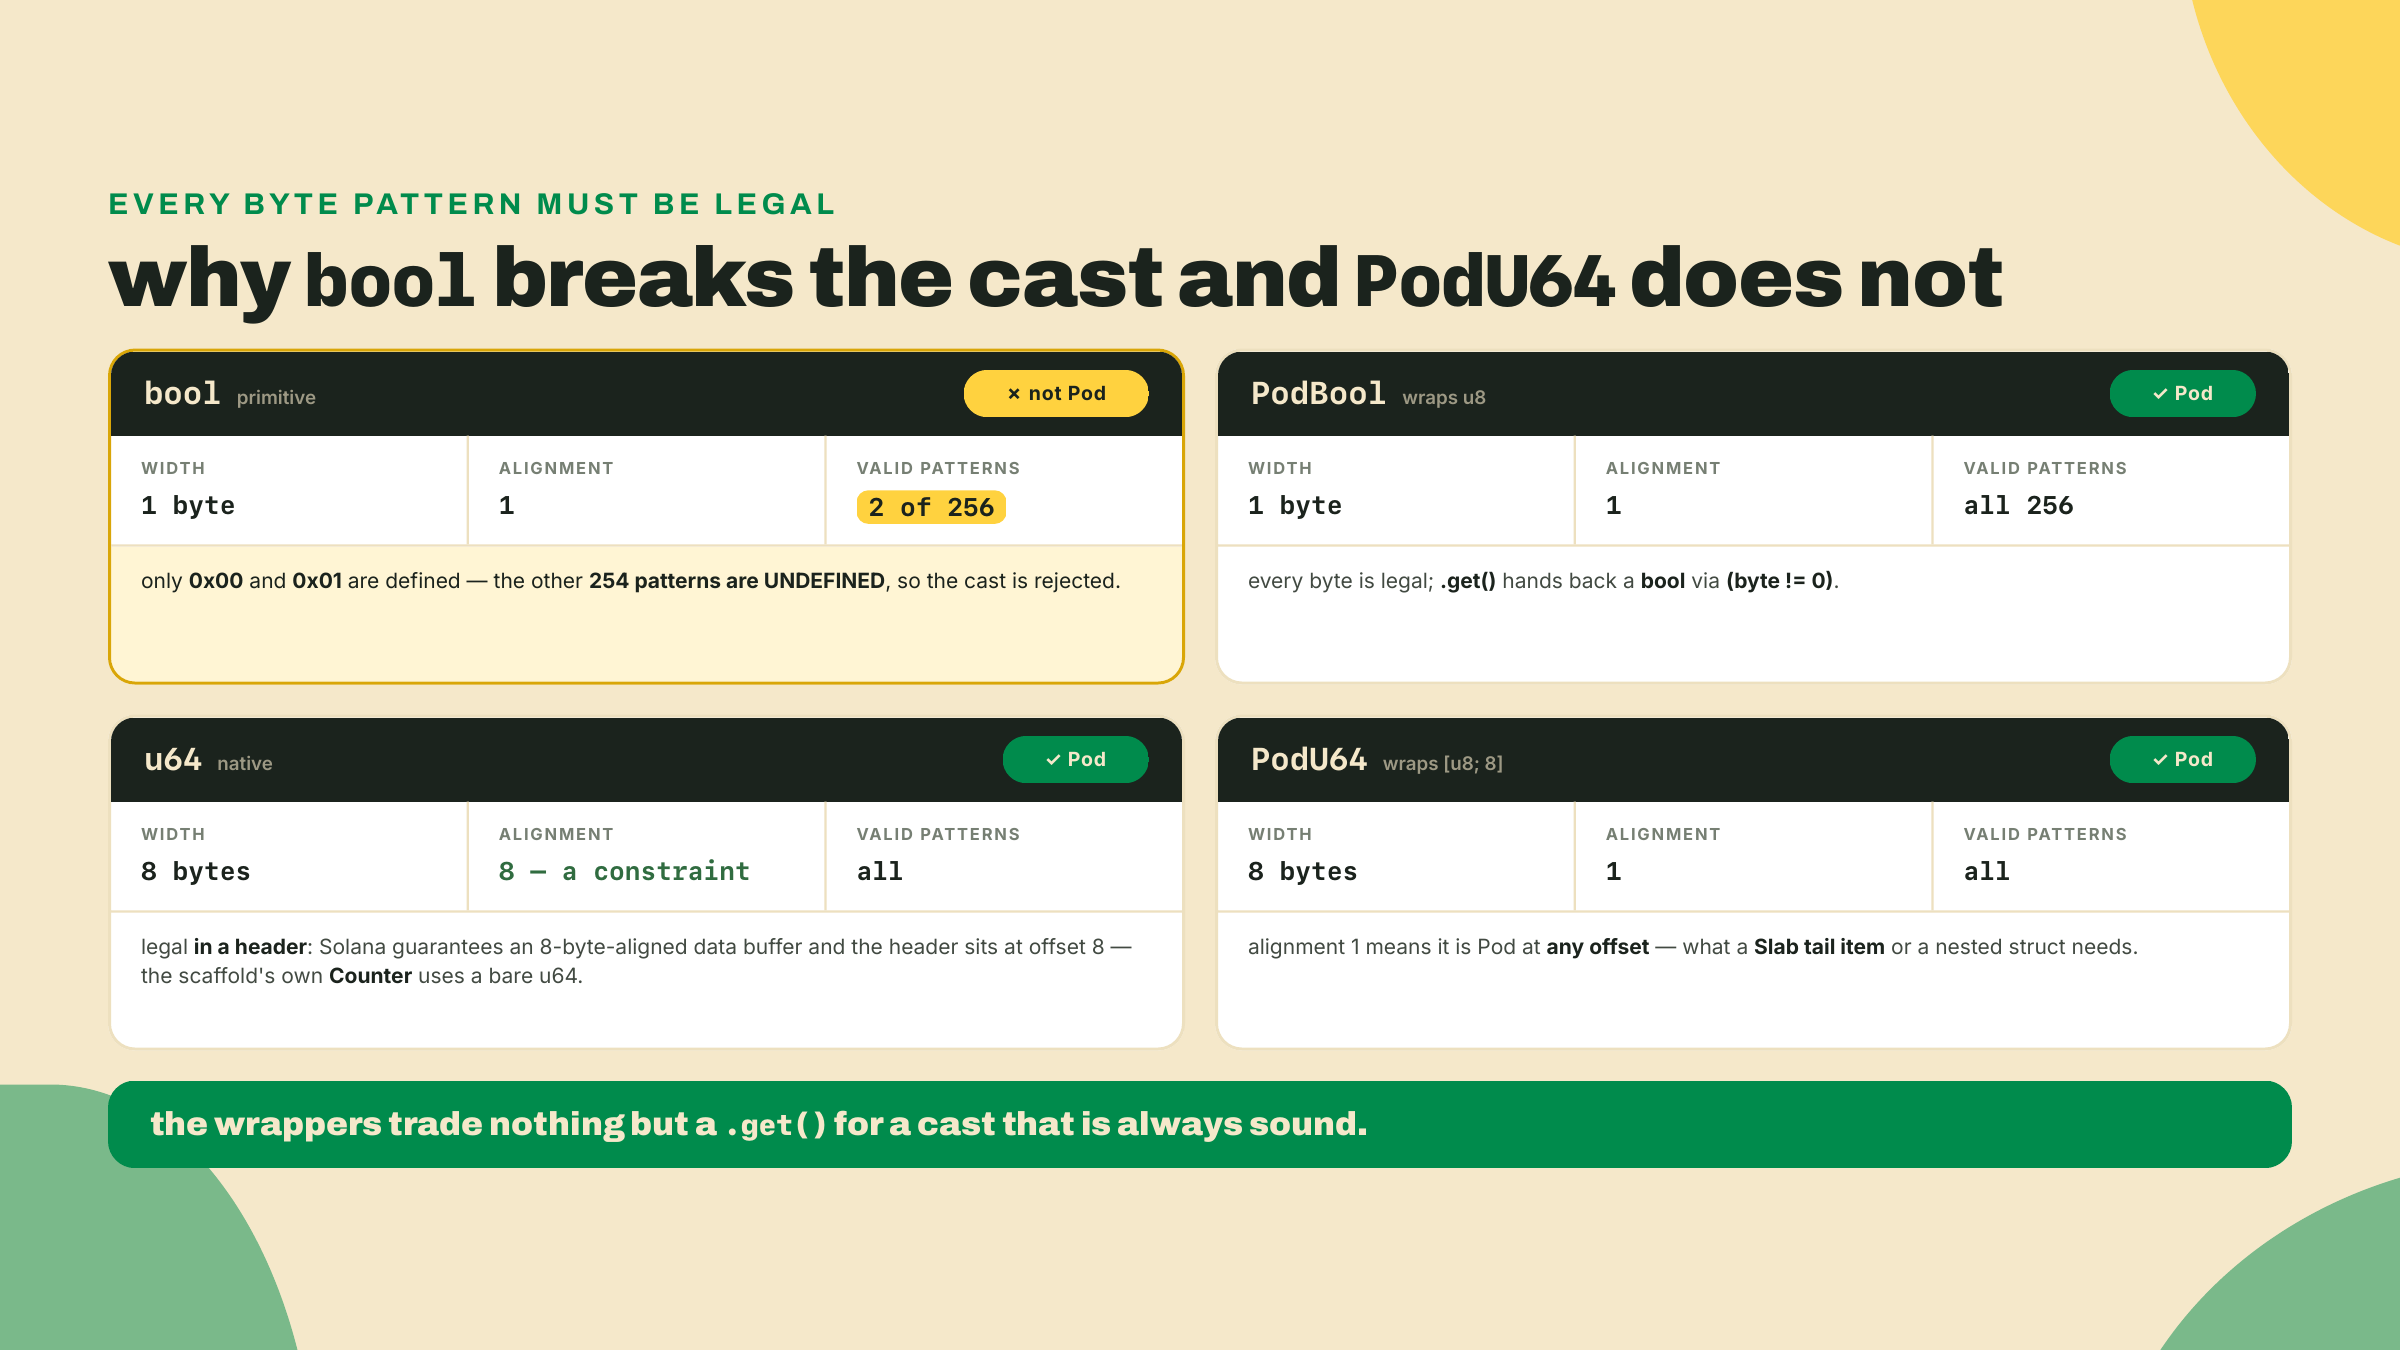
Aquela nota de alinhamento no card é a metade sutil, e vale ser preciso sobre ela em vez de repetir o folclore. Um u64 nativo exige um endereço alinhado em 8 bytes, e num header ele ganha um: a Solana garante que o buffer de dados da conta é alinhado em 8 bytes, e o V2 coloca o header logo depois do discriminator de 8 bytes, então data[8..] também está alinhado em 8. O framework afirma exatamente isso em tempo de compilação, rejeitando qualquer header cujo alinhamento passe da garantia de 8 bytes da Solana. É por isso que a conta Counter gerada pelo próprio scaffold escapa com um pub count: u64 puro, e a sua poderia também.
Então por que os wrappers? Porque essa garantia para no header. PodU64 embrulha [u8; 8], que tem alinhamento 1, então o cast é sólido não importa onde na conta o campo caia, que é o que você precisa no momento em que um valor fica numa lista no final, num offset que o compilador não consegue pré-alinhar, ou aninhado dentro de outra struct Pod. Campos de alinhamento 1 também tornam impossível introduzir preenchimento sem querer, e são o único jeito de carregar um tipo de 16 bytes como i128, cujo alinhamento natural é mais estrito que os 8 bytes que a Solana promete. Ele guarda o número como bytes little-endian e devolve ele por .get(); você escreve um convertendo do tipo nativo, PodU64::from(v) (não existe .set()). Esse é o mesmo truque que código Solana de baixo nível usa há anos, e o V2 dá a ele um nome e um tipo no prelude. O sinal de que isso é sobre layout e não sobre banir escalares nativos: PodU8 e PodI8 são literalmente aliases de tipo para u8 e i8, porque um campo de um byte nunca teve problema de alinhamento para resolver. Usamos os wrappers ao longo deste módulo porque a lição logo em seguida põe esses campos numa lista no final, onde eles deixam de ser opcionais.
Agora o mecanismo, dito com exatidão. No V2, Account<T> é definido como Slab<T, HeaderOnly>. Um Slab é uma view tipada sobre o buffer de bytes crus de uma conta. O parâmetro HeaderOnly diz que o header de tamanho fixo é T e que não existe região dinâmica no final. Ler account.play_count não desserializa nada; calcula um offset dentro do buffer e lê os bytes de lá como um PodU64. Escrever nele escreve esses bytes. Não tem cópia na pilha, não tem encode na saída, não tem lifetime <'info> pegando carona no wrapper até a definição da sua struct, do jeito que o AccountLoader obrigava.
A palavra "view" é estrutural. Uma view não é dona de nada. Ela aponta para os bytes da conta e interpreta eles. É por isso que o passo de saída na comparação acima era um no-op: não existe segunda cópia para escrever de volta, porque você estava editando o buffer real o tempo todo.
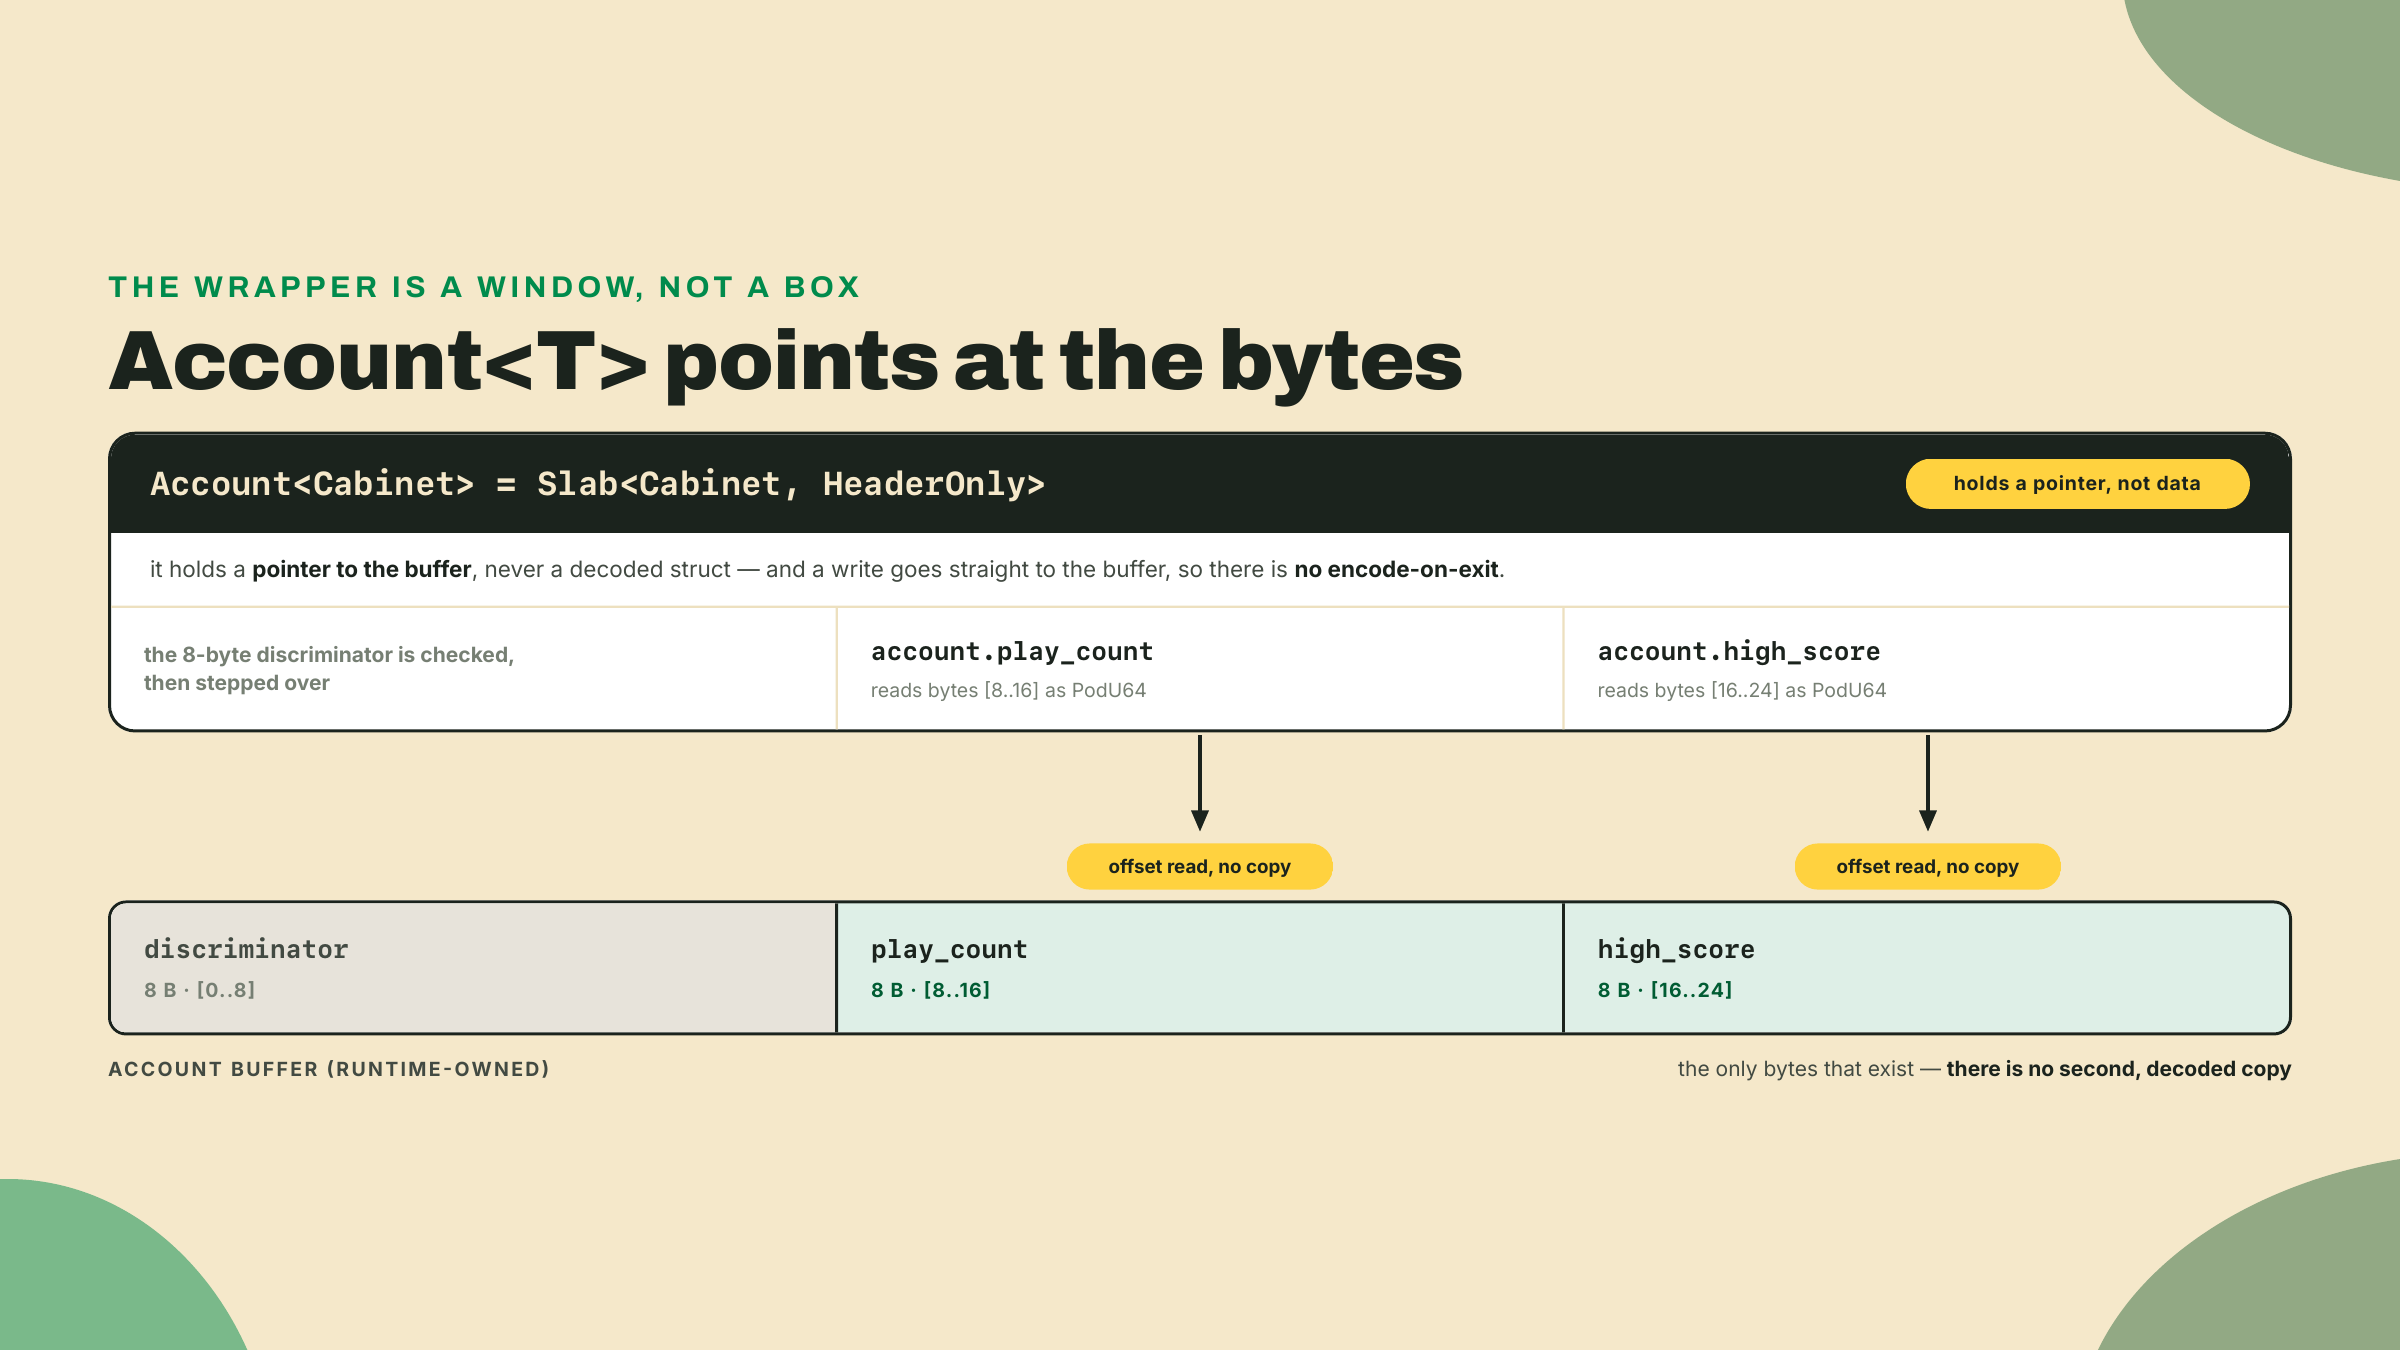
Uma coisa que o V2 não mudou: o discriminator de 8 bytes. Continua sendo a tag derivada de sha256 de m01-l4, continua sendo os primeiros oito bytes da conta, continua sendo como o runtime distingue um Cabinet de um Vault. O corpo Pod começa logo depois dele. É por isso que HeaderOnly descreve só o T e os seus testes fazem cast a partir de data[8..], nunca de data[..].
Este é o erro de primeiro dia mais comum de todos, então deixa eu nomear o sintoma antes de você bater nele. Se o seu teste lê account.data e todo campo parece deslocado em oito bytes do que você escreveu, você fez cast a partir do offset zero e leu o discriminator como o seu primeiro campo. A correção é um slice: &data[8..]. Nada foi corrompido, você só leu do começo errado.
Se você escreveu código zero-copy no V1, você fez isso com AccountLoader<'info, T>: um wrapper explícito e exótico que você buscava só quando uma struct era grande demais ou quente demais para desserializar. Você chamava .load()? e .load_mut()? e carregava o lifetime <'info> para todo lado. Todo mundo mais usava Account<'info, T> puro e engolia o custo do Borsh.
O V2 inverte o default. O que era o caso exótico do AccountLoader agora é o que Account<T> faz de fábrica, e o lifetime <'info> não pega mais carona no wrapper até a sua struct. Você não opta por entrar no zero-copy; você opta por sair dele, no caso raro em que você realmente precisa de dado de forma livre que nenhum cast consegue descrever — a saída de emergência do borsh com que este módulo fecha. (Uma cauda limitada não é uma saída: o Slab que você parafusa na próxima lição continua zero-copy.) A lição geral que vale extrair aqui, porque ela se repete por todo o V2, é que o framework moveu o custo do tempo de execução para o tempo de compilação. O default antigo era permissivo na escrita e caro na execução. O novo default é estrito na escrita e de graça na execução. Todo lugar em que o V2 parece mais exigente de escrever é um lugar em que ele parou de te cobrar quando o programa roda.
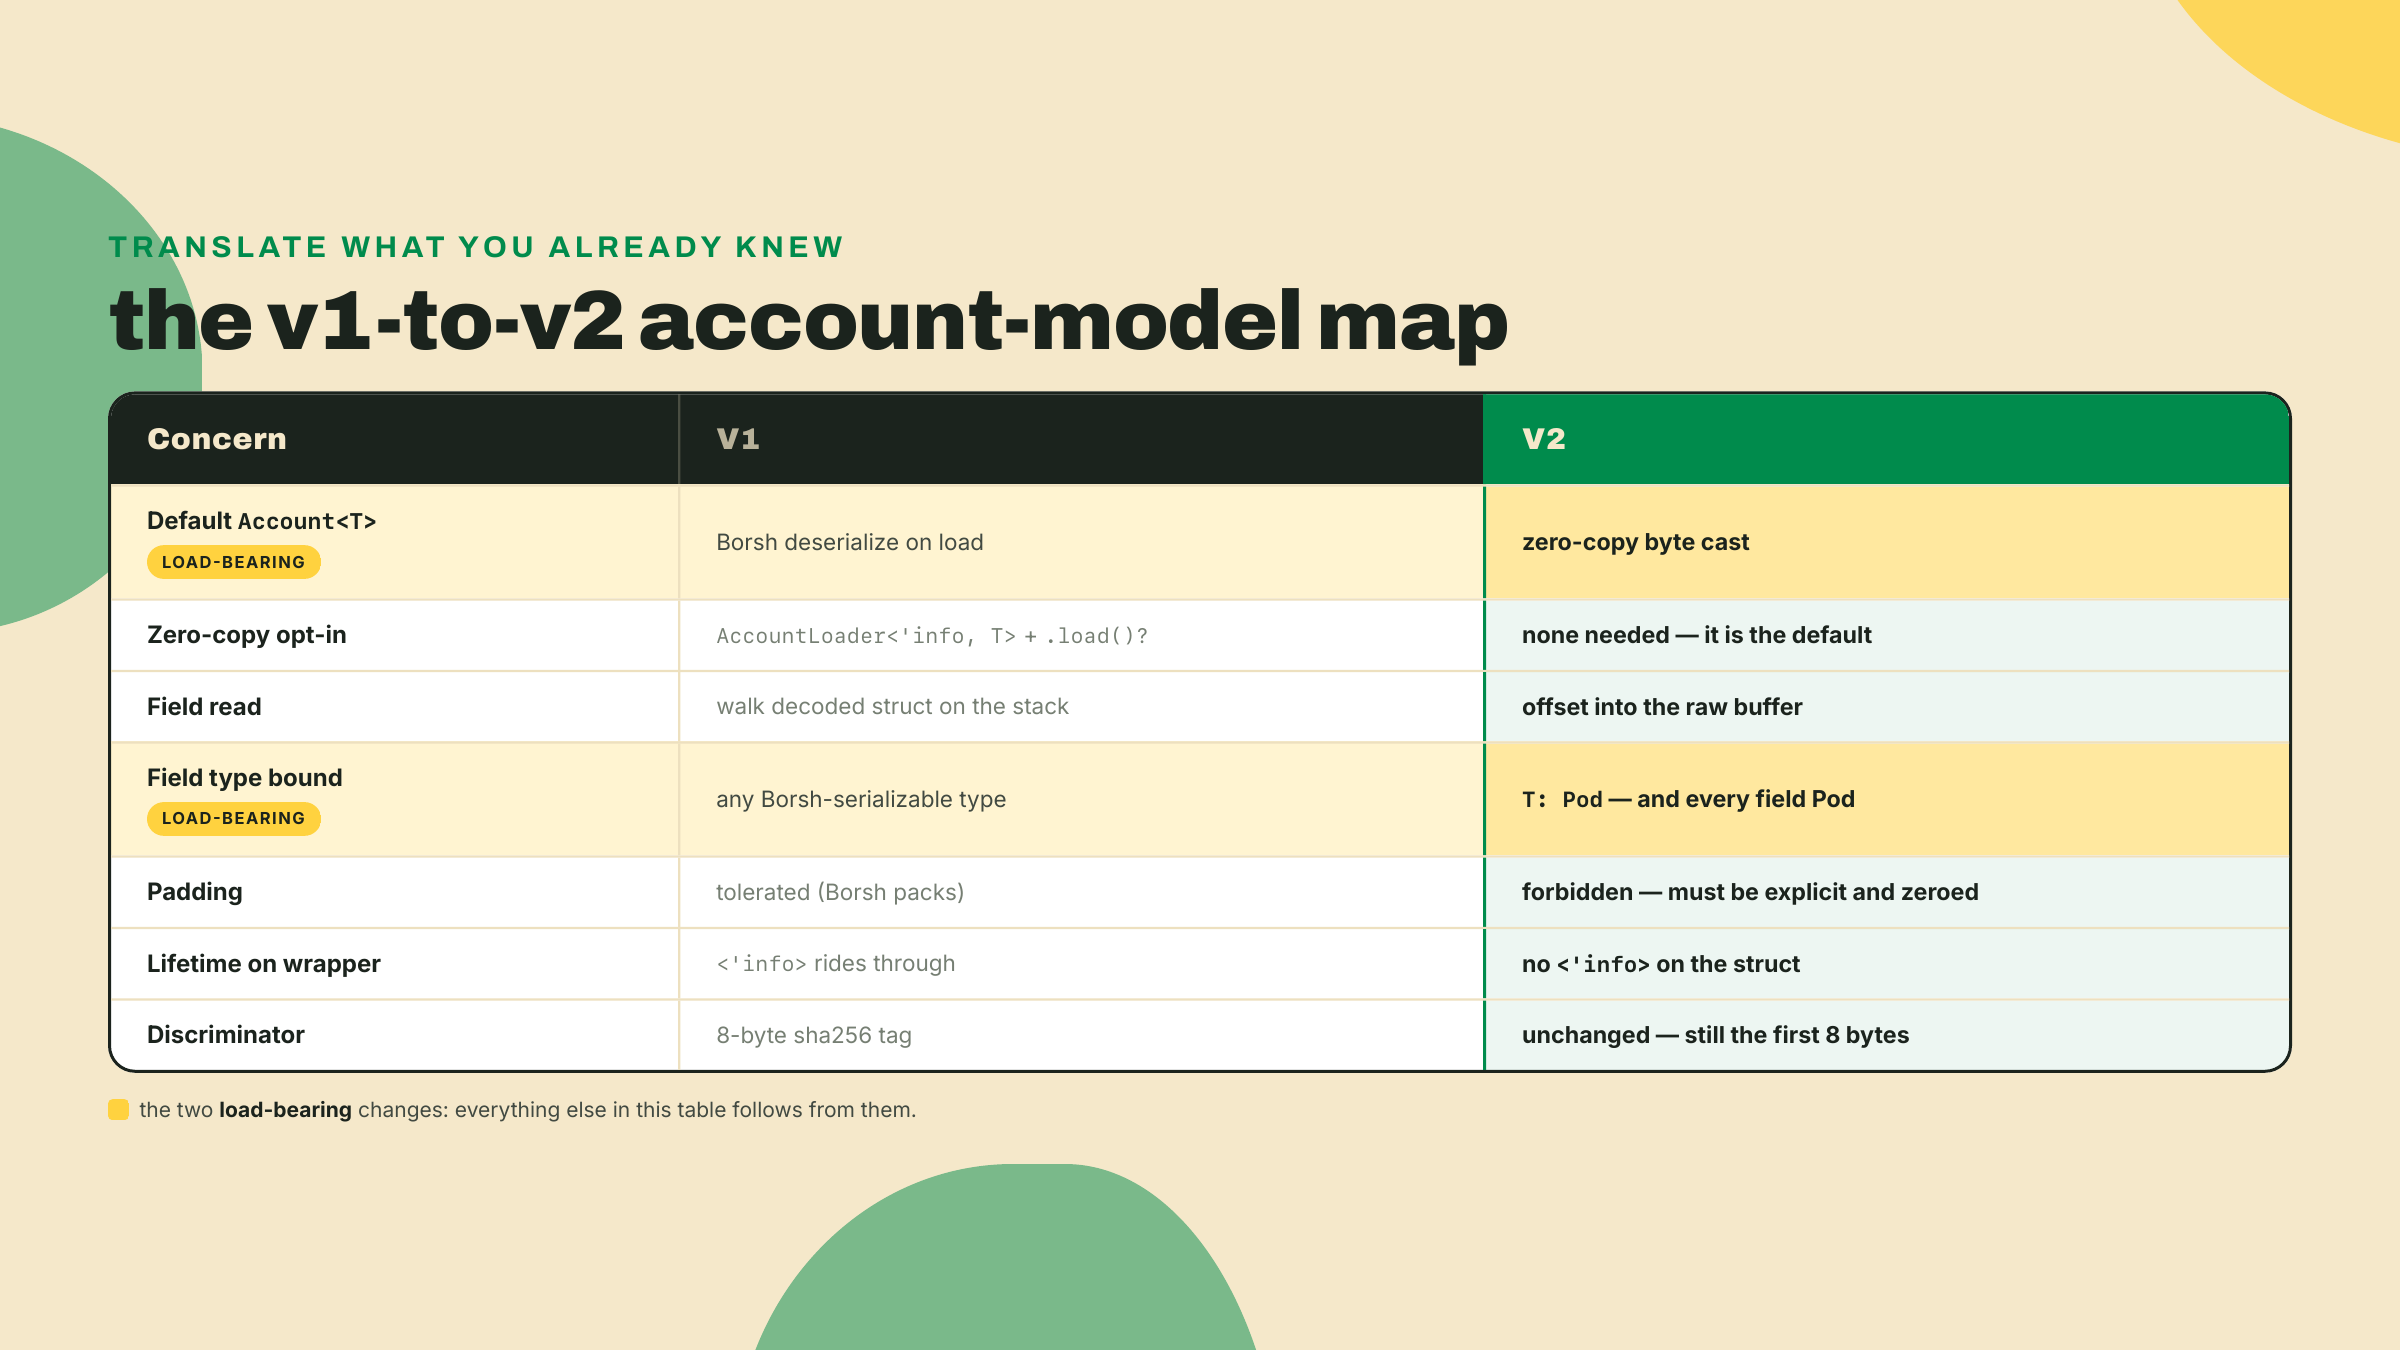
Se você já entregou programas Solana antes, três dúvidas devem estar se formando, e vale responder uma por uma, porque cada uma marca uma borda real do design.
A primeira: modificar o buffer no lugar não é perigoso? No V1 você editava uma cópia na pilha, e o Anchor escrevia ela de volta só se o handler retornasse limpo, o que te dava uma espécie de transacionalidade acidental. No V2 você escreve os bytes vivos da conta conforme vai. A resposta é que o runtime da Solana já te dá a garantia de verdade: uma instrução que retorna um erro desfaz todas as mudanças de conta da transação inteira, edições de buffer incluídas. A cópia na pilha nunca foi a coisa que te protegia. O runtime era. Então a escrita no lugar é exatamente tão segura, e com uma cópia a menos.
A segunda: e as contas que precisam crescer, um vetor que fica mais longo com o tempo? Esse é o limite honesto do HeaderOnly. Um corpo Pod puro tem tamanho fixo por definição, porque um cast precisa saber os offsets dos campos de antemão, e um Vec não tem offset fixo. A resposta do V2 não é "você não pode ter dado variável," é "dado variável mora numa região declarada no final, não contrabandeado dentro do header Pod." Essa região no final é assunto de uma lição posterior. Por hoje, tamanho fixo é o ponto, e é a maior parte do que o estado de conta de fato é.
A terceira: isso quebra clientes que leem a conta com Borsh? Nem sempre, e o greeter é o contraexemplo honesto: o Borsh codifica um u64 como oito bytes little-endian, e PodU64 guarda oito bytes little-endian, então para um header de inteiros simples os dois layouts coincidem e um cliente antigo rodando Greeter.deserialize ainda lê a contagem correta. A quebra vem de tudo que o Borsh conseguia expressar e um header Pod não consegue: um Vec com seu prefixo de comprimento, um Option com seu byte de tag, uma String. Migrar uma struct dessas para o V2 significa reestruturar ela — as partes dinâmicas vão para uma região declarada no final — e é essa reestruturação que move os bytes debaixo de um cliente que ainda decodifica a forma antiga. Então a regra do cliente é absoluta mesmo quando os bytes por acaso batem hoje: leia do mesmo jeito que o programa escreve — faça cast dos bytes em offsets conhecidos, não rode o decodificador antigo e torça. Esse é um custo de migração real, e fingir o contrário seria desonesto. É também o mesmo custo que o ecossistema inteiro paga uma vez, que é por que o framework fez disso o default em vez de um opt-in que fragmenta a história do cliente para sempre.
Zero-copy apaga o custo de serialização e deixa você modificar campos no lugar. Essa é a vitória, e ela não é pequena. Mas você herda a disciplina de layout C como preço, e é essa a parte franca de que o resto do módulo realmente trata.
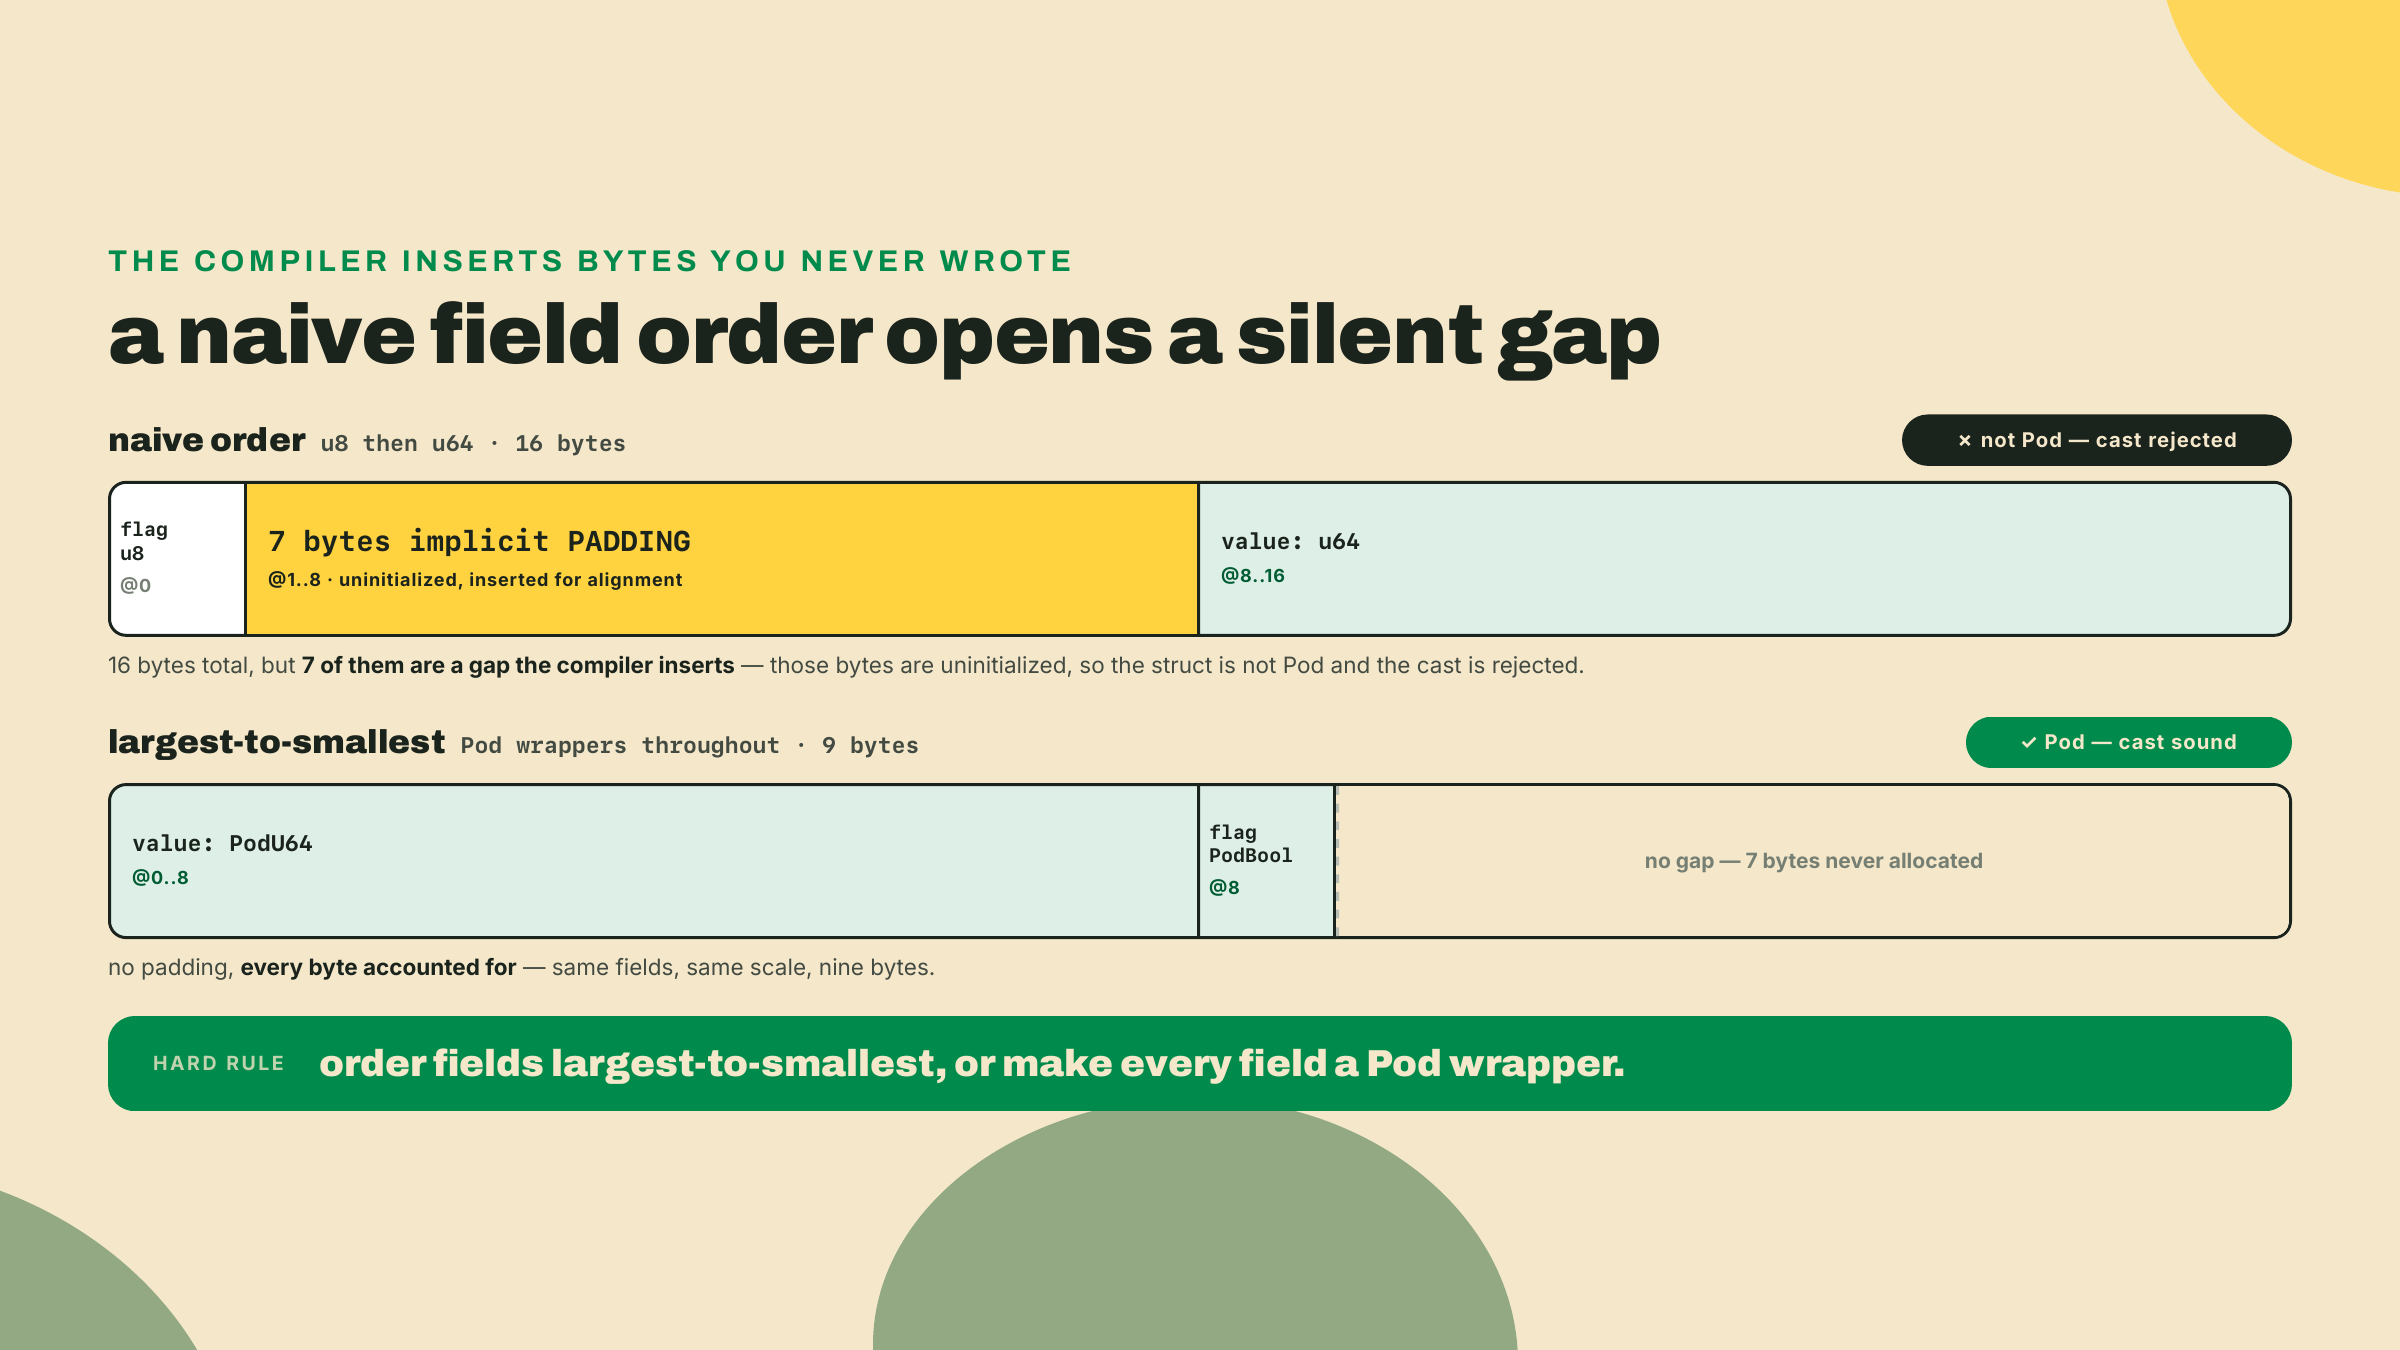
Todo campo precisa ser Pod, então um bool puro ou um Option ingênuo não compila. Preenchimento é proibido, então você ordena os campos do maior para o menor e o compilador afirma que não há lacunas implícitas entre eles. Alinhamento vira problema seu, que é por que os wrappers Pod existem. Uma ordem de campos em que um dev Rust normal nunca pensa, campo pequeno antes de campo grande, pode abrir em silêncio um byte de preenchimento que quebra o cast. No V2 isso não quebra em silêncio: não compila, que é a versão boa dessa falha. A velocidade é paga em rigor de layout. Você está trocando "o compilador me deixa escrever qualquer struct e eu pago em tempo de execução" por "o compilador me obriga a escrever uma struct legal e eu não pago nada em tempo de execução."
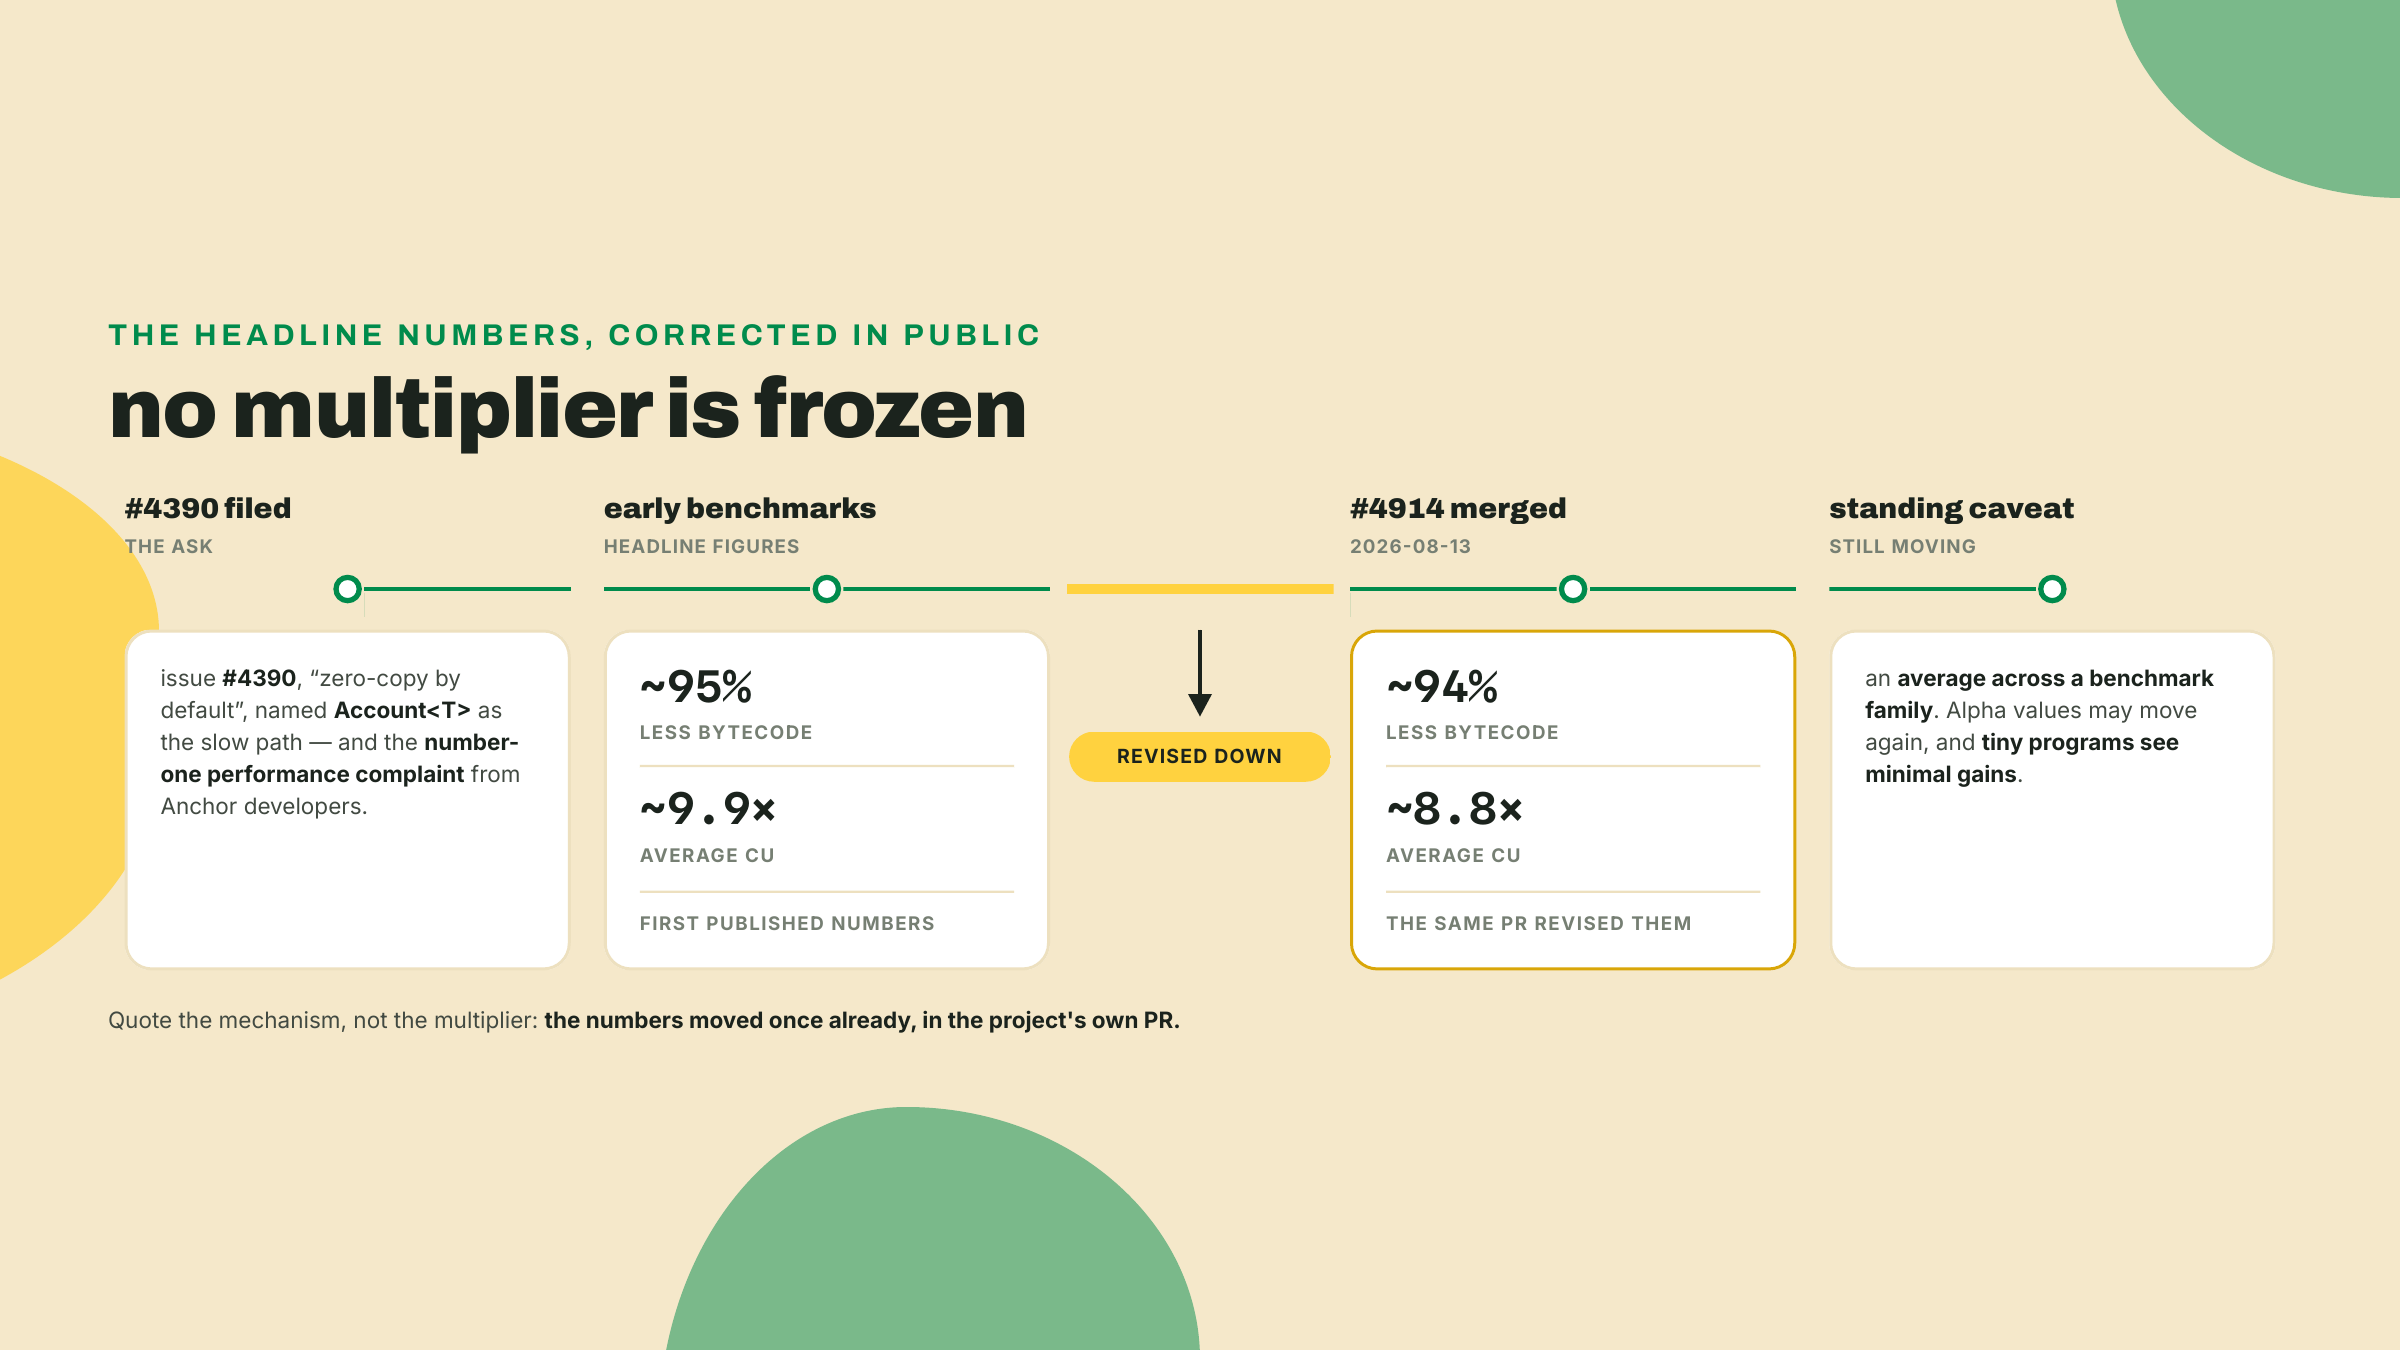
Você vai ouvir um número grudado no V2, e eu quero que você carregue ele direito, porque é um exemplo vivo de como este curso trata toda figura em movimento. Os benchmarks do V2 relatam mais ou menos 8.8x de redução média de CU e cerca de 94% menos bytecode publicado. Cite esses valores como aproximados e em movimento, nunca como garantia por programa.
Por que a ressalva. O PR #4914, mesclado em 2026-08-13, revisou os números de manchete para baixo: de 95% para 94% menos bytecode, de 9.9x para 8.8x de CU média. Isso é raro de se ver em público, um projeto corrigindo a própria figura de marketing para baixo, e é exatamente por isso que este curso nunca congela um multiplicador. O 8.8x é uma média sobre uma família de benchmarks, e a própria página do benchmark avisa que os valores da alpha podem mudar conforme o codegen muda. Programas pequenos veem o menor benefício. O seu cabinet-counter pelado, dois campos u64, vai mostrar quase nada, porque quase não havia custo de desserialização para apagar. Os ganhos aparecem quando a struct é grande e quente. Então quando um colega de equipe diz que o V2 deixou o contador minúsculo dele 8.8x mais barato, a releitura honesta é: essa é a média aproximada do projeto, já revisada para baixo uma vez e com expectativa de continuar se mexendo, e um contador de dois campos é o pior caso para ela.
Hora de construir o R1. Aqui está o recuo, dito em voz alta para você saber o que é seu: eu te entrego a struct Pod e o handler init inteiros, e eu mostro o cast de bytes uma vez no teste. Você preenche o handler increment e a asserção LiteSVM que lê data[8..] de volta. O challenge depois disto é inteiramente seu, sem apoio.
Você já confirmou na abertura que o PATH está servindo o RC. Se não estava, ou se o RC está faltando de vez, reinstale pelo canal git documentado agora, porque o avm install busca um binário pré-compilado do GitHub Release da tag e nenhum Release foi cortado para a tag v2, então o download dá 404 e o build via git é a rota sancionada:
# freshness note: as of 2026-08-22 the RC is 2.0.0-rc.1, tag v2.0.0-rc.1 on the
# anchor-next branch of the otter-sec fork (commit e4878b6d). m01-l2 installed from
# the branch because the channel was its subject; from here on the course pins the
# tag, because a branch tip moves and a tag does not. Re-verify before you rely on it.
# macOS, if the build trips on LTO: prefix that line with CARGO_PROFILE_RELEASE_LTO=off
cargo install --git https://github.com/otter-sec/anchor.git \
  --tag v2.0.0-rc.1 anchor-cli --locked --force
Não verifique conteúdo do V2 no toolchain 1.1.2; o modelo de contas é diferente e o código abaixo não vai se comportar do mesmo jeito.
Passo 1. Confirme as dependências. O seu programs/cabinet-counter/Cargo.toml precisa de anchor-lang na linha do V2, de bytemuck, e dos pins de wincode/solana-address de m01-l2 — você readicionou as quatro linhas na abertura, porque este é um scaffold novo e pular os pins mata o primeiro build na expansão de #[program]. Agora é a hora em que cada linha ganha a explicação dela. O scaffold tinha escrito anchor-lang como uma linha git seguindo a branch anchor-next; você editou ela para a versão do crates.io, exatamente como m01-l2 fez, porque essa é a única fonte que resolve contra os dois pins abaixo dela. Um desses dois pins mudou de forma aqui, e a razão vale uma frase agora em vez de uma surpresa no módulo 6: o greeter era um workspace descartável de um só, mas este crate é o primeiro degrau do fliperama, e ele acaba dividindo um workspace com os outros quatro — o R2 começa esse workspace em m03-l1, o R3 e o R4 são gerados por scaffold direto nele, e m09-l3 move este crate para junto deles. Um workspace resolve um solana-address para todos os seus membros, então a linha tem que ser um teto com que todo membro consiga concordar em vez de uma igualdade com que só um deles consiga. A freshness note que importa aqui é bytemuck, atualmente 1.25.2 (publicado em 2026-07-19). Qualquer 1.x funciona.
[dependencies]
# crates.io, not the git branch: a published version is immutable, and the branch
# tip now wants solana-address 2.7.0, which will not resolve against the pin below.
anchor-lang = "2.0.0-rc.1"
# The pins from m01-l2 — every program crate in this course carries them (issue #4937's class).
wincode = { version = "0.5", features = ["derive"] }
# A ceiling, not an equality. 2.7.0 is the version that moved to wincode 0.6; 2.6.1 is
# still on 0.5. Every crate in the arcade workspace carries this exact row, because the
# workspace resolves one solana-address for all of them and module 6 adds a Mollusk
# dev-dependency whose SVM stack reaches ^2.6.1. `=2.6.0` in any member refuses it.
solana-address = ">=2.6.1, <2.7"
bytemuck = "1.25"          # you added this in the opener

[dev-dependencies]
# The test harness. This wraps LiteSVM and re-exports what the test file needs,
# so you never depend on `litesvm` by name. The scaffold writes it tracking the
# `anchor-next` branch; repoint it at the tag so the litesvm it carries cannot
# move under you. Add the row outright if your scaffold predates it.
anchor-v2-testing = { git = "https://github.com/otter-sec/anchor.git", tag = "v2.0.0-rc.1" }
Passo 2. Escreva o estado e as contas. Esta é a parte que eu te dou inteira. Cole em src/lib.rs, substituindo a struct Counter gerada e o handler initialize dela, e incorporando o Cabinet que você adicionou na abertura; o scaffold cumpriu o propósito dele. Uma linha que você não cola: mantenha o declare_id! que o anchor init já escreveu. Ele casa com o keypair que está em target/deploy/, e sobrescrever ele com uma string digitada à mão te dá um id para o qual o deploy não consegue assinar. Se você algum dia perder o casamento, anchor keys sync reescreve declare_id! e Anchor.toml a partir do keypair. Resultado esperado depois deste passo: anchor build compila, com o handler increment ainda um stub. PodU64 vem do prelude do V2; é o wrapper de array de bytes com alinhamento 1 que derivamos acima, lido por .get() e escrito atribuindo um PodU64::from(value).
use anchor_lang::prelude::*;

// Leave the id anchor init generated for you here; do not paste one in.
declare_id!("<your generated program id>");

#[program]
pub mod cabinet_counter {
    use super::*;

    pub fn init(ctx: &mut Context<Init>) -> Result<()> {
        let cabinet = &mut ctx.accounts.cabinet;
        cabinet.play_count = PodU64::from(0);
        cabinet.high_score = PodU64::from(0);
        Ok(())
    }

    // Step 3 is yours: fill this in.
    pub fn increment(ctx: &mut Context<Increment>, score: u64) -> Result<()> {
        // TODO
        Ok(())
    }
}

#[account]
#[repr(C)]
pub struct Cabinet {
    pub play_count: PodU64, // bytes 8..16 of the account
    pub high_score: PodU64, // bytes 16..24 of the account
}

#[derive(Accounts)]
pub struct Init {
    #[account(
        init,
        payer = player,
        space = Cabinet::DISCRIMINATOR.len() + core::mem::size_of::<Cabinet>(),
        seeds = [b"cabinet", player.address().as_ref()],
        bump
    )]
    pub cabinet: Account<Cabinet>,
    #[account(mut)]
    pub player: Signer,
    pub system_program: Program<System>,
}

#[derive(Accounts)]
pub struct Increment {
    #[account(
        mut,
        seeds = [b"cabinet", player.address().as_ref()],
        bump
    )]
    pub cabinet: Account<Cabinet>,
    pub player: Signer,
}

#[error_code]
pub enum CabinetError {
    #[msg("play_count overflowed")]
    Overflow,
}
Duas linhas ali não são assunto desta lição, e eu prefiro nomear elas a deixar você se perguntando. seeds = [b"cabinet", player.address().as_ref()] com um bump puro faz do cabinet um endereço derivado do programa, um por player, então um player não consegue te entregar o cabinet de outra pessoa. Copie essas duas linhas por ora; o módulo 3 é inteiramente sobre o que elas geram e por que o bump é armazenado. E player.address() é o acessador do V2 de m01-l3, o substituto on-chain de .key(), que devolve uma referência para um Address em vez de um Pubkey.
Mais duas coisas para reparar, porque elas são a lição em miniatura. O cálculo do space é Cabinet::DISCRIMINATOR.len() + core::mem::size_of::<Cabinet>(), que dá 8 + 16 = 24 bytes: o discriminator mais o corpo Pod exato, sem constante mágica. E #[account] numa struct do V2 deriva o bound Pod e afirma em tempo de compilação que Cabinet não tem preenchimento. Adicione um campo bool puro ao Cabinet agora mesmo e tente fazer o build; o compilador vai rejeitar ele com um erro de Pod, não com uma surpresa em tempo de execução. É o trade-off fazendo o trabalho dele.
Passo 3. Preencha o handler increment. Esta é a sua primeira escrita de handler de verdade, então escreva antes de ler o próximo bloco, depois compare. Ele deve incrementar play_count em um com aritmética checada, e subir high_score só se o novo score bater o que está guardado. Leia por .get(); escreva atribuindo um wrapper novo, PodU64::from(value) (não existe .set(), e nem ::new() também, a conversão é uma impl de From). Note que o handler recebe &mut Context<T> no V2, não Context<T>. Aqui está o meu, para depois de você ter escrito o seu:
pub fn increment(ctx: &mut Context<Increment>, score: u64) -> Result<()> {
    let cabinet = &mut ctx.accounts.cabinet;

    let plays = cabinet
        .play_count
        .get()
        .checked_add(1)
        .ok_or(CabinetError::Overflow)?;
    cabinet.play_count = PodU64::from(plays);

    if score > cabinet.high_score.get() {
        cabinet.high_score = PodU64::from(score);
    }

    Ok(())
}
O checked_add está ali por um motivo. play_count é um u64 que você incrementa a cada jogada, e a regra da casa para aritmética em programa é checar tudo, então um wrap vira um erro limpo em vez de um reset silencioso para zero.
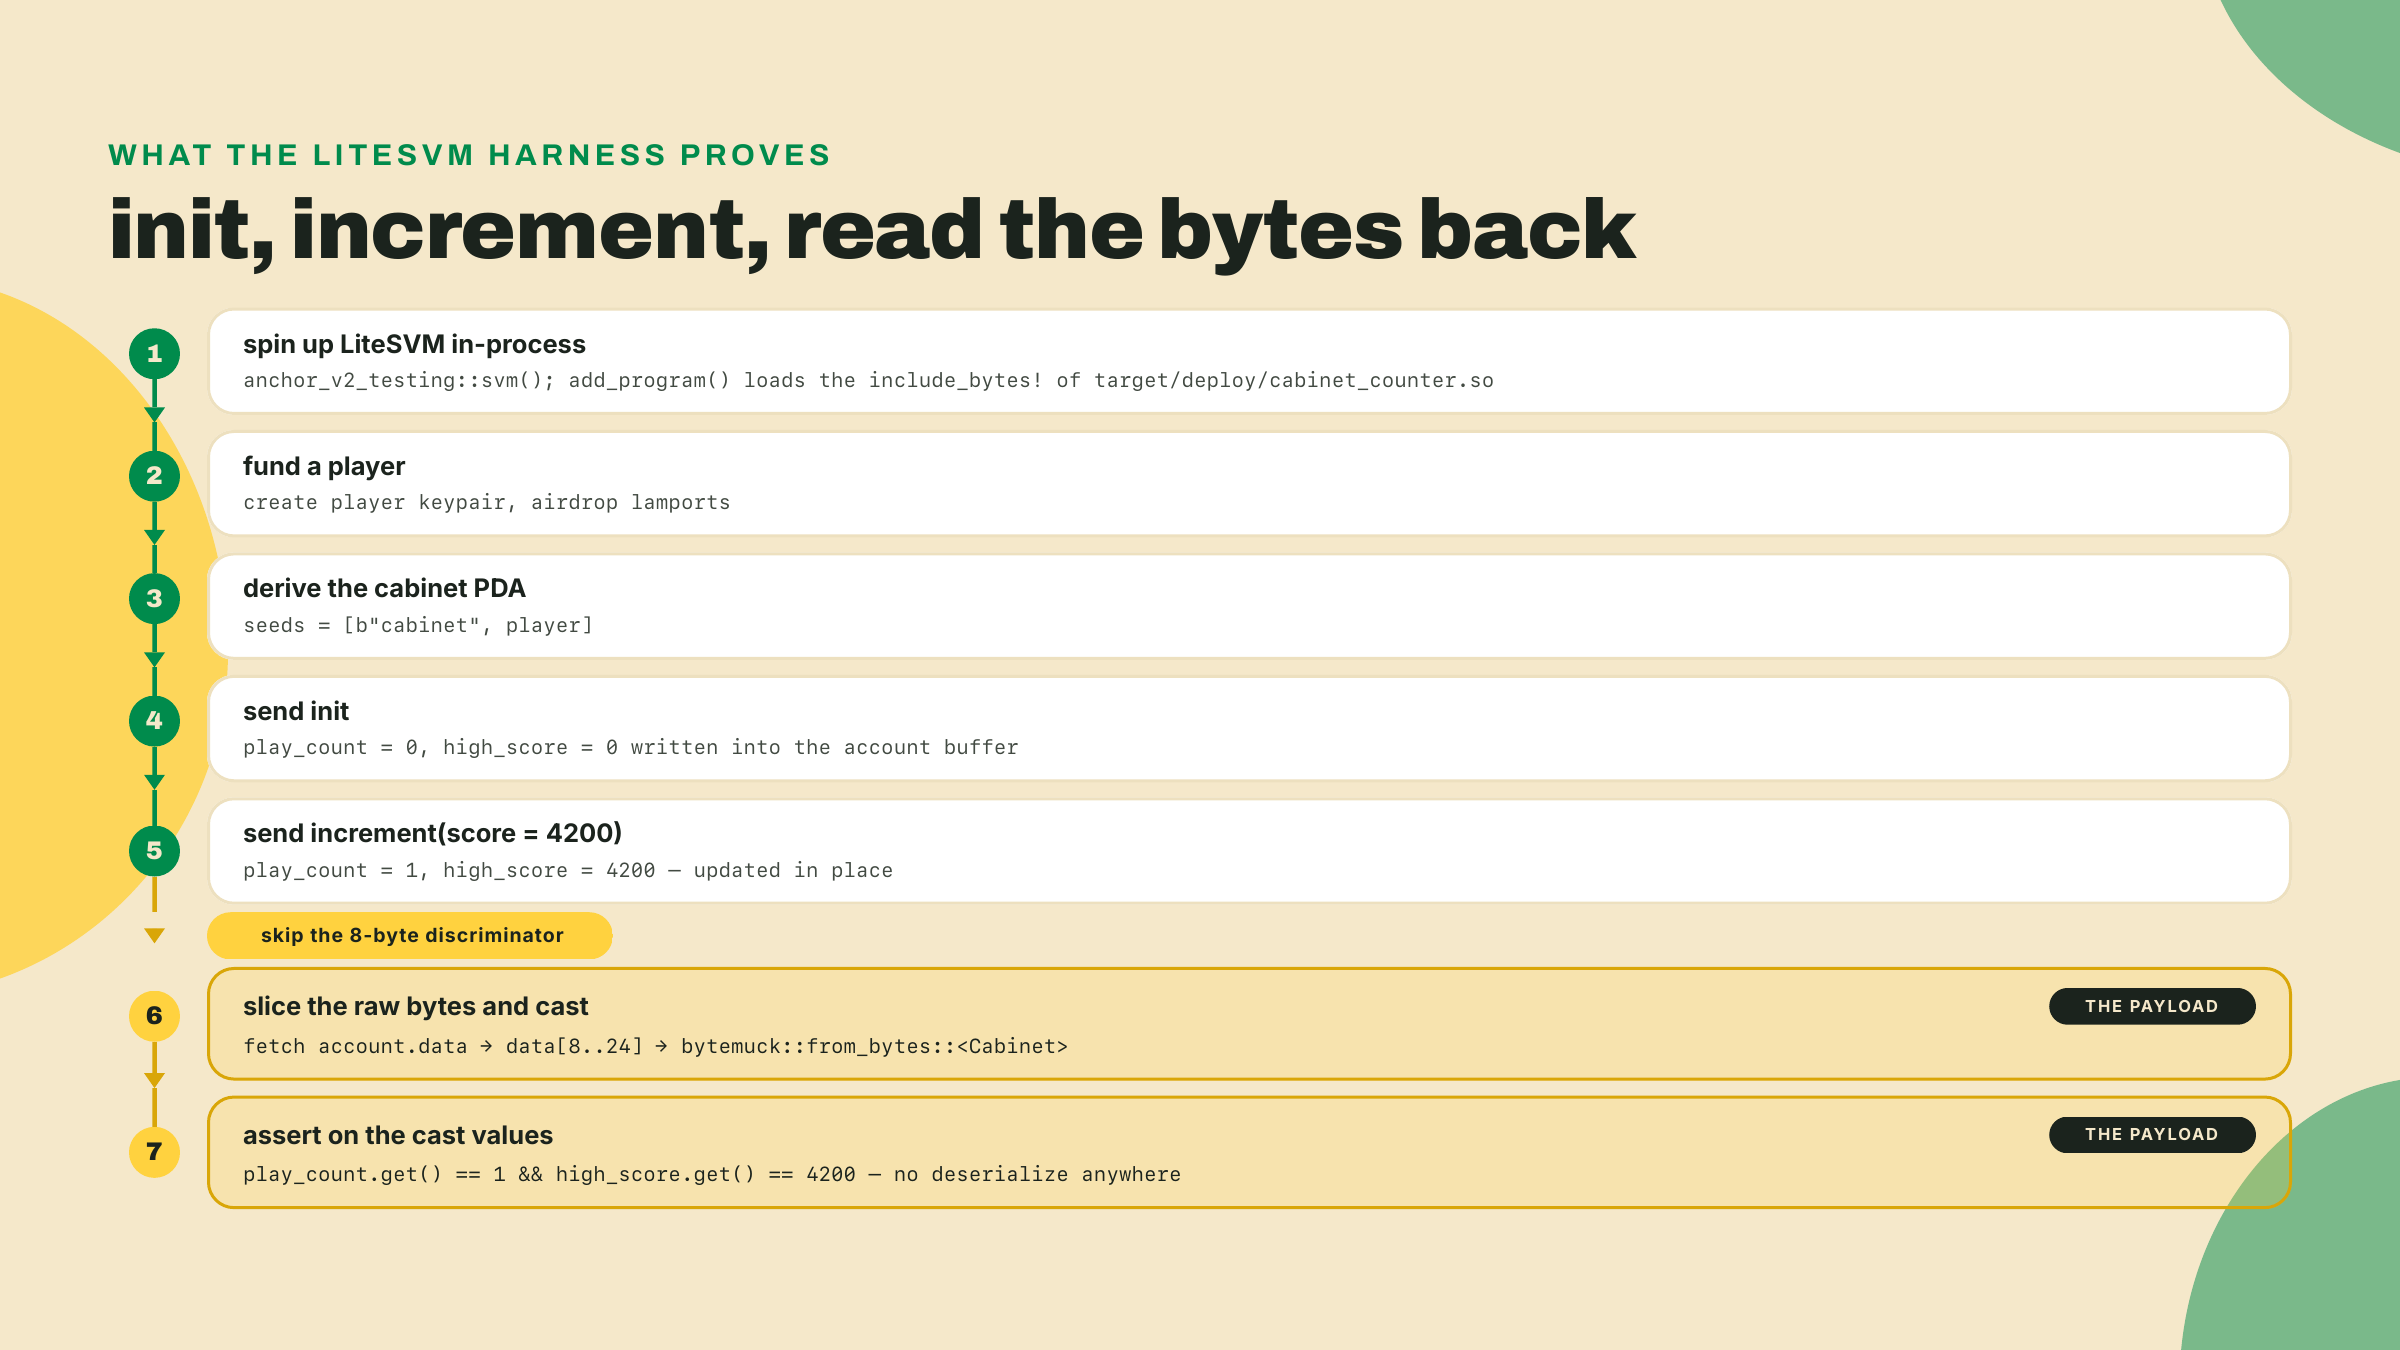
Passo 4. Leia os bytes de volta (a sua asserção). O teste mora ao lado do crate do programa, em programs/cabinet-counter/tests/cabinet.rs, que é o que faz o caminho de include_bytes! abaixo resolver; ponha ele na raiz do workspace e aquele caminho relativo sai andando para fora do repositório. Ele usa o LiteSVM, a VM Solana em processo que vira a trava de aceitação para todo degrau seguinte deste curso. Você não puxa litesvm direto: a dev-dependency anchor-v2-testing do scaffold embrulha ele e reexporta as peças que você precisa (Keypair, Signer, Message, VersionedTransaction), que é também como o anchor test --profile consegue pendurar tracing nos mesmos testes depois. Eu te dou o scaffolding da bancada de teste; as três linhas de assert lá embaixo são suas. Escreva elas a partir do fluxograma acima antes de olhar as que estão impressas abaixo: quanto deve ser play_count depois de um increment, quanto deve ser high_score, e quantos bytes tem a conta inteira?
use {
    anchor_lang::{
        bytemuck, programs::System, solana_program::instruction::Instruction, Id,
        InstructionData, ToAccountMetas,
    },
    anchor_lang::prelude::Address,
    anchor_v2_testing::{Keypair, Message, Signer, VersionedMessage, VersionedTransaction},
    cabinet_counter::{accounts, instruction, Cabinet},
};

fn send(
    svm: &mut anchor_v2_testing::LiteSVM,
    payer: &Keypair,
    ix: Instruction,
) {
    let blockhash = svm.latest_blockhash();
    let msg = Message::new_with_blockhash(&[ix], Some(&payer.pubkey()), &blockhash);
    let tx = VersionedTransaction::try_new(VersionedMessage::Legacy(msg), &[payer]).unwrap();
    svm.send_transaction(tx).unwrap();
}

#[test]
fn cabinet_round_trips() {
    let program_id = cabinet_counter::id();

    // `anchor_v2_testing::svm()` is LiteSVM::new(), plus the profiling
    // callback when the crate is built with --features profile.
    let mut svm = anchor_v2_testing::svm();
    let bytes = include_bytes!("../../../target/deploy/cabinet_counter.so");
    svm.add_program(program_id, bytes).unwrap();

    let player = Keypair::new();
    svm.airdrop(&player.pubkey(), 1_000_000_000).unwrap();

    let (cabinet, _bump) =
        Address::find_program_address(&[b"cabinet", player.pubkey().as_ref()], &program_id);

    // init: play_count = 0, high_score = 0
    let init_ix = Instruction::new_with_bytes(
        program_id,
        &instruction::Init {}.data(),
        accounts::Init {
            cabinet,
            player: player.pubkey(),
            system_program: System::id(),
        }
        .to_account_metas(None),
    );
    send(&mut svm, &player, init_ix);

    // increment with a score of 4200
    let inc_ix = Instruction::new_with_bytes(
        program_id,
        &instruction::Increment { score: 4200 }.data(),
        accounts::Increment {
            cabinet,
            player: player.pubkey(),
        }
        .to_account_metas(None),
    );
    send(&mut svm, &player, inc_ix);

    // read the raw bytes back, skipping the 8-byte discriminator.
    let raw = svm.get_account(&cabinet).unwrap().data;
    let state: &Cabinet = bytemuck::from_bytes(&raw[8..8 + core::mem::size_of::<Cabinet>()]);

    // The three assertions. Write yours first, then check against these.
    assert_eq!(state.play_count.get(), 1);
    assert_eq!(state.high_score.get(), 4200);
    assert_eq!(raw.len(), 24); // 8 discriminator + 16 body
}
Checkpoint. Rode anchor test. Você deve ver um teste passando. Se em vez disso as asserções falharem porque os campos parecem deslocados, confira o slice: ele tem que ser raw[8..24], depois do discriminator, não raw[0..16]. Essa é a cilada de offset de antes, e vê-la uma vez num assert falhando é o jeito mais rápido de nunca mais esquecer. Se o programa falhar ao compilar na struct, você tem um campo não-Pod ou uma lacuna de preenchimento; releia a ordem dos campos.
Esse teste verde é o R1 pronto. Você escreveu uma conta Pod de dois campos, um init, um increment, e a primeira bancada de teste LiteSVM do curso, e você viu os bytes exatos que escreveu saírem de volta sem nenhum passo de serialização no caminho.
Sem apoio desta vez. Adicione um handler reset ao programa e um segundo teste que comprove isso.
O comportamento: reset põe play_count de volta em 0 e deixa high_score intocado. Pense nisso como o operador do fliperama zerando a contagem de jogadas no começo de um turno sem apagar o recorde de todos os tempos no marquee.
A sua barra de aceitação, as três precisam valer:
reset compila e recebe a mesma conta Cabinet validada por PDA, mutável.reset, depois lê data[8..] de volta e afirma play_count == 0 e que high_score ainda é igual ao score que você definiu.cabinet_round_trips existente continua passando.A parte interessante é a asserção, não o handler. Um reset que zera os dois campos sem querer vai passar num teste preguiçoso que só checa play_count. Escreva o teste que pegaria esse bug: afirme que o high score sobreviveu. É isso que o exercício está testando. Tanto o handler quanto o teste vão no seu próprio checkout do R1, ao lado do que você acabou de construir; uma solução de referência fica ao lado desta lição — reset-play-count/reset.rs para o handler e a struct de accounts, reset-play-count/cabinet_reset.rs para o teste — para depois de você ter uma rodada verde própria.
Momento de feedback. Antes de seguir em frente, responda isto em uma frase, em voz alta ou num comentário no topo do seu arquivo de teste: quais duas coisas o bound T: Pod proíbe na sua struct? Se a sua frase nomear campos não-Pod (o bool puro) e preenchimento implícito (a lacuna silenciosa de uma ordem de campos ruim), você tem o modelo. Se ela nomeou só uma, releia a seção do trade-off, porque a segunda é a que morde em silêncio.
Um contador por cabinet está de bom tamanho, mas um fliperama de verdade guarda uma tabela de high scores, várias linhas numa única conta, não um número só. Na próxima lição a gente põe uma lista limitada dentro de uma conta Pod e lê qualquer linha dela como um cast de bytes, sem o borsh nunca tocar o dado. HeaderOnly dá lugar a uma cauda de verdade, PodU64 ganha uma família de irmãos para os campos que ficam nela, e a variante #[event(bytemuck)] que m01-l4 estacionou finalmente vence, porque emitir ela precisa exatamente da disciplina Pod que você acabou de pagar. Boa construção.
Pergunta 1 de 3