Carregando...

 BetaBeta
Na lição passada você deu ao cabinet-counter uma TABELA de recordes. Você parafusou uma cauda Slab no R1, empurrou scores para dentro dela, e viu a conta se atualizar no lugar sem nenhuma serialização da lista inteira. Isso funcionou por um motivo e um motivo só: cada pedaço daquele estado tinha tamanho fixo. Uma contagem de partidas PodU64, um recorde PodU64, uma sequência limitada de itens Score com um MAX de tempo de compilação. Tamanho fixo é exatamente o motivo pelo qual o Slab podia morar nos bytes da própria conta e ser lido com um cast em vez de uma desserialização.
Então vamos quebrar isso. Abra o header Cabinet do R1, o de quatro campos que você fez crescer na lição passada (authority, play_count, high_score, bump), e acrescente um campo que um fliperama de verdade obviamente iria querer, um nome fornecido pelo jogador:
pub owner_name: String, // <- add this line to Cabinet
Faça o build. Não compila, e o texto exato vai depender do seu rustc, mas a linha estrutural é sempre o mesmo trait bound:
error[E0277]: the trait bound `String: bytemuck::Pod` is not satisfied
Todo o resto que o compilador imprime aponta para esse único fato: Account<T> exige T: Pod, cada campo precisa de um layout fixo de tempo de compilação, e uma String é um ponteiro para o heap mais um comprimento em vez de uma sequência de bytes. Essa recusa é a lição inteira. O Pod te comprou velocidade proibindo a única coisa de que metade das suas structs acaba precisando: tamanho variável. No momento em que um campo é uma String, ou um conjunto sem máximo de tempo de compilação, o cast direto de bytes é uma mentira, porque não há bytes fixos para fazer cast. O Anchor V2 sabe disso, e mantém exatamente um wrapper para o caso em que o Pod genuinamente não alcança. Esta lição é sobre esse wrapper, quando recorrer a ele, e as duas arestas cortantes que você herda no momento em que recorre.
O recuo desta vez opera sobre julgamento em vez de código, porque o entregável é uma decisão de design, não um build. Eu modelo uma conta mista por inteiro para você ver o raciocínio. No Lab você declara o nível de cada campo antes de mim, uma linha por vez, e se confere contra o meu. Depois, no challenge, você pega uma conta diferente a frio, resolve sozinho o campo ambíguo dela, e justifica cada escolha em uma frase sem nada com que se conferir. Trabalhado, depois completion, depois solo, como sempre.
Comece pelo enquadramento honesto, porque é a coisa que a maioria das pessoas erra. A válvula de escape não é uma derrota, e o Pod não é "o jeito bom" contra o "jeito ruim" do borsh. São dois níveis de um design deliberado, e a habilidade que esta lição treina é saber a qual nível um campo dado pertence.
Aqui está a pergunta motivadora, a que o erro de String força em você. Você tem um campo cujo comprimento você genuinamente não consegue saber em tempo de compilação. Quais são as suas opções?
Descarte primeiro as respostas ingênuas, porque descartá-las é o que faz a resposta real parecer necessária em vez de arbitrária.
A primeira resposta ingênua: limite o campo. Guarde o nome como um PodVec<u8, 64>, trate-o como no máximo sessenta e quatro bytes, e continue no caminho zero-copy. Isso não é errado. Se um teto de sessenta e quatro bytes é aceitável, essa é a resposta correta, e você deve pegá-la. Mas leia o requisito de novo. O campo está especificado como de tamanho arbitrário. Um PodVec é limitado por definição, então no instante em que "arbitrário" é uma restrição real e não uma ressalva, o limite é uma violação de spec vestindo um check verde. O limite é a ferramenta certa para um campo limitado rotulado errado como ilimitado, e a ferramenta errada para um genuinamente ilimitado.
A segunda resposta ingênua: não guarde o nome de jeito nenhum. Faça hash do nome, mantenha o digest de 32 bytes on-chain como um [u8; 32] (que é Pod), e guarde a string de verdade em algum lugar off-chain. Para o problema certo, esse é um design perfeitamente bom. Mas agora você não consegue renderizar o nome a partir da conta, você acrescentou uma dependência off-chain e uma consulta, e você mudou em silêncio o que a conta é. Se o programa realmente precisa dos bytes on-chain, essa resposta resolveu um problema diferente daquele que você tem.
Então a pergunta real se estreita nisso: como você coloca um valor genuinamente de tamanho variável dentro de uma conta quando um cast fixo é impossível e você não pode se permitir mover os dados para off-chain?
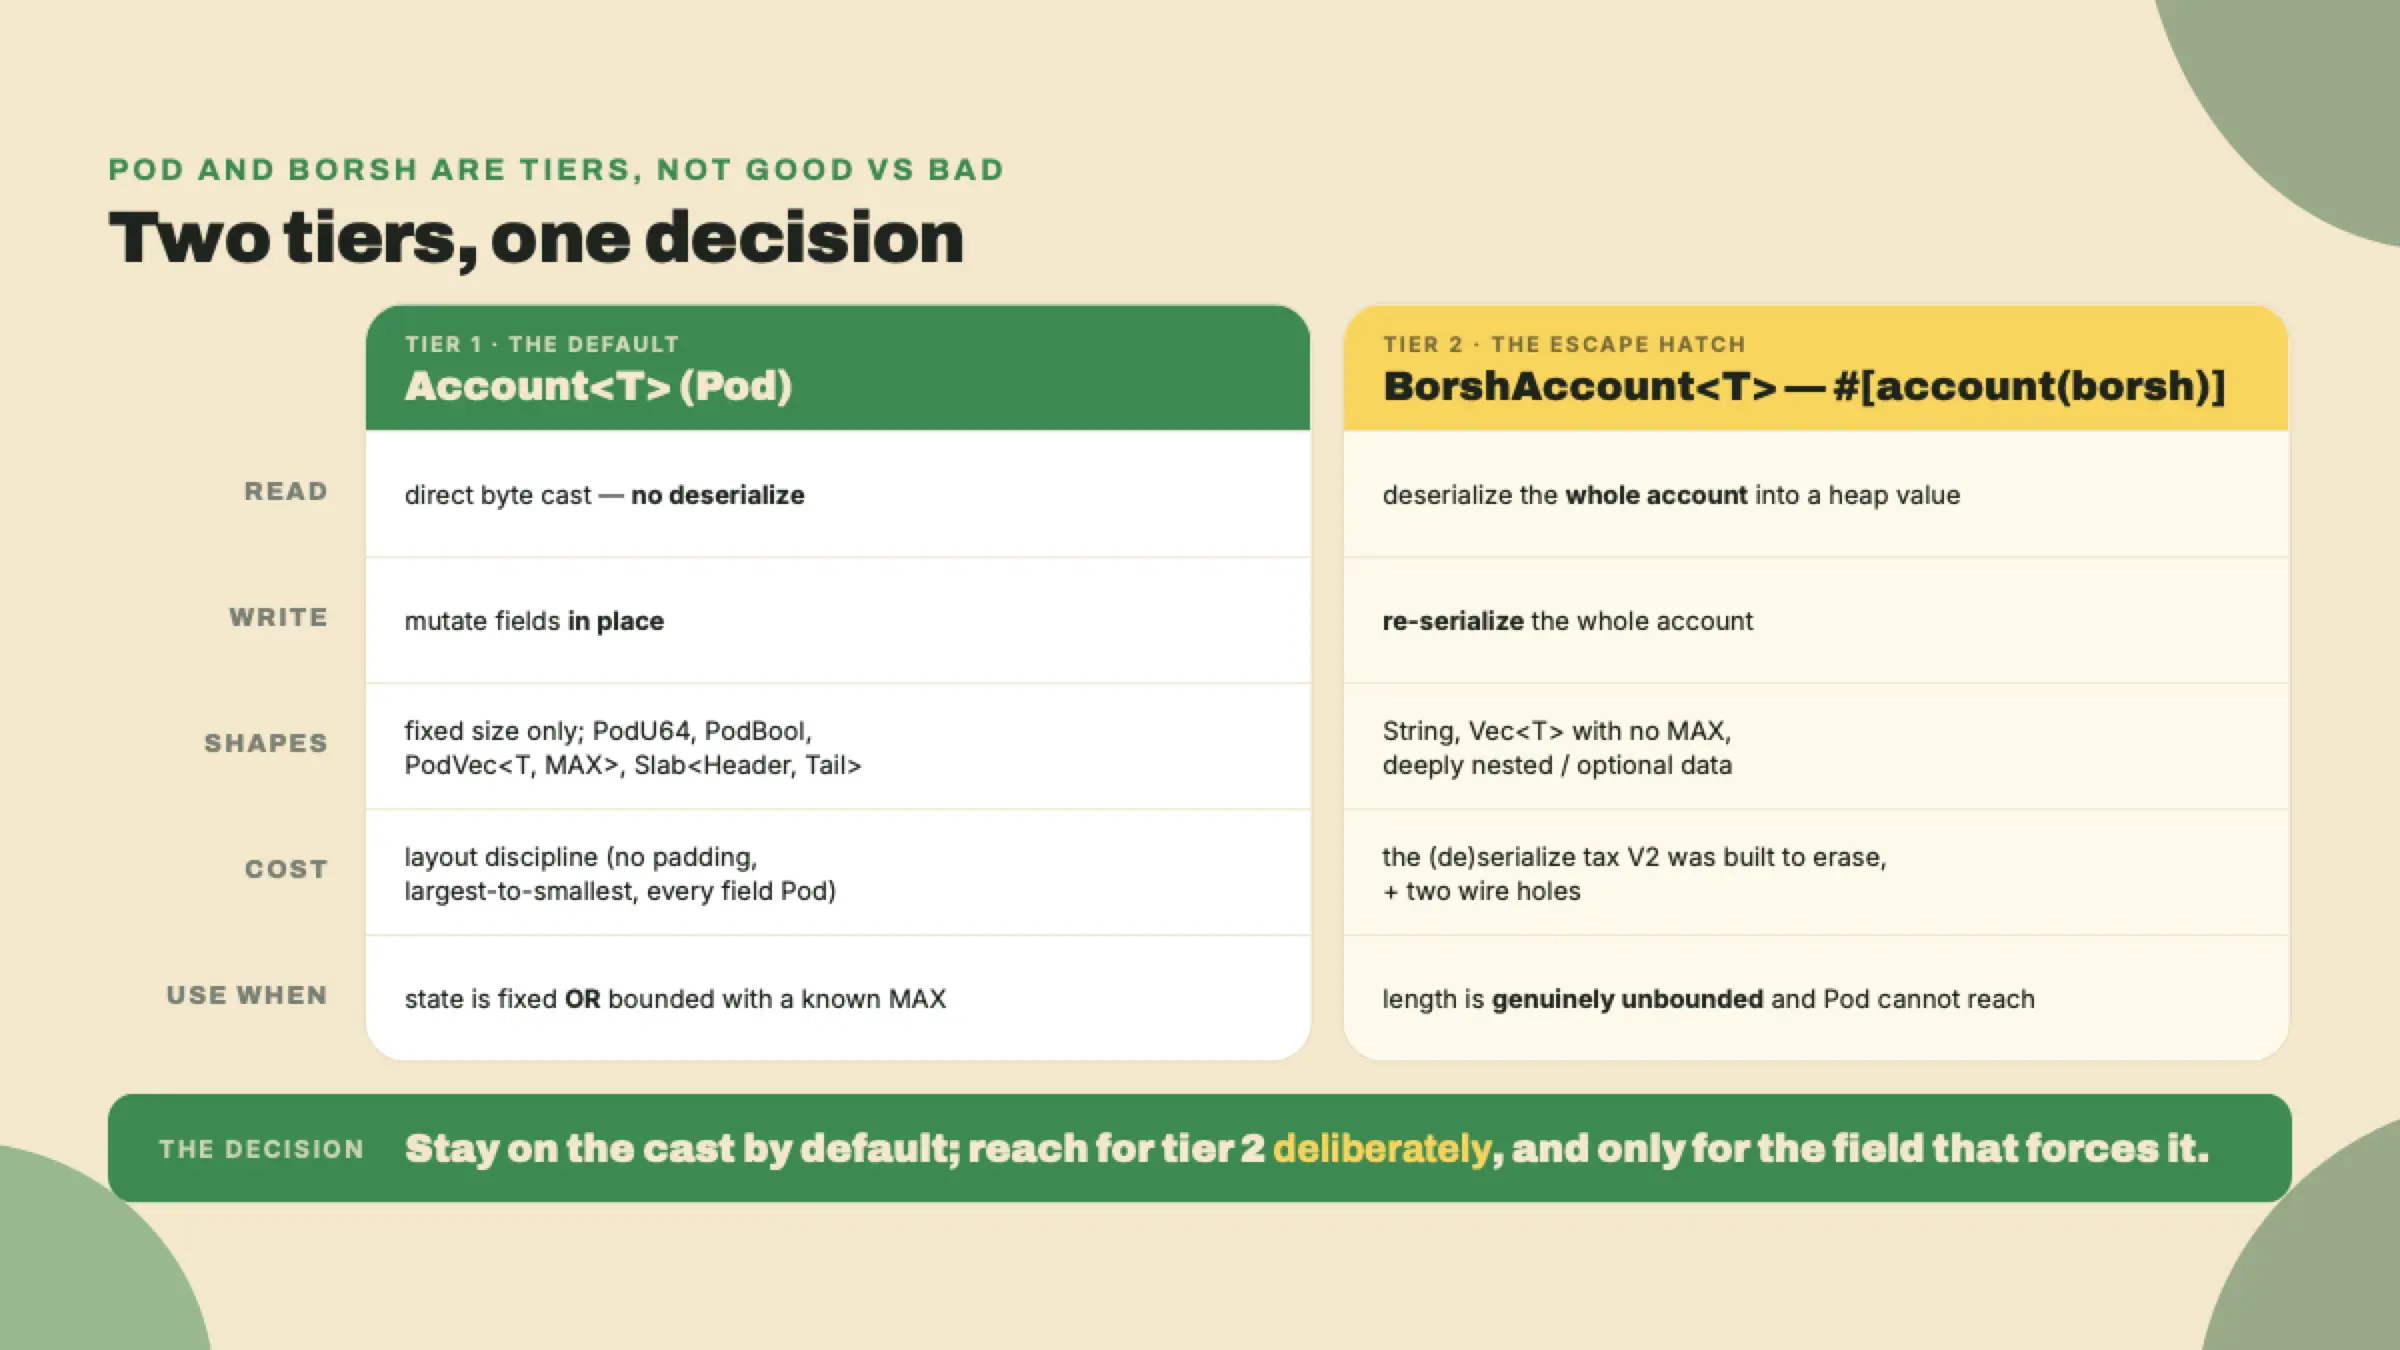
A resposta do Anchor V2 é o atributo #[account(borsh)] emparelhado com o wrapper BorshAccount<T>. O atributo vai na struct, e faz exatamente uma coisa: tira aquele tipo da exigência T: Pod e o coloca num modelo de desserialização na leitura. O wrapper vai na conta dentro do seu contexto #[derive(Accounts)], no espaço onde você escreveria Account<T>.
// A type that CANNOT be Pod, and doesn't try to be.
#[account(borsh)]
pub struct CabinetProfile {
    pub owner: Address,
    pub description: String, // variable length - the whole reason we're here
}

#[derive(Accounts)]
pub struct EditProfile {
    #[account(mut)]
    pub profile: BorshAccount<CabinetProfile>, // deserializes on read
    pub owner: Signer,
}
Note o que BorshAccount<CabinetProfile> está fazendo que Account<Cabinet> nunca fez. Quando o seu handler toca profile.description, o wrapper não te entrega uma view sobre os bytes crus. Ele lê os dados da conta e desserializa a coisa inteira para um valor Rust alocado no heap, String e tudo. Quando você escreve, ele serializa o valor inteiro de volta. Essa é exatamente a coisa que o zero-copy foi construído para evitar, e aqui você está escolhendo isso de propósito, porque a alternativa é não ter o campo de jeito nenhum.
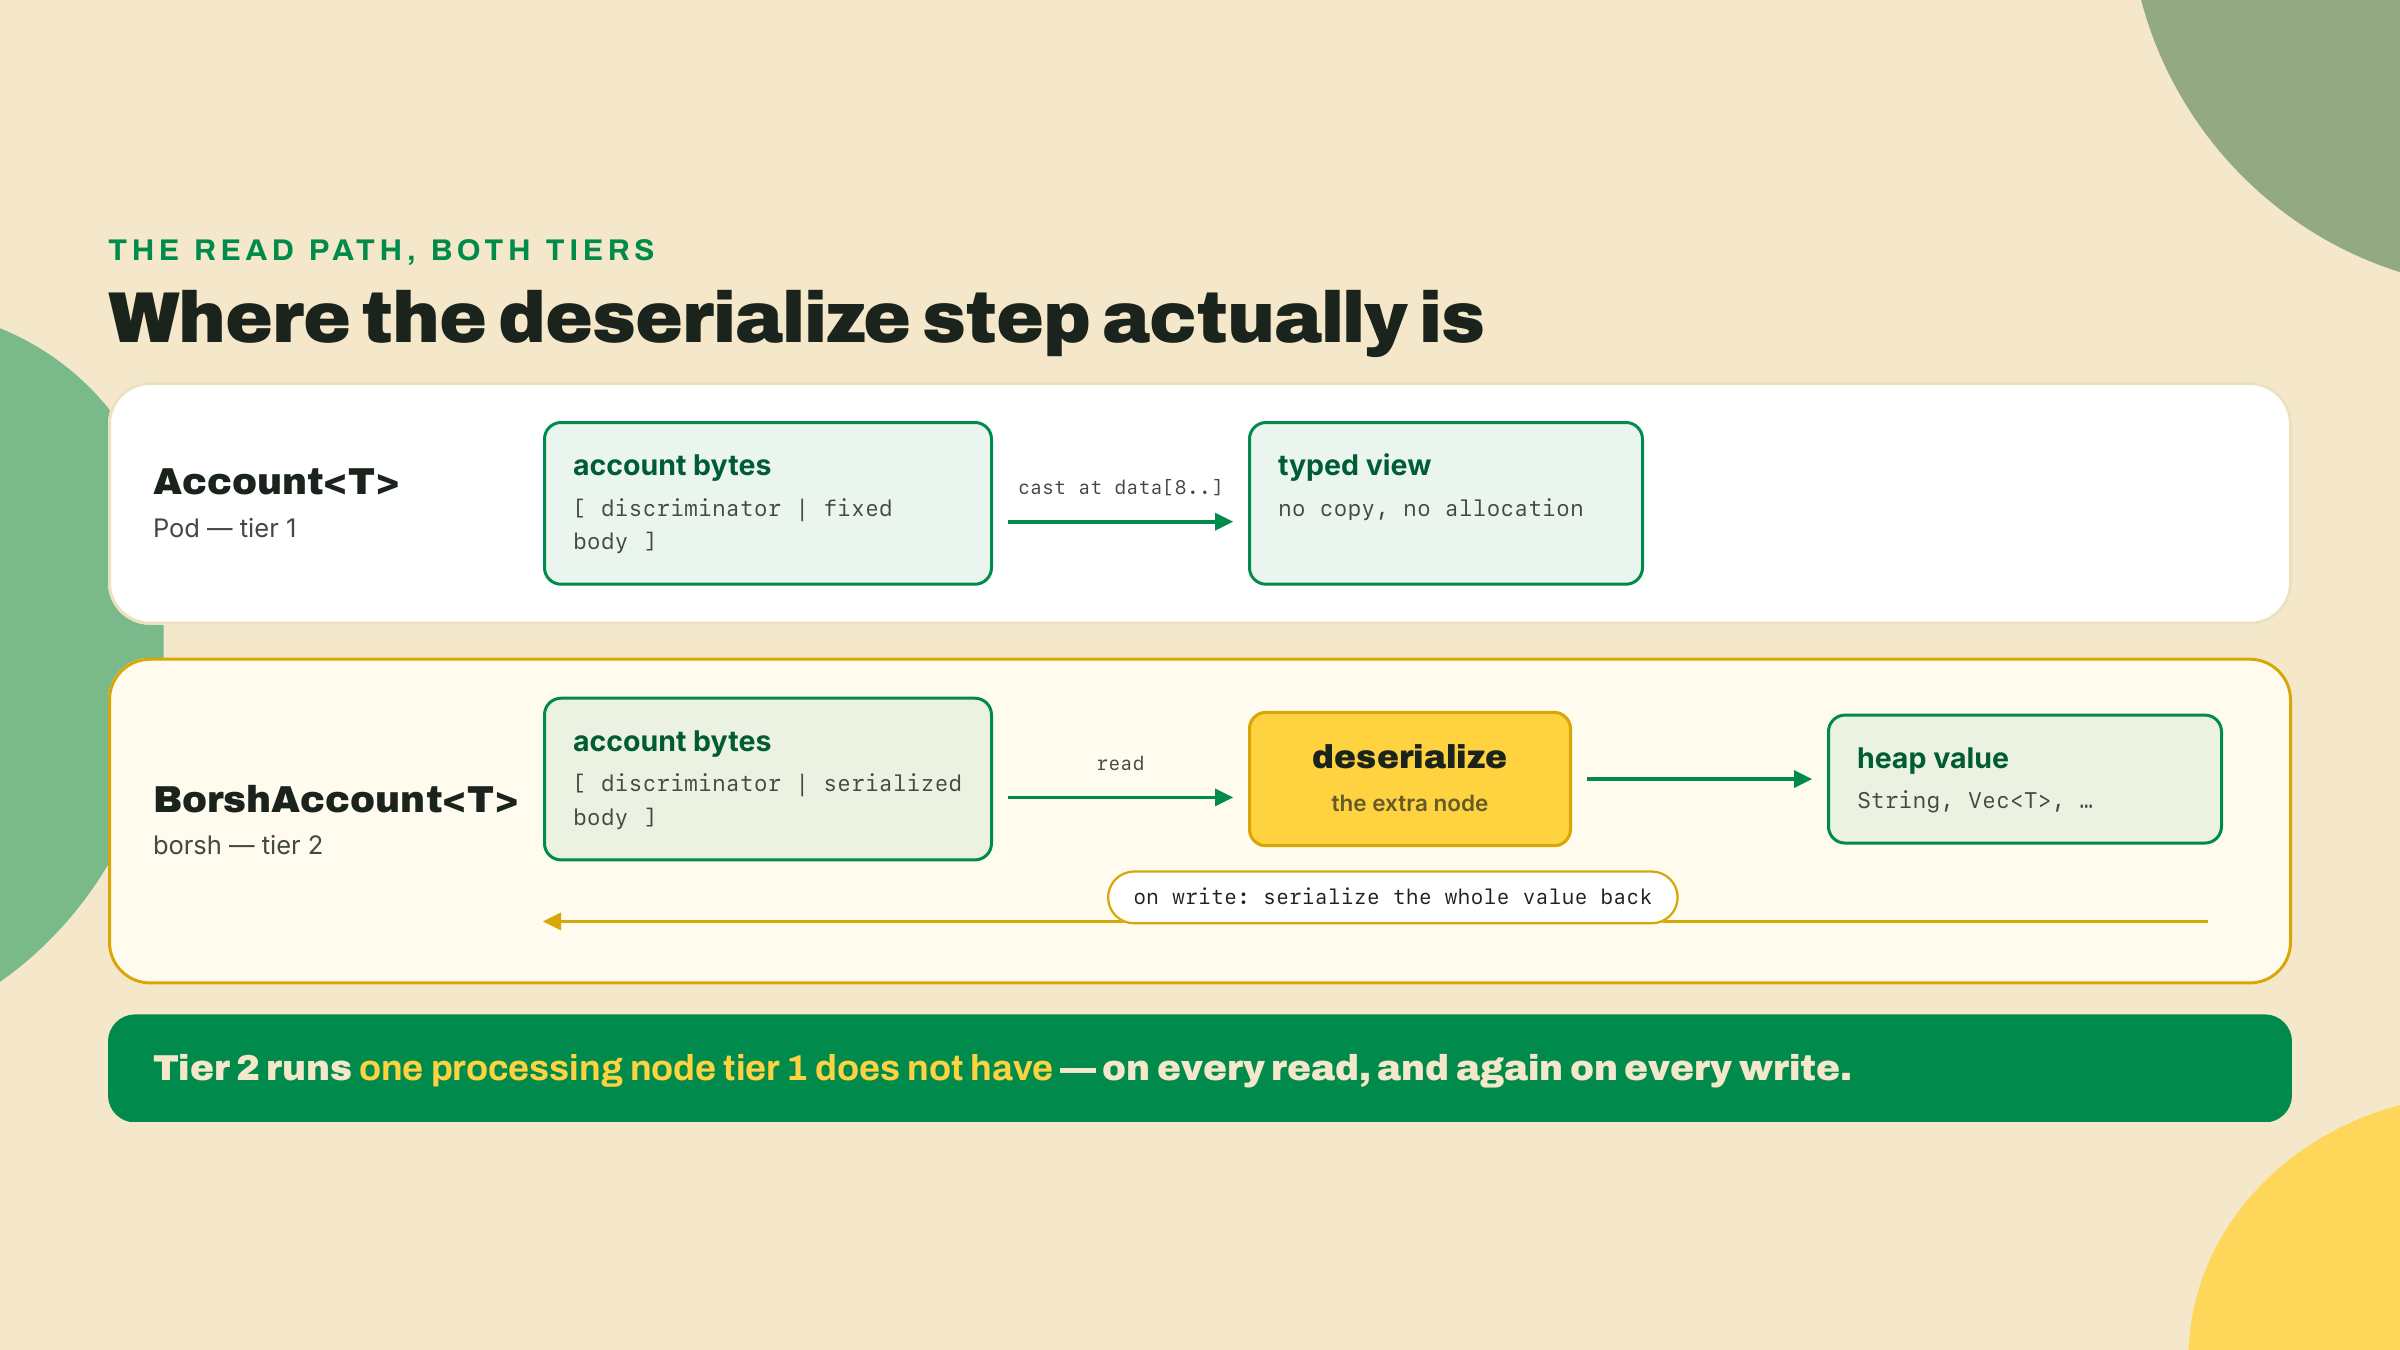
Seja franco sobre quanto isso custa, porque a resposta não é um número único, e tratá-la como um é como as pessoas ou se desesperam ou ficam complacentes. Separe o caso médio do pior caso. Numa struct borsh minúscula, um único Address e um nome de dez caracteres, a desserialização é barata em termos absolutos; você teria dificuldade de medi-la contra o resto de um handler. Esse é o caso médio, e é por isso que "borsh é lento" é grosseiro demais para ser útil. O pior caso é o que morde: o custo de desserialização escala com o tamanho dos dados, então um BorshAccount guardando uma descrição de quatro kilobytes paga uma desserialização de quatro kilobytes em cada instrução que a carrega, e uma reserialização de quatro kilobytes na saída quando ela era gravável. Um cast Pod não se importa se a conta tem cinquenta bytes ou quatro kilobytes; ele lê o campo que você pediu e para. Então o enquadramento honesto não é "borsh é lento" mas "o custo do borsh é proporcional ao tamanho inteiro da conta e pago em cada acesso, enquanto o do Pod é constante e quase zero." Essa proporcionalidade é exatamente o motivo pelo qual você isola o campo grande e variável em vez de fundi-lo na conta que você toca constantemente.
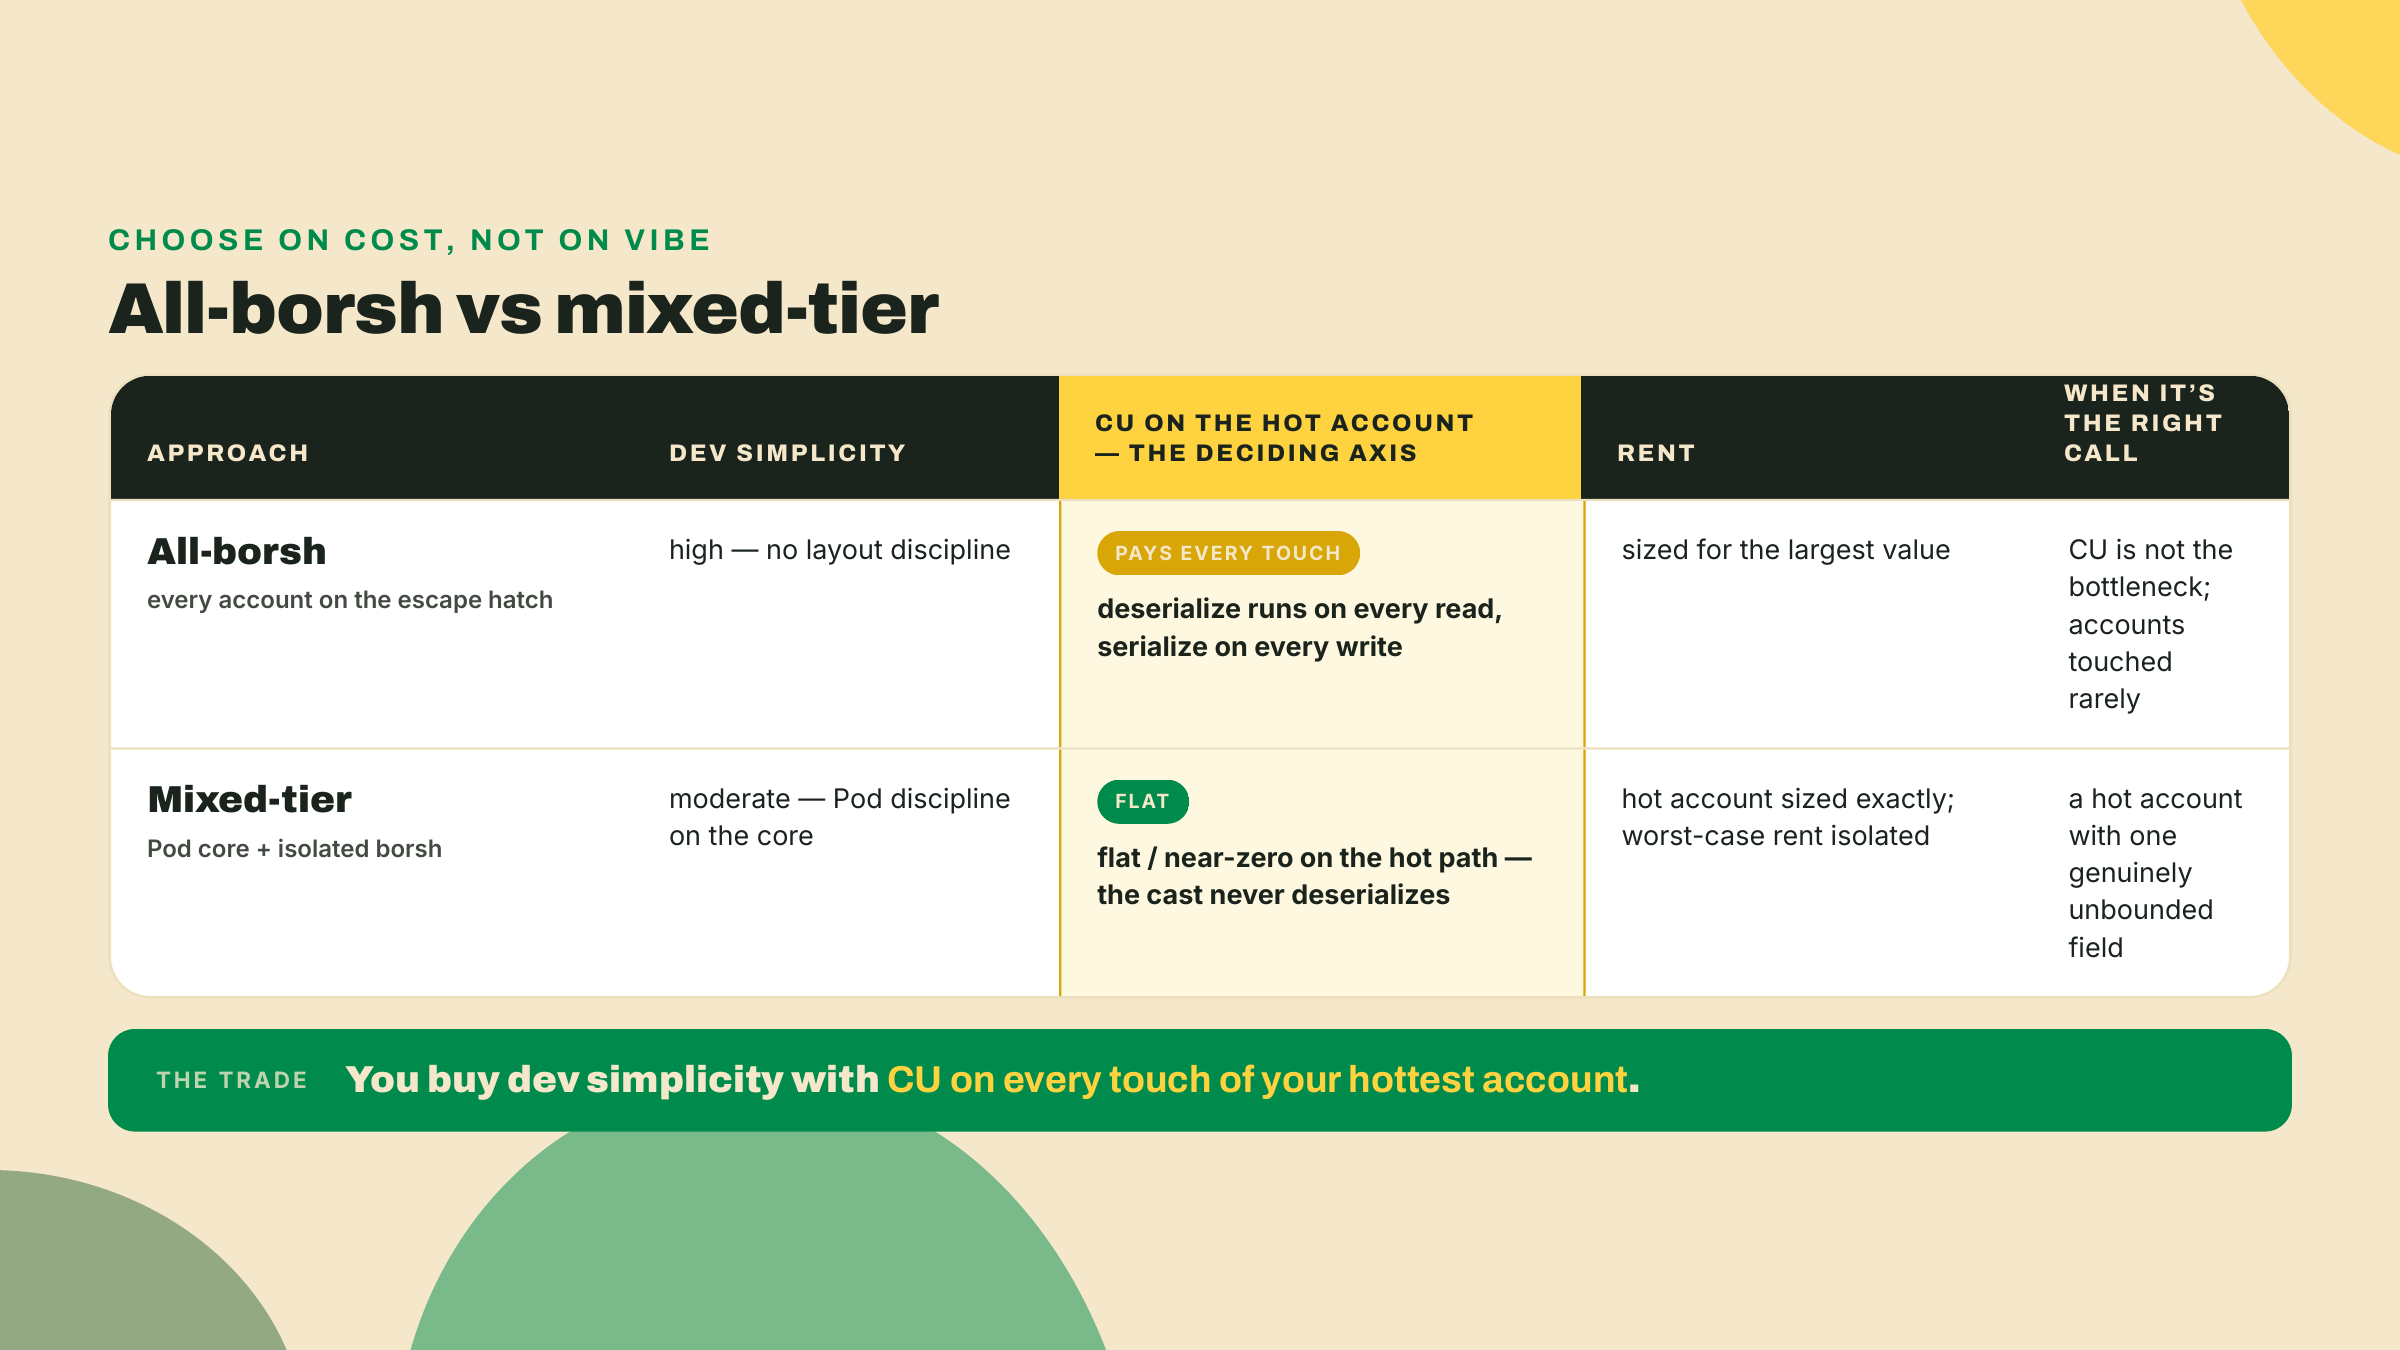
Diga o trade-off em voz alta, porque nomeá-lo é a jogada de credibilidade e pulá-lo é como as pessoas entregam o nível errado. O BorshAccount te compra tamanho variável e dados aninhados ou opcionais com facilidade. Você paga de volta no custo de (des)serialização que a tese inteira do V2 foi construída para eliminar, e, como a gente vai ver em seguida, em duas incompatibilidades de wire documentadas. Ele merece o seu lugar só onde o Pod genuinamente não alcança. O corolário é a parte que as pessoas perdem: uma conta mista, uma com alguns campos fixos e um campo ilimitado, não deve virar all-borsh por inteiro. Ela deve manter as suas partes fixas e limitadas em Pod e isolar a parte ilimitada. Mais sobre isso no lab, porque essa é a habilidade de design de verdade.
Antes de a gente ir mais longe, construa a versão mais forte da posição contra a qual acabei de argumentar, porque ela é genuinamente razoável e você vai sentir a atração dela. O argumento vai assim: o Pod é um sofrimento. Disciplina de layout, nenhum preenchimento, ordenação de campos do maior para o menor, wrappers Pod em cada campo, o imposto inteiro que você passou o módulo 2 aprendendo a pagar. O BorshAccount faz tudo isso desaparecer. Ponha uma String, um Vec, um Option, o que você quiser numa struct, derive o serializador, e siga com a sua vida. Por que não simplesmente fazer de cada conta um BorshAccount e parar de lutar contra o layout de bytes?
Conceda a parte válida, porque ela é real. Para um programa em que a CU não é o gargalo, em que as contas são tocadas raramente e os dados são genuinamente irregulares, all-borsh é mais simples, e código mais simples tem menos bugs. Eu já entreguei a versão all-borsh de um programa. Funciona bem, até deixar de funcionar. Então o argumento se sustenta: é uma troca real, e no eixo da simplicidade o borsh ganha.
Agora refine, porque o eixo que aquele argumento otimiza não é o eixo sobre o qual o V2 foi construído. Comparado a quê? Comparado ao Account<T>, cuja razão inteira de existir é que a desserialização default do v1 era, nas palavras do próprio framework na issue #4390, "o caminho lento" e "a reclamação de performance número um dos desenvolvedores do Anchor." Escolher all-borsh é escolher reintroduzir, em cada conta, exatamente o custo que a reescrita inteira se propôs a apagar. Numa conta que você toca uma vez por mês, tanto faz. Na conta quente de um programa que roda milhares de vezes por slot, você acabou de pagar de volta por inteiro a otimização de destaque do framework, sobre dados que na maior parte não precisavam dela. A simplicidade era real; ela também estava precificada em CU, e você não leu o recibo. É isso que "comparado a quê?" te compra: transforma "borsh é mais simples" de um veredito em uma troca com um custo nomeado, e o custo é exatamente a coisa que este curso existe para te ensinar a ver.
Agora a parte que morde em produção, e o motivo pelo qual esta lição existe num curso de framework em vez de numa nota de pé de página.
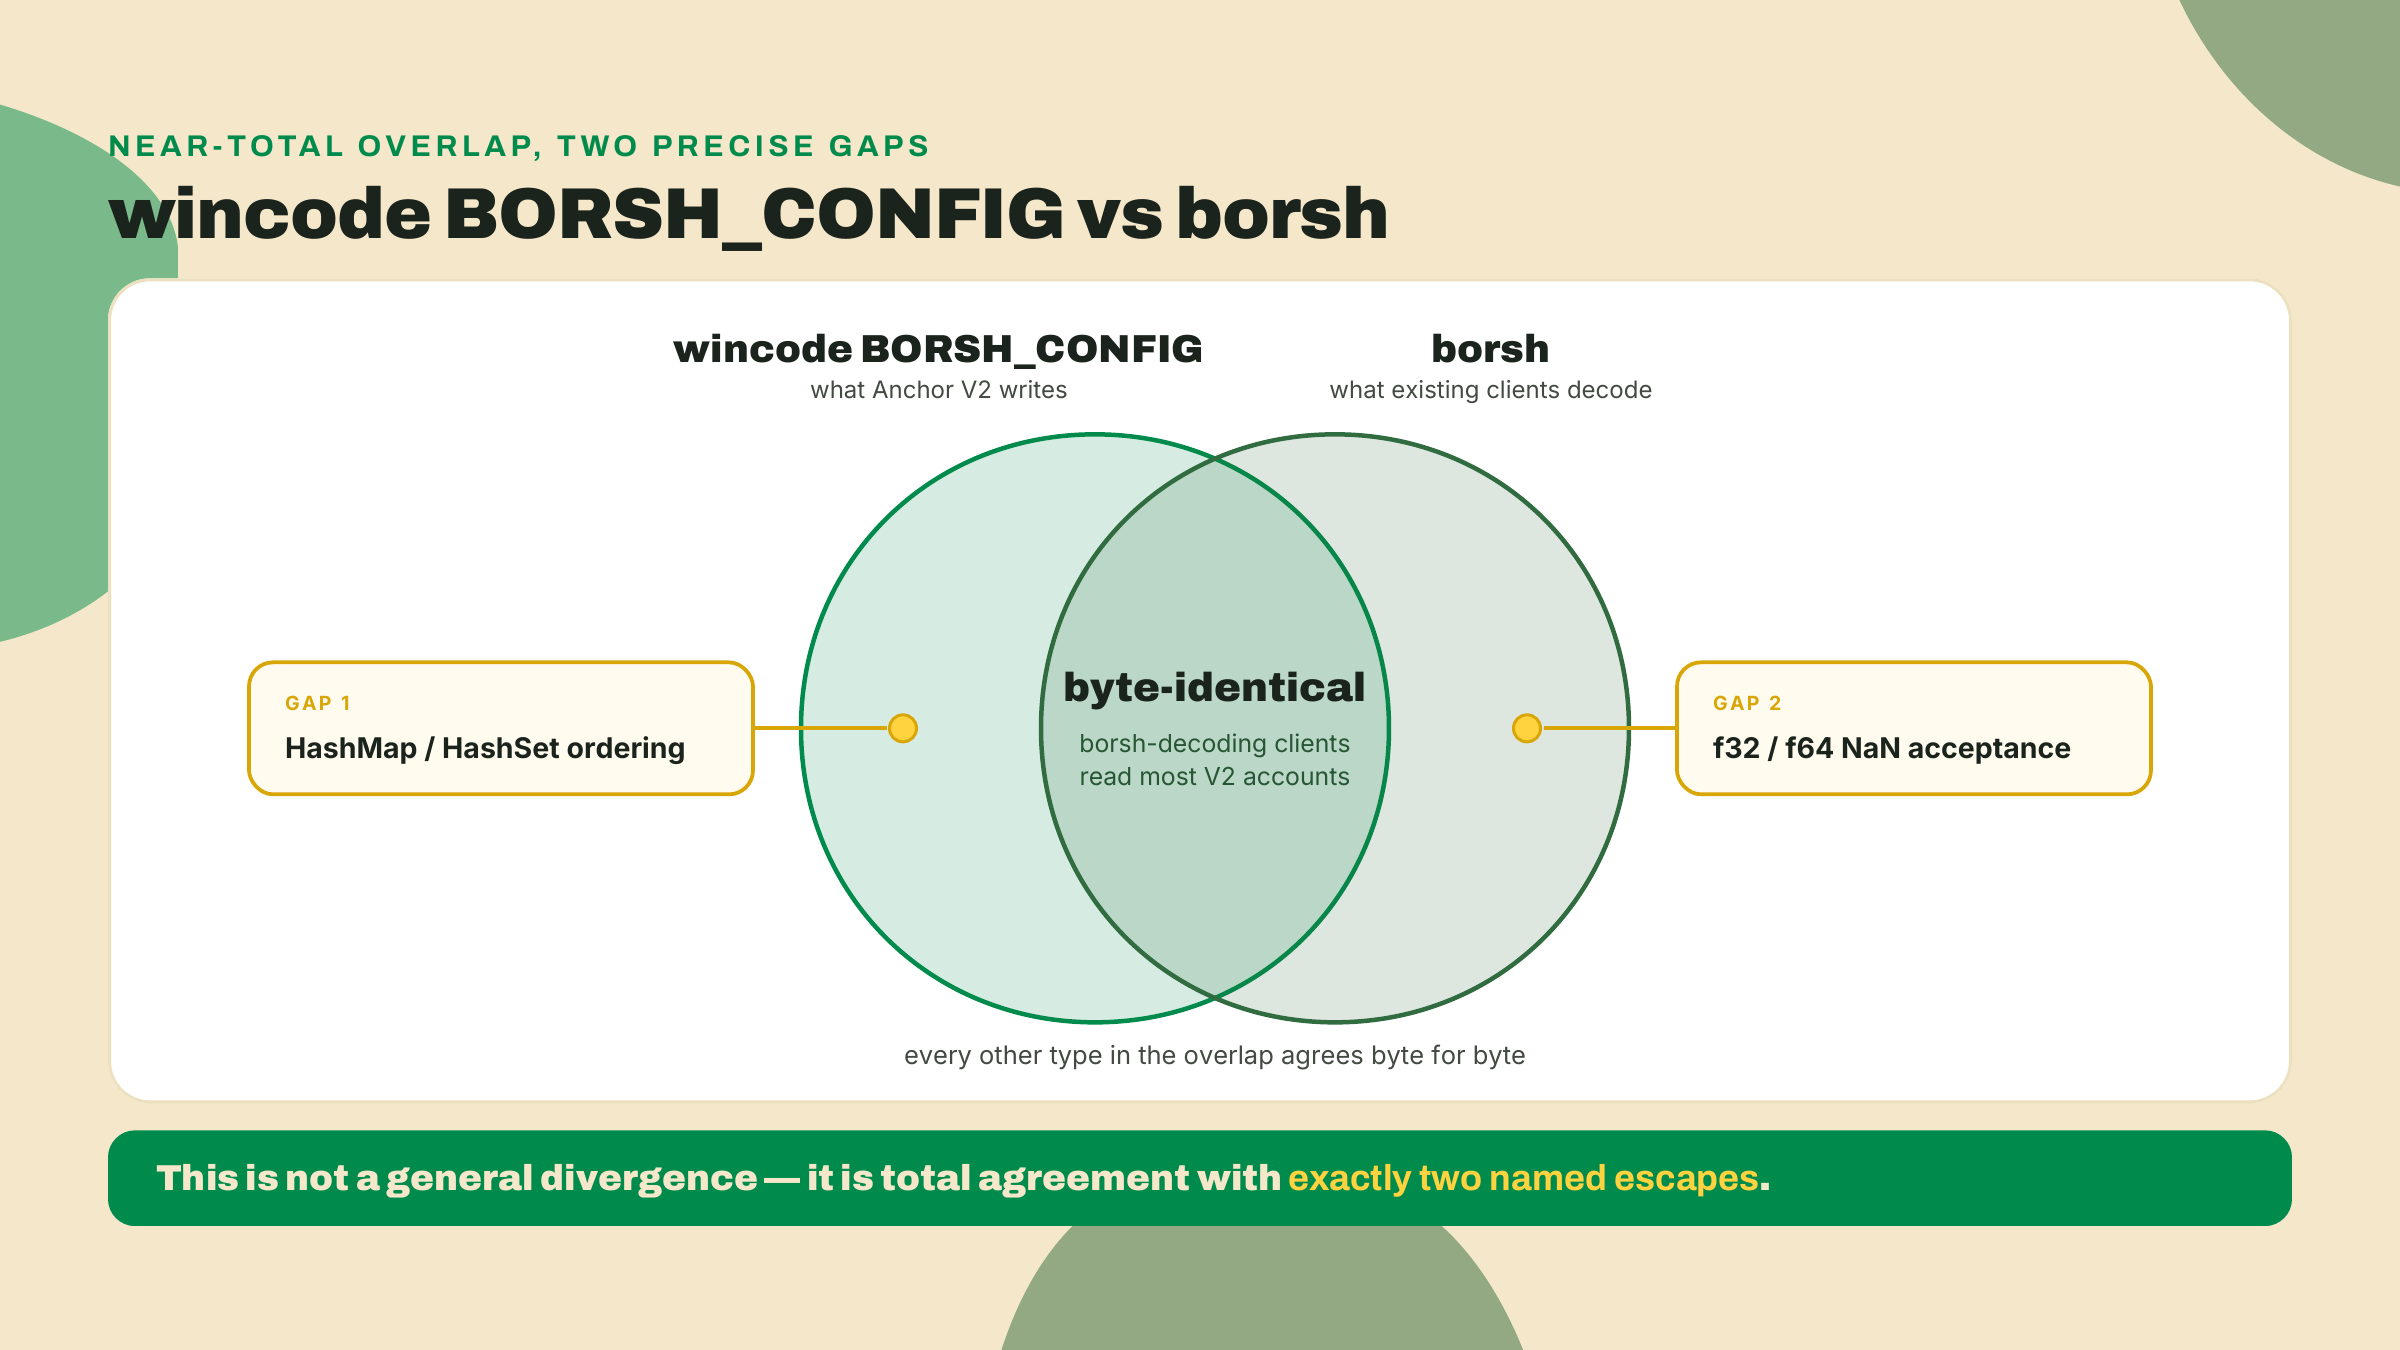
O serializador default do V2 não é o borsh clássico. Ele se chama wincode, e o seu BORSH_CONFIG é idêntico byte a byte ao borsh, com duas exceções documentadas. Esse "idêntico byte a byte, exceto" é a história inteira, então vamos ser precisos sobre as duas metades.
Comece pela pergunta que o design tinha de responder, porque a resposta não é óbvia. O V2 é uma reescrita do zero. Ele poderia ter entregado qualquer formato de wire que quisesse. Existe um ecossistema inteiro de ferramental por aí, indexadores, explorers, leitores off-chain, que já fala borsh, porque o borsh foi o wire do Anchor por anos. Então a pergunta de design era: você forka o formato de wire e força cada um desses consumidores a reescrever os seus decodificadores, ou você fica compatível e herda o ecossistema de graça? Colocada desse jeito, a resposta se escolhe sozinha. O wincode mantém o layout de bytes do borsh precisamente para que os decodificadores existentes continuem funcionando. Adotar o V2 não forka o wire. Esse é um presente de compatibilidade deliberado, e na maior parte do tempo você consegue aproveitá-lo sem pensar.
Aliás, você já conheceu esse serializador. Na lição passada, quando você emitiu um #[event(bytemuck)] e eu notei que um #[event] simples serializa com o wincode sob uma config idêntica à do borsh, aquele wire de evento simples é exatamente esse serializador. O evento default, o corpo de conta default, o mesmo serializador por baixo. Então a história de compatibilidade não é duas histórias: o motivo pelo qual um indexador que lê borsh consegue parsear os seus eventos V2 é o mesmo motivo pelo qual ele consegue parsear os seus bytes de BorshAccount. Um formato de wire, compatível com borsh exceto em dois lugares, usado para os dois. Isso vale guardar, porque significa que os dois buracos abaixo se aplicam aos seus eventos também, não só às suas contas.
Então por que é "idêntico byte a byte exceto" e não só "idêntico byte a byte"? Porque existem exatamente dois lugares em que o próprio comportamento do borsh já não é determinístico para começar, e um serializador que quer saída determinística tem de fazer uma escolha ali, e o wincode fez uma escolha diferente da que o borsh clássico fez. Os dois buracos são sobre determinismo, e uma vez que você vê por que cada um é não determinístico em primeiro lugar, a regra cola de vez.
O primeiro buraco é a ordenação de campos de HashMap e HashSet. A causa raiz é esta: um HashMap em Rust não tem ordem de iteração definida. A biblioteca padrão deliberadamente a randomiza a cada execução para se defender de ataques de hash-flooding, então "itere o map e serialize as entradas nessa ordem" é uma sequência de bytes diferente a cada execução. O borsh e o wincode resolvem essa indeterminação de formas diferentes, então se um campo da sua conta borsh é um HashMap e você depende da ordem em que as entradas dele caem no wire, você tem bytes não determinísticos: o mesmo estado lógico pode serializar de duas formas, e um cliente que decodifica borsh lendo uma conta escrita por wincode pode discordar sobre a ordem. A conta não está corrompida. Ela só não é estável em ordem entre os dois codificadores, e qualquer coisa que faça hash ou assine sobre os bytes crus vai notar imediatamente.
O segundo buraco é a aceitação de NaN em f32 e f64. A causa raiz aqui é que NaN não é um valor só. O padrão de float IEEE-754 define uma faixa inteira de padrões de bits que todos significam "não é um número," e NaN não é nem igual a si mesmo. Então "serialize este float" é ambíguo no momento em que o float pode ser NaN: qual padrão de bits de NaN você escreve, e você aceita algum? Os dois codificadores diferem sobre aceitarem ou não um valor NaN. Se a sua struct carrega um float que pode ser NaN, eles podem discordar sobre se o valor é legal no wire. (Floats no estado on-chain são um sinal de alerta por outros motivos, matemática financeira determinística quer inteiros e ponto fixo, mas se você os tem, essa é uma aresta real.)
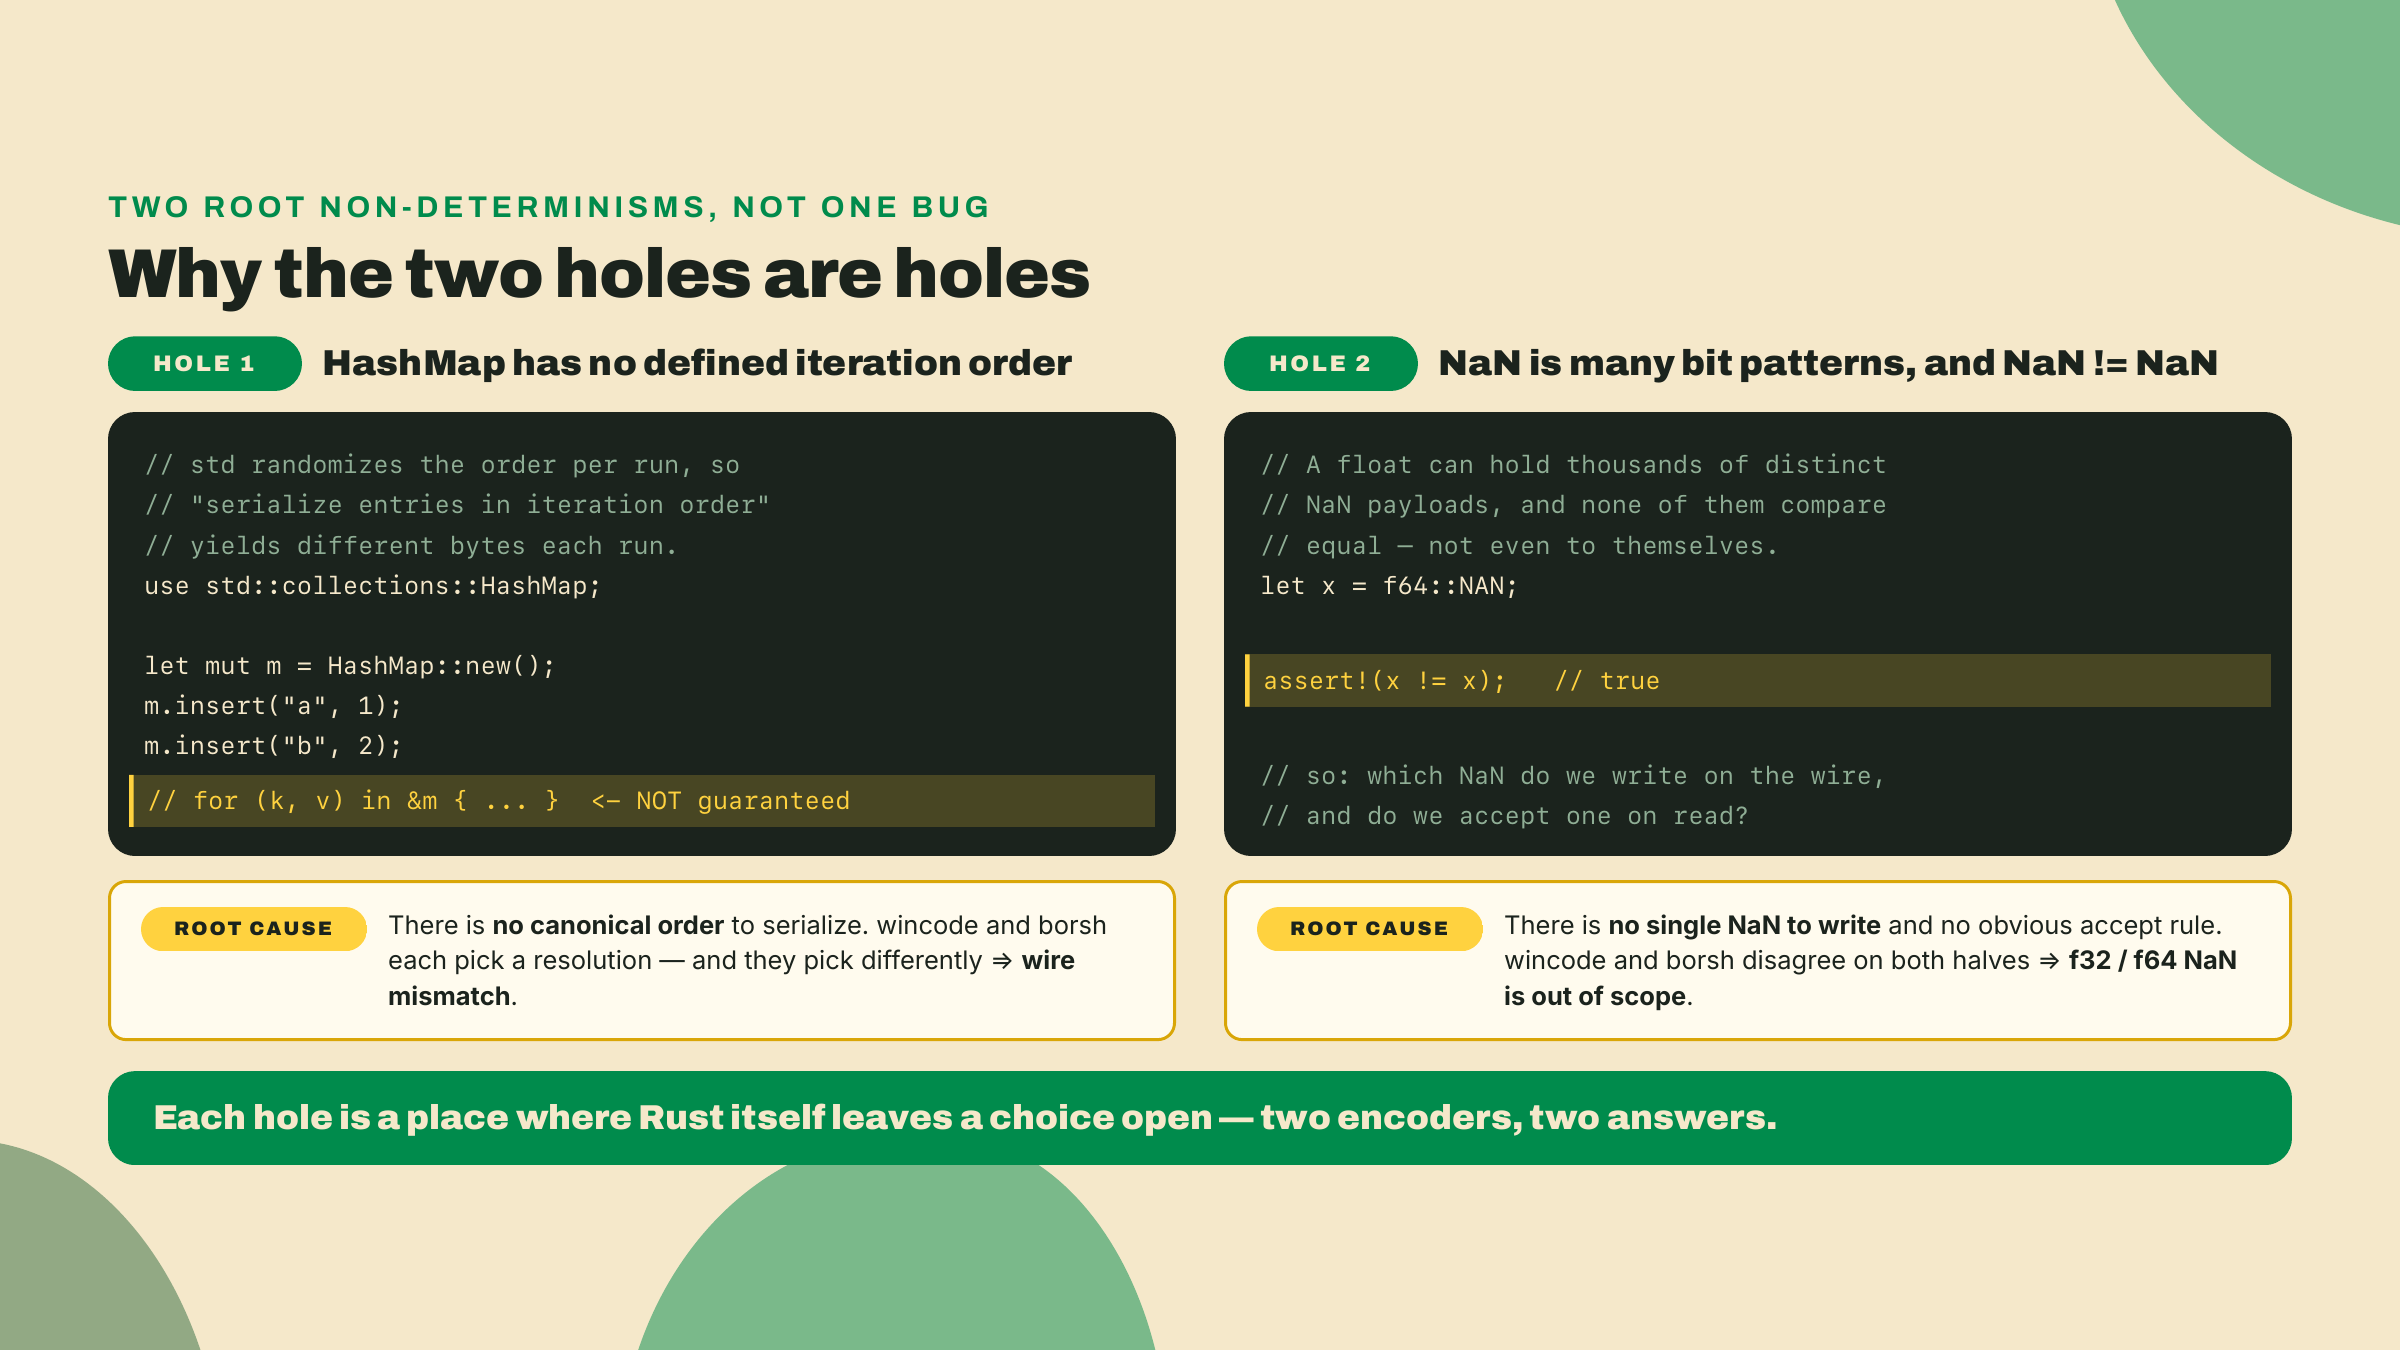
Junte os dois e a regra sai limpa. Um cliente que decodifica borsh consegue ler a maioria das contas wincode, mas não se você depende da ordenação de map ou set, e não se você depende de floats NaN. Se nenhuma das duas é verdade sobre a sua struct, e para a maioria esmagadora das contas nenhuma é, a compatibilidade se mantém e você pode seguir em frente. Se alguma das duas é verdade, você tem de decidir a história de codificação deliberadamente, porque o wire não é mais uma coisa só.
| Os dois buracos de wire | O que difere | Quando te morde |
|---|---|---|
ordenação de HashMap / HashSet | a ordem de iteração em que as entradas serializam | você depende da ordem do map, ou você faz hash/assina sobre os bytes crus da conta |
NaN de f32 / f64 | se um valor NaN é aceito no wire | a sua struct carrega um float que pode ser NaN |
Uma pergunta que este nível levanta merece uma resposta direta em vez de enrolação, porque errá-la é um bug de estado silencioso: como um BorshAccount se comporta através de uma CPI?
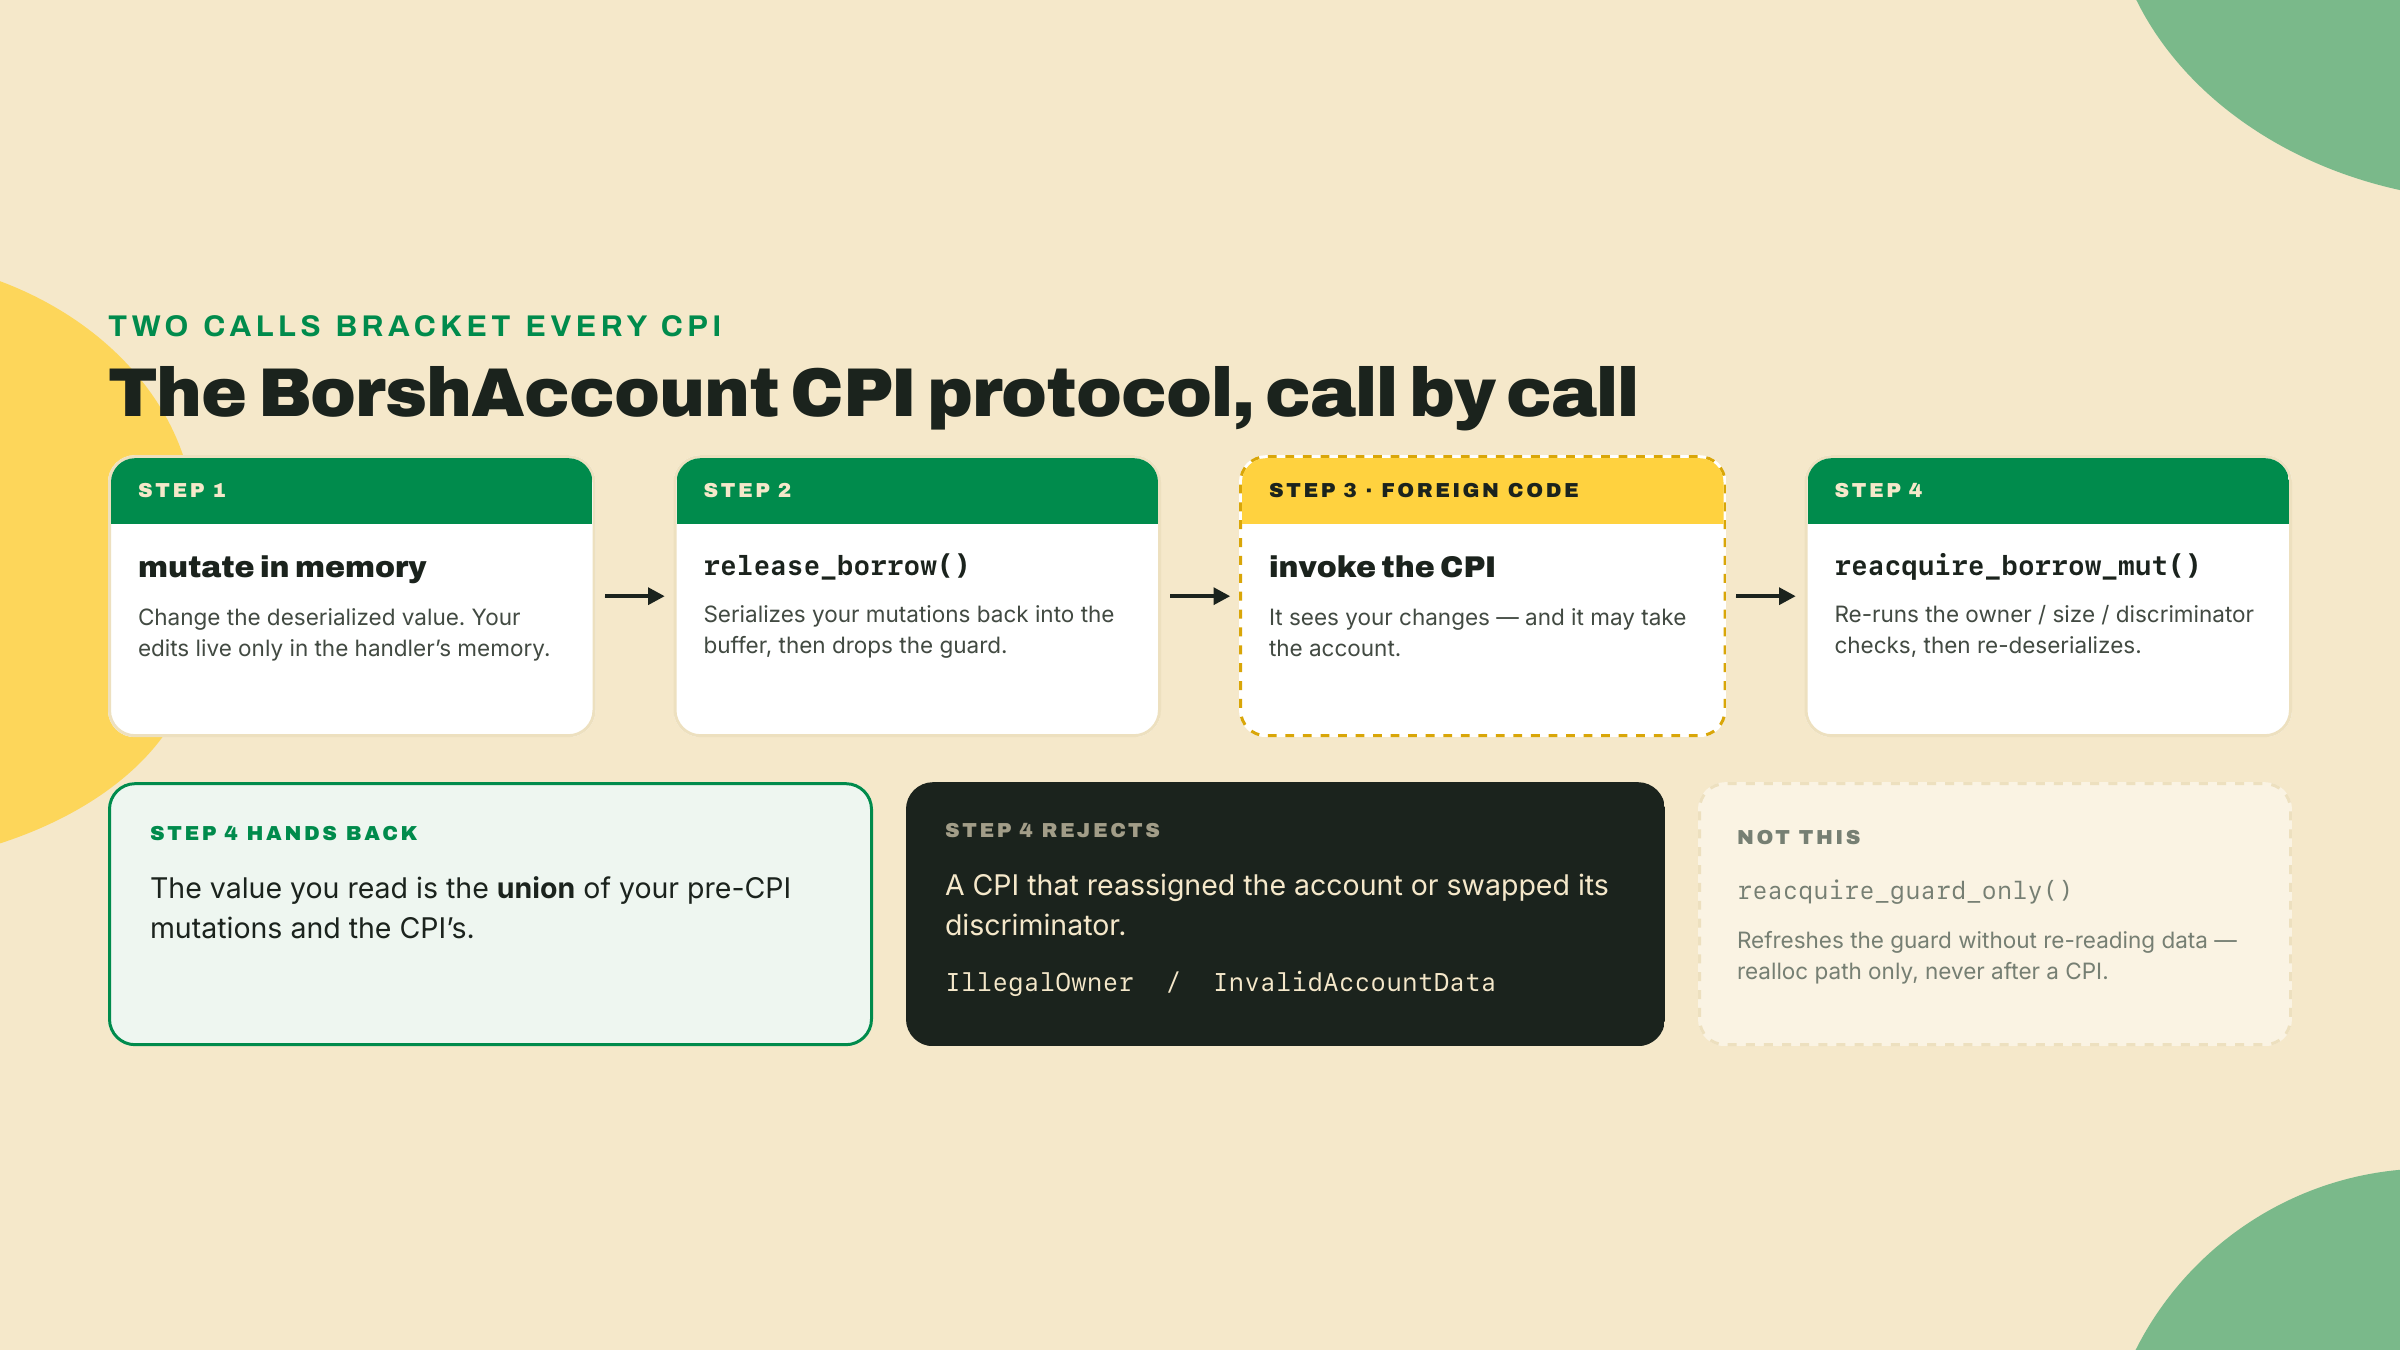
Aqui está por que a pergunta é afiada e não acadêmica. Um BorshAccount guarda um valor desserializado, uma cópia no heap do estado da conta, não uma view ao vivo sobre os bytes. Esse é o ponto inteiro do nível. Mas uma cópia pode ficar obsoleta. Se o seu handler desserializa uma conta borsh e então invoca uma CPI que muta os bytes daquela mesma conta on-chain, a cópia no heap que o seu handler ainda segura é anterior à CPI. Com o Account<T> de caminho lento do v1 essa era a clássica cilada do .reload(): deixe de recarregar depois de uma CPI e você raciocina sobre o estado pré-CPI.
Uma nota de nomenclatura antes do protocolo, porque o nome do tipo e a seção acima podem parecer se contradizer. BorshAccount<T> é um alias para SerializedAccount<T, BorshSerializer>, e BorshSerializer é o wincode sob o seu BORSH_CONFIG. Então o nome é sobre o formato, não sobre o crate: um BorshAccount escreve bytes em forma de borsh, produzidos pelo wincode, que é exatamente o motivo pelo qual os dois buracos acima são os dois lugares em que o nome deixa de ser uma promessa. Com isso resolvido: o tipo entrega um protocolo explícito de duas chamadas em torno de uma CPI. Antes da chamada você usa release_borrow(), que serializa as suas mutações em memória de volta para o buffer e solta a trava de borrow, para que a CPI veja as suas mudanças e possa tomar a conta. Depois da chamada você usa reacquire_borrow_mut(), que roda de novo as checagens completas de tempo de carga (owner, size, discriminator) e desserializa de novo o valor a partir do buffer ao vivo. A nota do próprio framework sobre o que você recebe de volta é precisa: o estado atualizado é a união das suas mutações pré-CPI e das mutações da CPI, e uma CPI que reatribuiu a conta ou trocou o discriminator dela é rejeitada com IllegalOwner ou InvalidAccountData em vez de ser aceita em silêncio. Existe um terceiro método, reacquire_guard_only(), que atualiza a trava sem reler os dados; esse é para o caminho de realloc e a documentação diz isso explicitamente, então não recorra a ele depois de uma CPI.
O contraste com o nível Pod vale ser guardado. Para o Account<T>, o modelo de borrow do CpiHandle do V2 transforma "você esqueceu de recarregar" em um erro de compilação, que você encontra de frente mais tarde no curso. Para o BorshAccount<T> a disciplina é um par de chamadas que você faz de propósito. Os dois são melhores que o silêncio do v1, mas só um deles é checado para você, que é mais um pequeno motivo pelo qual a válvula de escape continua sendo uma válvula de escape. Se o seu design desserializa uma conta borsh, invoca uma CPI que a toca, e então lê o valor, escreva mesmo assim o teste LiteSVM que afirma o valor pós-CPI: o protocolo está documentado, mas o seu uso dele é a coisa que vale comprovar.
Hora da primeira história de guerra do módulo, porque ela torna uma disciplina abstrata dolorosamente concreta.
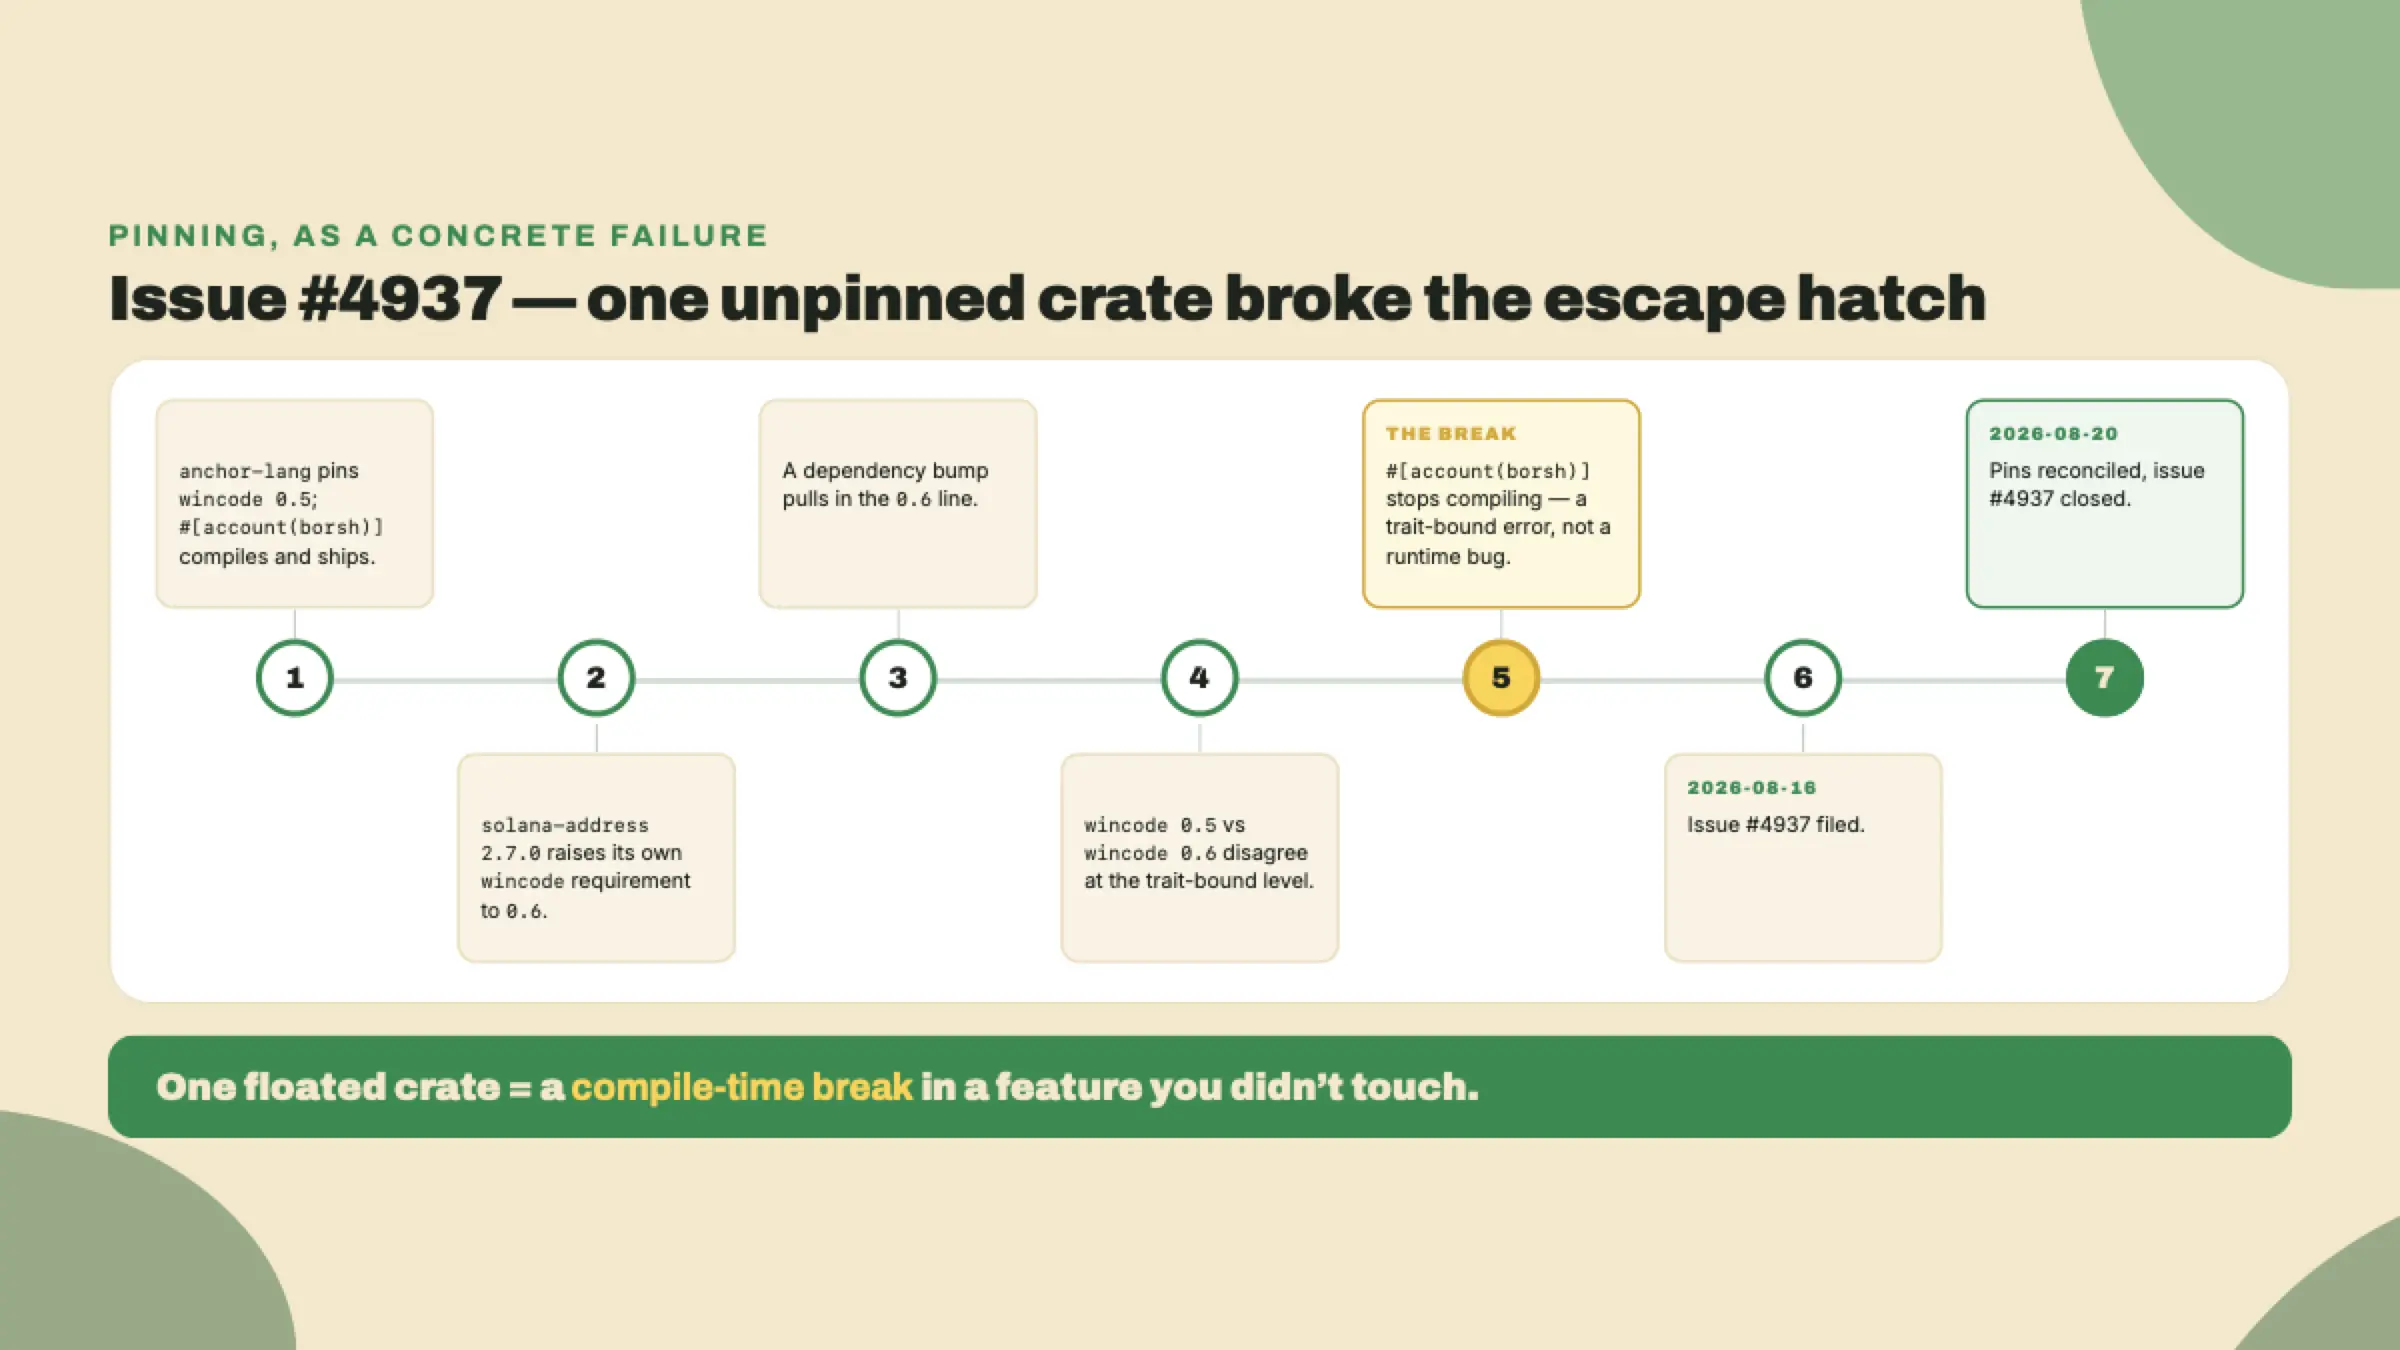
A issue #4937 foi aberta em 2026-08-16 e fechada quatro dias depois, em 2026-08-20. O bug: o anchor-lang fixava o wincode em 0.5 enquanto o solana-address 2.7.0 havia movido a sua própria exigência de wincode para 0.6. (O próprio solana-address nunca entregou nada além de uma linha 2.x — não existe solana-address 0.6; a versão que se moveu é a do wincode, e as duas frases abaixo acertam isso.) Aquelas duas versões discordavam no nível do trait bound, e a discordância quebrou o #[account(borsh)]. Não com uma falha de runtime, não com um bug sutil de wire, mas com um erro de compilação, um trait bound que não fechava mais, até os pins serem reconciliados. Alguém subiu uma dependência, e a válvula de escape que você acabou de aprender parou de compilar.
É por isso que você começou o PINS.md lá em m01-l2, uma tabela com uma coluna verified, e por isso que todo pin nestas lições carrega uma tag "isto vai mudar, re-verifique na escrita". Acrescente uma linha wincode nela agora se você ainda não tiver acrescentado. O V2 é um RC de poucas semanas, e o ref em que você está decide a resposta aqui: o wincode está em 0.5 no crate 2.0.0-rc.1 publicado e na tag v2.0.0-rc.1, e já se moveu para 0.6 na ponta da branch anchor-next. O crate do seu programa fixa wincode = "0.5" à mão, então a tag é o ref que concorda com ele — que é exatamente o motivo pelo qual todo bloco de instalação de m02-l1 em diante fixa --tag v2.0.0-rc.1 em vez da branch. Siga a branch no lugar disso e o anchor-lang da ponta exige solana-address 2.7.0, o seu teto < 2.7 recusa, e o cargo falha a resolução antes de uma única linha compilar. O solana-address tem a sua própria cadência. Você fixa tudo junto e não deixa nenhum crate flutuar, porque a #4937 é a cara de deixar um crate flutuar: um build verde na segunda, um erro de trait bound na terça, e uma tarde gasta fazendo bisect num grafo de dependências em vez de entregar.
A linha de instalação em si não é repetida aqui — o lab desta lição nunca invoca o toolchain. Se você realmente precisar reinstalar, use o bloco exato de m02-l1, --tag v2.0.0-rc.1 e --locked: a tag, nunca a branch.
Aqui está o problema de design, e é o que você vai enfrentar de verdade. O fliperama quer uma conta de perfil por máquina guardando três coisas:
[u8; 32], que nunca muda de comprimento.Score.A jogada preguiçosa é ver um campo ilimitado e fazer da conta inteira um BorshAccount. Resista. Isso abriria mão do zero-copy na chave fixa e no leaderboard limitado sem motivo, pagando o imposto de desserialização em dois terços da conta que nunca precisaram dele. A jogada disciplinada é modelar cada campo no nível a que ele pertence, e, quando um campo força o borsh, isolá-lo.
Passo 1, rotule cada campo antes de escrever uma linha. Declare todos os três agora, em voz alta ou num comentário, antes de ler o resto deste parágrafo; o ponto é pegar em qual deles você hesita. Resultado esperado: três rótulos, um dos quais te levou mais tempo que os outros dois. Aqui estão os meus. A chave de 32 bytes tem tamanho fixo, então ela é Pod, um [u8; 32] simples. O leaderboard é limitado em dez, então ele é um Slab ou um PodVec<Score, 10>, ainda Pod, ainda zero-copy, exatamente o que você construiu na lição passada. Só a descrição é ilimitada, então só a descrição força a válvula de escape.
Passo 2, divida a conta ao longo da fronteira entre os níveis. A estrutura limpa mantém as duas partes Pod juntas e isola a parte borsh. Um formato razoável: uma conta central Pod para a chave e o leaderboard, e um BorshAccount separado para a descrição, para que o estado fixo quente continue sendo lido com um cast e o estado variável frio pague o seu próprio imposto só quando tocado.
Duas decisões de formato no código abaixo valem ser apontadas, porque as duas parecem ir contra as regras da lição passada e nenhuma vai. Primeiro, o board é um campo PodVec em vez de uma cauda Slab. A regra de bolso da lição passada era que uma lista que é o ponto da conta ganha uma cauda Slab, e uma lista pendurada num registro maior ganha um campo PodVec. Aqui o ponto da conta é o registro central, chave e board juntos, e um Slab só pode ter uma cauda, então o board vai como campo. Segundo, a ordem dos campos: [u8; 32] fica acima de um PodVec muito maior, o que quebraria a regra do maior para o menor se essa regra fosse sobre tamanho. Ela é sobre alinhamento, e os dois aqui são alinhamento 1, então não há preenchimento que qualquer das ordens possa abrir. Ordene livremente quando tudo for alinhamento 1; ordene deliberadamente no instante em que um escalar nativo aparecer.
// Tier 1: fixed + bounded, stays zero-copy. Read with a cast.
#[account]
#[repr(C)]
pub struct CabinetCore {
    pub machine_key: [u8; 32],       // fixed - Pod
    pub board: PodVec<Score, 10>,    // bounded MAX=10 - Pod
}

// Tier 2: the ONE unbounded field, isolated behind the escape hatch.
#[account(borsh)]
pub struct CabinetDescription {
    pub text: String,                // unbounded - borsh, deserializes on read
}

#[derive(Accounts)]
pub struct EditCabinet {
    #[account(mut)]
    pub core: Account<CabinetCore>,               // cast, no deserialize
    #[account(mut)]
    pub description: BorshAccount<CabinetDescription>, // deserialize on read
    pub operator: Signer,
}
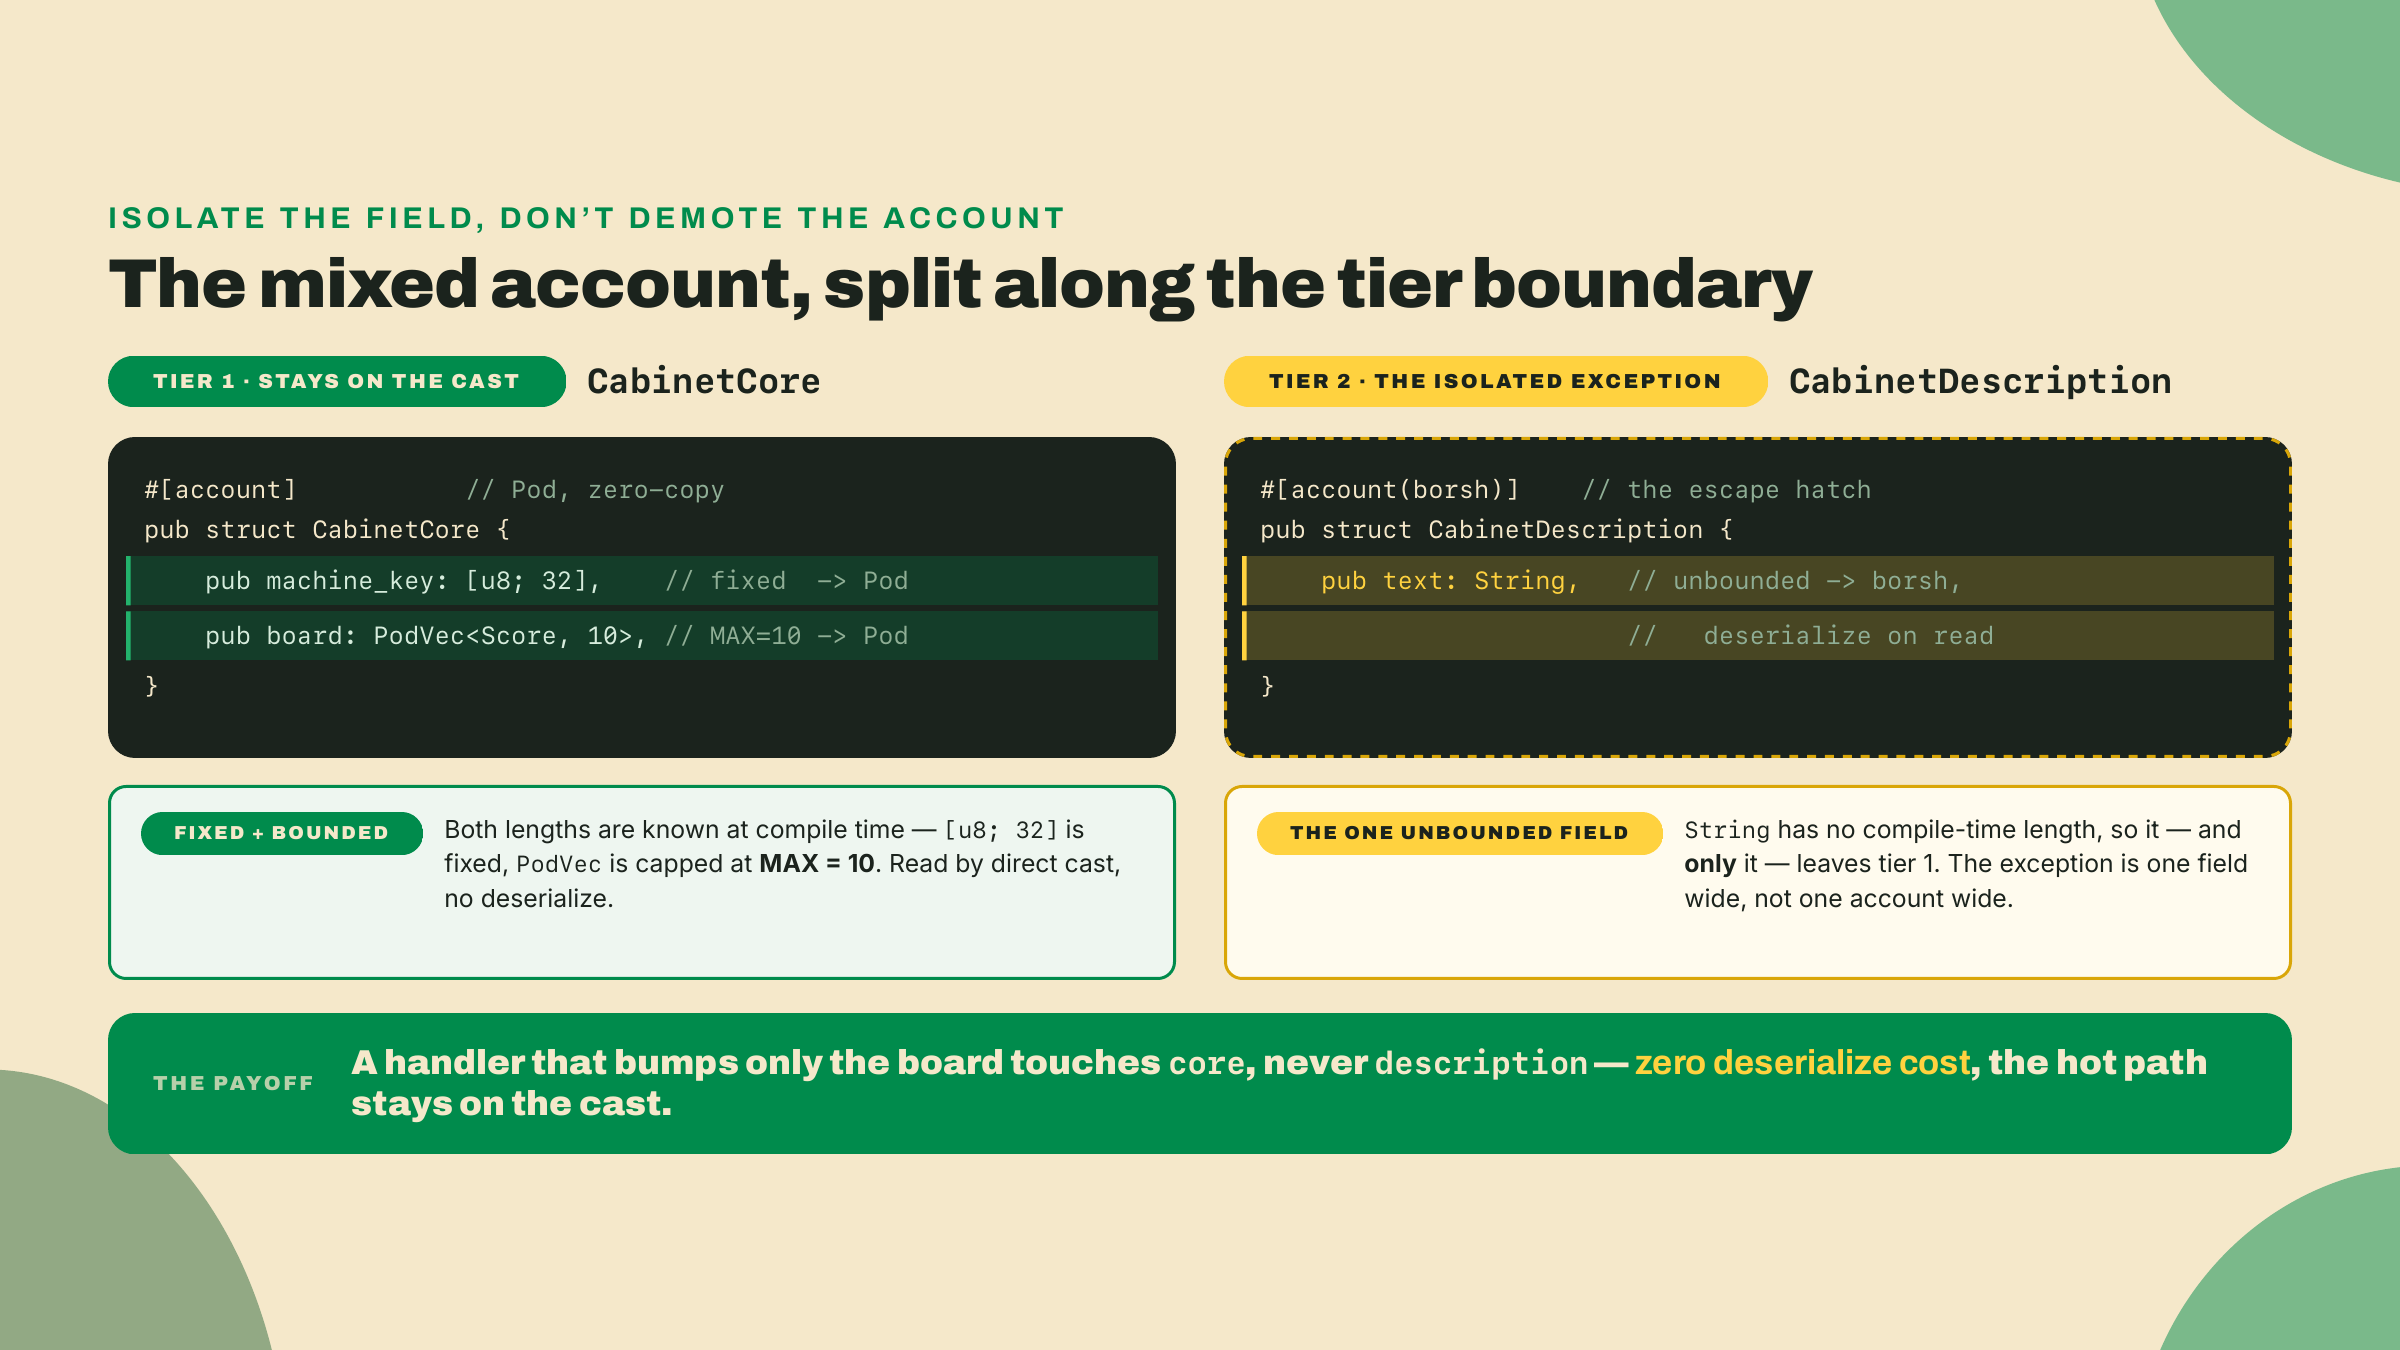
Passo 3, leia o custo que você acabou de escolher. Num handler que só atualiza o leaderboard, você toca core e nunca description, então você paga custo zero de desserialização: o caminho quente continuou no cast. Só um handler que edita o texto desserializa qualquer coisa. Esse é o retorno de dividir ao longo da fronteira entre os níveis em vez de virar all-borsh: você limitou o escopo do imposto ao único campo que o exigia. Existe um ângulo de rent também, e ele corta do mesmo jeito. Uma conta Pod se dimensiona exatamente para o seu layout fixo, mas uma conta borsh tem de ser alocada grande o bastante para a maior string que você vai armazenar algum dia, então você paga rent pelo pior caso. Dividir mantém o rent de pior caso isolado na conta de descrição, em vez de inflar a conta que guarda o seu leaderboard quente.
Passo 4, faça a checagem de sanidade contra os dois buracos de wire. Olhe para CabinetDescription. É uma única String, nenhum HashMap, nenhum HashSet, nenhum float. Então os dois buracos wincode-vs-borsh são irrelevantes aqui, e um cliente que decodifica borsh a lê sem problema. Essa checagem é o hábito: sempre que um campo vira borsh, pergunte "esta struct carrega um map, um set, ou um float que pode ser NaN?" Se não, a compatibilidade se mantém e você segue em frente. Se sim, você deve uma decisão à codificação.
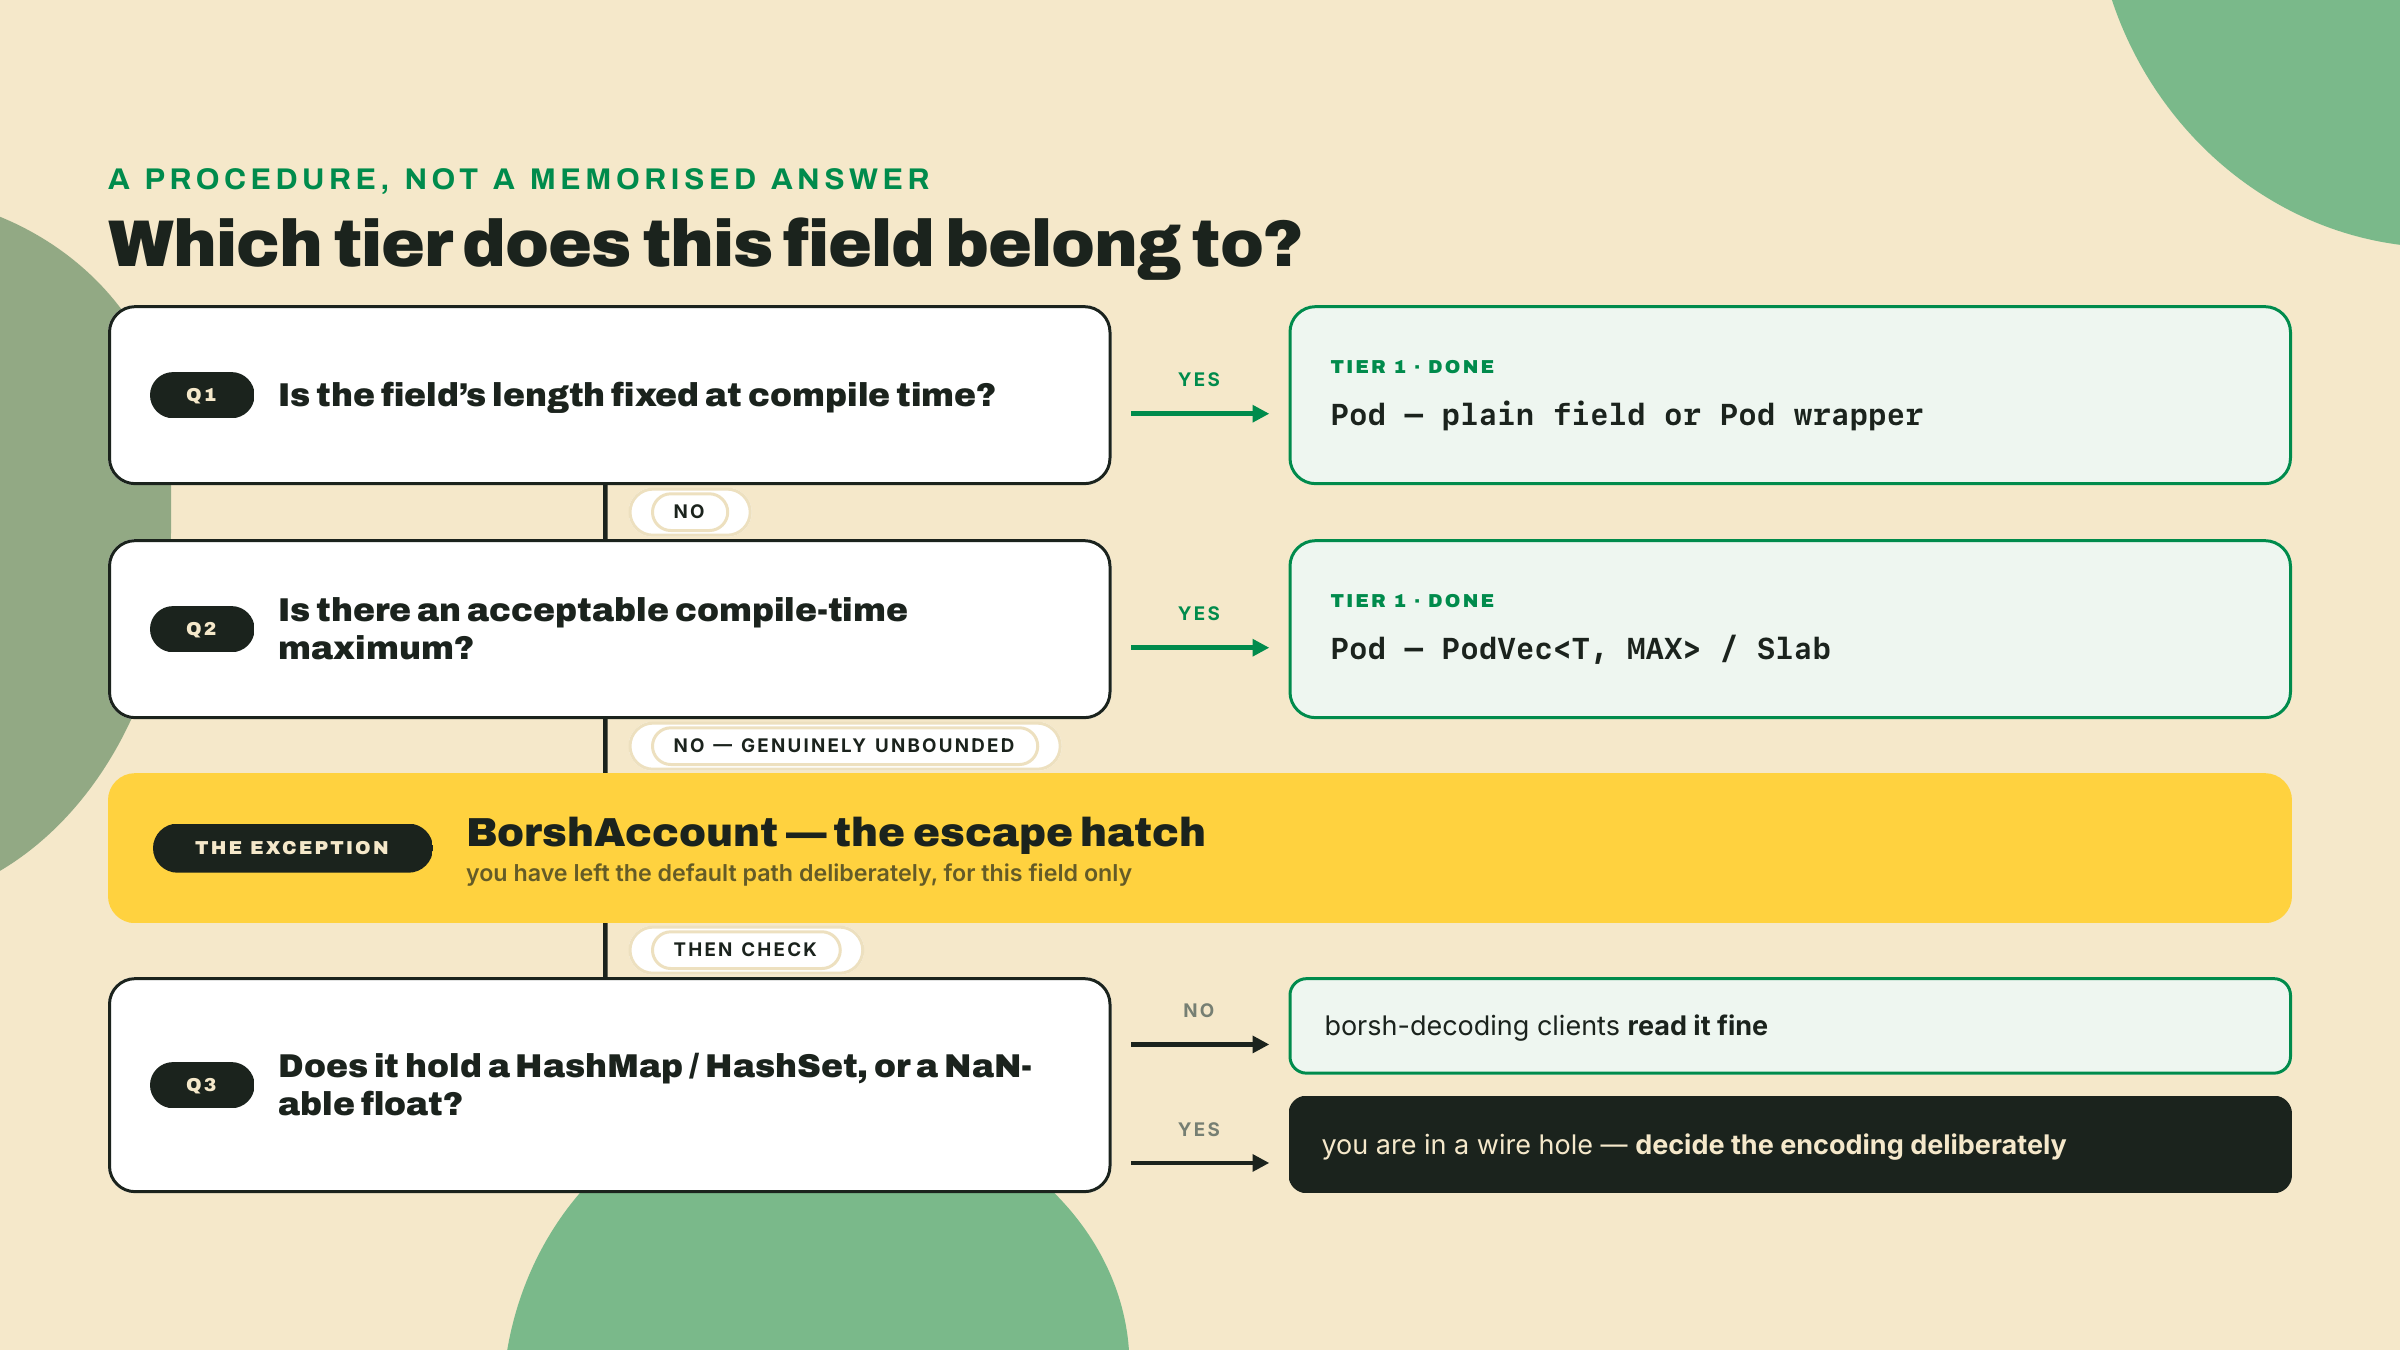
Checkpoint. Você deve agora conseguir apontar para qualquer campo de uma conta e dizer, num só fôlego, a qual nível ele pertence e por quê: fixo vai para Pod, limitado-com-máximo-conhecido vai para Pod, genuinamente ilimitado vai para BorshAccount, e uma conta mista isola a parte ilimitada em vez de rebaixar a coisa inteira. Se você consegue fazer isso para os três campos acima sem hesitar, o lab funcionou.
Aqui está o artefato avaliado, e ele é de propósito uma decisão escrita em vez de uma compilação, porque o que está sendo testado é julgamento, não sintaxe. A gente fez o perfil da máquina juntos. Esta é uma conta diferente, e ninguém a rotulou para você.
O fliperama precisa de um livro-razão do operador: uma conta por operador, tocada em cada payout, guardando
payout_bps, a fatia do operador em pontos-base,machines, os endereços das máquinas que este operador administra, sem teto escrito na spec,settings, um HashMap de chaves de configuração por máquina para valores,support_note, uma nota livre que o operador digita para a equipe do salão.Rotule cada campo como Pod ou BorshAccount, dê exatamente um motivo por escolha, e então diga qual dos campos borsh, se algum, precisa da checagem de buraco de wire e por quê. O formato da resposta é quatro rótulos, quatro motivos, uma frase de buraco de wire, nada mais. Para calibrar o formato sem te dar uma resposta, aqui está um campo que não está na lista: "a machine_key da máquina é Pod porque [u8; 32] tem um comprimento fixo em tempo de compilação." Uma oração de fato, uma oração de motivo. Se um motivo seu ficar mais longo que isso, você provavelmente está justificando o nível errado.
Dois desses quatro são o ponto. machines é o campo que o fluxograma faz você interrogar em vez de responder: rode a Q2 com honestidade, porque "sem teto escrito na spec" não é a mesma afirmação que "genuinamente ilimitado," e qual das duas ele acaba sendo decide o nível. E este livro-razão é tocado em cada payout, o que significa que ele é uma conta quente, então para quaisquer campos que caiam no nível 2 você deve também dizer se eles pertencem a esta conta afinal ou a uma separada, do jeito que o lab separou a descrição.
Escreva o artefato; o prompt vive em operator-ledger/prompt.md e a minha rotulagem de referência trabalhada em operator-ledger/reference.md. Leia a referência só depois que os seus próprios quatro rótulos estiverem no papel, e onde você discordar dela, a pergunta interessante não é quem está certo, mas qual das Q1 e Q2 do fluxograma vocês dois responderam de forma diferente. Essa discordância é a habilidade inteira.
A lição aqui nunca foi "borsh é ruim." Você aprendeu onde os dois níveis se encontram, e agora você consegue ficar nessa costura e colocar qualquer campo do lado correto dela: estado fixo e limitado lido por cast direto dos bytes pelo ganho de CU, estado genuinamente ilimitado isolado atrás de BorshAccount<T>, e os dois buracos de wire wincode-vs-borsh checados sempre que a válvula de escape entra em cena. Esse é o modelo completo de estado on-chain que este curso precisava que você dominasse antes de poder dar um endereço a esse estado.
Porque isso é o próximo. Você já consegue modelar qualquer estado, fixo, limitado ou ilimitado, e escolher o nível certo para cada campo. O que você ainda não consegue fazer é encontrar esse estado de forma determinística, ou dizer quem é o dono dele. O próximo módulo dá às suas contas um endereço e um dono: endereços derivados de programa, bumps canônicos pré-computados em tempo de expansão de macro, e o catálogo completo de constraints do V2. Ele abre no quarter-vault, a conta de crédito pré-pago cujo endereço ninguém distribui porque o programa a re-deriva, sozinho, a partir da chave do jogador, toda vez.
Pergunta 1 de 4