Carregando...

 BetaBeta
Hoje termina com um check verde em uma execução que você não iniciou. Confira a linha de partida primeiro: abra o terminal da lição passada e rode:
git --version
Se imprimir uma versão, metade da toolchain de hoje já está na sua máquina. Se der erro, a primeira seção instala em um comando. De qualquer forma, mantenha o terminal aberto; tudo daqui para frente acontece nele e, no fim, uma máquina que não é sua vai estar sondando a internet a cada meia hora em seu nome.
Na lição passada você construiu o pulse v0: uma sonda TypeScript em strict mode que imprime uma latência real para uma URL real, mas só enquanto você fica ali rodando. Esse é o defeito fatal que corrigimos hoje. Um batimento que para quando você fecha o laptop é um check de pulso, não um monitor. Então esta lição faz o primeiro ship do curso: seu repo vai a público no GitHub, um arquivo YAML entra nele, e o GitHub roda a sua sonda a cada 30 minutos, noites, fins de semana, época de prova, fazendo commit de cada resultado de volta como status.json. No caminho você ganha git e GitHub flow em nível de dev profissional, a anatomia de um workflow e a física honesta da plataforma: por que CI em repo público é genuinamente grátis, por que o agendamento deriva, o que mata um cron ocioso em silêncio e por que o próprio commit do workflow não se dispara em um loop infinito.
Como o trabalho se divide: este ainda é o tier totalmente resolvido. Todo comando e o arquivo de workflow completo aparecem anotados na página; seus TODOs são exatamente três linhas dentro desse arquivo (a expressão cron, o bloco permissions, a trava de nenhuma mudança), e o challenge no fim, uma trava de checagem de tipos que você constrói sozinho, é seu primeiro pequeno passo solo. As rodinhas começam a sair no próximo módulo.
Uma nota de honestidade: o primeiro ship é a execução agendada, não uma URL. O endereço web público da estação chega no módulo 3, renderizando exatamente o status.json que esta lição começa a produzir. A vitória de hoje é mais silenciosa e, eu diria, maior: um check verde em uma execução que você não iniciou.
Sem teoria ainda. Check verde primeiro, entendimento depois. Você precisa do git e do gh, a CLI do GitHub. No macOS:
# git ships with the Xcode command line tools
xcode-select --install

# gh via Homebrew
brew install gh
No Ubuntu/Debian: sudo apt install git gh. No Windows: winget install Git.Git GitHub.cli. Depois diga ao git quem você é (essa identidade vai em todo commit que você fizer):
git config --global user.name "Your Name"
git config --global user.email "you@example.com"
Agora, no seu diretório pulse-station da lição passada, três movimentos: ignore o lixo, tire um snapshot de todo o resto e coloque no GitHub. O .gitignore vem ANTES do primeiro commit. Fazer commit de node_modules é o erro clássico de primeira semana, e desfazer isso depois é muito mais chato do que evitar agora:
cd pulse-station
git init -b main

printf "node_modules/\n.env\n" > .gitignore

git add .
git commit -m "pulse v0: strict-mode latency probe"
git init -b main começa o repo com main como a branch padrão. Guarde essa expressão, branch padrão. Ela volta com dentes na seção do cron. Depois autentique o gh e crie o repo, público de propósito:
gh auth login
gh repo create pulse-station --public --source=. --push
Esse nome de repo é estrutural, então digite exatamente: raw.githubusercontent.com/<user>/pulse-station/main/status.json é a URL que o painel de m03-l2 busca e que o script de demo de m10-l1 verifica. Renomeie depois e você ganha o direito de atualizar os dois.
A flag --public é economia, não idealismo. A própria documentação de cobrança do GitHub diz sem rodeios: "O uso do GitHub Actions é gratuito para repositórios públicos que usam runners padrão hospedados pelo GitHub." Sem medição. Sem cota, sem contador de minutos, sem cartão. Essa é a razão pela qual a lição m01-l1 (este curso se refere às lições em formato módulo-primeiro: m01-l1 é módulo um, lição um, a primeira lição que você leu; de agora em diante as referências cruzadas usam essa abreviação) fez de "seu repo é público" um pré-requisito declarado: estamos a ponto de rodar uma sonda 48 vezes por dia, para sempre, e em um repo público isso custa exatamente nada. Vamos fazer a conta completa da alternativa privada em um minuto.
Agora o primeiro workflow. Crie o arquivo que o GitHub Actions procura. O caminho é uma convenção hardcoded na plataforma:
mkdir -p .github/workflows
Coloque isto em .github/workflows/pulse.yml:
name: pulse

on: push

jobs:
  probe:
    runs-on: ubuntu-latest
    steps:
      - run: echo "a machine that is not yours ran this"
Faça commit e push:
git add .github
git commit -m "ci: first trivial workflow"
git push
Abra seu repo no github.com e clique na aba Actions. Em segundos você deve ver uma execução girando e, pouco depois, um check verde ao lado da mensagem do seu commit. Clique nela e leia o log: uma máquina Ubuntu nova bootou em algum datacenter, executou seu echo e desligou. Essa é a lição inteira, comprimida em uma execução. Tudo daqui para frente é fazer essa máquina fazer algo que valha a pena, em um agendamento, sem você.
Checkpoint: a aba Actions mostra uma execução concluída chamada pulse com um check verde. Se não mostrar nada, o arquivo provavelmente não está exatamente em .github/workflows/pulse.yml; o caminho é estrutural.
Seis linhas de YAML acabaram de requisitar um computador, então cada uma merece seu nome. Um workflow é o arquivo inteiro: uma receita disparada por eventos. Um job é uma unidade nomeada dentro dele (probe) que ganha sua própria máquina virtual nova. Um step é um comando ou uma action reutilizável dentro de um job, executados em ordem. Um runner é a máquina que executa o job; runs-on: ubuntu-latest pede um runner padrão hospedado pelo GitHub, do tipo gratuito. Essa palavra padrão está fazendo um trabalho silencioso: o GitHub também aluga runners maiores, com mais núcleos e RAM, e esses são, textualmente da documentação de cobrança, "sempre cobrados, mesmo quando usados por repositórios públicos." A alegação de CI grátis que você acabou de descontar vale só nas máquinas padrão, que para uma sonda que busca três URLs já é mais computador do que vamos precisar.
on: push é o trigger: quais eventos iniciam o workflow. Agora, todo push. Em breve, também um relógio.
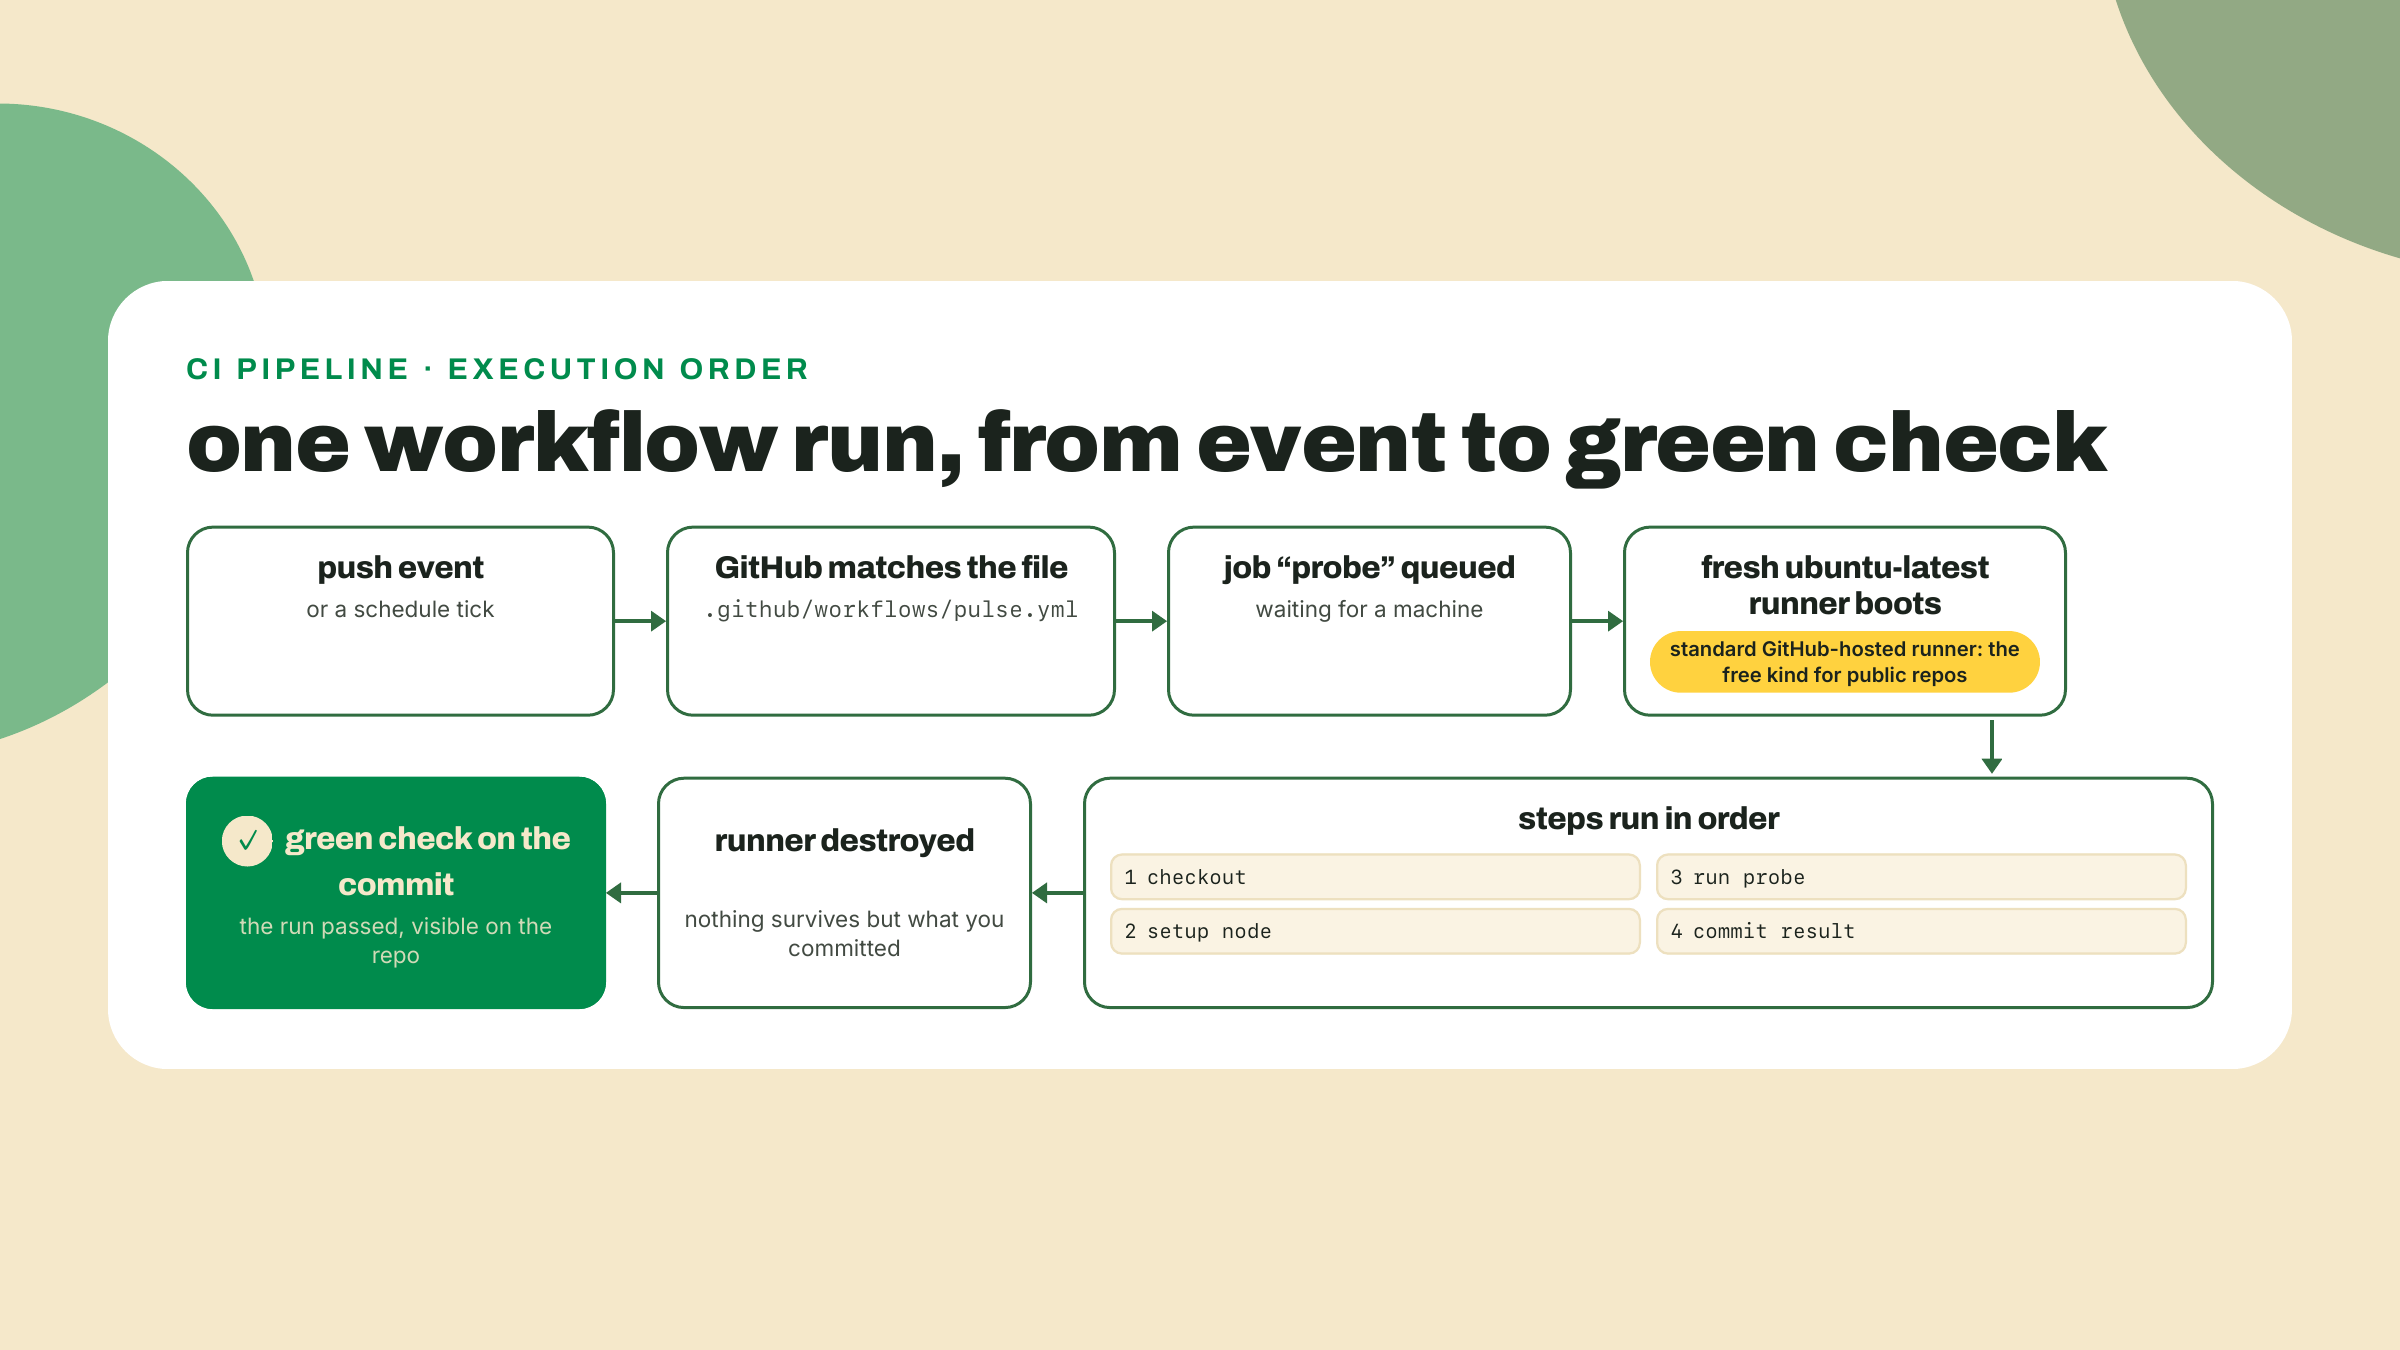
Mais uma peça de anatomia antes que ela prove seu valor no lab: a maioria dos workflows reais começa com - uses: actions/checkout@v7. Um runner novo inicia sem nada nele, nem mesmo o seu código. A action checkout clona seu repo na máquina. uses: puxa uma action reutilizável do marketplace em vez de rodar um comando de shell; @v7 fixa sua versão major. Os pins de versão nesta lição (checkout v7, setup-node v7) eram os majors atuais em 2026-09-02; as actions se movem mais devagar que o npm, mas confira a página do marketplace quando você ler isto.
Seu amigo em um repo privado de time fica olhando um medidor de minutos do Actions. Você nunca vai, e a distinção vale a precisão, porque "CI é grátis" e "CI é grátis para você" são afirmações diferentes.
O sistema de minutos incluídos mede repositórios PRIVADOS: o plano Free inclui 2,000 minutos por mês e, passando disso, builds privados param ou cobram. Repositórios públicos em runners padrão simplesmente não são medidos. Não existe uma cota sendo generosamente não consumida; o contador não existe para você. Duas pegadinhas, as duas já nomeadas: a palavra padrão (runners maiores sempre cobram, público ou não) e o fato de que esta é a postura atual do fornecedor, citada da documentação de cobrança deles, não uma lei da física.
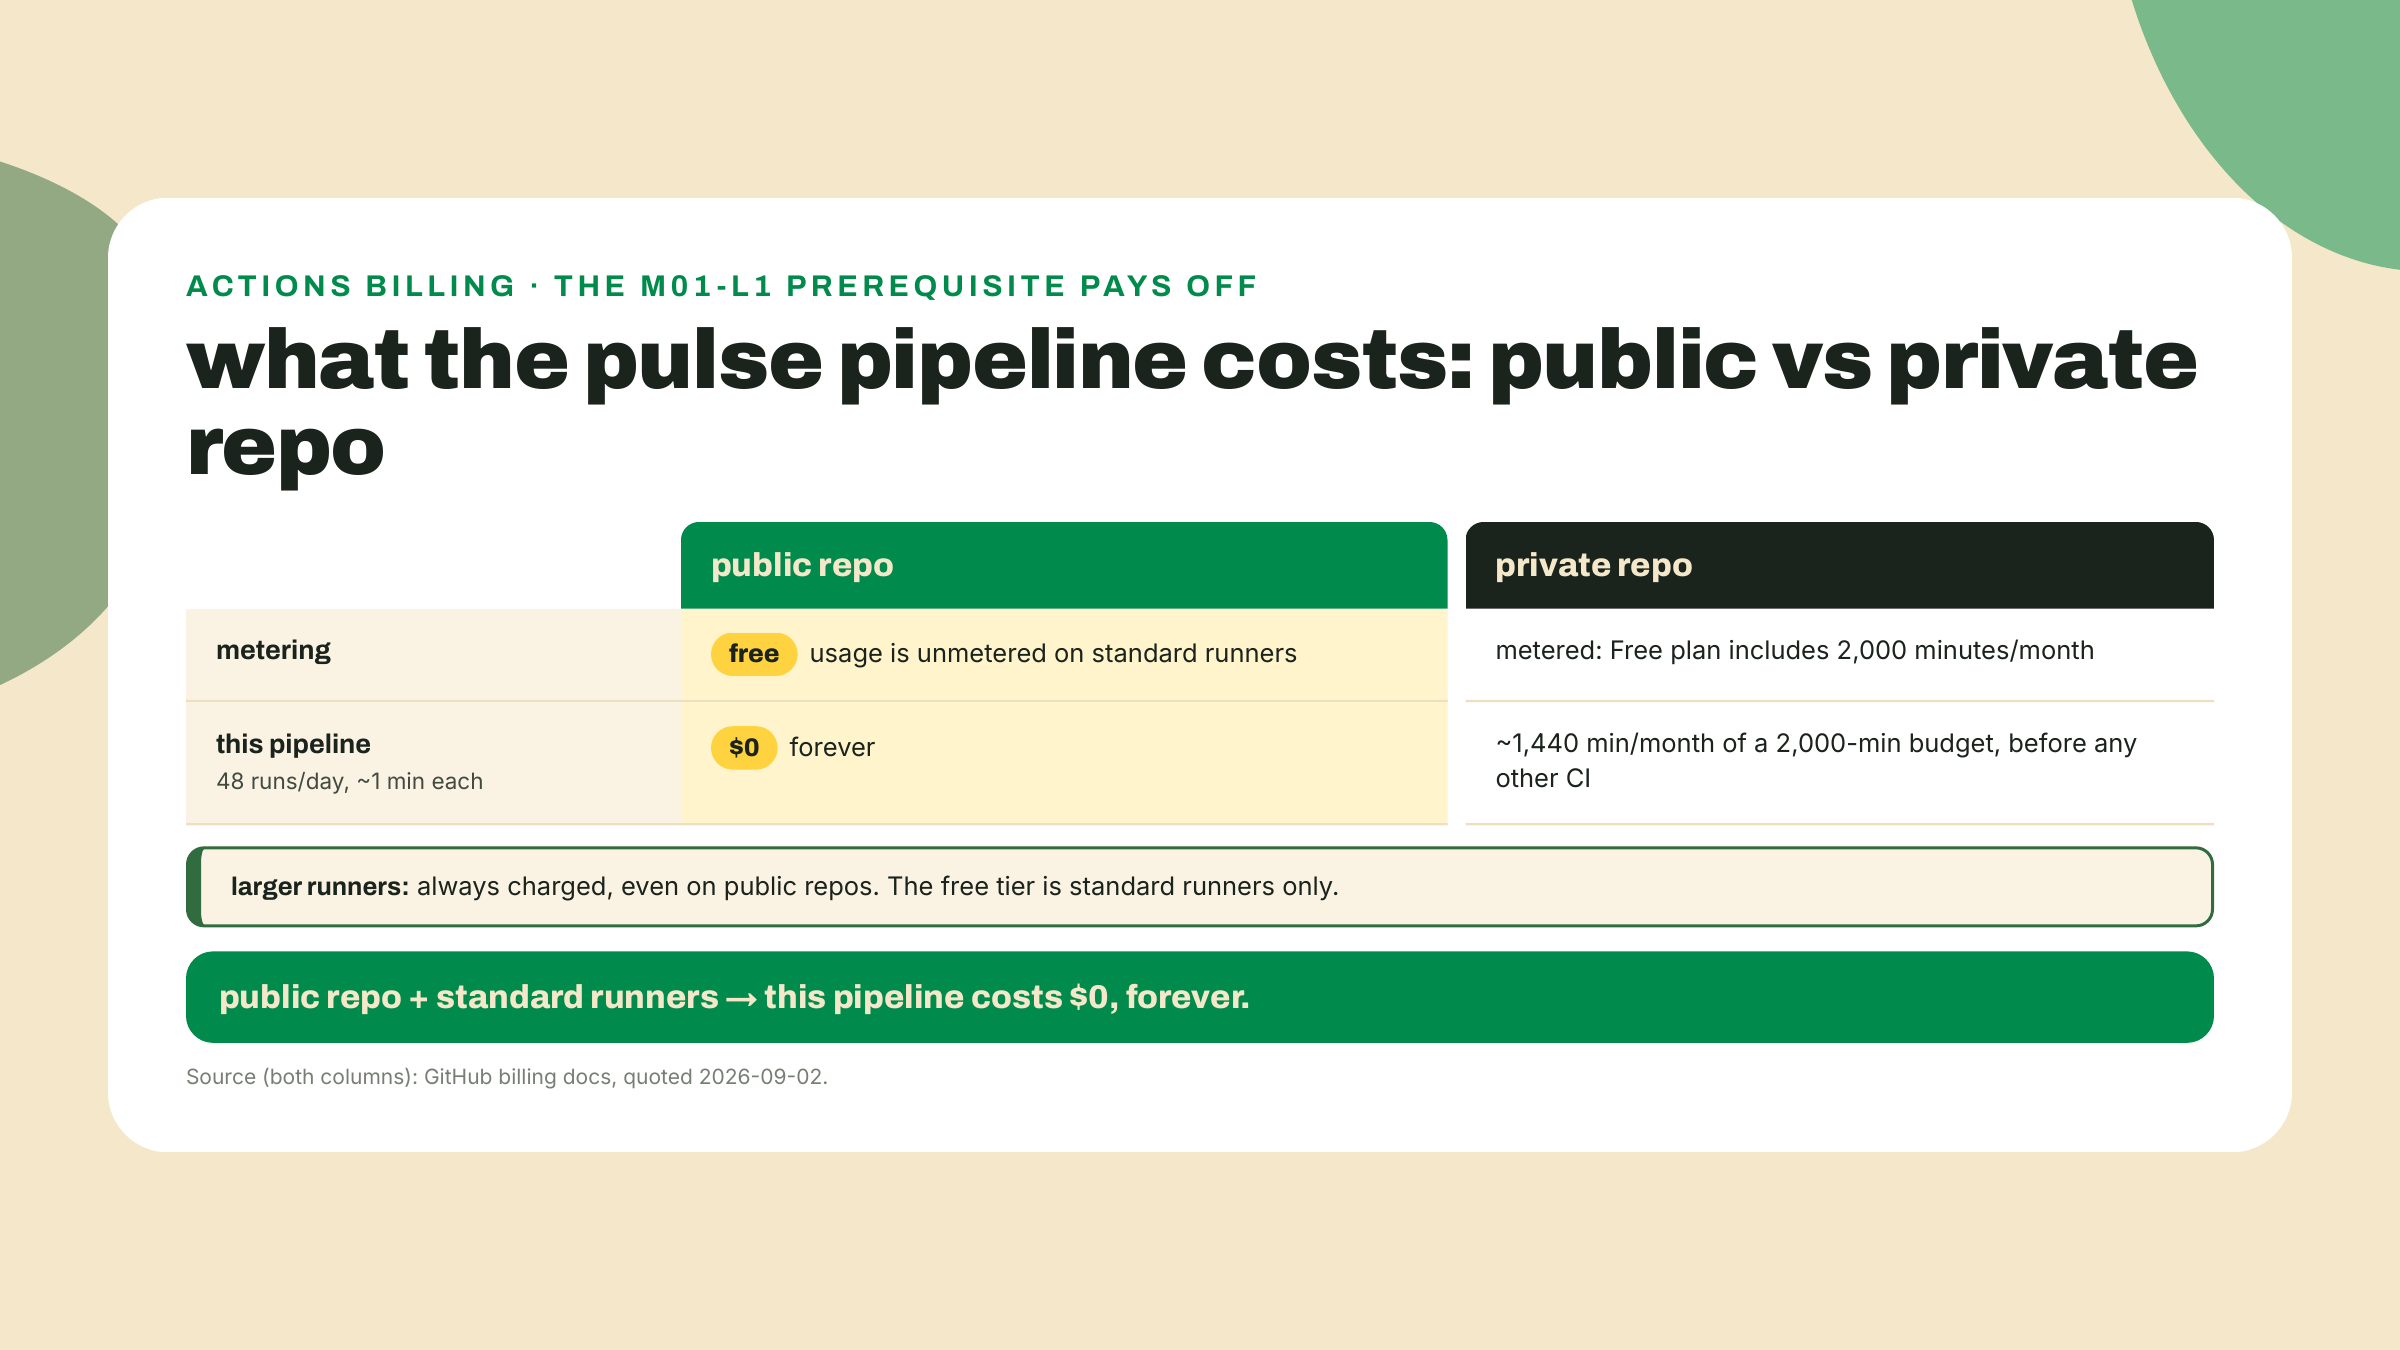
Faça a conta do repo privado uma vez e você nunca vai esquecer por que o repo é público: 48 execuções agendadas por dia a um minuto cada já são mais ou menos 1,440 minutos por mês, quase três quartos do orçamento de repo privado do plano Free, gastos em um batimento. No repo público: zero, e o medidor que contaria isso não existe.
Aqui está a linha que transforma sua sonda em um monitor. No bloco de trigger do workflow:
on:
  push:
    branches: [main]
  schedule:
    - cron: "*/30 * * * *"
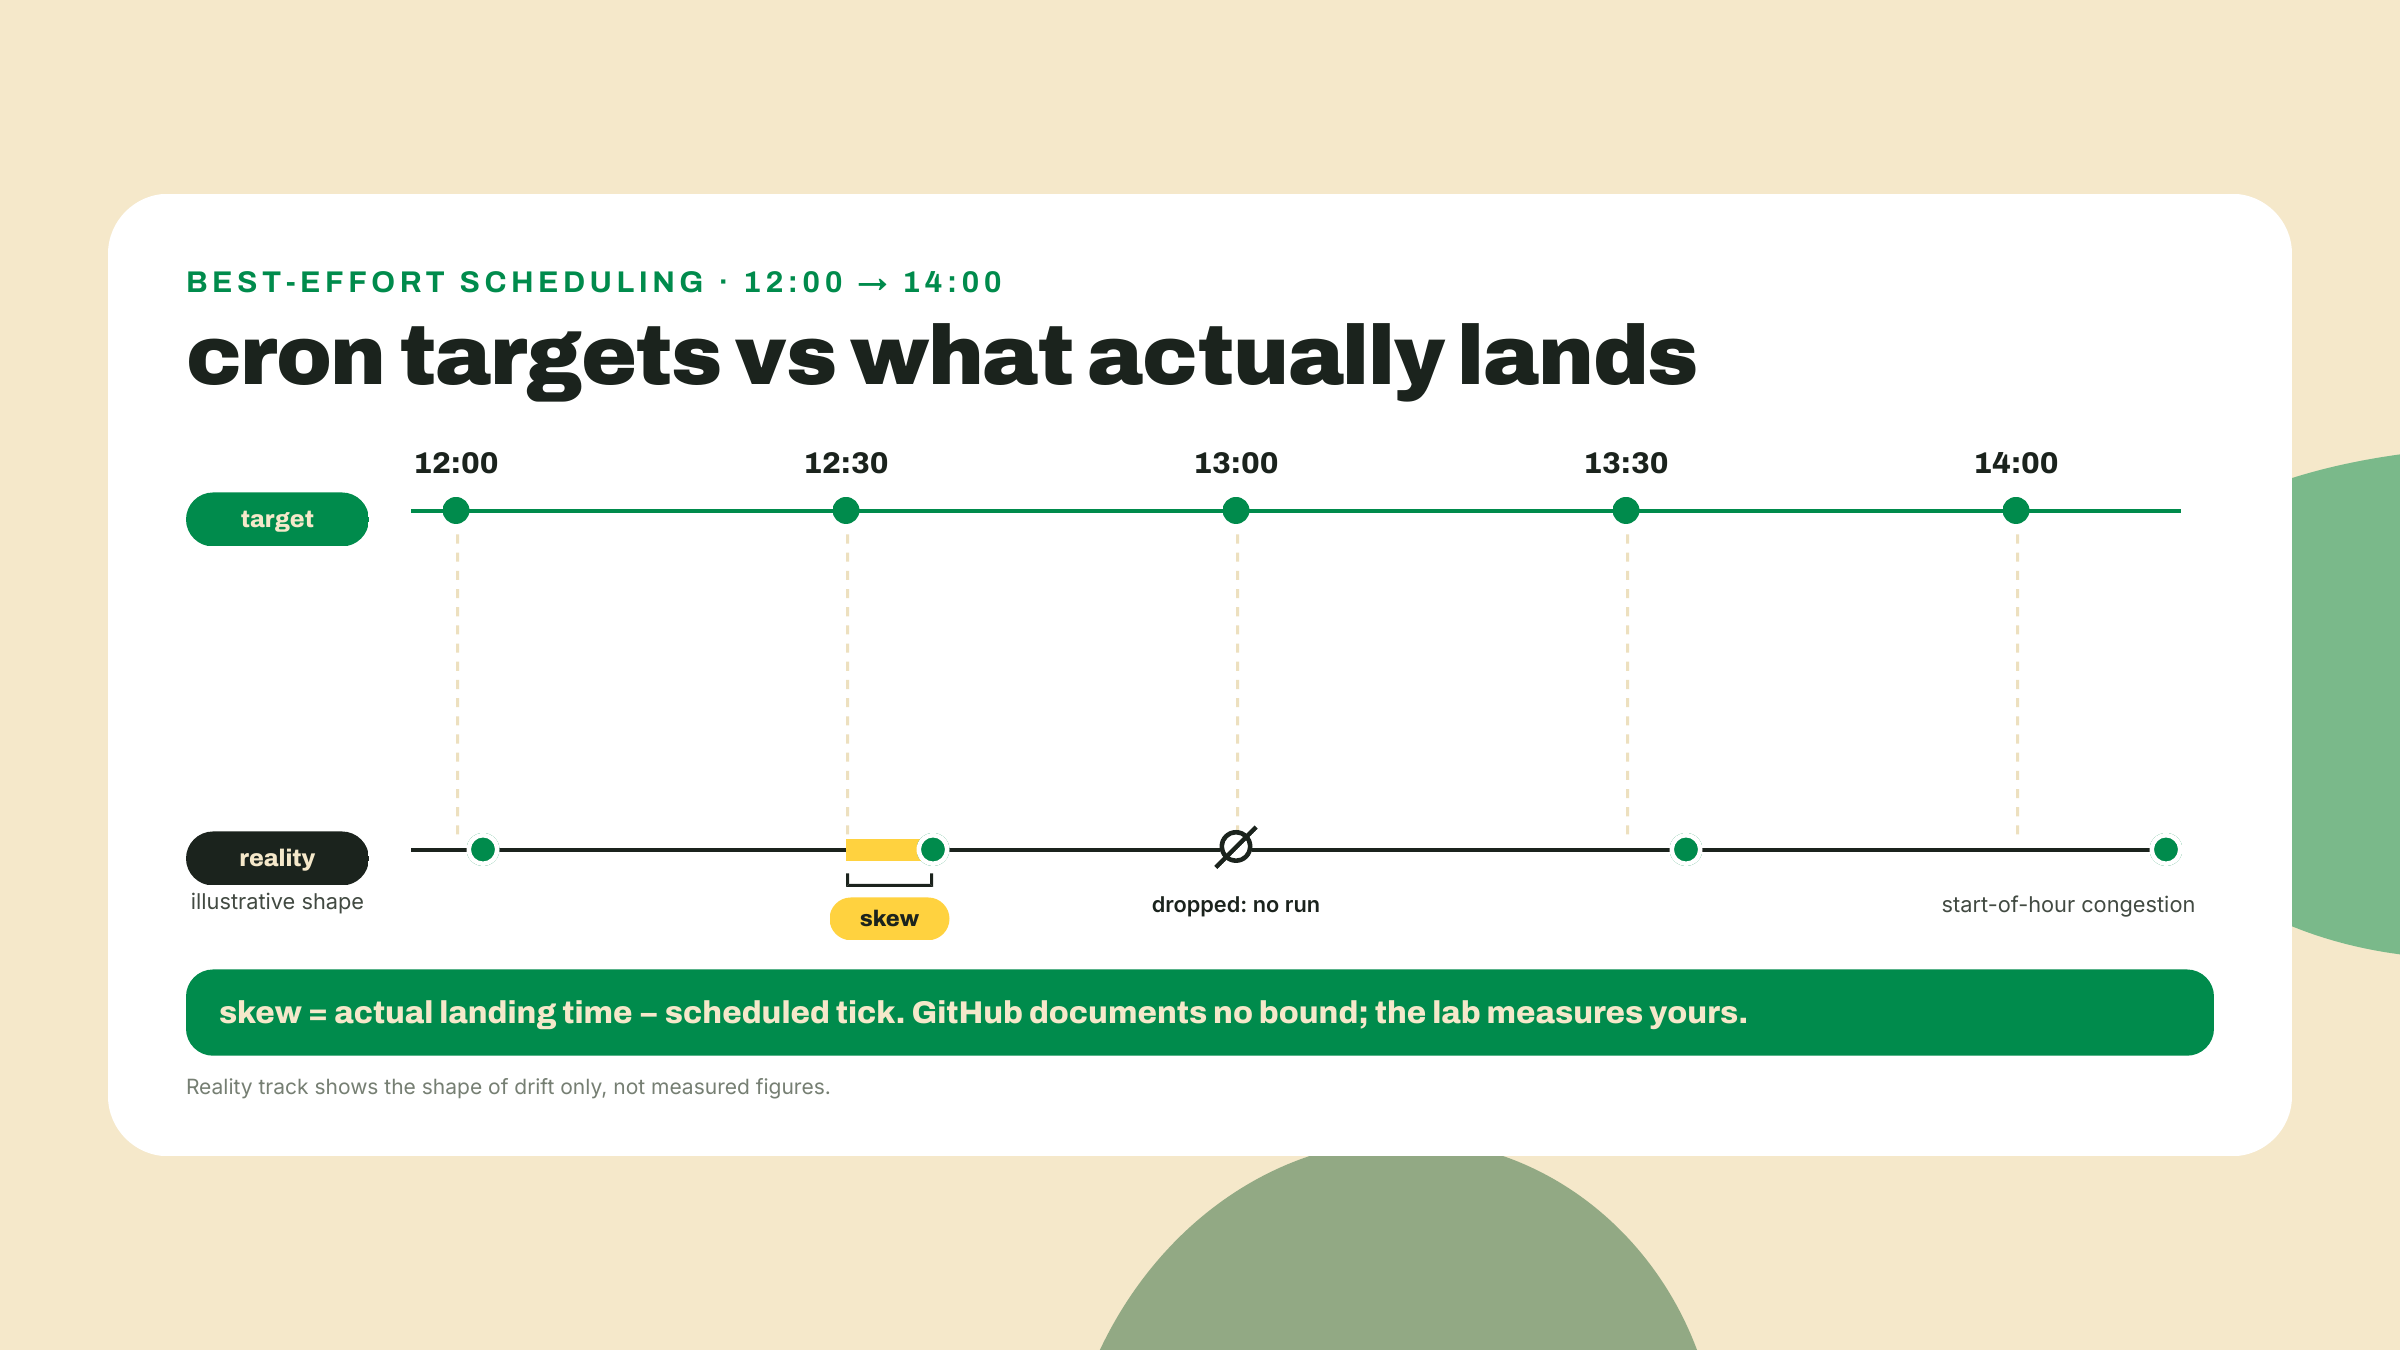
Uma expressão cron são cinco campos: minuto, hora, dia do mês, mês, dia da semana. */30 * * * * se lê "a cada 30º minuto, a cada hora, todos os dias": :00 e :30, o tempo todo. O piso da plataforma está documentado: "O menor intervalo em que você pode rodar workflows agendados é uma vez a cada 5 minutos," então nosso 30 é confortavelmente legal. O horário é UTC por padrão; um fuso horário é opt-in via uma string IANA se você algum dia precisar, e para um monitor você não precisa. UTC é o único fuso em que uma frota deveria pensar.
Duas realidades sobre esse agendamento, as duas da própria documentação do GitHub, as duas coisas que tutoriais adoram omitir.
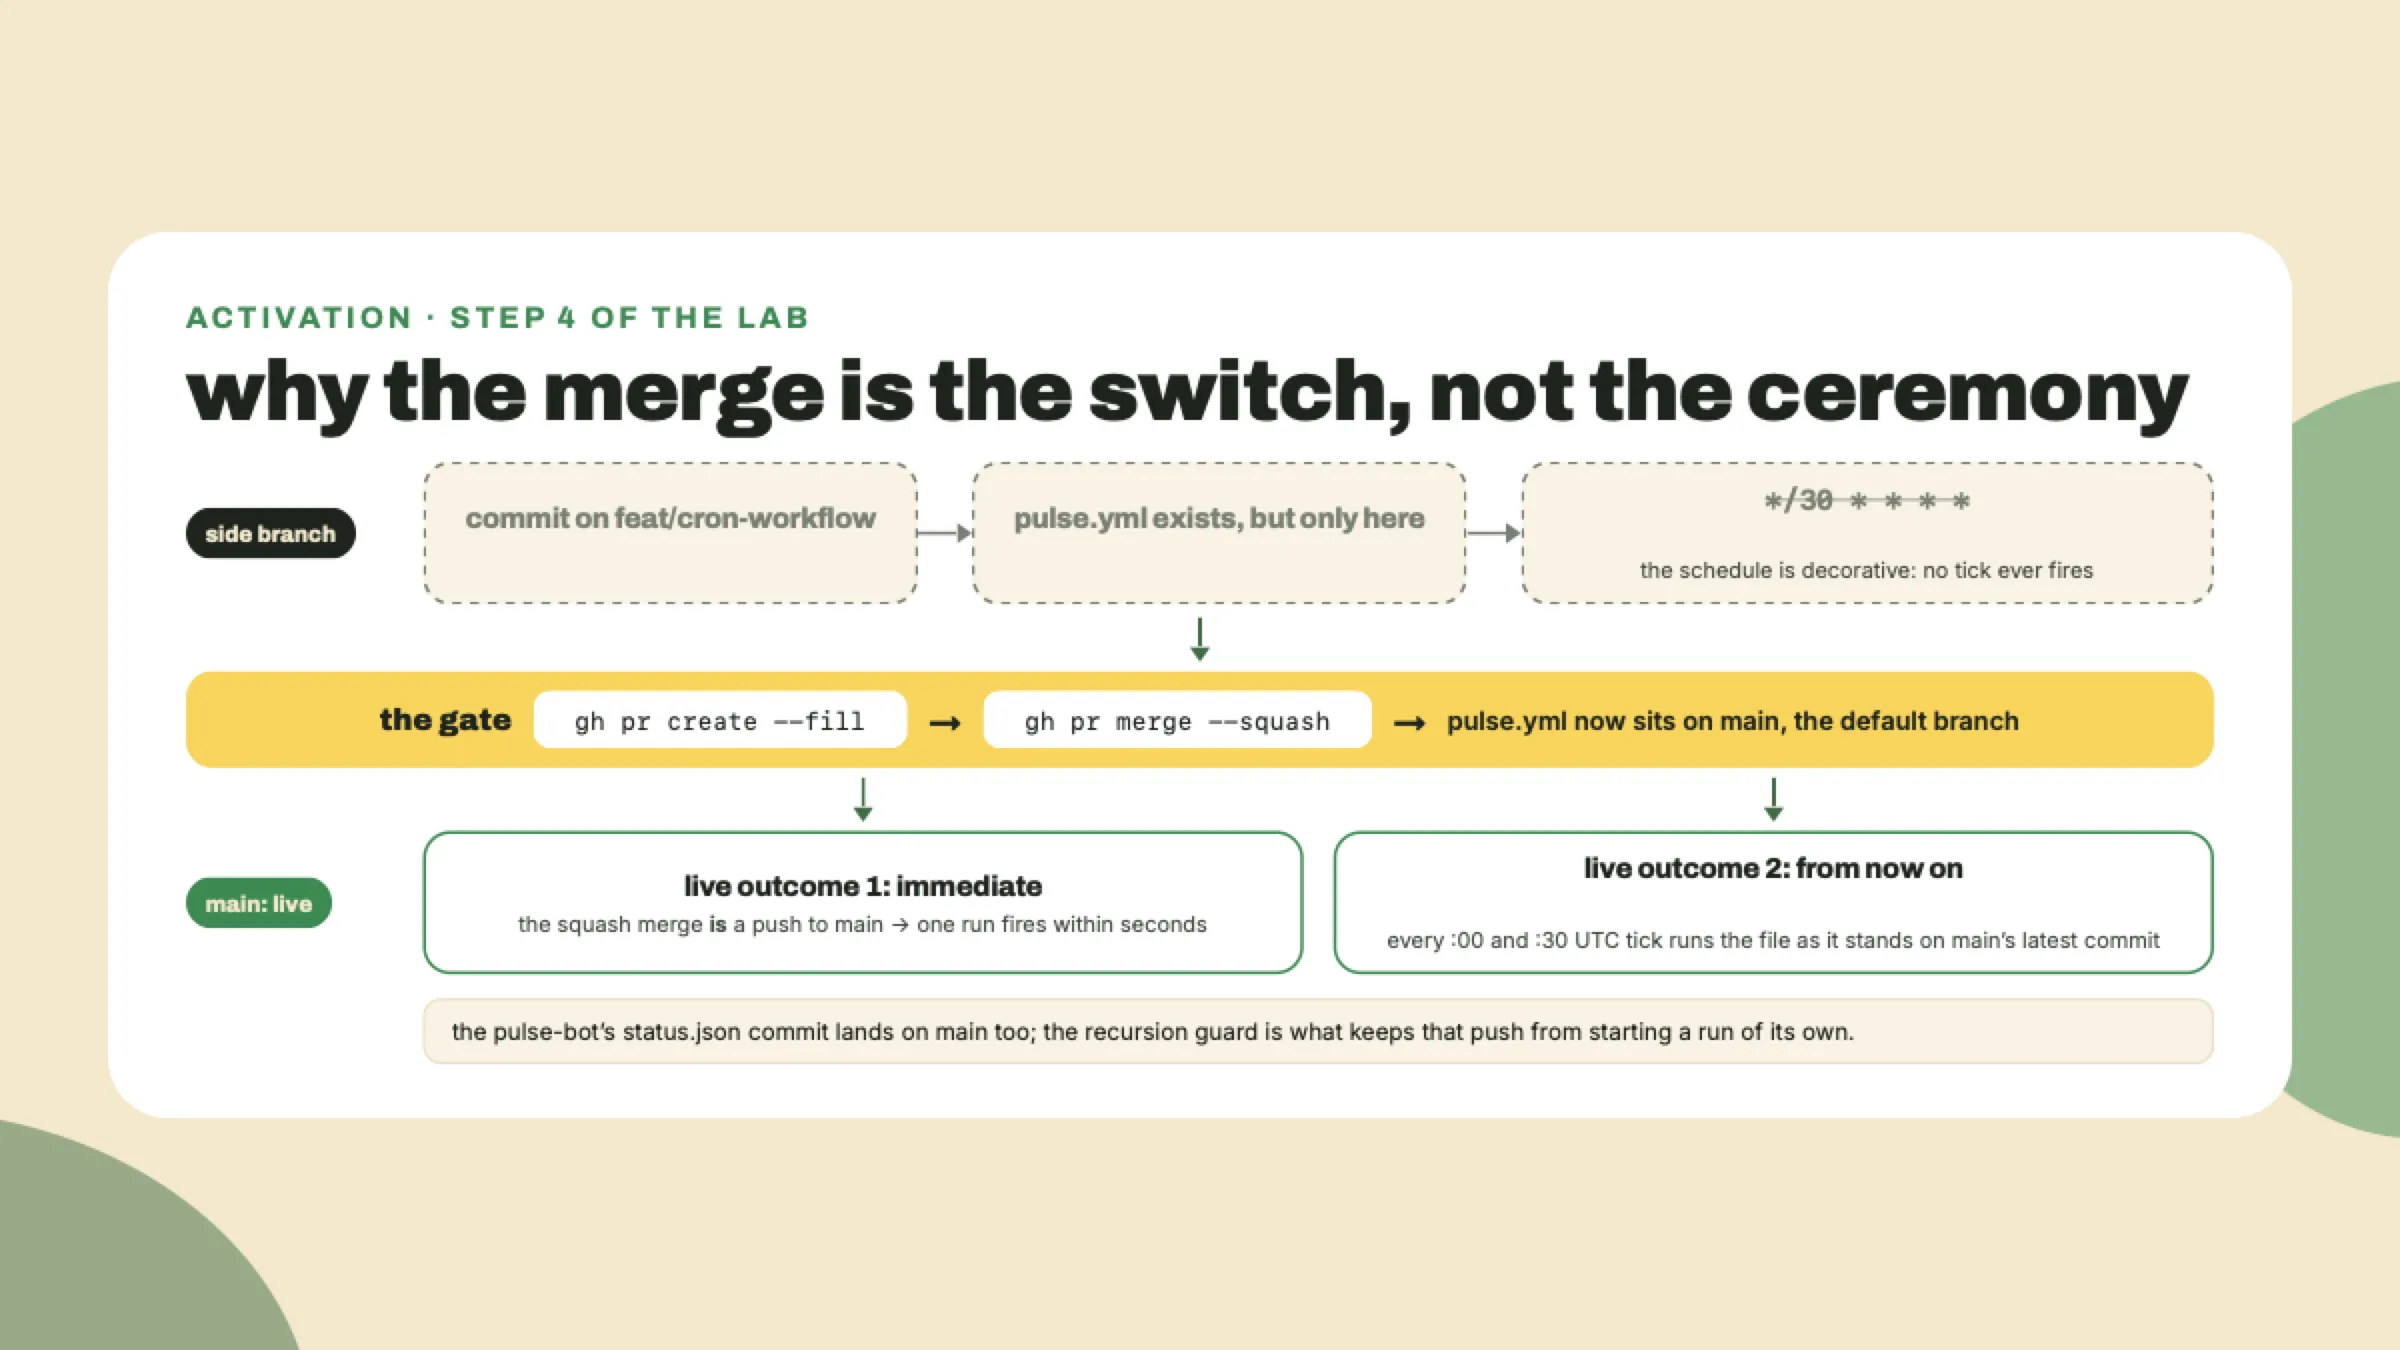
Primeiro, a pegadinha: "Workflows agendados rodam no último commit da branch padrão." O cron da sua feature branch não existe no que diz respeito ao agendador. Você pode dar push em uma branch com um agendamento belíssimo e esperar para sempre. E note que nosso trigger de push está filtrado para branches: [main], então dar push na branch em si também não inicia nada; uma aba Actions vazia em uma feature branch é o filtro funcionando, não um bug. O fluxo é: construa em uma branch, faça merge para main, e deixe o próprio push do merge para main disparar o workflow para feedback instantâneo; só então o relógio também começa. É por isso que o lab faz o merge antes de observar.
Segundo, a física: o agendamento é best-effort. Textualmente, de duas páginas de documentação diferentes: "Eventos agendados podem ser atrasados durante períodos de alta carga de execuções de workflow do GitHub Actions. Os horários de alta carga incluem o começo de cada hora. Se a carga for suficientemente alta, alguns jobs na fila podem ser descartados." Leia isso duas vezes. Não só atrasados. Descartados. Sua execução de :30 pode cair às :34, e de vez em quando pode não cair nunca.
Quão atrasado, na média? Ninguém pode te dizer, e digo isso literalmente: o GitHub documenta a existência do atraso e sua causa, e nenhum limite em lugar algum. Threads da comunidade relatam de tudo, de minutos a horas, e discordam entre si por ordens de magnitude, que é exatamente o tipo de número que você deveria se recusar a repetir. Então não vamos. Vamos medir. A marca registrada deste curso, e aqui está sua primeira aparição, é alvos versus realidade: Solana, a blockchain que este curso tem como destino, mira slots de 300ms (um slot é o batimento da chain, o intervalo em que ela produz blocos), e uma sonda de 20 amostras em 2026-09-01 mediu 316ms. Mesma física aqui. Seu cron tem um alvo (:00:30) e uma realidade (quando a fila permitir), e o lab te põe a fazer o diff dos dois e reportar o SEU desvio, do mesmo jeito que a lição m08-l1 vai te fazer aferir o tempo de slot da chain em vez de citar seu alvo. Um batimento de 30 minutos dá de ombros para uma deriva de quatro minutos e sobrevive a uma execução descartada. Um bot de trading não sobreviveria. Escolher cargas de trabalho que tolerem a folga da plataforma é uma decisão de projeto, e você está tomando ela agora mesmo, de propósito.
O workflow que você vai terminar no lab acaba fazendo commit de status.json de volta no repo. Duas perguntas deveriam te incomodar sobre isso, e as duas têm respostas de uma palavra escondidas na plataforma.
Pergunta um: o workflow consegue sequer dar push? Não por padrão. Toda execução recebe uma credencial embutida chamada GITHUB_TOKEN, criada automaticamente, com escopo no seu repo, expirando com a execução. A política padrão recente concede a ela permissão de conteúdo somente leitura, então um push com ela falha com um 403 a menos que você peça mais. Você pede no arquivo de workflow, e o pedido é visível, revisável e versionado:
permissions:
  contents: write
Esse bloco é o workflow declarando, na cara aberta, "Eu pretendo escrever neste repositório." Qualquer pessoa auditando seu repo pode ver exatamente o que a automação pode tocar. Esquecer disso é a forma mais comum de este lab falhar; o sintoma é um 403 no step do push.
Pergunta dois, a divertida: nosso workflow dispara em push, e o próprio workflow dá push. Por que isso não é um loop infinito, 48 execuções recursivas de profundidade até o almoço? Porque o GitHub pensou nisso, textualmente: "Eventos disparados pelo GITHUB_TOKEN não vão criar uma nova execução de workflow," com exatamente duas exceções, workflow_dispatch e repository_dispatch, nenhuma das quais usamos. A documentação dá a razão no mesmo suspiro: isso "evita que você crie acidentalmente execuções recursivas de workflow." O commit de status é dado, não sinal. Ele cai no repo, não acorda o pipeline. Para a nossa estação, essa trava é um presente discreto: o único comportamento que teríamos tido que construir nós mesmos já vem como padrão.
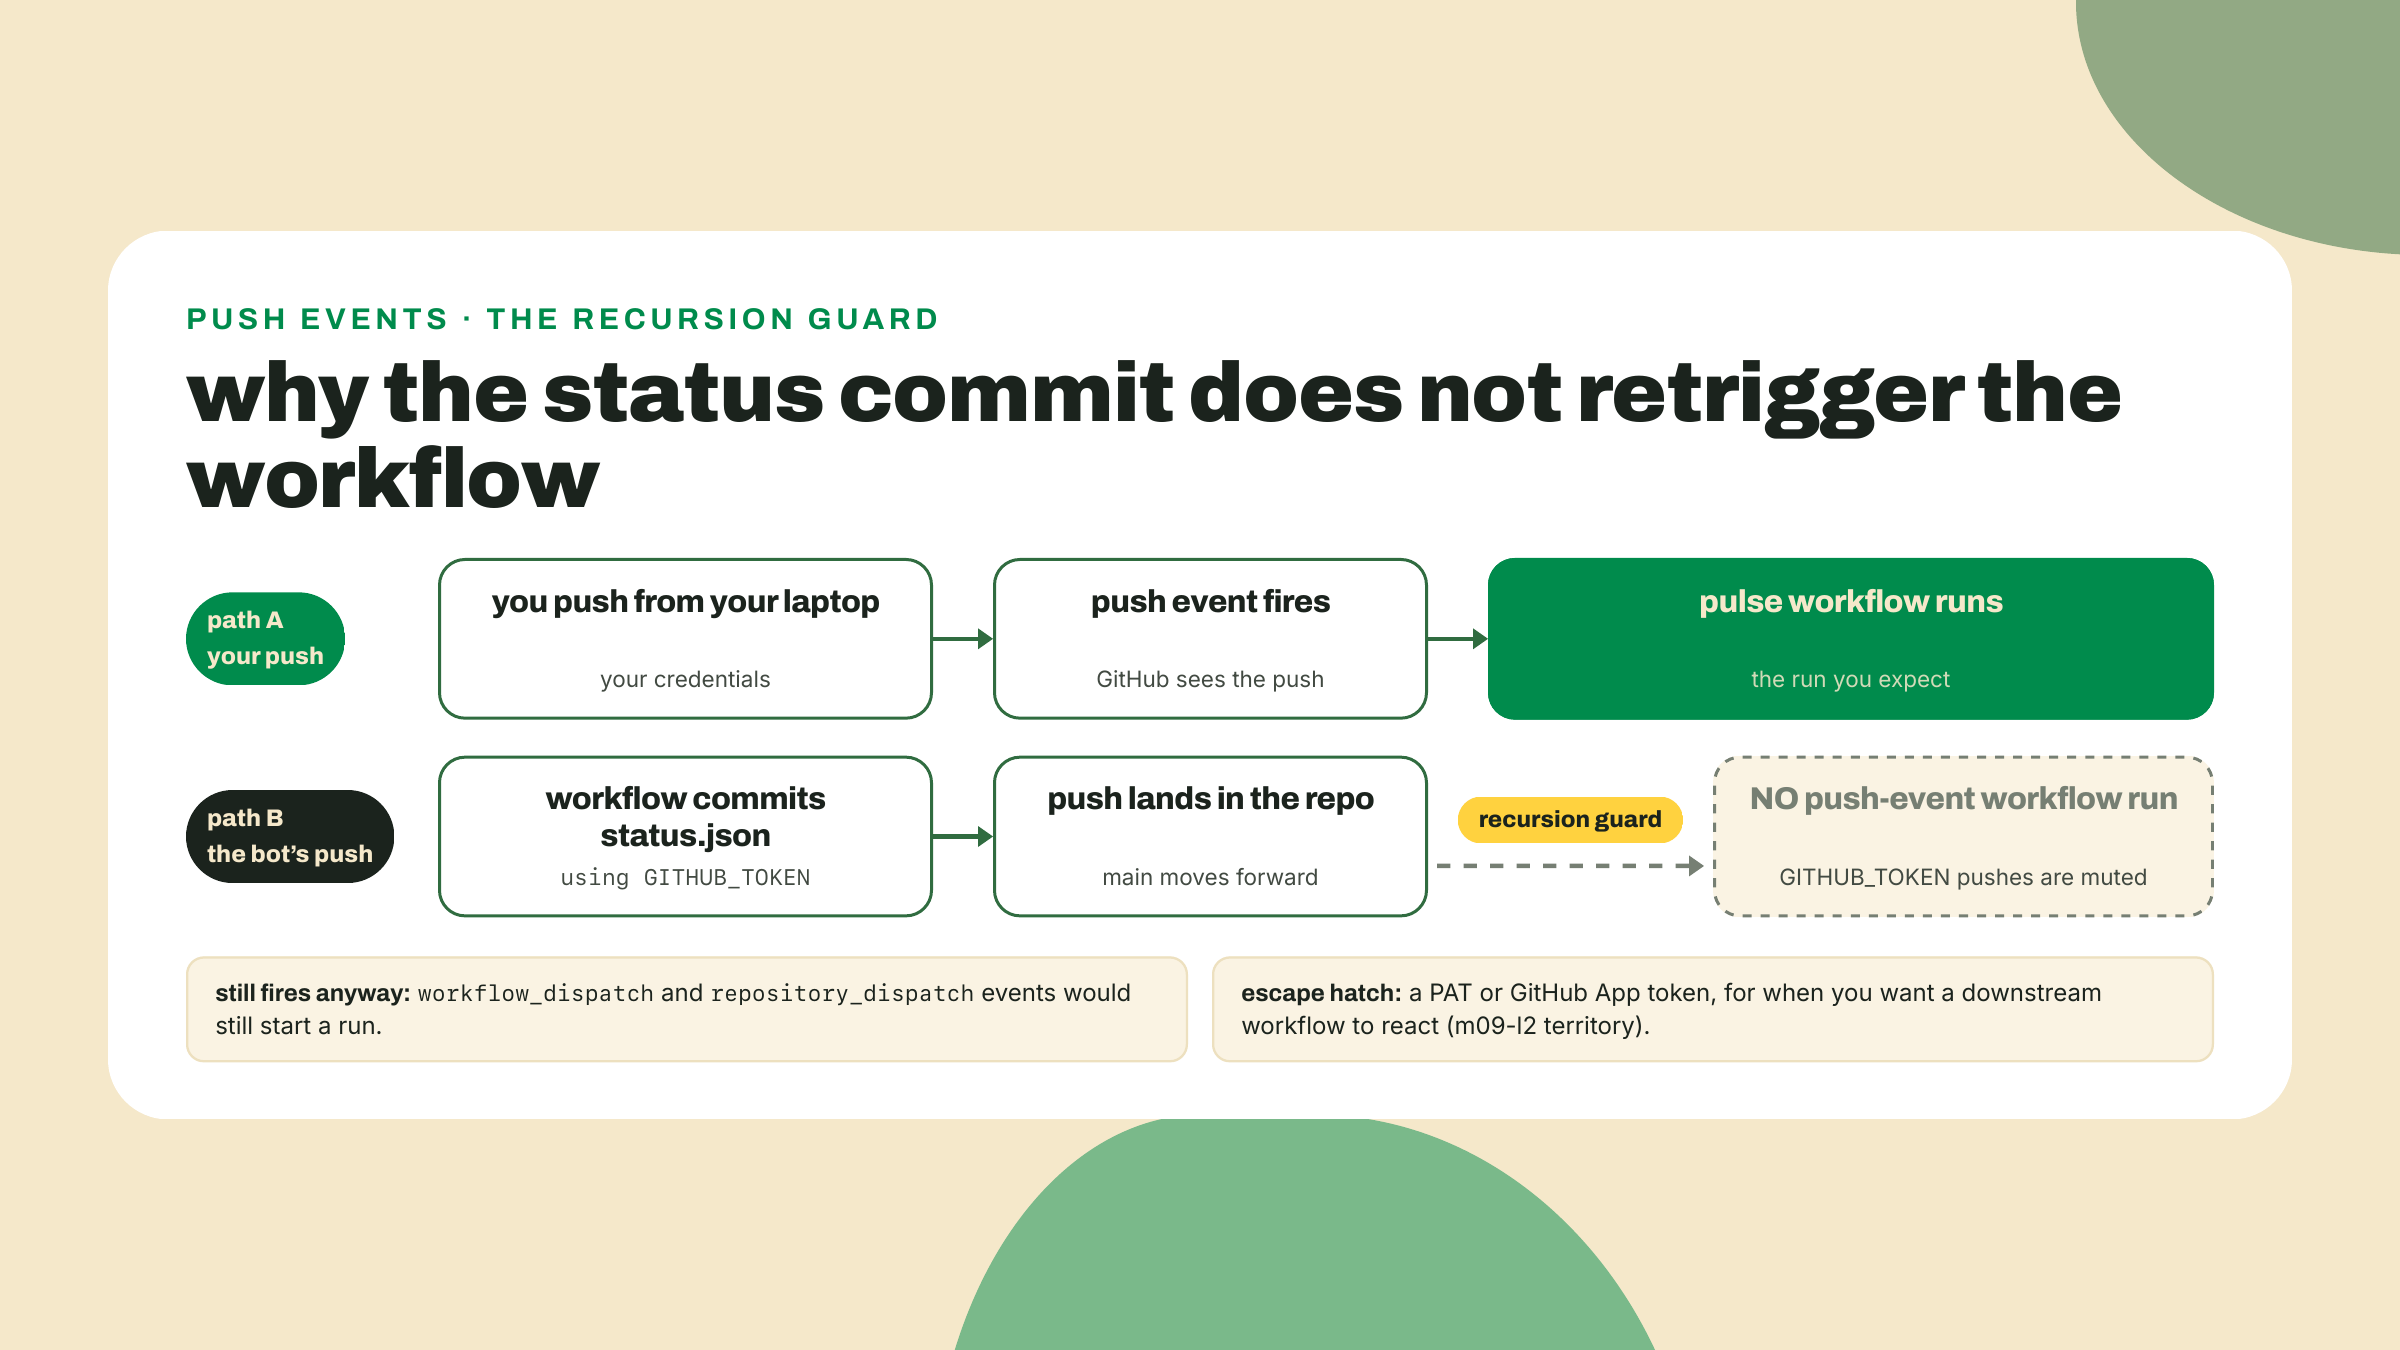
Um ponteiro para frente para que a trava não te surpreenda depois: um dia você vai QUERER que um commit acorde um segundo workflow, e o caminho documentado é autenticar com um personal access token ou um token de GitHub App em vez do GITHUB_TOKEN. O módulo 10 traz essa ponte de volta na montagem do capstone, onde você relê exatamente esta trava como operador; hoje, a trava trabalhando contra a propagação é exatamente o que queremos.
Agora a armadilha que pega todo mundo em algum momento, eu incluído. Já voltei de algumas semanas fora para um dos repos da minha própria estação e encontrei seus dados congelados no meio do mês: nenhum erro, nenhum e-mail, nenhum X vermelho. Só silêncio, semanas de profundidade. Na primeira vez que acontece você vai jurar que a plataforma quebrou. Não quebrou. Ela documentou isso.
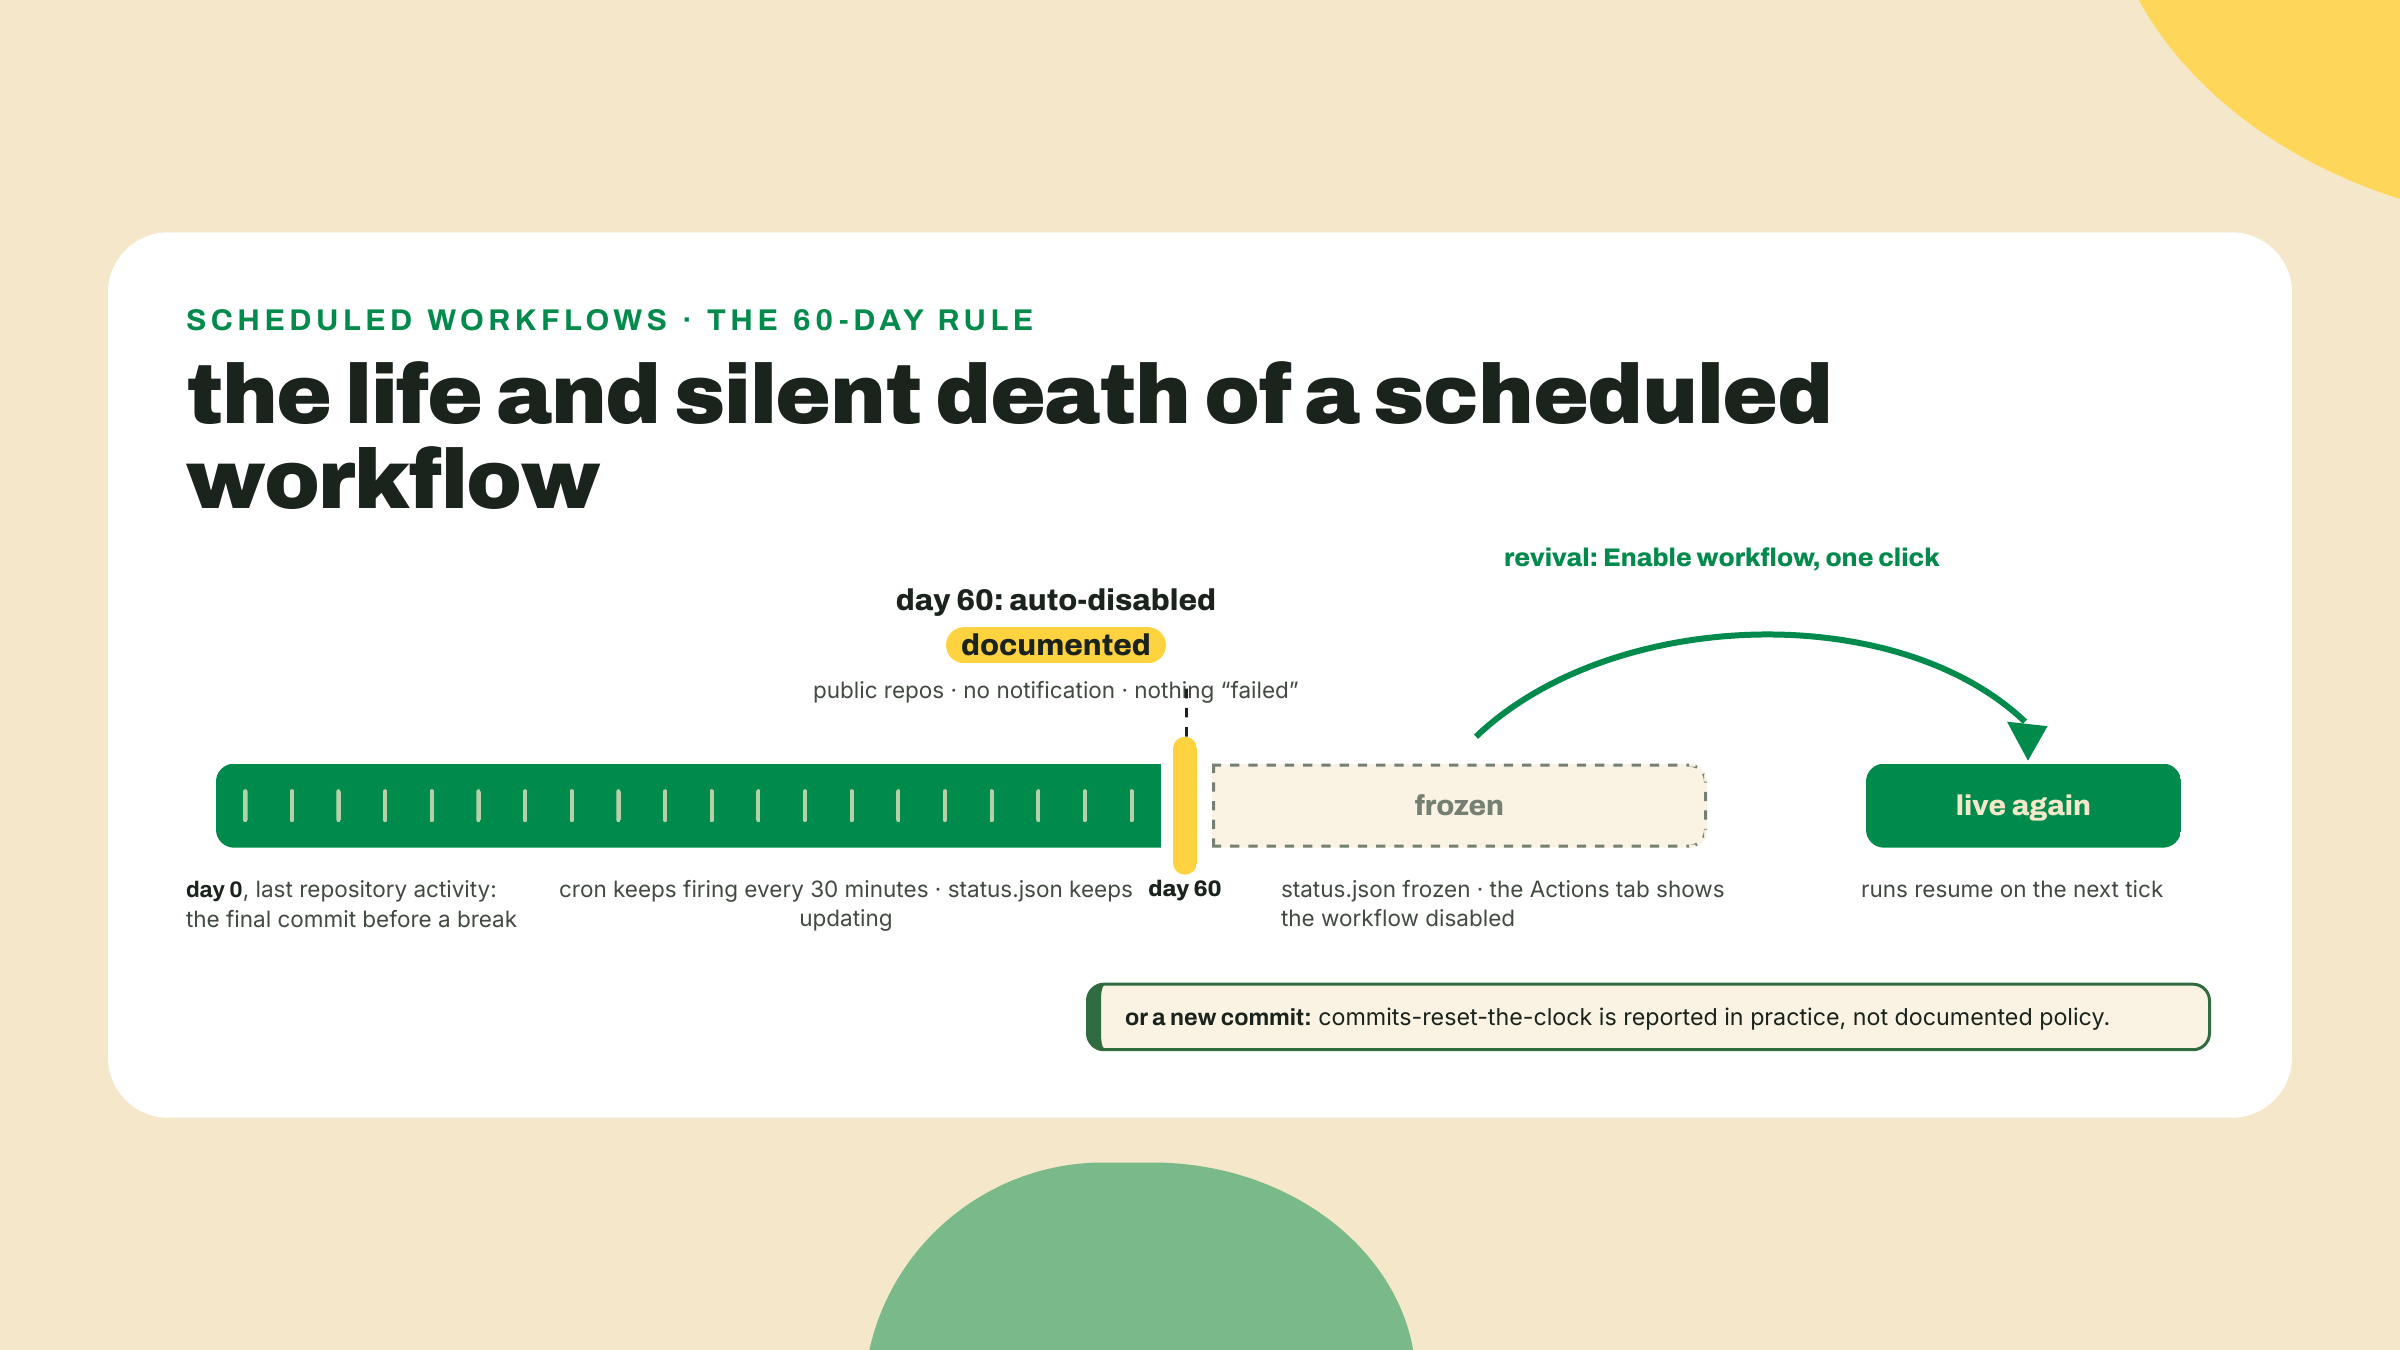
Textualmente: "Em um repositório público, workflows agendados são automaticamente desativados quando nenhuma atividade no repositório ocorreu em 60 dias." Sessenta dias ociosos e o GitHub desliga seu cron. Nada falhou, então nenhuma notificação de falha dispara; o agendamento simplesmente para. Reativar é um clique: aba Actions, selecione o workflow na barra lateral, Enable workflow.
A contramedida que todo mundo usa é o commit de keepalive: atividade automatizada ou manual que reseta o relógio. Aqui eu te devo uma ressalva, porque é aqui que a documentação silencia: o GitHub nunca define o que significa "atividade no repositório". A prática da comunidade, e a existência de actions de keepalive feitas para isso, diz que commits resetam o relógio de 60 dias, e é assim que eu jogaria. Mas isso é relatado-na-prática, não política do GitHub, e este curso não vai fantasiar uma como a outra. Para a sua estação, a leitura prática é mais gentil de todo jeito: um repo em que você está construindo ativamente reseta seu próprio relógio constantemente, e uma estação terminada que precisa sobreviver à sua atenção é precisamente o caso para o qual a lição de alarme do módulo 9 existe.
Armadilha vizinha, mesma família: forks. Textualmente: "Quando um repositório público recebe um fork, workflows agendados são desativados por padrão." Se um colega faz um fork da sua estação esperando um batimento rodando, ele ganha um morto até visitar sua própria aba Actions e ativar. Fazer-fork-e-esperar-para-sempre é um rito de passagem; agora não vai ser o seu.
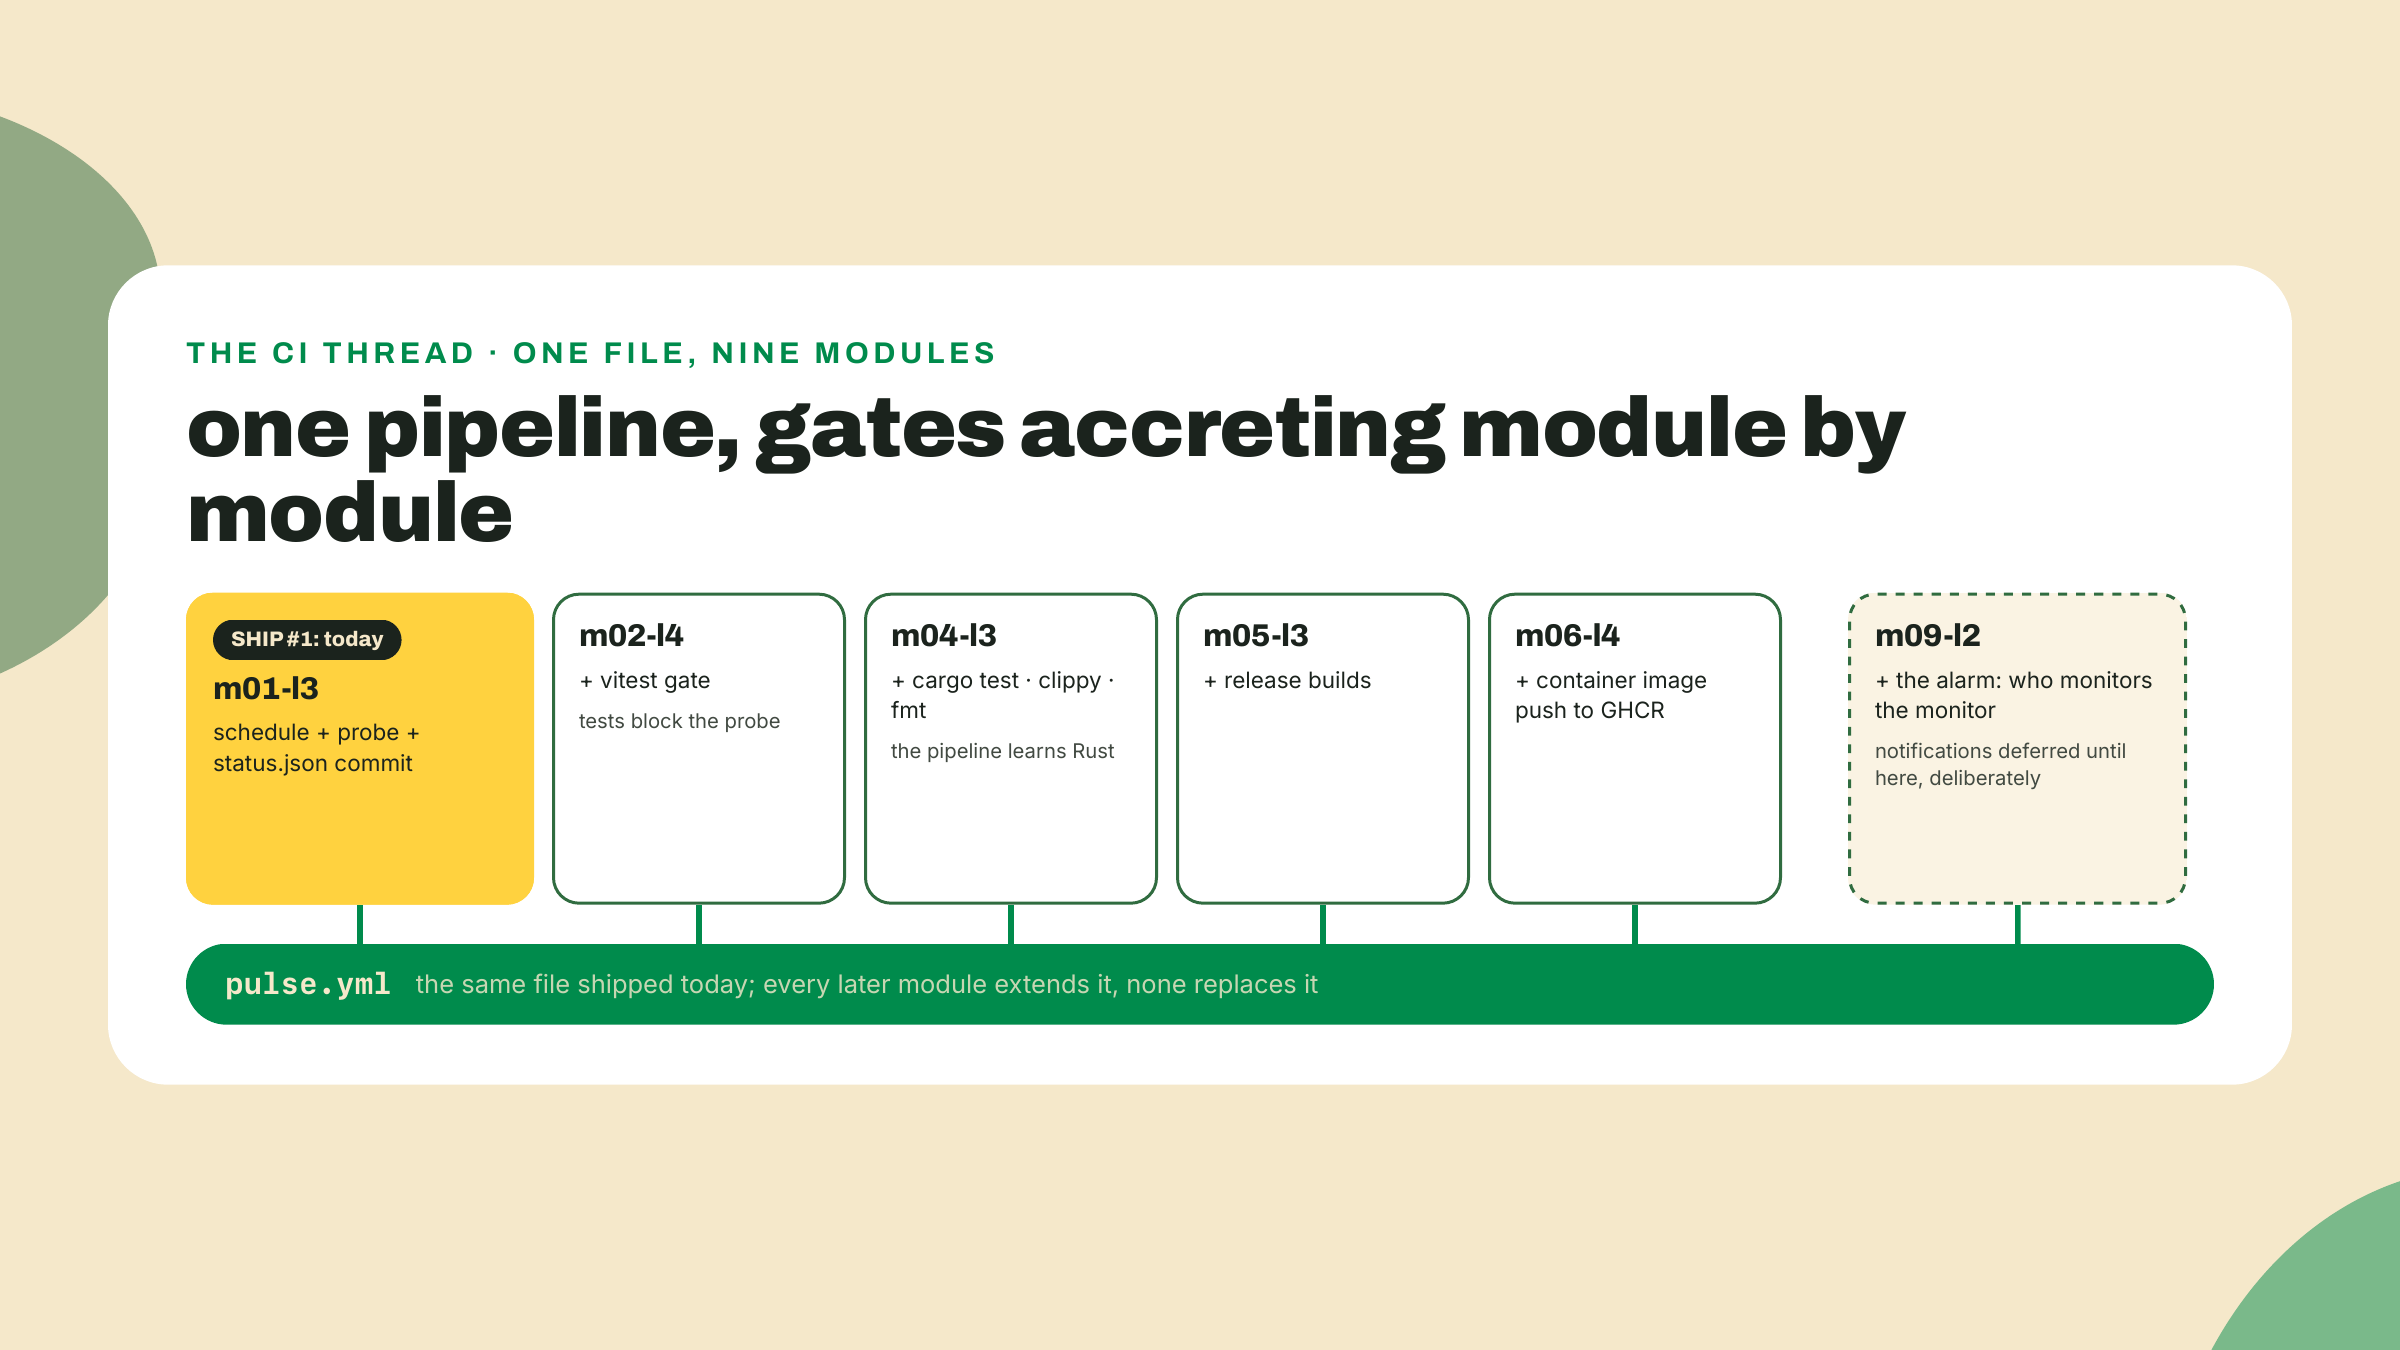
Dê um zoom out antes do lab, porque este arquivo YAML não é um acessório de uma lição só. Ele é a espinha dorsal do curso, e eu quero esse contrato por escrito.
CI não é um executor de testes. É a primeira máquina que não é sua para rodar seu código. Testes são só uma das coisas que você pode colocar nela. Hoje a máquina roda sua sonda em um relógio. Em m02-l4 este mesmo arquivo ganha uma trava de vitest, e daí em diante código que falha nos seus testes não pode chegar em main. Em m04-l3 ele aprende Rust: cargo test, clippy, fmt como não negociáveis. Em m05-l3 ele faz build de binários de release; em m06-l4 ele dá push de imagens de contêiner para um registro. Todo módulo que vem depois adiciona uma trava a ESTE pipeline, o que você faz ship hoje. Até o capstone, "está na main" e "uma máquina verificou" vão significar a mesma coisa, e essa equivalência é o hábito mais transferível que este curso instala.
O trade-off que você está aceitando merece a mesma luz do dia. No seu laptop a sonda rodou exatamente quando você disse. Na infraestrutura compartilhada do tier gratuito o agendamento é best-effort: execuções derivam e, sob carga, algumas são descartadas, o que é sobrevivível para um batimento de 30 minutos e desqualificante para qualquer coisa que precise de horário exato. A plataforma também pode te parar em silêncio, como a regra dos 60 dias acabou de mostrar. Você trocou controle por permanência, e CI grátis nas máquinas de outra pessoa significa fazer engenharia para os modos de falha DELES. Essa habilidade, projetar em torno da folga documentada de uma plataforma em vez de se ressentir dela, é o fio de ops de todo este curso.
Vá mais fundo (os 20%). esta lição ensinou a fatia do GitHub Actions que a estação precisa: triggers, uma forma de job, o token e a física de agendamento da plataforma. O resto, matrix builds, estratégias de cache, reusable workflows, environments, secrets, self-hosted runners, vive na documentação do GitHub Actions em https://docs.github.com/en/actions (verificado ao vivo em 2026-09-02). Salve nos favoritos agora; quando a trava de um módulo posterior precisar de uma feature que não ensinamos, é para lá que vamos apontar, capítulo por capítulo. Nada no lab de hoje depende disso.
Hora de fazer o check verde acontecer sem você. Pipeline completo: um runner de frota que escreve status.json, o workflow adulto com seus três TODOs, um branch-and-merge de verdade e depois a espera por uma execução que você não iniciou.
Faça a sonda escrever um arquivo, não só uma linha. Seu probe.ts imprime em um terminal que ninguém vai estar olhando às 3 da manhã; a frota precisa de evidência em disco. Crie fleet.ts ao lado dele:
import { writeFile } from "node:fs/promises";

const TARGETS = [
  "https://www.rust-lang.org",
  "https://www.typescriptlang.org",
  "https://solana.com",
];

type ProbeResult = {
  url: string;
  status: number;
  latencyMs: number | string; // deliberate v0 sin, see below
  checkedAt: string;
};

async function probeOne(url: string): Promise<ProbeResult> {
  const checkedAt = new Date().toISOString();
  const start = performance.now();
  try {
    const res = await fetch(url, { signal: AbortSignal.timeout(10_000) });
    const latencyMs = Math.round((performance.now() - start) * 10) / 10;
    return { url, status: res.status, latencyMs, checkedAt };
  } catch {
    return { url, status: 0, latencyMs: "timed out or unreachable", checkedAt };
  }
}

const results: ProbeResult[] = [];
for (const url of TARGETS) {
  results.push(await probeOne(url));
}

const report = {
  generatedAt: new Date().toISOString(),
  targets: results,
};

await writeFile("status.json", JSON.stringify(report, null, 2) + "\n");
console.log(`wrote status.json: ${results.length} targets`);
O mesmo par de cronometragem do probe.ts, três alvos em sequência, um arquivo JSON de saída. Essa forma de relatório, generatedAt mais um array targets de { url, status, latencyMs, checkedAt }, é um contrato: o painel do módulo 3 renderiza exatamente este arquivo, então trate os nomes dos campos como congelados a partir de hoje. E sim, latencyMs: number | string é uma mentira esperando para acontecer: um timeout é registrado como prosa e um consumidor downstream fazendo conta com ele ganha uma surpresa. Esse pecado é deliberado, o módulo 2 é inteiramente sobre fazer esta frota falhar alto em vez de falhar com educação, e ele precisa de algo para corrigir. Rode uma vez localmente:
npx tsx fleet.ts
cat status.json
Esperado: três latências reais (ou uma string honesta se um alvo der timeout) em JSON formatado. A instalação da lição passada fixou o tsx em devDependencies; confirme que está listado no package.json, porque o npm ci do runner está a ponto de precisar de uma instalação reproduzível. Se por algum motivo estiver faltando, npm i -D tsx resolve.
Faça o workflow crescer. Substitua a versão com echo de .github/workflows/pulse.yml pela real. Três TODOs são seus; todo o resto é dado. Preencha antes de espiar o passo 3:
name: pulse

on:
  push:
    branches: [main]
  schedule:
    # TODO 1: a cron expression that fires every 30 minutes
    - cron: "TODO"

# TODO 2: the permissions block that lets GITHUB_TOKEN push
#         (without it, the final step dies with a 403)

jobs:
  probe:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: 24
          cache: npm
      - run: npm ci
      - run: npx tsx fleet.ts
      - name: Commit status.json if it changed
        run: |
          git config user.name "pulse-bot"
          git config user.email "pulse-bot@users.noreply.github.com"
          git add status.json
          # TODO 3: skip the commit when status.json is unchanged
          #         (hint: git diff --staged --quiet exits 0 when staged is empty)
          git commit -m "pulse: scheduled probe"
          git push
Lendo as partes dadas: checkout põe seu código no runner em branco, setup-node instala o Node 24 (a linha LTS atual; o Node 26 assume como LTS em 2026-10-28, e o 24 aqui vai ser atualizado quando o fio de ops do curso revisitar) com cache do npm, npm ci faz uma instalação limpa a partir do seu lockfile, e o step de commit dá um nome ao robô para que o histórico de status.json se leia com honestidade.
Os TODOs preenchidos. Compare, não copie primeiro:
on:
  push:
    branches: [main]
  schedule:
    - cron: "*/30 * * * *"

permissions:
  contents: write
E a trava, dentro do bloco run: do step de commit, substituindo o comentário TODO e as duas linhas depois dele:
if git diff --staged --quiet; then
  echo "status.json unchanged, nothing to commit"
  exit 0
fi
git commit -m "pulse: scheduled probe"
git push
A trava é prática defensiva, e vou ser franco sobre isso: como fleet.ts está, generatedAt é um timestamp novo a cada execução, então status.json sempre muda e a trava nunca dispara. Mas no momento em que uma edição futura remover ou engrossar os timestamps, uma execução com latências idênticas tentaria um commit vazio e falharia o step. git diff --staged --quiet sai com 0 exatamente quando nada no staged mudou, então o step termina limpo e a execução fica verde.
Faça o ship do jeito profissional: branch, PR, merge. Você poderia dar push direto na main; adquira o hábito de não fazer isso, porque toda trava que este pipeline ganhar depois assume que mudanças chegam como pull requests. Uma branch é um rótulo móvel para uma linha de commits; um pull request é a unidade de mudança: um diff nomeado que alguém (hoje: você) revisa e faz merge.
git checkout -b feat/cron-workflow
git add .github fleet.ts package.json package-lock.json
git commit -m "ci: probe fleet on a 30-minute schedule"
git push -u origin feat/cron-workflow
gh pr create --fill
gh pr merge --squash
Fazer merge não é burocracia aqui, é ativação: lembre, workflows agendados rodam no último commit da branch padrão. Até isso cair na main, seu cron é decorativo.
Assista à execução disparada por push, depois confira o commit do robô. O merge para main aciona o trigger de push, então você ganha feedback instantâneo sem esperar o relógio. Na aba Actions, veja a execução ficar verde. Você ainda está na feature branch, e a execução local do passo 1 deixou um status.json não rastreado que o commit do workflow agora também adiciona, então o git recusaria o pull para evitar sobrescrevê-lo. Volte para a main, limpe o arquivo local e faça pull:
git checkout main
rm -f status.json
git pull
git log --oneline -3
Esperado: um commit de autoria de pulse-bot tocando status.json, sentado no topo do seu merge. Agora encare a aba Actions por um segundo a mais: aquele commit do bot NÃO iniciou outra execução. A trava de recursão da seção de teoria, ao vivo no seu próprio repo. Se em vez disso o step final da sua execução falhou com um 403, é o TODO 2 faltando ou mal indentado; corrija, dê push, rode de novo.
O momento para o qual você realmente fez o ship: uma execução que você não iniciou. A próxima fronteira de :00 ou :30 UTC está a no máximo 30 minutos de distância. Feche o laptop se quiser; esse é o ponto. Quando você voltar:
gh run list --workflow pulse.yml --limit 2
Esperado: pelo menos uma execução concluída cuja coluna de evento diz schedule, verde, com um commit novo de pulse-bot em status.json atrás dela. Sua sonda rodou em uma máquina que não é sua, em um relógio que ninguém observa, e fez commit da evidência. Esse é o SHIP #1. Saboreie por dez segundos inteiros.
Meça seu desvio. Alvos versus realidade, na sua própria edição. Puxe os timestamps das suas execuções agendadas:
gh run list --workflow pulse.yml --event schedule --limit 3 \
  --json createdAt,status,conclusion
Tome o createdAt de uma execução, note o tick de :00/:30 que ela estava mirando e subtraia. Escreva a frase: "agendado :30, caiu :3X, desvio Xm." Essa frase é a trava da lição, e ela te torna a única pessoa na sala com um número real para um atraso que o GitHub documenta apenas como existente. Mantenha o hábito; você vai fazer a mesma coisa com o tempo de slot de uma blockchain no módulo 8.
Checkpoint, tudo junto: o histórico do Actions mostra uma execução verde disparada por schedule que você não iniciou; status.json carrega um commit de autoria do workflow; esse commit visivelmente não redisparou o pipeline; e você consegue dizer seu desvio medido para uma execução. Quatro caixas, e o primeiro ship é real.
O pipeline roda seu código, mas nada ainda impede código ruim de chegar até ele. Corrija isso você mesmo.
Adicione um segundo job chamado typecheck ao pulse.yml que faz o checkout do código, configura o Node do mesmo jeito, instala e roda npx tsc --noEmit. Depois faça o job probe depender dele, para que um erro de tipo em qualquer lugar do repo bloqueie a sonda de rodar. Duas dicas e nada mais: jobs rodam em paralelo a menos que um declare needs: sobre outro, e tudo que o job typecheck precisa já está demonstrado nos três primeiros steps do job probe.
Aceitação, em ordem: introduza um erro de tipo proposital em fleet.ts e dê push (sim, direto na main, só esta vez: o trigger de push do workflow só observa main, então um push em branch não dispararia nada; o hábito do passo 4 continua valendo para mudanças reais). Veja a execução falhar em typecheck com probe inteiramente pulado. Depois reverta o erro, dê push de novo, e veja o pipeline inteiro ficar verde. Quando m02-l4 formalizar travas de CI com uma suíte de testes real, você já vai ter construído uma do nada.
Se sua execução agendada se recusar teimosamente a aparecer, ou seu número de desvio parecer absurdo, leve a saída de gh run list para a comunidade do curso; uma dúzia de desvios medidos lado a lado ensina mais sobre agendamento best-effort do que qualquer página de documentação, e eu leio essas threads.
Seu batimento agora bate sem você: uma máquina que não é sua sonda a internet a cada meia hora e faz commit da evidência. Mas leia uma semana de status.json e você vai achar mentiras educadas, as que plantamos hoje sabendo o que fazíamos: timeouts registrados como strings, alvos-lixo sondados sem reclamação. O módulo 2 faz a frota falhar alto, começando por dar ao seu v0 um alvo malformado e ver ele dar de ombros. Traga um alvo malformado; ele não vai saber o que o atingiu.
Pergunta 1 de 4