Carregando...

 BetaBeta
O m05-l3 encerrou o módulo Rust que entrega: uma CLI clap com o primeiro braço de sonda de verdade dela em cima do reqwest blocking, debug versus release medidos com números de verdade, e o CI anexando um binário de release a um GitHub Release. Aquele binário sonda, imprime e sai. Hoje ele para de sair. Você vai fazer crescer um terceiro crate no workspace, pulse-pollerd, que sonda todo alvo configurado num intervalo para sempre e responde GET /status com JSON enquanto faz isso. O contrato de recuo, em voz alta: o poll loop do tokio é a única coisa difícil autorada da lição e você recebe ele como um esqueleto de completion com dois buracos. O endpoint axum (o axum é o crate de servidor HTTP em Rust que serve a única porta JSON do daemon) é o oposto: um drop-in totalmente resolvido que você lê e edita mas nunca autora, um passo deliberado para trás em autonomia num pico de verdade, e eu vou dizer isso de novo quando a gente chegar lá. Todo o resto é músculo que você já tem.
A sua CLI sonda e sai. Um monitor que só roda quando você lembra de invocar ele não é um monitor. É um boato com linha de comando. A estação precisa de um processo que sobreviva à invocação: um loop que sonda para sempre, e uma porta em que você pode bater para perguntar como está tudo, agora.
Você conseguiria construir a primeira metade disso em noventa segundos com o que você já sabe. Leia este formato (e se quiser sentir ele rodando, faça isso num branch descartável, embrulhando o seu probe do m05-l3 nele; NÃO deixe isso na main entregue do pulse-cli, que o job de release do m05-l3 publicaria e que o passo 1 do lab precisa intocado):
use std::time::Duration;

fn main() {
    let interval = Duration::from_secs(30);
    loop {
        // your m05-l3 blocking probe(url, timeout), called for each URL you care about
        std::thread::sleep(interval);
    }
}
Isso é um daemon: um processo de primeiro plano de longa duração que faz o trabalho dele num agendamento sem precisar ser chamado duas vezes. Nenhum crate novo, nenhum runtime, nenhum async. Ctrl+C mata ele. Para um punhado de alvos isso é legitimamente aceitável, e eu quero que você segure essa sensação, porque a lição inteira é sobre saber exatamente quando isso deixa de ser aceitável. (Se você rodou ele num branch, apague o branch agora; a casa de verdade do loop é o crate novo que o lab constrói.)
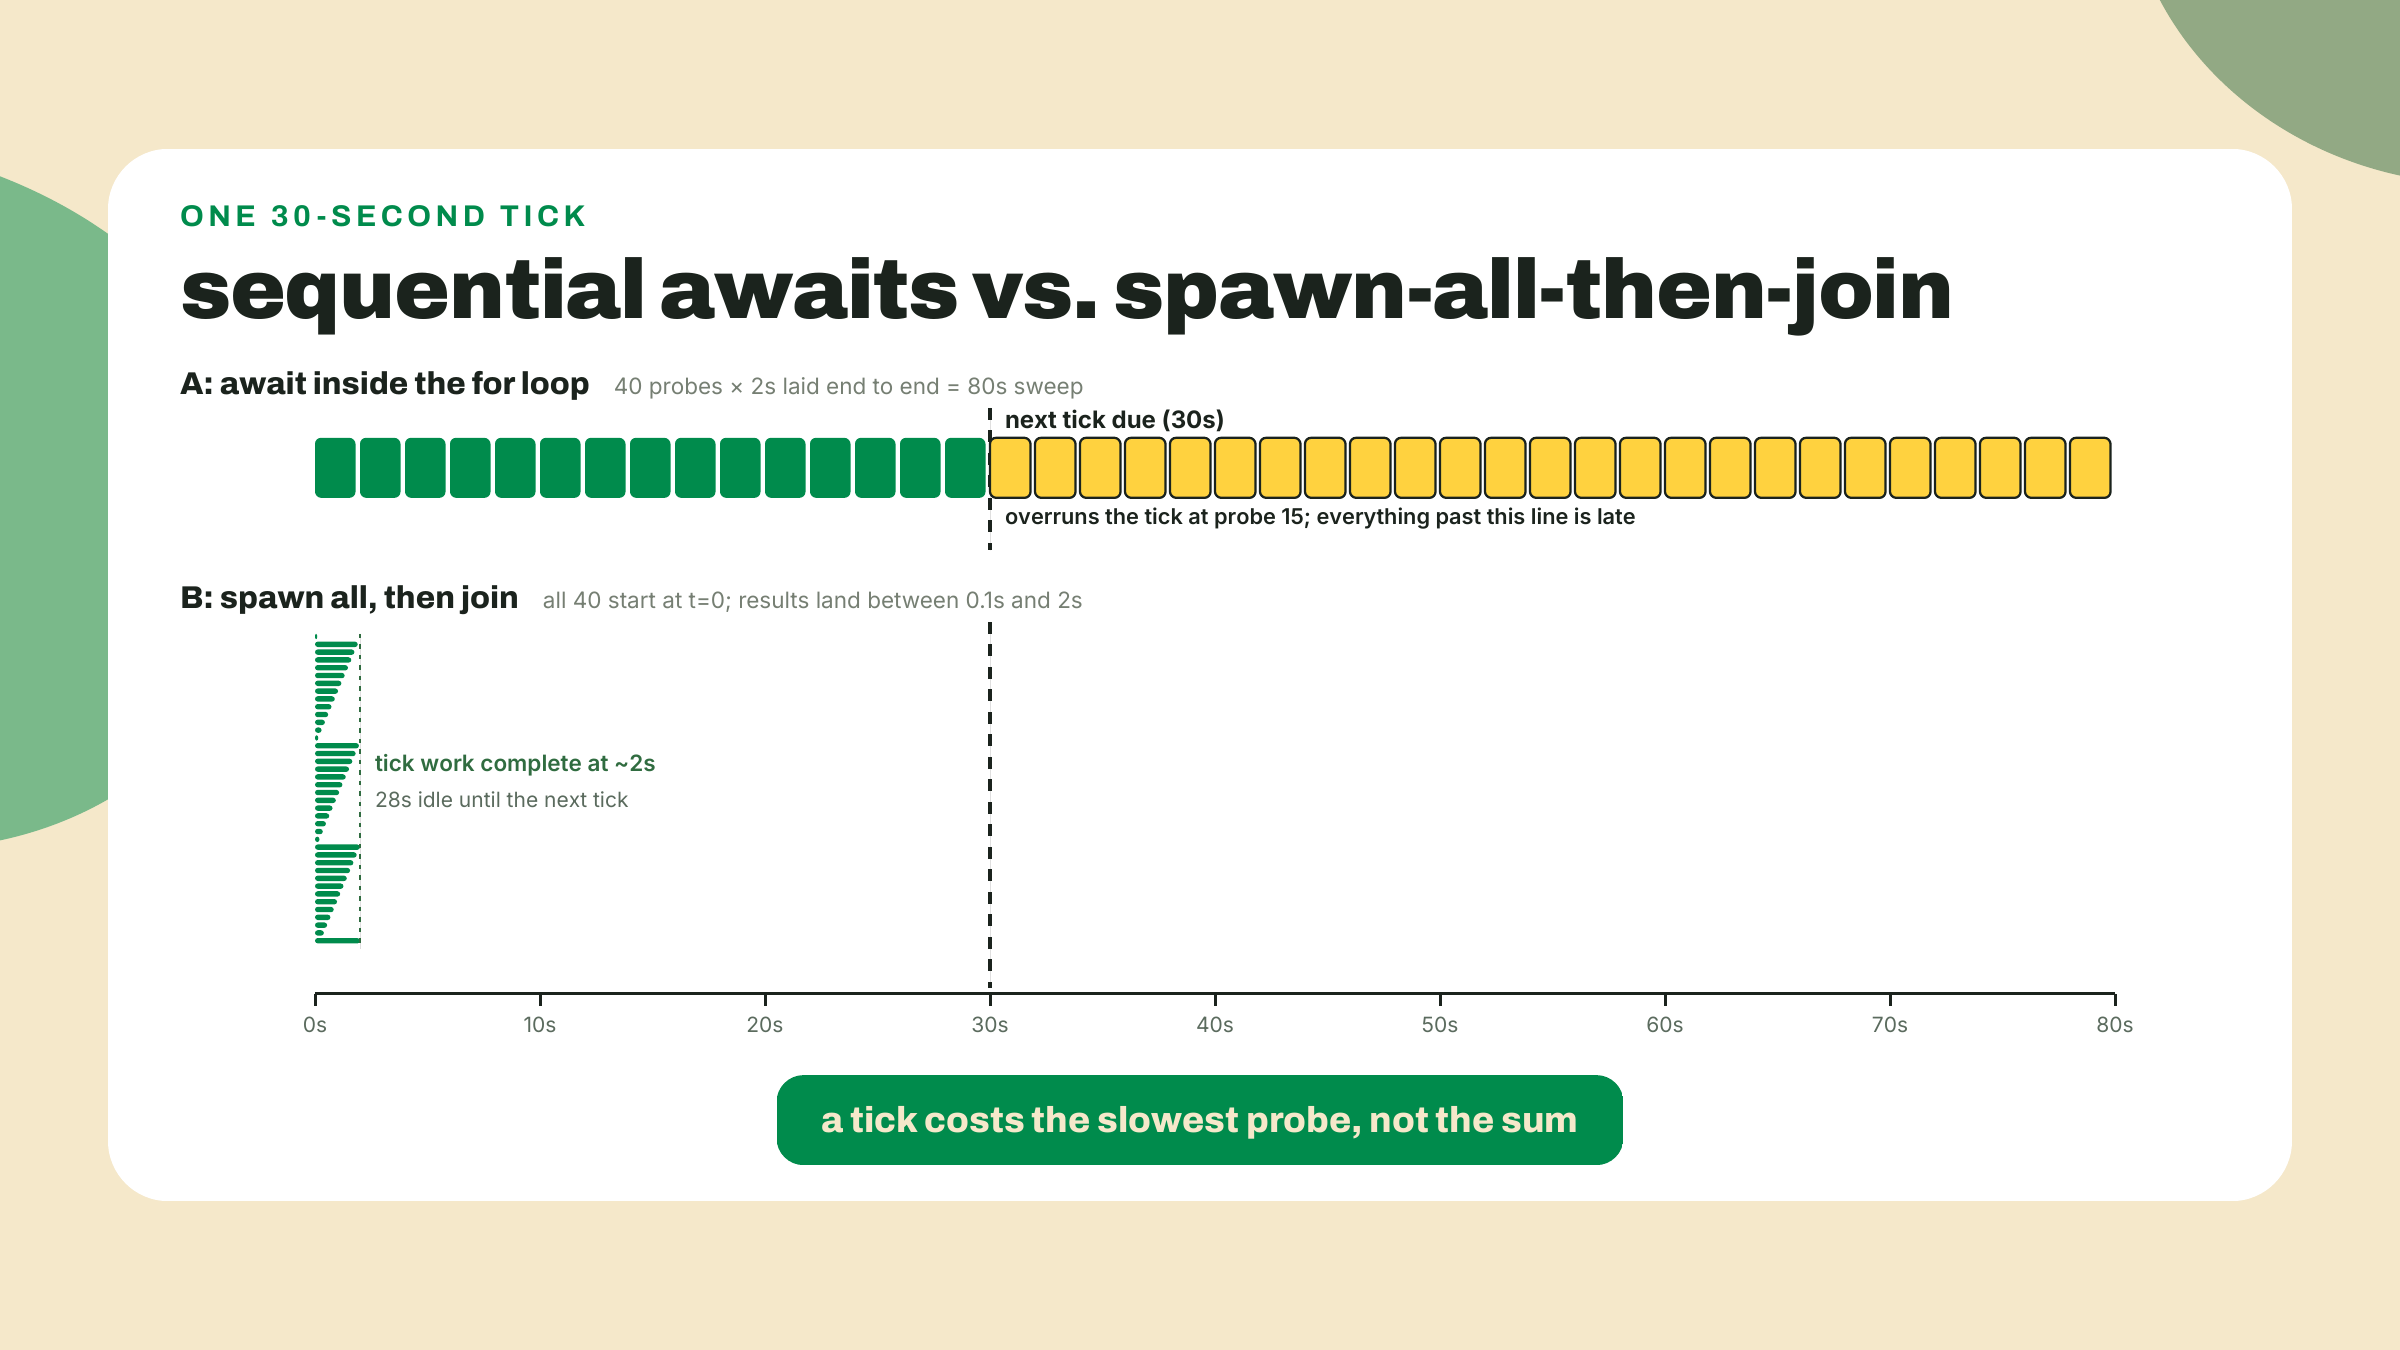
Então vamos fazer isso deixar de ser aceitável. A varredura dentro daquele loop é o fetch blocking do m05-l3, um alvo por vez. Cada sonda segura a thread até a rede responder. Agora faça a aritmética para uma estação adulta: 40 alvos, e digamos que um lento leve 2 segundos para dar timeout. No pior caso a sua varredura leva 40 vezes 2, que são 80 segundos, dentro de um loop que prometeu rodar a cada 30. O cronograma é ficção. A thread passa quase todo esse tempo sem fazer nada: estacionada numa syscall, esperando bytes que estão em algum lugar sobre o Atlântico. Esperar não é trabalhar. Você não precisa de mais CPU. Você precisa de um jeito de uma thread só segurar muitas esperas ao mesmo tempo.
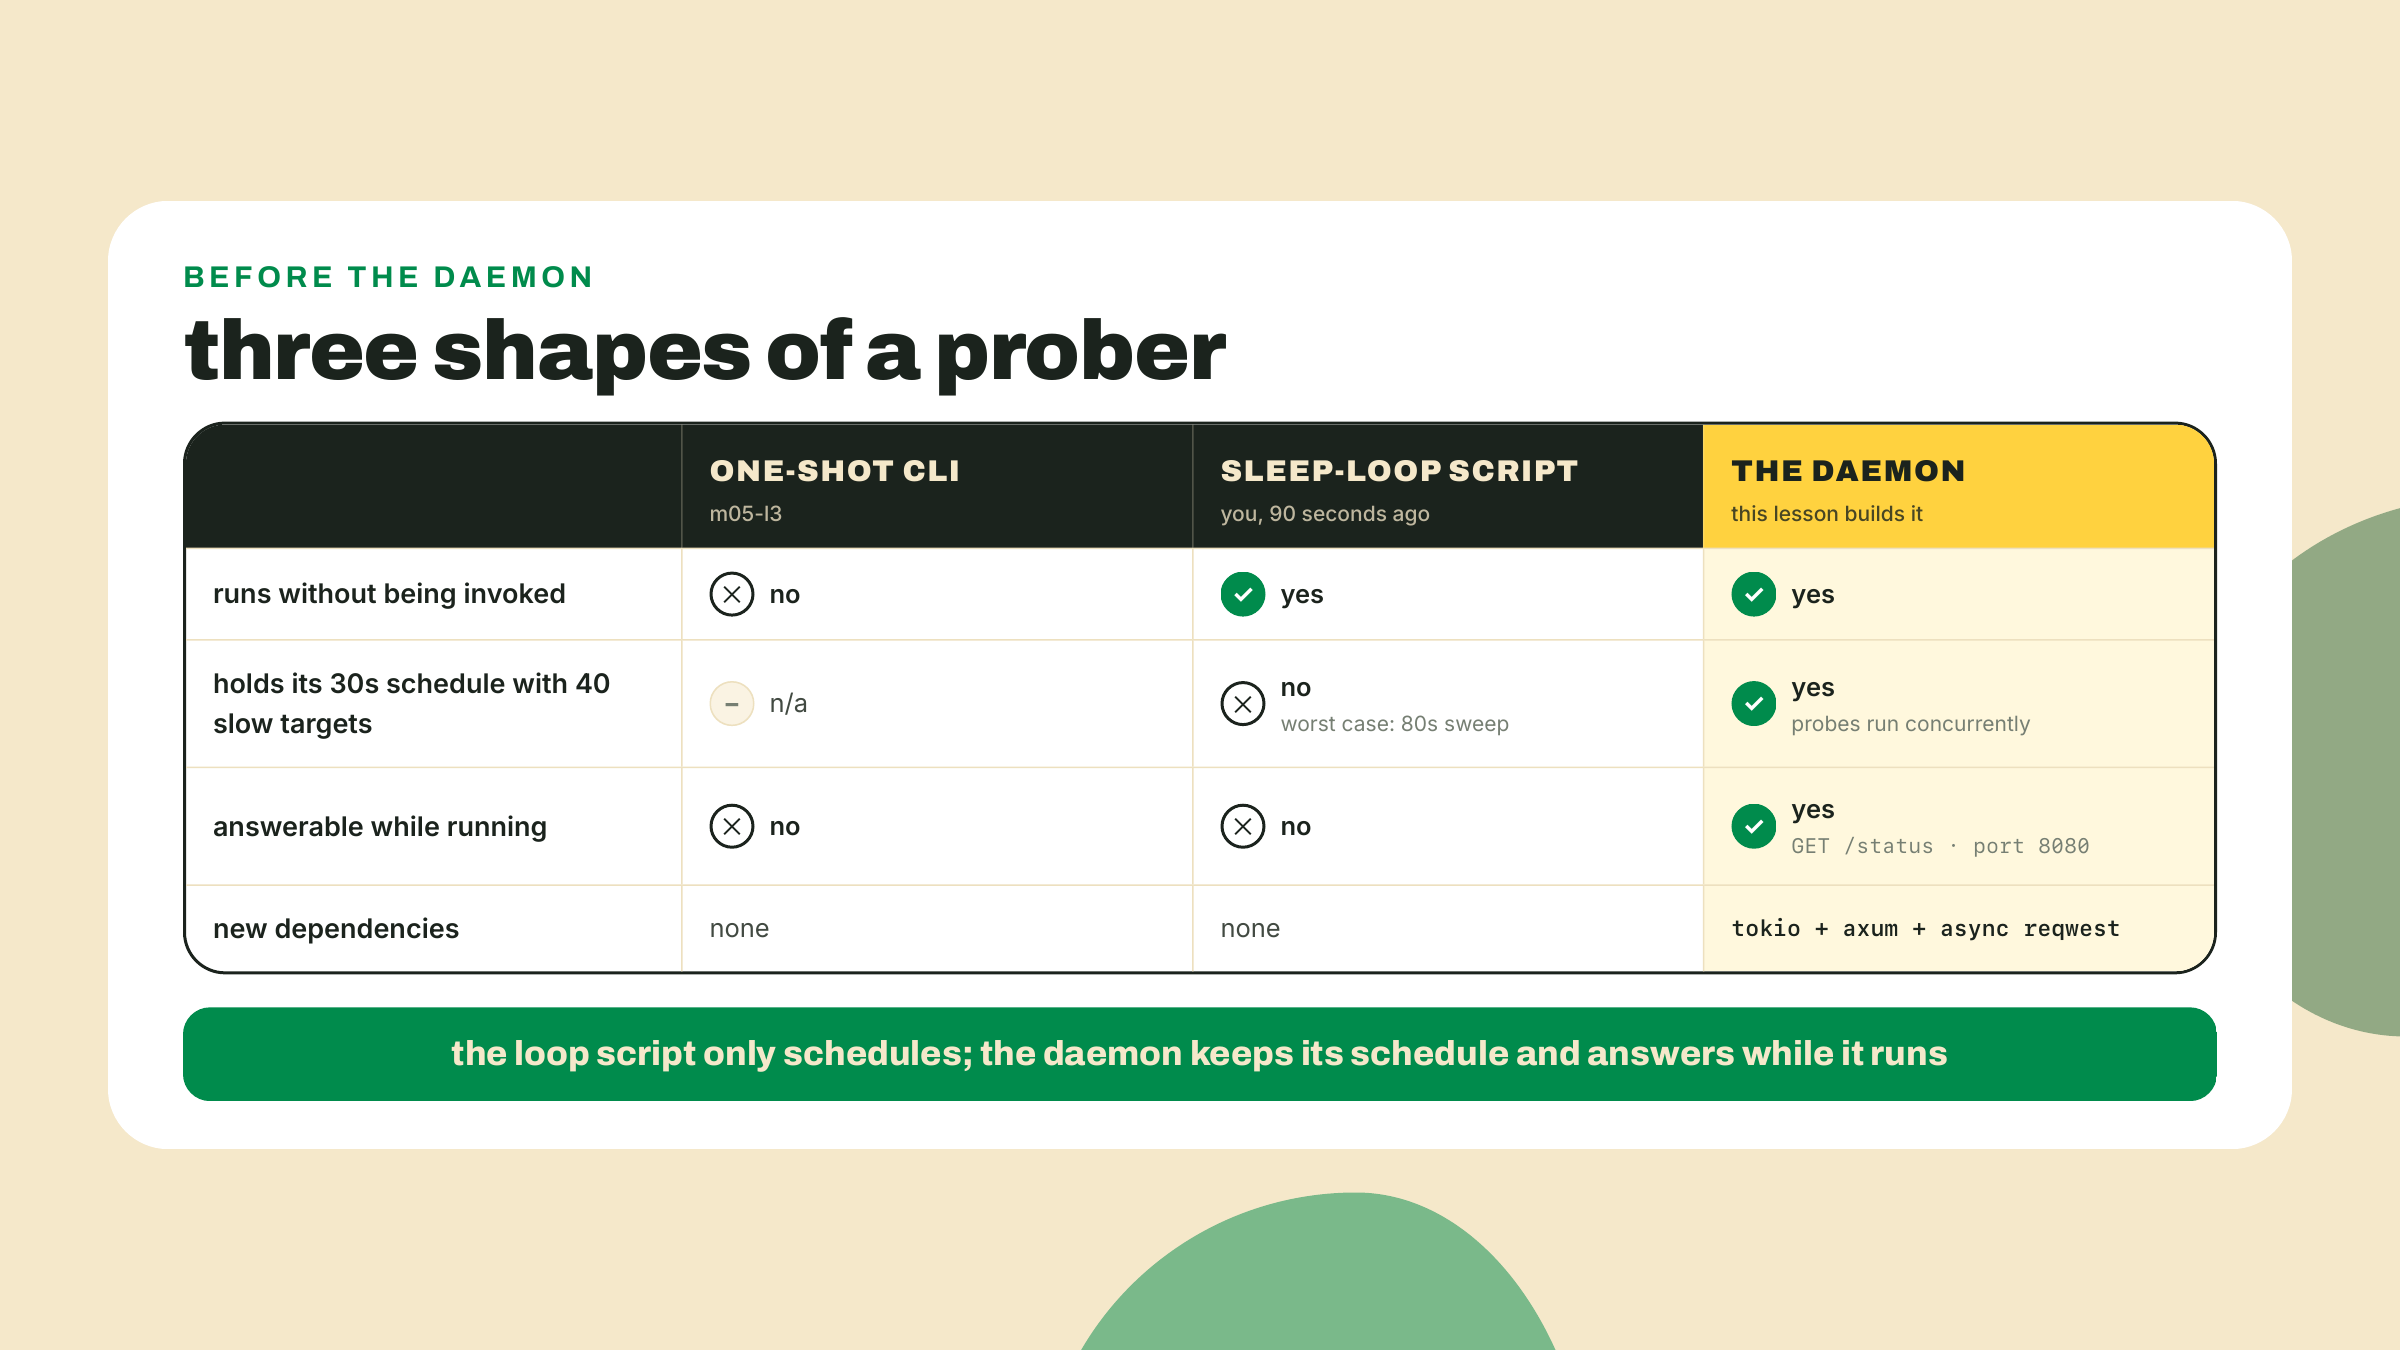
Esse é o argumento inteiro do Rust async, e você já usou o modelo.
Lá em m02-l3 você escreveu a frota TS: o probeAll disparava um pool de fetches, e todo await suspendia uma função no meio do corpo até a promise dela se estabelecer, liberando o event loop para rodar outra pessoa. O modelo mental era suspensão: await é um bookmark, não uma parede. O async do Rust é o mesmo modelo com uma diferença honesta. No Node o event loop é ambiente, sempre lá, invisível no seu package.json. No Rust o runtime é uma dependência que você consegue ver: você adiciona o tokio no Cargo.toml, anota a main, e o escalonador que estaciona e retoma as suas tasks é um crate com um número de versão. Mesma suspensão, agora com um nome no lockfile. Um parágrafo, e essa é a espiral inteira. Tudo o que você aprendeu sobre dar await em TypeScript transfere; o que muda é que a maquinaria para de ser mobília.
O que o tokio compra para um sondador I/O-bound, concretamente: uma task é uma função pausada, algumas centenas de bytes de estado, e uma thread só consegue segurar milhares delas. Cada sonda roda até bater num .await na rede, estaciona, e a thread segue para a próxima task. Quando o socket tem novidade, o runtime retoma a task certa de onde ela parou. Quarenta sondas em voo custam aproximadamente uma thread. A grafia alternativa de concorrência que você já conhece, uma thread de sistema operacional por sonda, compra a mesma vitória de tempo de relógio ao preço de uma stack inteira por thread e uma troca de contexto do kernel por passagem. Para 40 esperas isso honestamente funcionaria. Para 40,000 não, e um indexador que observa toda mudança de conta na Solana vive bem mais perto do segundo número.
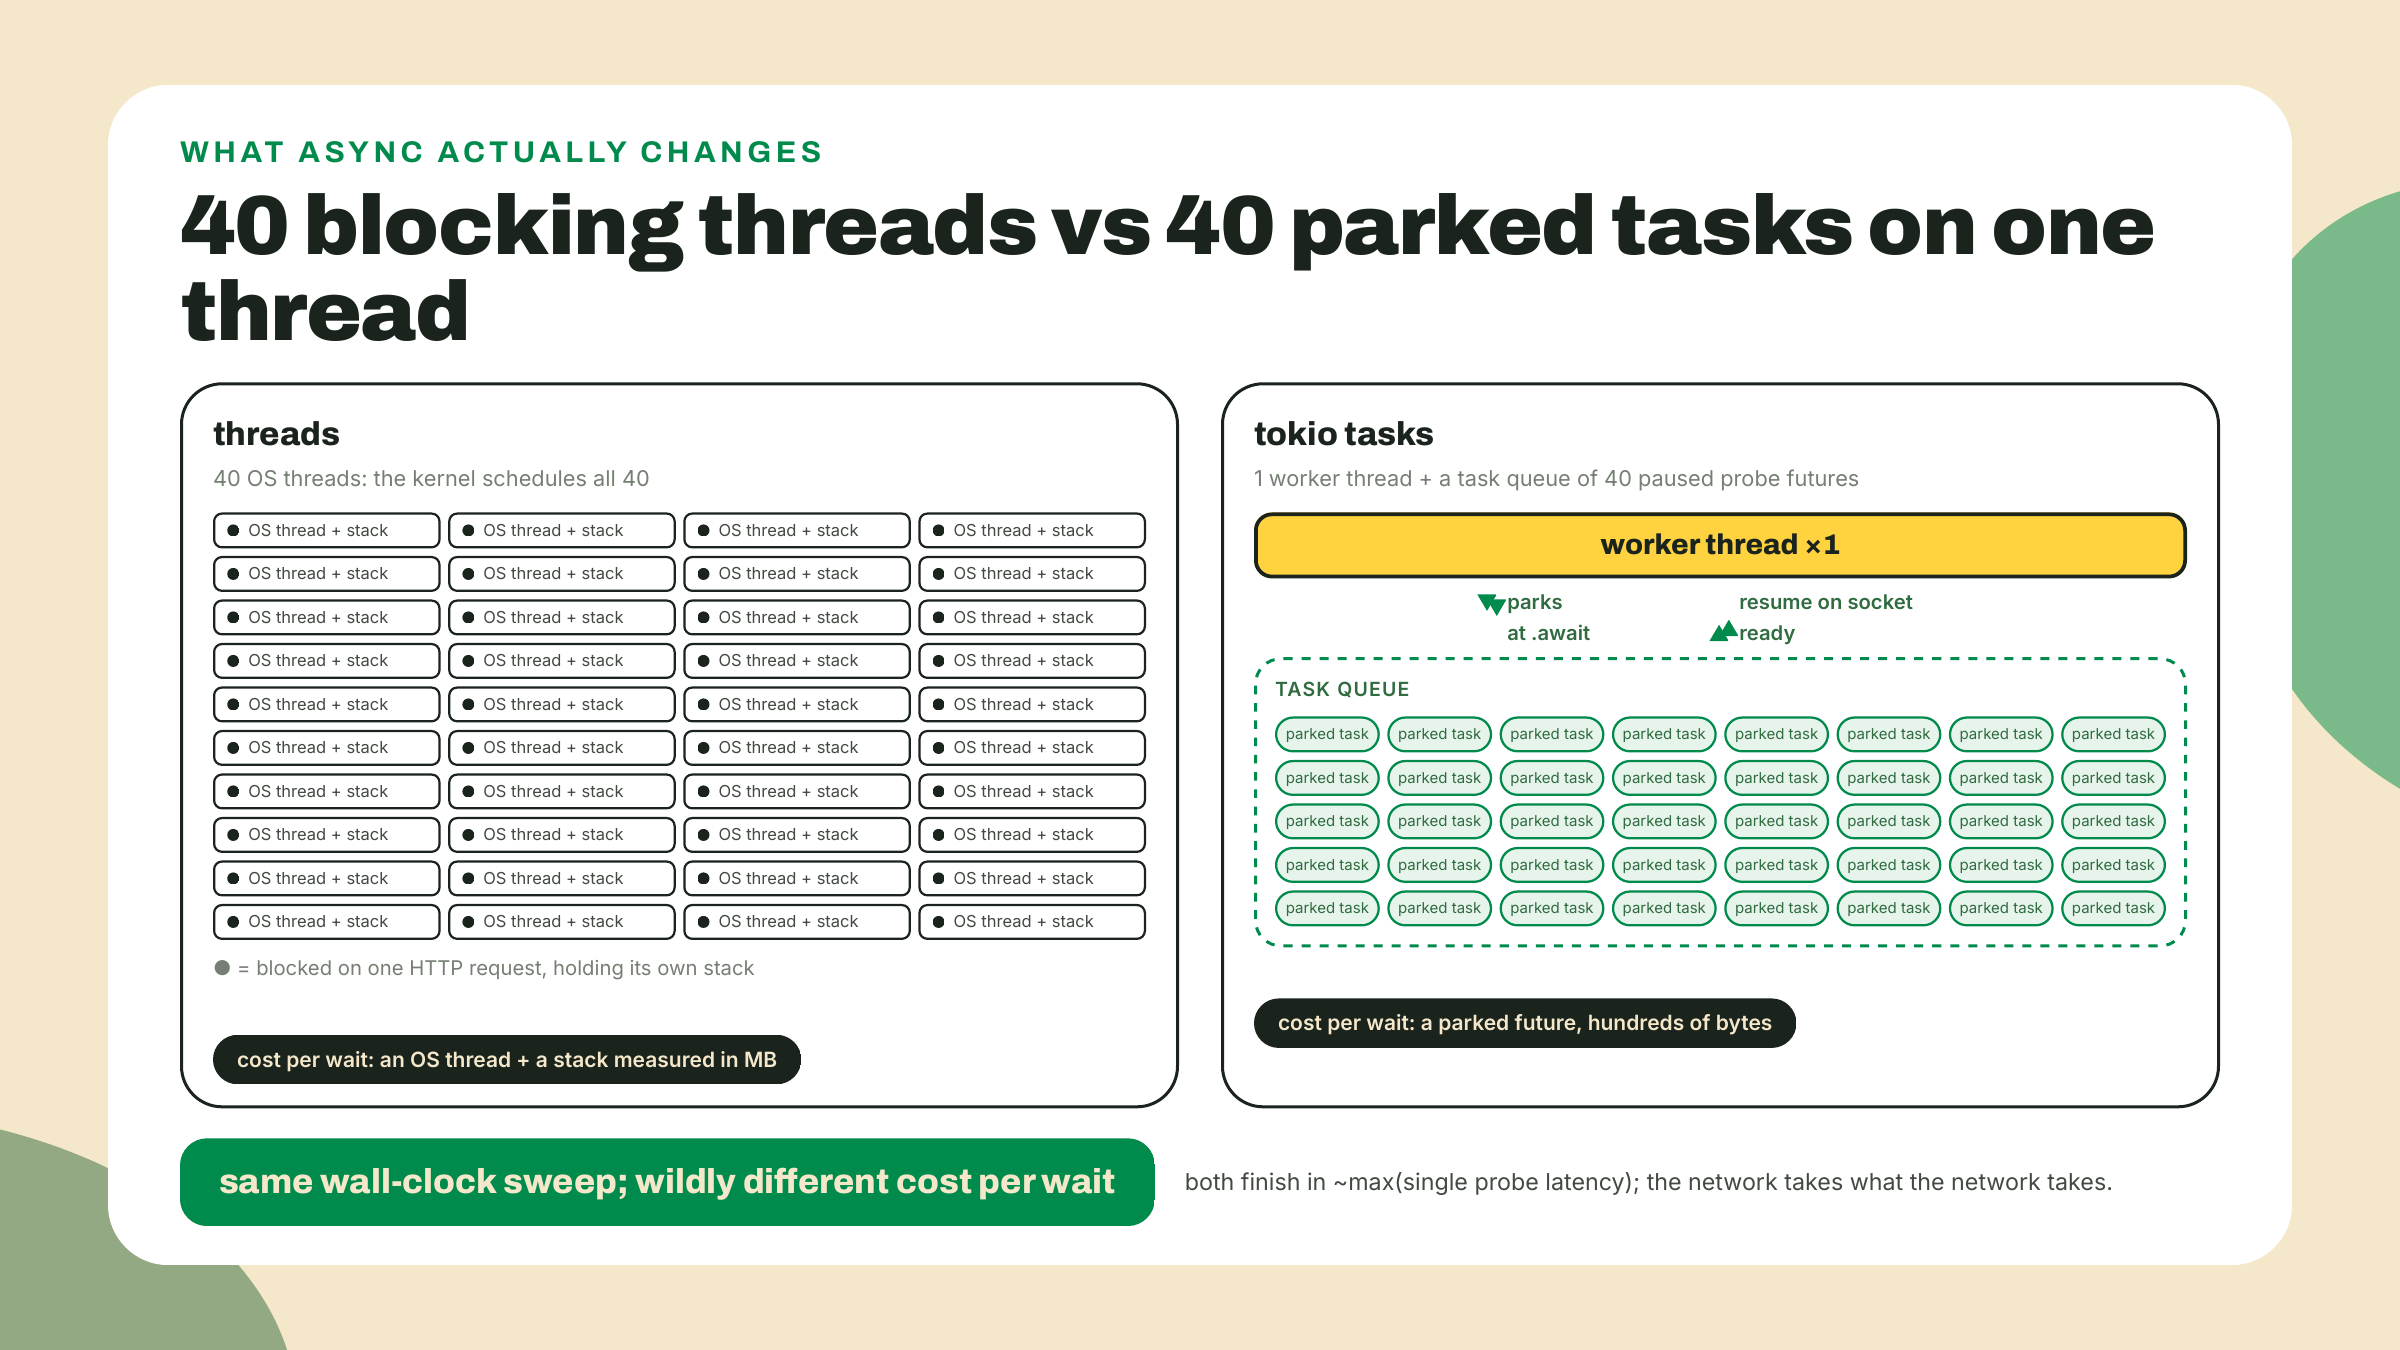
Repare no que não está naquele diagrama: latência. O async não deixa uma requisição única mais rápida. A rede leva o que a rede leva. Se um colega propuser migrar uma CLI de tiro único para o tokio por performance, a resposta honesta é que um único fetch que bloqueia uma vez e sai não tem fan-out nenhum para um runtime explorar, então a migração compra uma dependência e uma anotação nova e mais nada. A chamada blocking do m05-l3 era a decisão certa. Ela continua sendo a decisão certa para aquele binário. O async se paga no fan-out, e hoje, pela primeira vez, a gente tem fan-out.
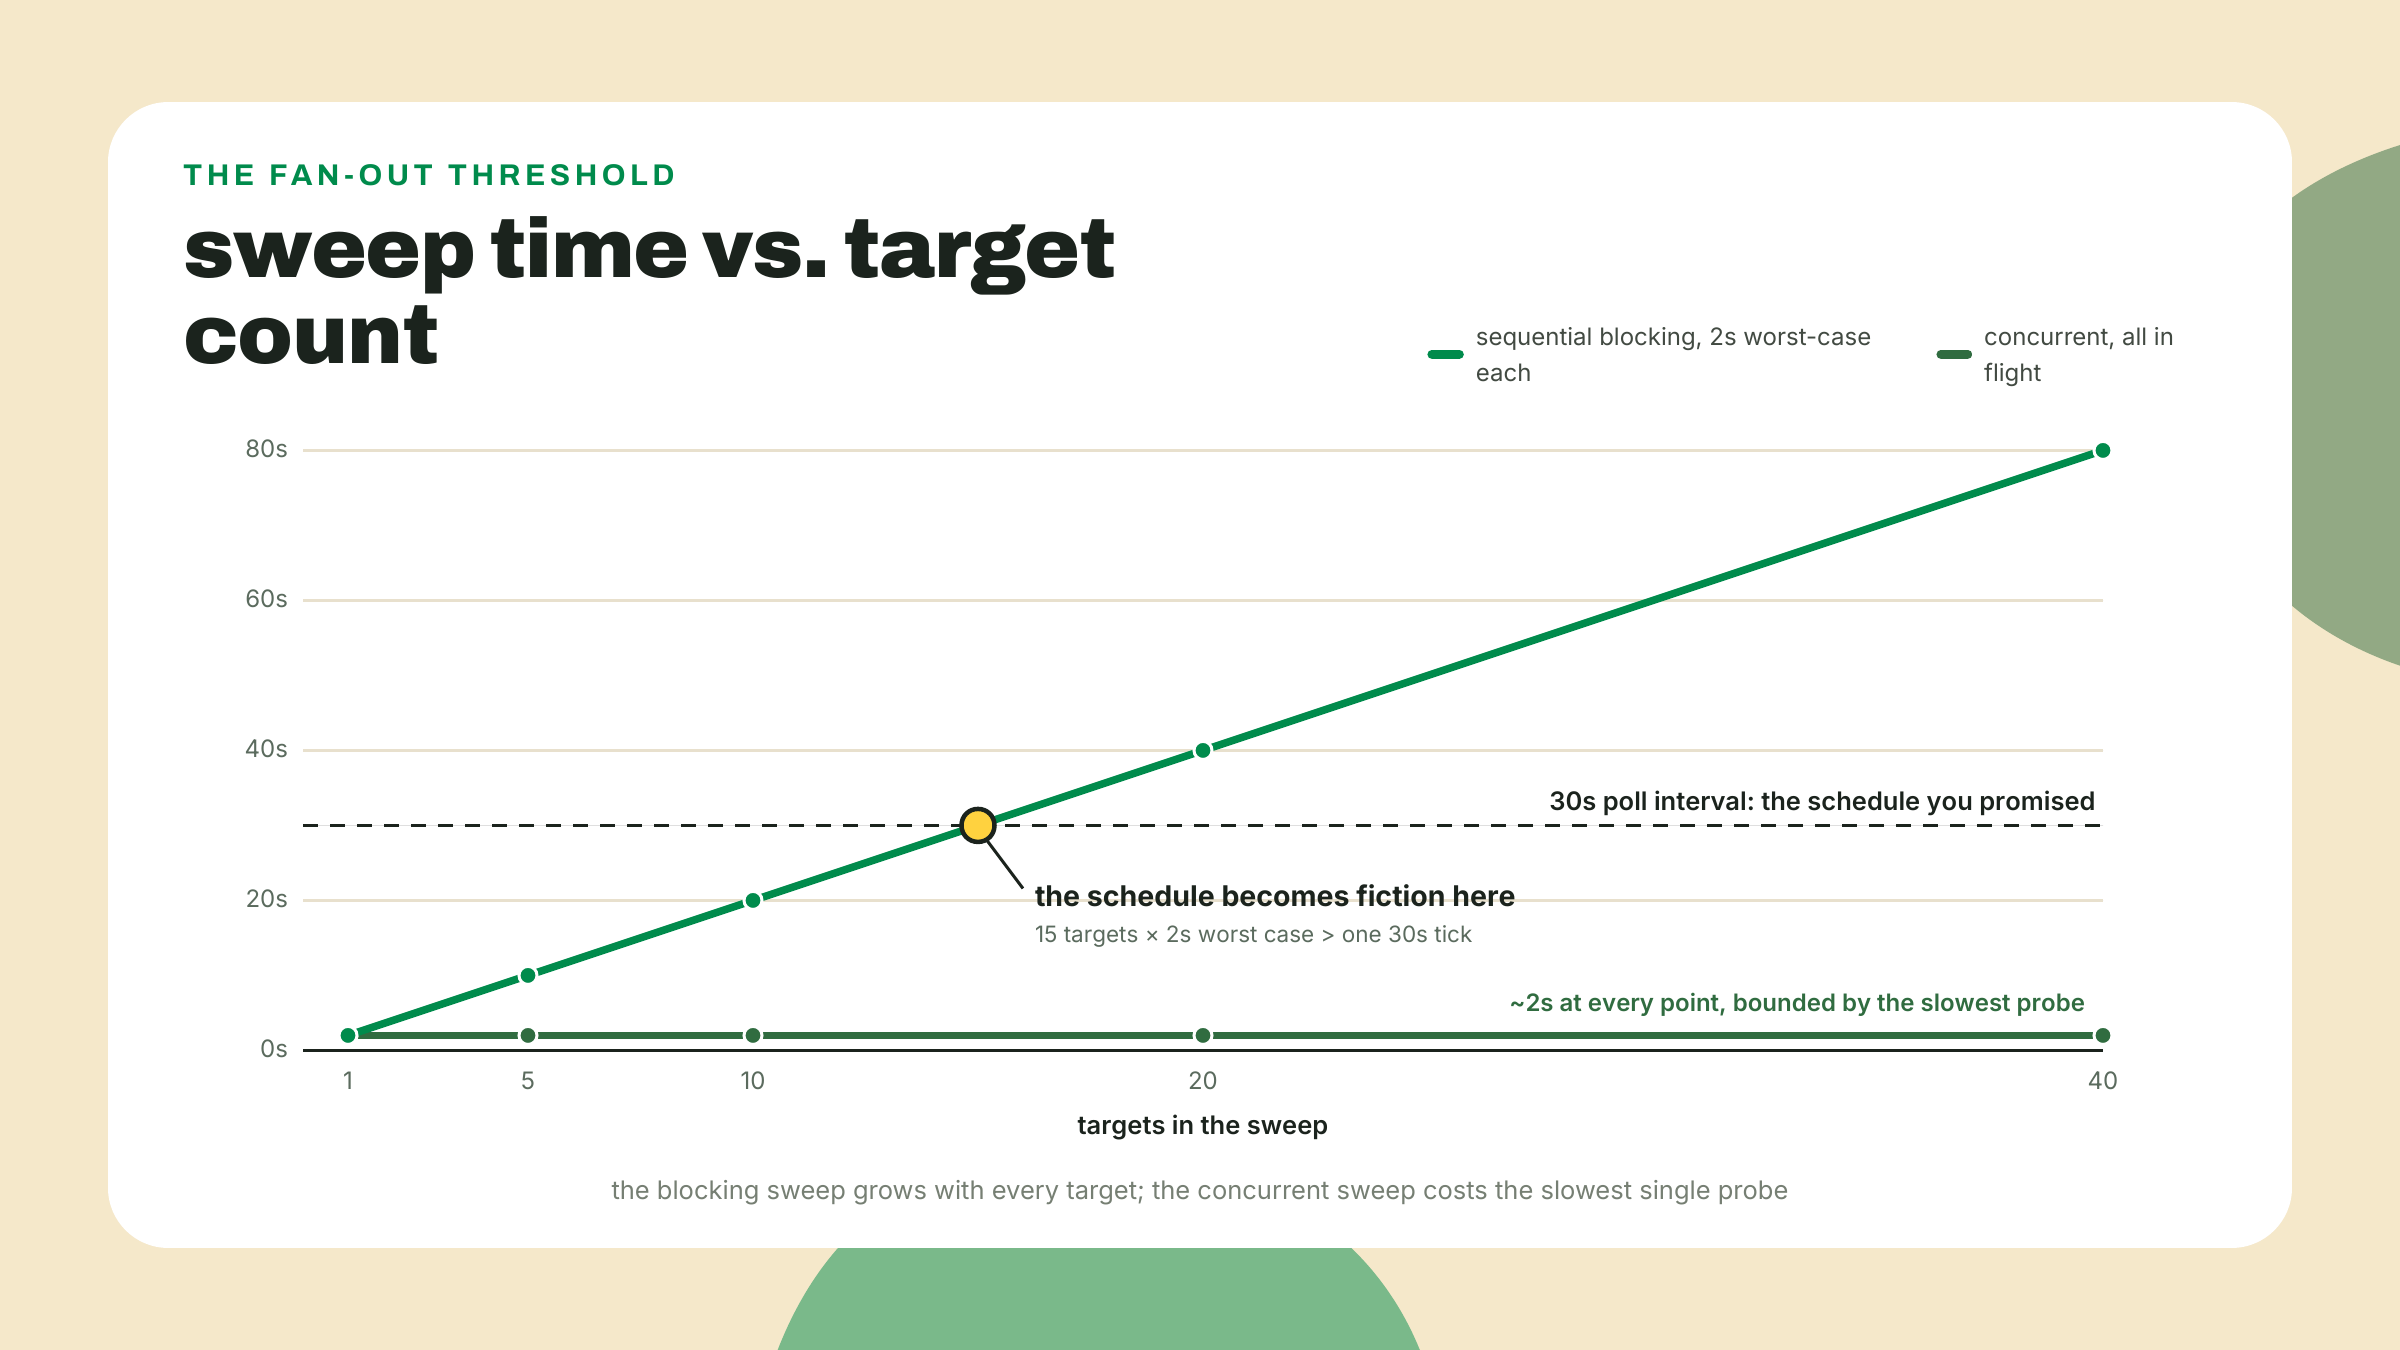
Aqui é onde o sequenciamento do curso te paga de volta. Você conheceu o reqwest em m05-l3 vestindo a feature blocking dele, precisamente para que a jogada de hoje fosse um diff pequeno e visível em vez de um primeiro contato embolado com um runtime. Mesmo crate. O cliente blocking que você usou é um wrapper protegido por uma feature dentro do reqwest; async é a cara default do crate. A migração são três edições.
No Cargo.toml, a feature flag sai:
# m05-l3, in pulse-cli:
reqwest = { version = "0.13", features = ["blocking"] }
# today, in pulse-pollerd:
reqwest = "0.13"
No ponto de chamada, o caminho de módulo perde blocking e as chamadas ganham .await:
// m05-l3, blocking:
let client = reqwest::blocking::Client::new();
let resp = client.get(url).send()?;

// today, async:
let client = reqwest::Client::new();
let resp = client.get(url).send().await?;
E em volta de tudo, um runtime, porque um .await precisa de um escalonador para quem ceder. Essa é a terceira edição e a única genuinamente nova: #[tokio::main] em cima de um async fn main. Vale desmistificar antes de você digitar isso, porque o atributo parece mágica e na verdade é um economizador de digitação. Ele expande para aproximadamente isto:
fn main() {
    tokio::runtime::Builder::new_multi_thread()
        .enable_all()
        .build()
        .expect("failed to build the tokio runtime")
        .block_on(async {
            // the body of your async main goes here
        });
}
Leia isso sem rodeios: construa um escalonador, passe para ele a sua main async como uma task grande só, rode aquela task até o fim. Um async fn em Rust não roda quando você chama ele; chamar ele constrói um valor que descreve o trabalho, e alguma coisa tem que dirigir aquele valor. Na frota TS o motorista era o event loop que o Node iniciou antes de a sua primeira linha executar. Aqui o motorista são cinco linhas de código de builder que você mesmo poderia escrever, e depois que você viu elas, "para onde vai o meu await" para de ser um mistério para sempre. O resto fica inalterado pela migração: o formato da requisição, o tipo de erro alimentando a sua taxonomia thiserror, o status e a latência que você mede. Feature flag fora, .await dentro, runtime em volta. Quando alguém te disser que migrações de Rust async são uma reescrita, este é o seu contraexemplo; quando alguém te disser que elas são de graça, a próxima seção é deles.
Um footgun antes de a gente seguir, porque ele é o clássico: o cliente blocking e o runtime são inimigos. Se você chamar reqwest::blocking de dentro de uma task do tokio, você estaciona uma worker thread inteira do runtime pela duração toda, e as entranhas do próprio cliente blocking brigam com o runtime em cima do qual elas estão sentadas. Você não precisa acreditar na minha palavra; este programa dá panic antes mesmo de tocar a rede:
#[tokio::main]
async fn main() {
    // the footgun: the BLOCKING client inside the tokio runtime
    let resp = reqwest::blocking::get("http://127.0.0.1:9");
    println!("{resp:?}");
}
thread 'main' panicked at .../tokio-1.53.1/src/runtime/blocking/shutdown.rs:51:21:
Cannot drop a runtime in a context where blocking is not allowed. This happens
when a runtime is dropped from within an asynchronous context.
Eu rodei isso nesta máquina para te dar a mensagem textualmente, porque você vai encontrar ela no mundo real mais cedo ou mais tarde e ela nunca diz a palavra reqwest. Dentro do pulse-pollerd, o cliente async, sempre. O cliente blocking fica no pulse-cli, onde ele continua correto.
Hora de nomear o trade-off, porque o tokio não é de graça e este curso não faz almoço grátis. Um runtime async é uma dependência de um escalonador que agora você tem que entender. E a primeira coisa a entender sobre ele é que o escalonamento dele é cooperativo: o runtime só consegue trocar entre tasks em pontos de .await, porque um ponto de suspensão é o único lugar onde uma task devolve o controle. Uma thread pode sofrer preempção do kernel no meio de qualquer coisa; uma task não. Esse único fato de design é de onde vem a classe de bug nova, aquela que não existia na sua CLI blocking: bloquear o runtime. Qualquer trecho síncrono longo dentro de uma task, um parse gigante de JSON, um std::thread::sleep que alguém cola de memória muscular, um mutex com o lock segurado tempo demais, nunca chega num .await, nunca cede, e empaca não só aquela task mas toda task estacionada naquela worker thread. O kernel teria te salvado; o tokio, por design, não vai. Os seus stack traces pioram também: um panic agora aflora através de camadas de encanamento do runtime, e a função que logicamente causou ele pode estar a três pontos de suspensão de distância do frame que mostra ele. Estes são custos de verdade pagos por times de verdade toda semana.
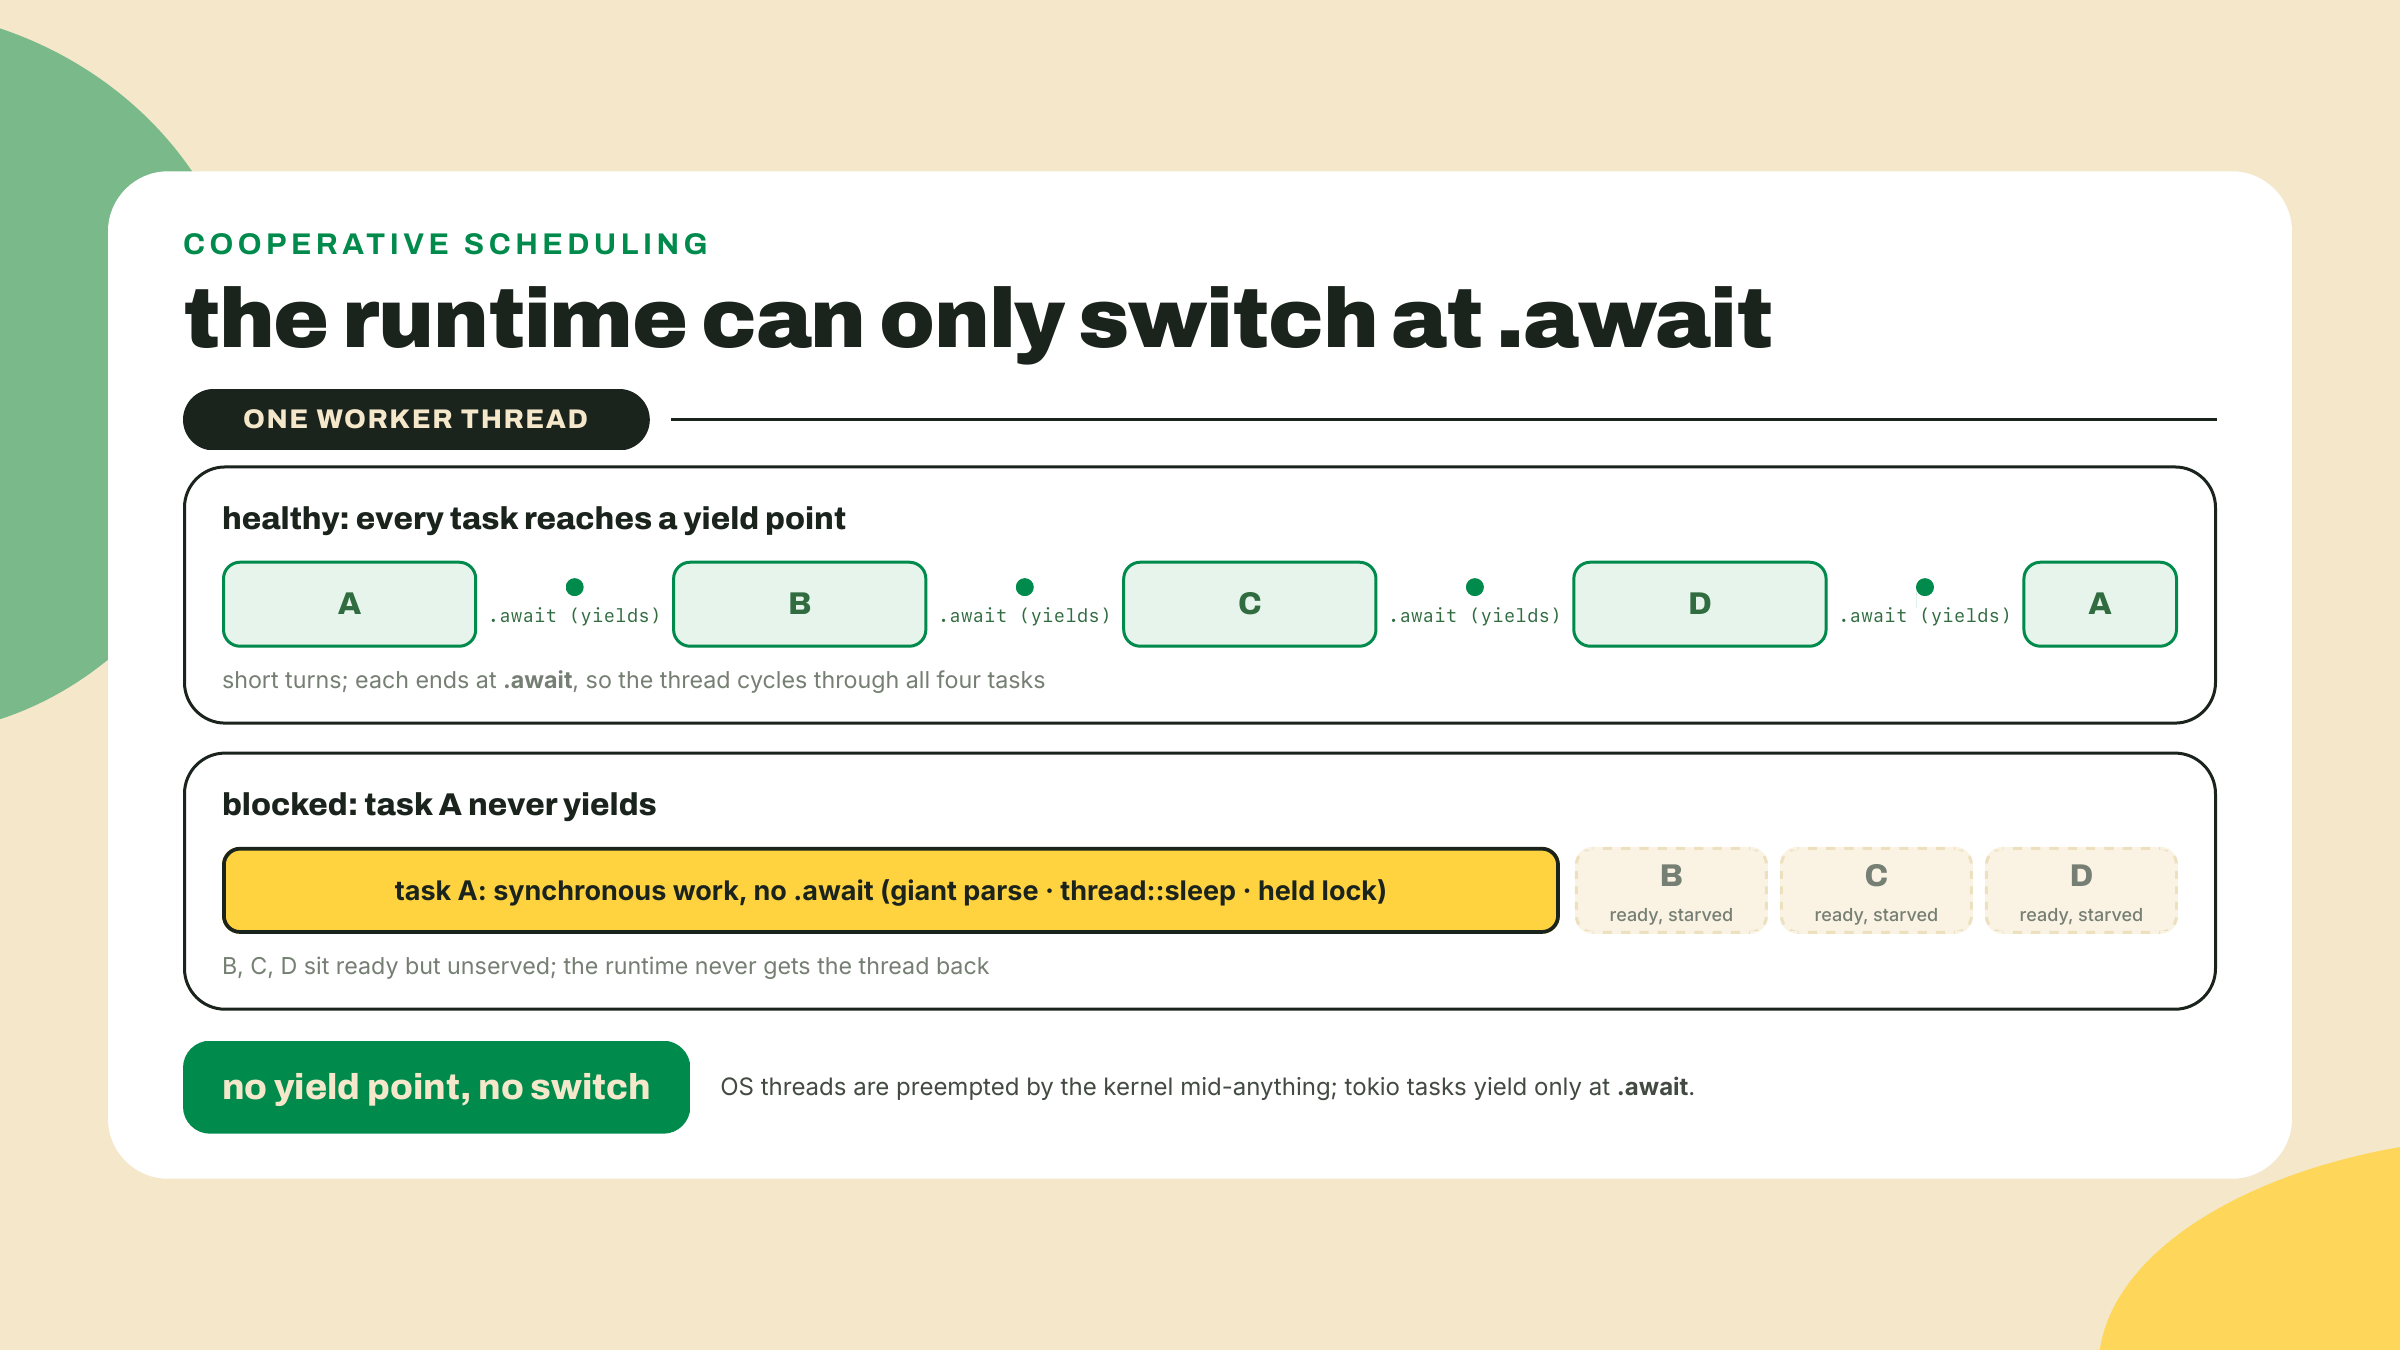
Então a regra de decisão, e eu vou colocar ela do jeito mais direto que eu consigo. Um punhado de tasks, quase todas esperando, sem fan-out: uma thread simples ou uma chamada blocking é o tamanho certo honesto, e correr atrás do tokio aí é engenharia movida a currículo. Trabalho I/O-bound com fan-out de verdade, muitos sockets em voo num agendamento: o runtime ganha a complexidade dele, e nada mais escala além disso. A CLI de tiro único fica do primeiro lado. Um poller de 40 alvos fica do segundo. Mesma base de código, as duas respostas certas, uma camada de distância.
Este é um debate vivo na engenharia de 2026 em geral, não paroquialismo de Rust. Em 2025-11-19, o Prisma 7 apagou o query engine em Rust dele em favor de um compilador de queries em TypeScript, na mesma temporada em que o próprio compilador do TypeScript estava sendo portado para Go por um speedup de build de aproximadamente 10x. Dois projetos emblemáticos cruzando a ponte das linguagens em direções opostas, e os dois estavam certos, porque "qual linguagem" nunca foi a pergunta. Ferramenta certa para a camada era. A nossa regra de tokio-quando-você-tem-fan-out, thread-quando-não-tem é a mesma disciplina uma camada abaixo.
Já que estou sendo honesto sobre dimensionamento: o axum, o crate de servidor HTTP que esta lição usa para dar ao daemon a única porta JSON dele, é o nosso tamanho certo, não o default do ecossistema. Examine o encanamento da infraestrutura Solana de verdade e o gRPC via tonic domina; de cinco repos Rust adjacentes à Solana que a gente examinou, quatro falam tonic, e o axum aparece em dois. Para um curso de fundamentos que precisa de uma porta JSON em que você consegue dar curl, o axum 0.8 é a escolha honesta correta, e quando você mais tarde ler o fonte de um indexador e encontrar tonic onde esperava axum, você vai saber que é a vizinhança, não um erro. Esse encanamento de dados em streaming é território de infraestrutura mais fundo do que este curso vai; quando o fonte de um indexador te mandar para lá, a documentação do próprio tonic é a porta. Mesma honestidade sobre observabilidade: println! é onde a gente está, tracing é a resposta adulta, e ele fica como bookmark até o m09-l2 fazer logging direito.
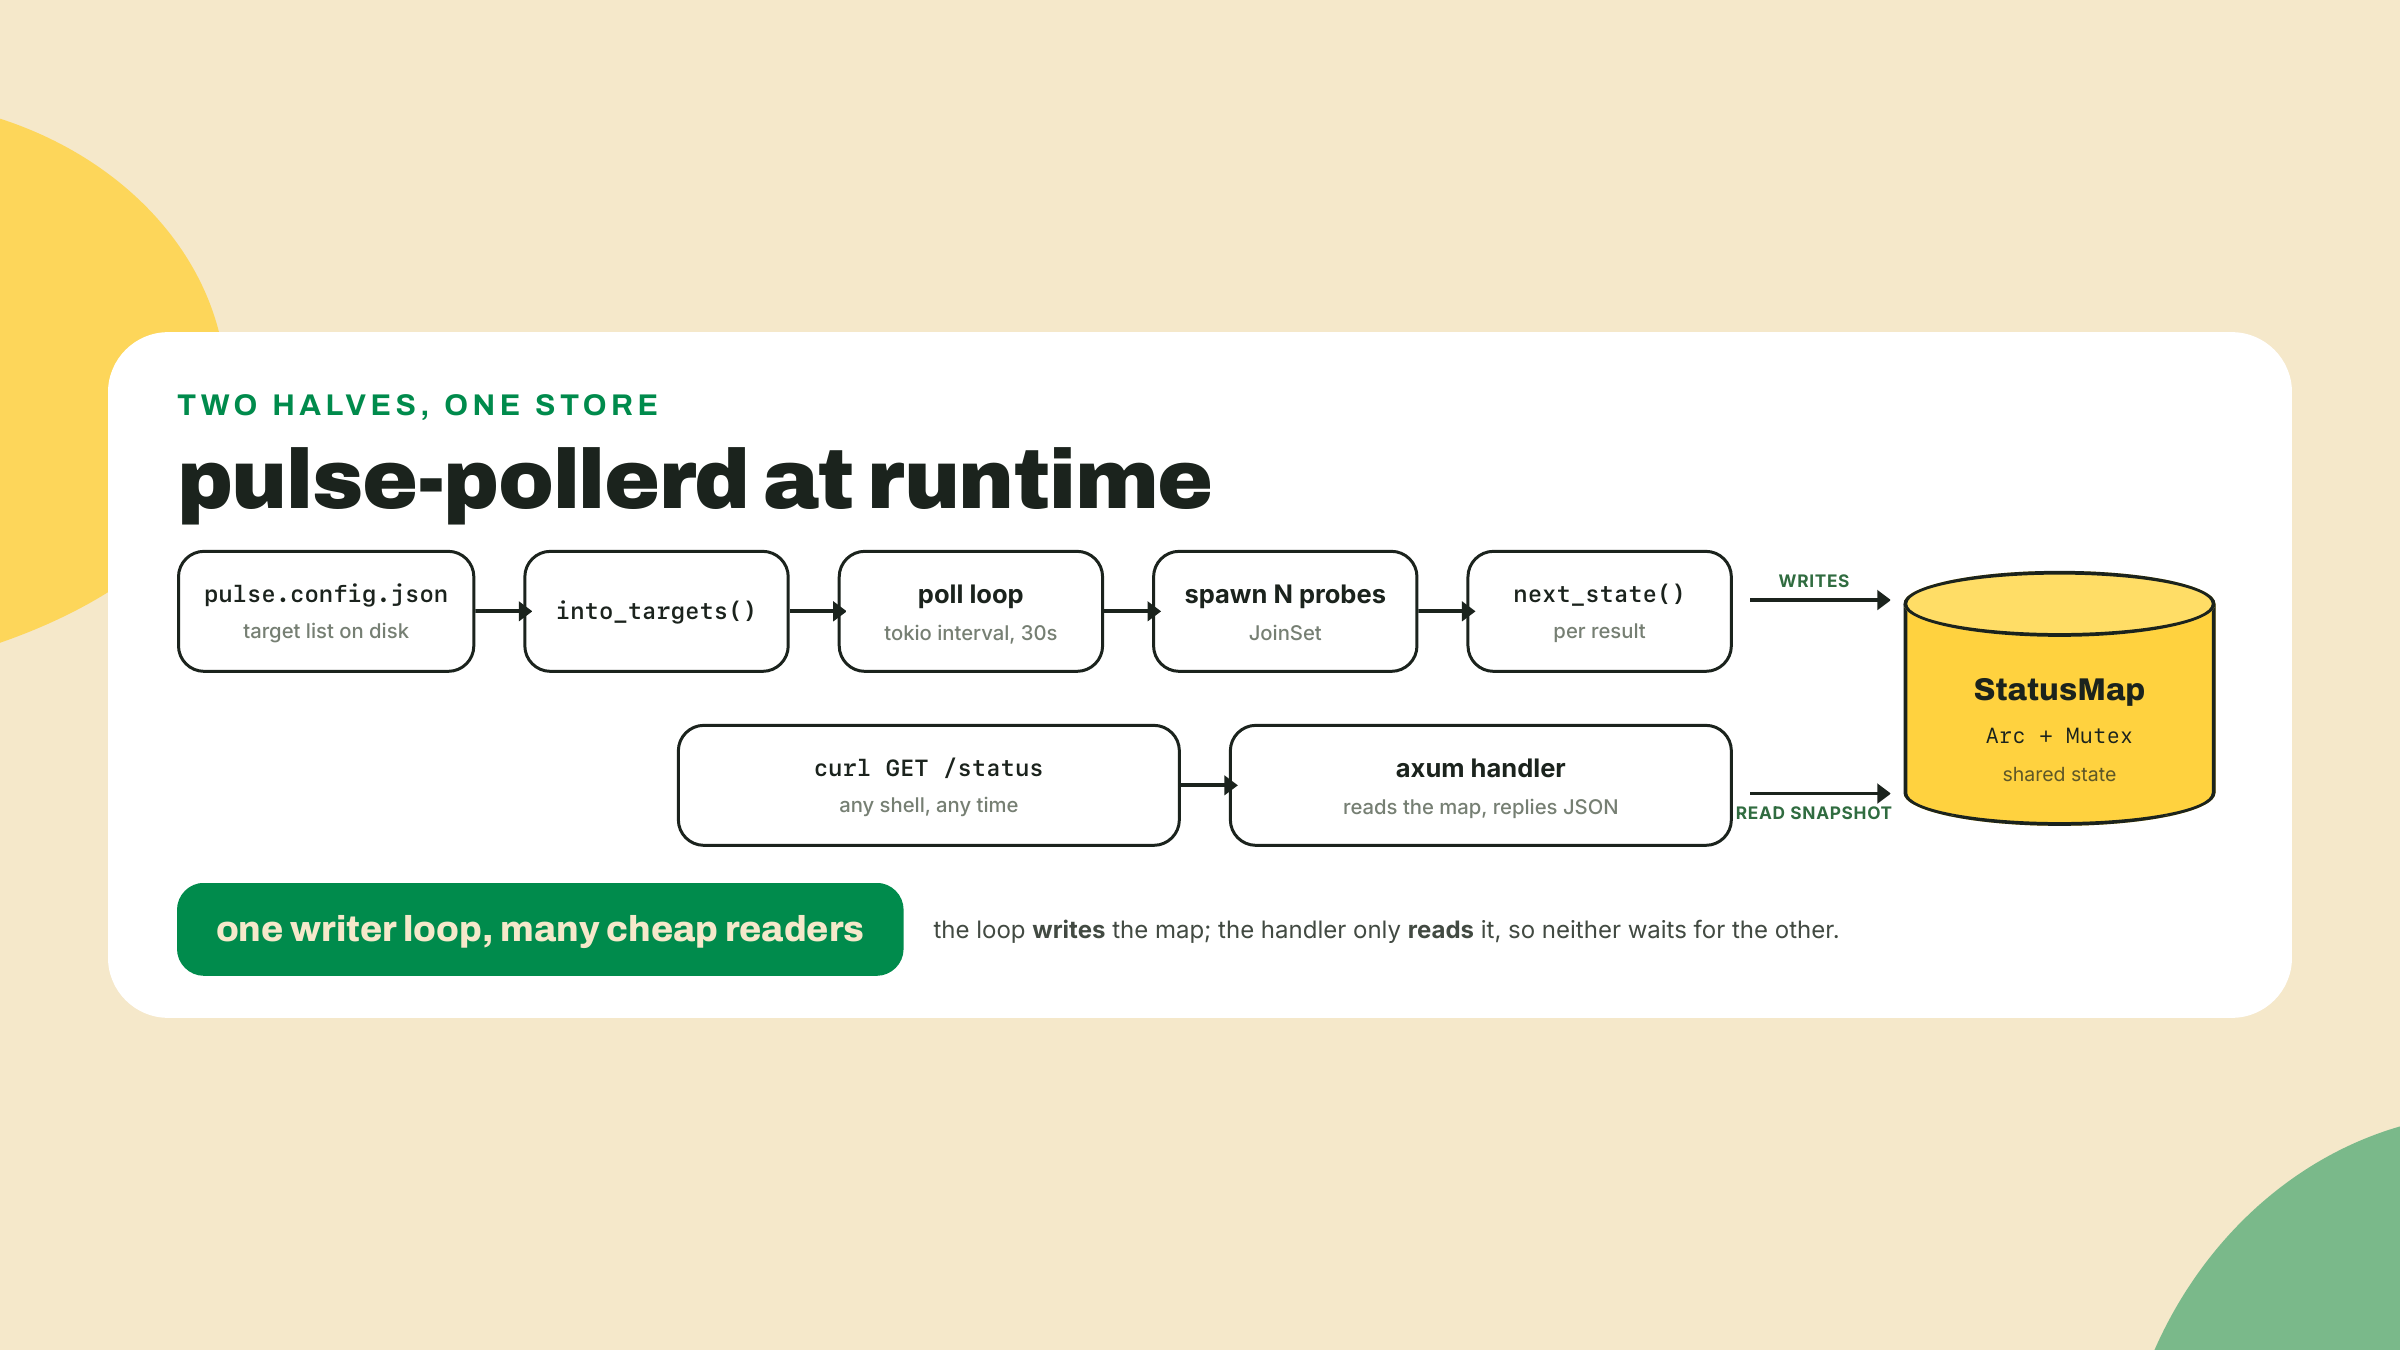
Um serviço, sintetizado até o formato verdadeiro dele, é só isto: um loop, mais uma pergunta respondível. O loop é o poll; a pergunta é /status. Todo orquestrador, todo balanceador de carga, toda página de uptime que você já viu é este padrão vestindo camadas. Construa a versão pelada uma vez e as camadas param de ser mágica.
Vá mais fundo (os 20%). esta lição ensina tokio no nível de saber-quando-você-precisa: o que um runtime compra para um sondador I/O-bound, o delta de blocking para async, e um poll loop honesto. Como futures de fato funcionam por baixo do capô, Pin, executores, streams, select!, e os padrões de concorrência mais fundos moram no capítulo de async do Book, que agora cobre async nativamente: https://doc.rust-lang.org/book/ch17-00-async-await.html (URL checada em 2026-09-02). Salve como bookmark, leia depois deste módulo. O lab abaixo não precisa de nada do material que ficou como bookmark.
O plano, para você ver o painel inteiro antes do primeiro comando: um crate binário novo entra no workspace, depende do pulse-engine, roda um loop de interval do tokio que sonda todo alvo do pulse.config.json, guarda o ProbeState mais recente por alvo em memória compartilhada, e serve ele na porta 8080.
Faça o workspace crescer. Da raiz do workspace:
cargo new crates/pulse-pollerd
Adicione o membro ao Cargo.toml da raiz ao lado dos dois crates do m05-l2:
[workspace]
resolver = "3"
members = ["crates/pulse-engine", "crates/pulse-cli", "crates/pulse-pollerd"]
Aí o manifest do crate novo. Este é mais um dos momentos de construir-sobre-o-que-você-já-tem do curso aterrissando: um segundo binário consumindo o mesmo motor puro, que é a razão inteira pela qual o m05-l2 fez você dividir o workspace. O investimento em pureza começa a pagar aluguel hoje.
[package]
name = "pulse-pollerd"
version = "0.1.0"
edition = "2024"

[dependencies]
pulse-engine = { path = "../pulse-engine" }
serde = { workspace = true }
serde_json = { workspace = true }
tokio = { version = "1.53", features = ["macros", "rt-multi-thread", "time", "net"] }
axum = "0.8"
reqwest = "0.13"
Pins checados contra o crates.io em 2026-09-02: tokio 1.53.1, axum 0.8.9, reqwest 0.13.4; a linha 1.x do tokio está estável em semver desde 2020, então os seus dígitos de patch podem estar mais altos e está tudo bem. Repare na linha de features do tokio: depois do m05-l2 você consegue ler ela. A gente opta pelas macros, pelo runtime multi-threaded, pelos timers e pelo TCP, em vez da feature full com pia da cozinha e tudo, porque agora você sabe o que uma feature flag custa e compra. Só o daemon paga pelo tokio; o motor e a CLI ficam exatamente como estavam.
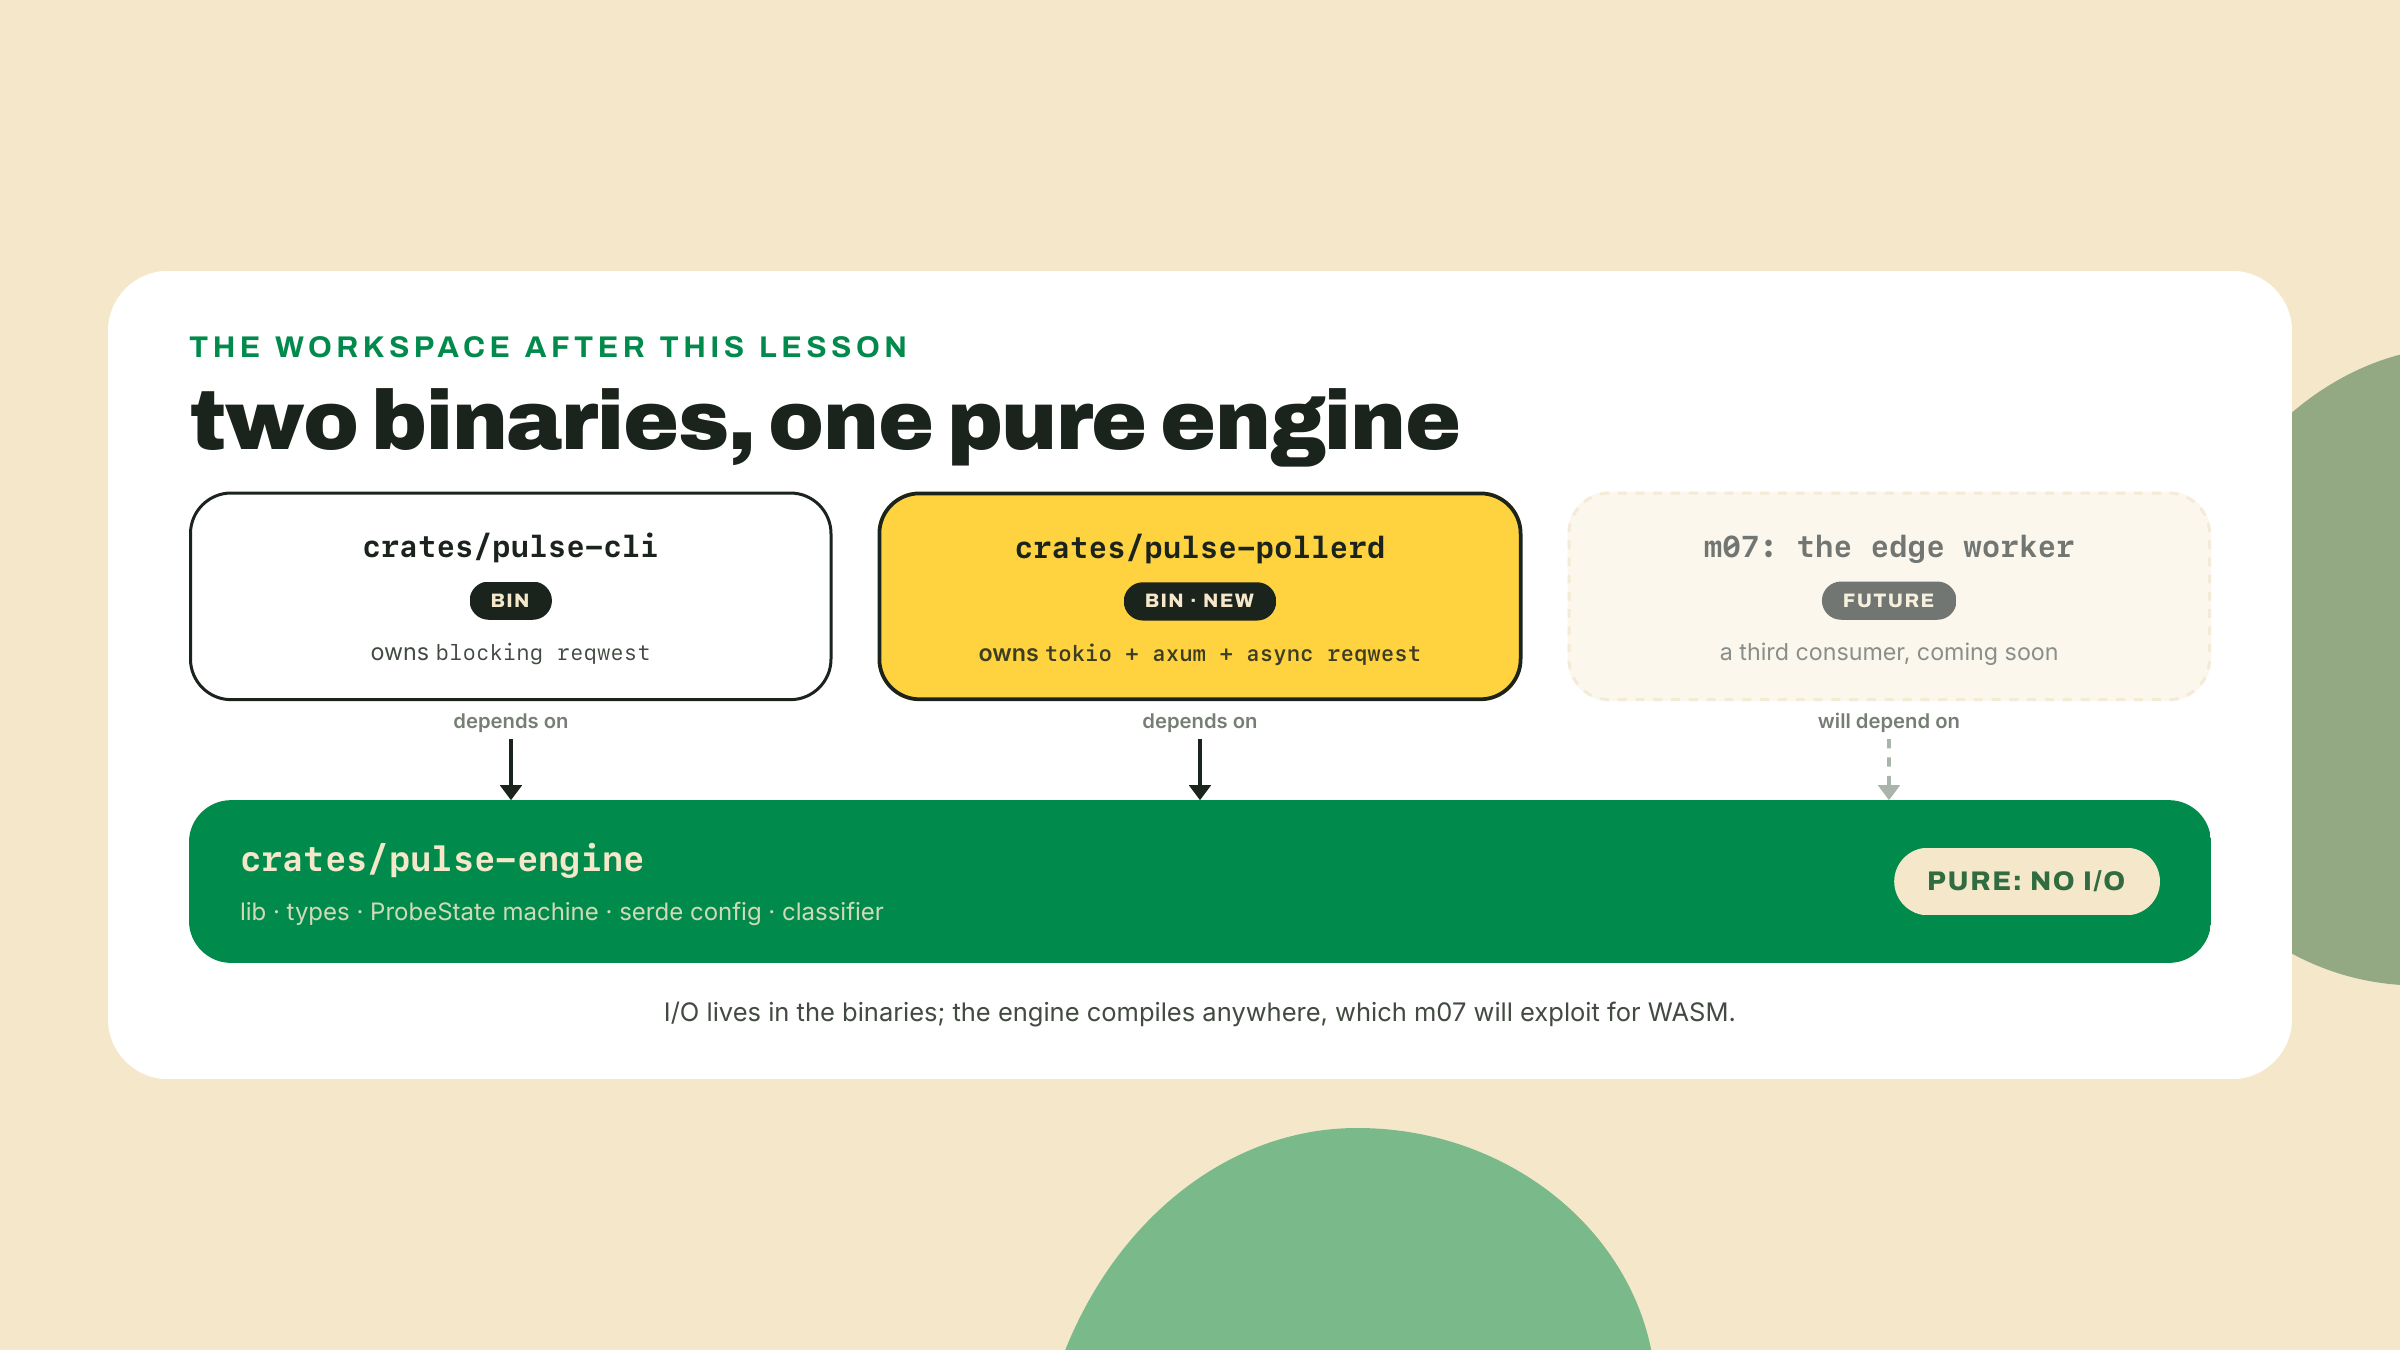
Promova o seu pipeline de config. O daemon precisa de config-para-alvos, e o pipeline de filter-map que você escreveu em m05-l1 no momento não tem casa: a reescrita com clap do m05-l3 substituiu a main do pulse-cli por inteiro, e o pipeline foi junto. Reconstrua ele onde ele deveria ter morado esse tempo todo, no motor, como um método em Config, para que todo binário presente e futuro compartilhe uma definição só. Ele vai em crates/pulse-engine/src/config.rs, ao lado das structs que ele transforma (não no lib.rs, que é o shim de re-export de cinco linhas e não guarda lógica nenhuma):
// crates/pulse-engine/src/config.rs
impl Config {
    pub fn into_targets(self) -> Vec<ProbeTarget> {
        self.targets
            .iter()
            .filter(|t| t.enabled)
            .map(|t| t.to_probe_target())
            .collect()
    }
}
Essa é a cadeia do m05-l1, textualmente, um método mais fundo. Rode cargo test --workspace, verde. É assim que um refactor de workspace deveria parecer.
Uma linha de derive. A resposta de /status serializa ProbeState para JSON, e o serde já é uma dependência do motor, então adicione o derive no enum de estado dentro do motor, que agora deve ler #[derive(Debug, Clone, Copy, PartialEq, Eq, serde::Serialize)]. O caminho serde:: está fazendo um trabalho silencioso: o engine.rs não tem linha use serde::Serialize; (o módulo de config importa ele, este módulo nunca precisou), então o token Serialize pelado seria um erro de macro-de-derive-não-encontrada; a forma totalmente qualificada não precisa de import. Uma linha, nenhuma dep nova, e uma auditoria já que você está por aqui: o Clone e o Copy que o seu enum do m04-l3 carrega desde o nascimento são estruturais hoje, porque o esqueleto do passo 4 copia estados para fora do mapa compartilhado (map.get(&name).map(|s| s.state)) e deriva Clone numa struct que segura um. Se a sua lista de derive um dia descolou daquele cânone, restaure os dois agora, ou o passo 4 te recebe com E0507s que a moldura de "uma linha" não prometeu.
O poll loop: a sua única coisa difícil autorada. Nomeada no resumo, entregue aqui como um esqueleto de completion. Dois buracos. Todo o resto neste arquivo é dado, porque a ideia difícil é o formato do loop, não o encanamento dele. Substitua o pulse-pollerd/src/main.rs por:
use std::collections::HashMap;
use std::sync::{Arc, Mutex};
use std::time::{Duration, Instant, SystemTime, UNIX_EPOCH};

use pulse_engine::{Config, ProbeState, ProbeTarget, next_state, parse_config};
use serde::Serialize;
use tokio::task::JoinSet;

const POLL_INTERVAL_SECS: u64 = 30;

#[derive(Clone, Serialize)]
struct TargetStatus {
    state: ProbeState,
    latency_ms: u64,
    last_poll: u64,
}

type StatusMap = Arc<Mutex<HashMap<String, TargetStatus>>>;

async fn poll_loop(targets: Vec<ProbeTarget>, statuses: StatusMap) {
    let client = reqwest::Client::new();
    let mut ticker = tokio::time::interval(Duration::from_secs(POLL_INTERVAL_SECS));
    // consecutive failures per target: the third argument your m04-l3 machine demands
    let mut failures: HashMap<String, u32> = HashMap::new();

    loop {
        // TODO(1): wait for the next tick of `ticker`.

        let mut probes = JoinSet::new();
        for target in &targets {
            let client = client.clone();
            let name = target.name.clone();
            let url = target.endpoint.clone();
            let timeout = Duration::from_millis(target.budget_ms);
            probes.spawn(async move {
                let started = Instant::now();
                let ok = matches!(
                    client.get(&url).timeout(timeout).send().await,
                    Ok(resp) if resp.status().is_success()
                );
                (name, ok, started.elapsed().as_millis() as u64)
            });
        }

        while let Some(joined) = probes.join_next().await {
            let Ok((name, ok, latency_ms)) = joined else {
                continue; // a probe task panicked; skip it, keep draining
            };
            let count = failures.entry(name.clone()).or_insert(0);
            *count = if ok { 0 } else { *count + 1 };
            let count = *count;
            let now = SystemTime::now()
                .duration_since(UNIX_EPOCH)
                .expect("system clock is set before 1970")
                .as_secs();
            let mut map = statuses.lock().expect("status lock poisoned");
            let prev = map
                .get(&name)
                .map(|s| s.state)
                .unwrap_or(ProbeState::Pending);
            // TODO(2): insert the fresh TargetStatus for `name` into `map`,
            // running `prev`, `ok`, and `count` through the engine's next_state.
        }
    }
}
Percorra ele antes de preencher, porque o formato é a lição. O tokio::time::interval dá um ticker que dispara no agendamento, e ele é a ferramenta certa em vez da alternativa tentadora, dormir 30 segundos no fim do loop, por duas razões que você consegue verificar: o primeiro tick dispara imediatamente, então o seu daemon sonda no boot em vez de encarar a parede por meio minuto, e o interval mede de tick a tick em vez de do fim-do-trabalho, então dois segundos de sondagem não esticam caladinho o seu período para 32. O TODO(1) é genuinamente uma linha, dar await naquele tick, e o ponto de fazer você escrever ele é que você sinta onde o loop respira.
Aí o bloco de spawn: a sonda de todo alvo vira uma task num JoinSet, e spawn quer dizer exatamente o que queria dizer conceitualmente na seção de teoria, passe este future para o runtime e deixe ele rodar concorrentemente com todo o resto. Todas as 40 entram em voo antes de você dar await em qualquer uma delas. Este é o conserto para o footgun que morde o primeiro poll loop de quase todo mundo, dar await nas sondas uma de cada vez dentro do for, que compila numa boa, roda numa boa em três alvos, e caladinho reconstrói a varredura sequencial de 80 segundos cuja aritmética você fez antes, só que com passos a mais. Dê spawn em todas, depois drene o set com join_next conforme os resultados chegam, na ordem que a rede decidir. O tick te custa a sonda única mais lenta em vez da soma.
E leia a drenagem com atenção, porque o join_next te passa um Result e isso não é cerimônia. Uma task que recebeu spawn é uma unidade de falha separada: se o corpo dela dá panic, o panic é capturado pelo runtime e volta para você aqui como um Err, em vez de derrubar o daemon. O corpo da nossa sonda não tem como dar panic realisticamente, não existe unwrap nele, mas o let ... else { continue } (leia como desestrutura-ou-pula) é a postura de nível daemon de qualquer jeito: uma sonda envenenada deveria te custar um ponto de dado, nunca o resto do tick. Um monitor que morre da coisa que ele estava monitorando é uma piada ruim.
O TODO(2) é a escrita de estado: construa um TargetStatus a partir de next_state(prev, ok, count), da latência medida e de now, e insira ele sob name. A sua máquina de estados do m04-l3, alimentada por resultados de rede de verdade enfim, e alimentada diretamente: um loop que já é dono de cada resultado simplesmente passa ele para next_state, sem trait nenhum no meio. O trait ProbeSource daquela lição não está sendo deixado para trás, ele está sendo quitado no passo 7, um crate ao lado, onde o plugue ao vivo que o m04-l3 prometeu finalmente entra. O mapa failures acima do loop existe porque a assinatura daquela máquina exige o terceiro argumento dela: o next_state só deixa Degraded cair para Down quando a contagem de falhas consecutivas passa do limiar, então o loop tem que lembrar a contagem entre ticks, zerada no sucesso, incrementada na falha. Repare também no estado anterior caindo para Pending por padrão para um alvo que o mapa nunca viu; primeiro poll depois do boot, tudo é Pending até a evidência chegar, que é a resposta honesta.
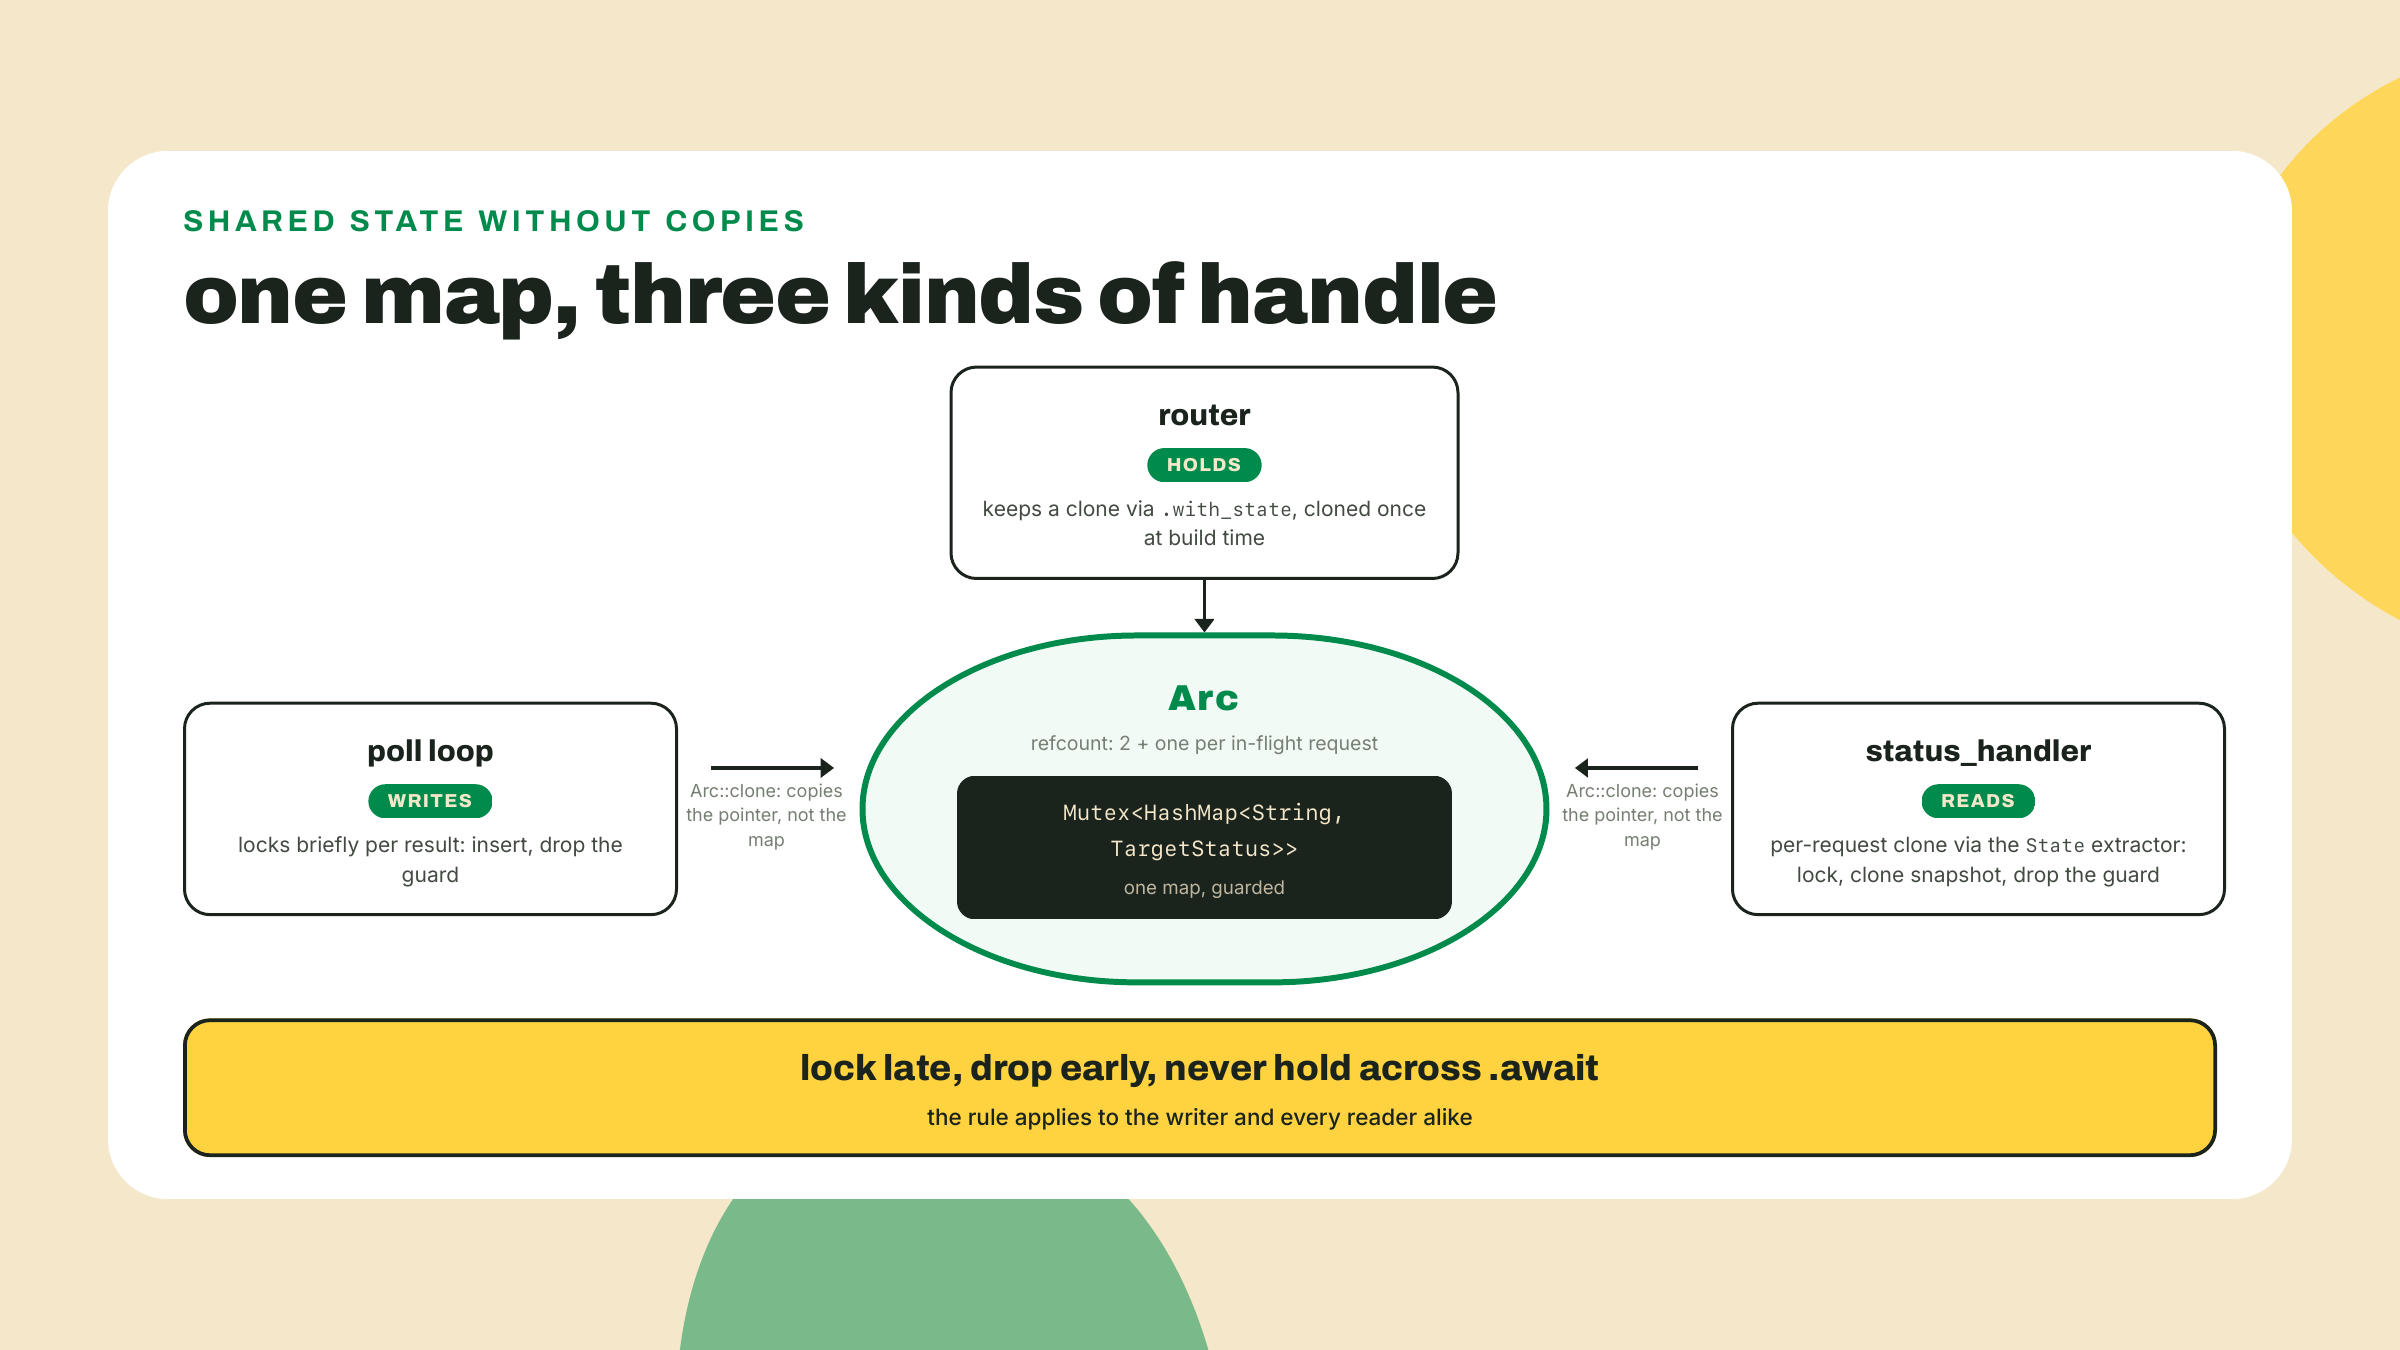
E olhe com atenção para as duas linhas em volta do lock. O mutex aqui é o std::sync::Mutex, o simples, e a seção crítica é minúscula: dá lock, lê o estado antigo, insere, e a trava é solta no fim da iteração. Não existe .await entre o lock e o unlock. Isso não é acidente, é a regra: segure um lock do std através de um .await e a task pode ser estacionada no meio da seção crítica enquanto outras tasks na mesma thread tentam pegar o mesmo lock. No melhor caso contenção, no pior caso deadlock. Lock tarde, solte cedo, nunca dê await segurando. Diga isso uma vez em voz alta; isso vai te poupar uma noite dentro do ano.
A porta /status: um drop-in resolvido. Aqui está a regressão anunciada no resumo, e aqui está por que ela existe. Servidores HTTP são um pico: roteamento, extractors, injeção de estado, binding gracioso, cada um com a sua própria toca de coelho, e nenhum deles é a briga deste curso. No Rust de produção você vai encontrar servidores quase sempre como coisas que você estende, não coisas que você autora a partir de um arquivo em branco. Então o endpoint chega totalmente resolvido e anotado, você lê cada linha, e a sua costura de edição são exatamente dois lugares: o estado compartilhado e o formato do JSON. Anexe ao main.rs:
use axum::{Json, Router, extract::State, routing::get};

async fn status_handler(State(statuses): State<StatusMap>) -> Json<HashMap<String, TargetStatus>> {
    // Lock, clone a snapshot, unlock. The response is built AFTER the guard drops.
    let snapshot = statuses.lock().expect("status lock poisoned").clone();
    Json(snapshot)
}

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let raw = std::fs::read_to_string("pulse.config.json")?;
    let config: Config = parse_config(&raw)?; // m05-l3's parked promise, called at last
    let targets = config.into_targets();

    let statuses: StatusMap = Arc::new(Mutex::new(HashMap::new()));

    // The loop gets its own handle on the state...
    let poller_state = Arc::clone(&statuses);
    tokio::spawn(async move {
        poll_loop(targets, poller_state).await;
    });

    // ...and the router gets another. Clones of the Arc, one shared map underneath.
    let app = Router::new()
        .route("/status", get(status_handler))
        .with_state(Arc::clone(&statuses));

    let listener = tokio::net::TcpListener::bind("0.0.0.0:8080").await?;
    println!("pulse-pollerd listening on http://localhost:8080/status");
    axum::serve(listener, app).await?;
    Ok(())
}
A única ideia de verdade neste drop-in é o compartilhamento. Arc é um ponteiro com contagem de referências: clonar ele copia o ponteiro e incrementa um contador, não o mapa. O poll loop é dono de um clone, o router é dono de outro via .with_state, e o axum passa ao handler um clone barato por requisição através daquele extractor State na assinatura. Um mapa, muitos donos, e o Mutex lá dentro arbitra as escritas. Olhe as duas chamadas Arc::clone na main: se você der move no original para dentro do loop que recebeu spawn em vez de clonar, o router não sobra nada para segurar, e o compilador vai te dizer isso na voz E0382 dele que você conhece de m04-l1. O handler em si tem quatro linhas e o comentário é estrutural: snapshot sob o lock, serialize fora dele, para que um cliente lento baixando JSON nunca segure o seu poll loop como refém. Repare também no que o handler não faz: ele não sonda. O loop é dono de produzir estado; a porta só reporta ele. Um endpoint que re-sondasse sob demanda martelaria os seus alvos toda vez que alguém desse curl, e deixaria /status tão lento quanto uma varredura.
O seu único TODO neste drop-in é uma edição de formato para você ter tocado a costura: a resposta no momento devolve o que quer que TargetStatus serialize. Confirme que last_poll está no JSON, e renomeie ou remodele um campo a gosto, talvez latency_ms para latencyMs com um rename_all do serde, o seu músculo de atributos do m05-l1. O formato do JSON é seu para ser dono; o encanamento não é, ainda.
Rode ele e bata na porta. Da raiz do workspace, com o pulse.config.json presente:
cargo run -p pulse-pollerd
O daemon imprime a linha de listening dele e aí parece não fazer nada, que é como um daemon se parece visto de fora. De um segundo terminal, bata duas vezes, com um intervalo de poll entre elas:
curl -s http://localhost:8080/status
sleep 30
curl -s http://localhost:8080/status
A primeira resposta se parece com isto, com os seus nomes de alvo e números honestos onde os meus são placeholders:
{
  "docs": { "state": "Up", "latency_ms": 143, "last_poll": 1788350402 },
  "api": { "state": "Down", "latency_ms": 611, "last_poll": 1788350402 }
}
Todo alvo HABILITADO da sua config está presente, cada um com um estado que a sua máquina do m04-l3 atribuiu a partir de um resultado de rede de verdade, uma latência medida, e um timestamp last_poll em segundos unix. Conte as chaves contra a config antes de seguir: a config da estação carrega três alvos, e a entrada tcp rpc desabilitada está legitimamente ausente, porque into_targets filtra por enabled antes de o loop sequer ver ela. Dois de três no JSON é o pipeline funcionando, não um bug. O estado exato em que um alvo que falha aterrissa depende de para onde a sua tabela de transição roteia uma falha a partir do estado anterior dela, que é assunto da sua máquina, não do poller; o poller só reporta o veredito. A segunda resposta mostra os mesmos alvos com last_poll avançado em aproximadamente 30 segundos, e essa palavra aproximadamente é honesta, porque timers dão tick quando o escalonador chega neles, então espere um segundo ou algo assim de desvio em vez de precisão de metrônomo. Esse timestamp avançando é a sua prova de vida: o loop sondou enquanto ninguém estava olhando, que é a descrição inteira do cargo. Este par de saídas, tirado com um intervalo de distância e mostrando o timestamp avançar com estados por alvo populados para todo alvo na config, é a trava da lição. Guarde as duas.
Mais uma expectativa ajustada de propósito, e ela é mais afiada que "estaca zero": mate o daemon, reinicie ele, e dê curl em /status antes de o primeiro tick terminar. Você não recebe todo alvo em Pending. Você recebe {}, porque o mapa é criado vazio e as únicas escritas acontecem lá embaixo no loop de drenagem. Aí o primeiro tick chega e todo alvo aparece já julgado, Up ou Down, porque a sua tabela do m04-l3 não tem braço que RETORNE Pending: (Pending, true) => Up e (Pending, false) => Down. Pending é a suposição interna do loop sobre um alvo que o mapa nunca viu, não um estado que /status possa algum dia te passar. O estado mora num HashMap na memória do processo. Persistência ainda não é promessa de ninguém, e nada na estação afirmou o contrário; quando o poller merecer uma memória que sobrevive a restarts, essa vai ser a decisão dela com os trade-offs dela.
Cobre a promessa do m04-l3: HTTP ao vivo atrás do trait. Uma promissória do tier de Rust vence nesta lição, e o daemon deliberadamente não é o crate que paga ela. O m04-l3 congelou o trait ProbeSource e prometeu que HTTP ao vivo um dia plugaria atrás dele; o m05-l3 construiu o braço de HTTP como uma chamada isolada e mandou você segurar a coceira. O poller que você acabou de construir também pula o trait, por razões que você agora consegue defender duas vezes: o loop dele já é dono de cada resultado, então ele passa os resultados direto para next_state, e o cliente blocking é banido dentro do runtime dele de qualquer jeito, como o panic no topo desta lição provou. Então o plugue aterrissa um crate ao lado, no pulse-cli, onde blocking é legal e o cliente do m05-l3 já mora. Primeiro dê ao trait um nome público: ele nunca entrou na lista de re-export do m05-l2 porque nenhum consumidor tinha ganhado um lugar para ele, e um acabou de ganhar, então adicione ProbeSource à linha de re-export do lib.rs do motor. Aí estenda o crates/pulse-cli/src/main.rs:
use pulse_engine::{ProbeSource, drive};

struct LiveSource {
    client: reqwest::blocking::Client,
    urls: Vec<String>,
    cursor: usize,
}

impl LiveSource {
    fn new(urls: Vec<String>, timeout_secs: u64) -> Result<Self, ProbeError> {
        let client = reqwest::blocking::Client::builder()
            .timeout(std::time::Duration::from_secs(timeout_secs))
            .build()
            .map_err(|e| ProbeError::Unreachable {
                reason: e.to_string(),
            })?;
        Ok(Self {
            client,
            urls,
            cursor: 0,
        })
    }
}

impl ProbeSource for LiveSource {
    fn next_latency(&mut self) -> Option<u64> {
        let url = self.urls.get(self.cursor)?;
        self.cursor += 1;
        let started = Instant::now();
        match self.client.get(url).send() {
            Ok(_) => Some(started.elapsed().as_millis() as u64),
            // A request that never came back is not the source running dry;
            // it is one infinitely slow sample, and drive's budget check
            // turns it into a failure.
            Err(_) => Some(u64::MAX),
        }
    }
}
Leia o impl contra o FixtureSource do m04-l3 e veja o contrato absorver uma segunda fonte sem uma única edição em drive: mesma assinatura, mesmo Option, só a origem da resposta mudou de um vetor para um socket. O braço Err é a única decisão de design no arquivo: None significaria "fonte esgotada" e terminaria o drive cedo demais, então uma requisição que falha reporta u64::MAX no lugar, uma latência infinita que orçamento nenhum passa. Agora faça do plugue uma superfície entregue em vez de um comentário de código: dê à CLI um terceiro subcomando ao lado de Probe e Report, uma variante Sweep carregando um posicional urls: Vec<String> e um #[arg(long, default_value_t = 1500)] budget: u64, tudo músculo de clap do m05-l3, com este braço de match:
    Command::Sweep { urls, budget } => {
        let mut source = LiveSource::new(urls, 10)?;
        let state = drive(&mut source, budget);
        println!("sweep verdict: {state:?} (alerting: {})", state.is_alerting());
    }
cargo run -p pulse-cli -- sweep https://www.rust-lang.org https://www.typescriptlang.org
# sweep verdict: Up (alerting: false)
Essa linha impressa fecha o loop que o m04-l3 abriu: o trait que passou dois módulos alimentando o drive com fixtures agora alimenta ele com medições ao vivo, o soquete do diagrama daquela lição enfim segura o segundo plugue dele, e toda fronteira que este módulo desenhou ficou onde estava: o daemon mantém o caminho direto dele, a CLI mantém o cliente blocking dela, e o motor continua não contendo I/O nenhum.
O daemon roda, a CLI faz sweep, e o motor no meio está sendo consumido por dois binários ao mesmo tempo. Esse é o momento de cobrar uma promessa: o m04-l2 fez você marcar os itens movidos como pub e disse que privacidade de módulo ganharia o tour próprio dela com o Cargo no M6. Este é aquele tour, e ele esperou até agora de propósito, porque visibilidade só significa alguma coisa quando existe gente de fora, e você acabou de terminar de construir a segunda. Nada abaixo muda a estação; são quinze minutos com o compilador, e você reverte tudo quando terminar.
O default do Rust é privado, e o seu próprio layout já percorre os níveis que importam:
pub mais um re-export no lib.rs: drive, next_state, parse_config, total_latency, a porta da frente curada. Consumidores alcançam estes como nomes pulse_engine:: pelados sem caminho de módulo nenhum à vista, que é o sentido inteiro de curar a lista: a main do poller chama parse_config, o loop dele chama next_state, e a CLI chama total_latency no braço report dela e drive no sweep que você acabou de escrever. parse_config é o que vale reparar, porque ele ficou naquela lista desde o m05-l2 sem ninguém chamar ele: o m05-l3 estacionou a fiação de config da CLI e prometeu que o poller do m06 pegaria a assinatura congelada de volta. O passo 4 é onde aquela promessa venceu, e a porta da frente parou de ser aspiracional.pub sem o re-export: parse_state. Ainda alcançável, no caminho completo pulse_engine::engine::parse_state, que é exatamente a fuçada em caminhos de módulo que a lista de re-export do m05-l2 existe para poupar aos consumidores. Alcançável e anunciado são promessas diferentes.cursor do FixtureSource. Nenhum caminho alcança ele de fora do motor; digite FixtureSource::new(vec![1]).cursor em qualquer lugar do poller e error[E0616]: field `cursor` of struct `FixtureSource` is private é a conversa inteira.Entre esses polos fica pub(crate): visível em todo lugar dentro do crate do motor, invisível para todo consumidor. Prove isso com o compilador em vez de acreditar na minha palavra. Vire o parse_state do motor para pub(crate) fn parse_state, solte let _ = pulse_engine::engine::parse_state("Up"); como a primeira linha da main do poller, e rode cargo check --workspace:
warning: function `parse_state` is never used
 --> crates/pulse-engine/src/engine.rs
  |
  | pub(crate) fn parse_state(raw: &str) -> Option<ProbeState> {
  |               ^^^^^^^^^^^
  |
  = note: `#[warn(dead_code)]` (part of `#[warn(unused)]`) on by default

error[E0603]: function `parse_state` is private
  --> crates/pulse-pollerd/src/main.rs
   |
   |     let _ = pulse_engine::engine::parse_state("Up");
   |                                   ^^^^^^^^^^^ private function
Duas mensagens, e o aviso não é ruído, é o mesmo fato contado de dentro. O motor ainda compila e os testes unitários dele ainda passariam, mas no momento em que parse_state parou de ser alcançável de fora, os únicos chamadores restantes eram os #[cfg(test)], que um cargo check simples não constrói, então o dead_code corretamente reporta uma função que ninguém usa. Isso é estrutural, não um erro no treino: qualquer item pub(crate) cujo único chamador fora de teste morava em outro crate avisa exatamente assim, e o conserto em código de verdade é ou um chamador dentro do crate ou um #[allow(dead_code)] com uma razão escrita. O erro abaixo dele é o de fora sendo recusado, e essa divisão, quieto por dentro, parada dura por fora, é o significado inteiro da configuração. pub(crate) é a marcação honesta para helpers que módulos do motor compartilham mas com os quais nenhum consumidor deveria se acoplar, porque um pub que você não quis dizer é uma API pública que agora você mantém. Reverta as duas edições e rode cargo check --workspace mais uma vez para confirmar que você está de volta ao silêncio; o resíduo do tour é o reflexo, não o código.
Solo, lógica de estado pura, nenhum conceito novo de async: exponha o contador de falhas consecutivas de cada alvo em /status. O loop já acompanha um por alvo, porque o terceiro argumento do next_state exige isso; o que o JSON ainda não mostra é a contagem em si. Adicione um campo em TargetStatus, preencha ele a partir da entrada de failures na vizinhança do TODO(2), e ele pega carona para dentro do JSON de graça, porque derives do serde não ligam para quantos campos você adiciona.
Você não precisa quebrar nada para ver isso funcionar, porque a config da estação já vem com um alvo que não tem como dar certo: api aponta para https://example.org/health, que responde 404, e o poller trava ok em resp.status().is_success(), então api vem falhando a cada tick desde que você subiu o daemon. É por isso que a amostra do passo 6 mostra ele Down. Aceitação: reinicie o daemon para que os contadores comecem do zero (eles moram em failures, um HashMap simples na memória do processo, então um processo novo começa vazio), deixe três ticks passarem, que é cerca de um minuto porque o primeiro tick dispara imediatamente, então dê curl em /status e leia api em 3 enquanto docs fica em 0. Se você preferir dirigir isso você mesmo, aponte uma segunda entrada para uma URL que não tem como dar certo e veja as duas subirem juntas nos mesmos ticks.
Se você quer saber por que um monitor se dá ao trabalho de contar falhas consecutivas em vez de alertar na primeira, leia os dois números lado a lado: docs se mantém em 0 por todo tick porque um alvo saudável zera no sucesso, então um único soluço ali mostraria um 1 e teria sumido no minuto seguinte, que é clima. A contagem subindo do api é o formato da notícia. O contador é o que diferencia esses dois, e é por isso que a tabela do m04-l3 trava a queda para Down em consecutive_failures >= 3 em vez de num único false.
Rode a autochecagem: transforme uma ferramenta de tiro único num daemon e diga com precisão o que o tokio te comprou em cima da versão com thread::sleep que você escreveu primeiro, quarenta esperas estacionadas numa thread só em vez de um cronograma fictício; migre uma chamada blocking do reqwest para async e nomeie o delta inteiro, feature flag fora, .await dentro, runtime em volta, mesmo crate; e defenda as duas direções da decisão de dimensionamento, porque agora você entregou a CLI blocking onde async seria overhead e o poller onde blocking seria mentira.
A recuperação de 30 segundos antes de você fechar o terminal: o que async compra para 40 sondas I/O-bound? (Uma thread só segura todas as 40 esperas, estacionadas e retomadas na conclusão; cada sonda não fica mais rápida.) E a regra do lock, em sete palavras? (Lock tarde, solte cedo, nunca cruzando await.)
Um pedido de calibração, porque esta lição fez duas apostas opostas em você: o poll loop como a sua coisa difícil autorada, o endpoint como um drop-in só de leitura. Se os dois TODOs do loop pareceram finos demais ou o drop-in te deixou com vontade de autorar o servidor você mesmo, diga isso no feedback; o recuo é afinado exatamente por este sinal.
O seu poller agora roda para sempre, mas só na sua máquina, contra o seu OS, a sua glibc, a sua sorte. O binário que o CI construiu em m05-l3 já te ensinou que entregar quer dizer passar software para máquinas que nunca viram o seu fonte. Na próxima lição a gente põe o daemon numa caixa que roda igual em todo lugar, e a gente começa sendo honesto sobre o que um contêiner sequer é. Traga o daemon.
Pergunta 1 de 4