Carregando...

 BetaBeta
m09-l1 auditou a árvore: npm audit e cargo audit rodaram nas duas raízes de workspace, o AUDIT.md aterrissou com vereditos de manter, atualizar, trocar ou aceitar o risco, e os dois lockfiles ganharam uma leitura de filosofia de pin. As dependências da estação agora têm um rastro em papel. Hoje a própria estação ganha um. Você vai fazer o poller emitir eventos de log em JSON estruturado nas fronteiras dele, dar à frota TS e ao edge worker o mesmo formato de evento, aprender a realidade de logs do tier gratuito de cada plataforma como uma restrição de design, ligar o único alarme que dispara quando uma execução agendada falha (e conhecer as três mortes silenciosas que ele estruturalmente não consegue ouvir), e terminar a varredura de segredos de quatro plataformas como uma tabela única. O contrato de recuo, em voz alta: este é o degrau de checklists em vez de passo a passo, o último apoio do curso. O formato de evento é dado uma vez como uma lista de campos, um grep de incidente é trabalhado por inteiro, e a fiação do poller, a fiação do worker, a configuração de notificação e a tabela da varredura são suas para conduzir a partir de checklists em superfícies das quais você já fez ship. Depois desta, m10-l1 te passa uma página em branco e pede a estação inteira de memória.
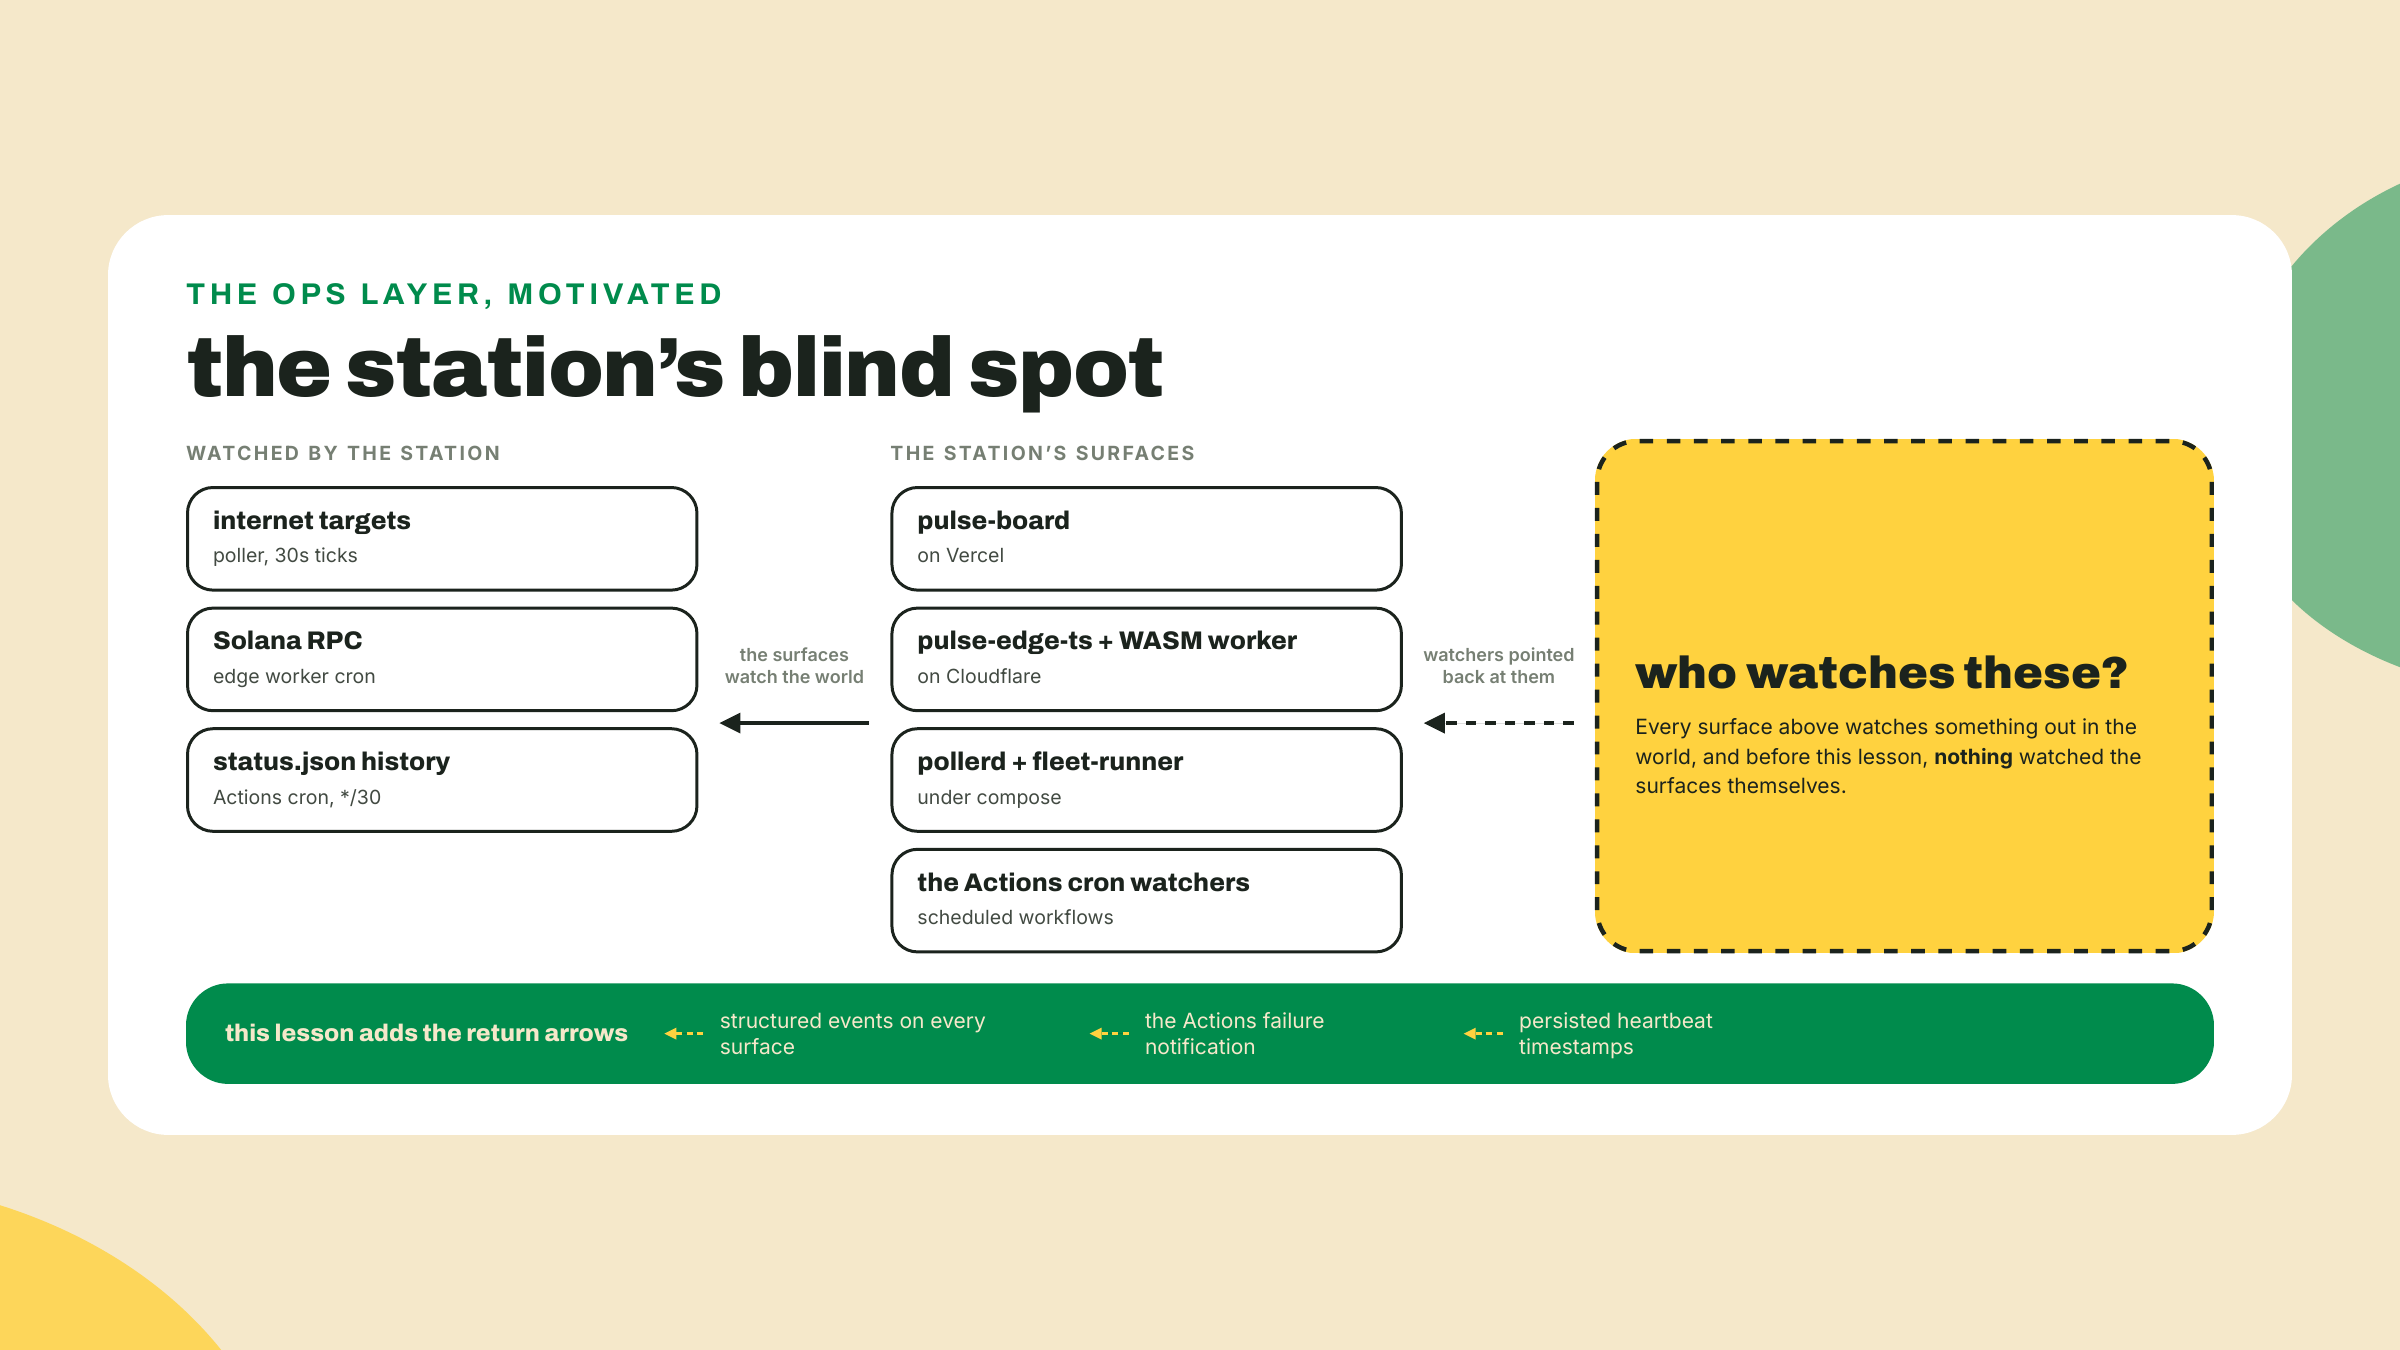
A sua estação vigia um painel no Vercel, dois edge workers, um poller em Docker e uma blockchain. Conte os vigias apontados de volta para ela: zero. Se o poller morrer às 3 da manhã, ou o cron parar de disparar em silêncio, a única testemunha é uma ausência, e ausências não mandam e-mail. O módulo 6 chamou um monitor que você precisa lembrar de invocar de boato com uma linha de comando. Mesma faca, um nível acima: um monitor não observado é só um boato.
Vamos fazer o poller falar primeiro e teorizar depois. Abra crates/pulse-pollerd/src/main.rs e adicione um helper acima de poll_loop (o serde_json já é uma dependência desde m06-l1, nada a instalar):
use serde_json::json;

fn log_event(value: serde_json::Value) {
    println!("{value}");
}
Depois, no drain loop, logo depois do ponto onde now é computado e antes do map.insert que escreve o status do alvo, emita um evento por resultado de sonda:
let outcome = if ok { "up" } else { "down" };
log_event(json!({
    "event": "probe_result",
    "target": name,
    "outcome": outcome,
    "latency_ms": latency_ms,
    "ts": now,
}));
Rode cargo run -p pulse-pollerd, dê a ele um tique de 30 segundos, e veja as linhas cruas aterrissarem no meio do resto da saída. Depois dê Ctrl-C nele (um daemon de cada vez; ele é dono da porta 8080) e rode de novo, filtrado:
cargo run -p pulse-pollerd 2>/dev/null | grep '"event":"probe_result"'
Uma linha JSON por sonda, filtrável por máquina, cada uma carregando quem, o quê, quão rápido e quando. Esse é o truque inteiro desta lição, executado nos primeiros dez minutos. O resto é fazer isso de propósito, em toda superfície, e depois garantir que a morte da própria estação seja pelo menos tão alta quanto a dos alvos dela.
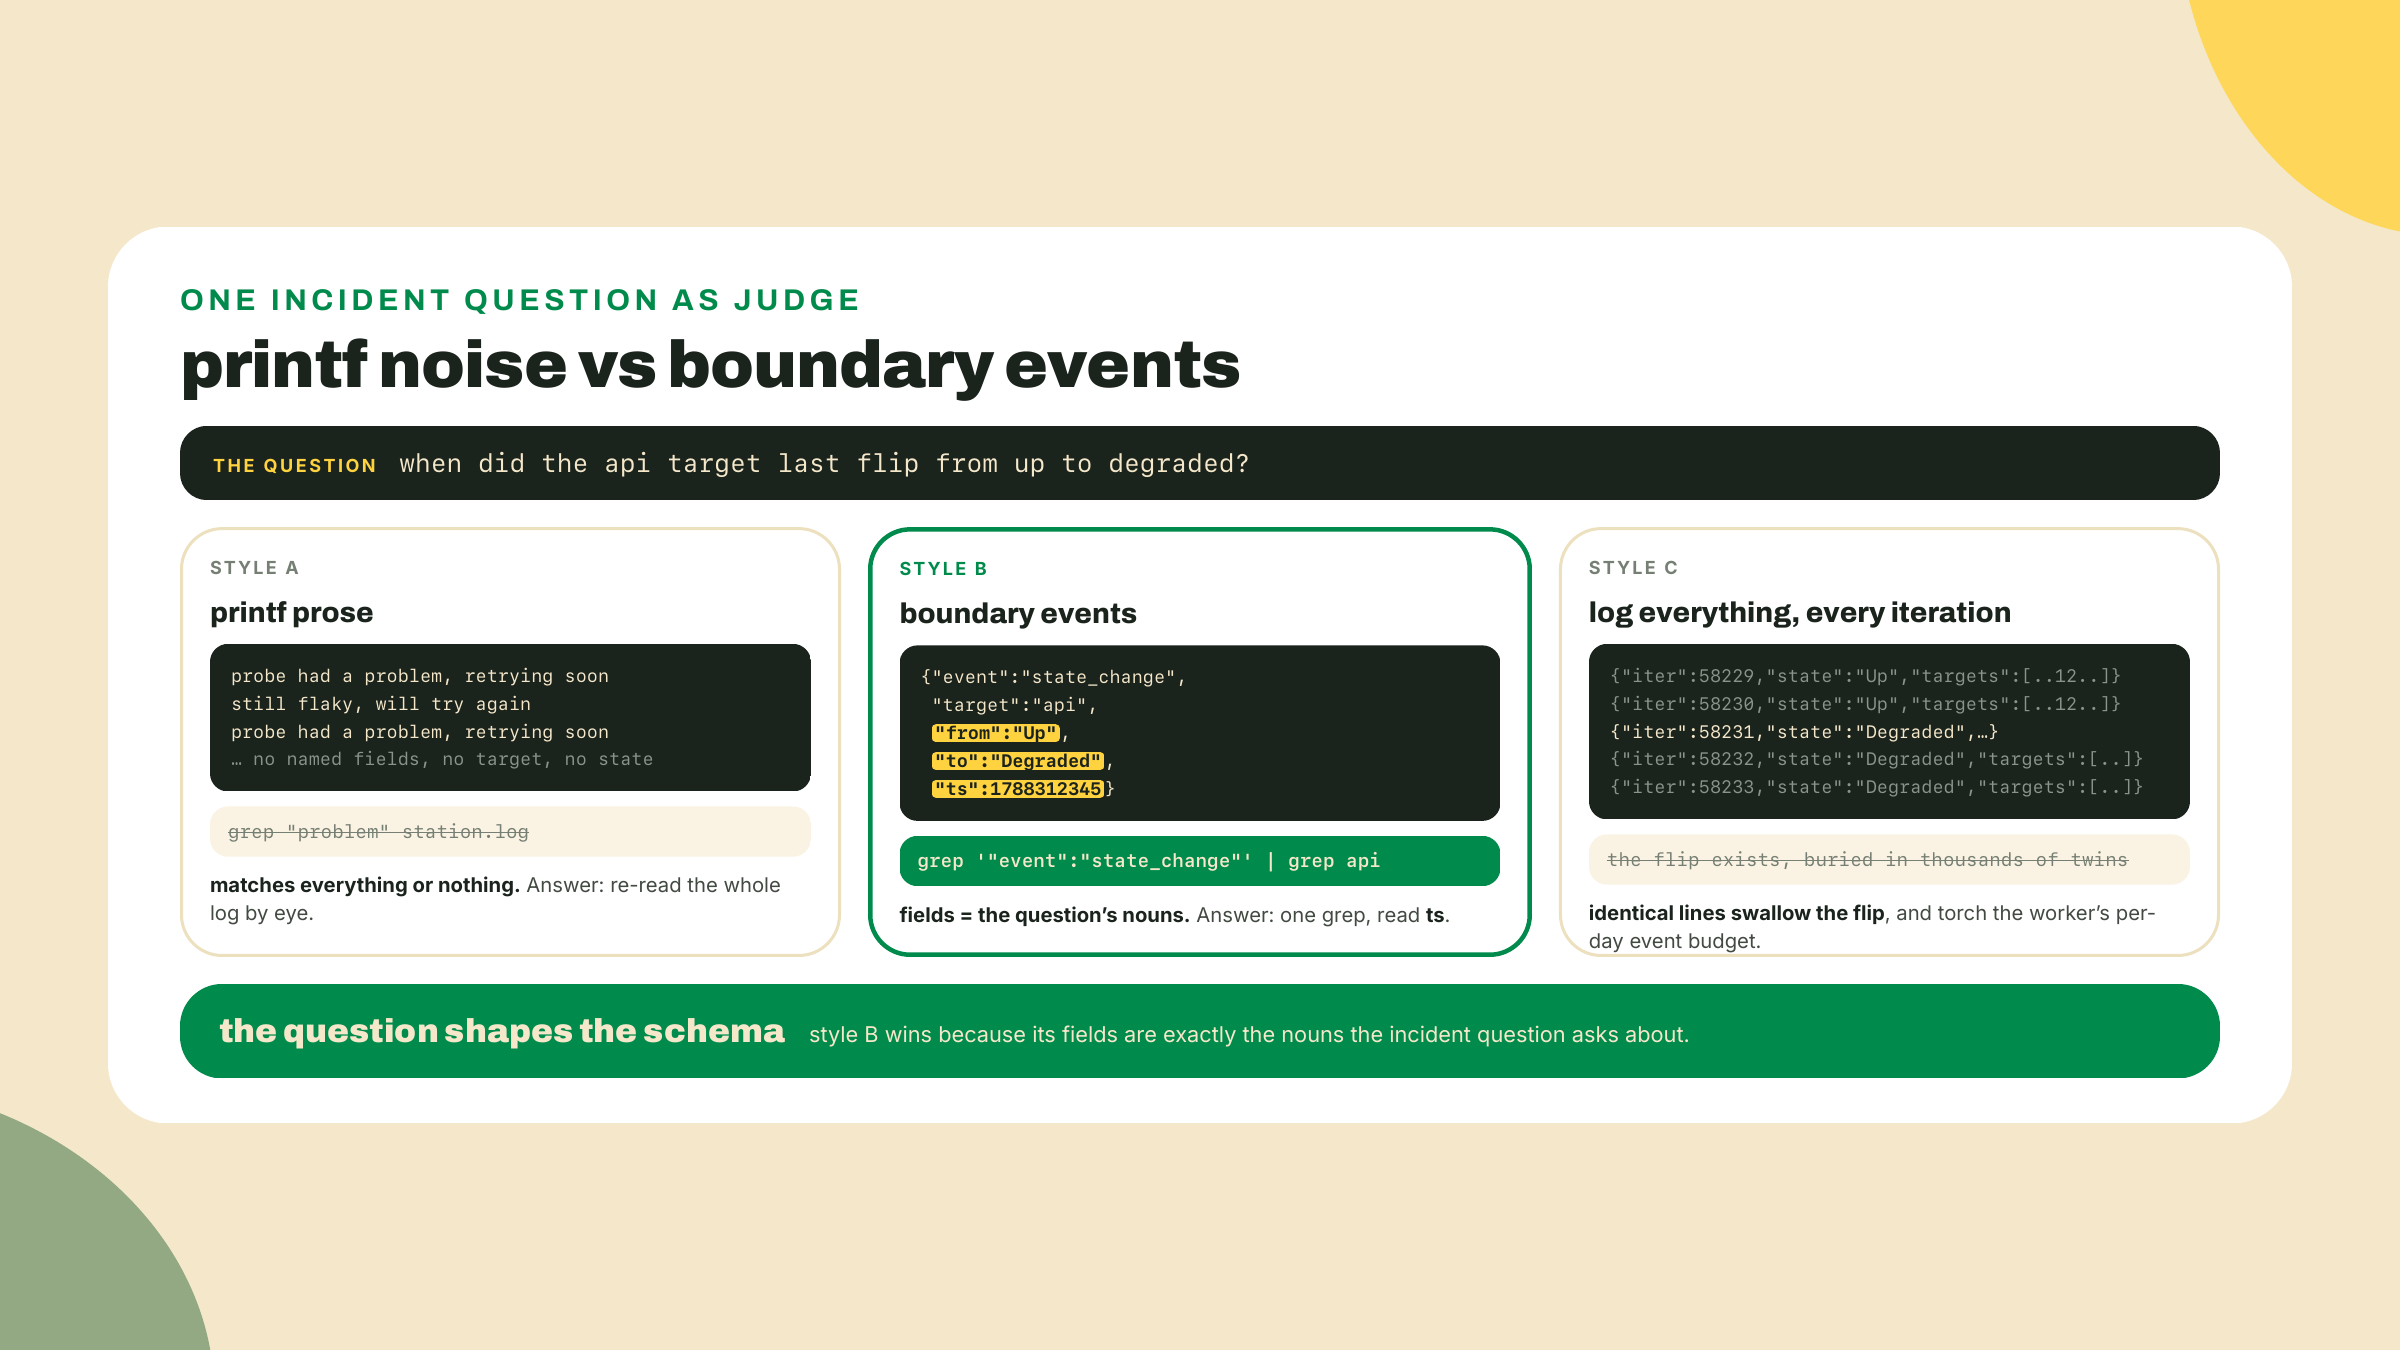
Aqui está a pergunta das 3 da manhã a que esta lição volta o tempo todo: "quando foi a última vez que o alvo api virou de up para degraded?" Agora olhe os dois estilos de logging que poderiam tentar responder ela. O primeiro é o que a maioria da gente escreve por instinto, e eu fui culpado disso por anos: println!("probe had a problem, retrying soon"). Prosa. Calorosa, legível de cima a baixo, e inútil às 3 da manhã, porque "um problema" casa com tudo e ancora nada. O segundo estilo trata a pergunta como o schema: uma mudança de estado é um evento, com um target, um from, um to e um timestamp, então a consulta de incidente é um grep com o nome do campo dentro.
O formato de evento da estação, dado uma vez, aqui, como o contrato que as três superfícies de logging compartilham:
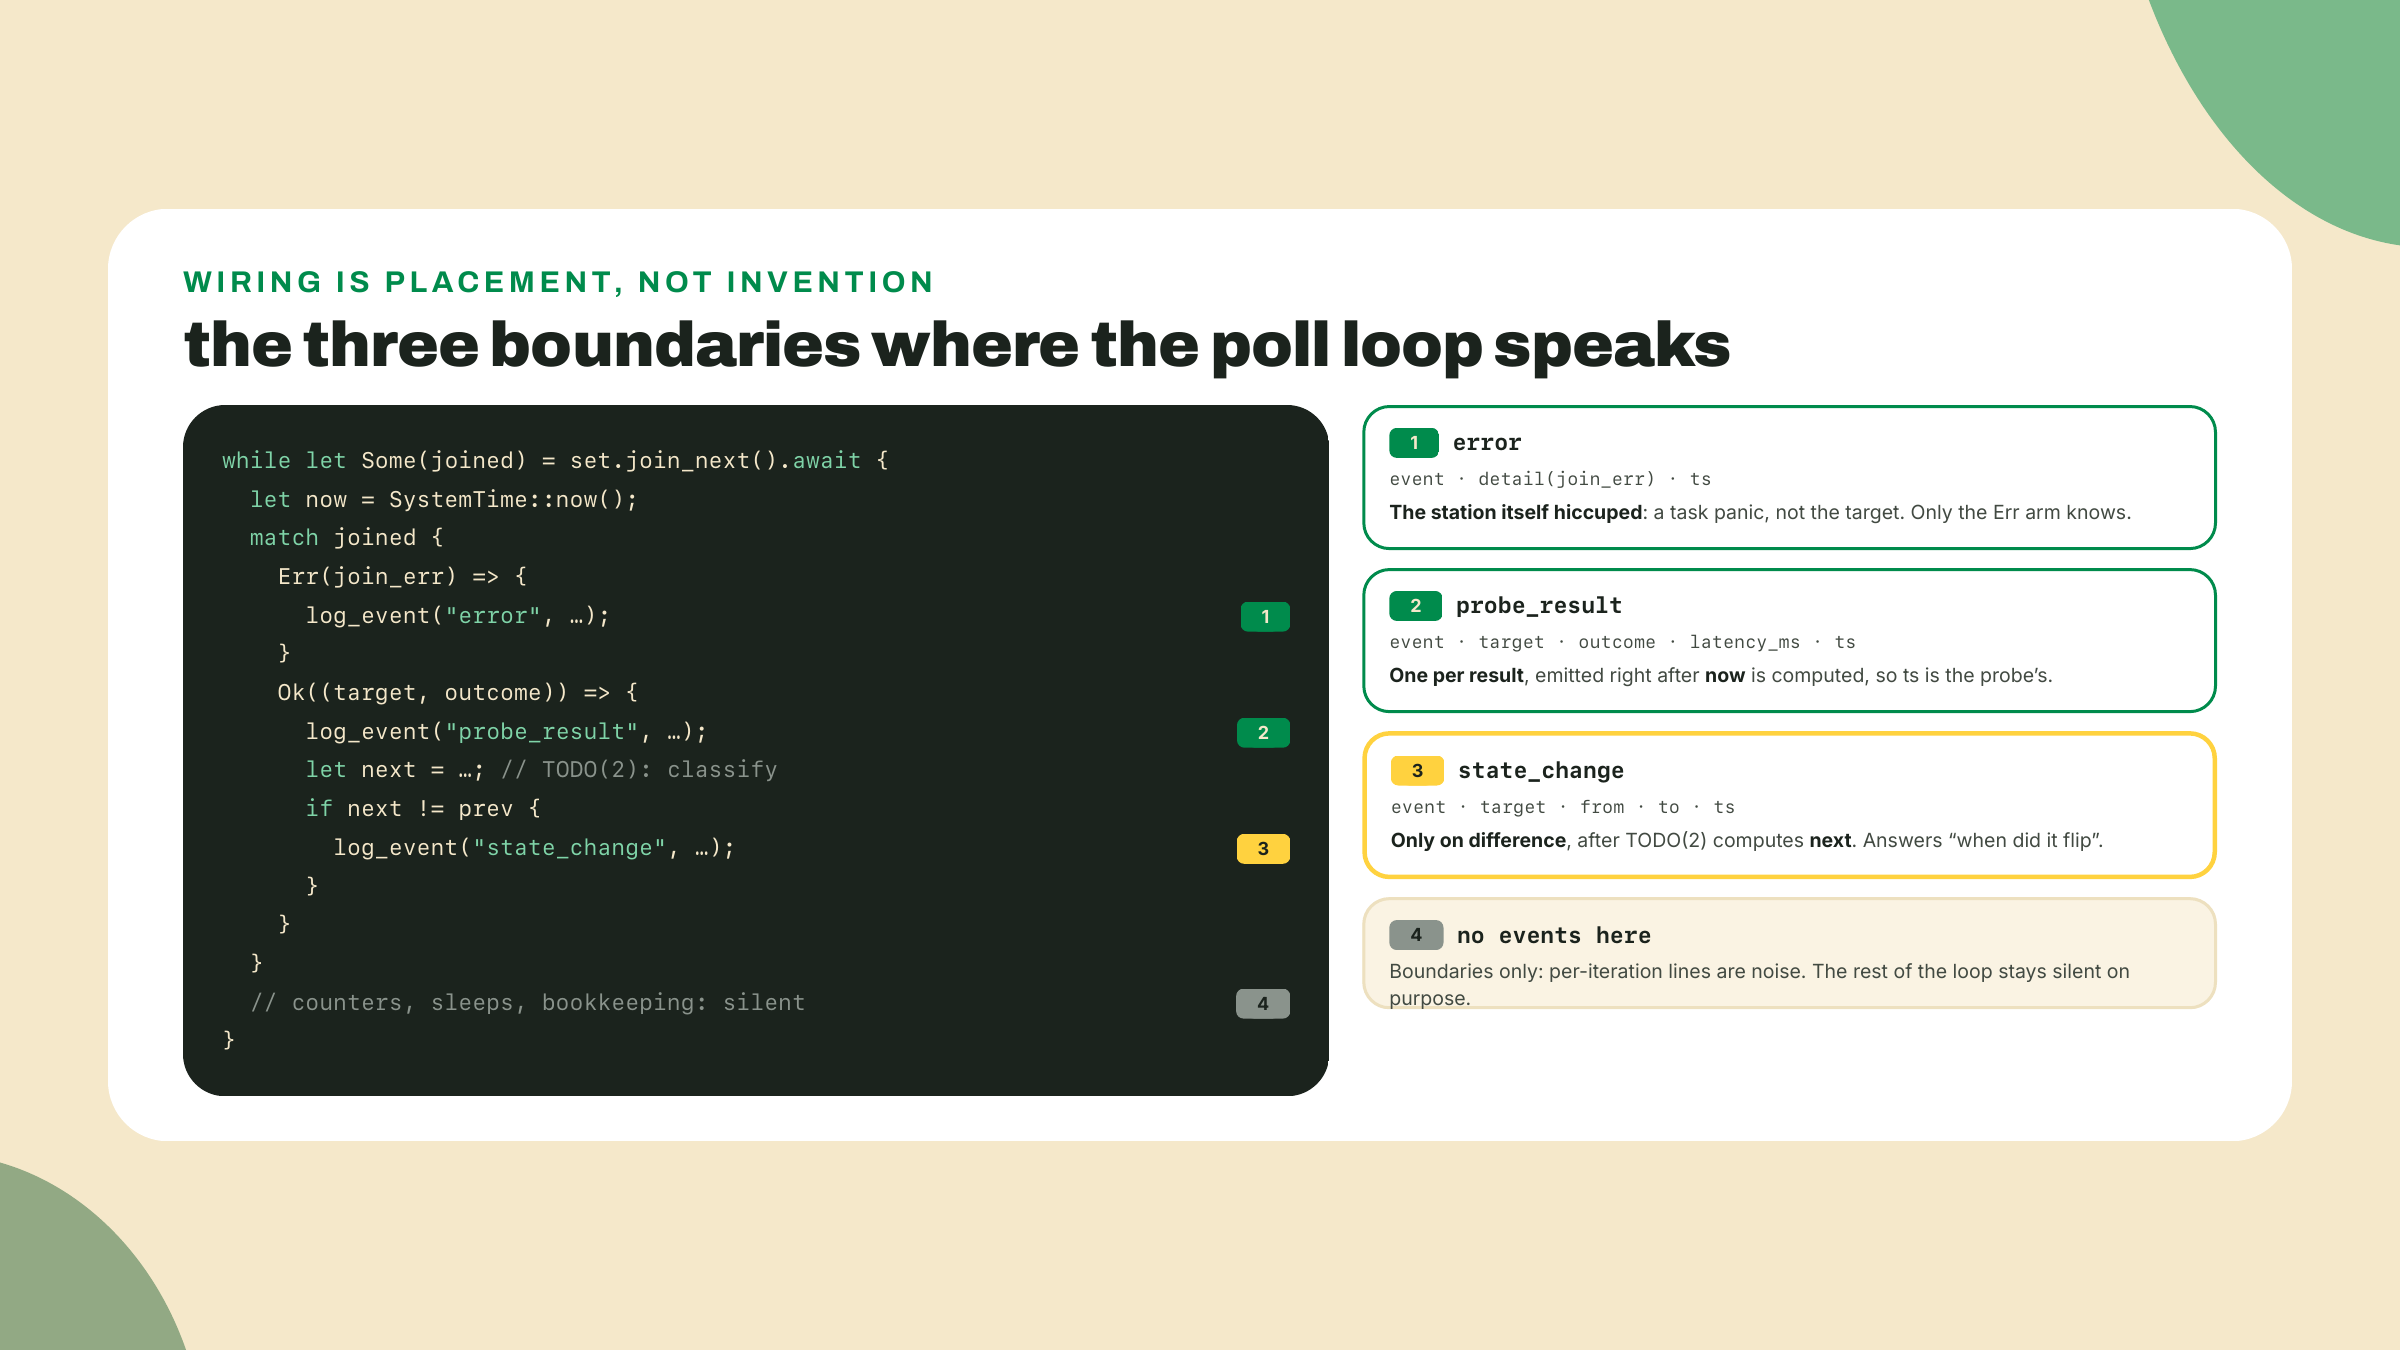
event (um de probe_result, state_change, error), target e ts (segundos unix).probe_result acrescenta outcome (up ou down) e latency_ms.state_change acrescenta from e to, grafados no vocabulário da própria superfície que emite: nomes do motor (Pending, Up, Degraded, Down) no poller, nomes de variante de ProbeResult na frota, nomes de veredito no edge; nomes estáveis dentro de uma superfície, não um enum compartilhado.error acrescenta message, e quer dizer que a própria estação soluçou, não que um alvo caiu. Um alvo down é um probe_result; uma task de sonda que deu panic é um error. Manter os dois separados é o que faz o stream de erro valer um alarme. Quando a superfície que falha é uma leitura da blockchain, error também carrega plane, a string de quatro vereditos do método plane() que m08-l3 te fez escrever, porque uma leitura da blockchain fica bem na costura entre a-estação-soluçou e o-alvo-caiu, e o plano é o que deixa quem lê às 3 da manhã decidir de que lado foi.Uma linha por evento, para o stdout, e nada mais. No poller em Rust isso é escrita de linha com serde_json puro através do helper que você acabou de adicionar, deliberadamente não um framework. Na frota e no worker é console.log(JSON.stringify(...)). O stdout importa mais do que parece: o pipeline de logging do Docker, o wrangler tail e o log de execução do Actions são todos só leitores da saída padrão, então escrevendo linhas ali você herda de graça o encanamento de log de três plataformas.
Por que fronteiras e não tudo? Porque um evento de log é uma afirmação de que alguma coisa mudou numa borda que vale a pena lembrar: um resultado voltou, um estado virou, a própria estação falhou. Uma linha por iteração de loop registra que o tempo passou. Volume não é capacidade de responder. Você vai sentir a diferença no momento em que der um grep numa semana de logs de compose, e a sua carteira vai sentir isso do lado do worker. O nome é mais velho que a computação: o diário de bordo do navio leva o nome do log literal que os marinheiros jogavam ao mar para medir velocidade, uma medição de fronteira com um timestamp. Marinheiros não faziam diário de cada onda.
Talvez você tenha notado o que a lista de campos deixa de fora: níveis de log. Nenhum botão debug, info, warn em lugar nenhum. Isso é uma decisão, não um descuido. Níveis respondem "com que volume eu devo dizer isso", e para uma estação com três tipos de fronteira o nome do evento já responde: probe_result é rotina, state_change é notável, error é a estação pedindo atenção. Um botão de severidade se paga quando um processo emite dezenas de tipos de evento vindos de dez subsistemas e você precisa baixar categorias inteiras sem fazer redeploy. Até a estação ser esse mundo (o crate tracing na caixa do vá-mais-fundo), um campo de nível seria mais uma decisão por call site comprando nada que um grep em event já não te dê.
Logging estruturado também tem um custo, e nomear ele é o mínimo de justiça: cerimônia. log_event(json!({...})) é mais feio que um print, todo campo é uma pequena decisão, e nada disso faz o caminho feliz rodar melhor. Você paga esse imposto exatamente para que o grep das 3 da manhã funcione. Observabilidade é seguro, e seguro é chato até exatamente a noite em que não é.
A estação agora loga. Para onde esses logs vão, e quanto tempo eles vivem, muda por plataforma, e os tiers gratuitos são honestos sobre serem parciais. Restrições, não reclamações:
Docker, local. docker logs <container> e docker compose logs <service> leem tudo o que um contêiner um dia escreveu no stdout, guardado até o contêiner ser removido. Acrescente -f para acompanhar ao vivo. Essa é a sua memória local mais longa e a superfície contra a qual o exercício de grep de incidente abaixo roda.
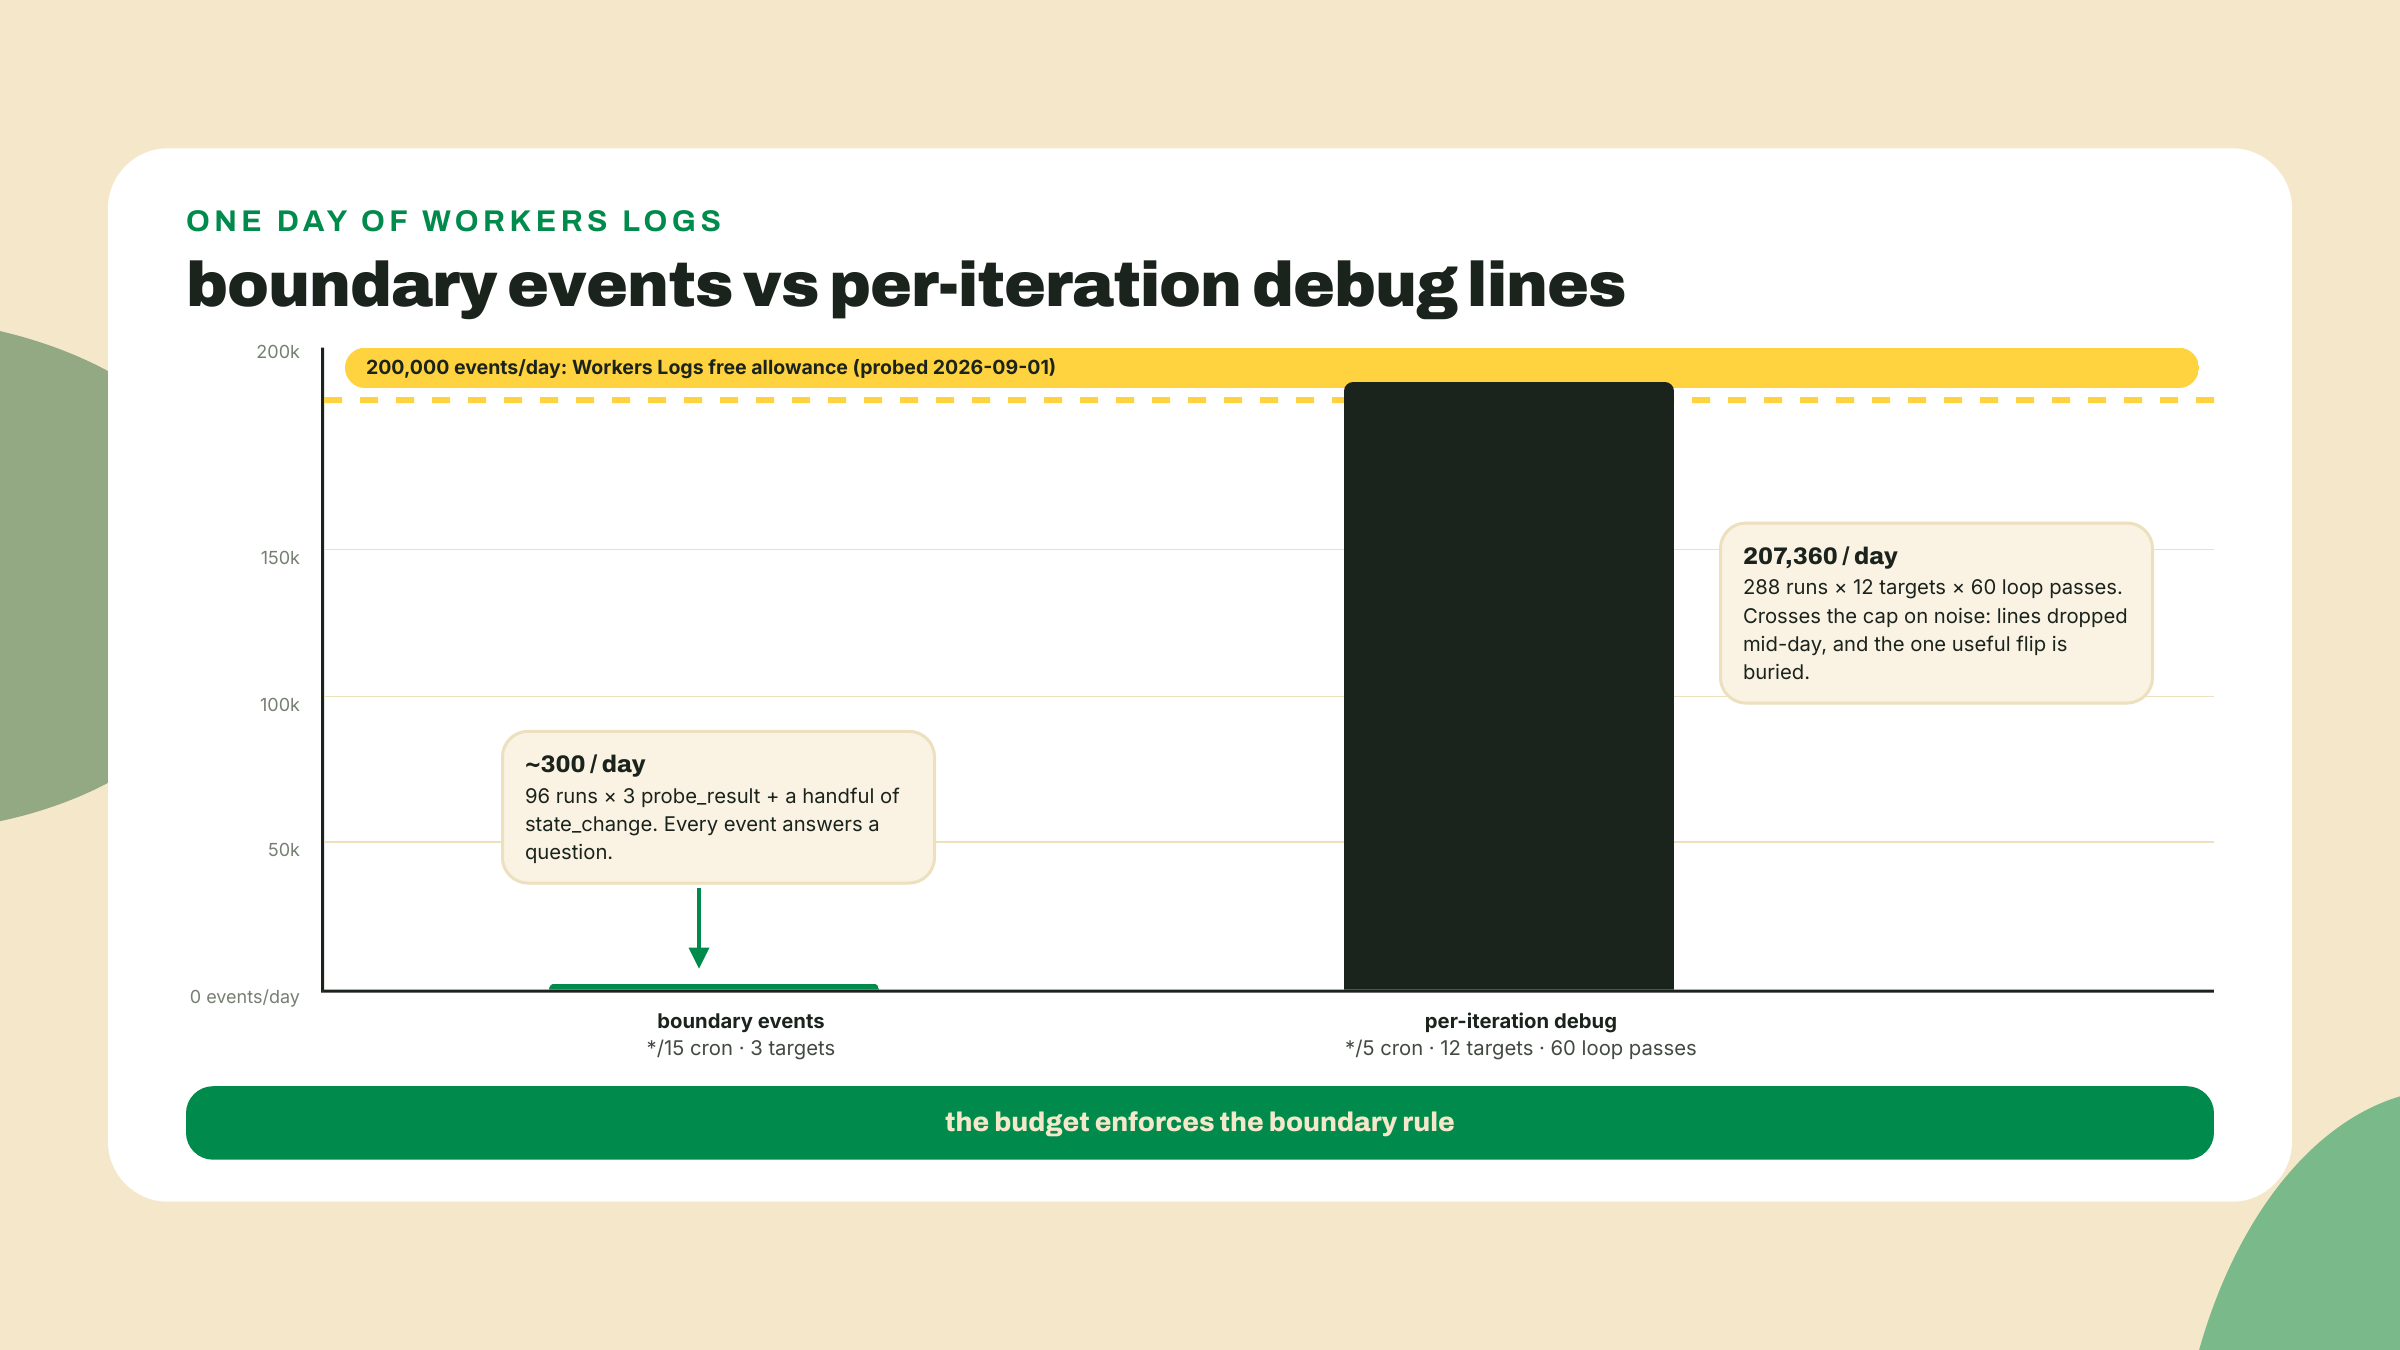
Cloudflare Workers. Duas ferramentas. npx wrangler tail faz streaming de eventos ao vivo de cada cidade em que o seu worker roda, a sua única análise forense em tempo real numa plataforma sem ssh. E o Workers Logs coleta eventos com uma cota gratuita de 200,000 eventos por dia (pela página de preços da Cloudflare, sondada em 2026-09-01). Esse número parece enorme até você fazer a aritmética de loop. Um worker tagarela hipotético num cron de 5 minutos faz 288 execuções por dia; dê a ele uma dúzia de alvos e uma linha de debug por alvo por passada do loop interno, digamos 60 passadas, e 288 × 12 × 60 dá 207,360 linhas. Estourando o orçamento, com ruído. Requests e eventos de log são medidores separados, então o seu tráfego pode estar longe do teto dele enquanto os seus logs são descartados no meio da tarde. O orçamento é a plataforma impondo a regra desta própria lição: logue nas fronteiras e o mesmo dia custa umas poucas centenas de eventos.
Vercel. No Hobby, logs de runtime são retidos por mais ou menos uma hora (pela documentação de limites do Vercel, checada em 2026-09-01). Sente com isso: um usuário reporta a sua função dando erro na manhã de sábado, você abre o painel na segunda, e encontra mais ou menos nada. Por design. O nosso painel é de arquivos estáticos hoje, então o que a estação tem no Vercel agora são logs de build, mas essa restrição é herdada no dia em que o painel ganhar a primeira função dele, e ela reenquadra para que servem os logs de plataforma. Desde 2025-04-23, quando o Vercel virou o Fluid compute ligado por default, serverless ali passou a querer dizer em silêncio "servidores que você não gerencia": concorrência dentro das instâncias, cobrança por CPU ativa, e o mesmo acordo com o histórico. A plataforma roda a sua função. Ela não arquiva o seu passado.
GitHub Actions. Cada execução guarda o log completo dela na aba Actions, por execução, navegável depois do fato. É aqui que o stdout do seu cron aterrissa, um step de cada vez, e onde você vai ler a execução vermelha do exercício de alarme. Ela também é a única das quatro superfícies que registra quando uma execução de fato começou versus quando ela estava agendada para começar, o que faz dela o dado bruto para a medição de desvio do lab. Um hábito se transfere sem mudança: se o seu workflow imprime eventos estruturados, o log da execução herda eles, e um grep sobre um log baixado responde perguntas do mesmo jeito que docker compose logs responde.
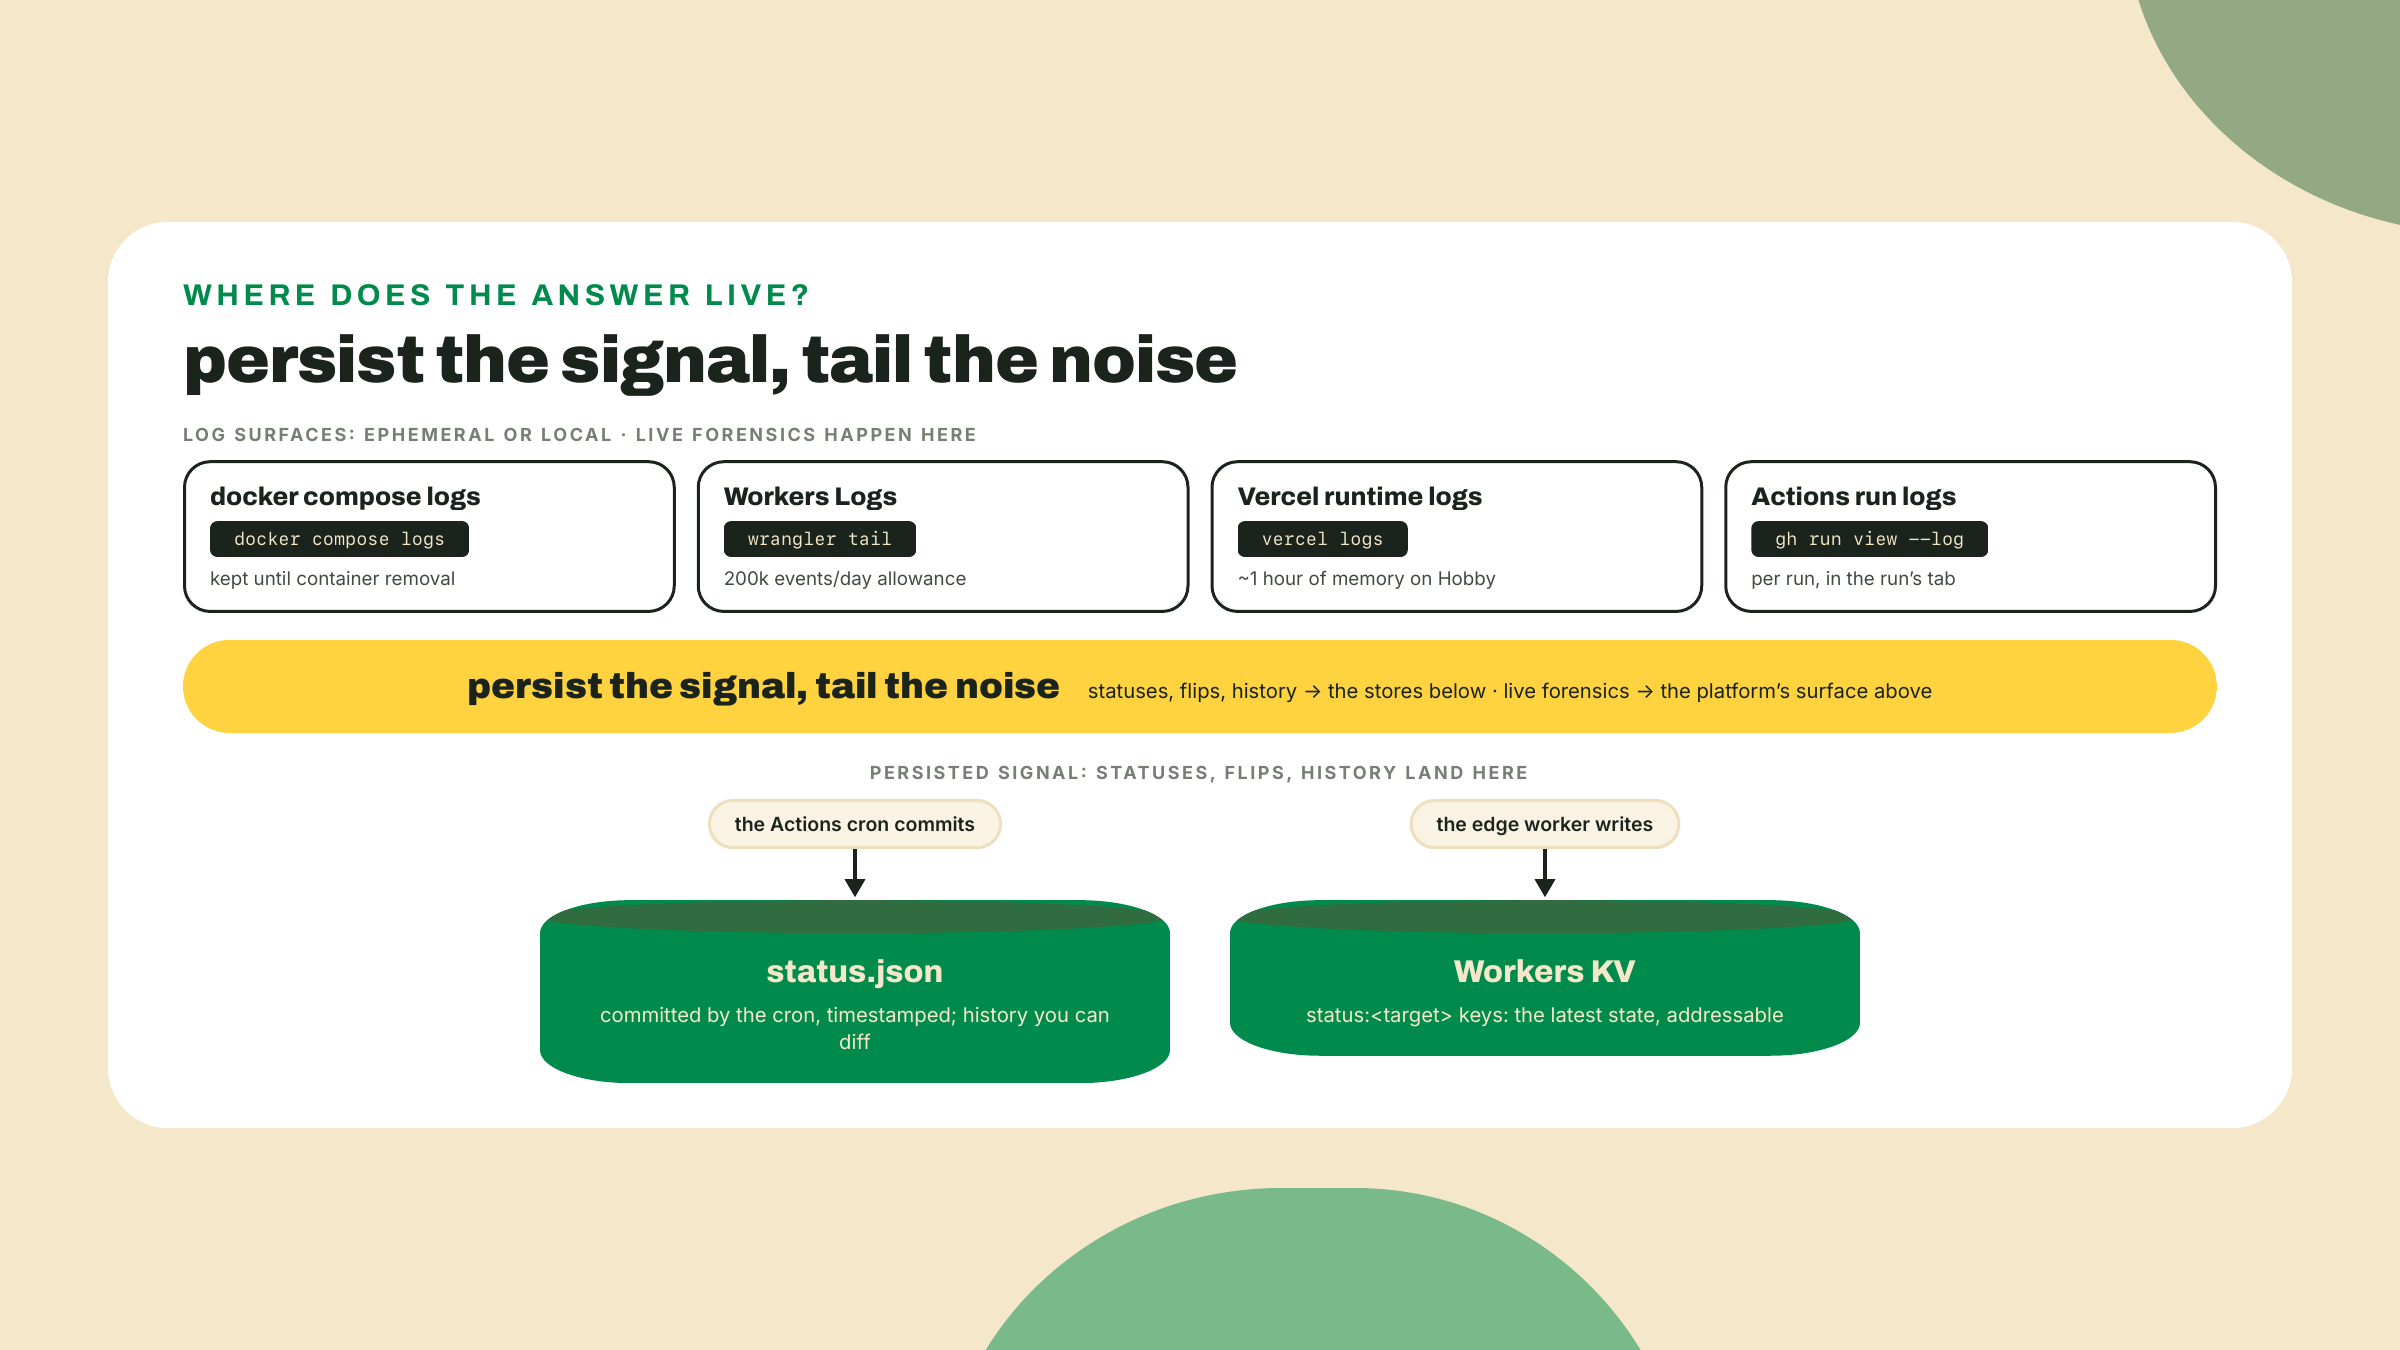
A frase de costura que organiza as quatro, e o design que a sua estação já segue sem ter dado nome a ele: persista o sinal, dê tail no ruído. Tudo o que a estação precisa lembrar mora em status.json e no KV, escrito ali de propósito, desde o módulo 1. Logs são para a pergunta do momento, com tail ao vivo ou grep no que é recente. Se você se pegar precisando de uma linha de log do sábado passado, aquela linha era um sinal fantasiado de log, e o lugar dela é no estado persistido. Arqueologia de segunda-feira de manhã do incidente de sábado só a partir de logs de plataforma de tier gratuito é impossível de propósito.
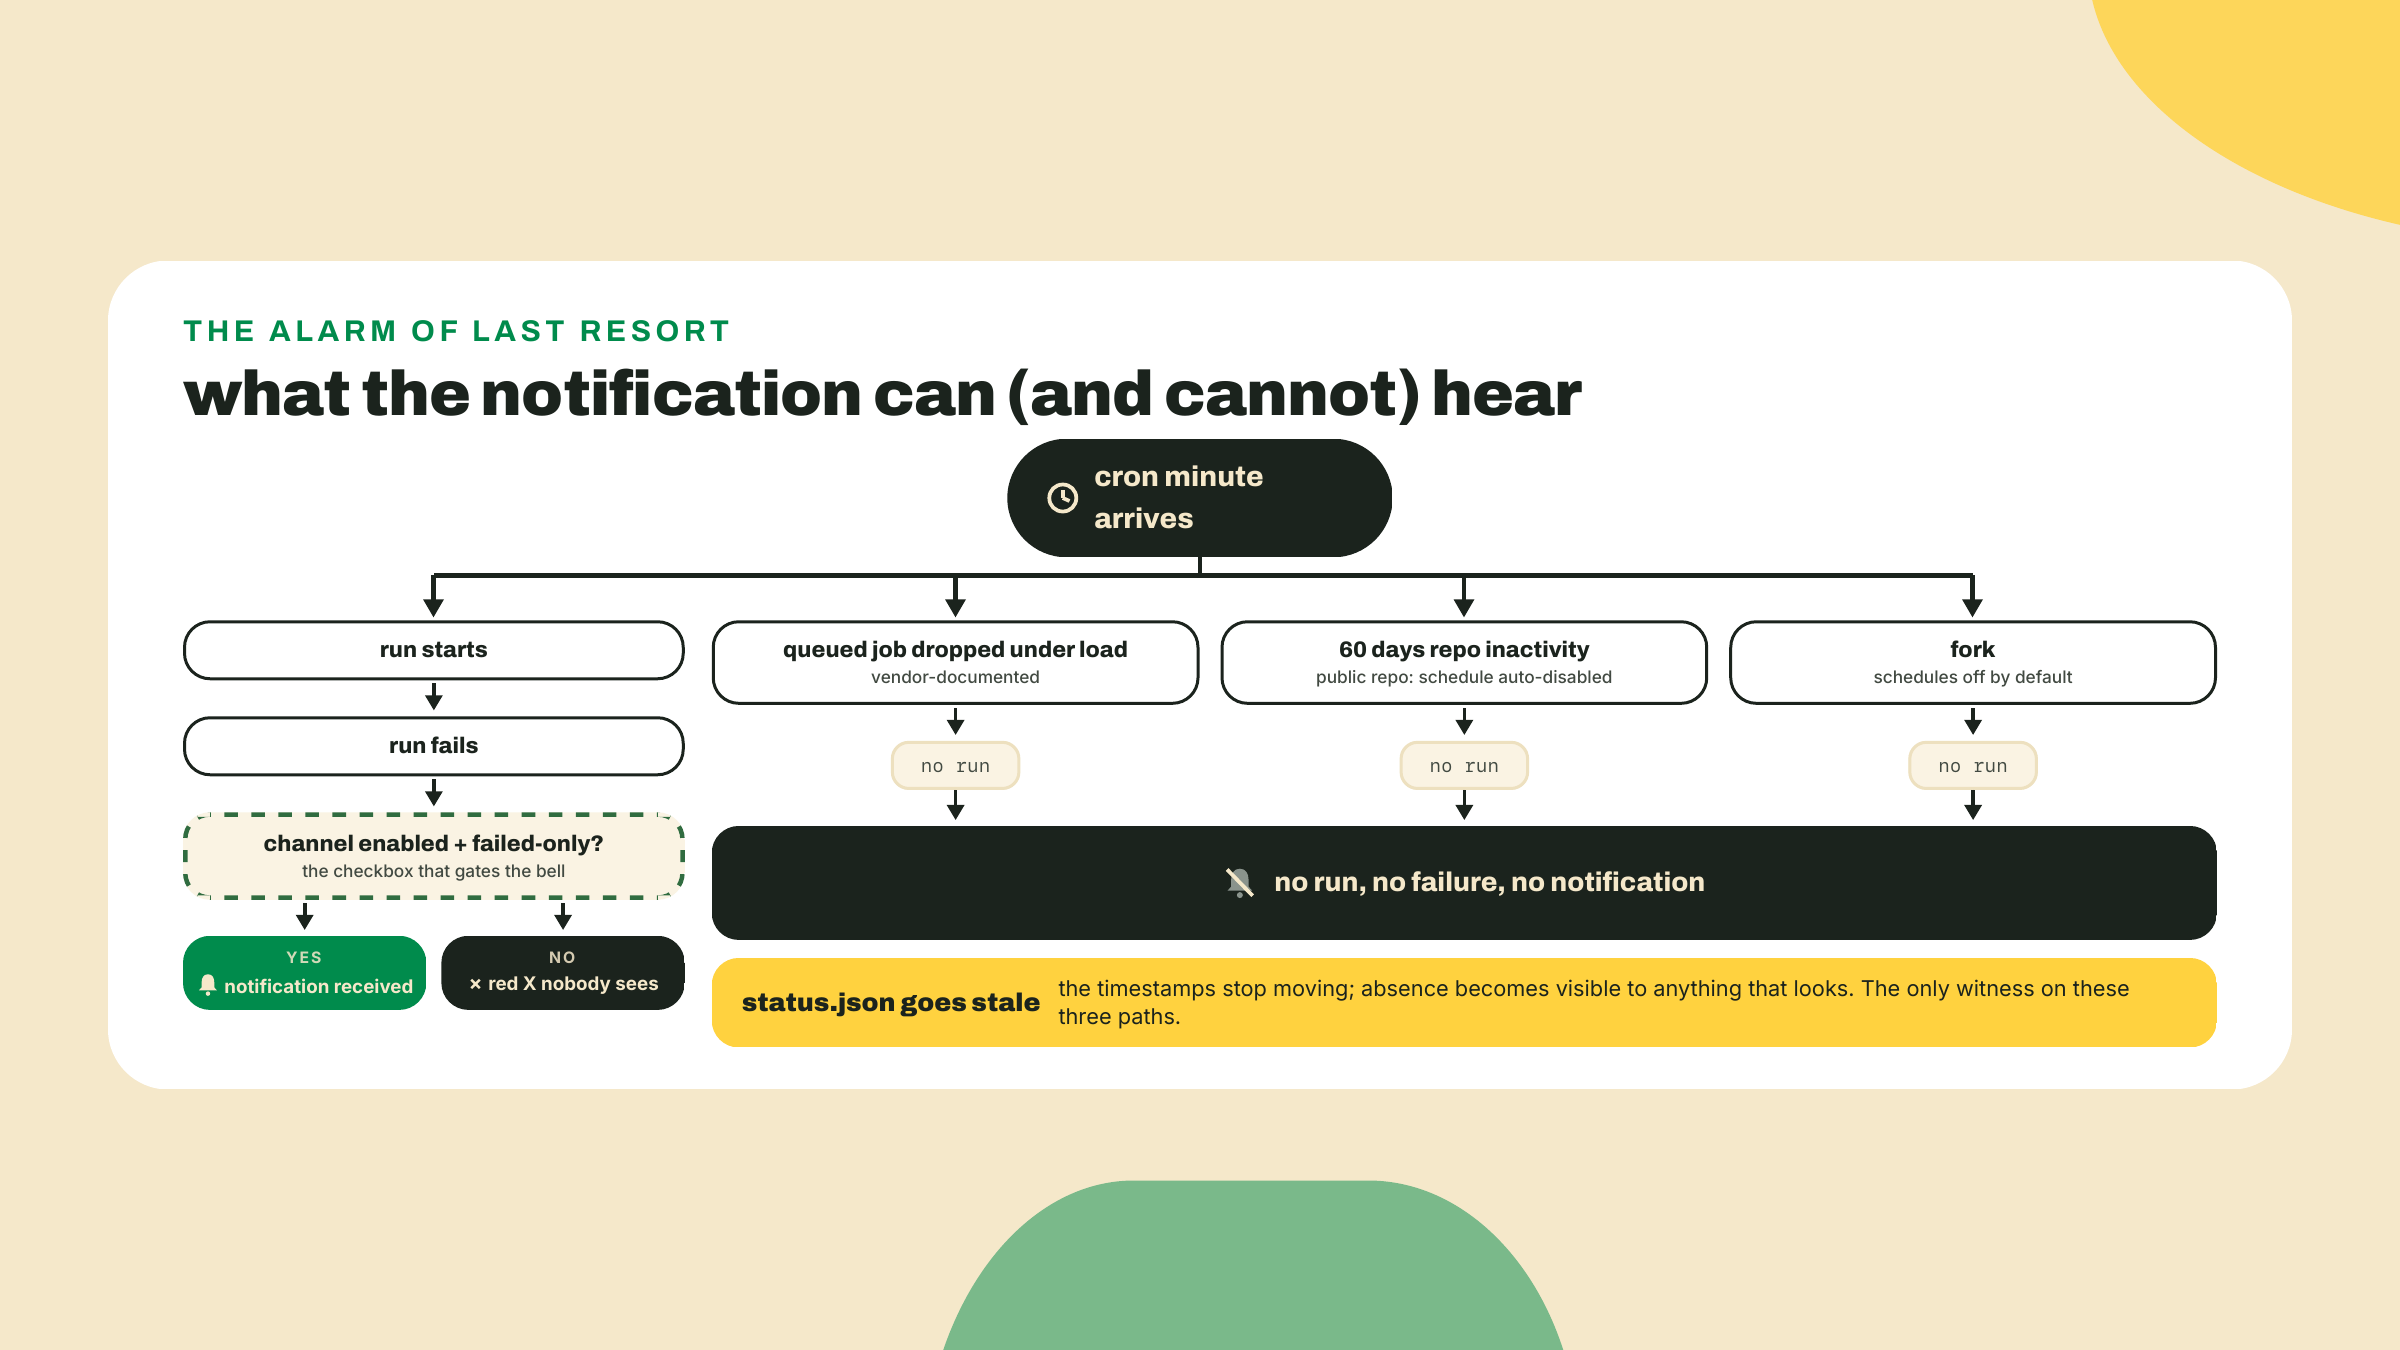
Agora a batida mais afiada da lição. Suponha que o seu workflow de cron falhe às 3 da manhã hoje à noite, com tudo nos defaults dele. O que o GitHub faz? Provavelmente nada que você vá ver. O canal de notificação do Actions vem por padrão em "Don't notify". Existe um X vermelho numa aba que você não está olhando, e esse é o alerta inteiro. Um alarme não configurado não é um alarme; é uma decoração com opinião.
Ligar ele é um passeio de settings, obrigatório no lab abaixo: Notification settings, depois System, depois Actions, escolha um canal de entrega (On GitHub, Email, ou os dois), e marque Only notify for failed workflows, porque um e-mail de execução verde a cada 30 minutos te treina a deletar exatamente a mensagem que um dia vai importar.
Dois comportamentos desse canal valem a pena saber antes de você ser dono de um repo compartilhado. Notificações de workflows agendados vão para o criador do workflow, a conta que commitou o cron primeiro. E, pela documentação do GitHub, se um workflow agendado é desabilitado e depois reabilitado, as notificações vão para o usuário que reabilitou ele em vez do usuário que modificou a sintaxe do cron por último. Numa estação solo isso é curiosidade. Em qualquer repo compartilhado, quer dizer que o pager pode trocar de mão em silêncio por um toggle inocente, então saiba de quem ele é.
E agora a parte honesta, a razão de este alarme ser "de último recurso" e não só "o alarme". Uma notificação de falha exige uma execução que roda e falha. A documentação do próprio GitHub, textualmente: "Eventos agendados podem ser atrasados durante períodos de carga alta de execuções de workflow do GitHub Actions. Horários de carga alta incluem o começo de toda hora. Se a carga estiver suficientemente alta, alguns jobs na fila podem ser descartados." Best effort, por escrito, do fornecedor. Uma execução descartada não produz X vermelho nenhum nem e-mail nenhum. A cilada de 60 dias que você conheceu em m01-l3 também não: num repo público, 60 dias sem atividade no repositório e o agendamento se desliga, limpo, sem nada falhando. O commit de keepalive que você aprendeu ali como contramedida mantém a ressalva de m01-l3 em pleno vigor aqui: a prática da comunidade diz que commits zeram o relógio, actions de keepalive feitas de propósito existem porque gente suficiente acredita nisso, e o GitHub nunca definiu o que "atividade" quer dizer, então isso segue como reportado-na-prática, nunca política. Forks começam com os agendamentos desligados por completo. Três maneiras documentadas de o batimento parar em puro silêncio, e o canal de notificação é estruturalmente surdo às três.
Qual é o tamanho do atraso de agendamento quando os jobs de fato rodam? Eu não citei um número, e não vou citar: o GitHub documenta que o atraso existe e nunca documenta o tamanho dele. Essa é a mesma disciplina da blockchain que a estação observa. A Solana mira slots de 300ms; em 2026-09-01 uma sonda de 20 amostras da rede de verdade mediu 316ms. Sistemas têm alvos, e você mede assim mesmo. O seu cron tem um minuto alvo (e um piso: o menor intervalo que o GitHub agenda é 5 minutos), então o lab faz você medir o seu próprio desvio a partir do histórico de execuções em vez de confiar num número que ninguém publicou.
Então o alarme ganha uma retaguarda que a plataforma não consegue descartar: o batimento persiste onde a ausência é visível. Toda execução do cron commita status.json com timestamps. Uma execução que nunca acontece deixa o arquivo desatualizado, e a desatualização é um fato que qualquer coisa consegue checar: você, dando uma olhada na idade dos dados do painel; ou uma sonda futura, tratando o seu próprio repo como um alvo. A notificação pega as mortes barulhentas. Os timestamps pegam as silenciosas. Nomear o que o alarme não consegue pegar não é uma ressalva na lição de ops; é a lição de ops.
Uma regra amarra a batida do logging à batida dos segredos, e ela é curta o bastante para memorizar: nunca logue o ambiente. Nem process.env, nem std::env::vars(), nem um objeto de erro que prestativamente embute o contexto de config dele. A varredura que você está a ponto de completar existe para manter segredos fora do git; uma linha de log que serializa o ambiente copia eles para dentro de logs retidos, que em algumas plataformas sobrevivem ao incidente e em todas as plataformas viajam mais longe do que você imagina. O seu schema de evento é seu aliado aqui: as quatro listas de campos acima não contêm nenhum campo que pudesse carregar um segredo, então enquanto as fronteiras emitirem só o schema, a varredura e os logs continuam de acordo.
A varredura em si é a quarta batida da lição e o entregável mais quieto do lab: uma tabela, quatro plataformas, respondendo "onde cada segredo mora para que ele nunca aterrisse no git ou numa linha de log". Você já conheceu toda linha dela, uma plataforma de cada vez: repo secrets alimentando o env do workflow no módulo 1, vercel env pull no módulo 3, .dev.vars mais npx wrangler secret put no módulo 7 com uma promessa de que m09-l2 varreria isso nas quatro. Esta é essa varredura. Novas na tabela são só as notas de operação, incluindo um limite duro que vale a pena anotar: o Vercel põe um teto no tamanho total das suas variáveis de ambiente, nomes e valores, de 64KB. O formato da tabela está no lab; ele tem que ler como algo que você colaria com fita no monitor, porque é mais ou menos esse o trabalho dele.
Vá mais fundo (os 20%). esta lição ensina logging estruturado como escrita de linha com serde_json puro, que é o tamanho certo para um daemon com um stdout. A resposta mais profunda do ecossistema Rust é o crate tracing: spans, níveis, subscribers, campos estruturados costurados através de call stacks async, a coisa que você busca quando um request toca dez funções e você quer a história remontada. A porta de entrada dele é https://docs.rs/tracing/latest/tracing/ (URL checada em 2026-09-02). Salve como bookmark, leia quando a estação crescer além da história que cabe em um processo. Nada no lab abaixo depende disso.
O recuo, dito mais uma vez para ninguém se surpreender no meio do lab: um exercício é trabalhado por inteiro (o grep de incidente no passo 3). Todo o resto é uma checklist contra código e plataformas que você já é dono. Reserve metade do seu tempo para os passos 5 a 7; um deles espera por um cron de propósito.
Termine os eventos do poller. Você emitiu probe_result na abertura. Faltam três emits, conduzidos pela lista de campos da seção de teoria: duas fronteiras novas e uma dívida que m08-l3 pré-pagou:
state_change: o seu drain loop computa o próximo estado inline, dentro da chamada de map.insert (state: next_state(prev, ok, count)), então suba ele primeiro: let next = next_state(prev, ok, count); acima do insert, com next no literal da struct. O emit vai entre a linha que você subiu e o insert, só quando houver diferença em relação a prev. O fragmento, onde next é o estado que você subiu:if next != prev {
log_event(json!({
"event": "state_change",
"target": name,
"from": prev,
"to": next,
"ts": now,
}));
}
Se o compilador reclamar que ProbeState não pode ser comparado com !=, adicione PartialEq à lista de derive do enum do motor, a mesma jogada de uma palavra que adicionar Serialize em m06-l1.
error: o skip do let ... else do drain loop hoje engole a única falha genuína de nível de estação que ele vê, uma task de sonda que deu panic, sem deixar rastro. Troque ele por um match para que o braço Err possa falar antes de pular:let (name, ok, latency_ms) = match joined {
Ok(result) => result,
Err(join_err) => {
log_event(json!({
"event": "error",
"message": join_err.to_string(),
"target": "pollerd",
"ts": SystemTime::now()
.duration_since(UNIX_EPOCH)
.expect("system clock is set before 1970")
.as_secs(),
}));
continue;
}
};
(Nenhum import novo é necessário para esse braço: SystemTime e UNIX_EPOCH estão sentados na linha use std::time::{...} deste arquivo desde o esqueleto do m06-l1.)
error de chain, a fronteira que m08-l3 pré-pagou: o seu chain_loop já dobra o plano de cada falha para dentro de last_error para o /status; dê às mesmas falhas uma voz no stdout. No caminho de falha, depois de os dois awaits terminarem e antes de o lock ser pego, emita um evento por Err que você está segurando. Os nomes das suas variáveis são seus; o formato é um emit por leitura que falhou, e a leitura de saldo ganha o gêmeo deste bloco:if let Err(e) = &slot {
log_event(json!({
"event": "error",
"target": "chain",
"plane": e.plane(),
"message": e.to_string(),
"ts": now,
}));
}
Este é o momento que m08-l3 prometeu quando fez você escrever plane(): quatro strings estáticas, agora nomes grepáveis no stream de log. Aponte o poller para a URL de RPC irresolvível daquela lição e um tique imprime (a sua própria mensagem das 2 da manhã onde está a minha; o plano na frente é a parte que o enum garante):
{"event":"error","message":"could not reach the RPC endpoint: error sending request for url (https://rpc.invalid/)","plane":"transport","target":"chain","ts":1788350402}
E a diferença das 3 da manhã entre "o RPC estava fora" e "a gente estava parseando errado" agora é grep '"plane":"transport"' versus grep '"plane":"shape"': um grep em vez de uma tarde, exatamente como prometido.
cargo run -p pulse-pollerd e confirme que as linhas de sonda continuam fluindo. Checkpoint: um tique produz uma linha probe_result por alvo, o primeiro tique depois do boot produz linhas state_change anunciando alvos Pending acordando, e uma URL de RPC sabotada produz eventos error vestindo o plano deles.
Reconstrua sob o compose. Da raiz do repo: docker compose up --build -d, depois prove o pipeline de ponta a ponta:
docker compose logs pollerd | grep '"event":"probe_result"' | tail -n 3
Três linhas JSON de evento, cada uma carregando target, outcome e latency_ms. Esse comando também é a trava de verify desta lição, então faça ele passar antes de seguir. Note o que você não construiu: o poller escreve no stdout, e o pipeline de logging do Docker faz a coleta, o armazenamento e o replay de graça.
O grep de incidente, trabalhado. Encene um incidente de verdade sem tocar em uma linha de código: corte o cabo do poller. Ache a rede e o contêiner do seu compose, depois desconecte:
docker network ls          # note the <project>_default network name
docker network disconnect <project>_default $(docker compose ps -q pollerd)
Dê a ele dois tiques (65 segundos é confortável), reconecte com o mesmo comando e connect, e dê mais um tique para ele se recuperar. Os seus alvos acabaram de viver um episódio completo: up, degraded, up. Agora responda a pergunta das 3 da manhã com um pipeline só:
docker compose logs pollerd | grep '"event":"state_change"' | grep '"to":"Degraded"'
Cada hit é uma virada, com timestamp. Leia o ts da última e converta ele (macOS: date -r <ts>; Linux, grafia GNU: date -d @<ts>). O grep mais a única linha que casa é um relatório de incidente completo. Depois rode você mesmo a pergunta da recuperação, mesmo pipeline, "to":"Up", e confira que a recuperação seguiu a reconexão. Trinta segundos, sem painel, sem ssh. O grep é o motor de consulta inteiro, que é exatamente o ponto de eventos JSON de uma linha.
Mesmo formato, superfícies TS. Checklist, sem passo a passo:
probe_result por relatório, e um state_change quando a variante de um alvo diferir da passada anterior (from/to carregam nomes de variante de ProbeResult; a frota não tem estados de motor). O helper inteiro é uma linha: const logEvent = (e: Record<string, unknown>): void => { console.log(JSON.stringify(e)); };pulse-edge-ts, troque a linha de veredito do m07-l1 (console.log(`${target.name}: ${entry.verdict}`), prosa, como acusado) pelo formato de evento: event, target, outcome mapeado do veredito da sua entry (up continua up; qualquer outra coisa mapeia para down; o veredito completo já mora no snapshot do KV), latency_ms se a sua entry mediu um, e ts: Math.floor(Date.now() / 1000) para casar com os segundos do poller.npx wrangler tail, force o cron uma vez localmente ou espere o quarto de hora passar, e confirme que os eventos chegam como JSON, não como prosa.logEvent dizendo isso, para o você do futuro tentado a adicionar uma linha de debug dentro de um loop.Reconstrua primeiro, ou o checkpoint falha sem causa declarada: o fleet-runner ainda roda a imagem do passo 2. docker compose up --build -d fleet-runner, depois um tique. Checkpoint: docker compose logs fleet-runner | grep '"event":"probe_result"' ENCONTRA linhas de evento que casam (casar é a condição de passagem aqui, a imagem espelhada do grep de segredos mais adiante, onde o silêncio é), e o wrangler tail mostra o mesmo formato vindo do edge.
Ligue o alarme. GitHub, Notification settings, System, Actions: defina a entrega (On GitHub, Email, ou os dois) e marque Only notify for failed workflows. Duas notas de rodapé da seção de teoria pertencem à sua cabeça enquanto você clica: este canal vinha em "Don't notify" até agorinha, e notificações de execução agendada se prendem ao criador do workflow, hoje você; anote isso na tabela para qualquer repo compartilhado futuro.
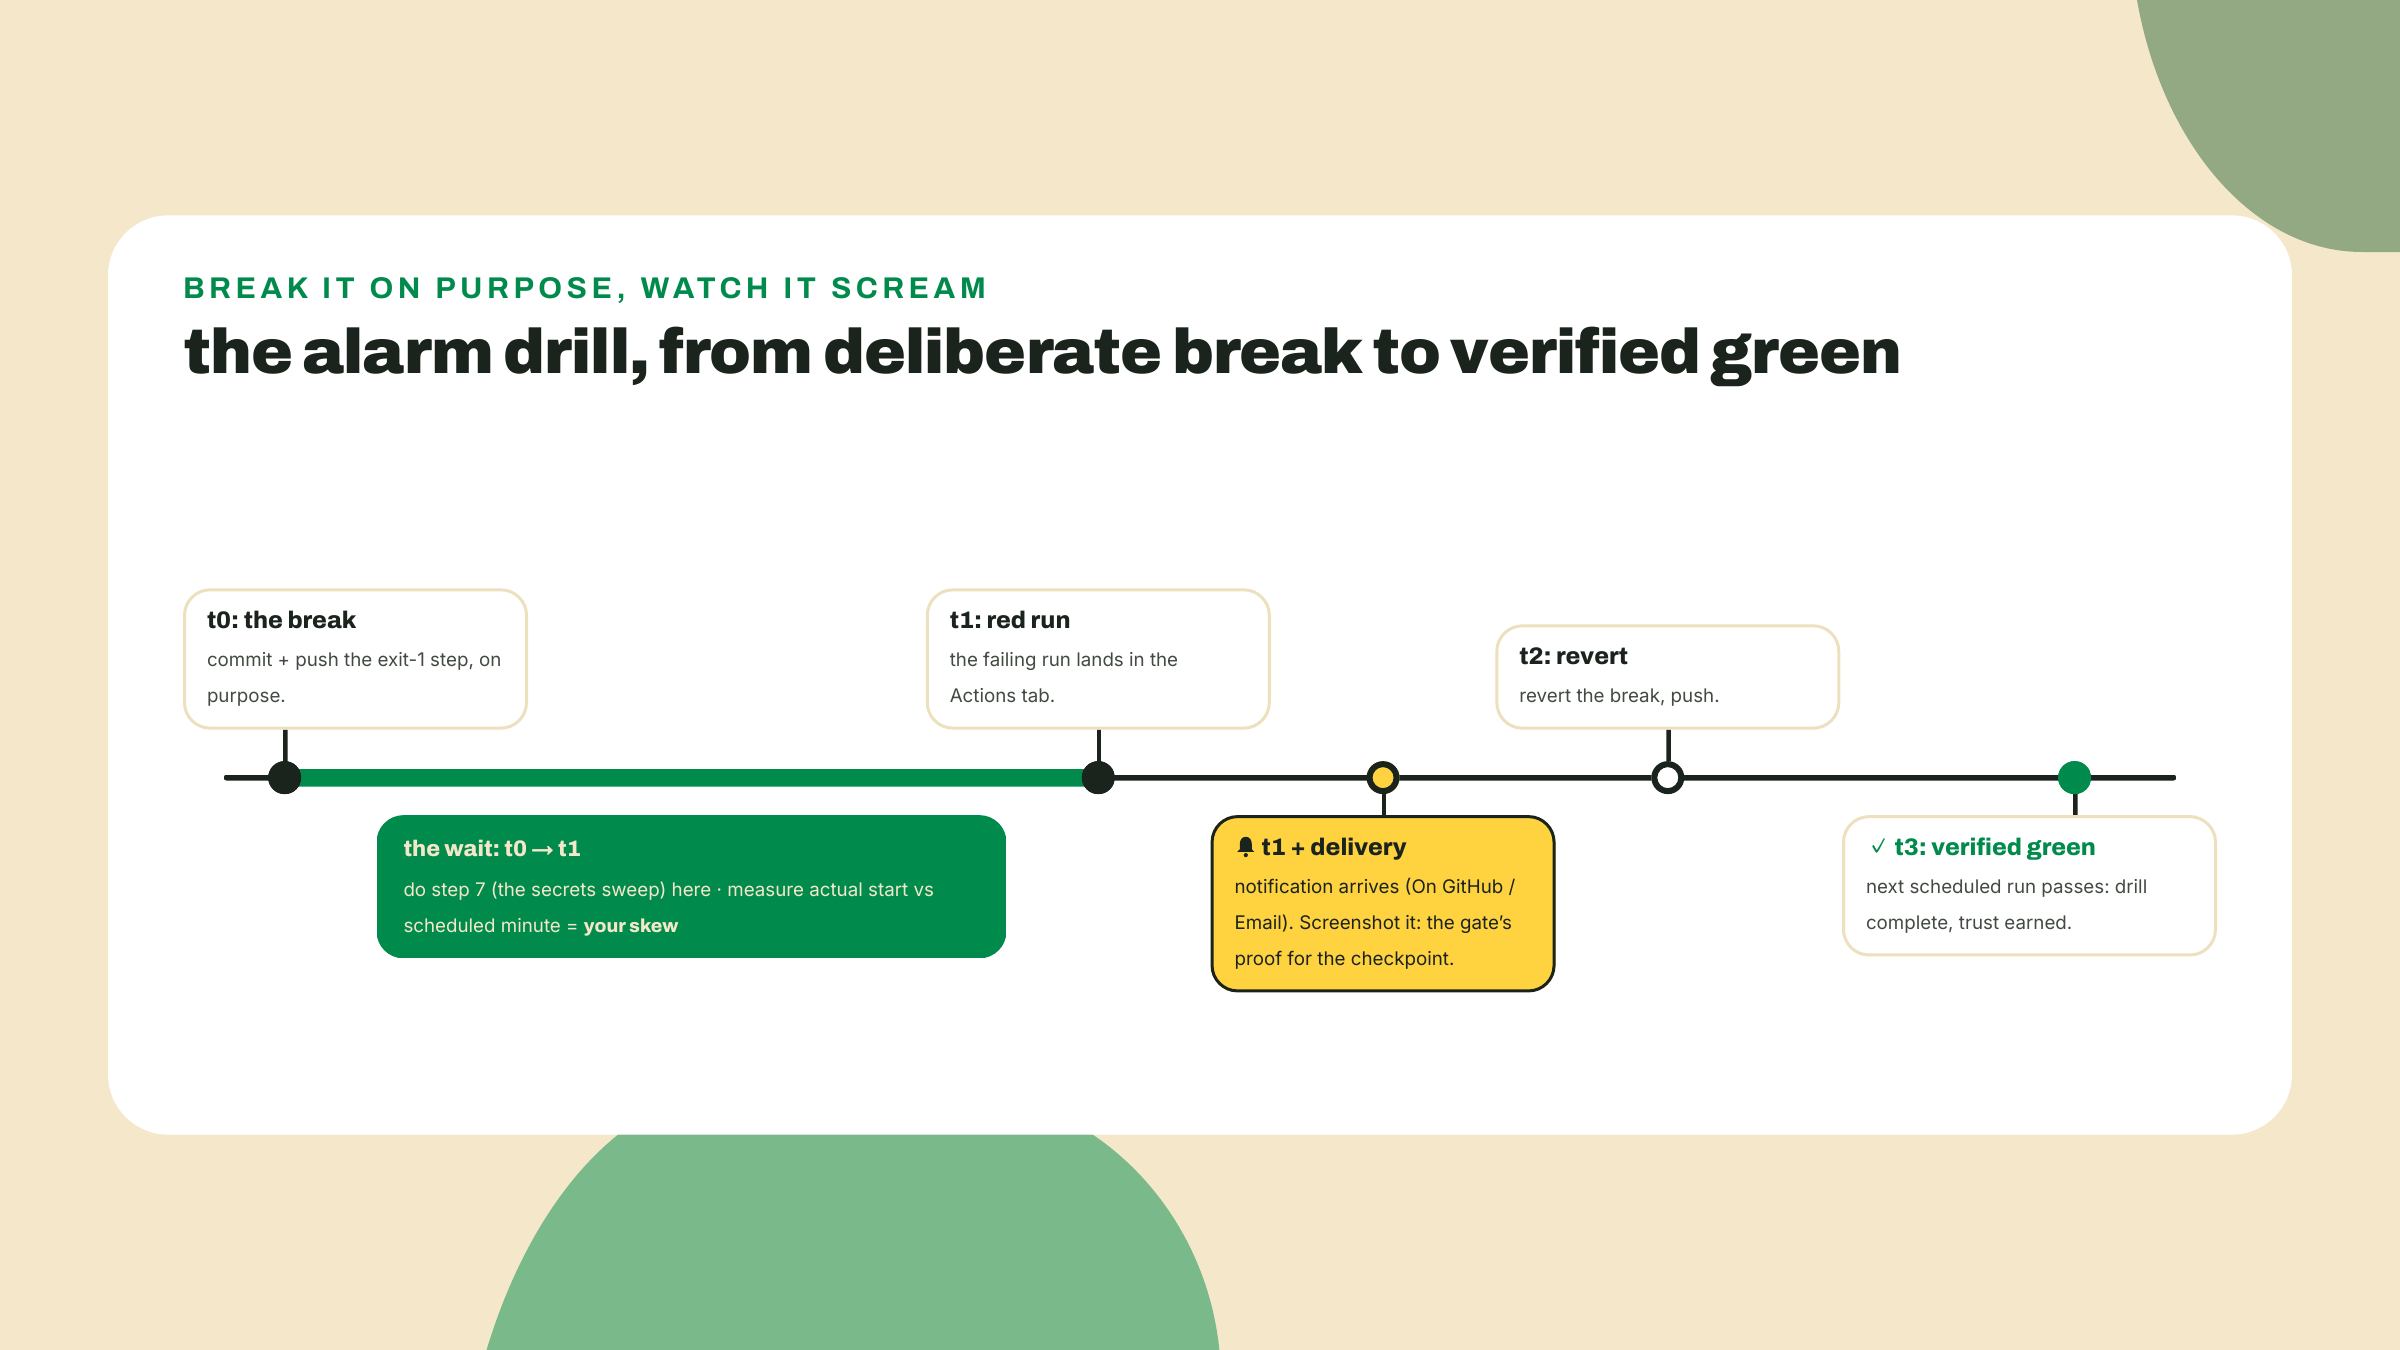
O exercício de alarme. Um alarme que você nunca ouviu é uma hipótese. Quebre o cron de propósito: adicione um step com run: exit 1 no topo do job do workflow da estação, commite, dê push. Depois deixe o agendamento disparar ele, não o seu push, porque o caminho agendado é o caminho para o qual o alarme existe. Espere um chamariz primeiro: o seu workflow também dispara em push, então o próprio commit do exit-1 produz uma execução vermelha imediata e, com as notificações recém-ligadas, provavelmente um e-mail em minutos. Essa NÃO é a prova; a evidência da trava é a falha agendada, e a coluna de evento da aba Actions (schedule versus push) é como você distingue as duas. Enquanto espera, faça o passo 7. Quando a execução vermelha aterrissar, três coisas para coletar: a própria notificação (tela ou e-mail, essa é a prova da trava), o log da execução na aba Actions mostrando a sua falha deliberada, e uma medição. Compare a hora real de início da execução com o minuto agendado do cron, para as últimas execuções já que você está ali, e escreva o desvio num comentário no arquivo do workflow. Esse número é seu, medido. Depois reverta o commit que quebrou, e veja a próxima execução ficar verde. Quebrado, ouvido, consertado, verificado: esse ciclo é o exercício, e você só confia em alarmes que você já ouviu.
A varredura de segredos. Crie SECRETS.md no repo da estação (ou uma seção do seu runbook, m10-l1 vai absorver de um jeito ou de outro) e complete esta tabela para a sua estação de verdade, uma linha honesta por plataforma:
| Plataforma | Config commitada | Dev local | Segredos de produção | Notas de operação |
|---|---|---|---|---|
| GitHub Actions | YAML do workflow, sem valores | n/a, roda remoto | repo secrets, injetados via env: | notificações se prendem ao criador do workflow; desabilitar e depois reabilitar reatribui elas; agendamentos de repo público se auto-desabilitam depois de 60 dias ociosos |
| Vercel | vercel.json | vercel env pull para um .env.local gitignorado | env vars por ambiente, painel ou CLI | tamanho total das env vars, nomes e valores, com teto de 64KB; valores com prefixo VITE_ são assados no bundle público por design |
| Cloudflare | config do wrangler, vars só para config pública | .dev.vars, gitignorado | npx wrangler secret put <KEY> | só de escrita depois de definido; visível como nome, nunca como valor |
| Docker / local | compose.yaml, Dockerfile, sem segredos em ENV | --env-file / env_file do compose, node --env-file para Node pelado | não é uma plataforma de prod aqui; imagens ficam livres de segredos | docker history imprime toda camada da imagem, incluindo qualquer ENV que você tenha assado ali |
Depois verifique a afirmação central da tabela mecanicamente: git grep -i pelos nomes e valores dos seus segredos de verdade encontra só nomes de binding, nunca um valor, no repo, na config do wrangler e em todo Dockerfile. Confira de novo a regra anti-vazamento da teoria: passe os olhos nos seus três call sites de logEvent/log_event e confirme que nenhuma chamada serializa um ambiente, um objeto de config ou o contexto completo de um erro capturado.
Commite a camada de ops. Nada acima se commitou sozinho, e m10-l1 assume que esse estado está no repo:
git add -A
git commit -m "ops layer: structured events, alarm drill, secrets sweep"
git push
Todo seu. Escolha uma pergunta de incidente que os seus eventos atuais não conseguem responder. O exemplo trabalhado do gênero: "quanto tempo durou o último episódio degradado?", que hoje exige olhar dois greps e fazer aritmética de timestamp na mão. Escolha a sua pergunta, depois adicione o único evento ou campo que torna ela respondível com um grep só (para o exemplo: um campo recovered na virada para up carregando segundos-desde-degraded, ou um evento episode dedicado na recuperação). Reencene o incidente de desconexão de rede e demonstre o grep respondendo a sua pergunta em uma linha. Aceitação: o campo ou evento novo aparece no emit de exatamente uma fronteira, o schema continua livre de segredos, e o pipeline que responde é um comando único que você cola no SECRETS.md sob um novo título ## Incident queries, a primeira entrada de uma lista que vai crescer (o runbook de m10-l1 absorve o arquivo inteiro; recommite depois de colar).
A trava, três provas, casando com as três promessas da lição. Uma: o grep de incidente, docker compose logs pollerd passado por um filtro de state_change, responde "quando o alvo X foi para degraded pela última vez" com uma linha JSON que casa. Duas: o exercício de alarme produziu uma notificação de verdade a partir de uma execução agendada deliberadamente quebrada, e a execução depois do conserto é verde. Três: o SECRETS.md cobre as quatro plataformas e o repo dá grep limpo de valores de segredo. Se as três valerem, a estação está observada, alarmada e higiênica.
A recuperação de 30 segundos antes de você fechar a aba: quais são as três maneiras de o cron parar sem nenhuma notificação de falha, e onde mora a defesa da estação contra a morte silenciosa? Você está buscando: descartado sob carga, auto-desabilitado em 60 dias, fork desligado por padrão; e o batimento persistido, os timestamps de status.json, onde a ausência é visível para qualquer coisa que olhe.
Se a superfície de log de uma plataforma se comportar diferente do que esta lição afirmou (janelas de retenção e cotas são os fatos que mais mudam neste curso, e fornecedores mexem neles sem cerimônia), mande a plataforma e o que você viu pelo feedback do curso; as caixas de restrição acima são resondadas exatamente a partir desses relatos.
Todo degrau da escada agora está construído: a estação está auditada, observada e alarmada. Uma coisa nunca aconteceu. Tudo isso, montado e verificado de ponta a ponta, como um sistema só, de memória. Isso é o capstone, e ele abre com você desenhando a estação inteira, todo componente e toda aresta, numa página em branco antes de fiar o painel final. Traga uma página em branco.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.