Cargando...

 BetaBeta
m06-l2 instaló un runtime de contenedores, construyó el modelo mental imagen-contenedor-capa-registro, y entregó la primera imagen ingenua del poller, con su peso de varios gigabytes dejado en tu pantalla a propósito. Hoy ese peso se va. Una idea, aplicada dos veces: construye en una caja, entrega solo lo que corre en otra. La imagen de Rust recibe el tratamiento de cargo-chef, tres etapas de build más un runtime de debian slim; la flota de TS recibe su propio build multi-stage de node slim; las dos se miden contra tu baseline registrado. En el camino el fleet-runner gana un modo de servicio por intervalos, porque un contenedor quiere un solo proceso de primer plano y de larga vida, no un script que sale. El contrato de repliegue: el Dockerfile de Rust está trabajado por completo, el Dockerfile de node lo escribes tú a partir del mismo patrón con TODOs solo en las fronteras de etapa, y el challenge del .dockerignore es enteramente Solo. Las rueditas de Contenedores 101 ya salieron.
Empieza con la evidencia. Terminal abierta, antes de cualquier lectura:
docker images pulse-pollerd
Ahí está, el número que anotaste la lección pasada, todavía en los gigabytes, para un binario que podrías adjuntar a un email. Y el peso no es una vergüenza de una sola vez sentada en tu disco. Cada máquina que alguna vez haga pull de esta imagen lo paga de nuevo: el runner de CI en cada push, el primer docker run de un desconocido, el tú del futuro en una laptop nueva, todos ellos descargando un toolchain completo de Rust y todo tu cache de build para correr unos pocos megabytes de poller compilado. Minutos y ancho de banda, multiplicados por cada pull, para siempre.
El arreglo es una sola idea, y quiero decirla en su forma más chica antes de cualquier sintaxis de Dockerfile. Un Dockerfile de una sola etapa no puede distinguir "hace falta para construir" de "hace falta para correr", así que entrega los dos. Un Dockerfile multi-stage son solo dos cajas en un archivo: una caja de build con el toolchain entero, y una caja de runtime que arranca casi vacía. Entre ellas, una instrucción, COPY --from, lleva los artefactos hacia adelante. Y acá está la regla que decide todo sobre lo que se entrega: la imagen final es la base de la etapa final más lo que le hagas COPY explícitamente adentro. Nada más. La caja de build, gigabytes de ella, se queda atrás en la máquina de build como un andamiaje después de que el edificio abre.
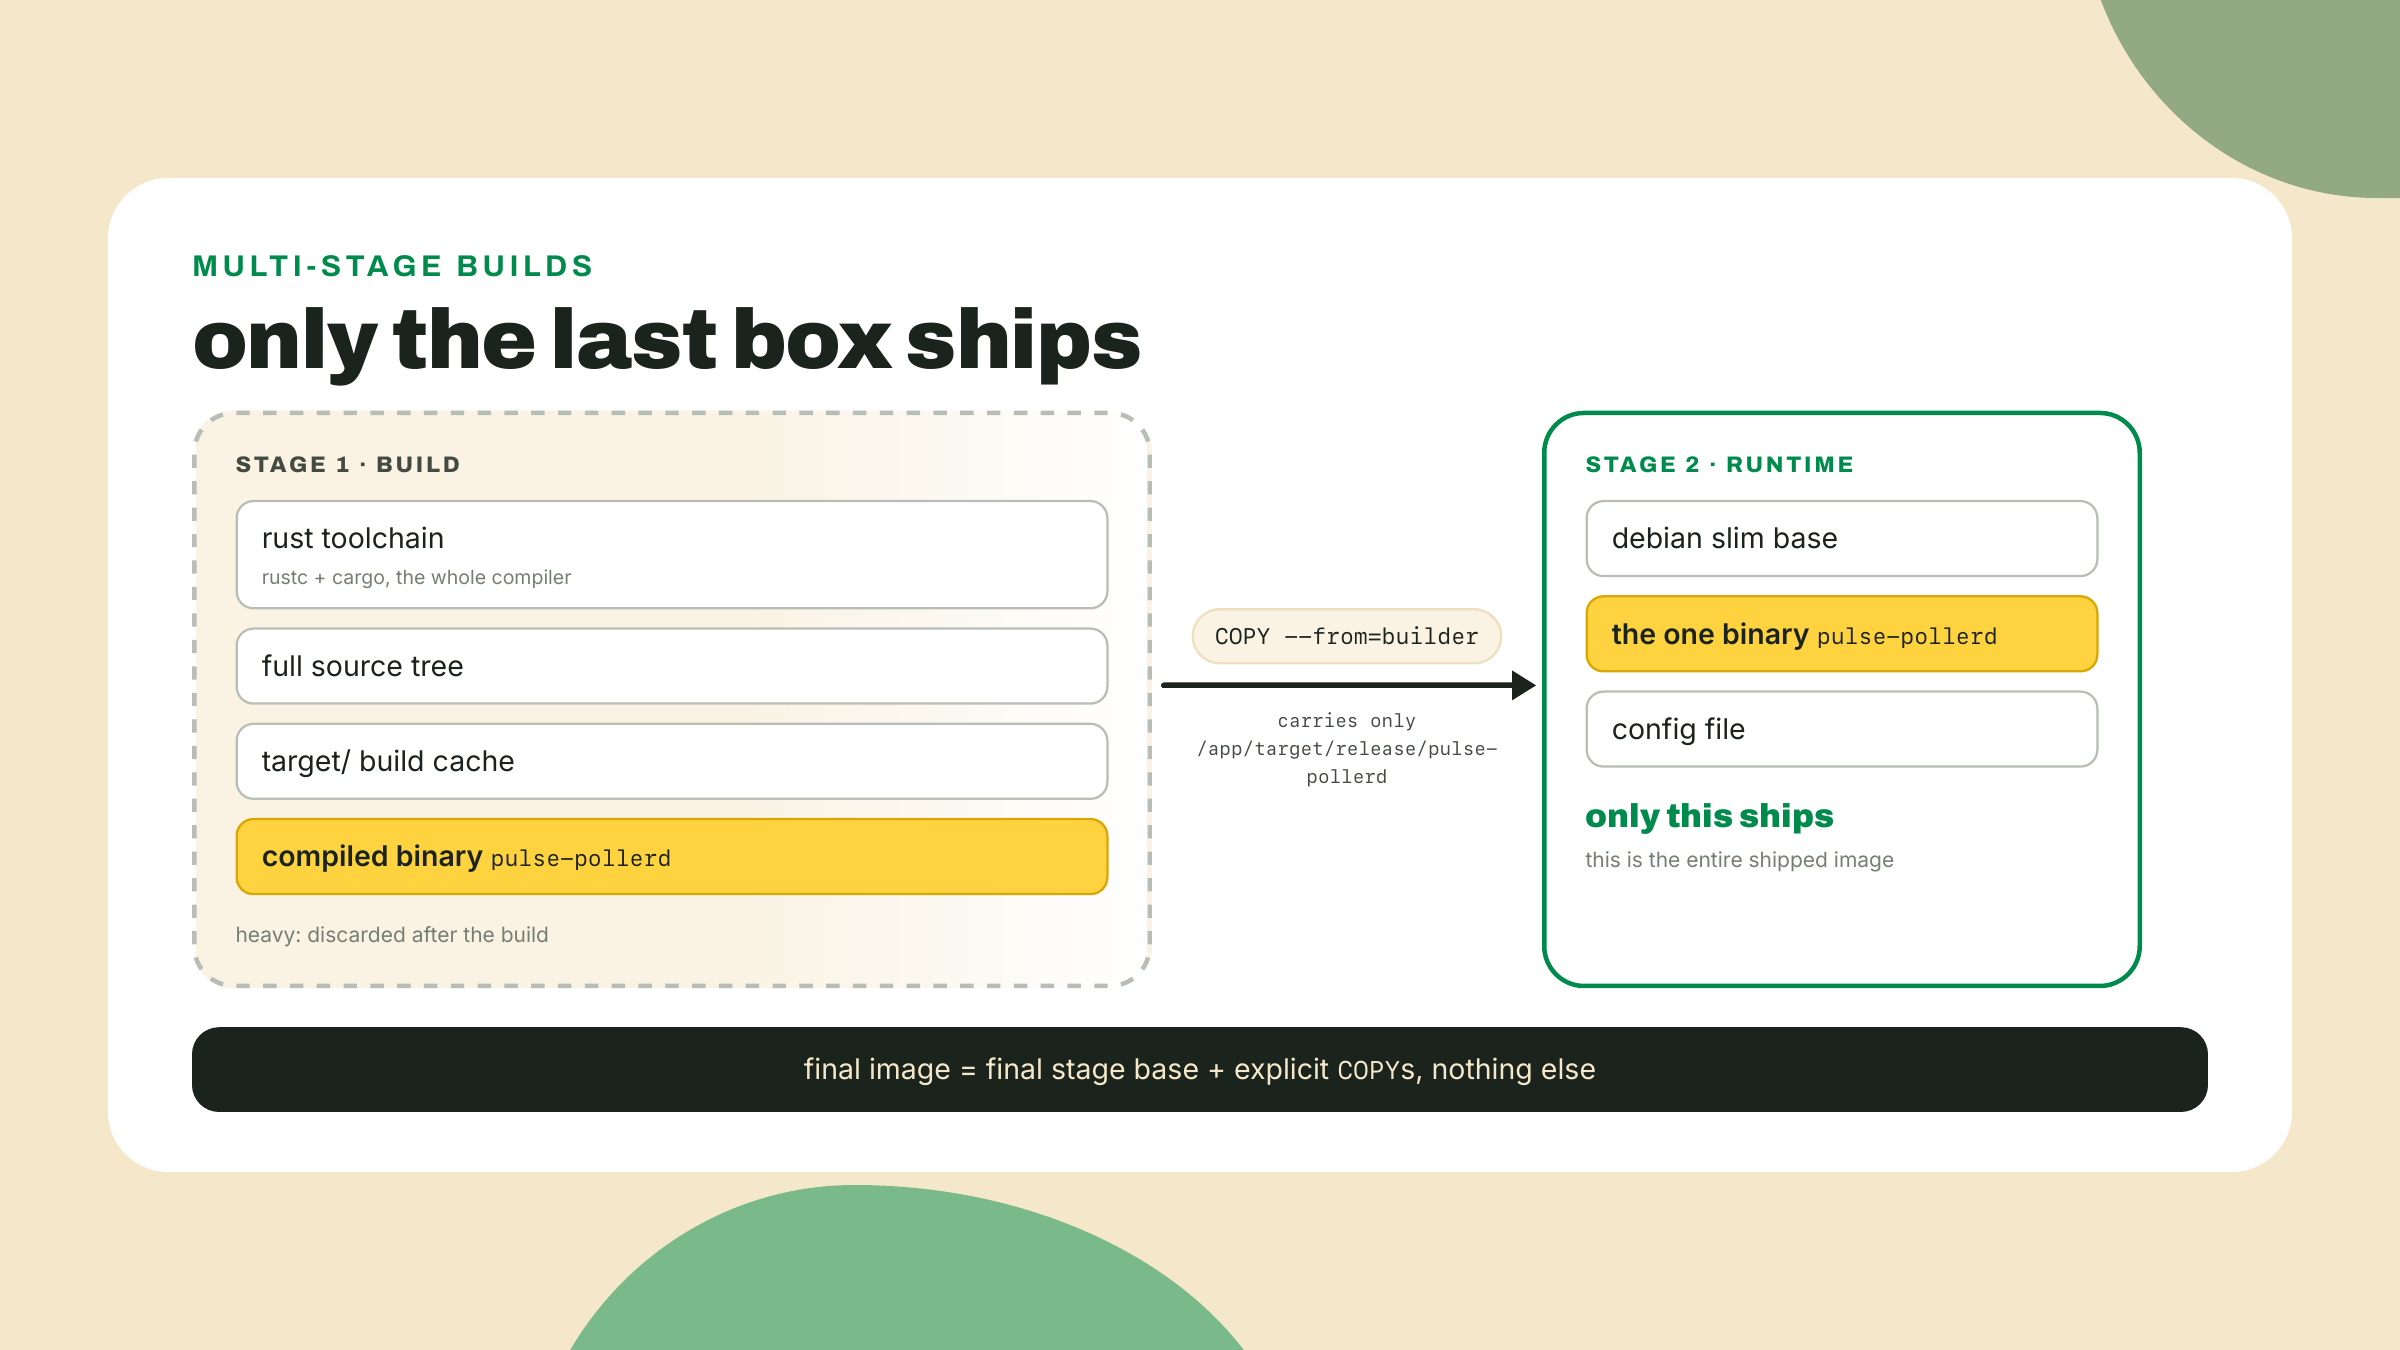
Esa es toda la idea. Todo lo demás es ingeniería alrededor de dos preguntas de seguimiento: ¿cómo mantienes rápida la caja de build cuando la reconstruyes cincuenta veces por día, y qué tan chica debería ser honestamente la caja de runtime?
La imagen ingenua tenía un segundo problema escondido detrás de su tamaño, y lo sentiste en el lab: cada reconstrucción era un cargo build --release en frío del workspace entero. El culpable es el orden en que se invalida el cache de capas (Docker reusa una capa cacheada solo si la instrucción y cada input arriba de ella siguen sin cambios; la primera capa que cambia invalida todo lo de abajo). Nuestro archivo ingenuo hacía COPY . . y después construía, lo que quiere decir que cualquier edición a cualquier archivo, un comentario en main.rs, un typo en el README, invalidaba la capa de copia y forzaba a la capa de build a recompilar cada crate de dependencia desde cero. Las dependencias no cambiaron. Tokio no cambió. Las pagaste igual, cada vez.
El arreglo es el cacheo de la capa de dependencias: arma el Dockerfile para que las dependencias compilen en su propia capa, con clave solo en los manifests, y tu fuente llegando después. Entonces una edición solo de código invalida las capas baratas de fuente y la capa cara de dependencias se queda cacheada. Cargo hace esto incómodo de hacer a mano, porque cargo build quiere archivos de fuente reales presentes, no solo Cargo.toml. Que es exactamente el hueco que cargo-chef existe para llenar.
cargo-chef (0.1.78, verificado contra crates.io el 2026-09-02) es un subcomando de cargo con dos verbos. cargo chef prepare escanea tu workspace y escribe un archivo de recipe, una descripción JSON de tu grafo de dependencias con tu fuente quitada. cargo chef cook construye solo las dependencias a partir de ese recipe, un target/ lleno de crates compilados y nada tuyo. El recipe solo cambia cuando cambian tus manifests, así que la capa de cook sobrevive cada edición de código que hagas en tu vida. Su README afirma builds hasta 5x más rápidos; ese es el número del autor, y el paso 3 te hace medir el tuyo. Un crédito, porque el origen es bueno: Luca Palmieri escribió cargo-chef para Zero to Production in Rust, y el Dockerfile de tres etapas que estás por escribir está sacado de su README a propósito. No reinventes una rueda que el ecosistema ya probó bajo carga.
El canon del README son cuatro etapas, tres para construir (chef, planner, builder) más la caja de runtime que se entrega, y la forma importa más que la sintaxis:
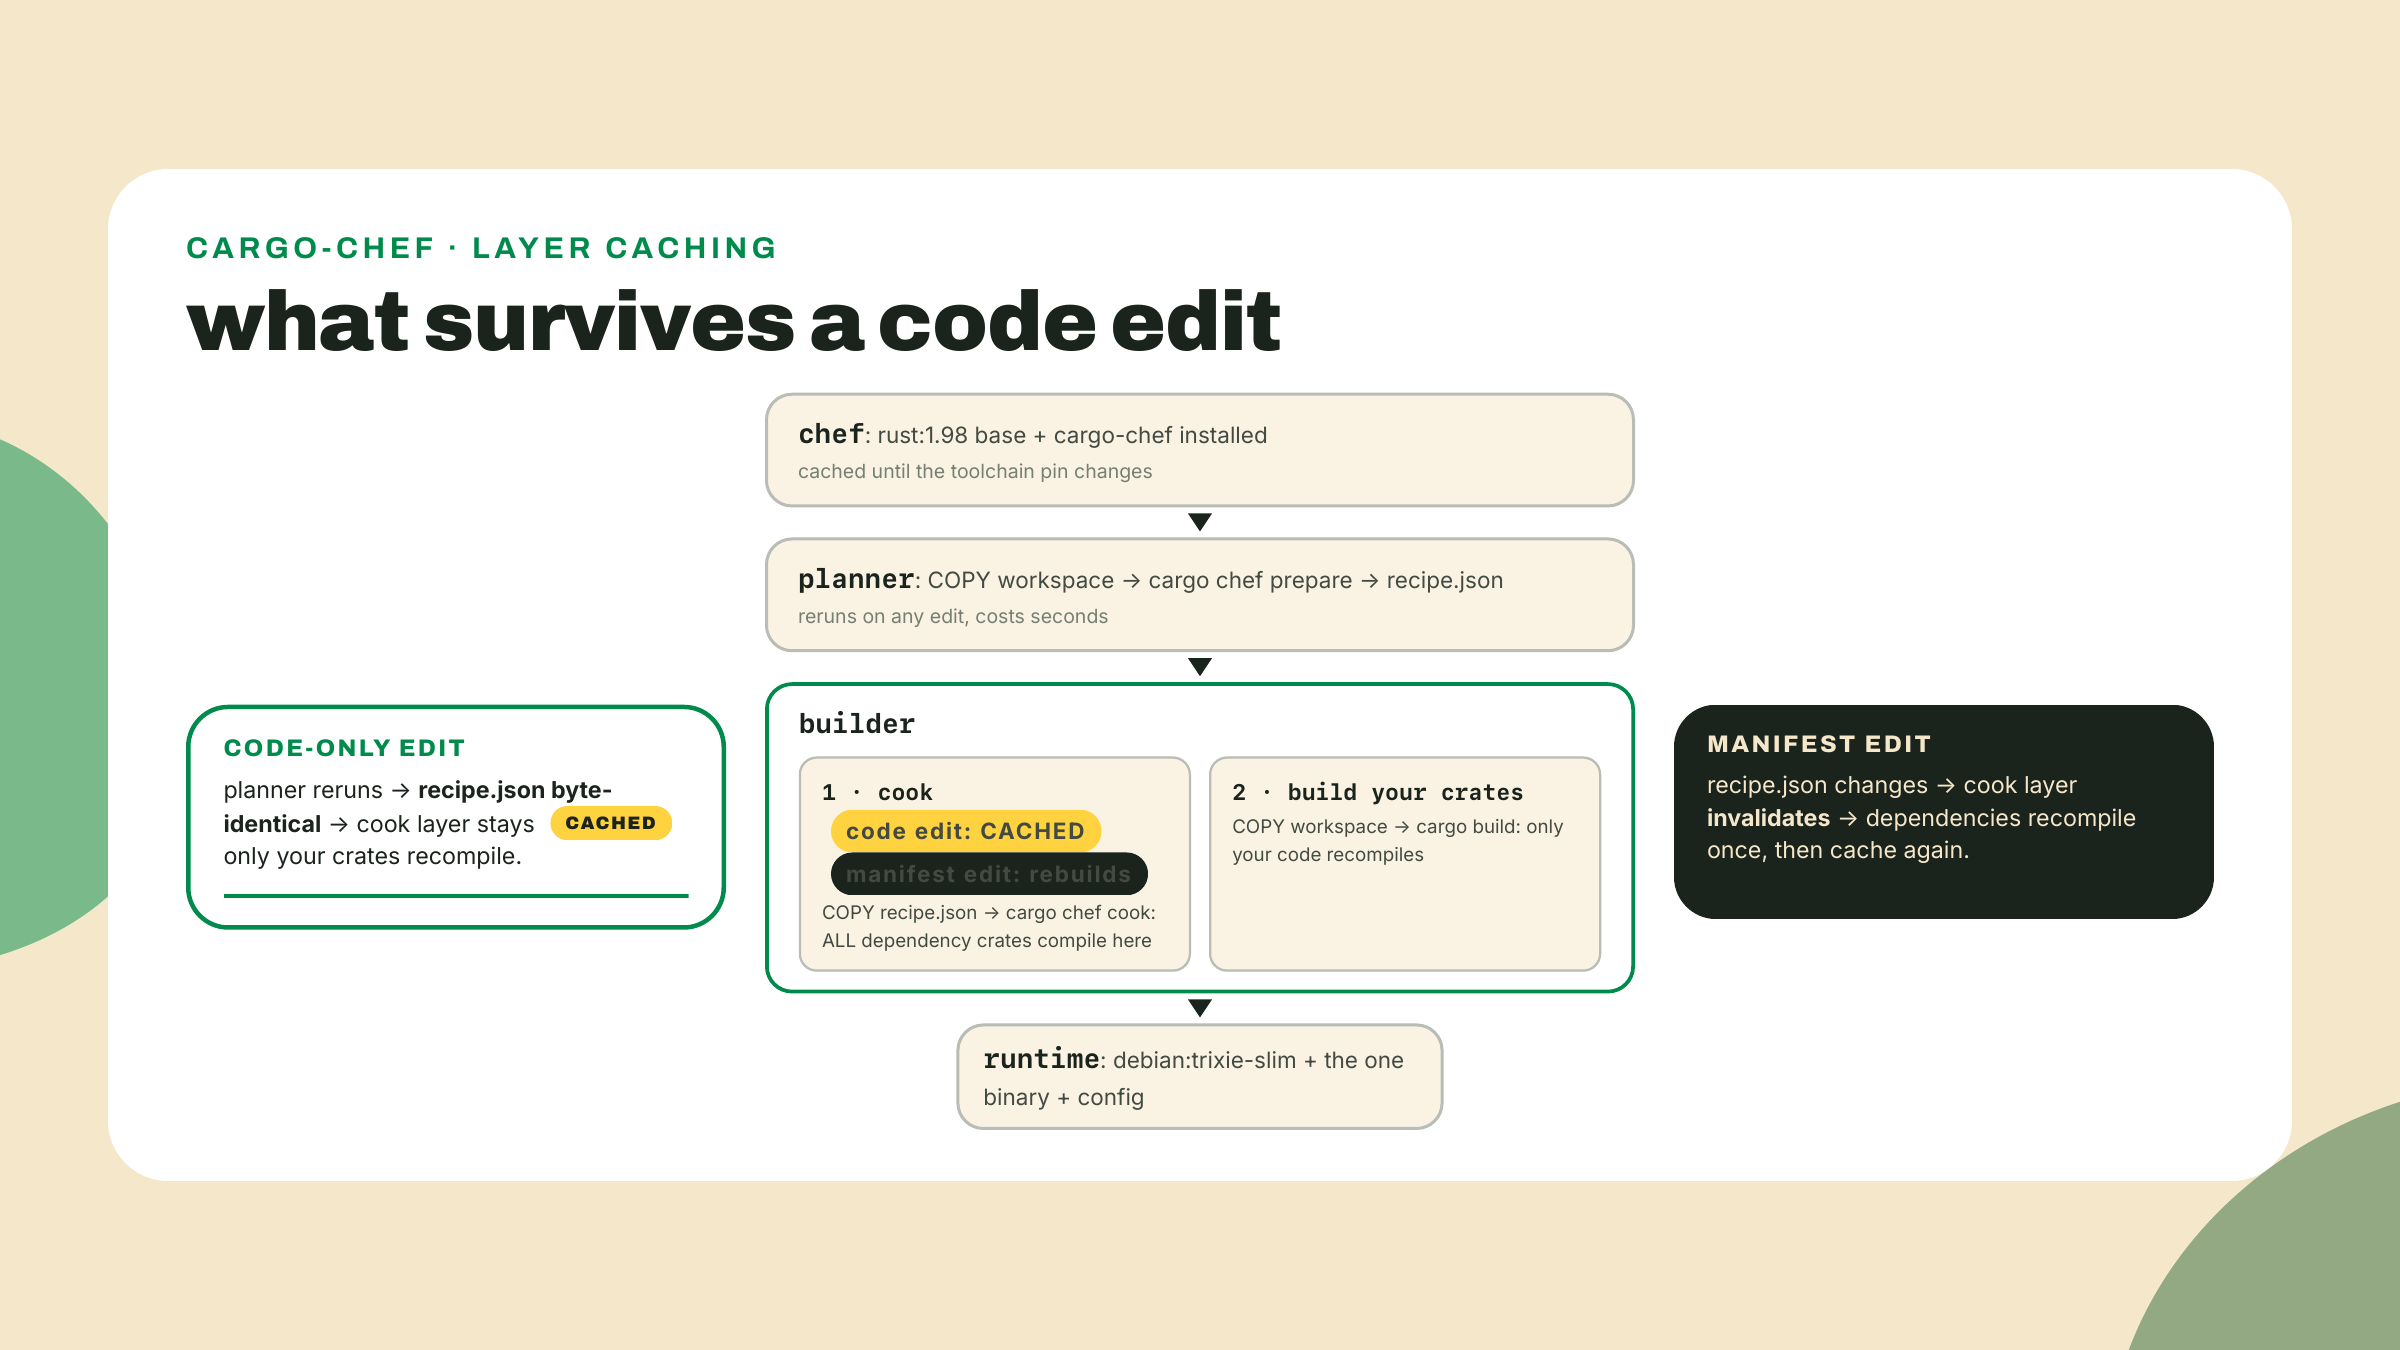
¿Por qué existe siquiera la etapa planner, en vez de cocinar directo? Porque el recipe es la clave del cache. prepare vuelve a correr en cada edición, pero es barato y su salida es determinista: entran los mismos manifests, sale un recipe.json byte-idéntico. La etapa builder copia solo ese archivo antes de cocinar, así que Docker compara el recipe, no ve cambio, y se saltea el cook. Tu compilación de dependencias ahora tiene su clave en tu grafo de dependencias en vez de en tu árbol de fuentes, que es lo que queríamos todo este tiempo.
La flota tiene la misma enfermedad en un cuerpo distinto. Una imagen ingenua de node haría COPY . . y pnpm install, y cada edición de fuente volvería a descargar y a re-enlazar el árbol de dependencias entero. La cura es la misma idea, y acá la ves sin una herramienta que ayude, porque los manifests de node alcanzan solos: copia primero el lockfile y los archivos package.json, instala en su propia capa, y solo después copia la fuente. cargo-chef automatiza para Rust exactamente lo que estás por hacer a mano para node. Una vez que escribiste los dos, ninguno es magia.
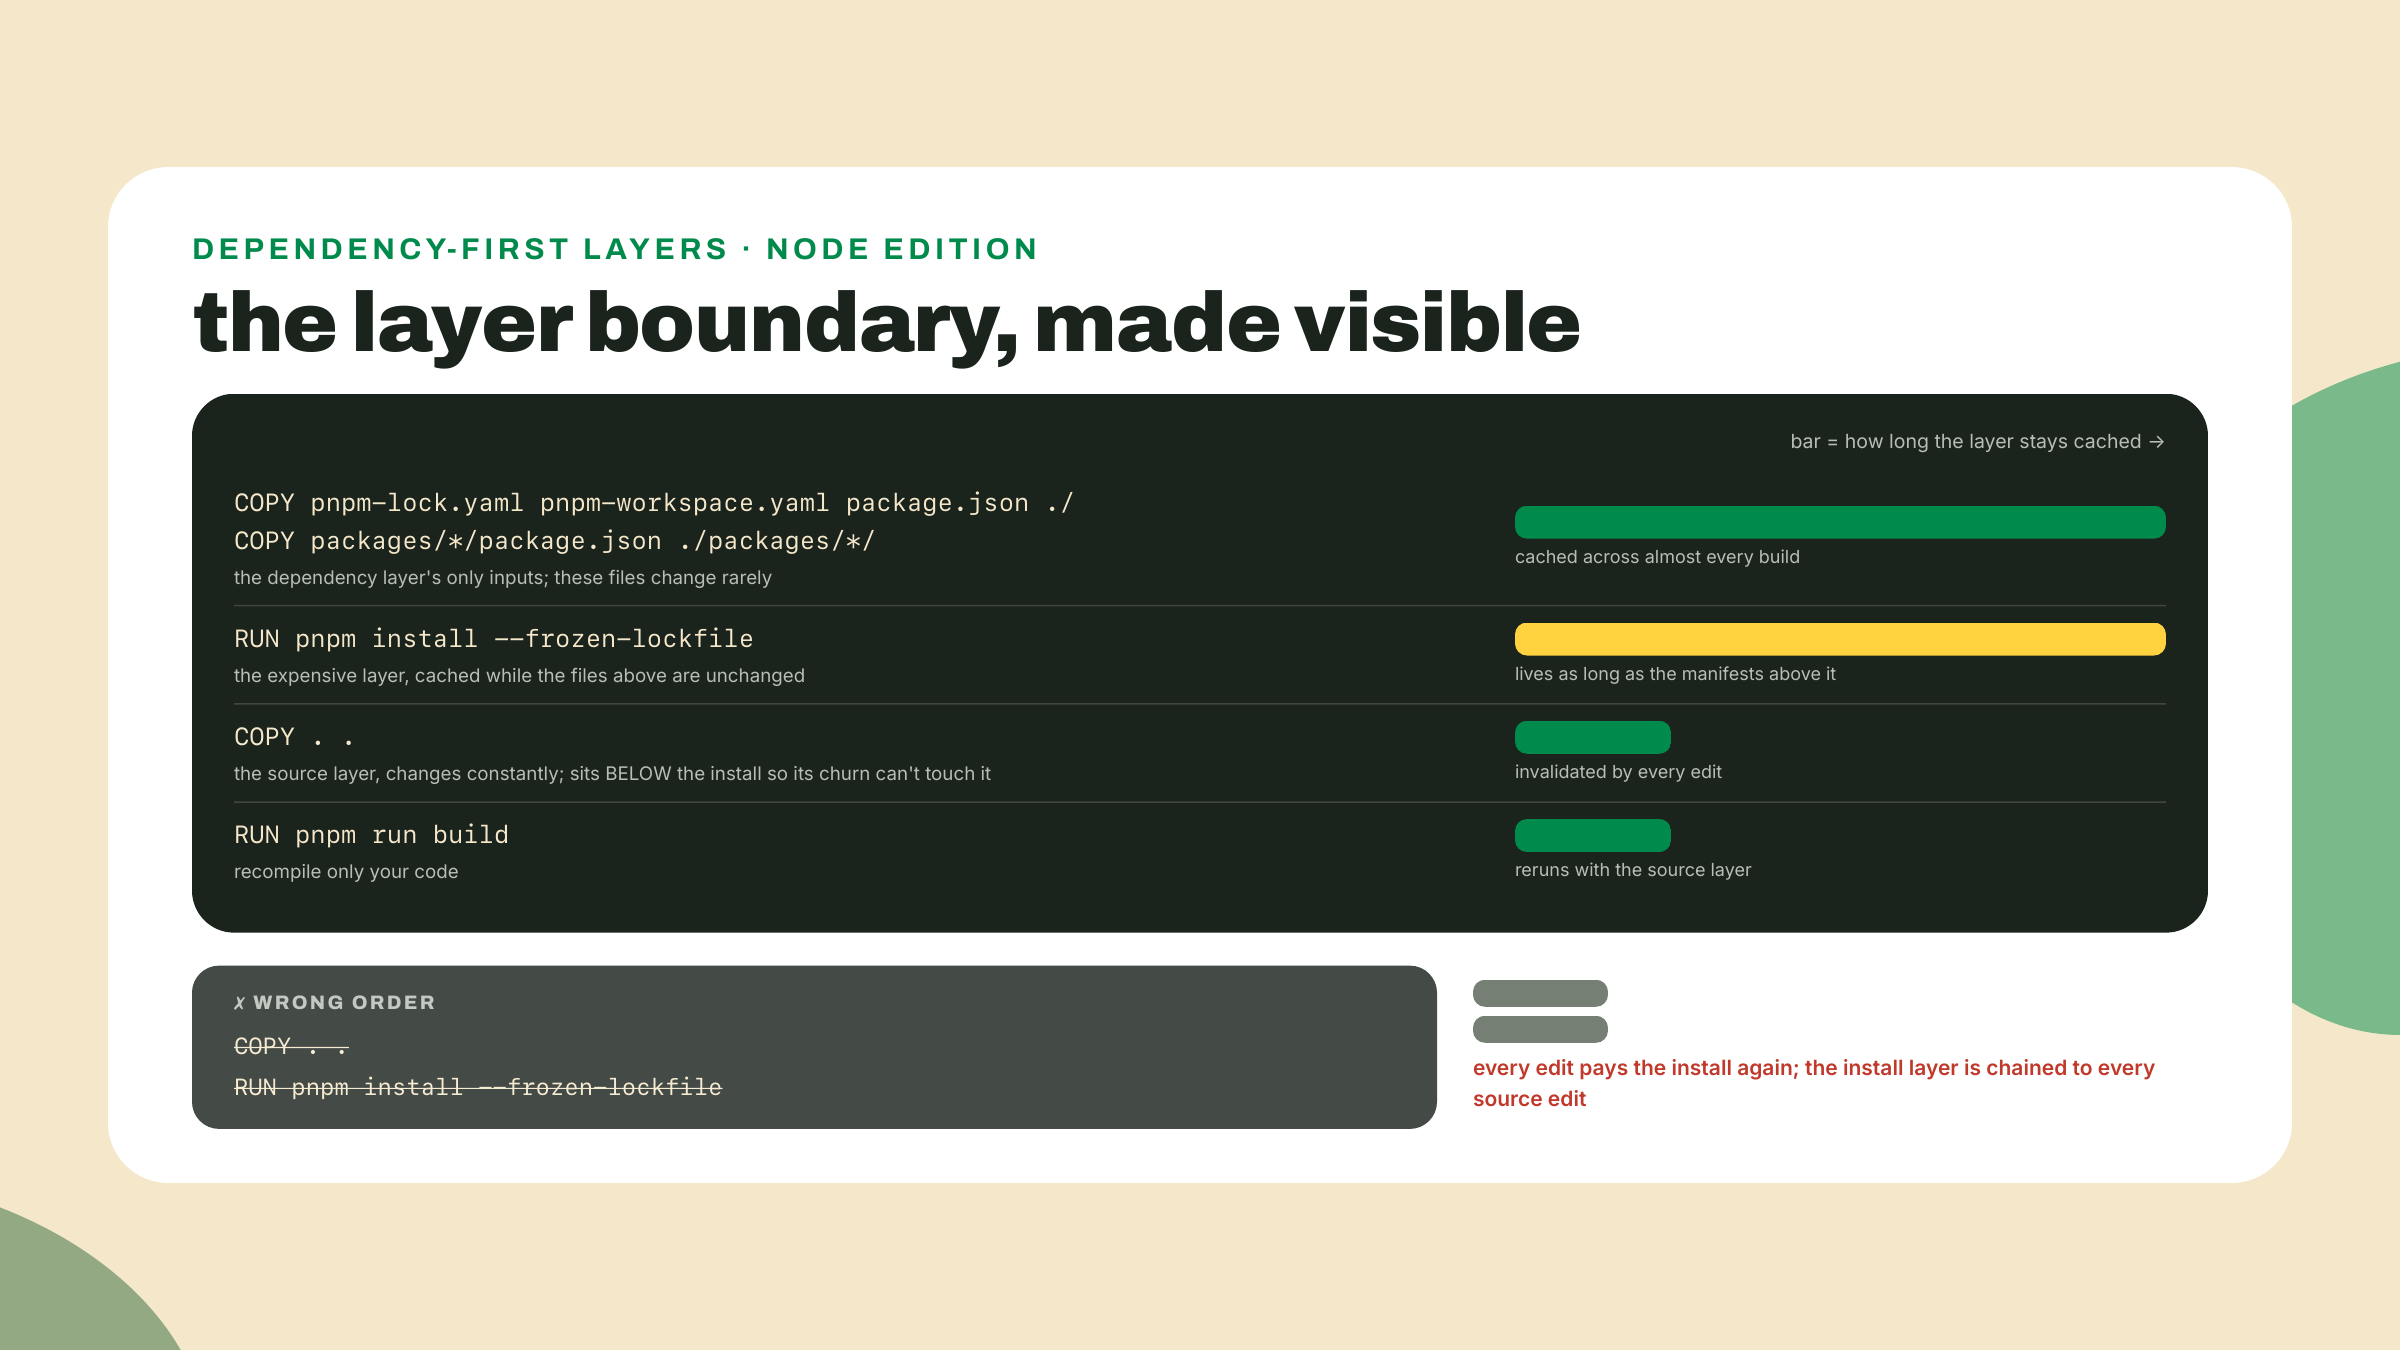
Dos decisiones específicas de node en esa imagen merecen su por qué. La base es node:24-slim: Node 24 es el LTS activo al 2026-09-02 (Node 26 toma la antorcha el 2026-10-28; el dígito sube, nada más cambia). Y pnpm se instala explícitamente, npm i -g pnpm@11.25.0, no el one-liner corepack enable de Dockerfiles más viejos: el 2025-03-19 el TSC de Node votó a corepack afuera, y desde Node 25 en adelante no viene en la caja. Node 24 todavía lo trae, así que la línea vieja funciona hoy y se rompe en el próximo bump de base, la peor clase de funciona. Un build de imagen quiere pasos deterministas y autocontenidos, así que instala la herramienta que necesitas, fijada. Y el dígito acá no es una afirmación de frescura, es un acuerdo: 11.25.0 es lo que dice el campo packageManager de m03-l1, y una imagen cuyo pnpm no coincide con el del workspace va a discutir contigo en --frozen-lockfile. El latest de npm desde entonces se movió a la línea 12 (12.3.4 el 2026-09-06, con 11 siguiendo vivo bajo latest-11), que es el punto más que un problema: un Dockerfile que tomara lo que latest sirviera el día del build habría cambiado en silencio de major de pnpm entre dos builds del mismo commit. Coincide con el workspace, no con el tag.
Una costura más, y es la interesante. ¿Por qué no simplemente hacer COPY --from del node_modules construido a la etapa de runtime, como copiamos el binario de Rust? Porque el node_modules de un workspace de pnpm es una red de symlinks hacia adentro del workspace, y las dependencias de pulse-fleet incluyen pulse-core, que vive afuera de cualquier cosa que copiarías ingenuamente. Lleva el directorio afuera del contexto y los links quedan colgando. pnpm trae un comando exactamente para esto: pnpm deploy extrae un paquete de un workspace hacia un directorio autocontenido, archivos reales, solo dependencias de producción, paquetes del workspace incluidos. La última línea de la etapa de build va a ser:
pnpm --filter pulse-fleet --prod deploy --legacy /out
Lo corremos con --prod y con --legacy, y la flag legacy merece honestidad: el deploy actual de pnpm quiere una opción a nivel de workspace llamada inject-workspace-packages, que sacrifica la frescura de symlinks en la que tu loop de dev se viene apoyando desde m03-l4. El copiador legacy no pide ese trade-off y es exactamente lo correcto adentro de una etapa de build descartable. Los dos comportamientos están documentados en la página de deploy de pnpm, verificado el 2026-09-02.
Voy a confesar de dónde vino la matrícula de este patrón, porque la pagué en la moneda más estúpida, esperando. Un viejo proyecto de panel mío tenía COPY . . sentado una línea arriba del install. Cada commit, y digo cada commit, CI volvía a descargar el universo de node, cuatro minutos extra, docenas de veces por semana, durante meses. Nadie lo notó porque siempre había sido así de lento. El arreglo fue mover una línea dos líneas para arriba. Lee tus logs de build de la forma en que leíste docker history la lección pasada; lo lento que está distribuido de forma pareja se siente como el clima, y casi siempre es una sola capa mal ubicada.
Hay un desajuste que veníamos ignorando con cortesía: el poller es un daemon, nacido para correr para siempre, pero el fleet-runner es un script. Barre sus targets una vez, escribe sus resultados, y sale, porque el cron de GitHub Actions lo vuelve a invocar según un calendario y esa era la forma correcta para ese hogar. Mete esa forma en un contenedor y obtienes una caja que arranca, trabaja por dos segundos, y muere. Compose, la lección que viene, lo reiniciaría obedientemente para siempre, y vi equipos entregar exactamente eso: una política de restart haciendo cosplay de scheduler, logs que se leen como una crónica de crashes, arranque de proceso pagado en cada barrido. Puedes reconocer el anti-patrón desde una sola celda de docker ps:
STATUS
Restarting (0) 2 seconds ago
Código de salida cero, reiniciando igual, para siempre. Las políticas de restart son para recuperarse de una falla. Planificar es el trabajo del programa. Un contenedor quiere un solo proceso de primer plano y de larga vida, así que el arreglo honesto es darle al runner un modo de servicio de verdad, un loop de intervalo en el código mismo, construido en esta lección, no asumido. Ese es el paso 4 del lab, y la flag que agrega es una interfaz: el archivo compose de la lección que viene la maneja a través de una variable de entorno, así que los nombres que elegimos hoy quedan congelados en el momento en que los elegimos.
Ahora la pregunta que todo tutorial de contenedores responde demasiado rápido: ¿qué tan chica debería ser la caja de runtime? La respuesta reflejo de internet es alpine, una distribución basada en musl cuya imagen base pesa alrededor de diez megabytes, y para la imagen de node los números incluso se ven amigables: el README de docker-node cita node:alpine como alrededor de 25% más chico que node:slim. Para Rust, la misma jugada significa construir contra x86_64-unknown-linux-musl y entregar un binario estático a una caja diminuta. Imagen más chica, pulls más rápidos, ¿cuál es el pero?
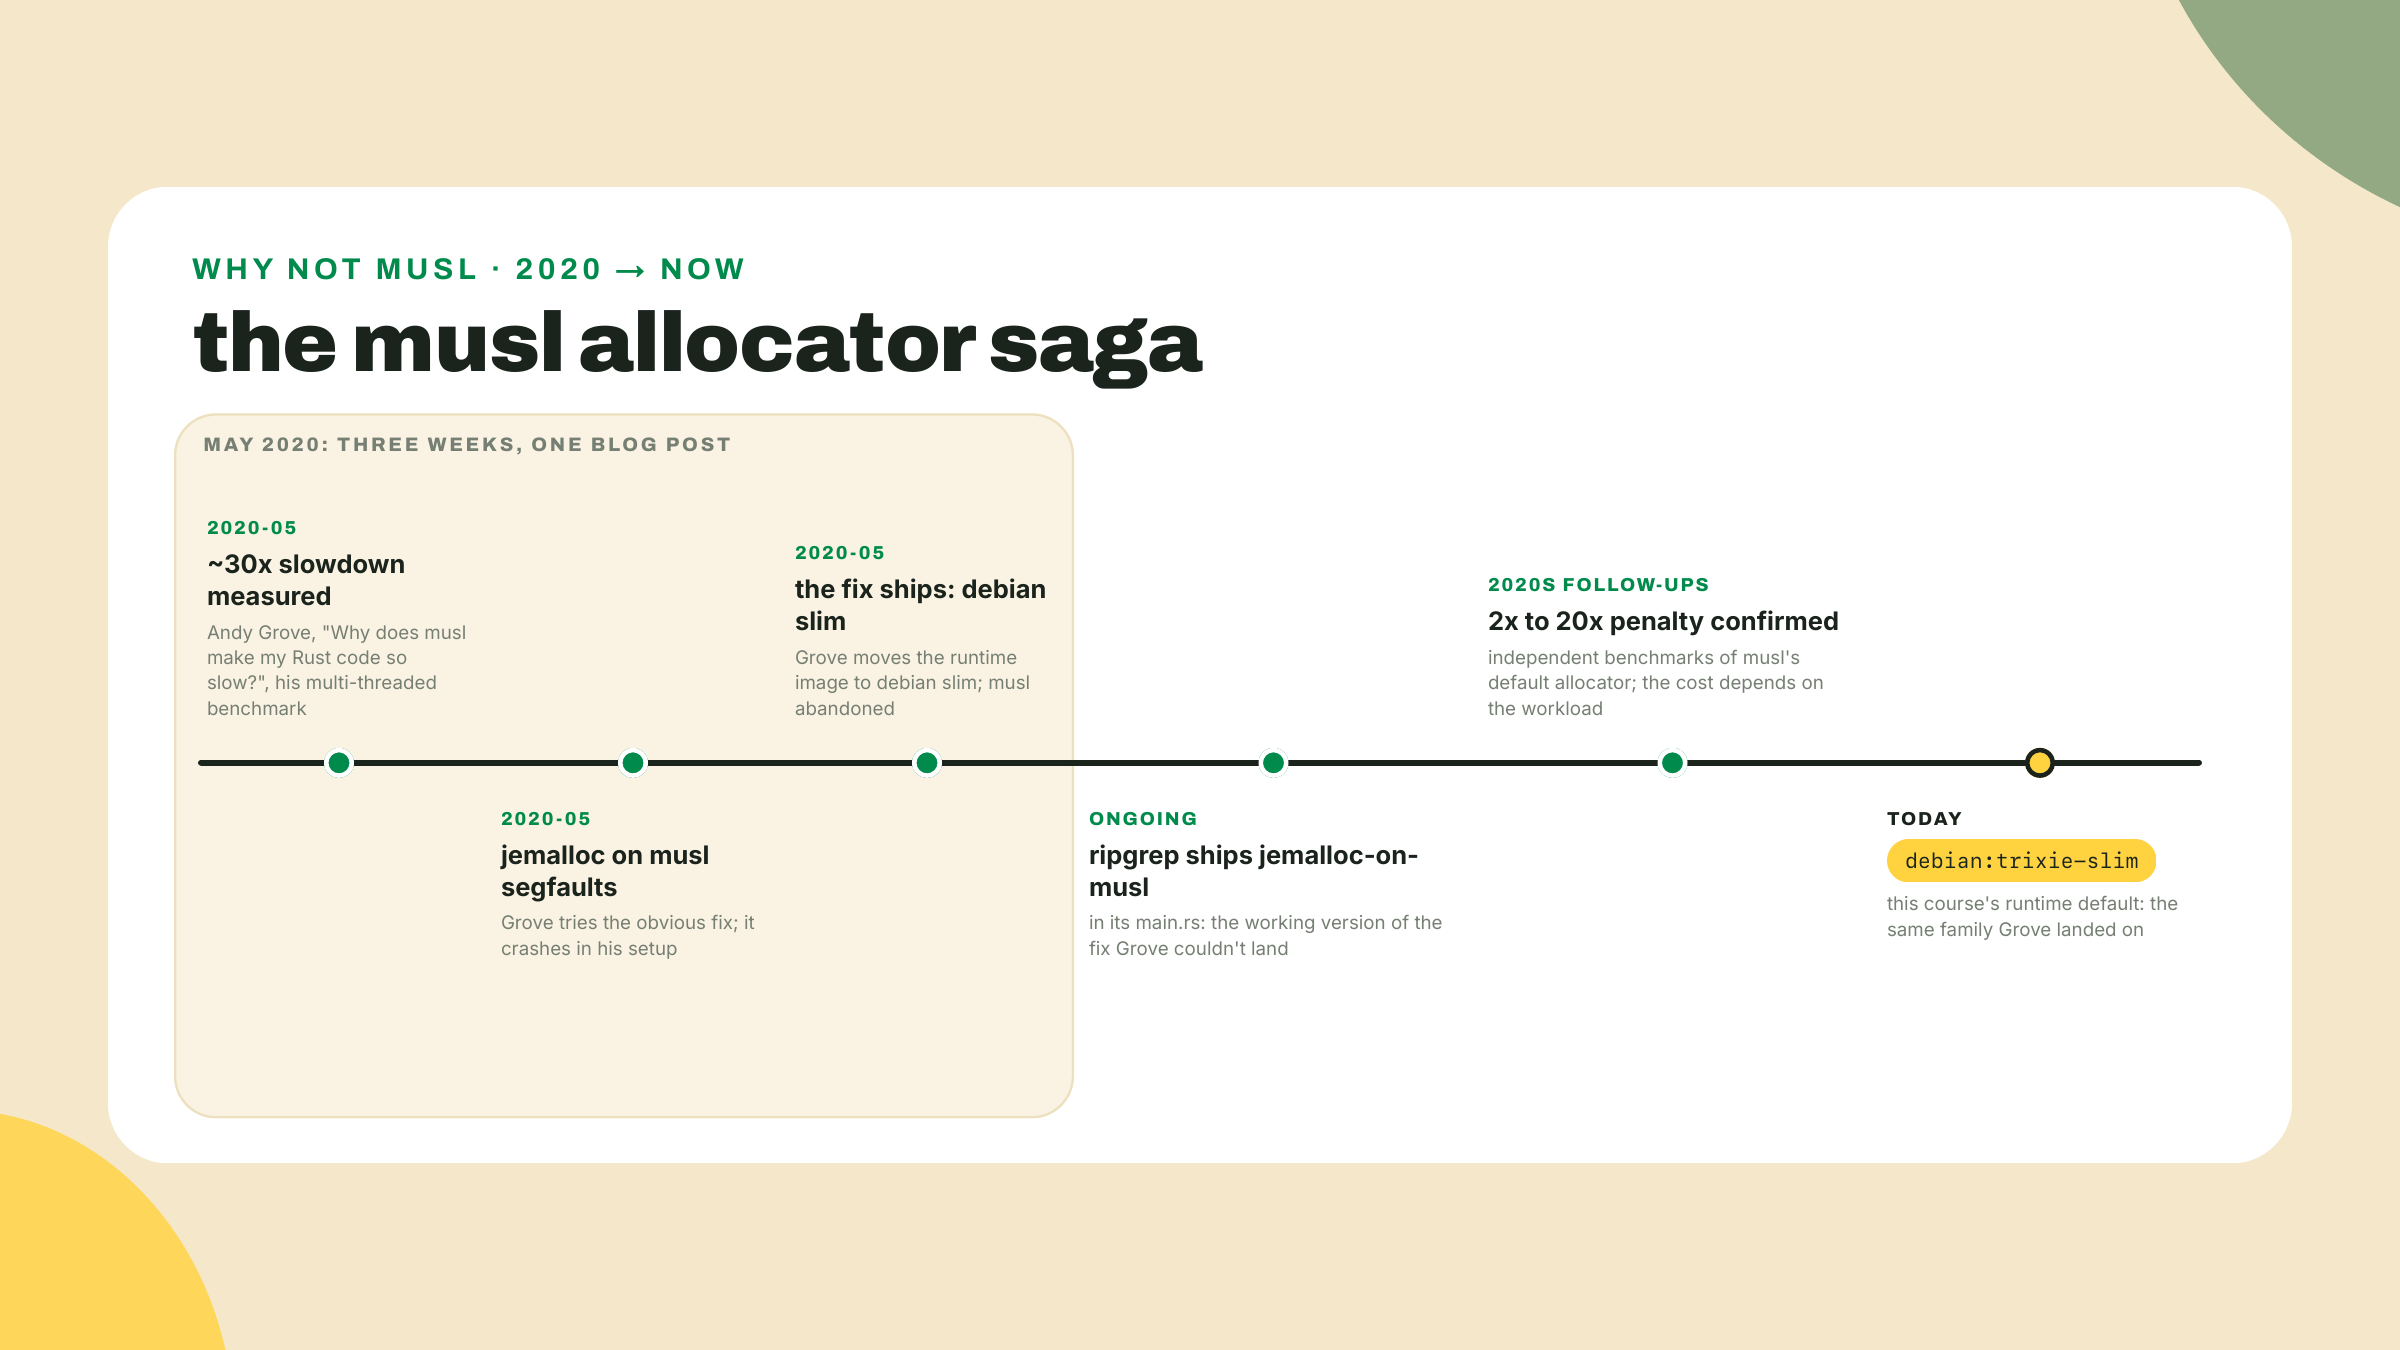
El pero tiene nombre y fecha. En mayo de 2020, Andy Grove de Apache Arrow y DataFusion publicó "Why does musl make my Rust code so slow?": su benchmark multi-thread corrió alrededor de 30x más lento en musl que en glibc. No por ciento. Veces. El culpable es el allocator por defecto de musl, que se degrada fuerte bajo asignación multi-thread, y nuestro poller es precisamente un proceso de tokio multi-thread. Mediciones posteriores ponen la penalidad entre 2x y 20x según la carga de trabajo; cada número le pertenece a su benchmark, no al tuyo. Grove probó el arreglo estándar, jemalloc. Dio segfault. Su arreglo real fue pasar a debian slim y abandonar musl: el hombre que escribió la queja sobre musl aterrizó en la base exacta que enseña este curso. ripgrep fue por el otro camino y lo hizo funcionar, entregando jemalloc en sus builds de musl hasta el día de hoy. Las dos son respuestas de ingeniería honestas. Ninguna es "alpine es más chico, usa alpine".
Hay una segunda trampa de alpine, y esta no se degrada, detona. Un binario de Rust construido para el target musl enlaza musl estáticamente; las librerías propias de alpine, incluida su OpenSSL, enlazan musl dinámicamente. Mete en una caja de alpine un binario con musl estático que también enlaza OpenSSL de C y los dos musls se encuentran a la hora del handshake de TLS; el resultado documentado es un segfault. La feature vendored del crate openssl es una salida; el canon del curso es más directo y coincide con cada archivo de reglas de Rust en este repo: usa rustls, sin dependencia de TLS en C, sin choque de enlazado que tener. La parte satisfactoria: ya vives según eso. reqwest 0.13 usa rustls por defecto (verificado contra la lista de features de 0.13.4 en docs.rs), así que el poller de m06-l1 no tiene OpenSSL con el que chocar. Todavía necesita certificados CA para verificar los servidores que sondea, que es por qué la etapa de runtime instala exactamente un paquete, ca-certificates, y nada más.
Así que la comparación honesta, en los ejes que importan:
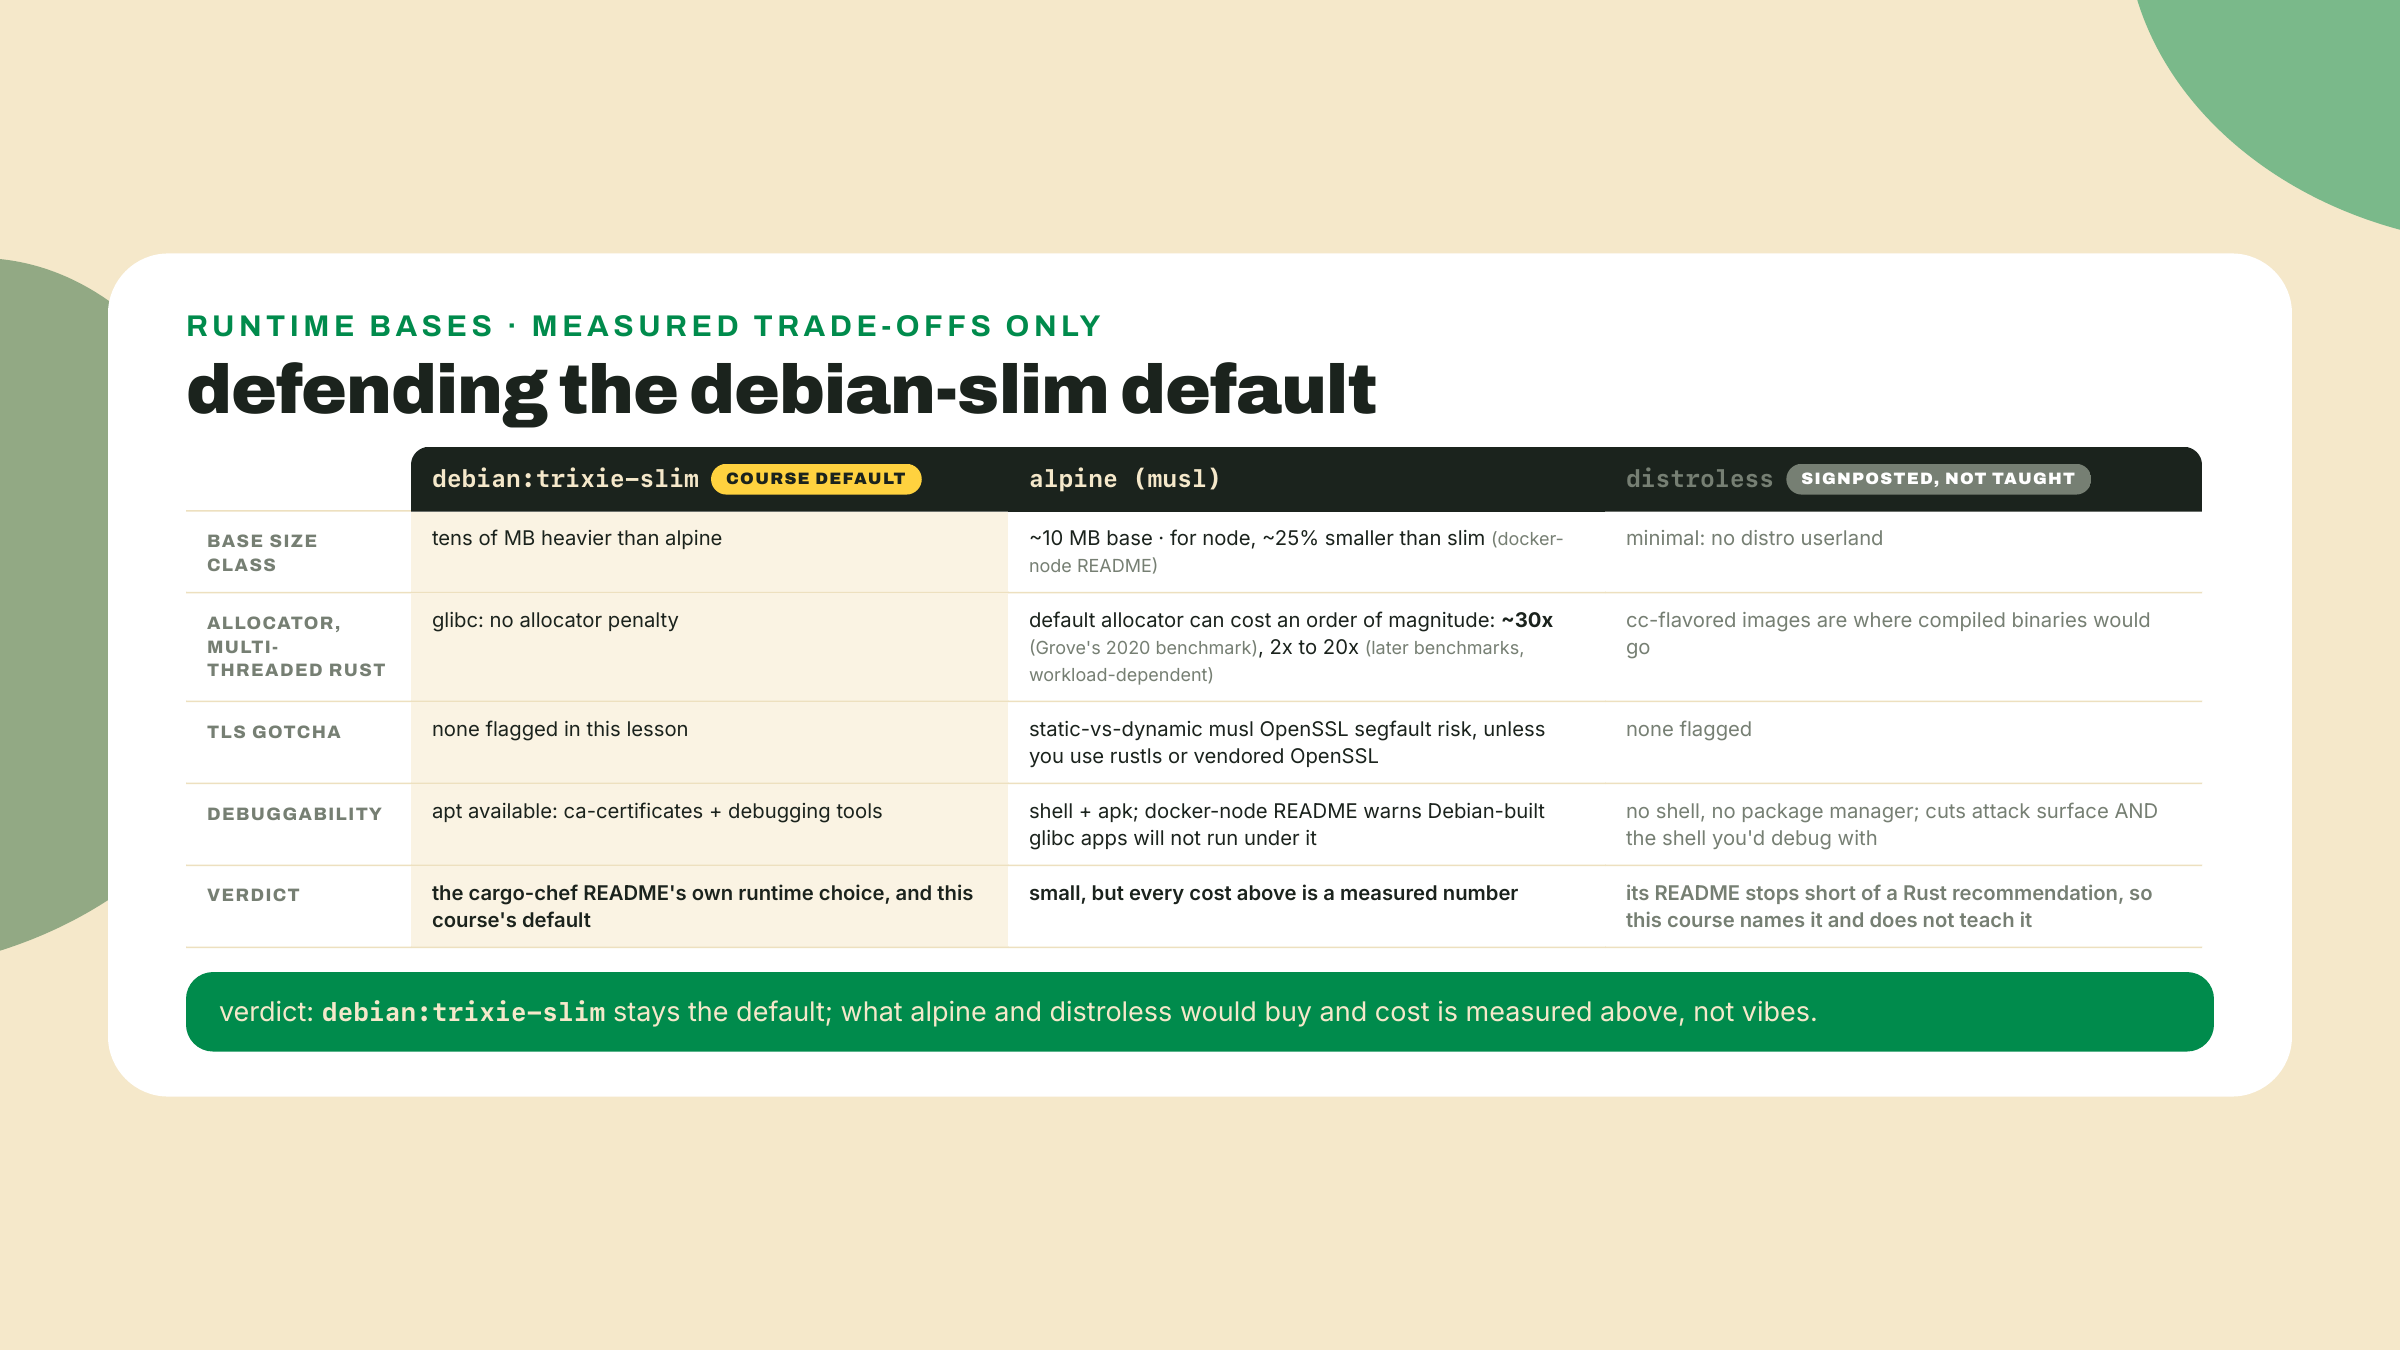
El trade-off, dicho una vez y sin adornos: la imagen más chica no es el binario más rápido. musl te compra una base de diez megabytes y puede costarte un orden de magnitud en el throughput del allocator; debian slim cuesta decenas de megabytes más y simplemente funciona; distroless recorta superficie de ataque y también recorta el shell que buscarías a las 2 a.m. Los builds multi-stage agregan su propio costo silencioso también, el que ahora sabes pagar: el orden de invalidación del cache se vuelve un asunto de diseño, y un Dockerfile con sus capas en el orden equivocado recompila el mundo en cada build mientras se ve perfectamente correcto. La elección de imagen base es un trade-off medido. Mide, elige, escribe el por qué en un comentario, sigue.
Dos terminales, dos workspaces: pulse-rs para el poller, pulse-station para la flota. Tu número de baseline ingenuo de m06-l2 va arriba de una nota borrador; cada medición de abajo aterriza al lado.
pulse-rs, reemplaza entero el Dockerfile ingenuo de la lección pasada. Este está trabajado por completo; lee las anotaciones contra el diagrama de flujo de cuatro etapas que está arriba:FROM rust:1.98 AS chef
RUN cargo install cargo-chef --locked --version 0.1.78
WORKDIR /app
FROM chef AS planner
COPY . .
RUN cargo chef prepare --recipe-path recipe.json
FROM chef AS builder
COPY --from=planner /app/recipe.json recipe.json
RUN cargo chef cook --release --recipe-path recipe.json
COPY . .
RUN cargo build --release --bin pulse-pollerd
FROM debian:trixie-slim AS runtime
RUN apt-get update \
&& apt-get install -y --no-install-recommends ca-certificates \
&& rm -rf /var/lib/apt/lists/*
WORKDIR /app
COPY --from=builder /app/target/release/pulse-pollerd /usr/local/bin/pulse-pollerd
COPY pulse.config.json .
ENV POLLER_PORT=8080
EXPOSE 8080
CMD ["pulse-pollerd"]
Las glosas, etapa por etapa. AS chef le pone nombre a una etapa para que etapas posteriores puedan hacerle FROM o COPY --from; la etapa chef es el toolchain compartido, rust:1.98 (el pin estable de la lección pasada, tag re-verificado el 2026-09-02) más cargo-chef instalado una vez, --locked para que se respete su propio lockfile, --version 0.1.78 para que la capa no cambie en silencio. El planner copia todo pero produce solo recipe.json. El builder copia solo el recipe, cocina las dependencias hacia la capa que sobrevive a tus ediciones, después copia tu fuente y construye tus crates. La etapa de runtime arranca desde debian:trixie-slim, la elección propia del README de cargo-chef, instala ca-certificates (un daemon de sondeo que no puede verificar TLS es un pisapapeles), y recibe exactamente dos archivos: el binario y la config. ENV POLLER_PORT=8080 mantiene funcionando tu challenge de m06-l2. Todo lo que crearon las etapas anteriores se queda atrás.
.dockerignore de la lección pasada sigue cercando target/ y .git/, así que la transferencia de contexto se mantiene chica. Después:docker build -t pulse-pollerd:slim .
docker images pulse-pollerd
El primer build es honesto sobre lo que cuesta: compila tu árbol de dependencias una vez adentro de la capa de cook, así que espera minutos, comparable al build ingenuo. El pago está en la columna SIZE: pulse-pollerd:slim debería aterrizar un orden de magnitud abajo de tu número ingenuo, de gigabytes a cientos bajos de megabytes; el mío midió 121 MB contra un ingenuo de 2.06 GB, un recorte de 17x, y la mayor parte del resto es la base slim de Debian misma más ca-certificates alrededor de un binario y un archivo JSON. Si algún tutorial te prometió megabytes de dos dígitos, ese es el barrio de alpine y de musl estático, y la sección de teoría ya le puso precio a ese viaje. Escribe el número al lado del baseline. Después demuestra que todavía funciona:
docker run --rm -p 8080:8080 pulse-pollerd:slim
Desde la segunda terminal, curl -s localhost:8080/status tiene que responder con el mismo JSON de siempre. Si en cambio el contenedor muere nombrando un archivo .so que falta, conociste la falla clásica de multi-stage: el "file not found" que en realidad es un error del linker, la etapa de runtime a la que le falta una librería compartida contra la que el binario enlaza. Volver a correr el contenedor que falla (docker run --rm pulse-pollerd:slim) imprime el nombre de la librería que falta; para la lista completa, corre ldd donde viven las herramientas y el binario de Linux, la etapa builder: docker build --target builder -t pulse-pollerd:builder . y después docker run --rm pulse-pollerd:builder ldd /app/target/release/pulse-pollerd. (Tu host no ayuda: macOS no tiene ldd, y tu binario del host no es el binario de Linux de todos modos.) Nuestra stack evita el caso común por construcción, rustls en vez de OpenSSL de C, pero el diagnóstico es tuyo de por vida.
Demuestra que el cache hace lo que afirmé. Abre cualquier archivo de fuente en pulse-engine o pulse-pollerd, cambia un mensaje de log o agrega un comentario, guarda, reconstruye con el mismo comando, y lee el log. El planner vuelve a correr y emite un recipe byte-idéntico, el paso cargo chef cook imprime CACHED, y el único trabajo de compilación son tus propios crates: segundos a minutos bajos en vez del build completo de dependencias. La afirmación de hasta-5x del README es la medición de Luca en sus proyectos; el ratio que acabas de producir es tuyo, y el tuyo es el que puedes citar. Ahora cambia una línea en Cargo.toml, reconstruye, y mira a la capa de cook invalidarse con honestidad: el recipe cambió, así que las dependencias recompilan una vez. Ese es el contrato de cacheo entero, demostrado en dos reconstrucciones.
Dale al fleet-runner un modo de servicio. Pasa a pulse-station, y sé preciso sobre CUÁL archivo de fleet, porque la estación lleva dos. El contenedor corre packages/pulse-fleet/src/fleet.ts, el sondeador manejado por config, de una sola corrida desde que nació: carga su config, barre cada target a través del pool de probeAll, imprime sus contadores de resumen, y sale. (No escribe ningún archivo de resultados; status.json le pertenece al OTRO fleet.ts, el que está en la raíz del paquete y que invoca el cron de m01-l3, y nada en este paso se le acerca.) Primera jugada: haz explícita la forma de una sola corrida envolviendo el cuerpo del barrido existente, desde la carga de config pasando por probeAll hasta la impresión del resumen, en una función, async function runSweep(configPath: string): Promise<void>, sin cambiar nada adentro. Después reemplaza el manejo de argumentos del entry point con esto:
const args = process.argv.slice(2);

const flagAt = args.indexOf("--interval");
const intervalRaw = flagAt === -1 ? process.env.FLEET_INTERVAL : args[flagAt + 1];
if (flagAt !== -1 && intervalRaw === undefined) {
  console.error("--interval needs a value in seconds");
  process.exit(1);
}
const positional =
  flagAt === -1 ? args : args.filter((_, i) => i !== flagAt && i !== flagAt + 1);

const configPath = positional[0];
if (!configPath) {
  console.error("usage: fleet [--interval <seconds>] <config-path>");
  process.exit(1);
}

let intervalSecs: number | undefined;
if (intervalRaw !== undefined) {
  intervalSecs = Number(intervalRaw);
  if (!Number.isFinite(intervalSecs) || intervalSecs <= 0) {
    console.error(`--interval wants a positive number of seconds, got "${intervalRaw}"`);
    process.exit(1);
  }
}

const stop = new AbortController();
process.on("SIGINT", () => stop.abort());
process.on("SIGTERM", () => stop.abort());

function sleep(ms: number, signal: AbortSignal): Promise<void> {
  return new Promise((resolve) => {
    if (signal.aborted) {
      resolve();
      return;
    }
    const timer = setTimeout(resolve, ms);
    signal.addEventListener(
      "abort",
      () => {
        clearTimeout(timer);
        resolve();
      },
      { once: true },
    );
  });
}

if (intervalSecs === undefined) {
  await runSweep(configPath);
} else {
  console.error(`fleet-runner: service mode, sweeping every ${intervalSecs}s`);
  while (!stop.signal.aborted) {
    await runSweep(configPath);
    await sleep(intervalSecs * 1_000, stop.signal);
  }
  console.error("fleet-runner: received stop signal, exiting cleanly");
}
Lee la interfaz primero, porque ahora está congelada y el archivo compose de la lección que viene depende de ella: una ruta de config posicional, una flag opcional --interval <seconds>, una variable de entorno FLEET_INTERVAL como fallback de la flag, una sola corrida cuando ninguna está puesta. El cron de m01-l3 sigue funcionando intacto por la razón más directa nombrada arriba: nunca llama a este archivo, corre el escritor de la raíz del paquete. Una divergencia deliberada para nombrar antes de que alguien me cite m06-l1: esa lección argumentó que el ticker de tokio le gana a dormir al final del loop, y este loop duerme al final. A propósito. Su período es tiempo de barrido más intervalo, ruido para un runner de una vez por minuto, mientras el sleep abortable compra el apagado limpio que un contenedor necesita; el poller se queda con el ticker porque allá el cronograma ES el producto. El sleep es el patrón AbortController de m02-l3 apuntado hacia adentro: SIGTERM o Ctrl-C abortan la señal, rompiendo la condición del loop y despertando el sleep de inmediato, así que un stop durante una siesta de diez minutos no espera diez minutos. El manejo de señales no es decoración. Adentro de un contenedor tu proceso es PID 1, y docker stop manda SIGTERM; un proceso de node que lo ignora recibe diez segundos silenciosos y después SIGKILL, que es cómo los servicios terminan con escrituras truncadas y sin despedida en los logs.
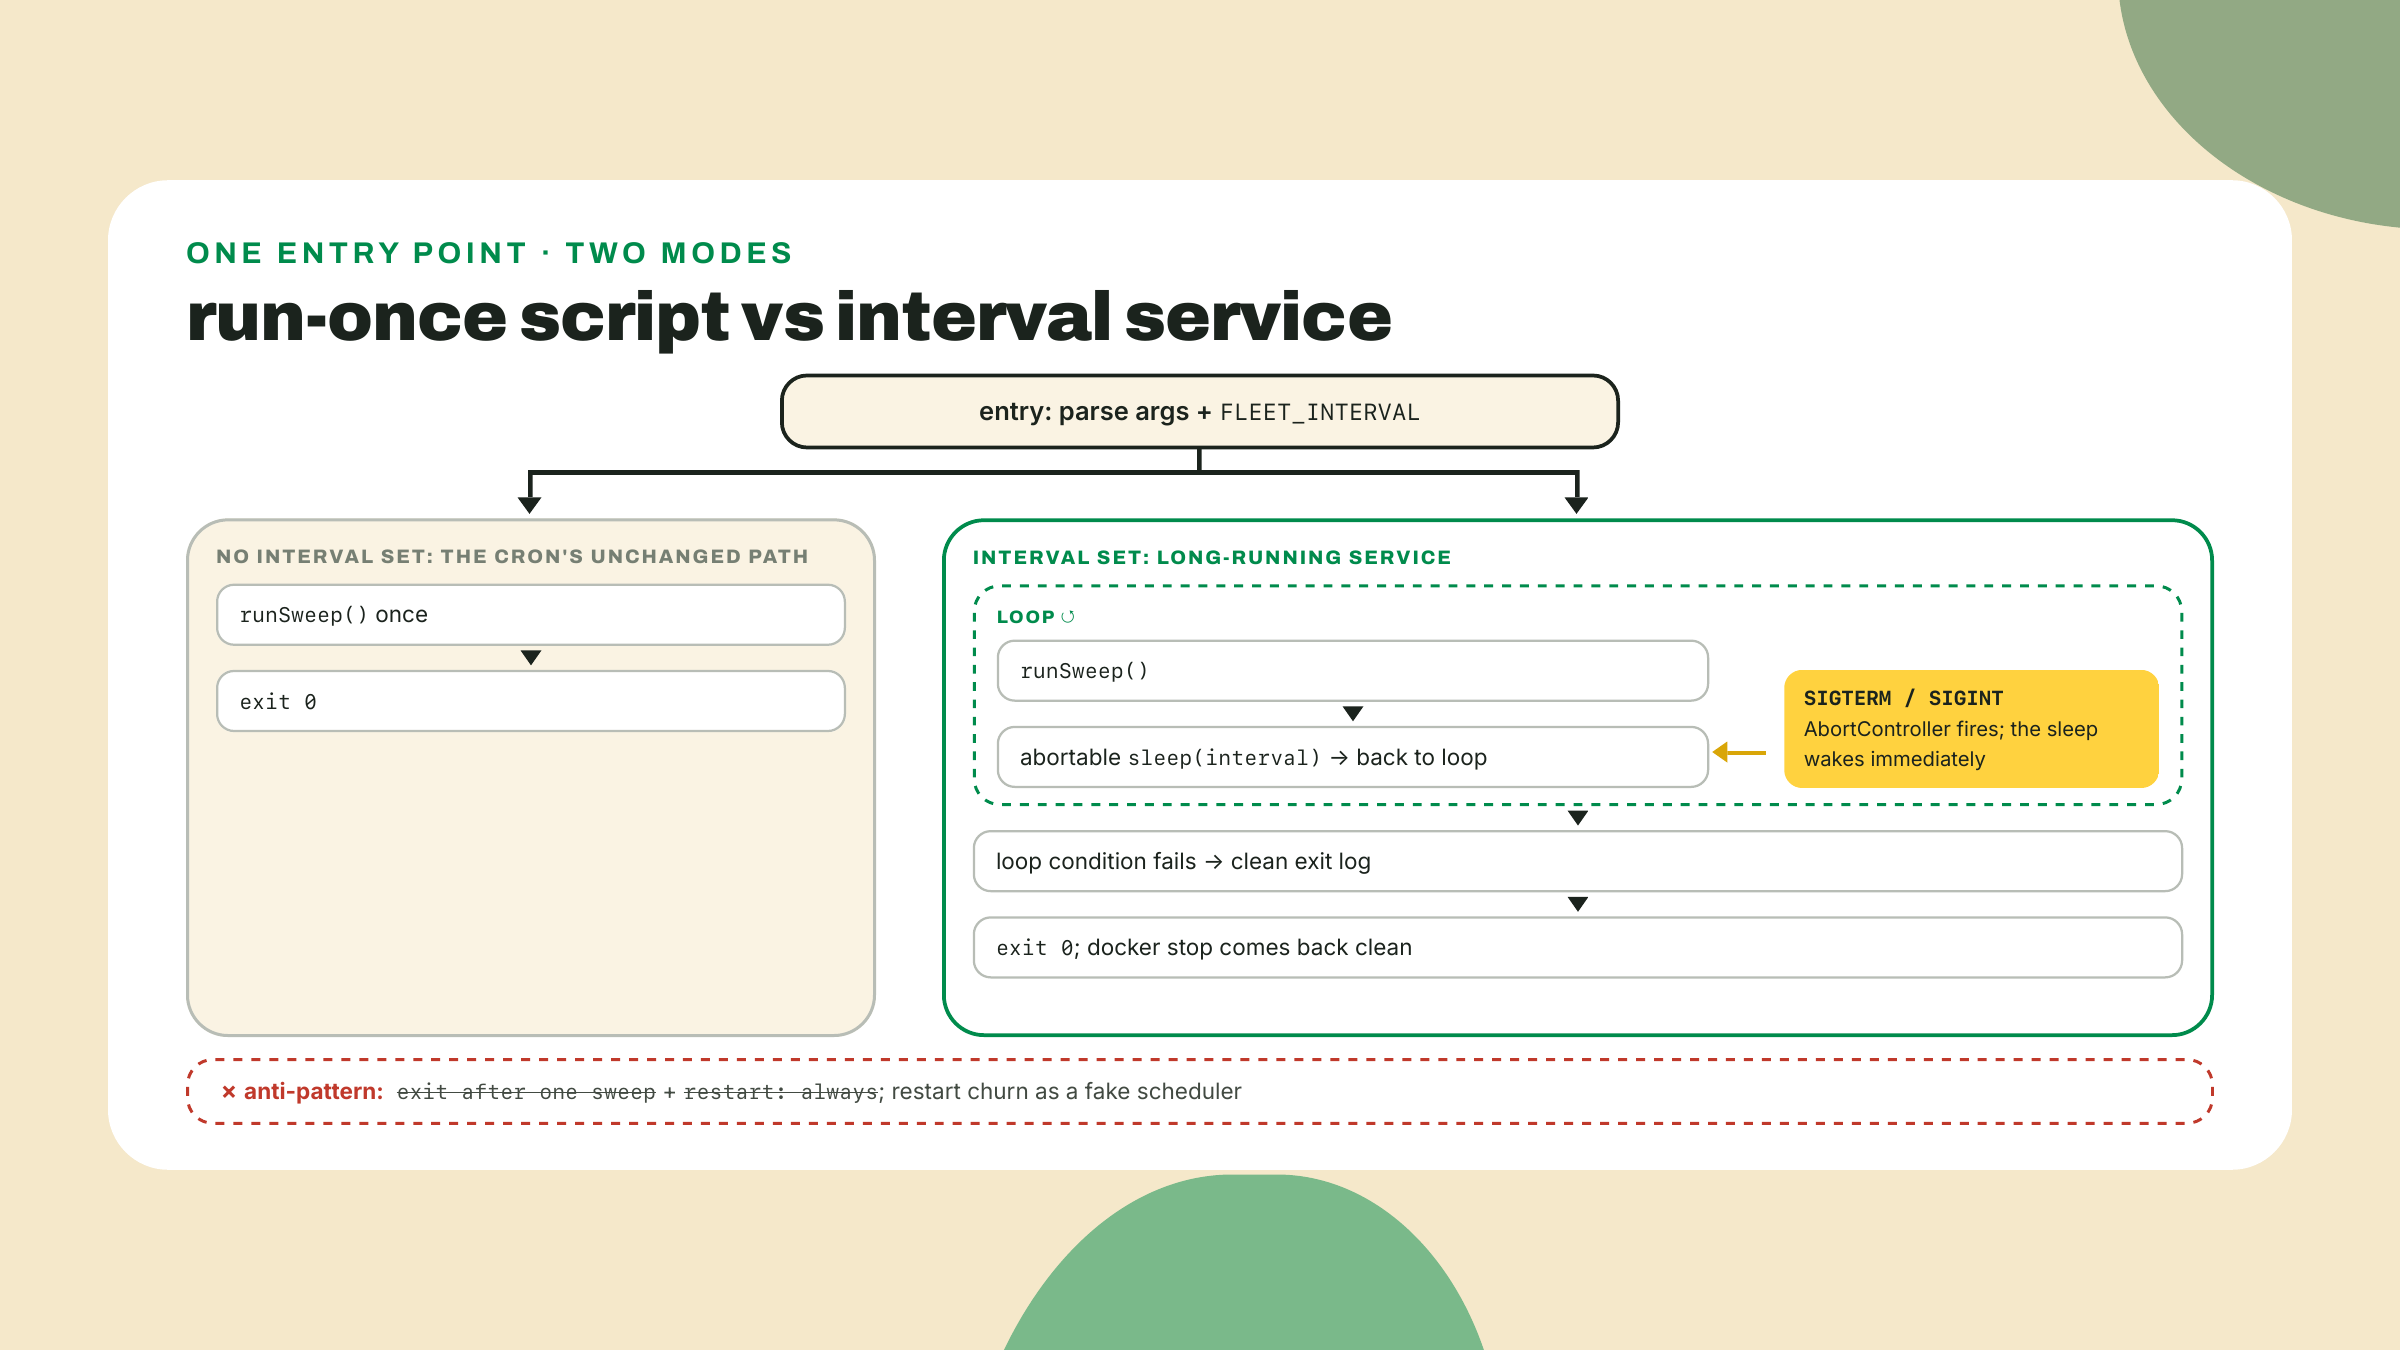
Pruébalo en el host antes de meterlo en la caja: npx tsx src/fleet.ts pulse.config.json --interval 10 desde packages/pulse-fleet debería imprimir la línea de modo de servicio, completar un barrido, pausar diez segundos, barrer de nuevo, y salir de forma limpia con Ctrl-C con la línea de despedida. Dos barridos en el log son la evidencia de aceptación, y el Checkpoint la quiere.
pulse-station, crea Dockerfile.fleet, el nombre explícito, no el default pelado, porque este archivo vive en la raíz del repo (el build necesita el workspace entero de pnpm como su contexto) mientras el Dockerfile propio del poller vive abajo en pulse-rs/, y el archivo compose y el job de CI de la lección que viene van a referenciar el archivo de la flota con exactamente este nombre:FROM node:24-slim AS base
RUN npm i -g pnpm@11.25.0
FROM base AS build
WORKDIR /app
# Dependency layer first, so a code edit cannot invalidate the install.
# TODO 1: COPY exactly what pnpm needs to resolve the workspace:
# pnpm-lock.yaml, pnpm-workspace.yaml, the root package.json,
# and each packages/*/package.json at its own path.
COPY ??? ???
RUN pnpm install --frozen-lockfile
# Source arrives AFTER the install layer.
# TODO 2: COPY the rest of the workspace in.
COPY ??? ???
RUN pnpm --filter pulse-core build \
&& pnpm --filter pulse-fleet build
RUN pnpm --filter pulse-fleet --prod deploy --legacy /out
FROM node:24-slim AS runtime
WORKDIR /app
# TODO 3: COPY --from the deployed bundle at /out into /app,
# and COPY the fleet's config file in next to it.
COPY ??? ???
COPY ??? ???
CMD ["node", "dist/fleet.js", "pulse.config.json"]
Tres piezas chicas de cableado antes de que pueda construir, todas tuyas para poner:
build en pulse-fleet que emite dist/. La elección aburrida y correcta es tsc con un tsconfig.build.json que extiende tu config estricta y pone outDir: "dist", rootDir: "src", y, fácil de pasar por alto y obligatorio, include: ["src"], porque la raíz del paquete también lleva scripts sueltos (fleet.ts, probe.ts, smoke.ts) y un directorio tests/ que violan rootDir en el momento en que tsc los barre adentro. No hay ningún noEmit que apagar: la base estricta nunca lo puso, el CI de m01-l3 lo pasa como flag, así que un "noEmit": false explícito acá es documentación inofensiva. (Construye pulse-core primero, como ya hace el Dockerfile; su build de m03-l4 emite las declaraciones que lee la compilación de la flota.)"files": ["dist"] en el package.json de pulse-fleet, así pnpm deploy sabe qué llevar.packages/pulse-fleet/package.json a packages/pulse-fleet/, porque pnpm resuelve el workspace por forma. Si tu capa de install vuelve a correr en cada edición de código, copiaste demasiado adentro del TODO 1; el visual del orden de capas que está arriba es el mapa de debugging.pulse-station todavía no tiene .dockerignore, y construir sin uno no solo te avergüenza, falla. El contexto sin cercar pesa cerca de 1.8 GB, alrededor de 1.5 GB de eso pulse-rs/target/, y peor, COPY . . aterriza el node_modules construido en macOS de tu host encima del install fresco de Linux del contenedor; el pnpm --filter ... build de adentro del contenedor después nota el directorio de modules desajustado, trata de reemplazarlo, y aborta el build entero de la imagen con ERR_PNPM_ABORTED_REMOVE_MODULES_DIR_NO_TTY. Así que crea .dockerignore en la raíz de pulse-station con las dos entradas que desbloquean el build:node_modules
pulse-rs/target/
Ninguno de los dos directorios fue nunca un input real, porque el build compila adentro del contenedor a partir de un install limpio. Después, desde la raíz de pulse-station:
docker build -f Dockerfile.fleet -t pulse-fleet-runner:slim .
docker run --rm -e FLEET_INTERVAL=15 pulse-fleet-runner:slim
Fíjate en el tamaño de transferring context que imprime el log de build: incluso con la cerca de dos líneas está lejos de ser ordenado, ya que .git/, la salida de cobertura, y cada dist/ siguen viajando gratis, y el challenge termina el trabajo con números. La corrida debería imprimir la línea de modo de servicio y después barrer cada quince segundos; deja que aterricen dos barridos, después hazle docker stop desde la otra terminal (docker ps para el nombre) y mira llegar la línea de salida limpia adentro de un segundo, tu sleep abortable haciendo su trabajo contra un SIGTERM de verdad. Después la contabilidad final:
docker images
Lee la columna SIZE hacia la forma de abajo, con tu nota del baseline aportando la fila ingenua:
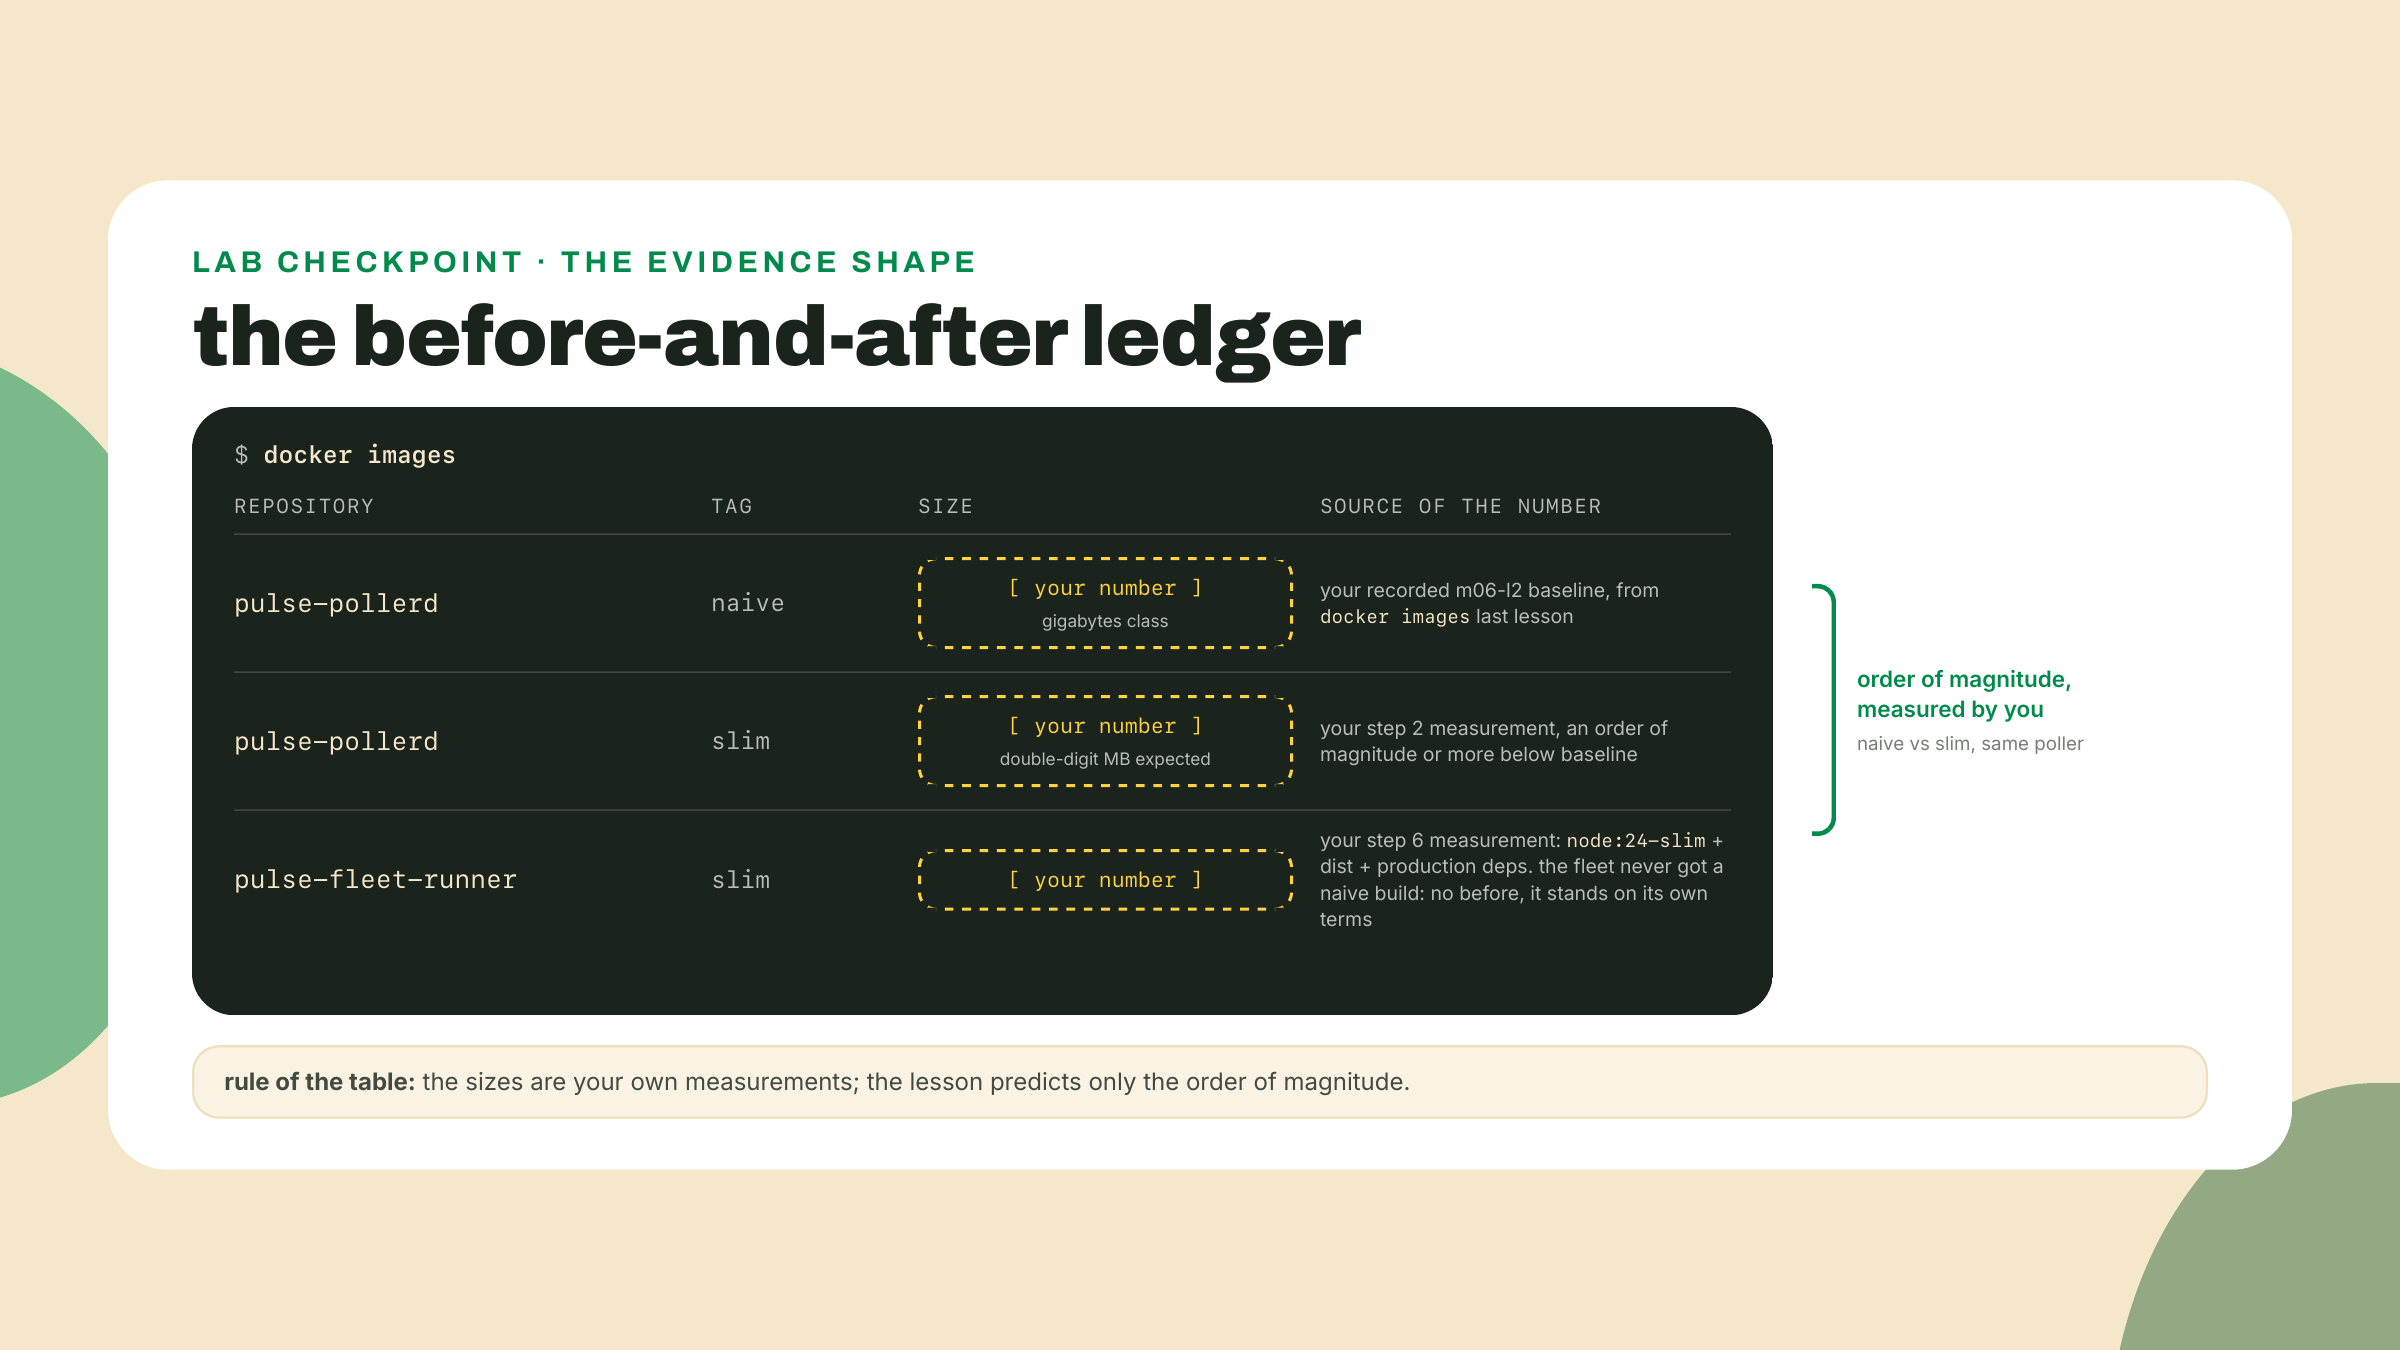
Los dos tags slim al lado de tu baseline ingenuo, orden de magnitud en pantalla, en tus propios números. Esa tabla más el extracto de log de dos barridos es toda la carga de la prueba de la lección.
Profundiza (el 20%). los builds multi-stage, COPY --from, y el cacheo de capas son el 80% que funciona del sistema de build; la maquinaria de abajo es BuildKit, el builder que ha sido el default de Docker por años (los propios docs de Docker ya ni siquiera dicen una versión-desde). Esta lección a propósito no imprime la versión actual de BuildKit, y la razón es instructiva: el dígito verificado el 2026-09-02, v0.32.2, quedó superado por v0.33.0 esa misma tarde. Nada acá depende de ninguna de las dos, y un número de versión en prosa del que nada depende es una decoración con fecha de vencimiento. Léelo de github.com/moby/buildkit/releases el día que lo necesites. Su documentación en https://docs.docker.com/build/buildkit/ (verificado en vivo el 2026-09-02) es el bookmark: cache mounts, secretos que nunca tocan una capa, builds multi-plataforma, frontends custom. Nada en esta lección ni en la siguiente depende del material que quedó como bookmark; cuando una necesidad de build supere lo que aprendiste hoy, esa página es donde vive la respuesta.
Solo, terminando la cerca que empezó el paso 6: el .dockerignore de dos líneas desbloqueó el build, pero el contexto todavía arrastra todo lo demás en el repo. Completa el archivo y demuéstralo con números, no con vibras. Toma el tiempo del estado actual en frío (time docker build --no-cache -f Dockerfile.fleet -t pulse-fleet-runner:slim .) y anota el tamaño de transferring context. Después cerca el resto del peso muerto, .git/, coverage/, cada dist/, manteniendo arriba las dos entradas del paso 6, y vuelve a correr las dos mediciones. Aceptación: la transferencia de contexto se desploma al rango de los kilobytes (la mía midió 9.89 kB; megabytes de un solo dígito pasa si te quedas con algo voluminoso a propósito), el build en frío se vuelve más rápido de forma medible, y la imagen sigue construyendo y corriendo su loop de intervalo. Registra cuál entrada hizo el trabajo pesado: pulse-rs/target/ sola cargaba alrededor de 1.5 de los 1.8 gigabytes originales, por qué una lista estándar de node_modules, dist/, .git/ habría dejado este contexto esencialmente sin recortar, y por qué mides en vez de copiar listas. Una sutileza que vale la pena descubrir: el build compila adentro del contenedor a partir de un install limpio, así que nada en node_modules fue nunca un input de contexto. Si ignorar algo rompe el build, era un input real y el error lo nombra; ese loop de feedback es mucho más amigable que el de .gitignore.
Barrera sobre hacer, dos pegados. Primero, la tabla de docker images: tu baseline ingenuo registrado contra pulse-pollerd:slim, con el recorte de orden-de-magnitud-o-mejor visible, y pulse-fleet-runner:slim al lado en sus propios términos (nunca existió un build ingenuo de la flota contra el que compararlo). Segundo, un extracto de log mostrando al fleet-runner en contenedor completando dos barridos de intervalo y después saliendo de forma limpia con docker stop, sin restarts involucrados. Si además agarraste la capa de cook imprimiendo CACHED en una reconstrucción solo de código en el paso 3, verificaste personalmente la afirmación que esta lección atribuyó en vez de asegurar, que es el hábito que sobrevive a cualquier herramienta en particular.
Lo que ahora puedes hacer, concretamente: dividir cualquier Dockerfile en etapas de build y de runtime y predecir lo que se entrega solo a partir de las líneas COPY; ordenar capas para que los installs de dependencias sobrevivan a las ediciones de código, a mano en node y vía cargo-chef en Rust; elegir una base de runtime como un trade-off medido y decir en voz alta lo que alpine le costaría a tu allocator y a tu TLS; y convertir un script de una sola corrida en un servicio que respeta señales, que es la diferencia entre un programa que puede vivir en un contenedor y uno que solo arranca en él.
Si el paso del pnpm deploy te peleó, o los TODOs de frontera de etapa te tomaron más intentos de los que se sintieron justos, dilo en el feedback del curso con el texto del error; el Dockerfile de node es el apoyo más nuevo de esta lección y los reportes deciden si los TODOs están bien calibrados.
Dos imágenes livianas que corren en cualquier parte. También: dos imágenes livianas que existen en exactamente una laptop, y "en cualquier parte" empieza con un registro del que otras máquinas puedan hacer pull. La lección que viene cablea la estación localmente, un archivo compose reemplazando los dos comandos de run que escribiste a mano, y después el único pipeline de CI del curso aprende a construir las dos imágenes y a empujarlas a GHCR, donde SHIP #3 se vuelve una imagen que la máquina de un desconocido puede hacer pull.
Pregunta 1 de 3
Pregunta 1 de 3