Cargando...

 BetaBeta
m06-l3 recortó las dos imágenes en un orden de magnitud: cargo-chef de 3 etapas sobre debian-slim para el poller, node slim multi-stage con pnpm fijado para el fleet-runner, que además ganó su modo de servicio por intervalos. Así que ahora tienes dos imágenes livianas y, si eres honesto, dos pestañas de terminal haciéndoles de niñera con flags de docker run tipeados a mano. Peor: esas imágenes existen en exactamente una máquina en la Tierra, la tuya. CI no puede hacer pull de lo que solo tienes tú. Tampoco puede el módulo futuro que vuelve a entregar este poller con sondas de la blockchain. Hoy se cierran las dos brechas, y la segunda es SHIP #3: un archivo compose reemplaza la niñera de pestañas, y el único pipeline de Actions del curso aprende a empujar las dos imágenes a ghcr.io, donde cualquier máquina con un daemon de docker puede hacerles pull. Cómo se divide el trabajo: el archivo compose y el job de CI son problemas de completion con TODOs angostos, y el challenge de prefijo-de-log-más-profile al final es todo tuyo. La ceremonia de plataforma se queda con la minoría del conteo de palabras a propósito; la idea del medio, donde el deployment de verdad empieza, es el centro de enseñanza.
Hoy no hay instalación nueva, para la mayoría de ustedes: Docker Desktop y OrbStack traen Compose como plugin del propio CLI de docker. La excepción es el camino de colima de m06-l2, cuyo brew install colima docker te dio un CLI de docker pelado sin plugin de compose; cierra la brecha con brew install docker-compose, y después enséñale al CLI dónde pone Homebrew los plugins agregando "cliPluginsExtraDirs": ["/opt/homebrew/lib/docker/cli-plugins"] a ~/.docker/config.json (el cableado documentado de colima). Todos lo confirman igual: docker compose version debería imprimir un string de versión, no un command-not-found. En la raíz del repo de tu estación, al lado de pnpm-workspace.yaml y pulse-rs/, crea compose.yaml:
services:
  pollerd:
    build:
      context: ./pulse-rs
    image: pulse-pollerd:local
    ports:
      # TODO 1: publish the poller's port. host:container, and the
      # container side is whatever POLLER_PORT says below.
      - "????:????"
    environment:
      POLLER_PORT: "8080"

  fleet-runner:
    build:
      context: .
      dockerfile: Dockerfile.fleet
    image: pulse-fleet-runner:local
    environment:
      # TODO 2: the runner's sweep interval, in seconds. Pick a value
      # you can watch without falling asleep. 60 is honest.
      FLEET_INTERVAL: "????"
    depends_on:
      - pollerd
Dos TODOs, los dos valores únicos que ya conoces: el mapeo de puerto es el mismo 8080:8080 que vienes tipeando con -p desde m06-l2, y el intervalo es lo que le pasaste a --interval la lección pasada. Llénalos, y después:
docker compose up
Mira lo que acaba de hacer un solo comando. Construyó las dos imágenes desde sus Dockerfiles (la del poller en pulse-rs/Dockerfile donde m06-l2 la puso, la de la flota en la raíz del repo como Dockerfile.fleet porque su contexto de build necesita todo el workspace de pnpm), creó una red privada para ellas, arrancó pollerd primero porque el runner declara depends_on, y ahora transmite los logs de los dos servicios a una sola terminal, cada línea prefijada con el servicio que la escribió. Desde una segunda terminal, curl -s localhost:8080/status responde exactamente como respondía cuando tipeabas las flags de run a mano. Dos pestañas de niñera, retiradas por un archivo YAML corto.
Mientras el par corre, toma el inventario de diez segundos en esa segunda terminal:
docker compose ps
Una fila por servicio: nombre, la imagen que corre, su estado y, para el poller, el mapeo de puerto en la misma forma host:container que te enseñó -p. Esto es lo que el checkpoint pide que pegues, y es donde miro primero cada vez que un stack compuesto se porta mal, por la misma razón por la que docker ps fue la primera parada en m06-l2: estado y puertos responden la mitad de todos los reportes de "está roto" antes de leer un solo log.
¿Por qué dos servicios, igual? Podrías construir una imagen gorda que corra los dos programas y saltarte el YAML por completo. La respuesta es la propia regla de m06-l3 volviendo con intereses: un contenedor, un proceso en primer plano. El poller y el runner tienen necesidades de reinicio distintas, logs distintos, cadencias de actualización distintas (vas a reconstruir la imagen de TS mucho más seguido que la de Rust), y meterlos a la fuerza en una caja suelda todo eso junto y te entrega un problema de supervisor adentro del contenedor. Compose existe precisamente para que mantener los procesos separados deje de costarte pestañas de terminal.
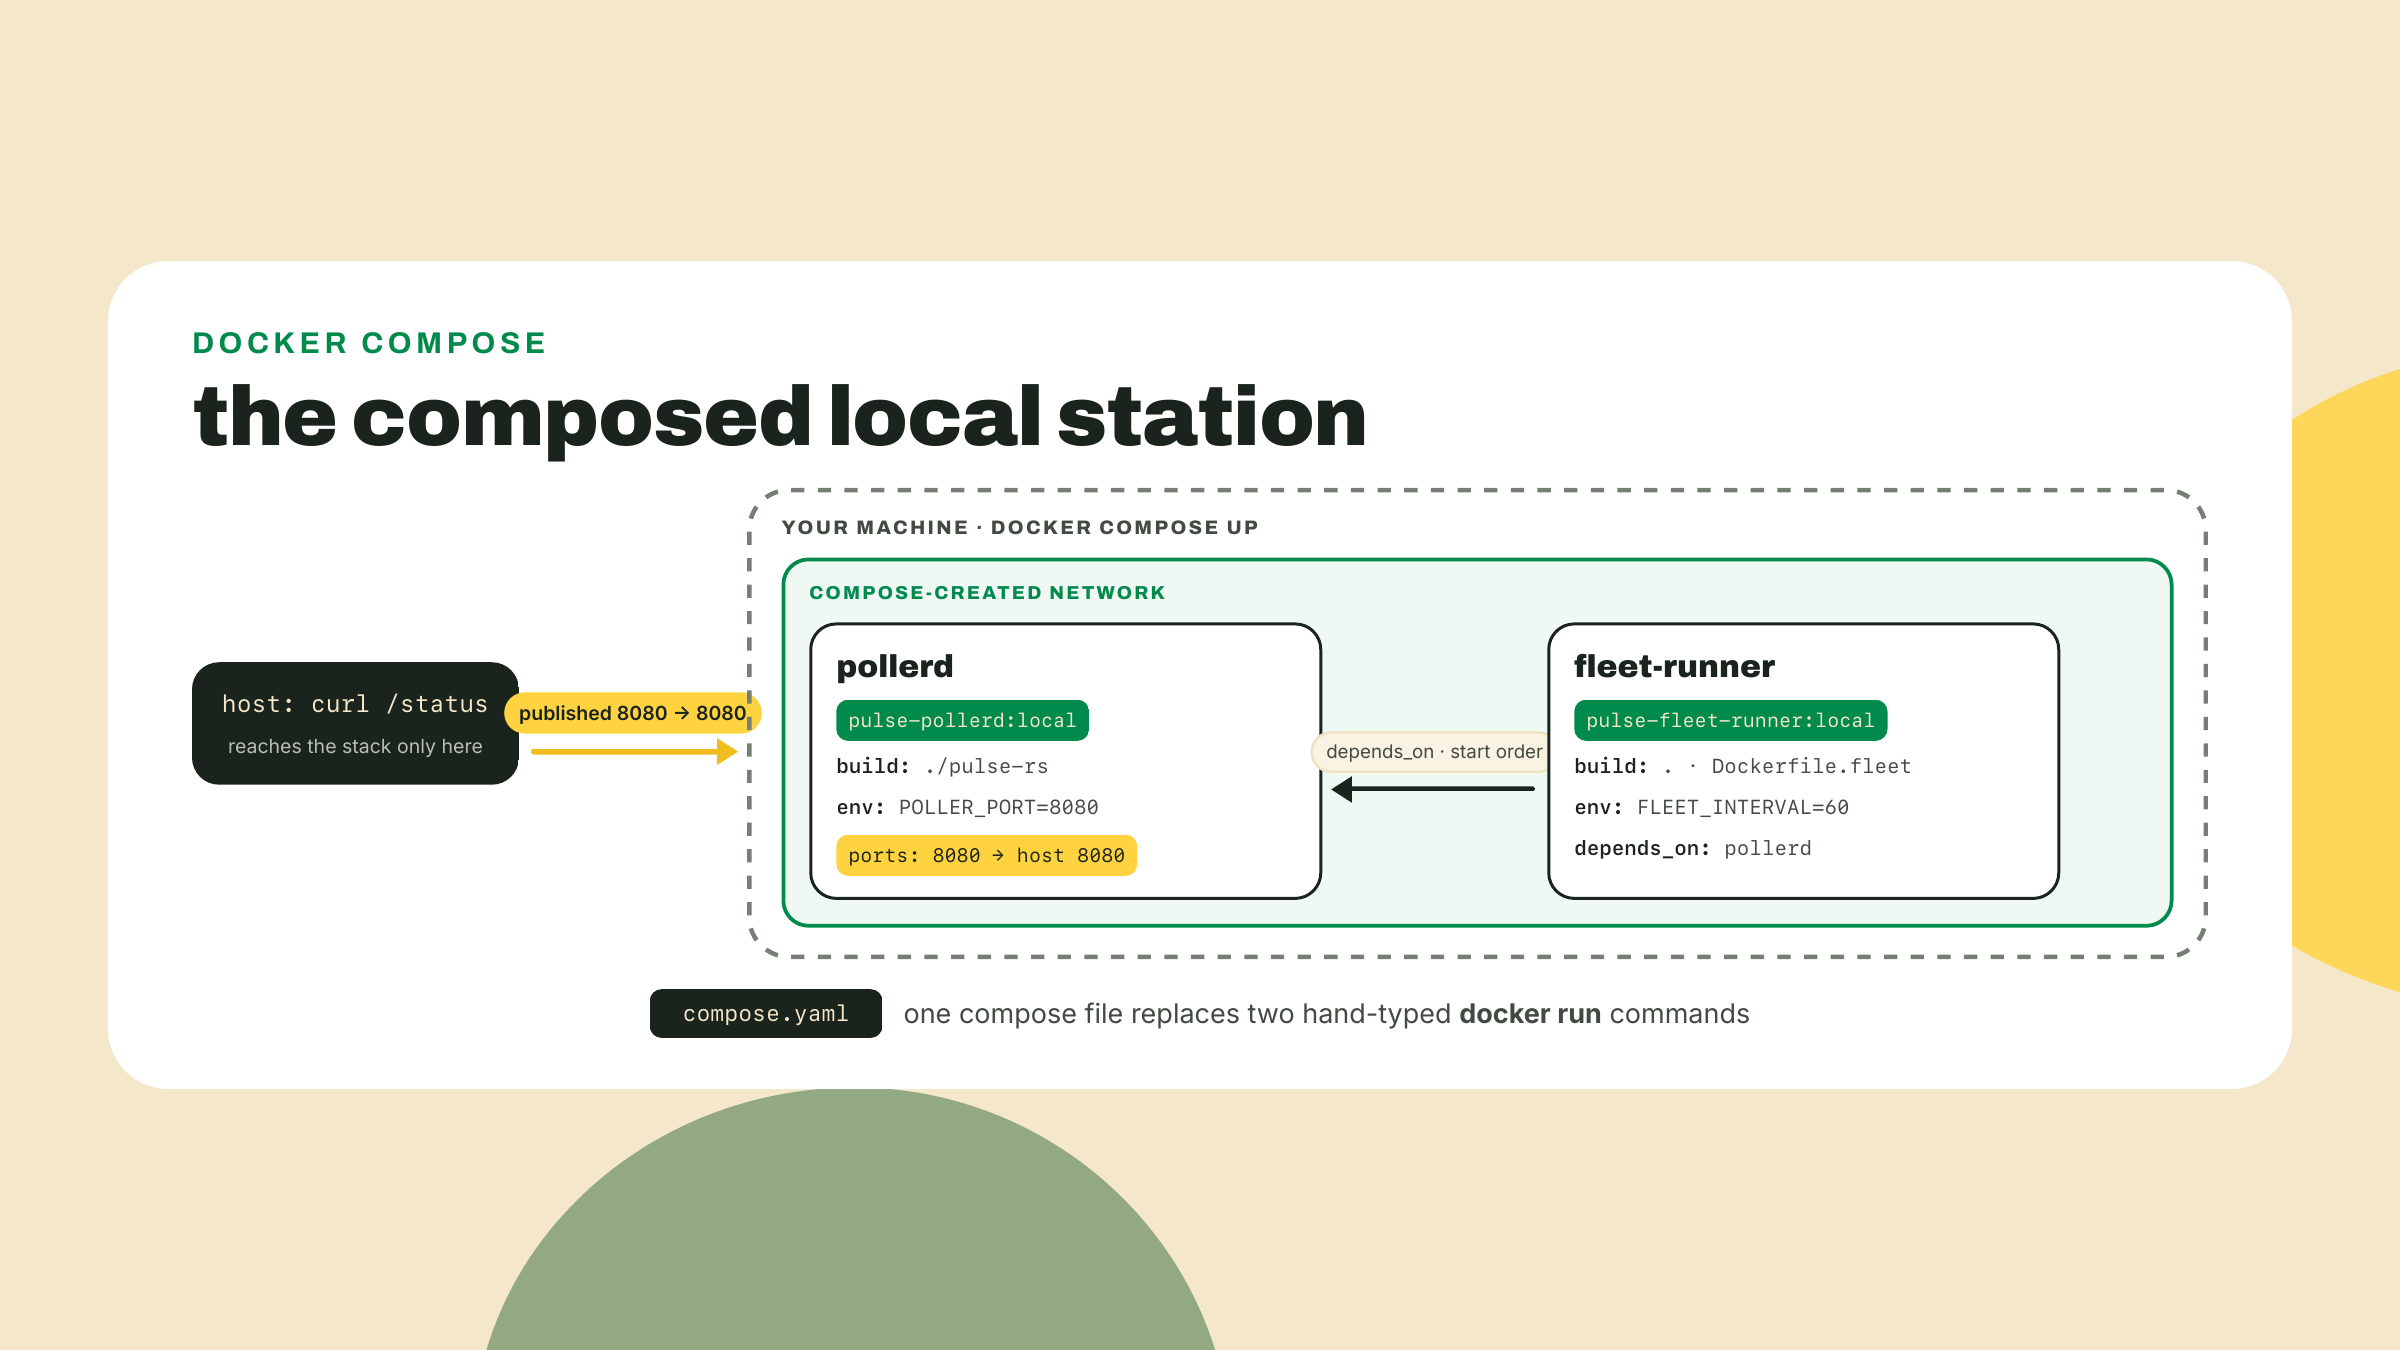
Ahora la anatomía, campo por campo, porque vas a leer cien de estos archivos en el mundo real y escribir una docena. Un servicio es la unidad de compose: una imagen, una receta de contenedor, un nombre. El nombre es estructural dos veces. Prefija el stream de logs que estás mirando, y se vuelve un hostname de DNS en esa red privada, así que los contenedores pueden alcanzarse por nombre; agrega http://pollerd:8080/status como target en la config de la flota y tu flota de TS sondea tu poller de Rust cruzando la red que construyó compose, sin direcciones IP cosechadas de ningún lado. build apunta a un contexto y a un Dockerfile opcional, e image nombra lo que produce el build; etiquetamos estas con :local para que nunca choquen con los tags multi-stage que mediste la lección pasada. ports y environment son tus flags -p y -e, escritas. depends_on ordena el arranque, y acá va la honestidad que los docs te deben y que este curso va a cobrar: espera a que el contenedor de pollerd arranque, no a que el poller esté listo. Arrancar es un hecho del proceso; estar listo es una opinión de la aplicación. Si el primer sweep del runner se dispara antes de que el socket del poller esté abierto, ese sweep falla y el siguiente funciona, que es exactamente el comportamiento resiliente que tu flota aprendió en m02: trata una conexión rechazada como una sonda Down, no como un crash.
Cuando una app genuinamente no tolera eso, una base de datos que tiene que aceptar conexiones antes de que corra una migración, digamos, compose sí tiene la forma más fuerte: dale a la dependencia un healthcheck (un comando que compose corre adentro del contenedor hasta que tenga éxito) y escribe la dependencia como depends_on con condition: service_healthy. Entonces compose espera a que esté listo según tu definición, no a que apenas haya arrancado. Nuestra estación no lo necesita, el backoff de la flota ya absorbe un poller que arranca lento, así que nombramos la herramienta y la dejamos en el cajón. Agarrar maquinaria de disponibilidad que un loop de retry ya cubre es cómo los archivos compose crecen a doscientas líneas.
Una verificación tamaño repaso mientras estás acá. La lección pasada congeló la interfaz del runner a propósito: --interval en el CLI, la variable de entorno FLEET_INTERVAL como su fallback, la flag ganando cuando están las dos, correr-una-vez cuando no está ninguna. El archivo compose de arriba habla la mitad de env de ese contrato, que es el idioma de contenedores por la misma razón por la que existe POLLER_PORT: una imagen inmutable, muchos deployments, la perilla por fuera. Si tu runner lee solo la flag, vuelve y cablea el fallback de m06-l3 antes de up; la imagen misma nunca debe necesitar reconstruirse para cambiar su cronograma.
Acá va todo el loop diario en una sola tarjeta, corrido desde el directorio que tiene tu archivo compose:
docker compose up -d           # start both services, detached
docker compose ps              # both services, their state, their published ports
docker compose logs -f         # tail the interleaved stream from both containers
docker compose up -d --build   # after you edit code; compose reuses images otherwise
docker compose down            # stop and remove the containers and the network
Los comandos del día a día, todos en forma con espacio: docker compose up -d para modo detached una vez que confías en el par, docker compose ps para ver los dos servicios con su estado y sus puertos, docker compose logs -f para seguir el stream entrelazado, docker compose up -d --build después de editar código (compose reusa imágenes salvo que le digas que reconstruya), y docker compose down para detener y eliminar contenedores y la red en un solo movimiento. Ese último es el hábito de cortesía que te dio --rm, escalado a todo el stack, y vale ser preciso sobre qué sobrevive: down elimina los contenedores y la red, mientras las imágenes se quedan en tu cache local, así que el próximo up es rápido. Nada que tu estación haya escrito adentro de un contenedor sobrevive a down, y para nosotros eso es aceptable porque nada en ninguna de las dos cajas escribe nada que valga guardar: el estado del poller se reconstruye sondeando, y el sweep en contenedor es src/fleet.ts, el sondeador manejado por config que m06-l3 tuvo el cuidado de desambiguar, que no escribe ningún archivo de resultados, imprime sus contadores de resumen a stdout y termina. (status.json le pertenece al OTRO fleet.ts, el script de la raíz del paquete que invoca el cron de m01-l3, y ese nunca fue a una caja.) Los canales que sobreviven en este deployment son el stream de logs (que el challenge hace fácil de grepear) y el status.json durable que el cron de Actions sigue commiteando, que nunca dejó de ser la copia canónica. El día en que un servicio necesite datos adentro del contenedor que sobrevivan al contenedor, vas a conocer los volúmenes, que este curso deja en el mismo cajón que las verificaciones de disponibilidad.
Una confesión sobre la forma del comando: yo todavía tipeo docker-compose, con guion y todo, cuando estoy cansado, porque los tutoriales de 2020 me lo quemaron en las manos. Ese binario con guion es Compose v1, muerto hace mucho. Lo que estás usando es Compose v2, el plugin en forma con espacio docker compose, y una arruga de nomenclatura vale decirla una vez para que nadie en tu equipo te "corrija": la arquitectura se llama v2, mientras los tags de release del proyecto son v5.x, siendo v5.5.0 el último mientras escribo esto el 2026-09-02. Los strings de versión se van a la deriva; la forma con espacio es el hecho estable.
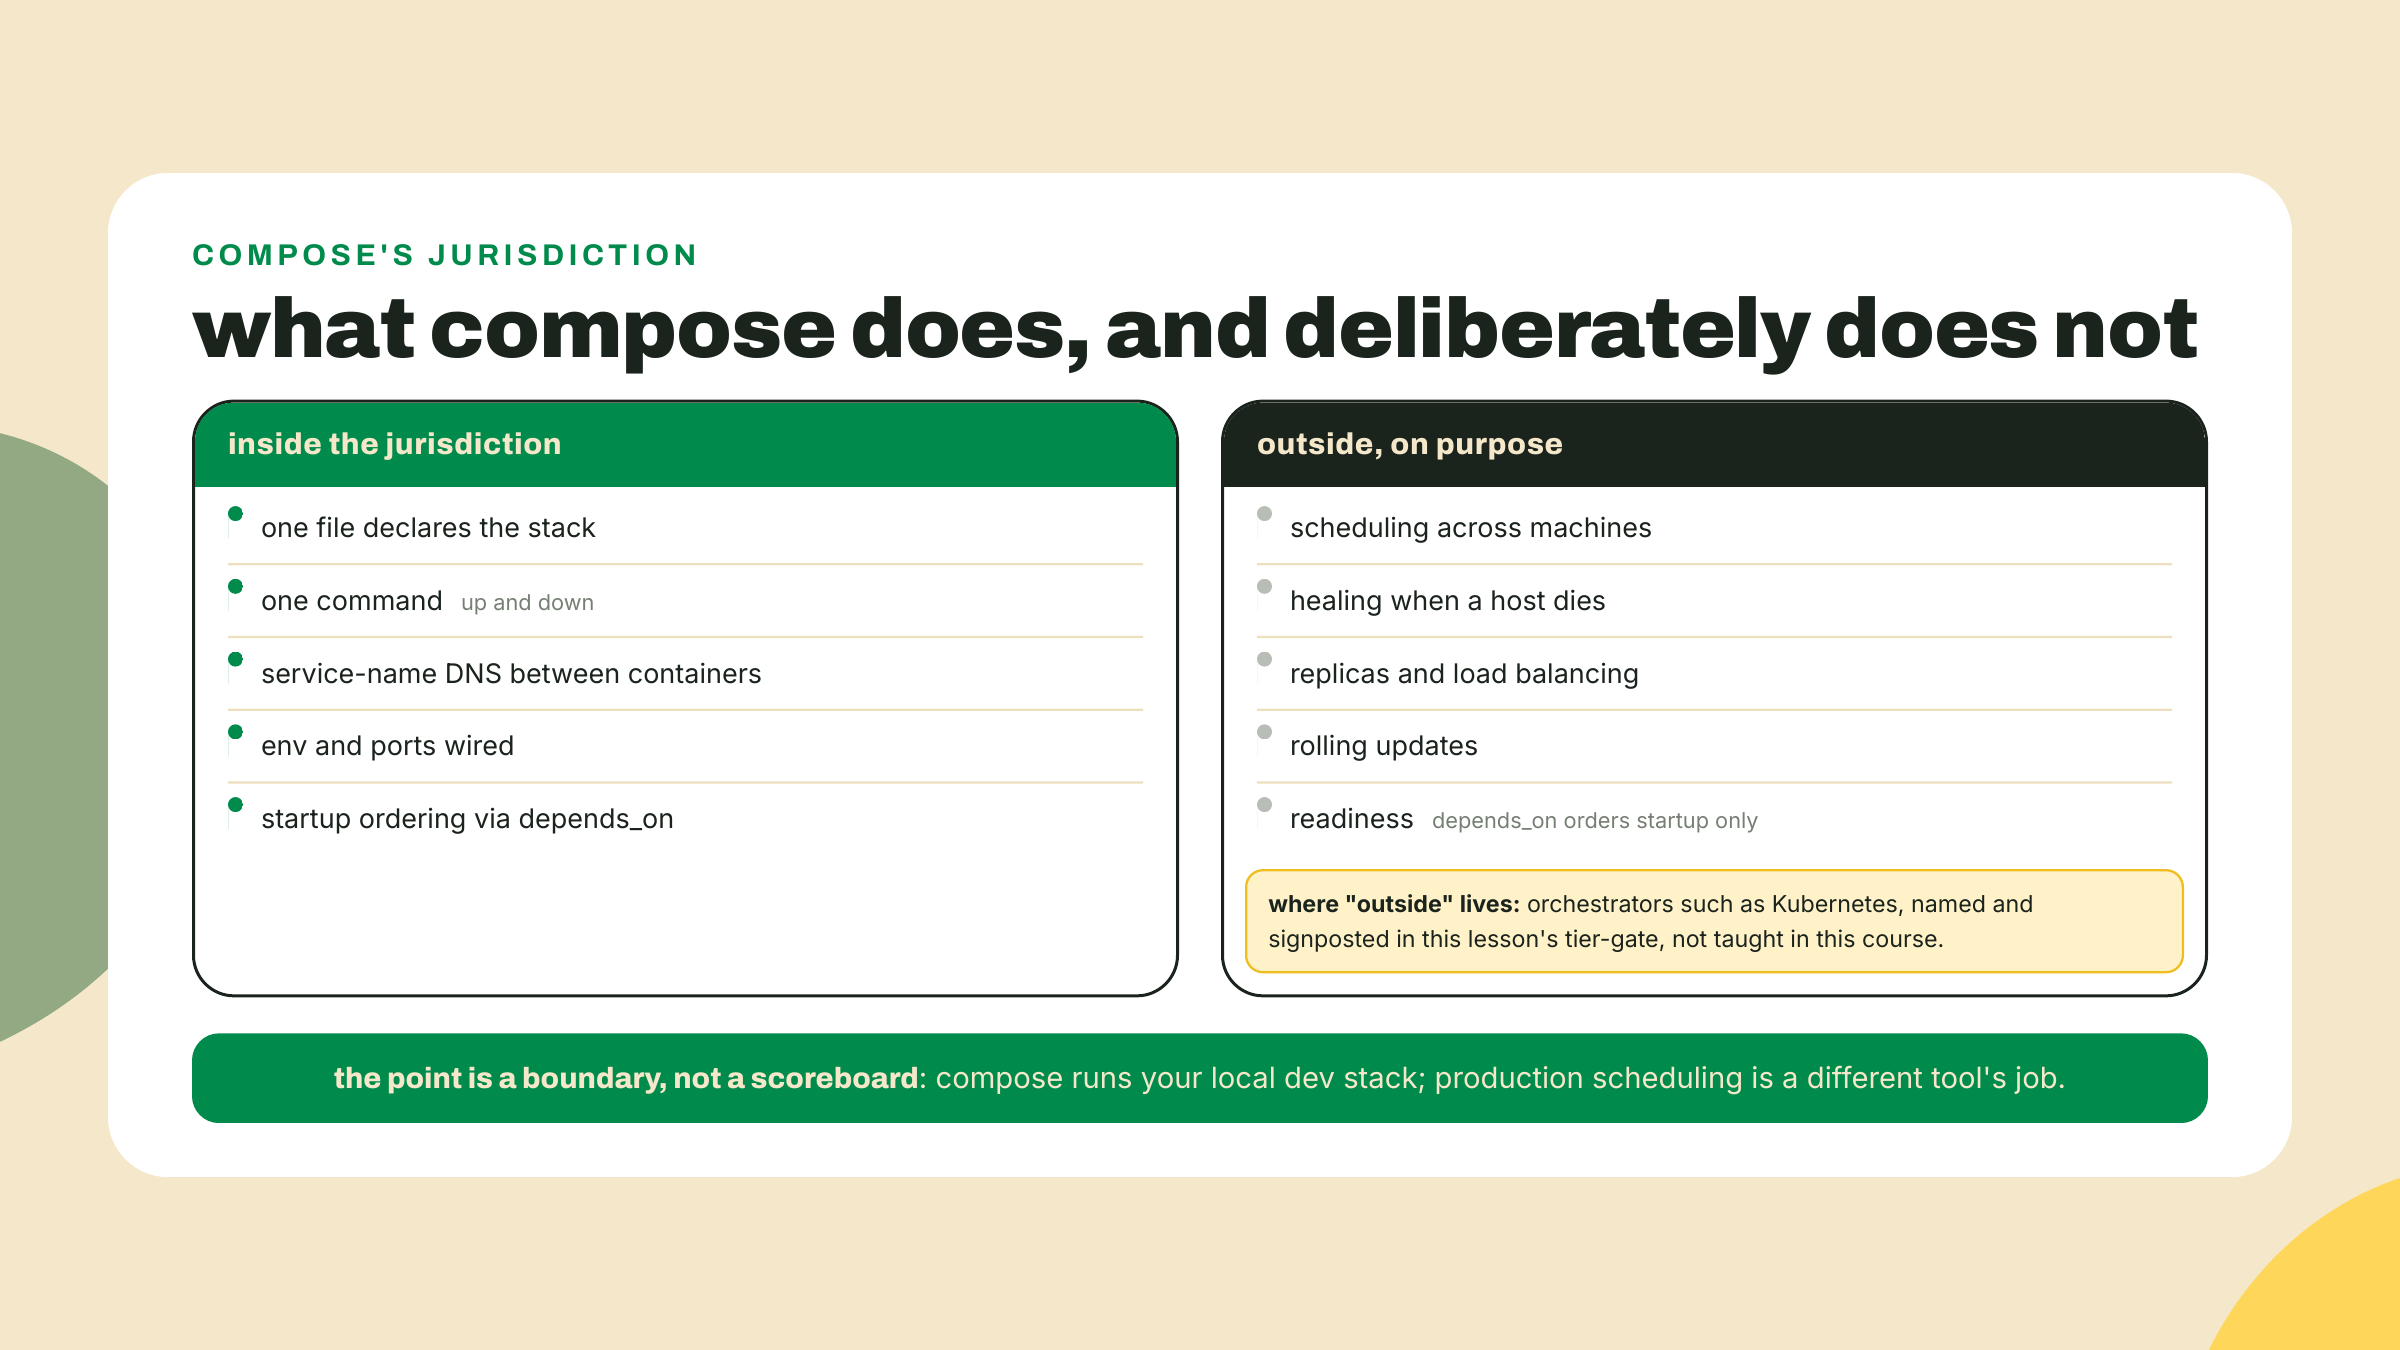
Di en voz alta lo que es este archivo: un contrato de dev local. Y di lo que no es: una historia de deployment. Compose no agenda nada más allá de tu única máquina. Si el poller crashea a las 3am, compose puede reiniciar el contenedor si se lo pides, pero si la máquina muere, no hay nada en ninguna parte que se dé cuenta. No sana nada entre hosts, no balancea nada, no despliega nada de forma gradual. En el momento en que quieres reinicios-ante-falla entre máquinas, o dos réplicas detrás de una dirección, o una actualización que cambia versiones sin downtime, dejaste la jurisdicción de compose por los orquestadores, y este curso deliberadamente no los enseña; la barrera del tier al final de esta lección los nombra como corresponde. Lo que compose compra adentro de su jurisdicción es real y diario: todo el stack en un archivo, commiteado en el repo, así que git clone más docker compose up es todo el documento de onboarding para la próxima persona. Vas a ver archivos compose de cosplay-de-producción en el mundo real, un restart: always haciendo de operaciones. Léelos como lo que son: un equipo chico siendo honesto sobre que una máquina es todo lo que necesitan todavía.
Ahora la segunda mitad, y la idea hacia la que este módulo viene caminando. Tus imágenes corren en cualquier parte donde viva un daemon de docker, pero existen en exactamente un lugar. Un registro resuelve la existencia. Ya te encontraste con la forma dos veces: npm guarda paquetes, crates.io guarda crates, un registro guarda imágenes. Incluso te logueaste en uno, Docker Hub, allá en m06-l2, para hacer pull de imágenes base con cortesía. Hoy empujas a uno distinto: GHCR, el GitHub Container Registry en ghcr.io, elegido porque vive al lado del repo, del pipeline y del token que ya tienes, sin cuenta nueva, sin relación de facturación nueva.
Una referencia de imagen ahí se lee ghcr.io/<owner>/<name>:<tag>: host del registro, después tu namespace de GitHub, después el nombre de la imagen y el tag. Un filo cortante que vale conocer antes del lab: los nombres de imagen tienen que ir en minúsculas, así que si tu usuario de GitHub tiene mayúsculas, el tag que empujes las tiene que doblar hacia abajo; el job de CI del lab hace esto mecánicamente para que nunca vuelvas a pensarlo.
¿Podrías empujar desde tu laptop en vez de desde CI? Mecánicamente, sí: crea un personal access token clásico con el scope write:packages, docker login ghcr.io con él, taggea, empuja. El lab no hace eso, y la razón vale poseerla porque le da forma a cómo publican los equipos de verdad. Un PAT de laptop es una credencial de vida larga sentada en tu llavero con acceso de escritura a cada paquete que tienes, y un push desde laptop publica lo que casualmente estaba en tu working tree, testeado o no. El GITHUB_TOKEN del workflow es lo opuesto en los dos ejes: acuñado fresco para cada corrida, muerto minutos después, limitado al único repo por los permissions que vas a escribir en el YAML, y solo puede publicar un commit que acaba de sobrevivir tus barreras. La costura del registro es exactamente donde quieres la disciplina de una máquina en vez de la memoria de un humano. Así que el canon del curso es push-solo-desde-CI, y la ruta del PAT se queda en tu bolsillo de atrás para el día en que necesites empujar un experimento suelto a algún lado privado.
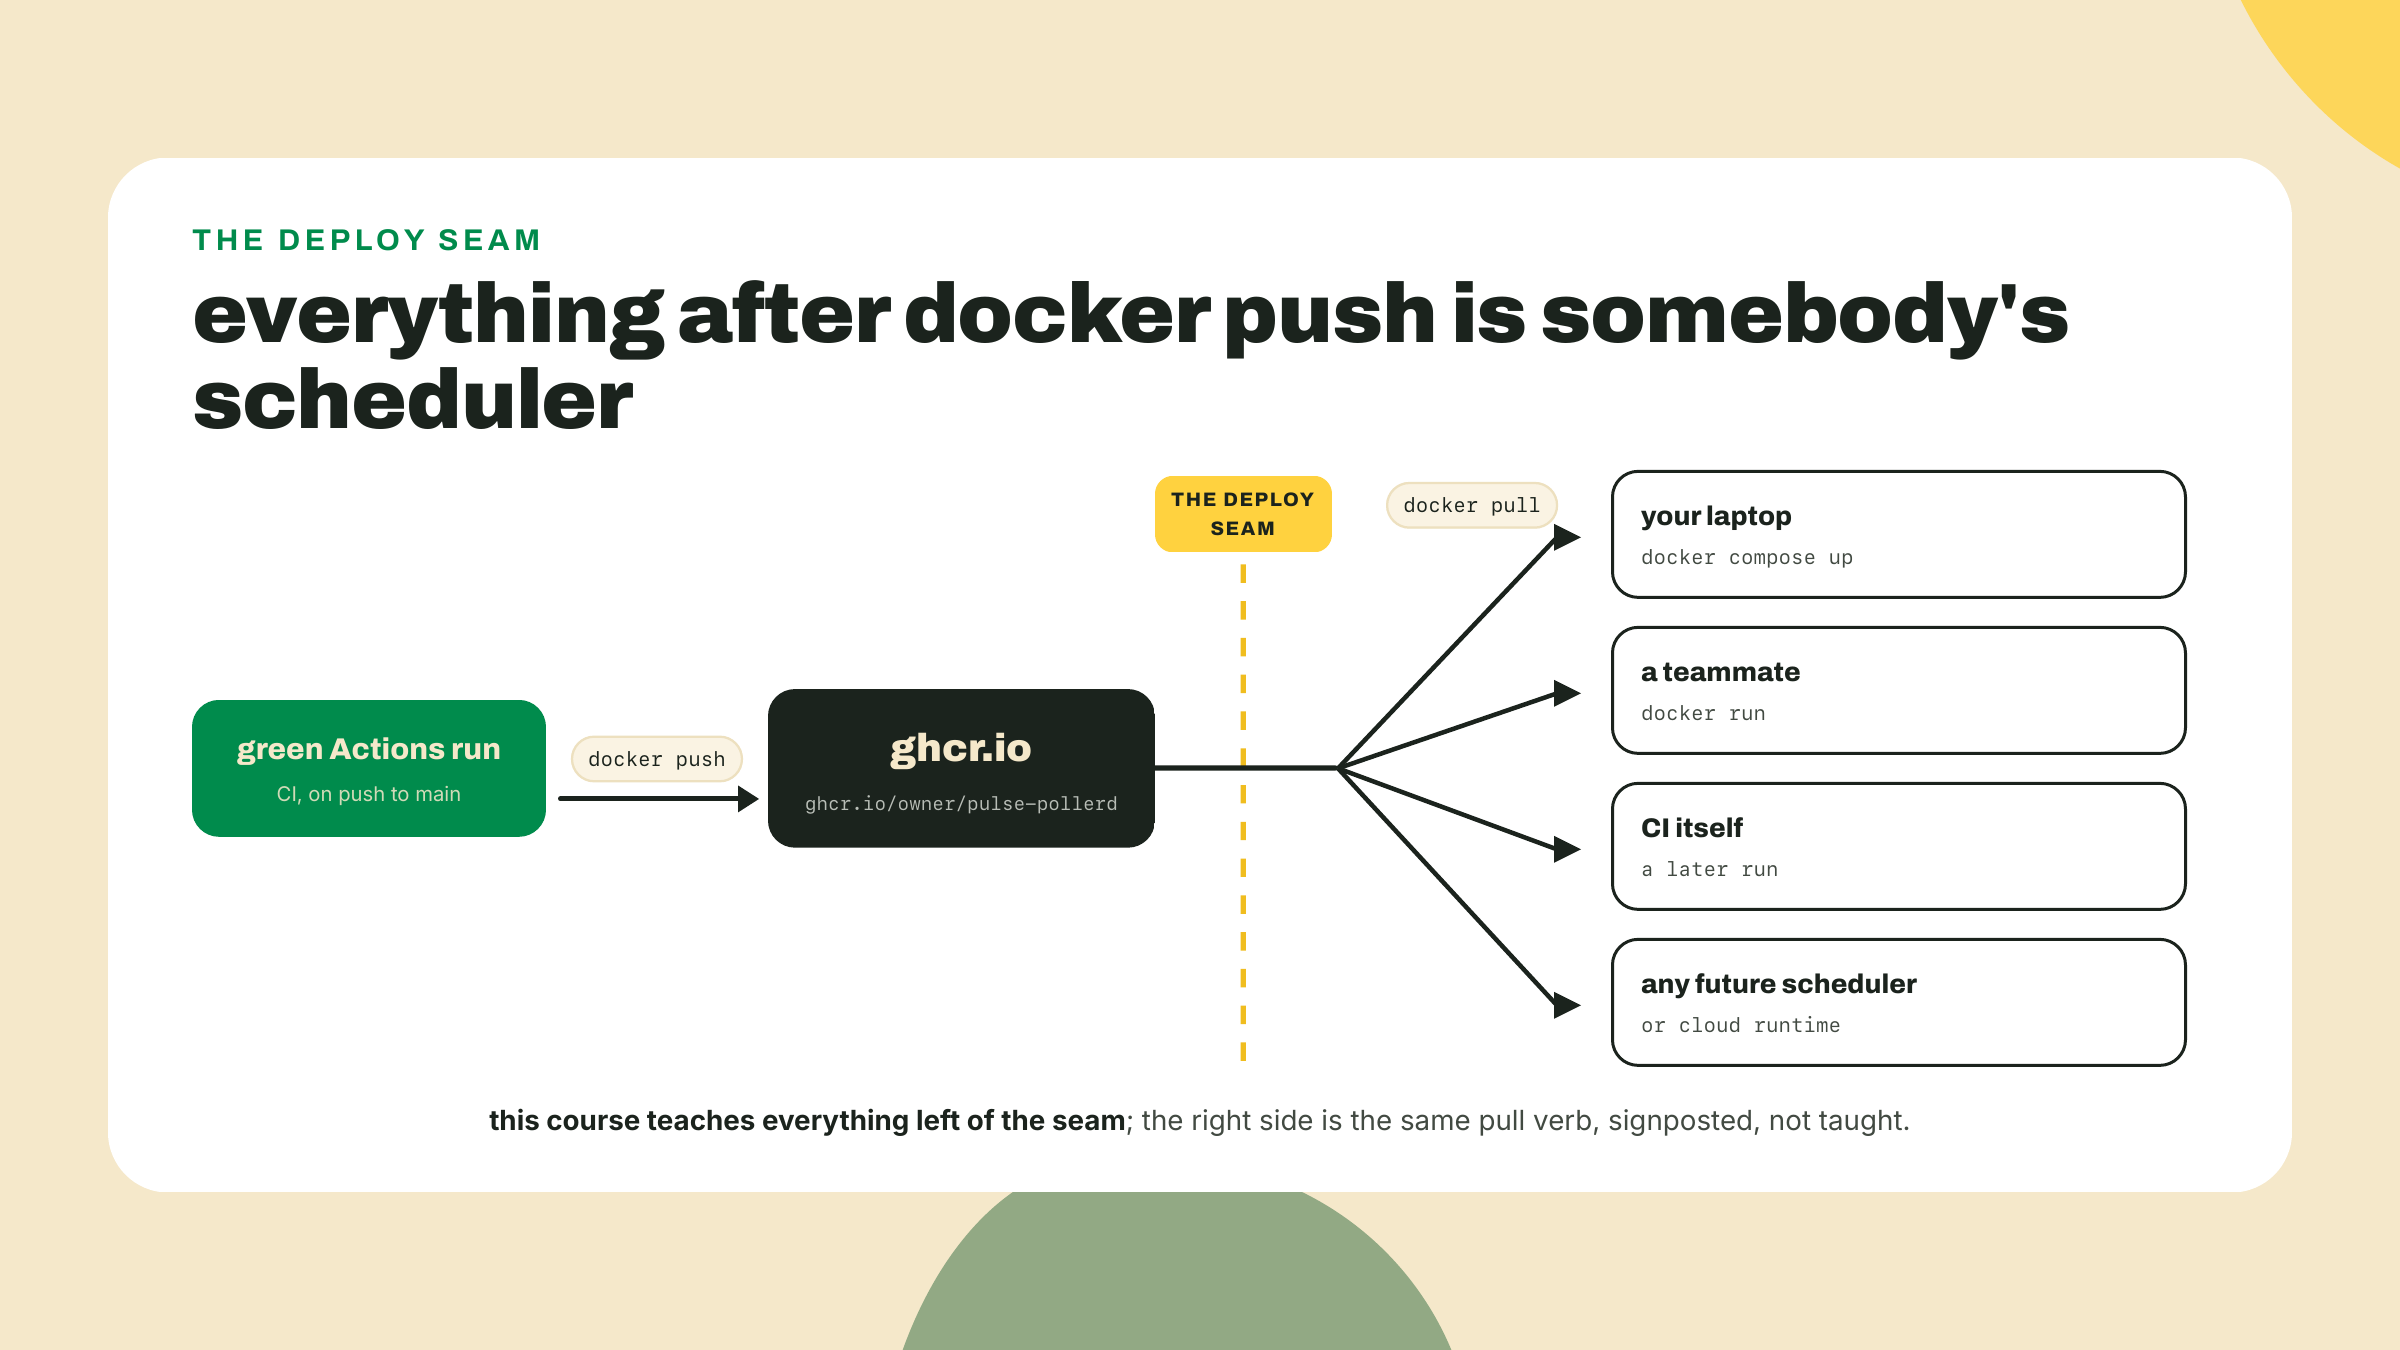
Acá va la síntesis, y es la oración con la que termina este módulo. El registro es el deploy. Todo lo que viene después de docker push es el scheduler de alguien: tu laptop corriendo docker compose up, el docker run de un compañero, algún orquestador futuro, un runtime de nube del que nunca oíste. Todos empiezan con el mismo verbo, pull, contra la misma dirección. Lo que significa que la entrega que estás por hacer es distinta en especie del cron de SHIP #1 y de la URL del panel de SHIP #2: esas entregaron comportamiento; esta entrega un artefacto que otras máquinas pueden correr. Una nota de límite dicha sin adornos, para que la promesa siga siendo honesta: el poller de la estación sigue corriendo localmente, vía compose o docker run. Esta lección no le da al poller una URL pública, y acá no se enseña ni tunneling ni self-hosting. La entrega es el registro mismo.
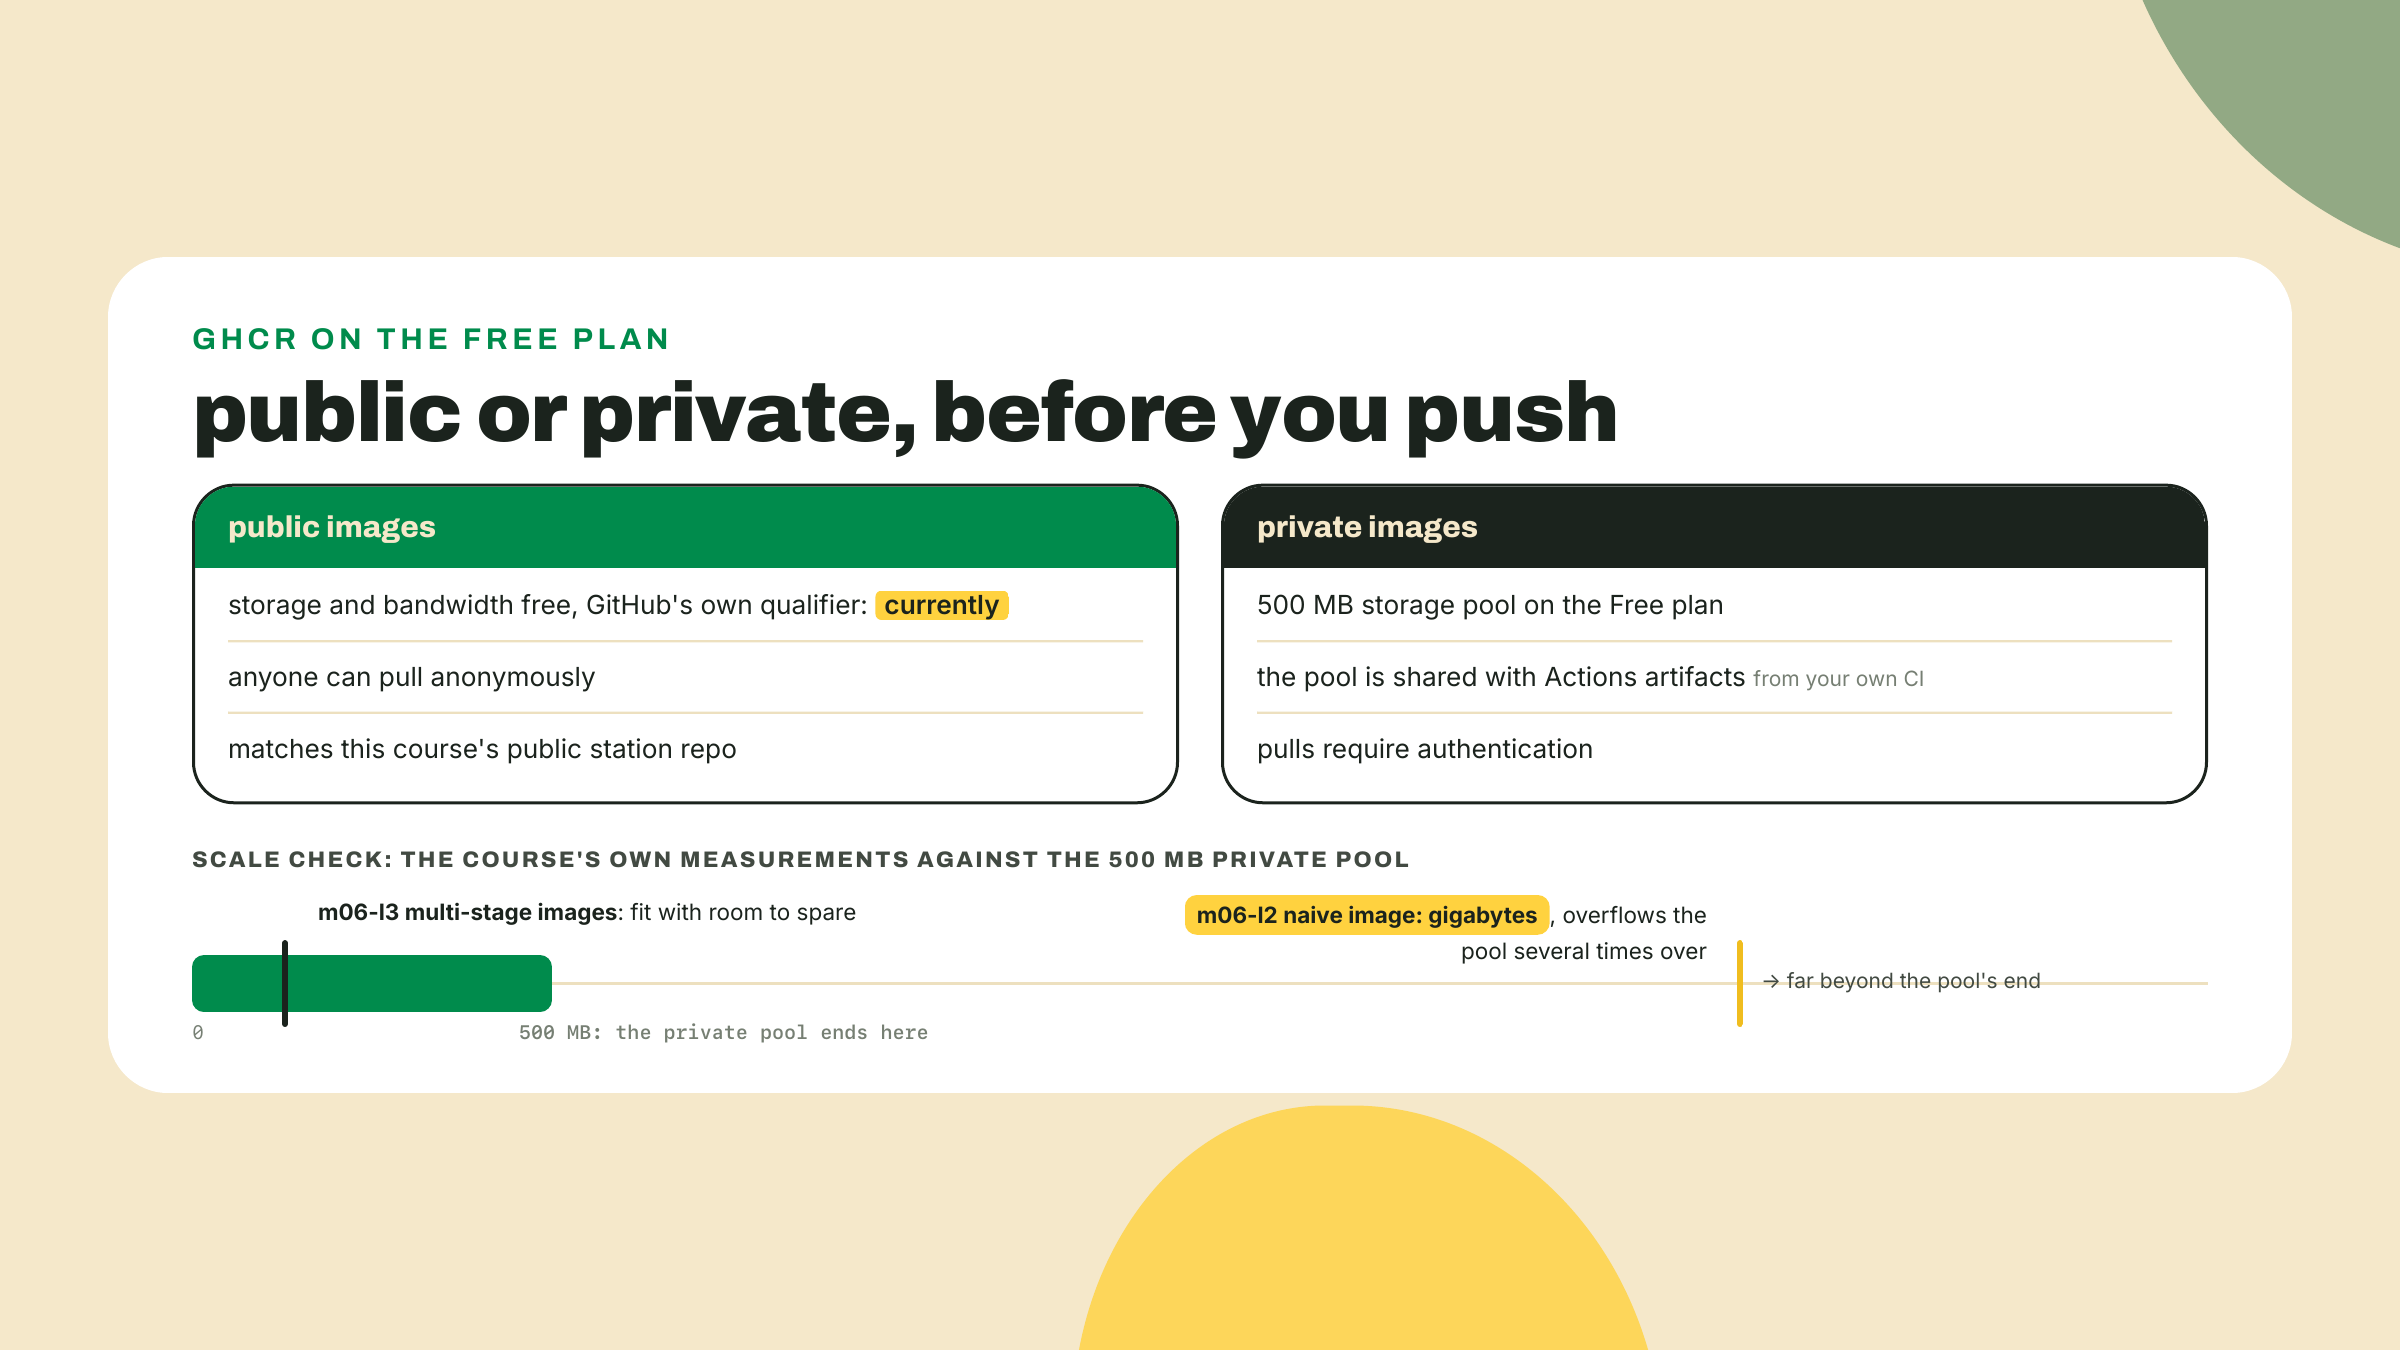
El párrafo del dinero, honesto y corto. Las imágenes de contenedor públicas en GHCR son gratis de almacenar y de servir, y la propia página de facturación de GitHub matiza eso con una palabra, "currently", un adverbio de vendor que deberías leer como el tiempo de los precios, no como el clima. Las imágenes privadas facturan contra un pool en cambio: el plan Free te da 500 MB de almacenamiento de paquetes privados y, la parte que muerde, ese pool es compartido con tus artifacts de Actions, así que los propios uploads de tu CI compiten con las capas de tus imágenes. Corre el número contra tu propia historia: la imagen ingenua que mediste en m06-l2 pesaba gigabytes, lo que significa que habría desbordado ese pool privado entero varias veces, sola, antes de tu primer artifact. Tus imágenes multi-stage entran cómodas. Eso es el trabajo de la lección pasada pagando el alquiler. Una distinción mantiene derecho el modelo mental cuando leas la página de facturación tú mismo: el almacenamiento es sobre los bytes que tus capas ocupan en reposo, mientras los pulls gastan transferencia, un medidor separado; mantener una imagen privada no sale más barato porque nadie la descargue. Para la estación de este curso, cuyo repo es público desde m01-l3, las imágenes públicas son el default honesto y el gratis.
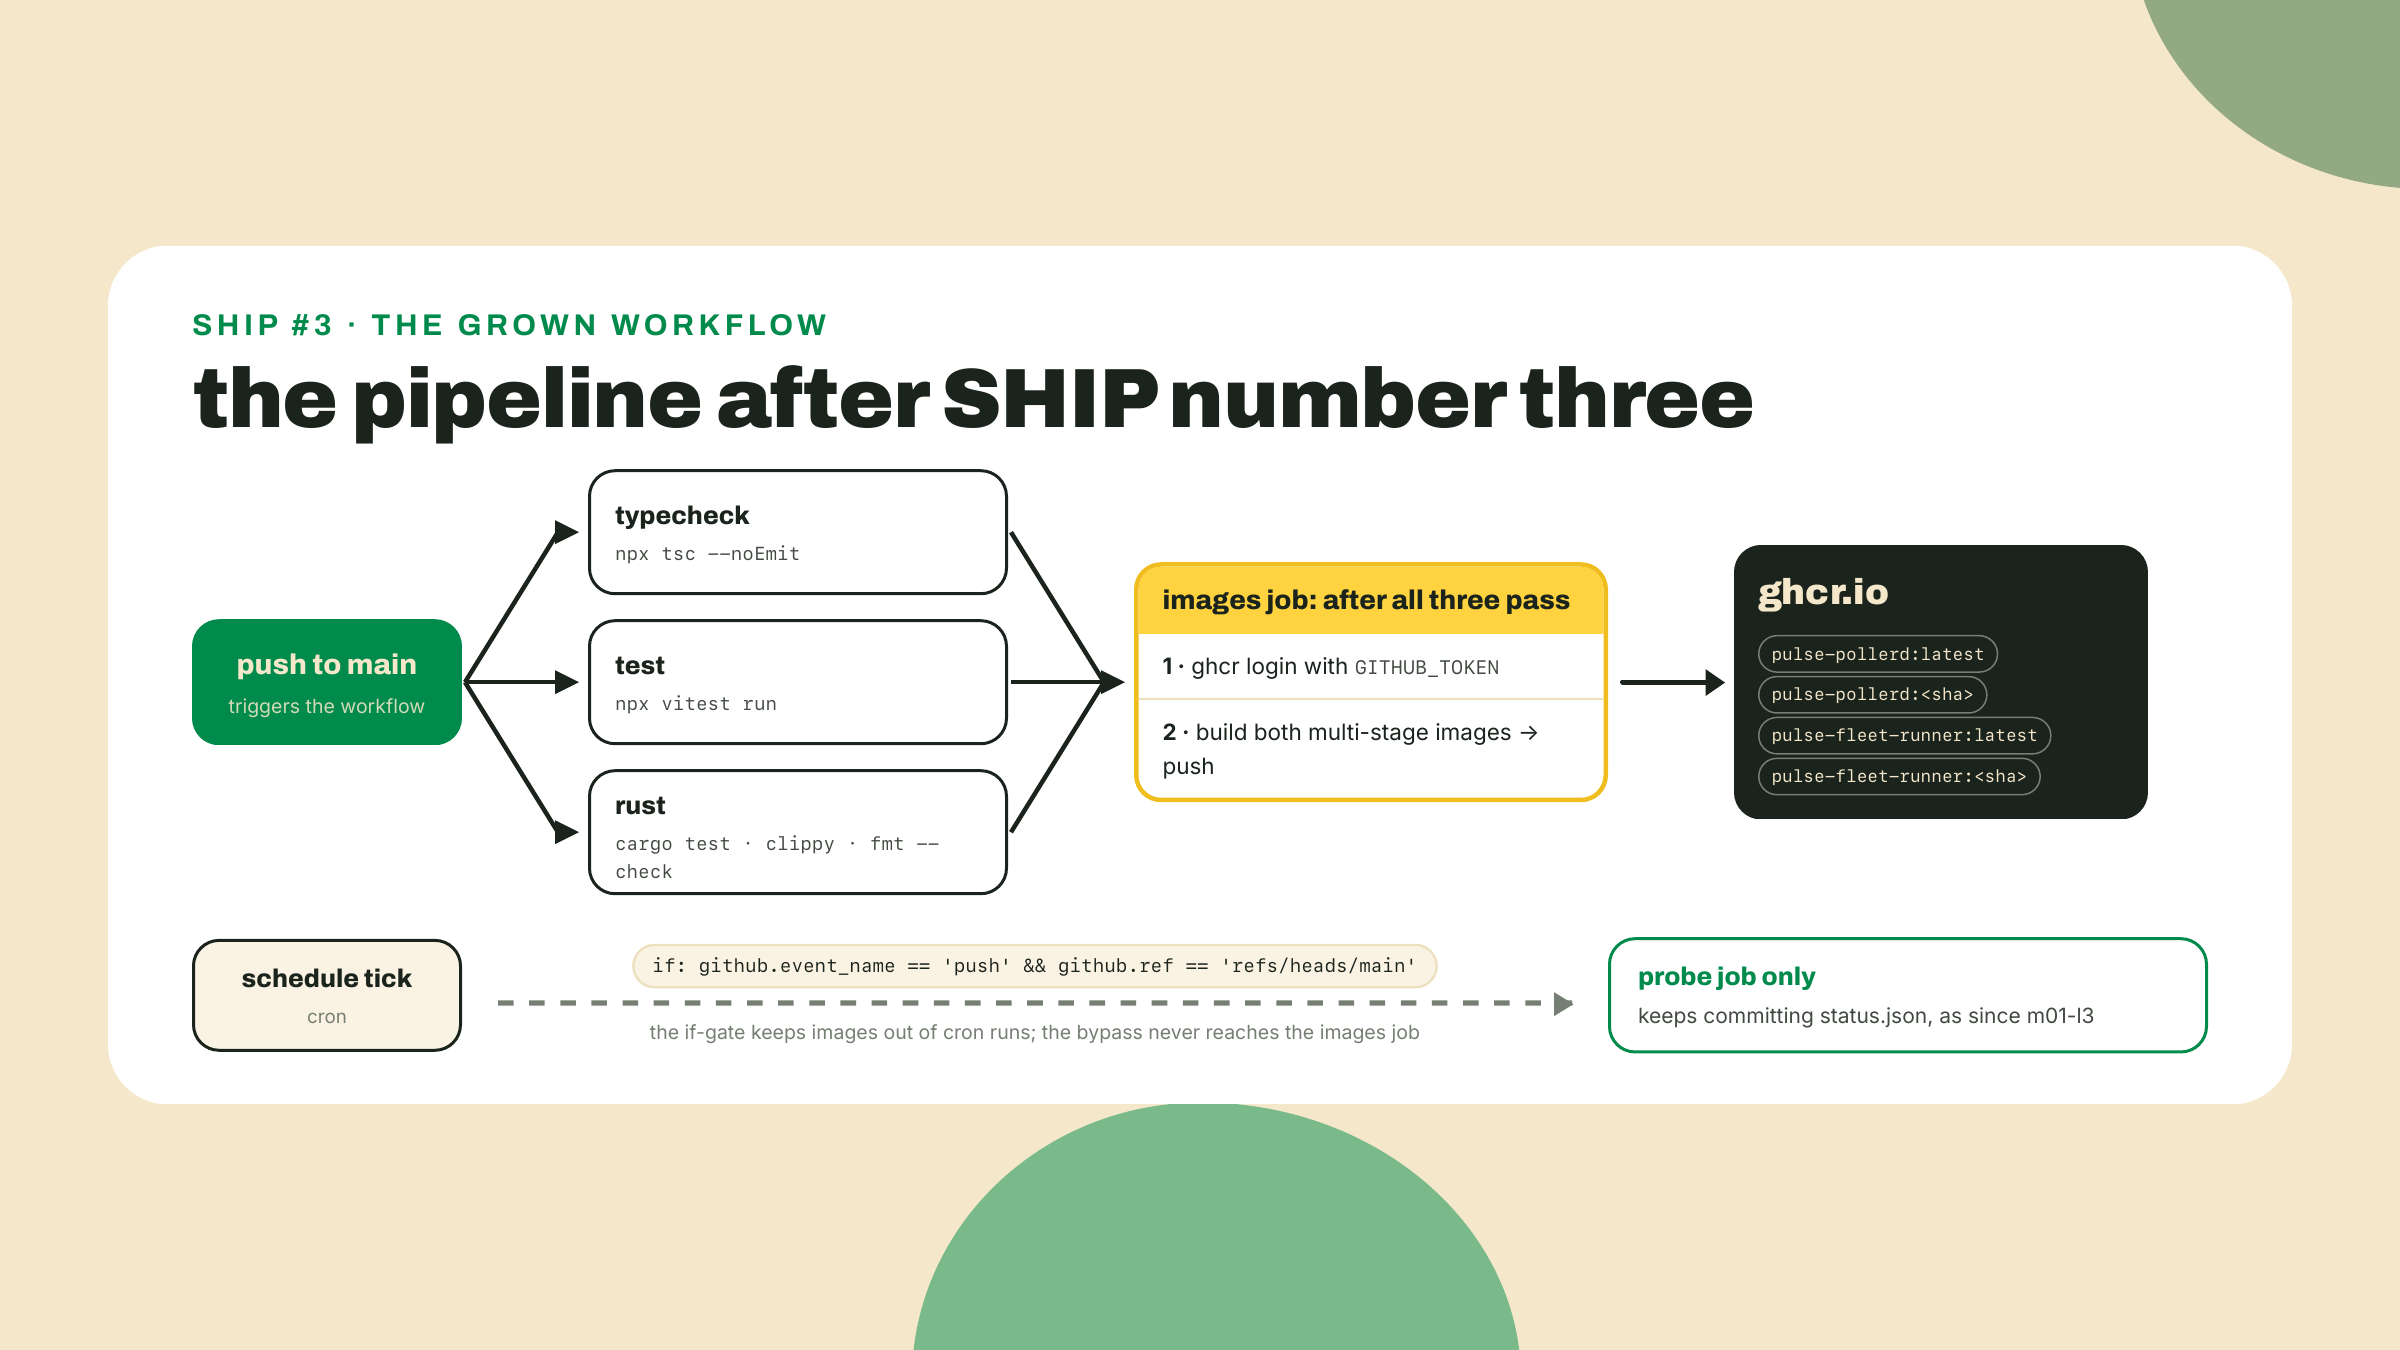
La re-entrega. Mismo repo, mismo .github/workflows/pulse.yml que vienes creciendo desde m01-l3, que ya pone barrera sobre vitest desde m02-l4 y sobre cargo test, clippy y fmt desde m04-l3. Gana un job. El job está trabajado abajo excepto el esquema de tags, que es tu TODO; el flip de visibilidad y el pull desde máquina limpia son tuyos para ejecutar, porque ejecutarlos es la lección.
Pon barrera al job antes de escribirlo. Tu workflow se dispara con push y también con el calendario del cron. El job de la sonda debería seguir disparándose 48 veces al día; un build de imagen no, porque nada de las imágenes cambia cuando tictaquea un calendario. Así que el job que estás por agregar abre con un if que lo corre solo para pushes a main. Lee la condición en el YAML de abajo y dite las dos cláusulas a ti mismo antes de seguir: evento correcto, branch correcto.
Agrega el job images. Agrega esto a pulse.yml, al mismo nivel de indentación que tus jobs existentes:
  images:
    if: github.event_name == 'push' && github.ref == 'refs/heads/main'
    needs: [typecheck, test, rust]
    runs-on: ubuntu-latest
    permissions:
      contents: read
      packages: write
    steps:
      - uses: actions/checkout@v7
      - name: log in to ghcr
        run: echo "${{ secrets.GITHUB_TOKEN }}" | docker login ghcr.io -u "${{ github.actor }}" --password-stdin
      - name: owner, lowercased
        run: echo "OWNER=$(echo '${{ github.repository_owner }}' | tr '[:upper:]' '[:lower:]')" >> "$GITHUB_ENV"
      - name: build and push pollerd
        run: |
          docker build -t "ghcr.io/$OWNER/pulse-pollerd:latest" pulse-rs
          docker push "ghcr.io/$OWNER/pulse-pollerd:latest"
          # TODO: also tag this same build with the commit SHA and push that tag too
      - name: build and push fleet-runner
        run: |
          docker build -f Dockerfile.fleet -t "ghcr.io/$OWNER/pulse-fleet-runner:latest" .
          docker push "ghcr.io/$OWNER/pulse-fleet-runner:latest"
          # TODO: same here, latest AND the commit SHA
Tres glosas donde viven las decisiones interesantes. needs: [typecheck, test, rust] hace que el registro se siente aguas abajo de cada barrera que construiste; una imagen no puede entregarse desde un commit que los tests rechazaron, que es el punto entero de tener barreras. El bloque permissions es el workflow declarando, a la vista, que su token puede escribir paquetes; te encontraste con este bloque en m01-l3 cuando contents: write dejó que la sonda commiteara status.json, y el mismo repaso en media oración cubre el token en sí: los pushes hechos con GITHUB_TOKEN no vuelven a disparar el workflow, así que no hay recursión. Olvida packages: write y el step del push muere con un 403 que parece un problema de contraseña equivocada; no lo es, no falta ningún secret, al token simplemente no se le otorgó el scope, y ahora sabes leer ese 403 como un problema del bloque de permissions para siempre. El step de pasar a minúsculas es el filo cortante de antes, limado: tr dobla tu usuario para que la referencia de imagen sea siempre legal.
Llena el TODO de tags. Dos tags por imagen, latest y el SHA del commit, empujados por separado. Por qué los dos: latest es un puntero mutable de conveniencia, está bien para humanos; el tag de SHA es un recibo inmutable que dice exactamente qué commit produjo esta imagen, y es desde donde desplegarías si alguna vez necesitaras hacer rollback. Adentro del job, el SHA es ${{ github.sha }}. La forma para el poller, tuya para espejarla en el runner:
docker build -t "ghcr.io/$OWNER/pulse-pollerd:latest" -t "ghcr.io/$OWNER/pulse-pollerd:${{ github.sha }}" pulse-rs
docker push "ghcr.io/$OWNER/pulse-pollerd:latest"
docker push "ghcr.io/$OWNER/pulse-pollerd:${{ github.sha }}"
Empuja y mira. Un eco de m06-l2 antes de hacerlo: si pulse-rs/pulse.config.json alguna vez fue un symlink en tu máquina, confirma que el reemplazo por archivo real está COMMITEADO, no solo sentado en tu working tree; el runner construye desde un checkout fresco, donde un symlink trackeado que apunta fuera del contexto de build queda colgando y la imagen del poller muere al arrancar, dos lecciones aguas abajo de su causa. Después commitea, empuja, abre la pestaña Actions. El job de images espera tus tres barreras, después construye las dos imágenes multi-stage en el runner y empuja cuatro tags. Corrida en verde, sin errores, los dos pushes logueados. Guarda la URL de la corrida; el checkpoint la quiere.
Mientras corre, lee el log de build con los ojos de la lección pasada y fíjate en algo que falta: las líneas CACHED. Tu laptop reconstruye el poller en segundos porque la capa de dependencias de cargo-chef está en tu cache local; el runner es una máquina fresca en cada corrida, así que compila el mundo en frío, cada vez, y el job de images va a ser el más lento de tu pipeline por un margen amplio. Eso no es un bug en tu Dockerfile, es el precio de los runners efímeros, y el arreglo (persistir la cache de build entre corridas de CI) es real, está documentado y deliberadamente no se enseña acá; archívalo al lado de la orquestación como algo que vas a agarrar cuando los builds en frío empiecen a doler. La barrera del if del paso 1 es lo que mantiene acotado este costo: lo pagas por merge, nunca por tic de cron.
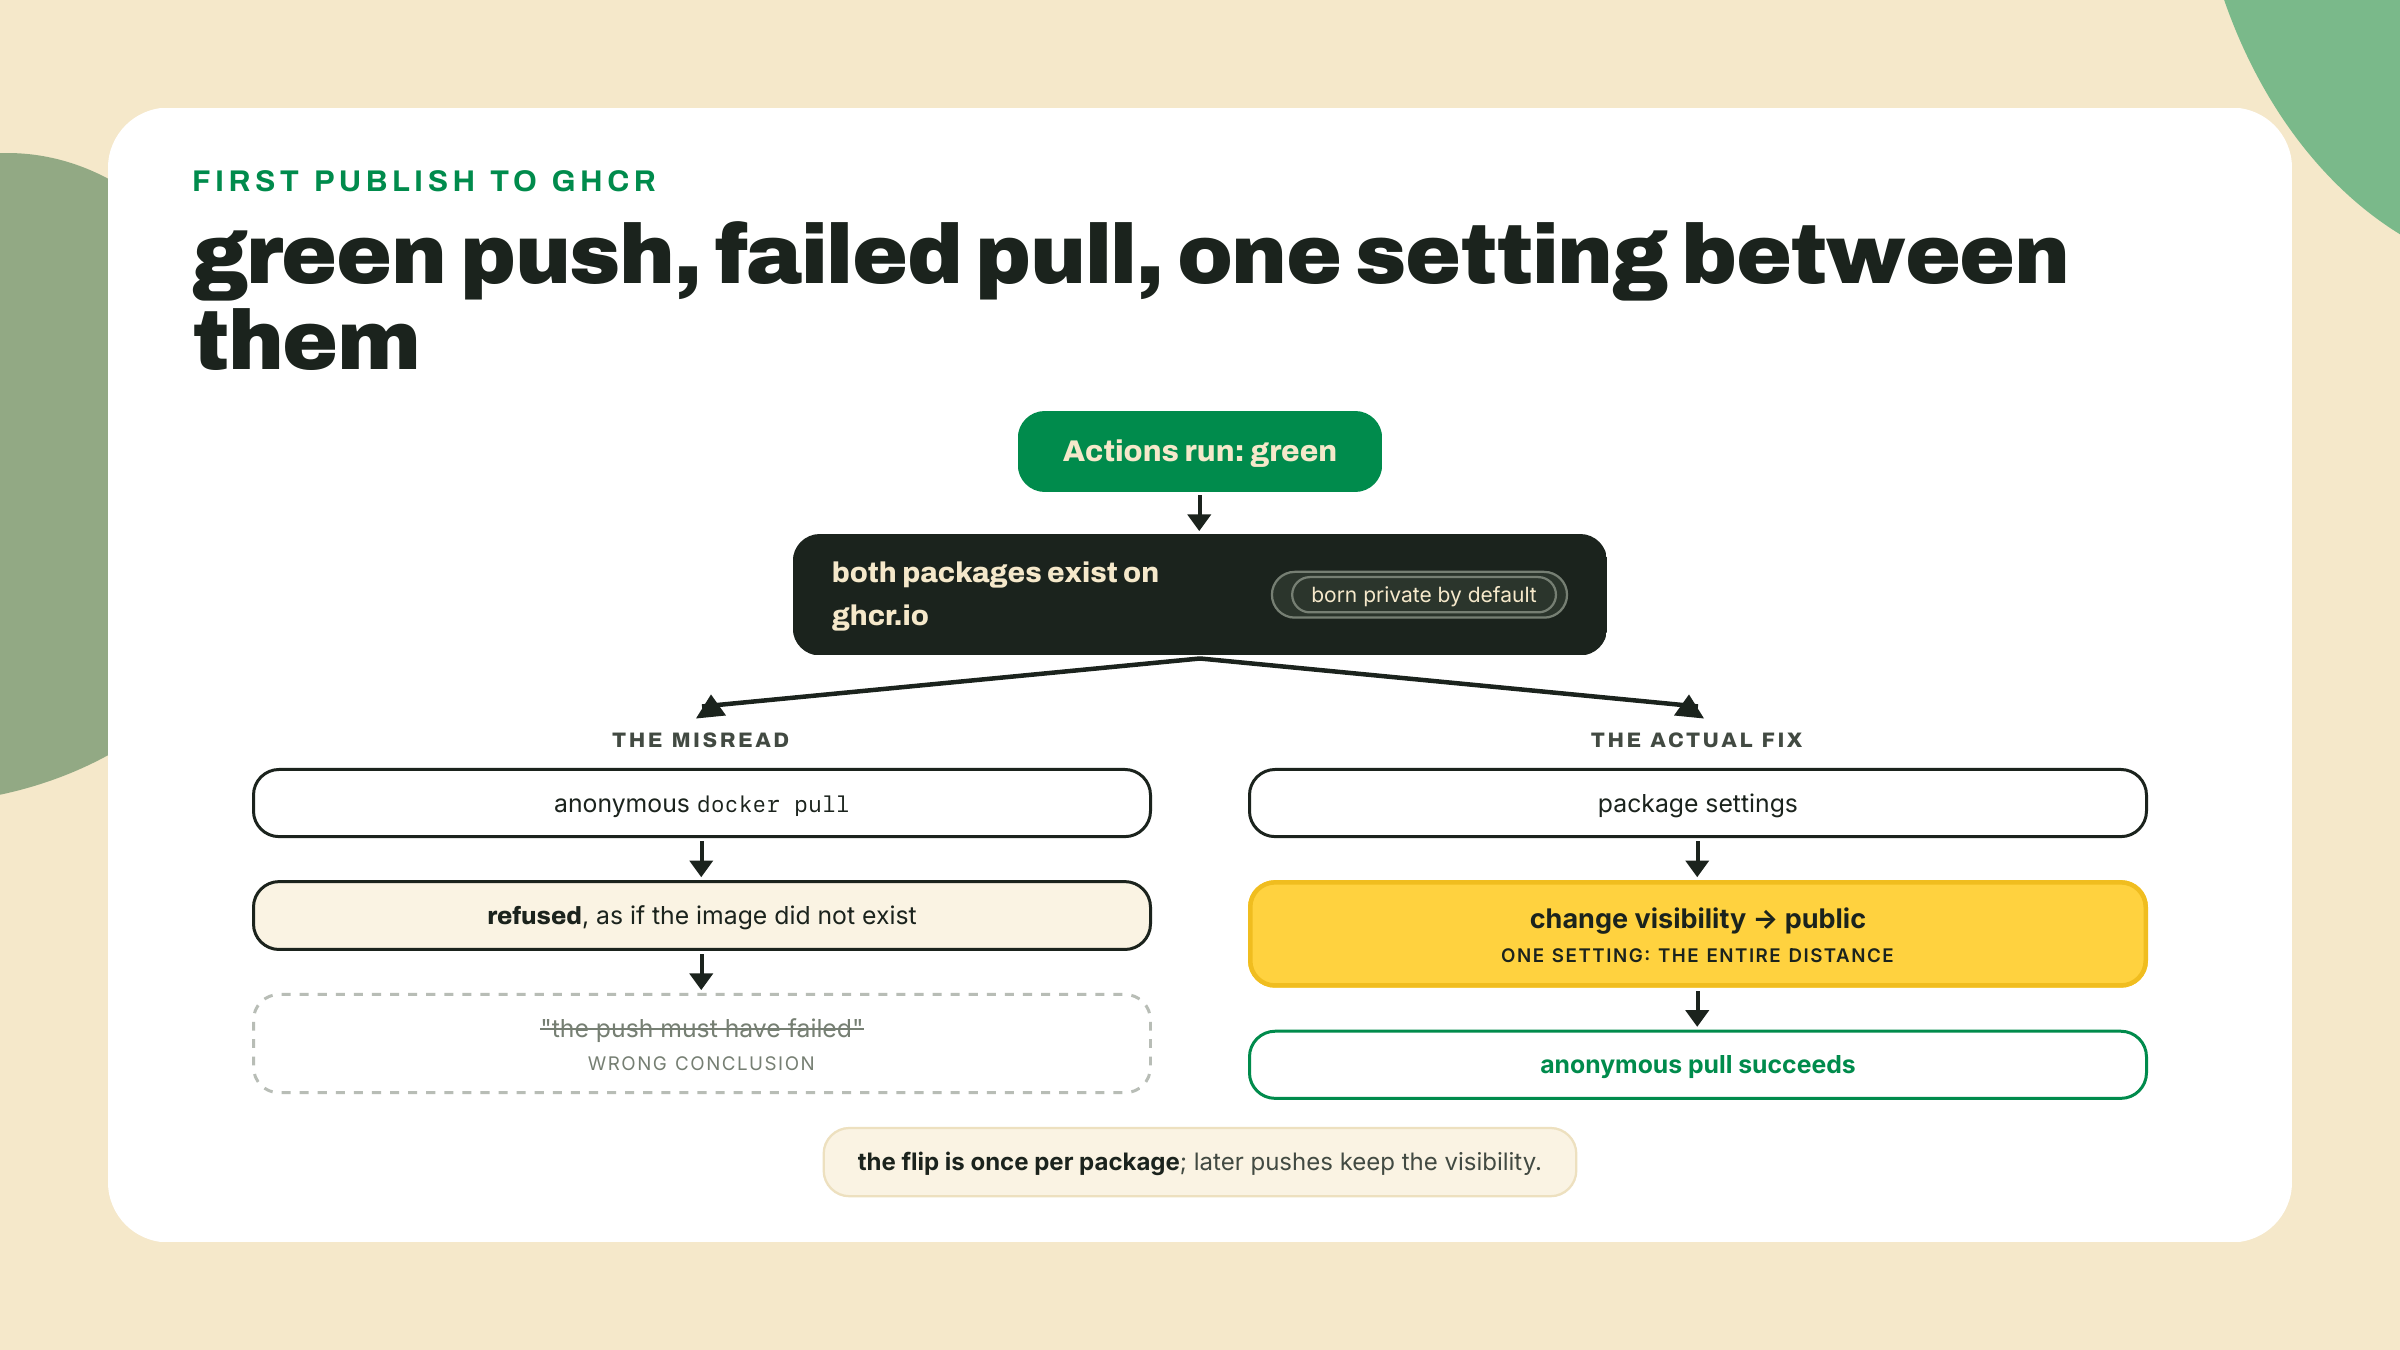
Ahora intenta usarla, y conoce el gotcha. La corrida está en verde, así que las imágenes son públicas, ¿no? Prueba la afirmación como lo haría la máquina de cualquier desconocido:
docker logout ghcr.io
docker pull ghcr.io/<your-username>/pulse-pollerd:latest
El pull falla, denegado, como si la imagen no existiera. No concluyas que el push falló; un push fallido hace fallar el step y la corrida, y la tuya estaba en verde. Este es el default de primera publicación de GHCR: cada paquete nuevo nace privado, visible para ti y para nadie más, y un pull anónimo se rechaza sin confirmar que el paquete siquiera exista. El arreglo es un setting, no código. En github.com, abre la pestaña Packages de tu perfil, haz clic en pulse-pollerd, después en Package settings, y después en la zona de peligro en Change visibility a Public y tipea el nombre del paquete para confirmar. Haz lo mismo con pulse-fleet-runner. Este es un flip de una sola vez por paquete; los pushes futuros al mismo paquete mantienen su visibilidad.
La prueba que viaja. Este es el chequeo intermedio del módulo, y es deliberadamente el mismo comando que correría un desconocido. Todavía deslogueado de ghcr.io, o mejor, en una segunda máquina que nunca vio tu código:
docker pull ghcr.io/<your-username>/pulse-pollerd:latest
docker run --rm -p 8080:8080 ghcr.io/<your-username>/pulse-pollerd:latest
Después curl -s localhost:8080/status desde otra terminal. Ese JSON es tu poller, corriendo desde una imagen que tu máquina le hizo pull a la internet pública, construida por un runner de CI que nunca tocaste, desde un commit que tus barreras aprobaron. El pull de GHCR es la demostración: no "funciona en mi máquina" sino "funciona en cualquier máquina que pueda hacer pull".
Solo, dos costuras, sin conceptos nuevos. Primero, haz que los logs entrelazados sean fáciles de grepear: dale a las líneas de log de cada servicio una forma estable de una línea, algo como una línea de resumen sweep por intervalo para el runner y una línea por poll para el poller, para que docker compose logs -f se lea como una línea de tiempo en vez de dos monólogos mezclados. Estás editando la salida de tus propios programas, no compose; la línea del runner es un console.log en el loop de intervalo, la del poller un println! (o la línea de log que ya emites) en el loop de poll. La prueba de una buena forma es que docker compose logs | grep sweep cuente la historia de la última hora por sí solo. Segundo, profiles: marca el servicio fleet-runner con profiles: ["fleet"], y después pon COMPOSE_PROFILES=fleet en un archivo .env al lado de compose.yaml para que un docker compose up pelado siga arrancando los dos servicios, mientras COMPOSE_PROFILES="" docker compose up levanta solo el poller. Compose lee ese archivo .env por su cuenta; nada lo sourcea. Aceptación: las dos variantes se portan como se describió, y docker compose config --services muestra la lista de servicios cambiando entre ellas, dos nombres en el caso default, uno cuando el profile se vacía.
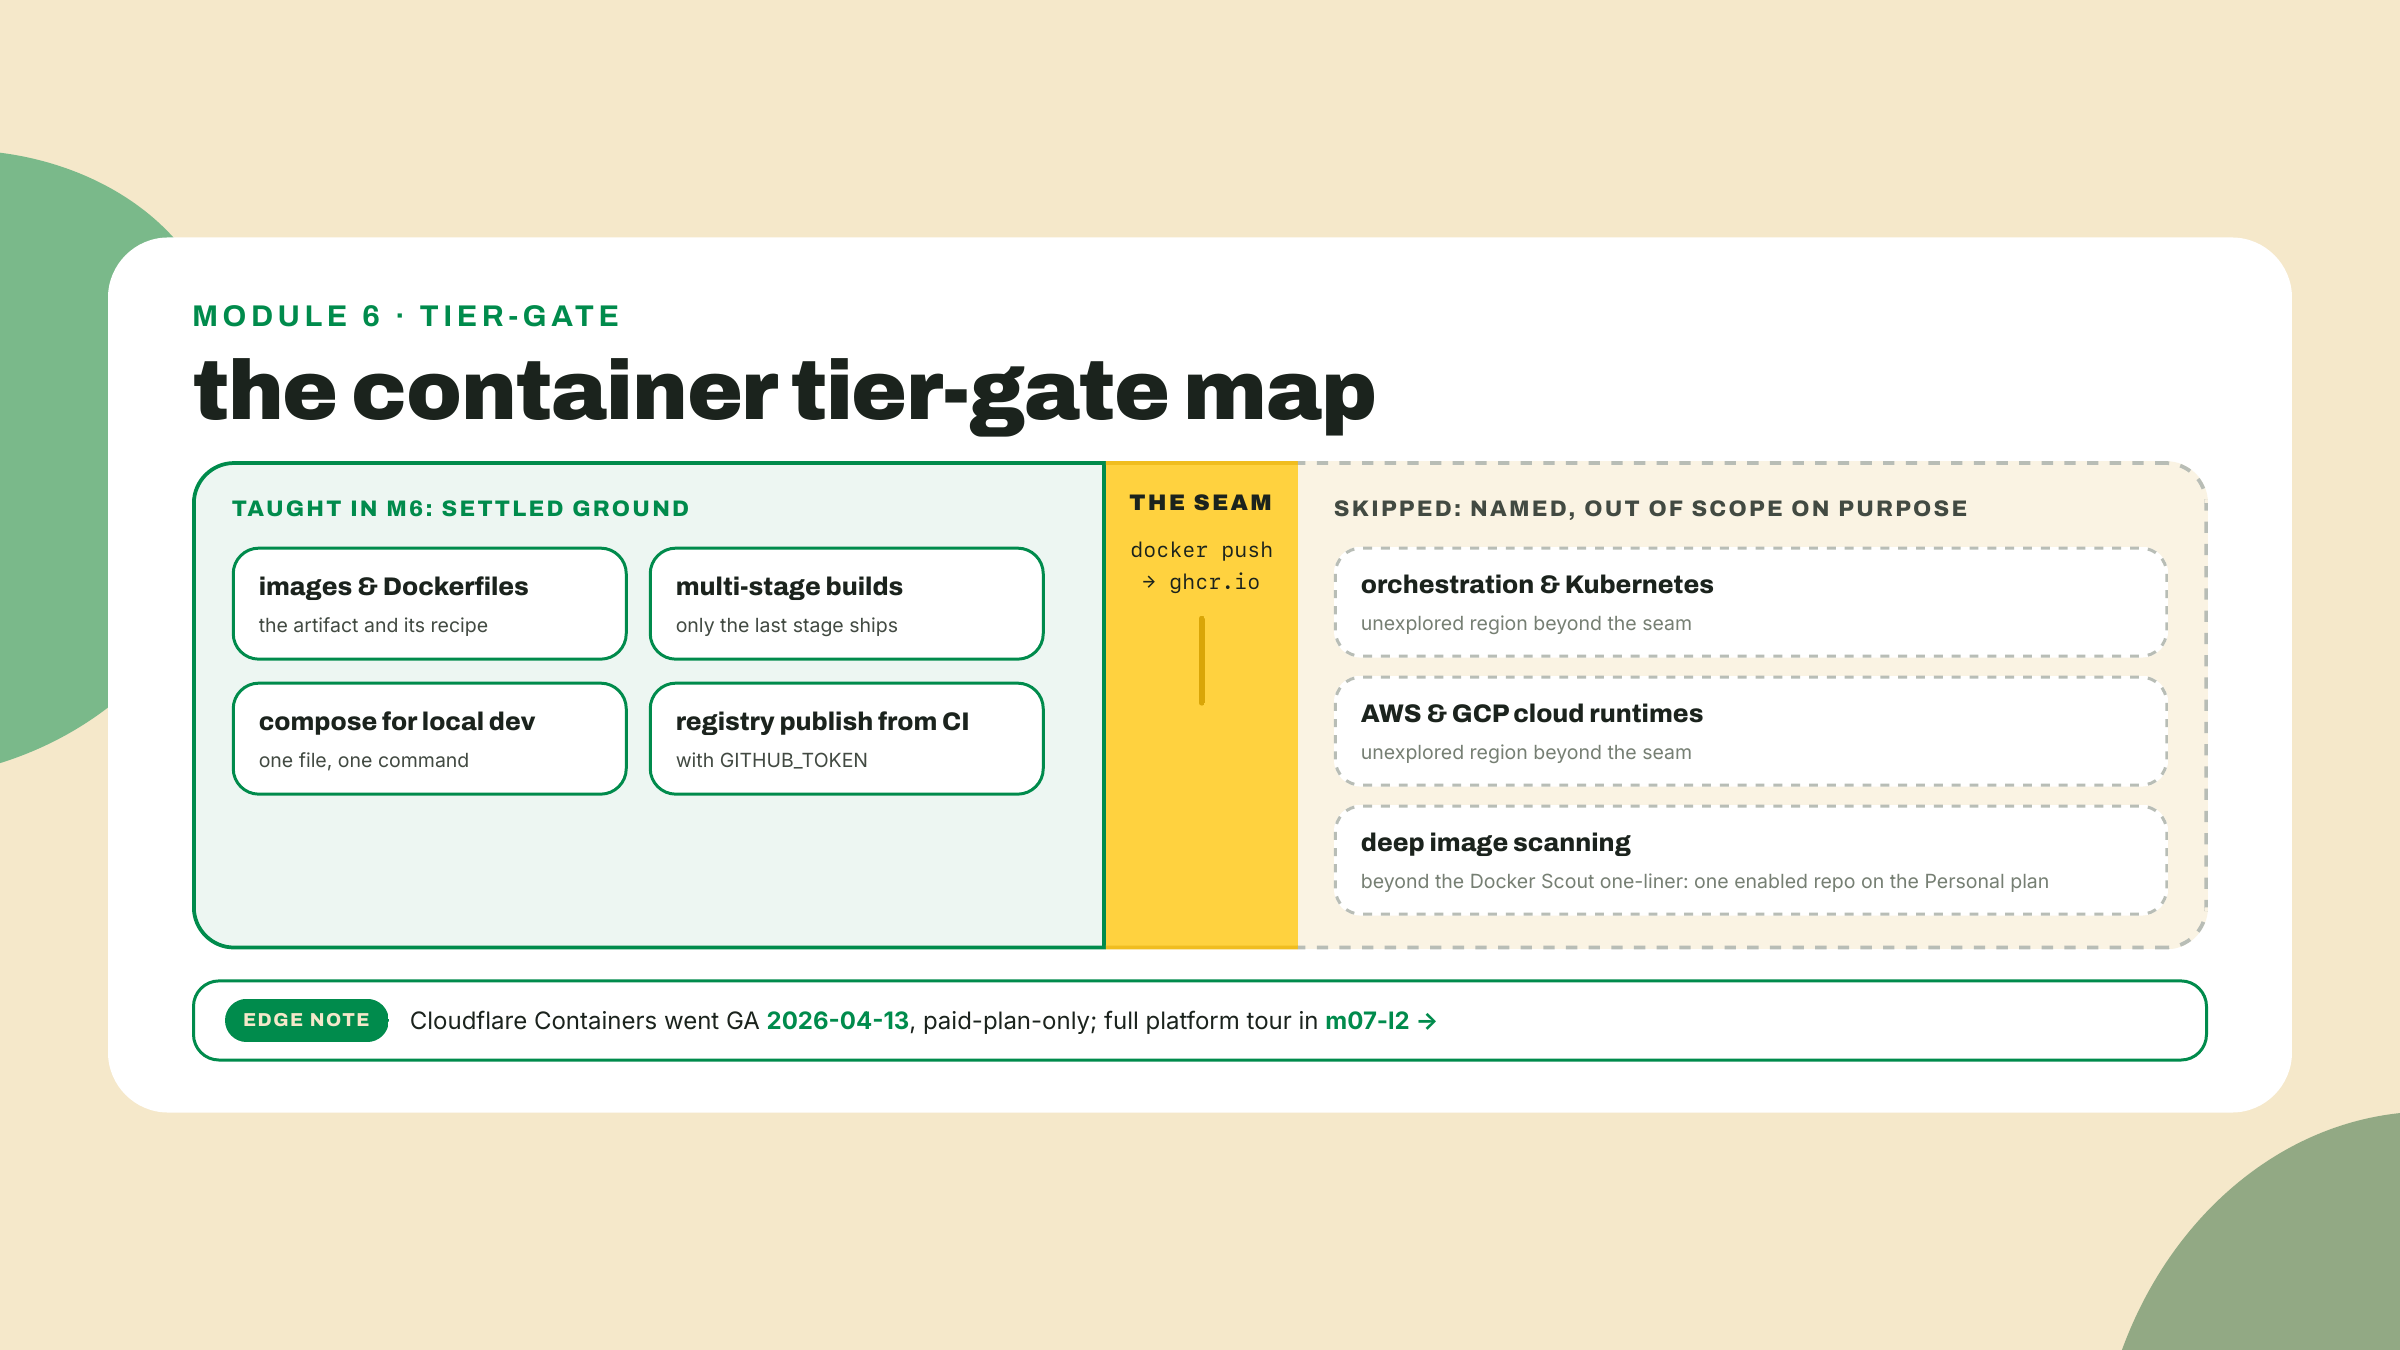
Cada límite de entrega en este curso te debe un mapa de lo que dejó afuera, y el mapa del tier de contenedores importa más que la mayoría porque el ecosistema arriba de él es enorme. Este es un mapa, no una disculpa: el territorio salteado se salteó porque el 80% del ciclo de vida de desarrollo por el que viniste no lo requiere. Tres nombres, señalizados con honestidad.
Orquestación, con Kubernetes a la cabeza, es todo lo que está del otro lado de la costura del deploy: una flota de máquinas que hacen pull de tus imágenes, mantienen corriendo la cantidad declarada de copias, reemplazan las que mueren, y despliegan versiones nuevas de forma gradual. Lee esa oración de nuevo y fíjate en que es el vocabulario de tu archivo compose, servicios e imágenes y estado deseado, estirado entre muchas máquinas; por eso aprender compose con honestidad es el primer peldaño correcto aunque compose no sea la escalera. Kubernetes está fuera de alcance a propósito, este curso no tiene hermano a quien pasarte para eso, y ahora tienes el concepto exacto, imágenes en un registro, que consume todo orquestador.
Runtimes de nube, AWS y GCP y sus servicios administrados de contenedores, mismo veredicto: son consumidores del lado del pull de la costura que acabas de construir, y enseñar cualquiera de ellos habría costado un módulo que este curso gastó en los dos lenguajes en cambio. La profundidad del escaneo de imágenes recibe una línea honesta: Docker Scout escanea capas con vulnerabilidades conocidas, su plan Personal incluye 1 repo habilitado, y ese es tu punto de entrada gratis cuando las imágenes de la estación empiecen a cargar dependencias que no escribiste. Un toque de color para el borde del mapa, porque dice algo cierto sobre dónde está esta industria: el 2026-04-13 Cloudflare Containers llegó a GA, la plataforma de edge-functions admitiendo que algunas cargas de trabajo solo quieren una caja Linux, pero está detrás del plan Workers Paid de $5/mo, que falla la regla de este curso de no-tarjeta; la familia de plataformas a la que pertenece recibe su tour completo en m07-l2.
Barrera sobre hacer, tres cosas para pegar: tu salida de docker compose ps mostrando los dos servicios en Up mientras curl -s localhost:8080/status responde desde el stack compuesto; la URL de la corrida verde de Actions cuyo job de images empujó los dos paquetes; y el docker pull deslogueado o desde segunda máquina de tu propia imagen de GHCR seguido por las primeras líneas de su salida de docker run. Esa tercera es la que habría sido imposible en el desayuno.
Un pedido de calibración antes de que cierres la terminal. Esta lección apostó a que el archivo compose necesitaba solo dos TODOs y el job de CI solo uno, sobre la teoría de que tres lecciones de Docker y dieciocho de hacer crecer el pipeline se ganaron esa delgadez. Si alguno se sintió como llenar un formulario en vez de construir, o si el flip de visibilidad te agarró incluso con la advertencia impresa arriba, di cuál en el feedback del curso; el cronograma de repliegue se ajusta exactamente con estos reportes.
La estación ahora corre en cualquier parte donde viva un daemon de docker, y esa oración era toda la promesa del módulo. Pero fíjate en lo que todavía concede: la estación corre en un lugar a la vez, el daemon de alguna máquina única, en algún lado. El módulo que viene las sondas dejan de vivir en una región por completo. La misma lógica de la estación va al edge de Cloudflare, desplegada a cientos de ciudades a la vez, en los dos lenguajes, TypeScript primero y después el pago de Rust. El registro era el deploy; todo lo que viene después de docker push es el scheduler de alguien. Hora de ir a conocer a los schedulers.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.