Cargando...

 BetaBeta
m06-l4 cerró el tier de contenedores: el poller y fleet-runner corren local bajo compose, las dos imágenes viven en GHCR empujadas por CI, y la barrera del tier nombró lo que saltamos (K8s, la nube, profundidad de escaneo). Así que la estación ahora mide internet desde un panel en Vercel, un cron en Actions, y un poller en una caja. Cada uno de esos la mide desde exactamente un lugar. Hoy eso cambia: despliegas pulse-edge-ts, un Cloudflare Worker que corre el mismo clasificador de pulse-core en un calendario, recuerda el último estado conocido en Workers KV, guarda un secreto de verdad como se debe, y sondea el RPC público de Solana como un target más. El apoyo que este módulo viene adelgazando: el esqueleto del worker y la config vienen dados, el cableado de KV y el loop del cron son TODOs de completion que terminas tú, y el segundo tipo de target de sonda, al final, es entero tuyo. Ya entregaste a tres plataformas; la cuarta debería sentirse menos como un tutorial y más como reconocimiento.
Acá está el dolor, y es uno que tu propia estación viene teniendo calladita desde el módulo uno. Una sonda que corre en una región te cuenta de la ruta de esa región al target, no del target. Tu cron de Actions corre donde sea que GitHub lo haya planificado. Tu poller corre en tu casa. Cuando cualquiera de los dos dice "degradado, 900ms," de verdad no puedes distinguir si el target se puso lento o si un cable transatlántico tuvo una mala tarde. El arreglo no es un servidor más grande. El arreglo es tu código corriendo en cientos de ciudades a la vez, y un tier gratis te lo da en los primeros diez minutos de esta lección. Haz esto ahora:
npm create cloudflare@latest -- pulse-edge-ts
El scaffolder (Cloudflare le dice C3, y baja por npm, sin instalar nada más allá de esta línea) hace una serie corta de preguntas. Responde: empieza con el Hello World example, plantilla Worker only, lenguaje TypeScript, git Yes, y cuando ofrezca desplegar, di No, porque queremos leer lo que entregamos primero. Dos notas de prompts del 2026-09-04: C3 ahora también ofrece un archivo AGENTS.md, responde que no; y adentro del repo de la estación el git Yes calladamente no hace nada (C3 detecta el repositorio padre). Las dos cosas están bien. Te queda una carpeta que contiene src/index.ts, una config wrangler.jsonc, y wrangler mismo fijado como dependencia de dev (línea v4, 4.128.0 cuando lo chequeé el 2026-09-02), que es por qué cada comando de wrangler en esta lección corre a través de npx. Ahora:
cd pulse-edge-ts
npx wrangler dev
Abre la URL de localhost que se imprime, ve Hello World!, para el servidor de dev, y entrégalo de verdad:
npx wrangler deploy
El primer deploy te lleva de la mano por el login del navegador y por elegir un subdominio workers.dev, y después imprime una URL en vivo con la forma pulse-edge-ts.<your-subdomain>.workers.dev. Ábrela en tu teléfono. Eso es SHIP #4, una cuarta plataforma en vivo antes de que termine la sección de teoría, y todo el resto de esta lección es mejorar lo que responde en esa URL. (Los ships hasta ahora, en orden: #1 el cron de Actions en m01-l3, #2 la URL del panel de Vercel en m03-l3, #3 las imágenes de GHCR en m06-l4, #4 acá. El gemelo de Rust de la lección que viene aterriza una segunda URL bajo este mismo ship, porque la plataforma es el ship y el segundo motor es el punto.)
Tu poller es un proceso de node: arranca, es dueño de memoria, corre hasta que algo lo mata. Un Worker no es ninguna de esas cosas. Tu código corre adentro de un isolate, un sandbox liviano adentro del runtime workerd de Cloudflare, y la plataforma levanta isolates en la ciudad suya a la que llegue el tráfico, corre tu handler por un evento, y tira el isolate sin ningún problema. Ningún arranque que controles, ninguna memoria que conserves, ningún proceso que sea "el" servidor. El contrato es un par de handlers: fetch corre cuando llega un request, scheduled corre cuando dispara un cron. Ese es todo el modelo de programación.
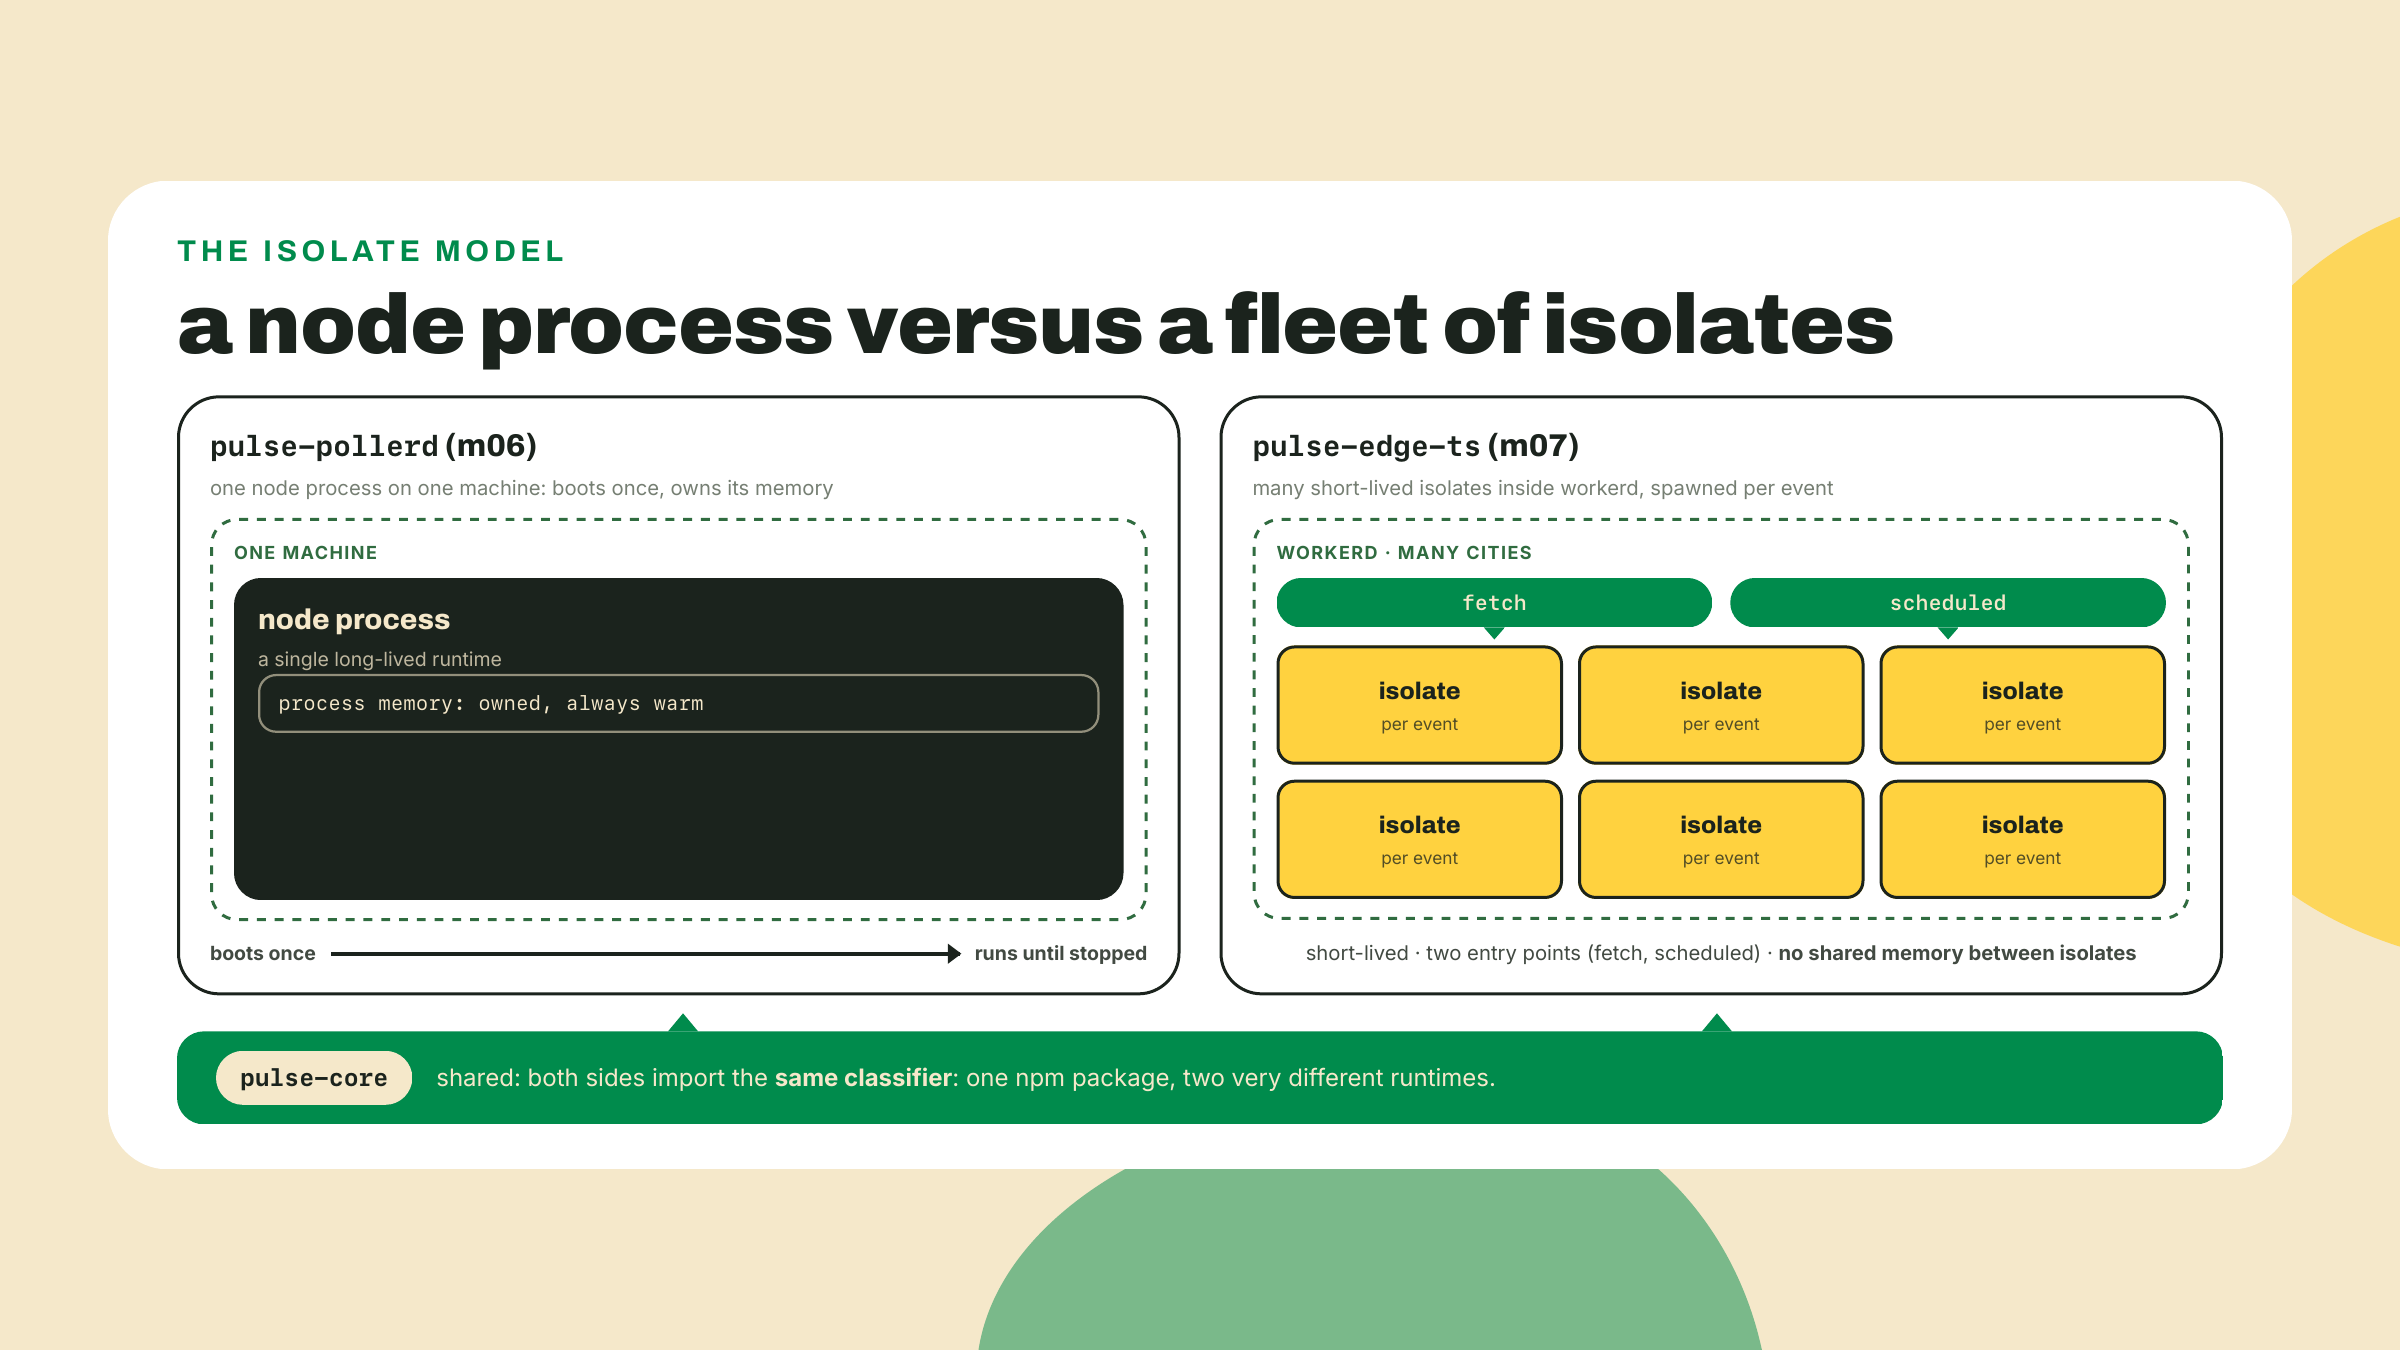
El one-liner honesto, y desarma casi todo el misterio: el edge no es un servidor más rápido, es tu código donde el usuario ya está. Todo lo raro de Workers sale de ahí. Los builtins de node existen solo como shims, porque no hay node ni OS debajo: una llamada al sistema de archivos no tiene disco al que llegar. Nada de memoria de larga vida, porque no hay "la máquina" en la que viva. Un presupuesto de 10 ms de CPU por invocación en el tier gratis, porque mil ciudades pueden costear correrte solo si eres chico. Y las partes de tu codebase que sobreviven este entorno sin cambios son exactamente las partes que m03-l1 te obligó a hacer puras. Vamos a cobrar esa afirmación en un minuto.
Un párrafo sobre Pages, porque internet va a intentar mandarte para allá. Cloudflare históricamente entregó un segundo producto, Pages, para sitios estáticos, y los tutoriales de la era 2023 para "despliega tu página de estado" te van a apuntar ahí. Cuando sondeé los docs de Pages para esta lección el 2026-09-01, el propio banner de Cloudflare decía: "Workers soporta la mayoría de los casos de uso de Pages y ofrece un conjunto de funcionalidades más amplio. Es la plataforma principal de Cloudflare para construir aplicaciones. Empieza los proyectos nuevos con Workers". Eso es un vendor jubilando un producto por recomendación, a la vista de todos, y nos zanja la pregunta: este curso construye Workers, punto, y los assets estáticos viajan encima de Workers cuando los necesitamos. La lección durable le gana a la trivia de plataforma. Lee los docs actuales del vendor, no posts de blog del año en que se escribió el tutorial; viste a los docs de Docker hacer la misma migración calladita sobre el propio verificador de links de este curso allá en m06-l2.
Ahora la columna vertebral de ingeniería de esta lección. En m03-l1 partiste la estación en pulse-core (la unión ProbeResult, classifyProbe, los helpers de backoff, toda la lógica pura) y paquetes de app que hacen I/O alrededor. En m03-l4 publicaste el core a npm bajo tu scope. Esa decisión se paga sola hoy, porque el worker es un proyecto completamente nuevo fuera de tu workspace, y puede jalar el motor como lo haría cualquier extraño:
npm i @YOUR_NPM_USERNAME/pulse-core
Todo en ese paquete importa a workerd sin cambios. Clasificadores, tipos, backoffDelay: funciones puras sobre datos pelados, ninguna opinión sobre dónde corren. Esa es toda la razón por la que existió la disciplina de extracción, y este es el tercer consumidor probándolo (el panel de Vercel fue el segundo).
Lo que no porta es todo lo que rodea al core, y workerd falla a gritos exactamente en la costura, aunque la falla se movió desde la era temprana de Workers. El workerd actual trae una capa de compatibilidad con Node, prendida por defecto en fechas de compatibilidad recientes, así que import { readFileSync } from "node:fs" ya no rompe el build; el import resuelve y readFileSync es una función de verdad. Lo que falta es la máquina debajo. El único sistema de archivos que ve un worker es su propio bundle de solo lectura, montado en /bundle, así que en el momento en que esa función busca el archivo de config de la flota el runtime se niega siquiera a arrancar, nombrando el camino que no pudo encontrar. Algunas APIs no llegan tan lejos: child_process.spawn existe como nombre y lanza ERR_METHOD_NOT_IMPLEMENTED en el instante en que lo llamas. Esto no es un bug para rodear; es la plataforma dibujándote en rojo la frontera de núcleo puro y cascarón de I/O: los módulos con shim, el sistema operativo ausente. Cada lado de la costura tiene un reemplazo nativo de la plataforma: el I/O de archivos se vuelve fetch (la red es el disco acá), el acceso a env se vuelve bindings tipados en el objeto env que reciben tus handlers, y el estado persistente se vuelve KV. El port no es "haz que la flota corra en el edge." Es "importa el core, reescribe el cascarón."
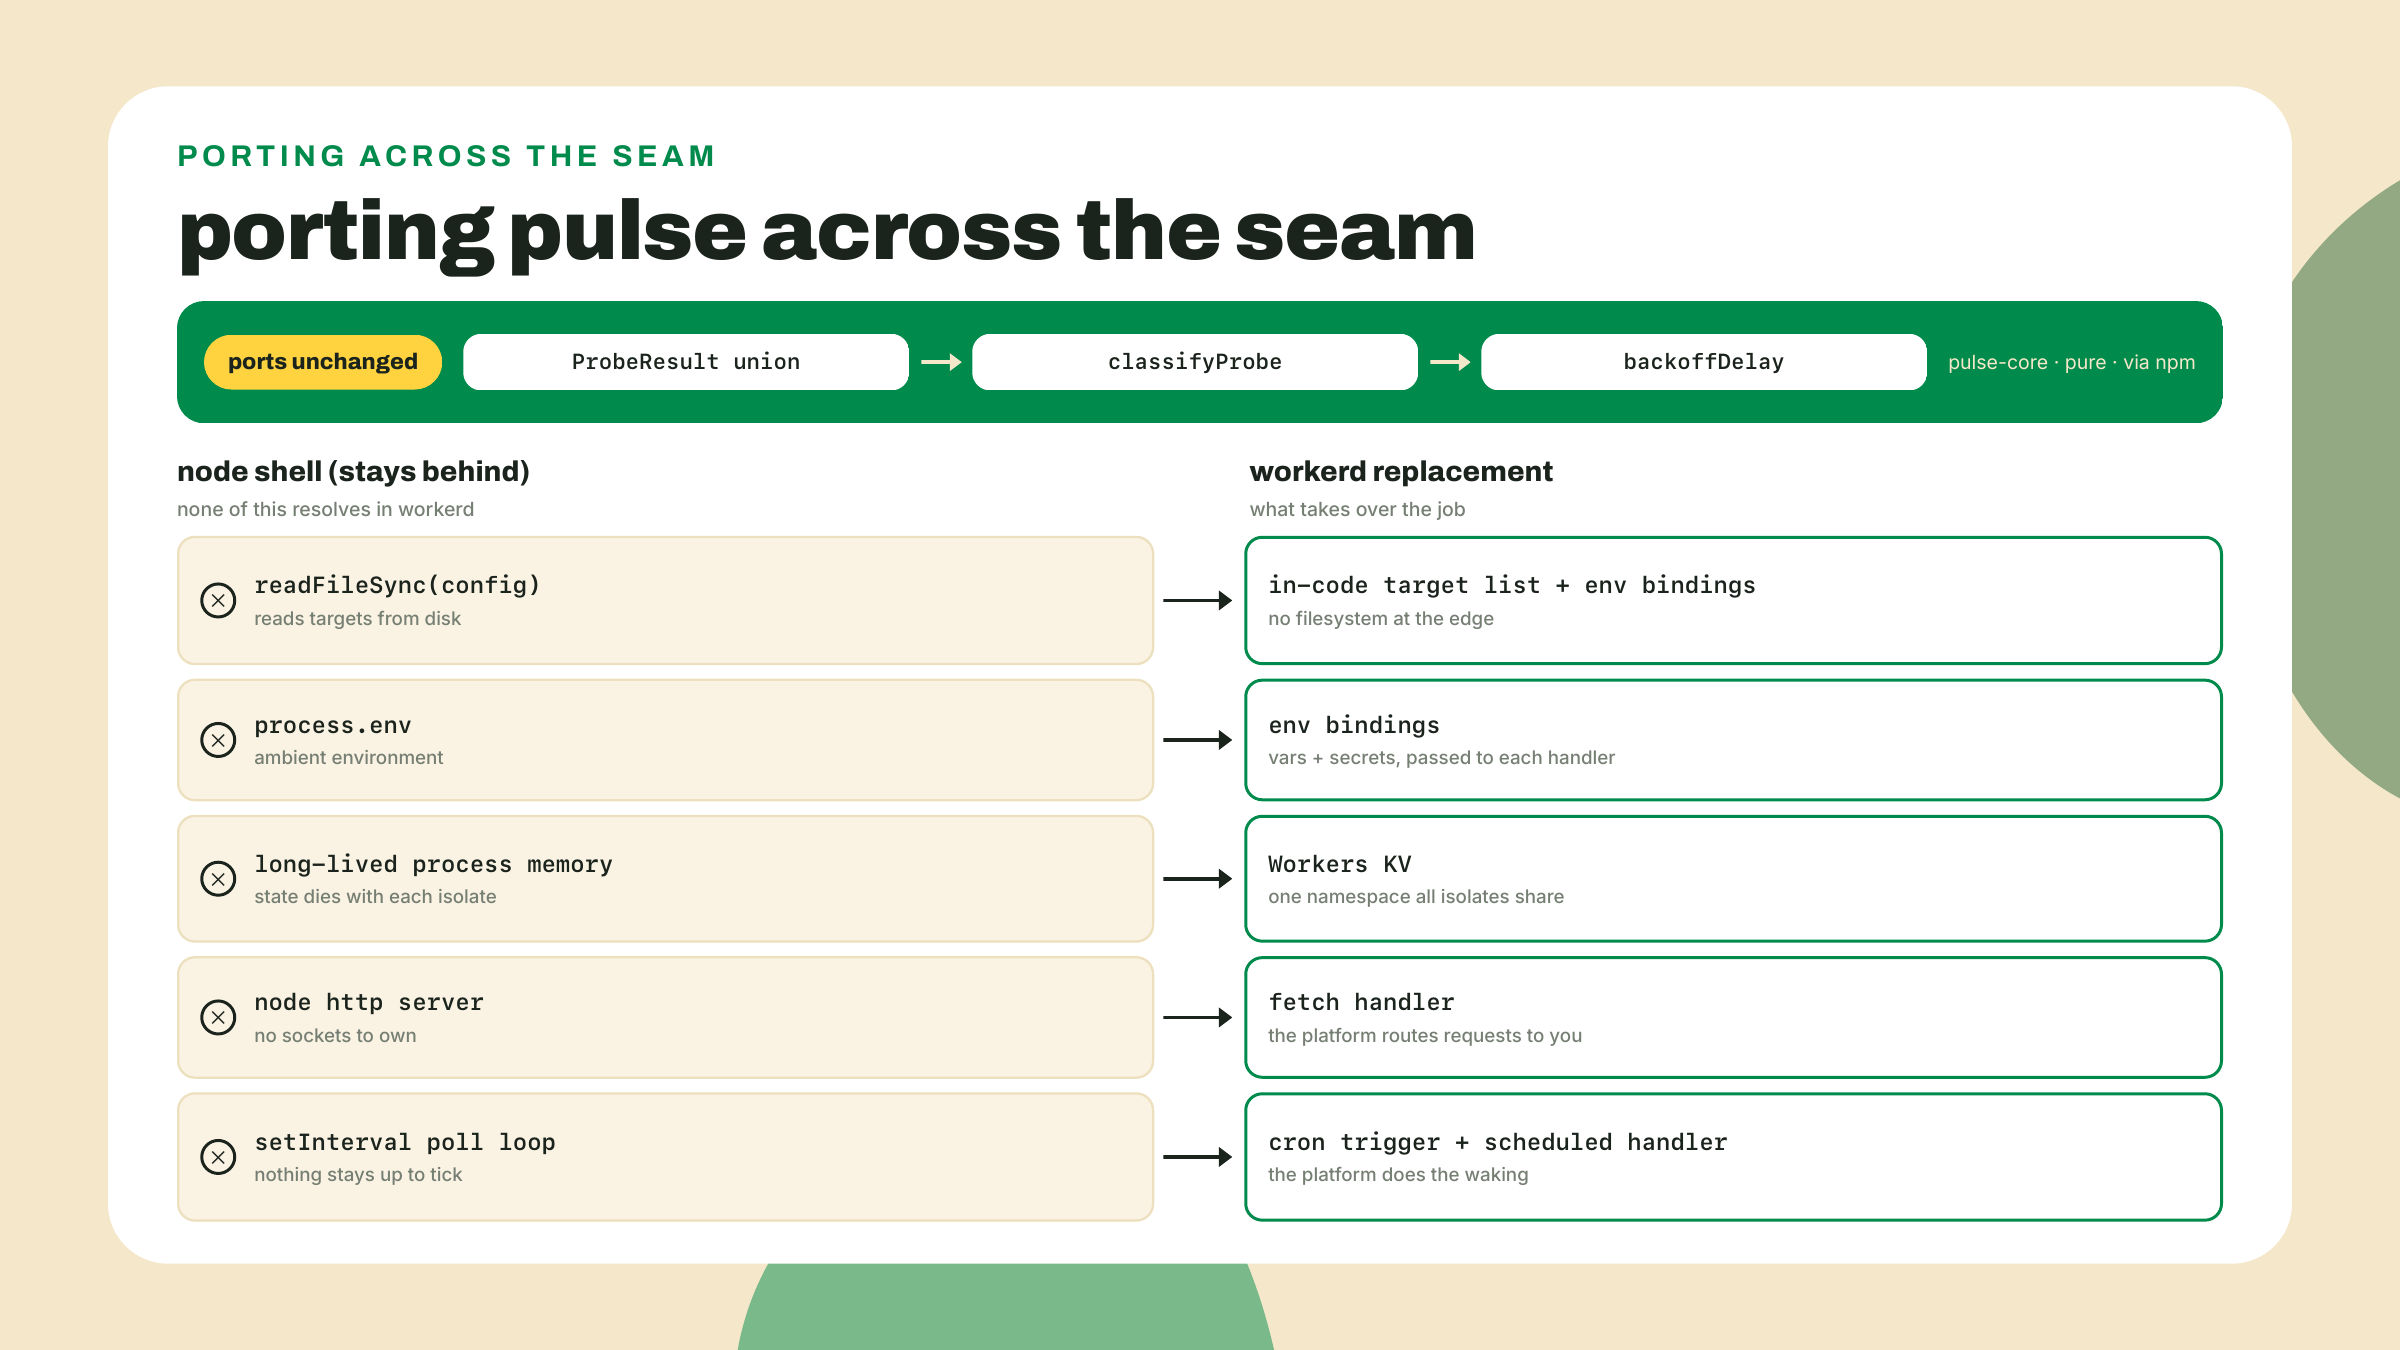
Una palabra más sobre esos bindings, porque son la mejor idea callada de la plataforma y toda la relación del worker con el mundo exterior. En la flota, la configuración y la capacidad llegaban de forma ambiente: process.env era una bolsa global a la que cualquier módulo podía meter la mano, y nada en la firma de una función te decía que necesitaba una base de datos o un token. Un Worker invierte eso. Todas las capacidades que tu código puede tocar (el namespace de KV, el secreto, las vars de config peladas) se declaran en la config de wrangler, y el runtime se las da a tu handler como un único parámetro env tipado. Nada es ambiente. Lee la firma de un handler y sabes todo su radio de explosión. Es inyección de dependencias impuesta por la plataforma en vez de por la disciplina del equipo, y la historia de TypeScript la completa: wrangler types lee tu config y tu .dev.vars y genera la interfaz Env, así que agregar un binding sin actualizar los tipos no es un error que puedas cometer calladamente. Viniendo del módulo tres, esto debería rimar: es la idea del mapa de exports otra vez, una superficie pública curada reemplazando el acceso de alcanza-a-donde-sea, aplicada a infraestructura en vez de a módulos.
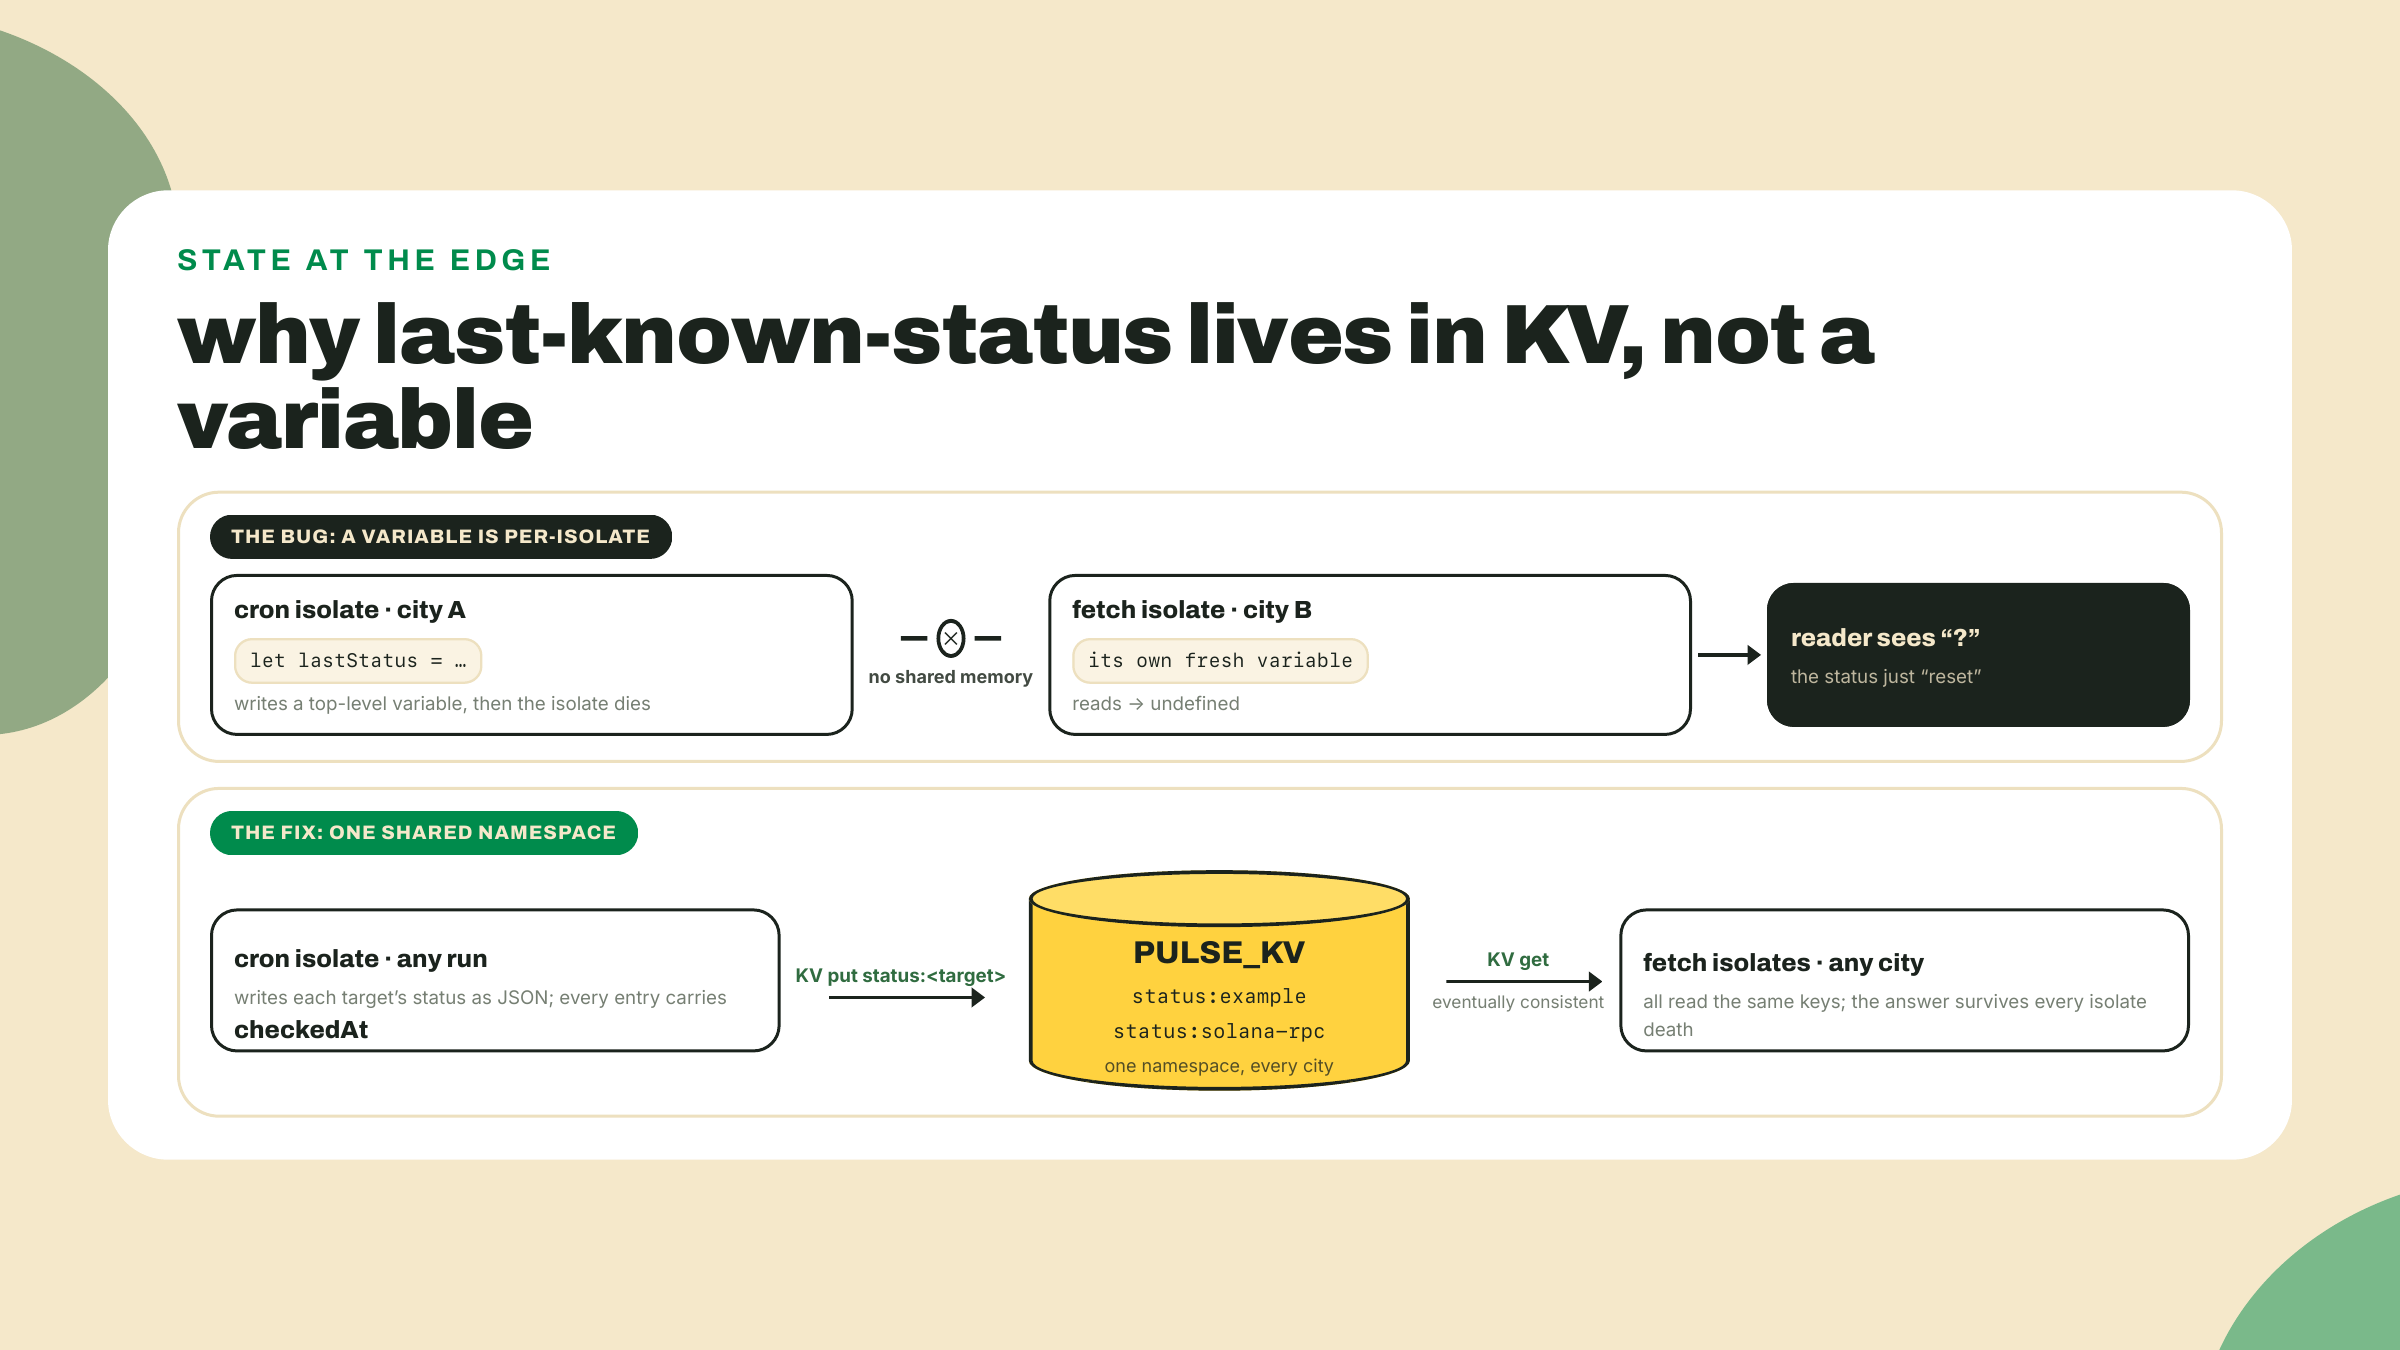
El trabajo de la estación es el último estado conocido, y un isolate no puede recordarlo. Una variable de nivel superior funciona en wrangler dev por unos cuantos requests, y después se "resetea", porque el isolate al que escribiste se murió, o el siguiente request aterrizó en una ciudad distinta. La memoria del worker no sobrevive a las invocaciones y no abarca ubicaciones. Funcionaba en dev es el bug de estado clásico de esta plataforma, y la cura es el almacén compartido de la plataforma: Workers KV, un namespace global de clave-valor al que tu worker llega a través de un binding. La API es lo bastante chica como para mostrarla entera:
await env.PULSE_KV.put("status:example", JSON.stringify(entry));
const stored = await env.PULSE_KV.get<StatusEntry>("status:example", "json");
const list = await env.PULSE_KV.list({ prefix: "status:" });
Put, get (con "json" haciéndote el parseo), list por prefijo. KV es eventualmente consistente: una escritura aterriza en una ubicación y se propaga hacia afuera, así que una lectura en otra ciudad puede ver por un rato el valor anterior. Para una página de estado cuyas entradas dicen "al momento de este timestamp," esa ventana de desactualización está genuinamente bien, y decirlo en voz alta es la habilidad de diseño: estás eligiendo la consistencia eventual porque el modelo de datos ya lleva su propio campo de frescura.
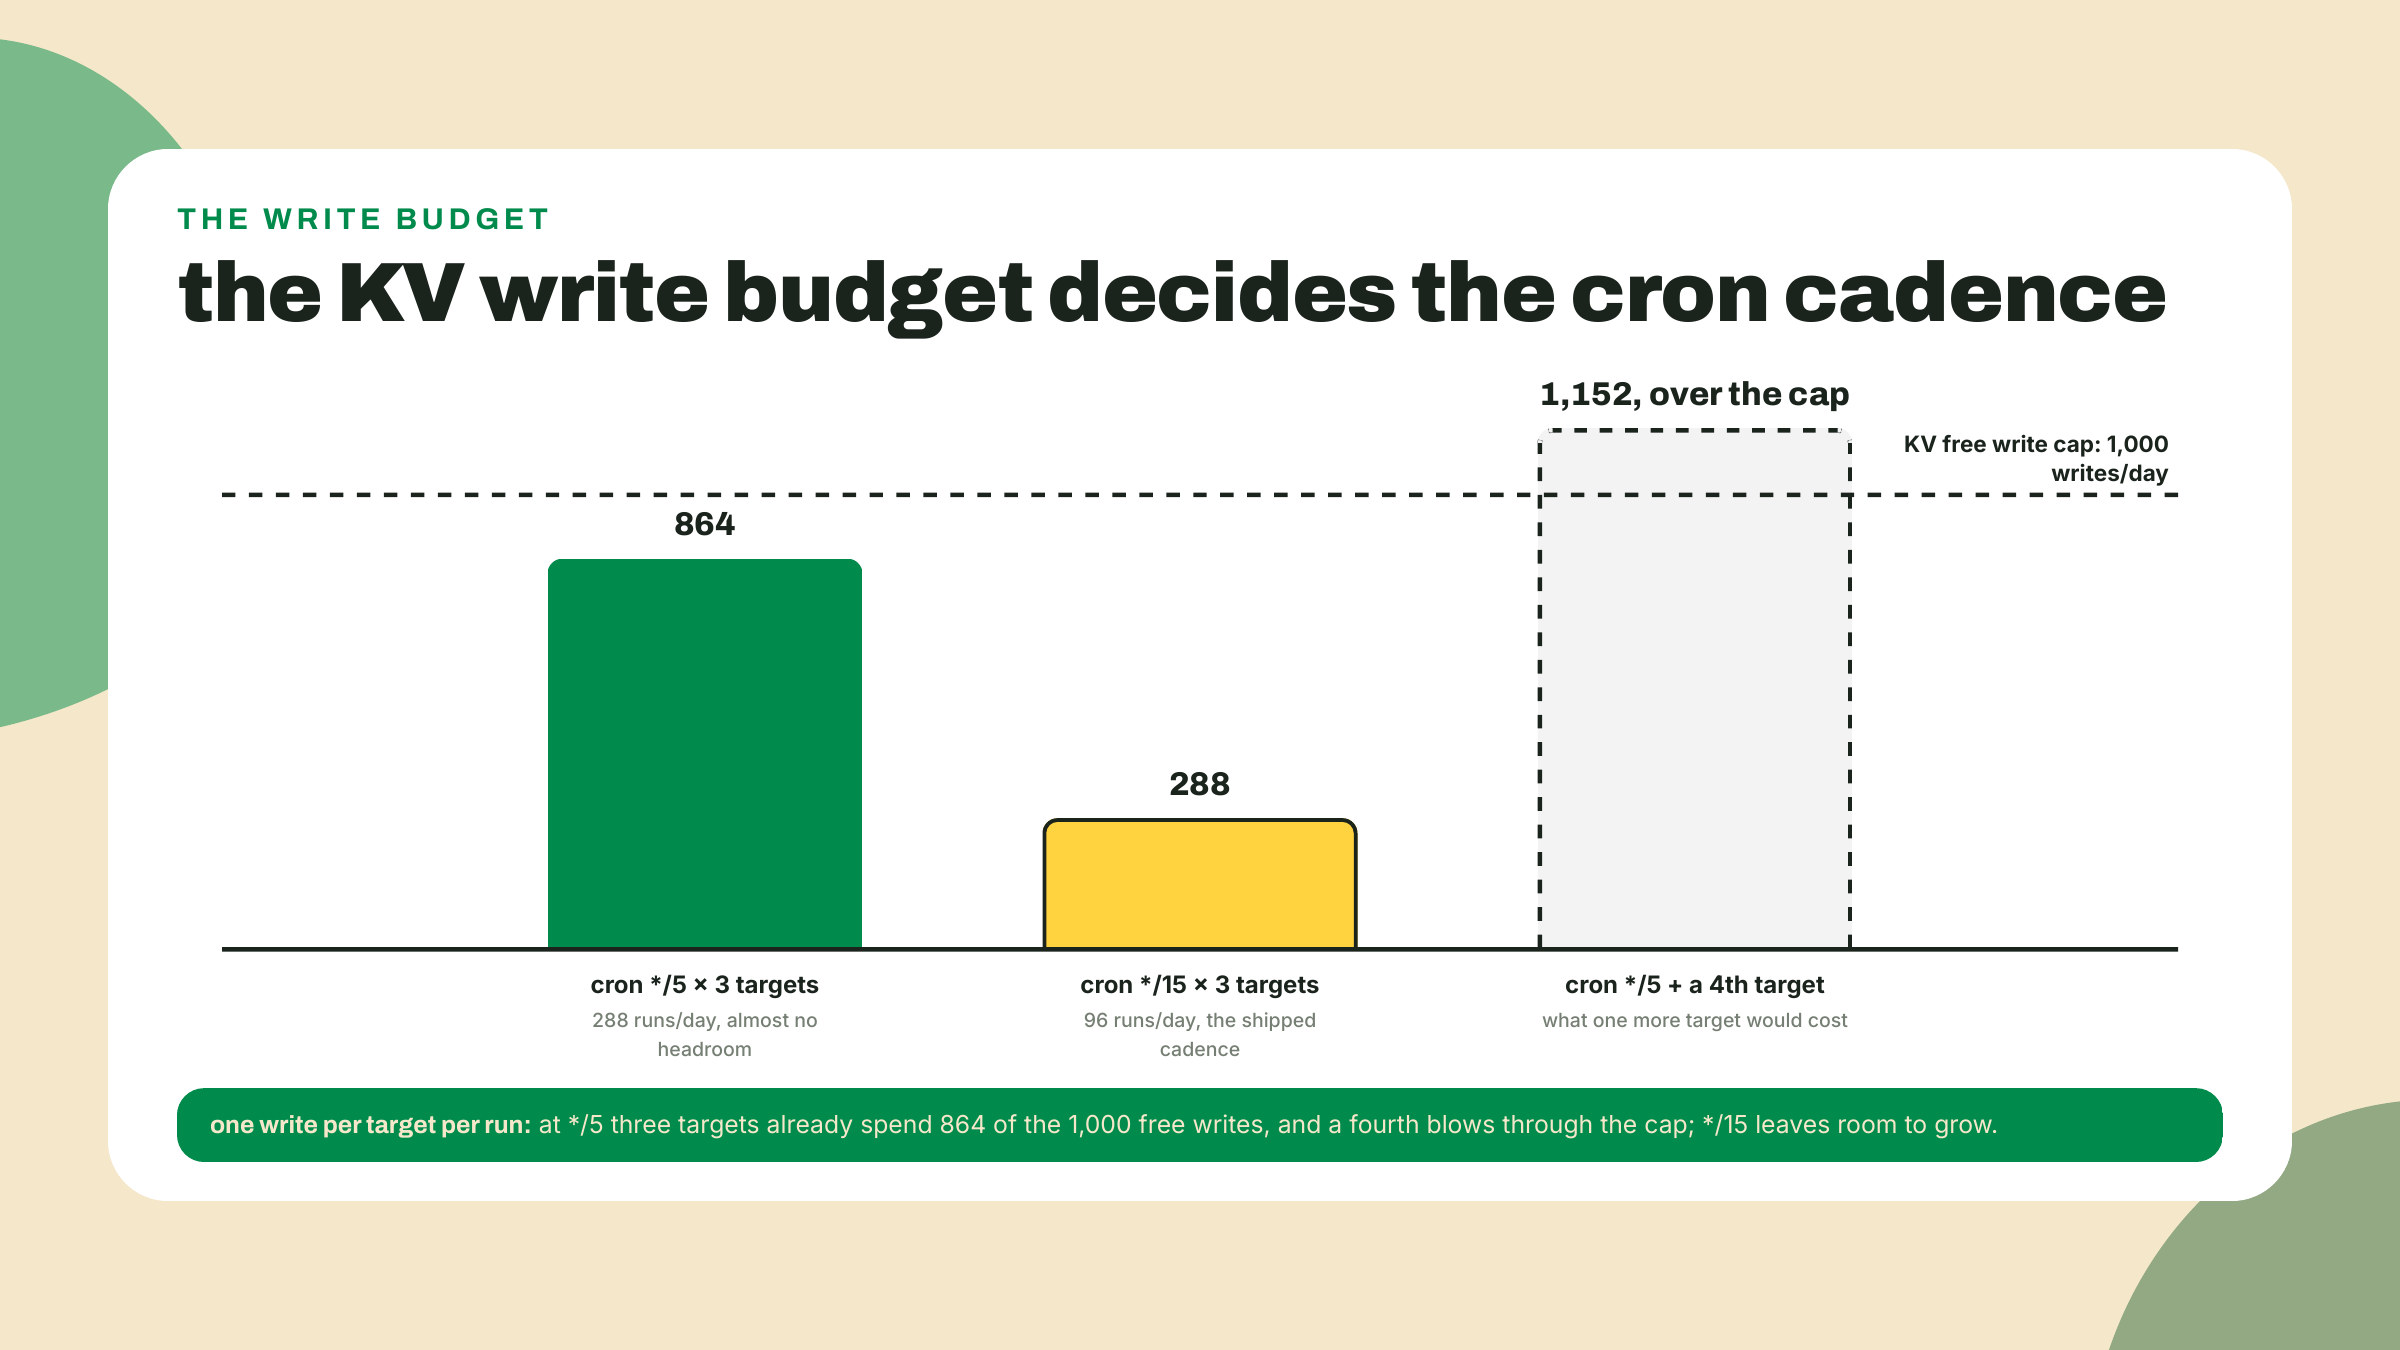
KV en el plan gratis está medido, y los números le dan forma al diseño más de lo que podrías esperar: 100,000 lecturas por día, 1,000 escrituras por día (según la página de precios, sondeada el 2026-09-01). Las lecturas son abundantes; las escrituras son el recurso escaso. Haz la aritmética para nuestro worker antes de escribir una línea: un cron cada 5 minutos son 288 ejecuciones al día, y escribir una clave por target quiere decir 288 por la cantidad de targets. Tres targets son 864 escrituras, que entran debajo de 1,000 con casi nada de margen; un cuarto target se pasa del tope. Cada 15 minutos son 96 ejecuciones, 288 escrituras para tres targets, y lugar para hacer crecer la lista de targets. Por eso la config de abajo dice */15. El presupuesto hizo el diseño, exactamente como CAP=25 dimensionó tu pool en m02-l3.
El trigger del cron es configuración, no código. Tu wrangler.jsonc crece un bloque triggers con un array de crons, y la plataforma invoca tu handler scheduled en ese beat, desde su propia infraestructura. Ninguna laptop involucrada, la misma promesa que el cron de Actions de M1, menos el spin-up del runner. Probarlo local sería miserable si tuvieras que esperar tiempo de reloj de verdad, así que wrangler dev expone una ruta HTTP pelada que dispara el handler a pedido:
curl "http://localhost:8787/cdn-cgi/handler/scheduled"
(Si esa ruta da 404 en tu versión de wrangler, usa la grafía más vieja de la misma puerta: arranca dev con npx wrangler dev --test-scheduled y hazle curl a "http://localhost:8787/__scheduled?cron=*+*+*+*+*" en cambio; wrangler ha llevado las dos a lo largo de la línea v4.) Esa ruta se gana su lugar rápido cuando tu único punto de entrada dispara en un calendario; le vas a pegar una docena de veces en el lab.
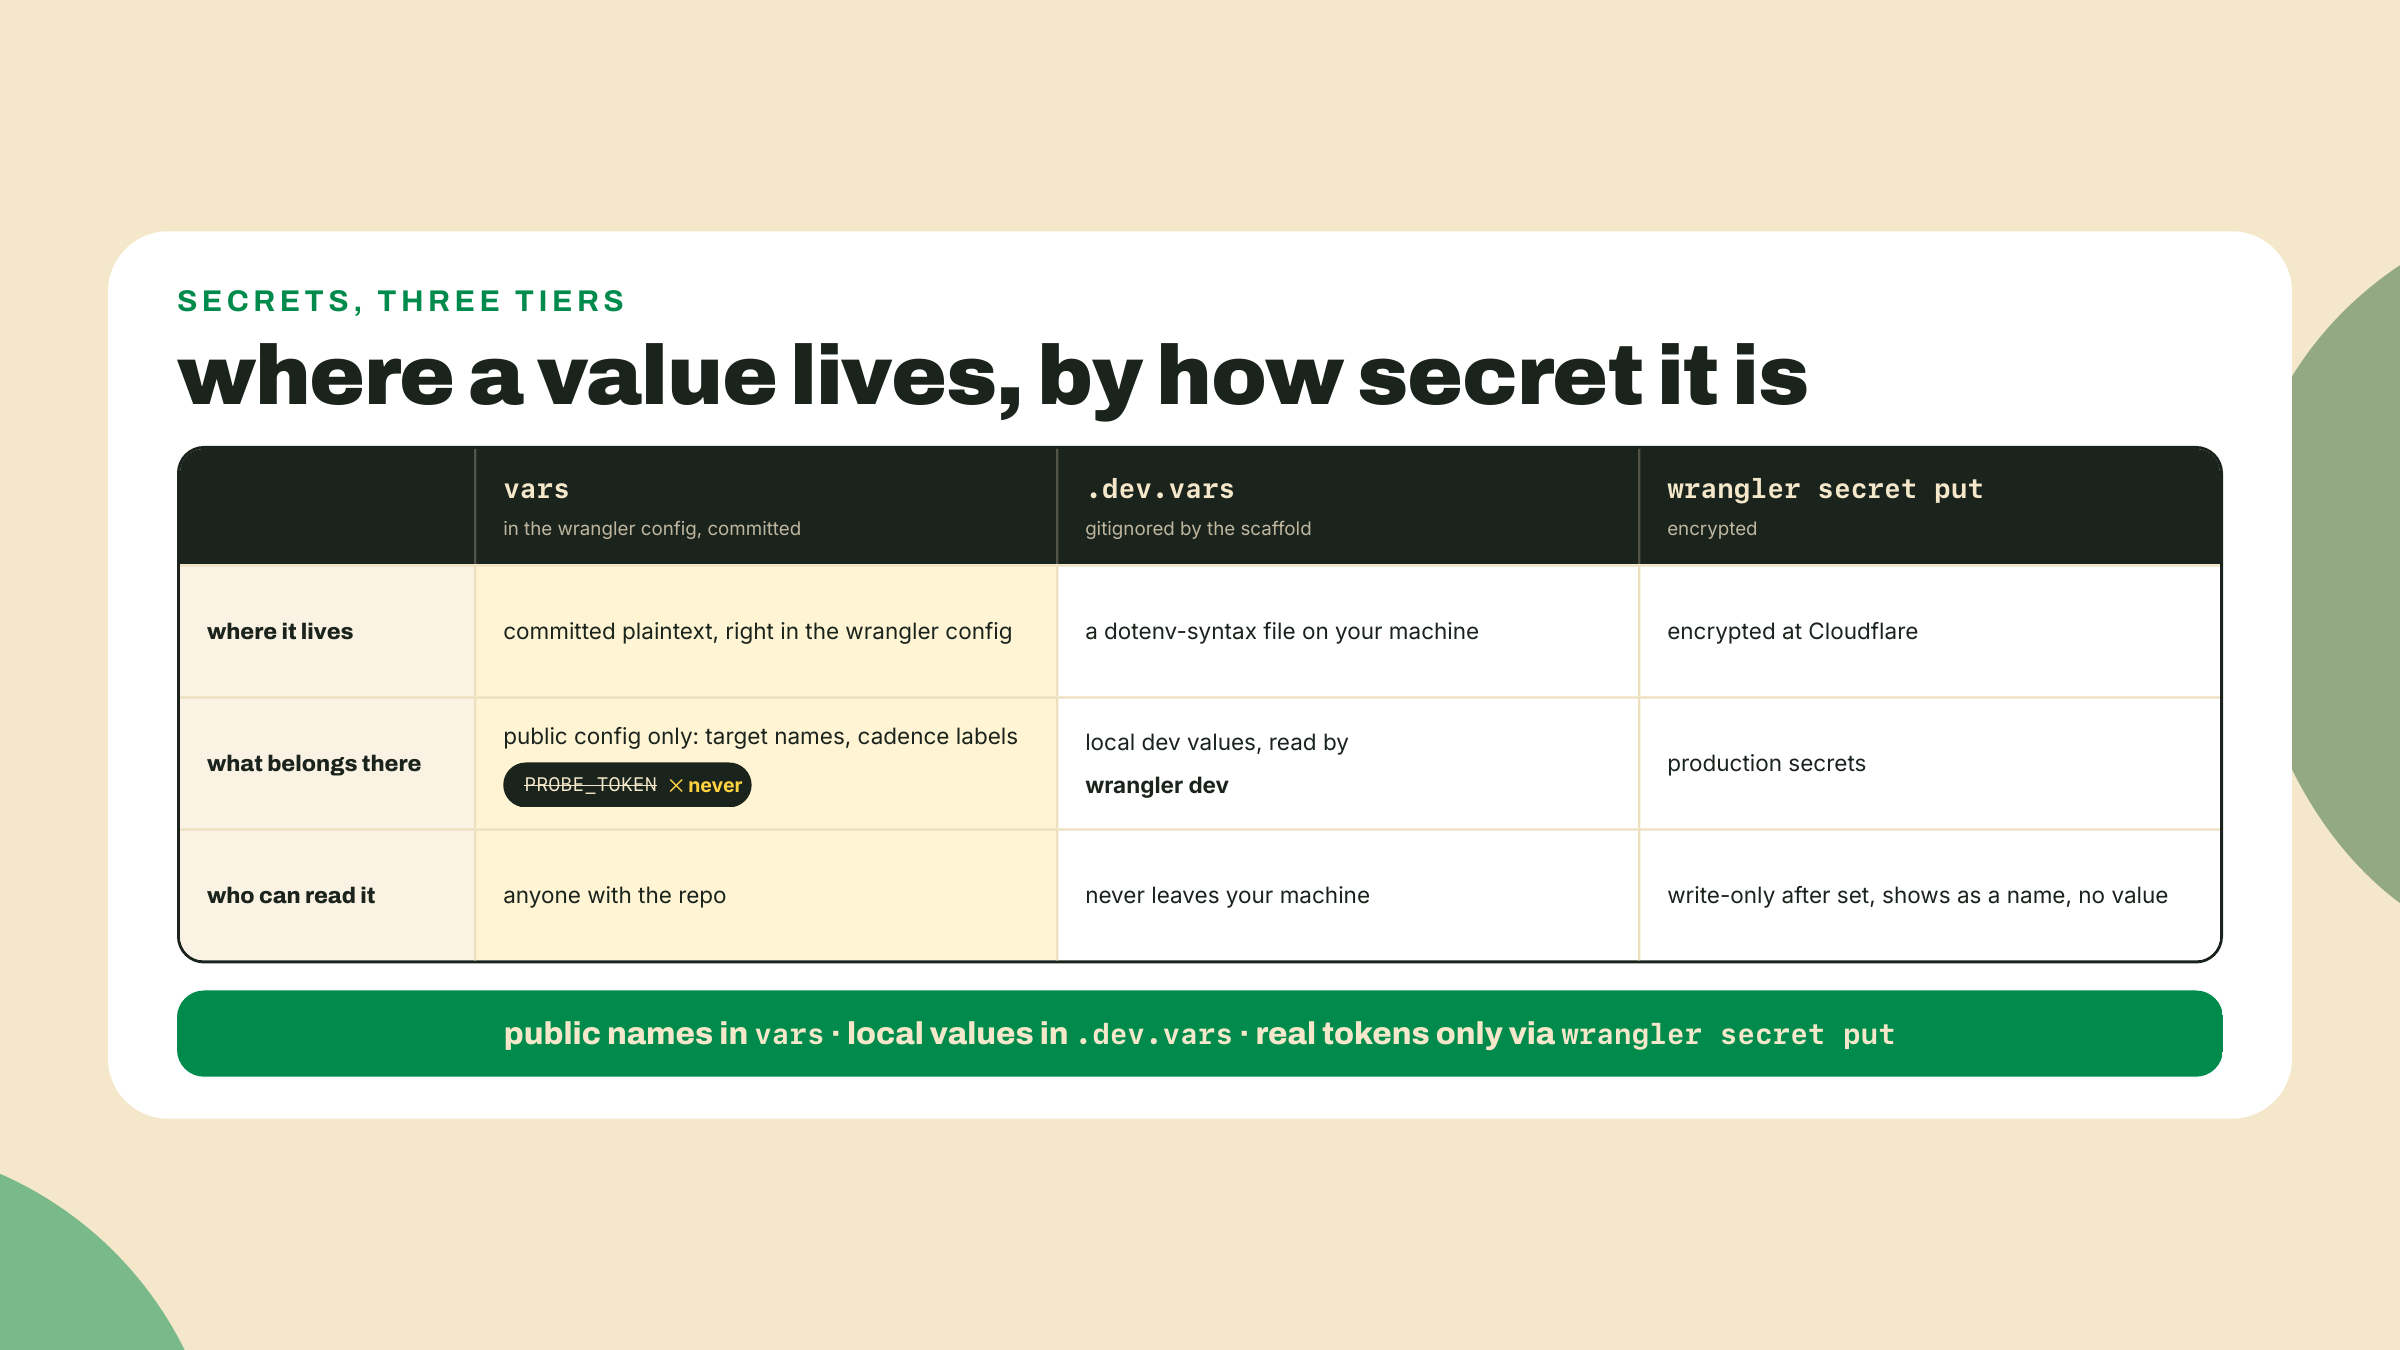
Los secretos ahora, y esto es un hábito enseñado, no una nota al pie, porque el worker necesita uno de verdad: un token de header para un target de demo protegido. La regla tiene tres tiers. La config pelada que cualquiera puede leer va en el bloque vars de la config de wrangler, y solo eso, porque ese archivo se commitea. Los secretos de desarrollo local van en .dev.vars, sintaxis dotenv, gitignoreados por el scaffold, leídos automáticamente por wrangler dev. Los secretos de producción suben con npx wrangler secret put <KEY>, que pregunta por el valor, lo guarda encriptado, y nunca lo vuelve a mostrar; no se lee en el panel, no se lee con wrangler, visible solo como un nombre. Un token en el bloque vars está commiteado en texto plano con la cara inocente de un archivo de config. Ese es todo el modelo de higiene, y m09-l2 lo va a barrer por las cuatro plataformas.
Ahora el párrafo de dinero, números dichos una vez y sin rodeos, todos de la página de precios sondeada el 2026-09-01. Workers Free: 100,000 requests al día, y 10 ms de CPU por invocación. KV gratis: las 100,000 lecturas y 1,000 escrituras al día contra las que acabas de presupuestar. El número sutil es el de CPU, así que ponlo contra la luz: 10 ms miden cómputo, no espera. El tiempo gastado esperando un fetch es gratis; un loop síncrono apretado es lo que revienta el presupuesto. Hazlo concreto con nuestro propio dominio: supón que una versión posterior guardara historial de sondas y decidieras que el worker debería computar percentiles móviles sobre diez mil muestras en cada request. Ordenar diez mil números es CPU de verdad, hazlo unas cuantas veces seguidas y estás rozando el medidor, y el modo de falla no es una cuenta, son invocaciones tirando error a mitad de cómputo mientras tu conteo de requests está lejísimos del tope diario. Mientras tanto el worker actual espera tres fetches y gasta bastante menos de un milisegundo computando de verdad. Esa asimetría es toda la personalidad del tier: un worker de sondas le entra hermoso porque su vida es 99% esperar a los servidores de otra gente, y la computación pesada sigue perteneciendo al poller de Docker, donde la CPU es tuya por hora en vez de medida por milisegundo. Sobre la pregunta de la tarjeta: en ningún lado de los docs ni de los precios de Cloudflare el vendor imprime una promesa de "sin tarjeta de crédito", así que no le voy a poner esas palabras en la boca; lo que sí puedo decir es que todo reporte de 2026 del registro a Workers Free que pudimos encontrar no tenía tarjeta pedida al momento de la sonda del 2026-09-01. Si tu registro te pide una, esa es una nota de feedback del curso que quiero.
La estación viene derivando hacia Solana desde M2, y hoy la blockchain se vuelve un target monitoreado, sin ceremonia y sin librería nueva. El RPC público de Solana habla JSON-RPC sobre POST HTTP pelado, y su pregunta más barata es getHealth:
curl -s https://api.mainnet.solana.com -X POST -H "content-type: application/json" \
  -d '{"jsonrpc":"2.0","id":1,"method":"getHealth"}'
Un nodo sano responde {"jsonrpc":"2.0","result":"ok","id":1}. Ese hostname es la forma que imprimen hoy los propios docs de cluster de Solana, y es la que este curso usa en todos lados; M8 abre contándote cuál es la grafía más vieja que te vas a encontrar en tutoriales y por qué todavía resuelve.
Una nota de honestidad de producción antes de que tu worker siquiera lo sondee: que ese curl funcione no promete que el mismo POST funcione desde adentro de workerd. Los endpoints de RPC público corren política anti-abuso sobre más que la tasa de requests; discriminan por fingerprint de cliente y por egress, y a partir de una re-verificación del 2026-09-04, el POST idéntico a getHealth que devuelve ok desde curl vuelve así desde un isolate de wrangler dev en la misma máquina y la misma IP:
{"jsonrpc":"2.0","error":{"code":403,"message":"Your IP or provider is blocked from this endpoint"},"id":1}
Los proveedores bloquean a algunos clientes al por mayor, sin culpa ninguna de tu código. Esa es la primera lección de ops de verdad que da un monitor: un upstream es un único punto de rechazo, así que una estación lleva un fallback documentado. El nuestro es https://solana-rpc.publicnode.com, sin llaves, el mismo JSON-RPC (verificado respondiendo ok desde adentro de workerd, 2026-09-04). api.mainnet.solana.com queda como canónico; el paso 7 te dice cuándo recurrir al fallback. Para el worker, esto es un target más: POST en vez de GET, mide la latencia, pásale el resultado al mismo classifyProbe que usa cada otra parte de la estación. Nada de @solana/kit todavía, a propósito; M8 lo presenta cuando empecemos a que nos importe qué hay adentro de las respuestas. Hoy el transporte respondiendo pronto es la señal de salud.
Sé preciso sobre qué es esa señal, porque las herramientas de monitoreo que exageran sus propias mediciones son la forma en que las páginas de estado terminan mintiendo. getHealth es el nodo al que le preguntaste reportando sobre sí mismo: dice "ok" cuando ese nodo cree que está al día con el cluster, y un nodo enfermo o rezagado responde con un cuerpo de error de JSON-RPC en cambio. Es la autoevaluación de una máquina detrás de un balanceador de carga, no un veredicto sobre Solana. Tu sonda por lo tanto mide exactamente dos cosas honestas: si el RPC público te respondió, y qué tan rápido, desde la ciudad en la que haya corrido tu isolate. Eso es precisamente lo que una estación de estado debería registrar, y precisamente cómo se debería leer la entrada. Cuando M8 empiece a decodificar cuerpos de respuesta con kit, la estación se gradúa de "el endpoint de RPC responde" a "y acá está lo que dice la blockchain", y la diferencia entre esas dos oraciones es una distinción que ahora es tuya.
Una disciplina se traslada sin cortes. El RPC público deja pasar 100 requests por cada 10 segundos por IP, y un 429 de él quiere decir lo mismo que quería decir un 429 en m02-l3: te están diciendo un presupuesto, y martillarlo cava el pozo más hondo. El backoff que construiste ahí, backoffDelay más jitter equitativo, viene a través del import de pulse-core y envuelve la sonda del RPC en el lab. Todo el argumento de M8 está en este párrafo en miniatura: la blockchain es un endpoint más, con latencias de verdad y límites de verdad, y las buenas maneras de ingeniería que construiste para HTTP inestable son las maneras que necesita sondear la blockchain.
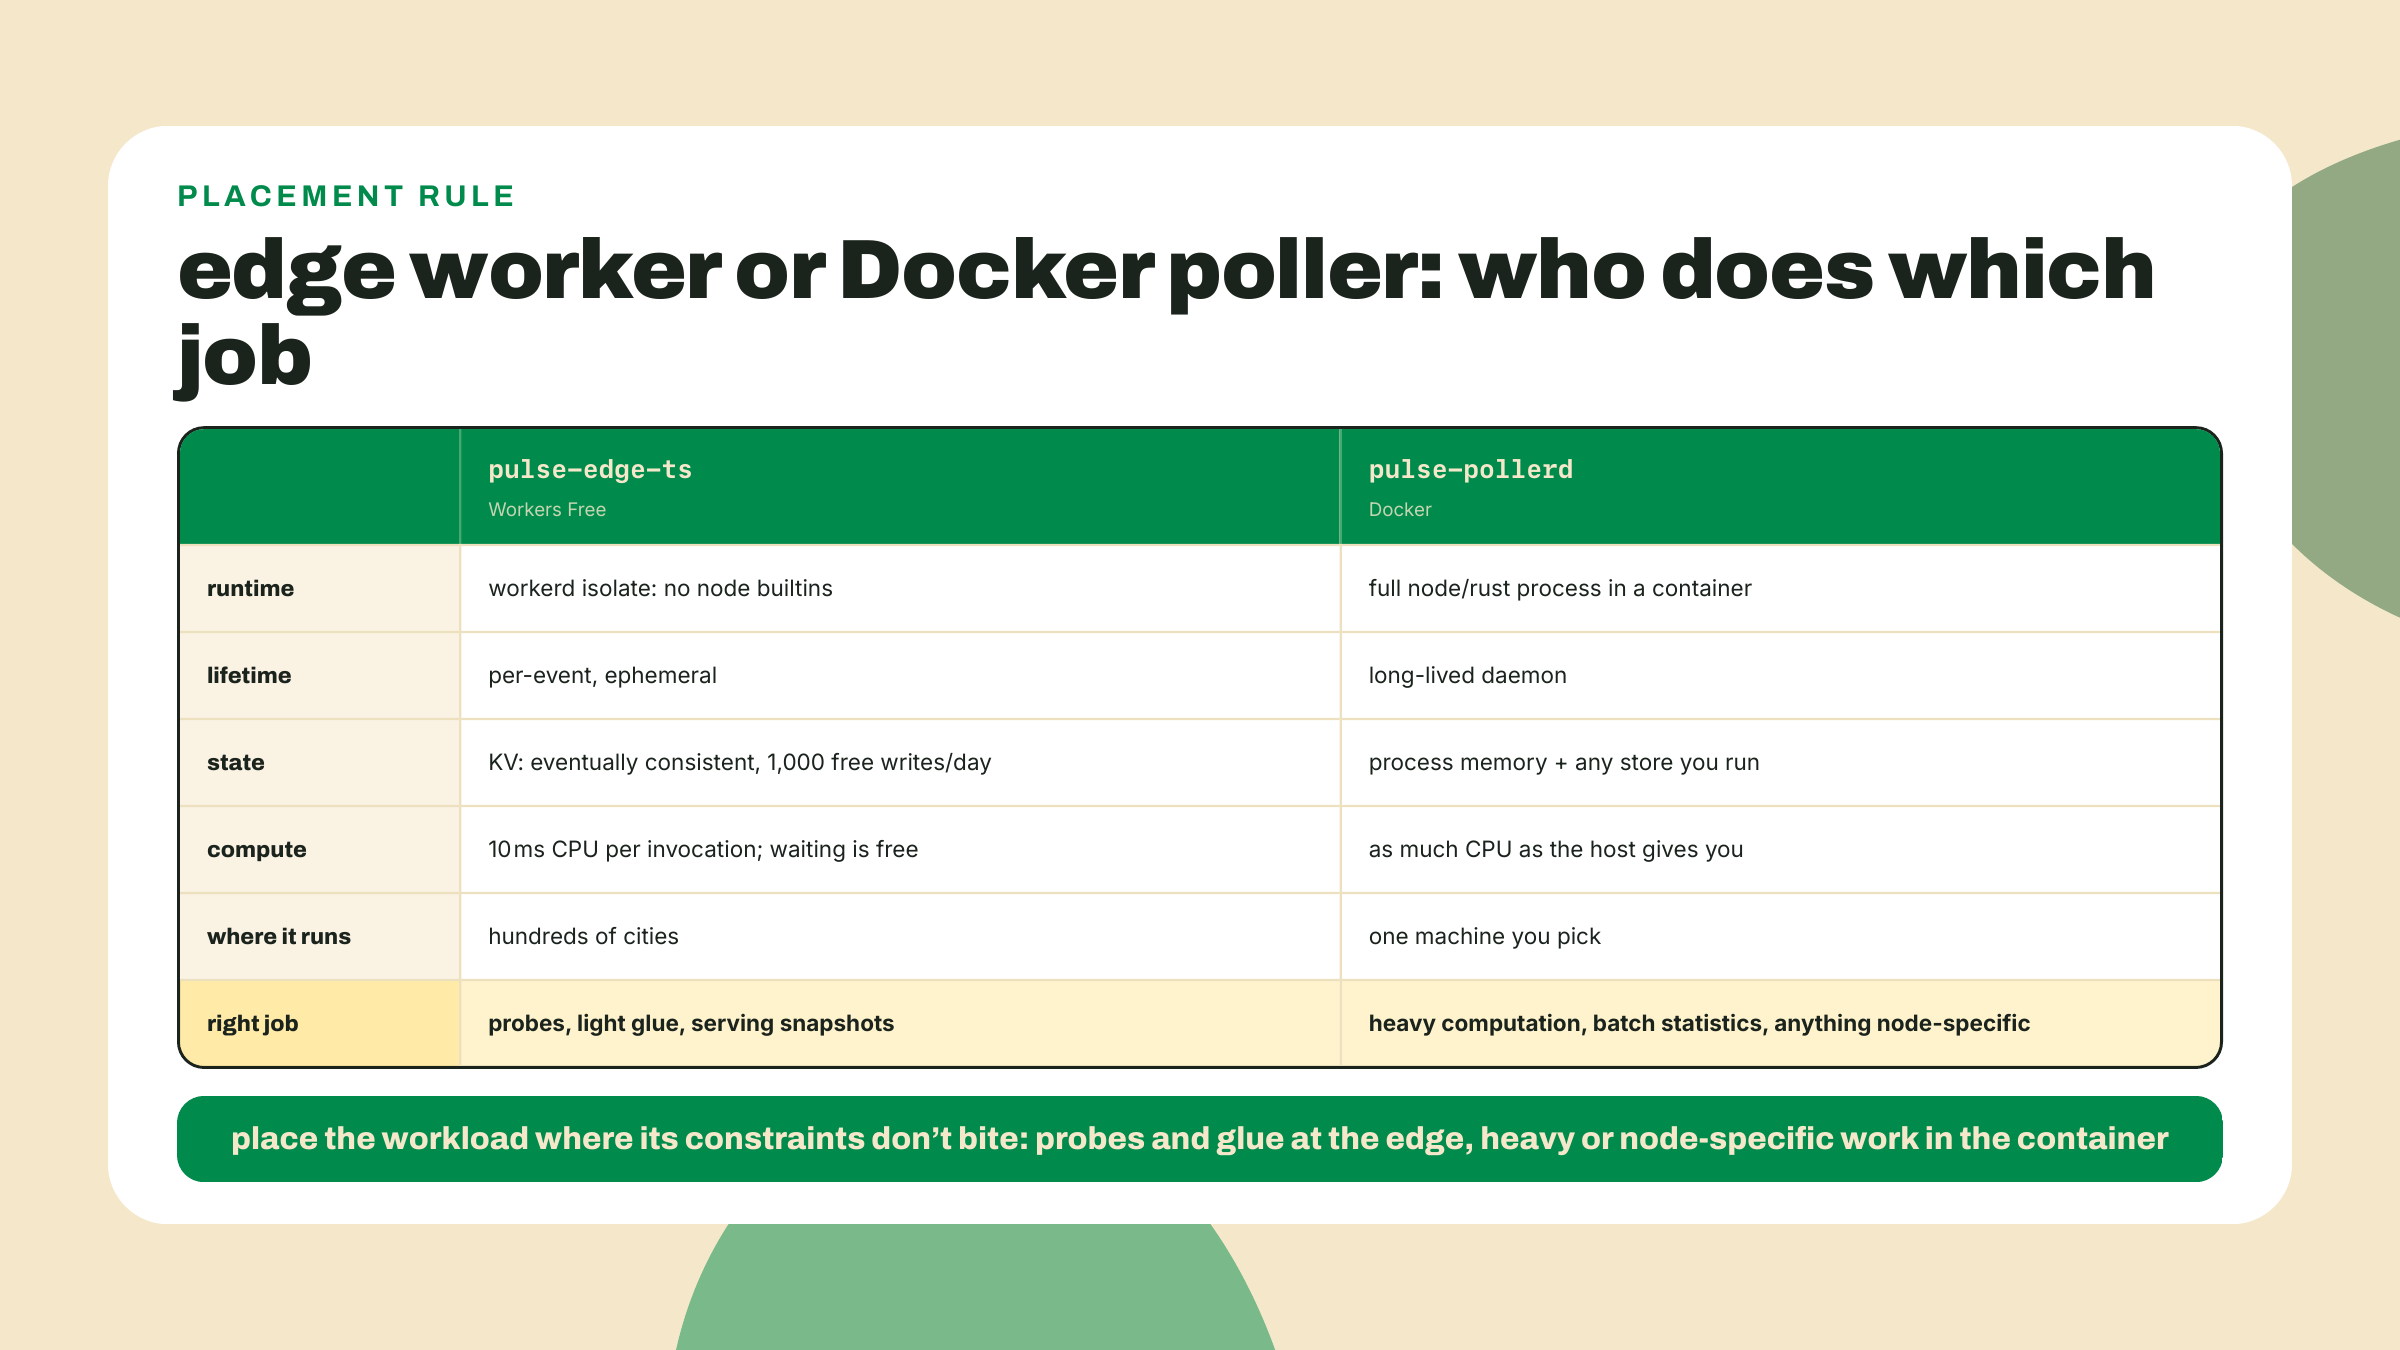
Esta sección se hizo larga, así que déjame nombrar el trade-off y cerrar la teoría. El edge te da proximidad y escala que no operas, y el precio es un runtime deliberadamente angosto: builtins de node como shims sin OS detrás, nada de memoria de larga vida, nada de threads, 10 ms de CPU medida, y estado compartido solo a través de un almacén eventualmente consistente con una asignación diaria de 1,000 escrituras. El edge es donde van las sondas, no donde va todo. Di en voz alta la división del trabajo, porque ahora operas las dos mitades: el worker mide y recuerda la última respuesta; el poller, con un sistema de archivos de verdad, CPU sin medición, y toda la memoria de proceso que quiera, es donde se acumula el historial y se computan las estadísticas cuando la estación crezca esas ambiciones. El tier de contenedores de M6 sigue existiendo por una razón, y cuando Cloudflare entregó Containers a GA el 2026-04-13 (solo planes pagos), la propia plataforma concedió el punto: algunas cargas de trabajo simplemente quieren una caja Linux. La tuya se queda con su caja en GHCR; las sondas de hoy se llevan las ciudades.
Profundiza (el 20%). esta lección enseñó la plataforma a través del equivalente a un worker: isolates, los dos handlers, KV, cron, secretos. El tour guiado de todo lo demás (R2, D1, Durable Objects, Queues, el panel) vive en la propia guía de get-started de Cloudflare: https://developers.cloudflare.com/workers/get-started/guide/ (URL chequeada el 2026-09-02). Guárdala como bookmark, camínala después del lab. Nada de abajo depende de ella.
El repliegue, dicho: los pasos 1 y 2 ya los hiciste en la apertura. El esqueleto y la config en los pasos 3 a 5 vienen dados con el par de KV y el loop del cron como huecos que llenas. El paso 6 es secretos, trabajado en corto. El segundo tipo de target de después es el challenge, entero tuyo.
Confirma el estado del scaffold. Tienes pulse-edge-ts/ desplegado con hello-world de la apertura. Si no, corre los dos comandos del principio de la lección ahora. Todo lo de abajo edita este proyecto.
Instala el motor y prueba la costura. Dos comandos, una falla a propósito:
npm i @YOUR_NPM_USERNAME/pulse-core
(¿Te saltaste el npm publish de m03-l4? No hace falta cuenta: npm pack adentro de packages/pulse-core, la misma jugada del tarball que m03-l4 usó para inspección, y después npm i ../packages/pulse-core/<scope>-pulse-core-0.1.0.tgz; instalar desde un tarball local es nuevo acá, y es un comando.) Después, arriba de todo en src/index.ts, pega la jugada de la flota para cargar la config:
import { readFileSync } from "node:fs";
const config = JSON.parse(readFileSync("./pulse.config.json", "utf8"));
y corre npx wrangler dev. El import en sí resuelve, porque el workerd actual trae un shim de compatibilidad con Node, y después el runtime se niega a arrancar:
✘ [ERROR] The Workers runtime failed to start.
...
Uncaught Error: no such file or directory, readAll '/bundle/pulse.config.json'
  ... in readFileSync
Lee ese camino. /bundle es el único sistema de archivos que tiene un worker, su propio código subido, de solo lectura. Ese rechazo es la costura de la sección de teoría, en vivo en tu pantalla: el módulo portó, la máquina no. Borra las dos líneas. El import del core del próximo paso resuelve limpio, y ahora sabes por qué existe la diferencia.
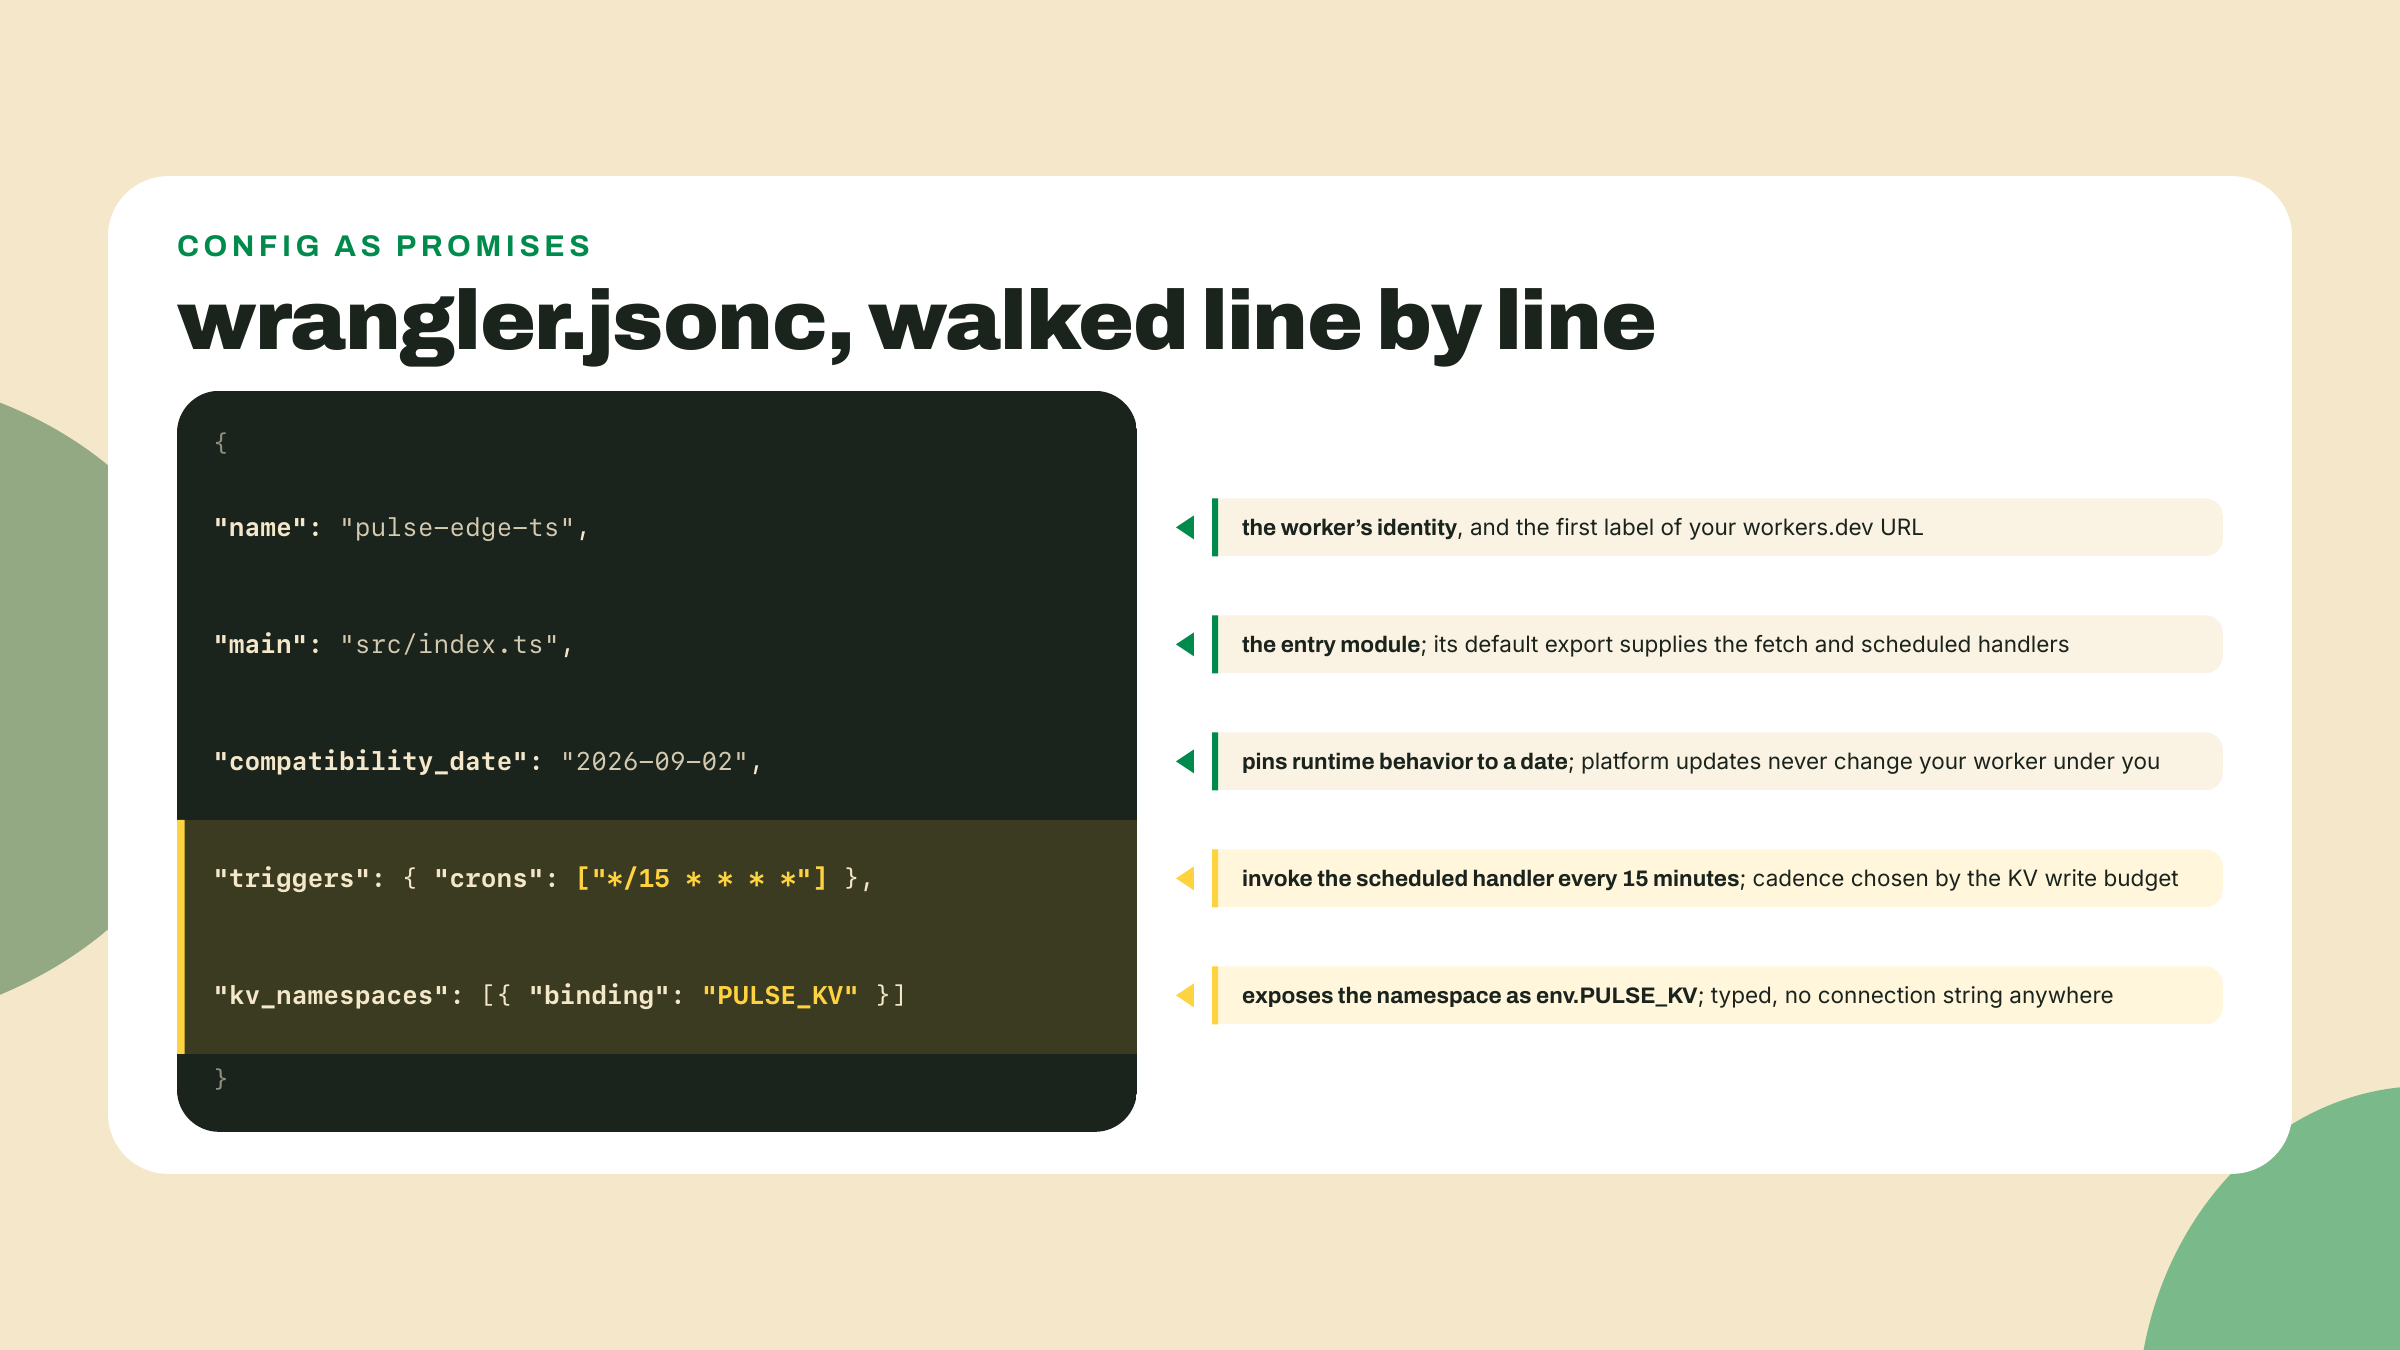
Reemplaza la config. Abre wrangler.jsonc y déjalo así (el id de tu namespace llega en el paso 4; deja el placeholder hasta entonces):
{
  "name": "pulse-edge-ts",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-02",
  "triggers": {
    "crons": ["*/15 * * * *"]
  },
  "kv_namespaces": [
    { "binding": "PULSE_KV", "id": "<your-namespace-id>" }
  ]
}
Crea el namespace. Un comando, después un pegado:
npx wrangler kv namespace create PULSE_KV
La salida imprime el id del namespace y el snippet exacto del binding; reemplaza <your-namespace-id> en tu config con el id de verdad. De acá en adelante, el código del handler llega al almacén como env.PULSE_KV, y la generación de tipos del scaffold mantiene Env honesto: corre npm run cf-typegen (el scaffold lo trae; corre wrangler types por debajo, así que npx wrangler types si tu plantilla le puso otro nombre) cada vez que cambien los bindings.
El worker, con dos huecos. Reemplaza src/index.ts con el esqueleto de abajo. Todo viene dado excepto los dos TODOs: el par put/get de KV, y el cuerpo por target del loop del cron con backoff en el target del RPC. Llénalos antes de leer las versiones terminadas que siguen.
import {
  classifyProbe,
  backoffDelay,
  type ProbeResult,
} from "@YOUR_NPM_USERNAME/pulse-core";

interface Env {
  PULSE_KV: KVNamespace;
  PROBE_TOKEN: string;
}

interface Target {
  name: string;
  url: string;
  kind: "http" | "solana-getHealth";
  headers?: Record<string, string>;
}

interface StatusEntry {
  name: string;
  verdict: ReturnType<typeof classifyProbe>;
  result: ProbeResult;
  checkedAt: string;
}

const TIMEOUT_MS = 3000;
const MAX_RETRIES = 2;
const BASE_MS = 500;
const CAP_MS = 4000;

const sleep = (ms: number) => new Promise((resolve) => setTimeout(resolve, ms));

// pulse-core exports the frozen (kind, value) boundary form. A dns-error
// carries a hostname, not a reading, so it is decided here, not there.
function verdictOf(result: ProbeResult): ReturnType<typeof classifyProbe> {
  switch (result.kind) {
    case "ok":
      return classifyProbe("ok", result.latencyMs);
    case "timeout":
      return classifyProbe("timeout", result.budgetMs);
    case "http-error":
      return classifyProbe("http-error", result.status);
    case "dns-error":
      return "down";
  }
}

function targetList(env: Env): Target[] {
  return [
    { name: "example", url: "https://example.com/", kind: "http" },
    {
      name: "protected-demo",
      url: "https://httpbin.org/bearer",
      kind: "http",
      headers: { authorization: `Bearer ${env.PROBE_TOKEN}` },
    },
    { name: "solana-rpc", url: "https://api.mainnet.solana.com", kind: "solana-getHealth" },
  ];
}

async function probeOnce(target: Target): Promise<ProbeResult> {
  const controller = new AbortController();
  const timer = setTimeout(() => controller.abort(), TIMEOUT_MS);
  const started = Date.now();
  try {
    const res =
      target.kind === "solana-getHealth"
        ? await fetch(target.url, {
            method: "POST",
            headers: { "content-type": "application/json" },
            body: JSON.stringify({ jsonrpc: "2.0", id: 1, method: "getHealth" }),
            signal: controller.signal,
          })
        : await fetch(target.url, { headers: target.headers, signal: controller.signal });
    await res.text();
    if (res.ok) {
      return { kind: "ok", latencyMs: Date.now() - started };
    }
    return { kind: "http-error", status: res.status };
  } catch {
    if (controller.signal.aborted) {
      return { kind: "timeout", budgetMs: TIMEOUT_MS };
    }
    return { kind: "dns-error", host: new URL(target.url).hostname };
  } finally {
    clearTimeout(timer);
  }
}

async function probeWithBackoff(target: Target): Promise<ProbeResult> {
  let result = await probeOnce(target);
  for (let attempt = 0; attempt < MAX_RETRIES; attempt++) {
    if (!(result.kind === "http-error" && result.status === 429)) break;
    const delay = backoffDelay(attempt, BASE_MS, CAP_MS);
    const jittered = delay / 2 + Math.random() * (delay / 2);
    await sleep(jittered);
    result = await probeOnce(target);
  }
  return result;
}

export default {
  async scheduled(controller: ScheduledController, env: Env, ctx: ExecutionContext) {
    const checkedAt = new Date().toISOString();
    for (const target of targetList(env)) {
      // TODO 1: probe this target (with backoff), classify the result with
      // verdictOf, assemble a StatusEntry, and put it into PULSE_KV
      // under the key `status:${target.name}` as JSON.
    }
  },

  async fetch(request: Request, env: Env): Promise<Response> {
    // TODO 2: list PULSE_KV keys with the "status:" prefix, get each entry
    // as JSON, and return { updatedAt, targets } via Response.json, with a
    // CORS header so a browser page may read this endpoint.
    return Response.json({ updatedAt: new Date().toISOString(), targets: [] });
  },
} satisfies ExportedHandler<Env>;
Lee lo que ya está decidido por ti antes de llenar huecos, cinco notas:
probeOnce de m02-l3 en el fetch de la plataforma, las mismas cuatro salidas hacia la misma unión; solo un 429 da la vuelta por el loop de retry, con jitter, exactamente la disciplina de la flota, ahora apuntada al tope del RPC de 100 requests por cada 10 segundos por IP.Date.now() porque workerd no es node y performance.now() ahí está deliberadamente engrosado por razones de ataques de temporización; campos de milisegundos leídos de un reloj grueso son bastante honestos para una página de estado.dns-error. Si esa exageración te pica después del párrafo de arriba sobre herramientas que exageran sus mediciones, bien; el renombre que ofreció m02-l3 (network-error, con el compilador llevándote de la mano a cada switch) está a un mandado de distancia.Env a mano para que esta página sea autocontenida, pero en tu repo la salida de npm run cf-typegen del paso 4 es el Env autoritativo; una vez que PROBE_TOKEN exista en .dev.vars (paso 6), vuelve a correr el typegen y retira la interfaz local en favor de la generada, que es el mecanismo que vendió el paso 4.Ahora el cuerpo completado del TODO 1, para después de que hayas escrito el tuyo:
const result = await probeWithBackoff(target);
const entry: StatusEntry = {
  name: target.name,
  verdict: verdictOf(result),
  result,
  checkedAt,
};
await env.PULSE_KV.put(`status:${target.name}`, JSON.stringify(entry));
console.log(`${target.name}: ${entry.verdict}`);
Y el TODO 2:
const list = await env.PULSE_KV.list({ prefix: "status:" });
const targets: StatusEntry[] = [];
for (const key of list.keys) {
  const entry = await env.PULSE_KV.get<StatusEntry>(key.name, "json");
  if (entry) targets.push(entry);
}
return Response.json(
  { updatedAt: new Date().toISOString(), targets },
  { headers: { "access-control-allow-origin": "*" } },
);
Dos líneas acá son interfaz, no implementación, así que trátalas como congeladas. Primero, la forma de la respuesta: { updatedAt, targets } donde cada entrada lleva name, verdict, result, y checkedAt. Este JSON es la superficie exacta que sondea el capstone de M10 cuando el panel crece una columna de edge, así que los nombres de campo que entregas hoy son los nombres de campo de los que va a depender una página futura. Segundo, el header de CORS: el capstone lee este endpoint desde un navegador, los navegadores bloquean las lecturas cross-origin por defecto, y access-control-allow-origin: * es la configuración honesta para un snapshot de estado público y de solo lectura. Nada de acá es sensible; todo el propósito del endpoint es que lo lean extraños. (Si ese header es nuevo para ti, no te desvíes; el lado del navegador de la historia recibe su tratamiento como corresponde en el capstone, cuando una página nuestra de verdad haga el fetch.)
La línea de console.log no es decoración; es lo que wrangler tail te muestra en el paso 7. Nota lo que prueba la línea del clasificador: classifyProbe, sin modificar, publicado desde tu workspace hace semanas, ahora está produciendo veredictos en un isolate. El envoltorio verdictOf a su alrededor son cuatro líneas de adaptador, no un segundo clasificador: solo desempaqueta cada variante en el par (kind, value) que toma la frontera publicada, y decide sobre la única variante que no tiene lectura numérica para darle. Cada banda, cada umbral, cada criterio sigue siendo del paquete. El mismo código que el panel, el mismo código que la CLI.
Higiene del scaffold: la plantilla de C3 entregó test/index.spec.ts, specs de vitest que afirman que el handler de fetch devuelve Hello World!. Dejó de hacer eso en el momento en que pegaste el esqueleto, así que esas specs quedan en rojo de acá en adelante. Borra el archivo, o reescribe sus afirmaciones contra la forma { updatedAt, targets }; las pruebas que fallan a sabiendas le enseñan a todo el mundo a ignorar el comando de test.
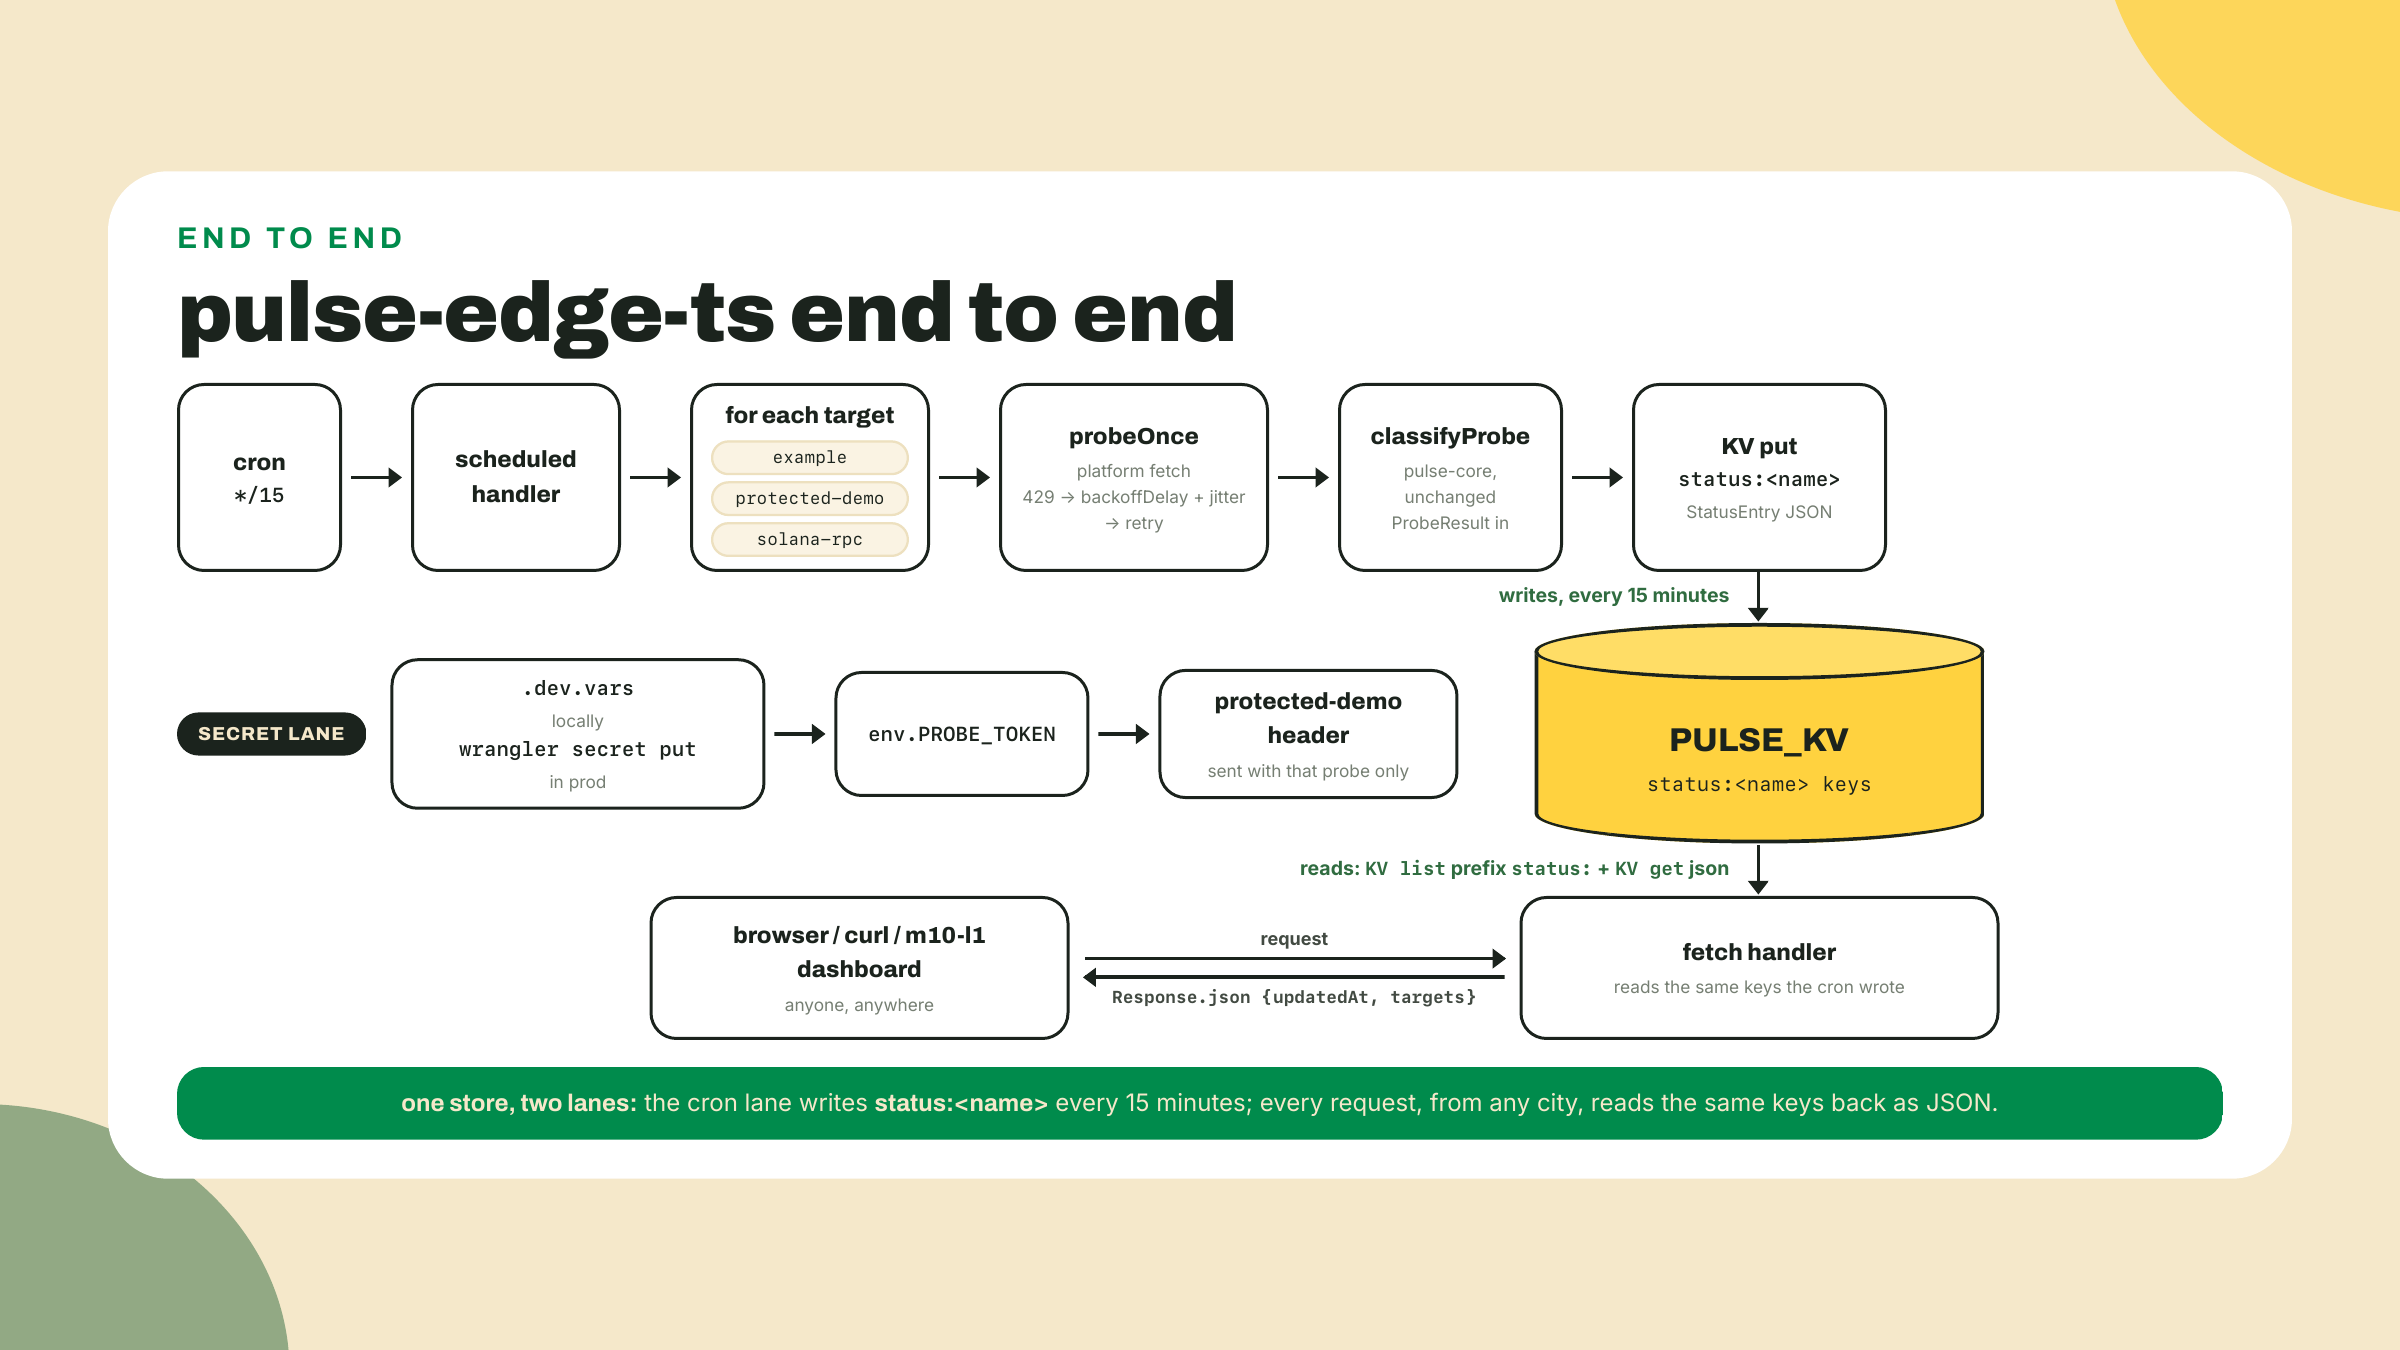
Cablea el secreto, las dos mitades. Local, crea .dev.vars en la raíz del proyecto (el gitignore del scaffold ya lo cubre; verifica con git check-ignore .dev.vars):
echo 'PROBE_TOKEN=local-dev-token' > .dev.vars
Para producción:
npx wrangler secret put PROBE_TOKEN
Escribe cualquier valor en el prompt. Un pequeño crédito de honestidad a httpbin acá: su endpoint /bearer devuelve 200 para cualquier bearer token y 401 para ninguno, lo que lo vuelve un reemplazo gratis de target protegido; el valor del token no importa, la plomería sí. Lo que estás practicando es la regla de tres tiers con comandos de verdad, y la verificación de aceptación del final lo prueba con grep.
Córrelo local, después entrégalo. Arranca npx wrangler dev, después fuerza el cron en una segunda terminal:
curl "http://localhost:8787/cdn-cgi/handler/scheduled"
(El mismo fallback que la sección de teoría si esto da 404: npx wrangler dev --test-scheduled más la ruta /__scheduled?cron=*+*+*+*+*.) Mira la terminal de dev imprimir tres líneas de veredicto, después pégale a http://localhost:8787/ y lee tu snapshot de JSON. Después:
npx wrangler deploy
npx wrangler tail
Deja tail corriendo hasta que pase el cuarto de hora y el cron dispare en producción; las mismas tres líneas de log llegan desde la infraestructura de Cloudflare sin ninguna máquina tuya involucrada. Ese comando merece una oración de respeto, porque es tu primer sabor de observabilidad en una plataforma donde no puedes hacerle ssh a nada: tail transmite en vivo logs y excepciones desde cada ciudad en la que corre tu worker, hacia tu terminal, y es la diferencia entre "el cron probablemente disparó" y verlo disparar. El panel de Cloudflare muestra la misma historia en su vista de worker si prefieres hacer clic a transmitir; cualquiera de los dos es evidencia aceptable. Checkpoint: curl -s https://pulse-edge-ts.<your-subdomain>.workers.dev/ devuelve JSON con una entrada por target, y la entrada de solana-rpc lleva un veredicto de la última sonda a getHealth. Si esa entrada en cambio dice down con {"kind":"http-error","status":403}, esa es la blocklist de la sección de teoría rechazando tu isolate, no un bug: tu worker acaba de manejar un rechazo de verdad correctamente. Cambia el target por el fallback documentado y vuelve a disparar el cron:
{ name: "solana-rpc", url: "https://solana-rpc.publicnode.com", kind: "solana-getHealth" }
La entrada se va a up; quédate con el endpoint que te responda, y anota el cambio. (Los workers desplegados hacen egress desde IPs de datacenter de Cloudflare, que el anti-abuso de RPC público también vigila, así que el fallback importa en producción también.) Ábrelo en tu teléfono, sin wifi, para el efecto completo.
Fuerza una falla y mírala salir a la superficie. Cambia la URL del target example por https://definitely-not-a-real-host.example, vuelve a desplegar, y después del siguiente disparo del cron vuelve a hacerle curl al snapshot. La entrada ahora muestra la variante dns-error y un veredicto down, con timestamp. (Algunas corridas archivan un timeout en cambio, cuando el lookup de DNS que falla sobrevive al abort de 3 segundos; cualquiera de las dos es honesta, el veredicto es down de las dos formas, y volver a disparar normalmente muestra la grafía dns-error.) Ese loop (rompe un target, mira al almacén decirlo en el siguiente beat) es toda la razón de existir de la estación, ahora corriendo desde cientos de ciudades. Restaura la URL y vuelve a desplegar.
Agrega un segundo tipo de target de sonda, punta a punta, sin tocar la plomería que viene dada: una verificación de código de estado esperado. Un target como { name: "redirect-check", url: "https://example.com/missing", kind: "expect-status", expectStatus: 404 } debería clasificar up cuando el estado de la respuesta iguala a expectStatus (un 404 puede ser la respuesta correcta; un chequeo de salud para una página que no debe existir es un patrón de monitoreo de verdad), y caer a la clasificación normal si no. Vas a necesitar extender el tipo Target, enseñarle a probeOnce el tipo nuevo, y decidir a qué variante de ProbeResult mapea una coincidencia de expectativa; hay una respuesta limpia usando la unión tal como está. Aceptación: npx wrangler deploy funciona; tu JSON de workers.dev muestra el target nuevo clasificado correctamente; el loop de falla forzada del paso 8 sigue funcionando; y el secreto existe en prod vía npx wrangler secret list. Después haz commit del proyecto del worker (git add pulse-edge-ts && git commit) antes de la verificación final: git grep -i probe_token encuentra solo el nombre del binding, nunca un valor, y tu config commiteada no contiene ningún secreto. El commit va primero porque git grep busca solo en archivos trackeados; en un proyecto sin commitear no encuentra nada y no prueba nada.
Lo que ahora puedes hacer, en concreto: explicar qué es un isolate y predecir cuáles de tus módulos van a correr y cuáles no en uno antes de intentarlo; hacer el scaffold, desarrollar, y desplegar un Worker con npm create cloudflare@latest y npx wrangler deploy; persistir estado compartido en KV y dimensionar un presupuesto de escrituras contra un tope del tier gratis; correr un cron de verdad en el edge y probarlo local a través de la ruta scheduled; y mantener un secreto fuera de git en la tercera plataforma seguida.
La recuperación de 30 segundos antes de que cierres la pestaña: ¿por qué el objeto de estado dejó de vivir en una variable, y dónde se gasta el tiempo de CPU en este worker? Estás apuntando a: la memoria del isolate ni sobrevive a las invocaciones ni abarca ciudades, así que el estado compartido va a KV; y el presupuesto de 10 ms mide solo cómputo, así que un worker que en su mayoría espera fetches casi no gasta. Si las dos salieron limpias, el modelo de la plataforma es tuyo.
Si la costura te mordió en algún lado que esta lección no predijo (una dependencia de una dependencia buscando un builtin de node es el clásico), manda el nombre del módulo en el feedback del curso; la tabla de porteo de arriba crece exactamente a partir de esos reportes.
La mitad de TS de la estación ahora corre en cientos de ciudades. La lección que viene es el pago hacia el que venía construyendo todo el arco de Rust: el mismo motor puro de M4, compilado a WASM, desplegado al mismo edge con el mismo wrangler deploy. Un contrato de plataforma, dos lenguajes.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.
Inscríbete para hacer el quiz
El quiz es parte del curso: inscríbete para responderlo, seguir tu progreso y ganar XP.