Carregando...

 BetaBeta
O m06-l2 instalou um runtime de contêiner, construiu o modelo mental de imagem-contêiner-camada-registro e entregou a primeira imagem ingênua do poller, com o peso multi-gigabyte dela deixado na sua tela de propósito. Hoje esse peso sai. Uma ideia, aplicada duas vezes: construa em uma caixa, entregue só o que roda em outra. A imagem Rust ganha o tratamento cargo-chef, três estágios de build mais um runtime debian slim; a frota TS ganha o próprio build multi-stage node slim; as duas são medidas contra a baseline que você registrou. No caminho, o fleet-runner ganha um modo de serviço por intervalo, porque um contêiner quer um processo em primeiro plano de vida longa, não um script que sai. O contrato de recuo: o Dockerfile de Rust é totalmente resolvido, o Dockerfile de node você escreve a partir do mesmo padrão com TODOs só nas fronteiras de estágio, e o challenge do .dockerignore é inteiramente solo. As rodinhas de Contêineres 101 saíram.
Comece pela evidência. Terminal aberto, antes de qualquer leitura:
docker images pulse-pollerd
Lá está ele, o número que você anotou na lição passada, ainda nos gigabytes, para um binário que você poderia anexar em um e-mail. E o peso não é um constrangimento de uma vez só parado no seu disco. Toda máquina que algum dia der pull nesta imagem paga ele de novo: o runner de CI a cada push, o primeiro docker run de um estranho, o você do futuro num laptop novo, todos eles baixando um toolchain Rust completo e o seu cache de build inteiro para rodar poucos megabytes de poller compilado. Minutos e banda, multiplicados por cada pull, para sempre.
O conserto é uma ideia só, e eu quero enunciar ela na menor forma possível antes de qualquer sintaxe de Dockerfile. Um Dockerfile single-stage não consegue distinguir "precisou para construir" de "precisa para rodar", então ele entrega os dois. Um Dockerfile multi-stage é só duas caixas em um arquivo: uma caixa de build com o toolchain inteiro, e uma caixa de runtime que começa quase vazia. Entre elas, uma instrução, COPY --from, carrega os artefatos para a frente. E aqui está a regra que decide tudo sobre o que é entregue: a imagem final é a base do estágio final mais o que você explicitamente COPY para dentro dela. Nada mais. A caixa de build, gigabytes dela, fica para trás na máquina de build como andaime depois que o prédio abre.
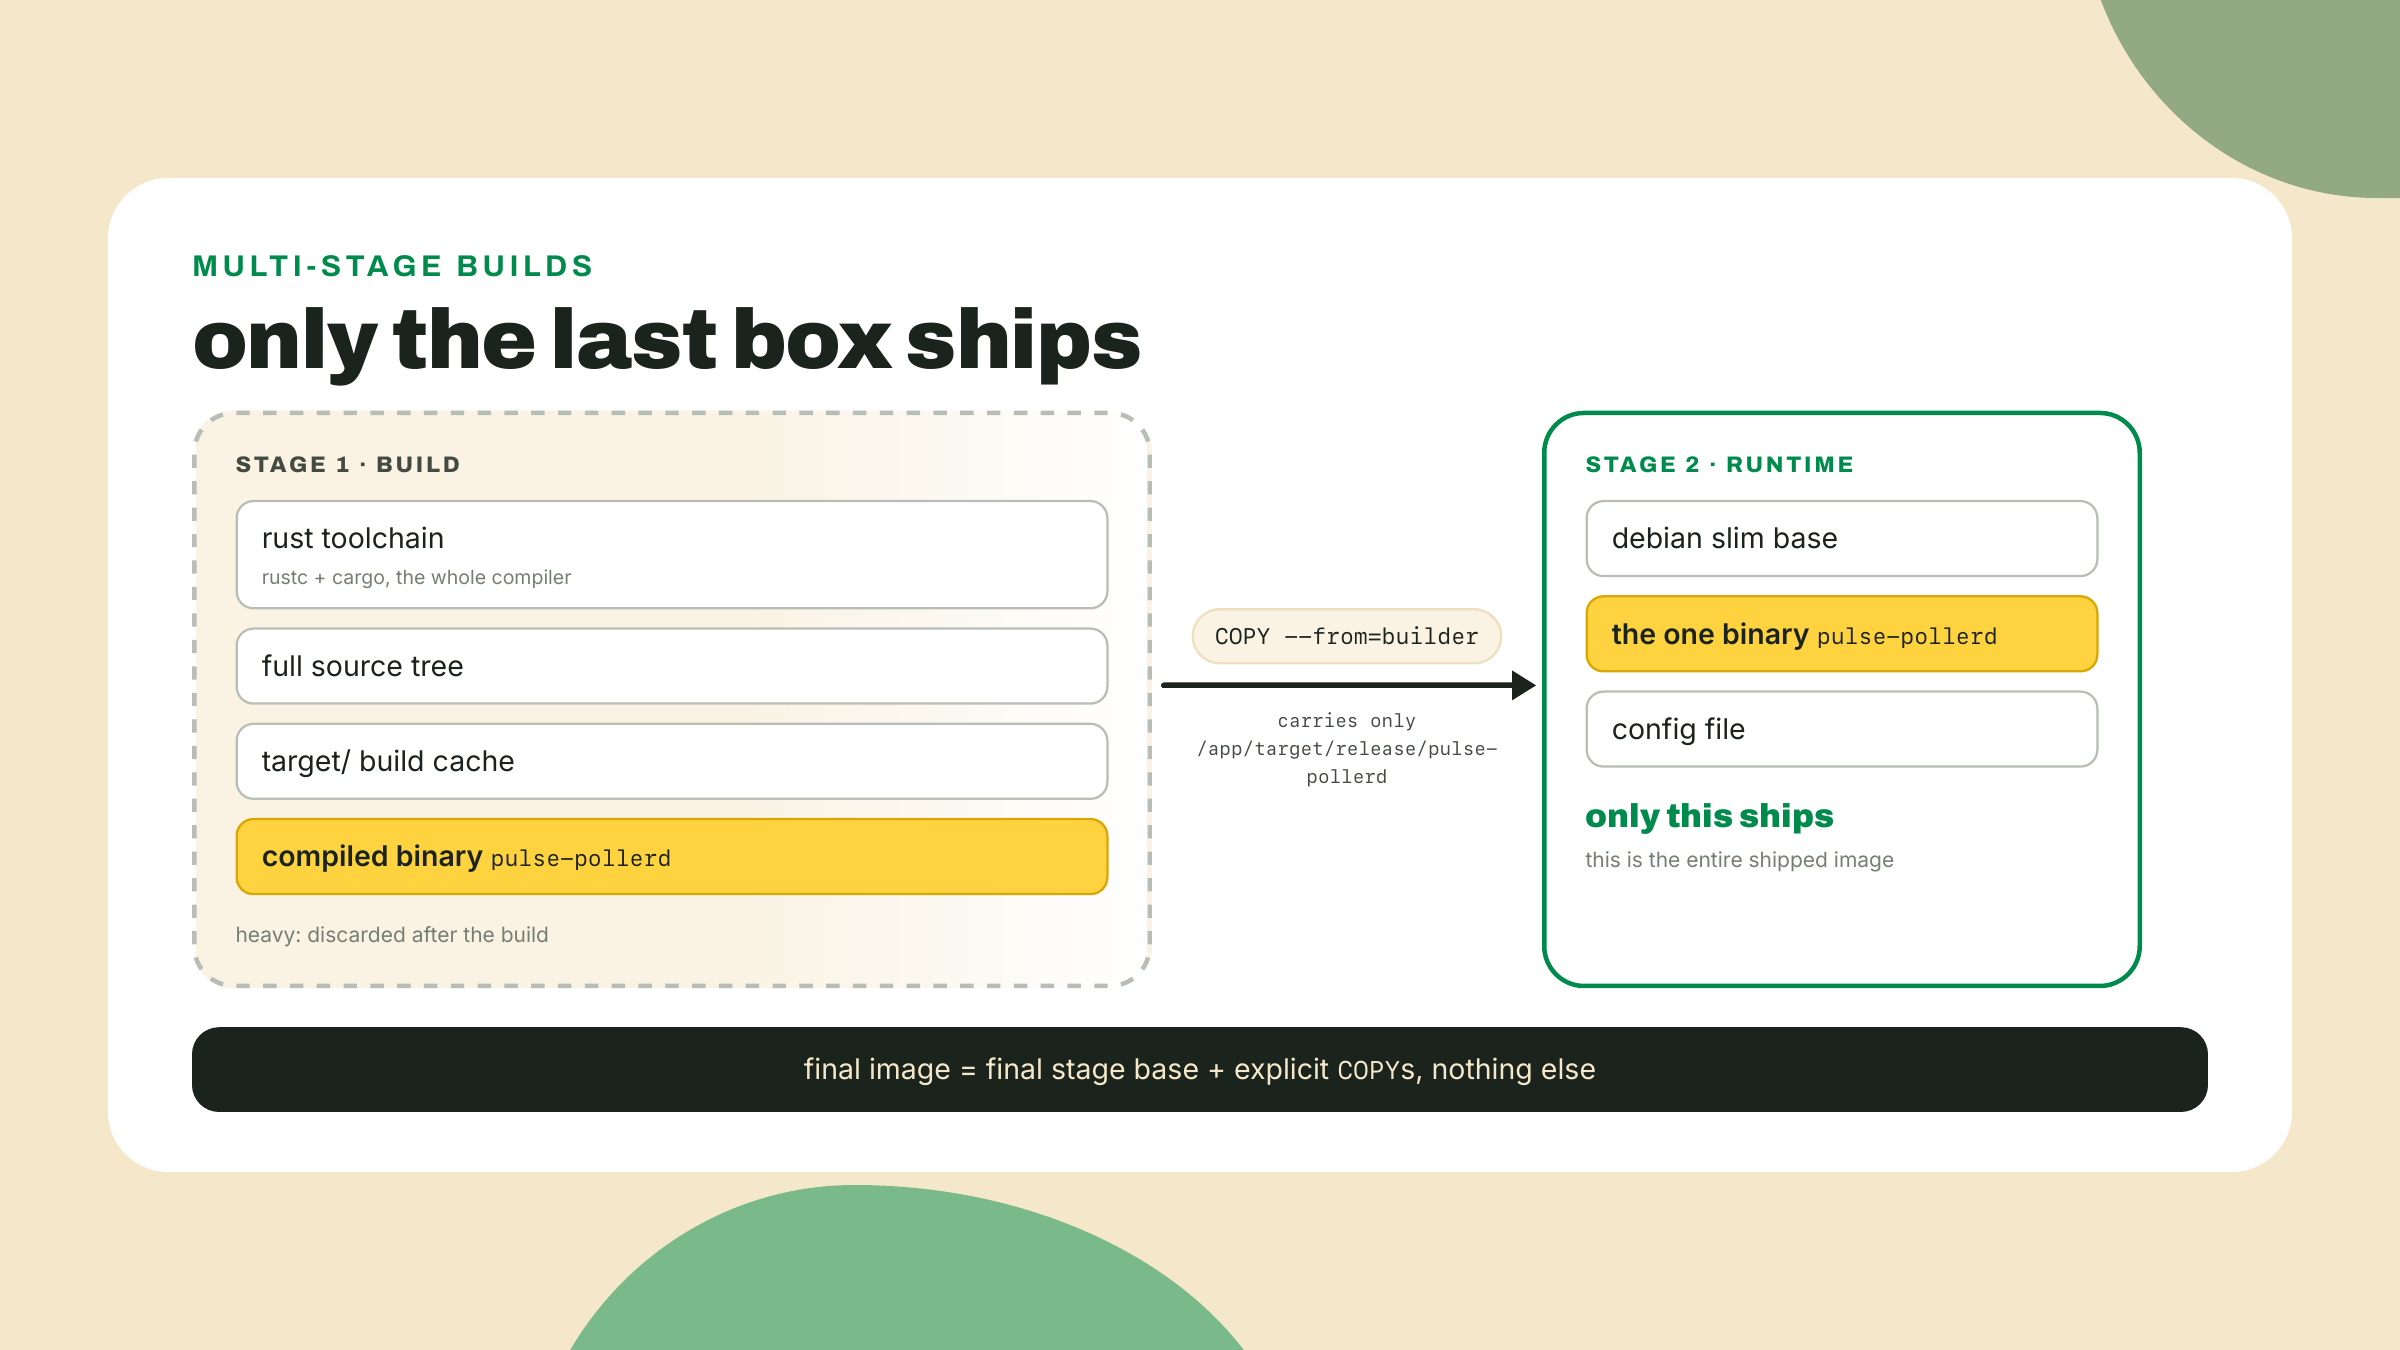
É essa a ideia inteira. Todo o resto é engenharia em volta de duas perguntas de acompanhamento: como manter a caixa de build rápida quando você reconstrói ela cinquenta vezes por dia, e quão pequena a caixa de runtime deveria ser, com honestidade?
A imagem ingênua tinha um segundo problema escondido atrás do tamanho dela, e você sentiu ele no lab: todo rebuild era um cargo build --release frio do workspace inteiro. O culpado é a ordem de invalidação do cache de camadas (o Docker reusa uma camada em cache só se a instrução e toda entrada acima dela estiverem inalteradas; a primeira camada mudada invalida tudo abaixo). O nosso arquivo ingênuo fazia COPY . . e depois construía, o que quer dizer que qualquer edição em qualquer arquivo, um comentário no main.rs, um typo no README, invalidava a camada de cópia e forçava a camada de build a recompilar todo crate de dependência do zero. As dependências não mudaram. O Tokio não mudou. Você pagou por elas mesmo assim, toda vez.
O conserto é cache de camada de dependências: arrume o Dockerfile para que as dependências compilem na camada própria delas, chaveada só nos manifests, com a sua fonte chegando depois. Aí uma edição só de código invalida as camadas baratas de fonte e a camada cara de dependências fica em cache. O Cargo torna isso desajeitado de fazer na mão, porque o cargo build quer arquivos de fonte de verdade presentes, não só o Cargo.toml. Que é exatamente a lacuna que o cargo-chef existe para preencher.
O cargo-chef (0.1.78, checado contra o crates.io em 2026-09-02) é um subcomando do cargo com dois verbos. O cargo chef prepare escaneia o seu workspace e escreve um arquivo de receita, uma descrição JSON do seu grafo de dependências com a sua fonte retirada. O cargo chef cook constrói só as dependências a partir dessa receita, um target/ cheio de crates compilados e nada do que é seu. A receita só muda quando os seus manifests mudam, então a camada do cook sobrevive a toda edição de código que você algum dia vai fazer. O README dele afirma builds até 5x mais rápidos; esse é o número do autor, e o passo 3 faz você medir o seu. Um crédito, porque a origem é boa: Luca Palmieri escreveu o cargo-chef para o Zero to Production in Rust, e o Dockerfile de três estágios que você está prestes a escrever é tirado do README dele de propósito. Não reinvente uma roda que o ecossistema já testou sob carga.
O canon do README são quatro estágios, três para construir (chef, planner, builder) mais a caixa de runtime que é entregue, e a forma importa mais que a sintaxe:
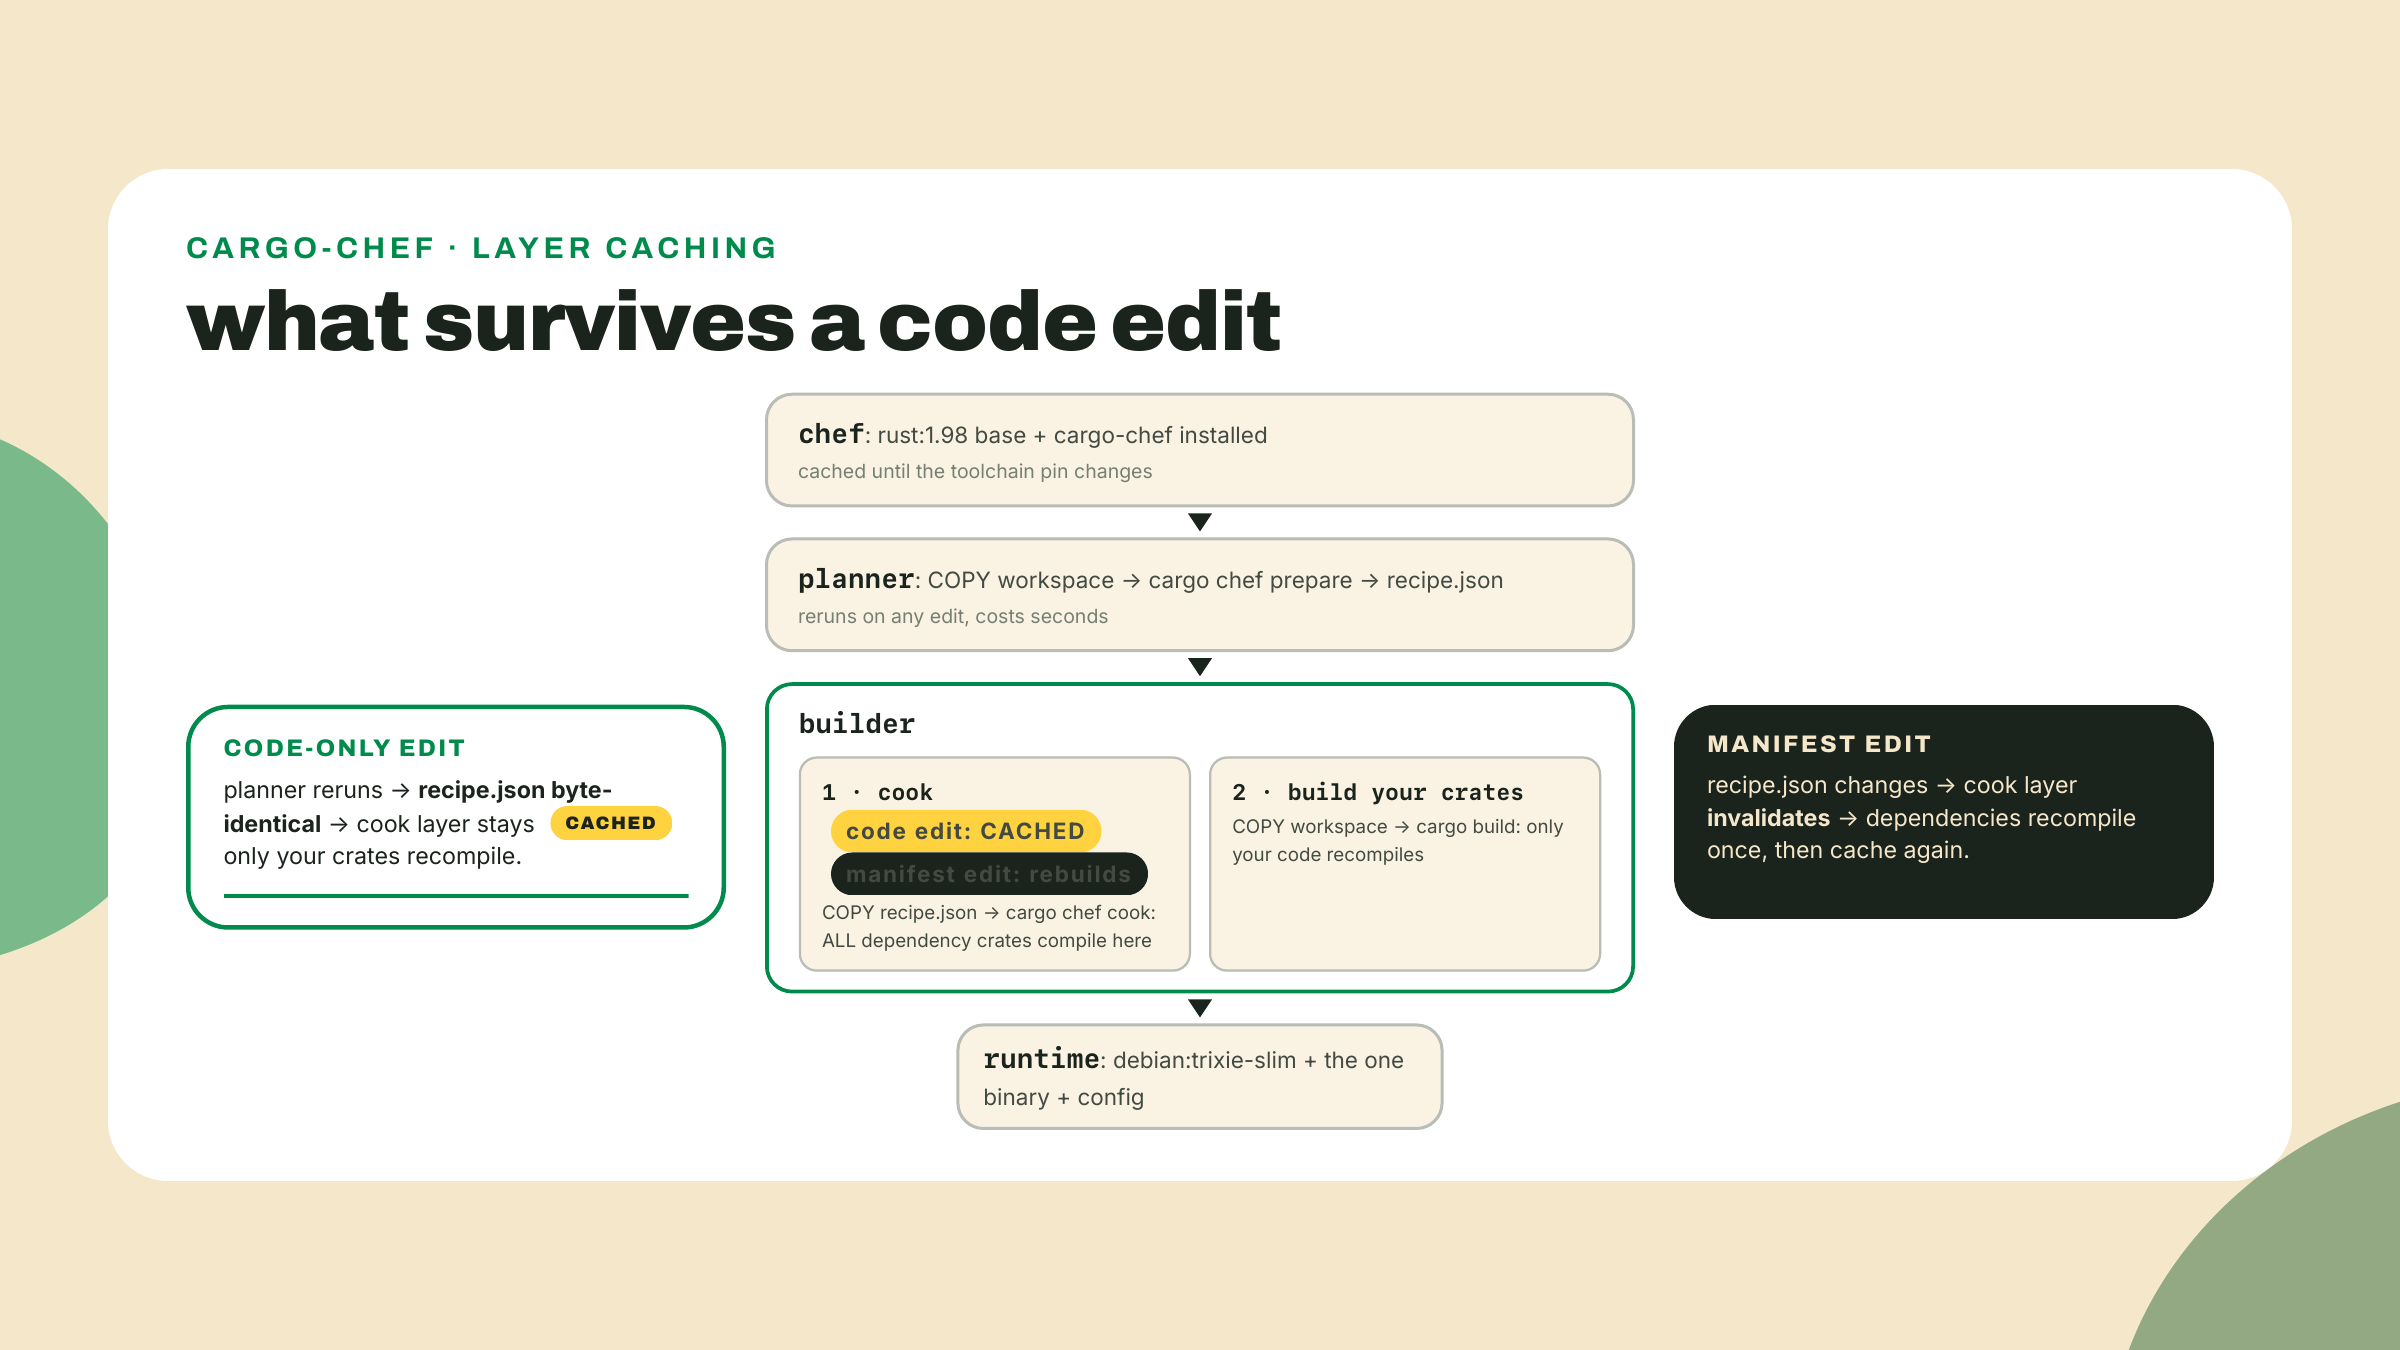
Por que o estágio planner existe, afinal, em vez de cozinhar direto? Porque a receita é a chave de cache. O prepare roda de novo a cada edição, mas é barato e a saída dele é determinística: os mesmos manifests entram, um recipe.json byte-idêntico sai. O estágio builder copia só esse arquivo antes de cozinhar, então o Docker compara a receita, não vê mudança, e pula o cook. A sua compilação de dependências agora é chaveada no seu grafo de dependências em vez de na sua árvore de fontes, que é o que a gente queria esse tempo todo.
A frota tem a mesma doença em um corpo diferente. Uma imagem node ingênua faria COPY . . e pnpm install, e toda edição de fonte voltaria a baixar e a relinkar a árvore de dependências inteira. A cura é a mesma ideia, e aqui você consegue ver ela sem uma ferramenta helper, porque os manifests do node bastam por si sós: copie o lockfile e os arquivos package.json primeiro, instale na camada própria deles, e só então copie a fonte. O cargo-chef automatiza para Rust exatamente o que você está prestes a fazer na mão para node. Depois que você tiver escrito os dois, nenhum dos dois é mágica.
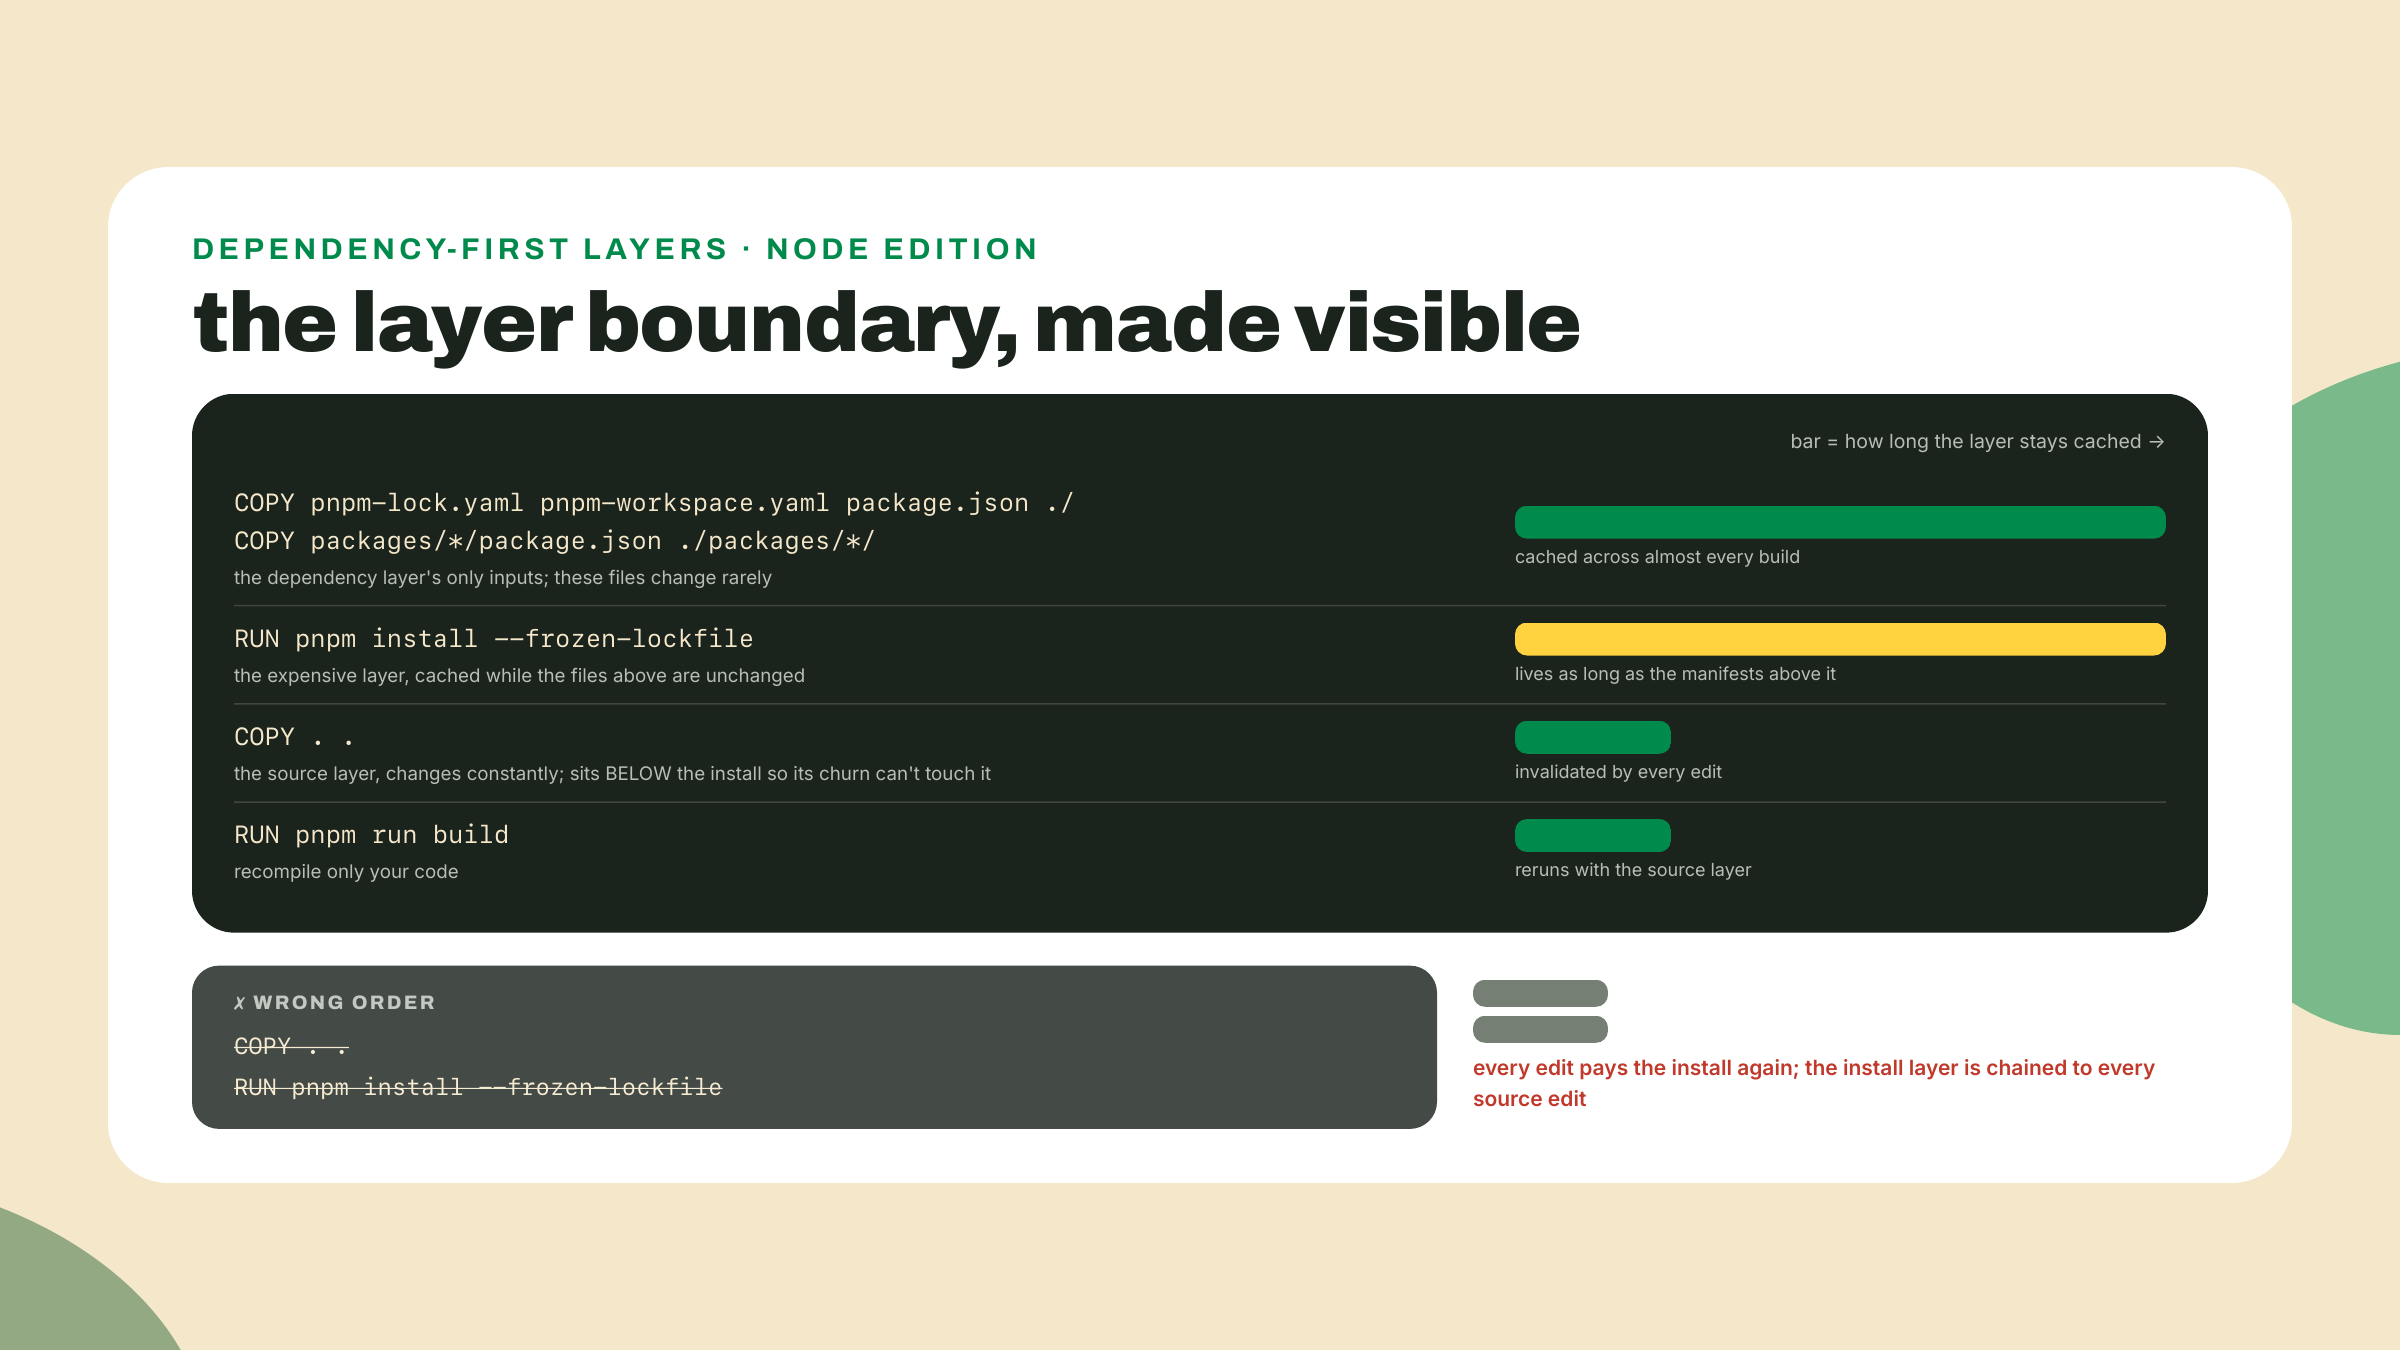
Duas decisões específicas de node nessa imagem merecem o porquê delas. A base é node:24-slim: o Node 24 é o LTS ativo em 2026-09-02 (o Node 26 pega o bastão em 2026-10-28; o dígito sobe, nada mais muda). E o pnpm é instalado explicitamente, npm i -g pnpm@11.25.0, não com o one-liner corepack enable dos Dockerfiles mais velhos: em 2025-03-19 o TSC do Node votou pela saída do corepack, e do Node 25 em diante ele não vem na caixa. O Node 24 ainda carrega ele, então a linha antiga funciona hoje e quebra no próximo bump da base, o pior tipo de funcionar. Um build de imagem quer etapas determinísticas e autocontidas, então instale a ferramenta de que você precisa, fixada. E o dígito aqui não é uma alegação de atualidade, é um acordo: 11.25.0 é o que o campo packageManager do m03-l1 diz, e uma imagem cujo pnpm discorda do pnpm do workspace vai brigar com você no --frozen-lockfile. O latest do npm desde então foi para a linha 12 (12.3.4 em 2026-09-06, com o 11 seguindo vivo sob latest-11), que é justamente o ponto e não um problema: um Dockerfile que pegasse o que quer que o latest servisse no dia do build teria mudado de major do pnpm em silêncio entre dois builds do mesmo commit. Bata com o workspace, não com a tag.
Mais uma costura, e é a interessante. Por que não simplesmente dar COPY --from no node_modules construído para dentro do estágio de runtime, do jeito que a gente copia o binário Rust? Porque o node_modules de um workspace pnpm é uma teia de symlinks para dentro do workspace, e as dependências do pulse-fleet incluem o pulse-core, que mora fora de qualquer coisa que você copiaria ingenuamente. Leve o diretório para fora do contexto e os links ficam pendurados no vazio. O pnpm já vem com um comando exatamente para isso: o pnpm deploy extrai um pacote de um workspace para um diretório autocontido, arquivos de verdade, só dependências de produção, pacotes do workspace incluídos. A última linha do estágio de build vai ser:
pnpm --filter pulse-fleet --prod deploy --legacy /out
A gente roda ele com --prod e com --legacy, e a flag legacy merece honestidade: o deploy atual do pnpm quer uma configuração de workspace inteiro chamada inject-workspace-packages, que abre mão da atualização automática dos symlinks em que o seu loop de dev vem se apoiando desde o m03-l4. O copiador legacy não pede esse trade-off e é exatamente o certo dentro de um estágio de build descartável. Os dois comportamentos estão documentados na página de deploy do pnpm, verificada em 2026-09-02.
Vou confessar de onde veio a mensalidade deste padrão, porque eu paguei ela na moeda mais idiota, esperando. Um projeto de painel antigo meu tinha COPY . . parado uma linha acima do install. Todo commit, e eu quero dizer todo commit, o CI baixava o universo node de novo, quatro minutos extras, dezenas de vezes por semana, durante meses. Ninguém notou porque sempre tinha sido lento assim. O conserto foi mover uma linha duas linhas para cima. Leia os seus logs de build do jeito que você leu o docker history na lição passada; lentidão distribuída por igual parece clima, e em geral é uma camada fora do lugar.
Tem um desencontro que a gente vem ignorando com educação: o poller é um daemon, nascido para rodar para sempre, mas o fleet-runner é um script. Ele varre os alvos dele uma vez, escreve os resultados dele e sai, porque a cron do GitHub Actions reinvoca ele num agendamento e essa era a forma certa para aquela casa. Ponha essa forma em um contêiner e você ganha uma caixa que inicia, trabalha por dois segundos e morre. O Compose, na próxima lição, reiniciaria ela para sempre com todo o zelo, e eu já vi times entregarem exatamente isso: uma política de restart fazendo cosplay de escalonador, logs que se leem como uma crônica de crashes, startup de processo pago a cada varredura. Você consegue reconhecer o anti-padrão a partir de uma única célula do docker ps:
STATUS
Restarting (0) 2 seconds ago
Código de saída zero, reiniciando mesmo assim, para sempre. Políticas de restart são para se recuperar de falha. Agendar é trabalho do programa. Um contêiner quer um processo em primeiro plano de vida longa, então o conserto honesto é dar ao runner um modo de serviço de verdade, um loop de intervalo no próprio código, construído nesta lição, não suposto. É esse o passo 4 do lab, e a flag que ele adiciona é uma interface: o arquivo compose da próxima lição dirige ela por uma variável de ambiente, então os nomes que a gente escolhe hoje ficam congelados no momento em que a gente escolhe.
Agora a pergunta que todo tutorial de contêiner responde rápido demais: quão pequena a caixa de runtime deveria ser? A resposta reflexa da internet é alpine, uma distribuição baseada em musl cuja imagem base tem uns dez megabytes, e para a imagem node os números até parecem amigáveis: o README do docker-node cita o node:alpine como uns 25% menor que o node:slim. Para Rust, a mesma jogada quer dizer construir contra x86_64-unknown-linux-musl e entregar um binário estático dentro de uma caixa minúscula. Imagem menor, pulls mais rápidos, qual é a pegadinha?
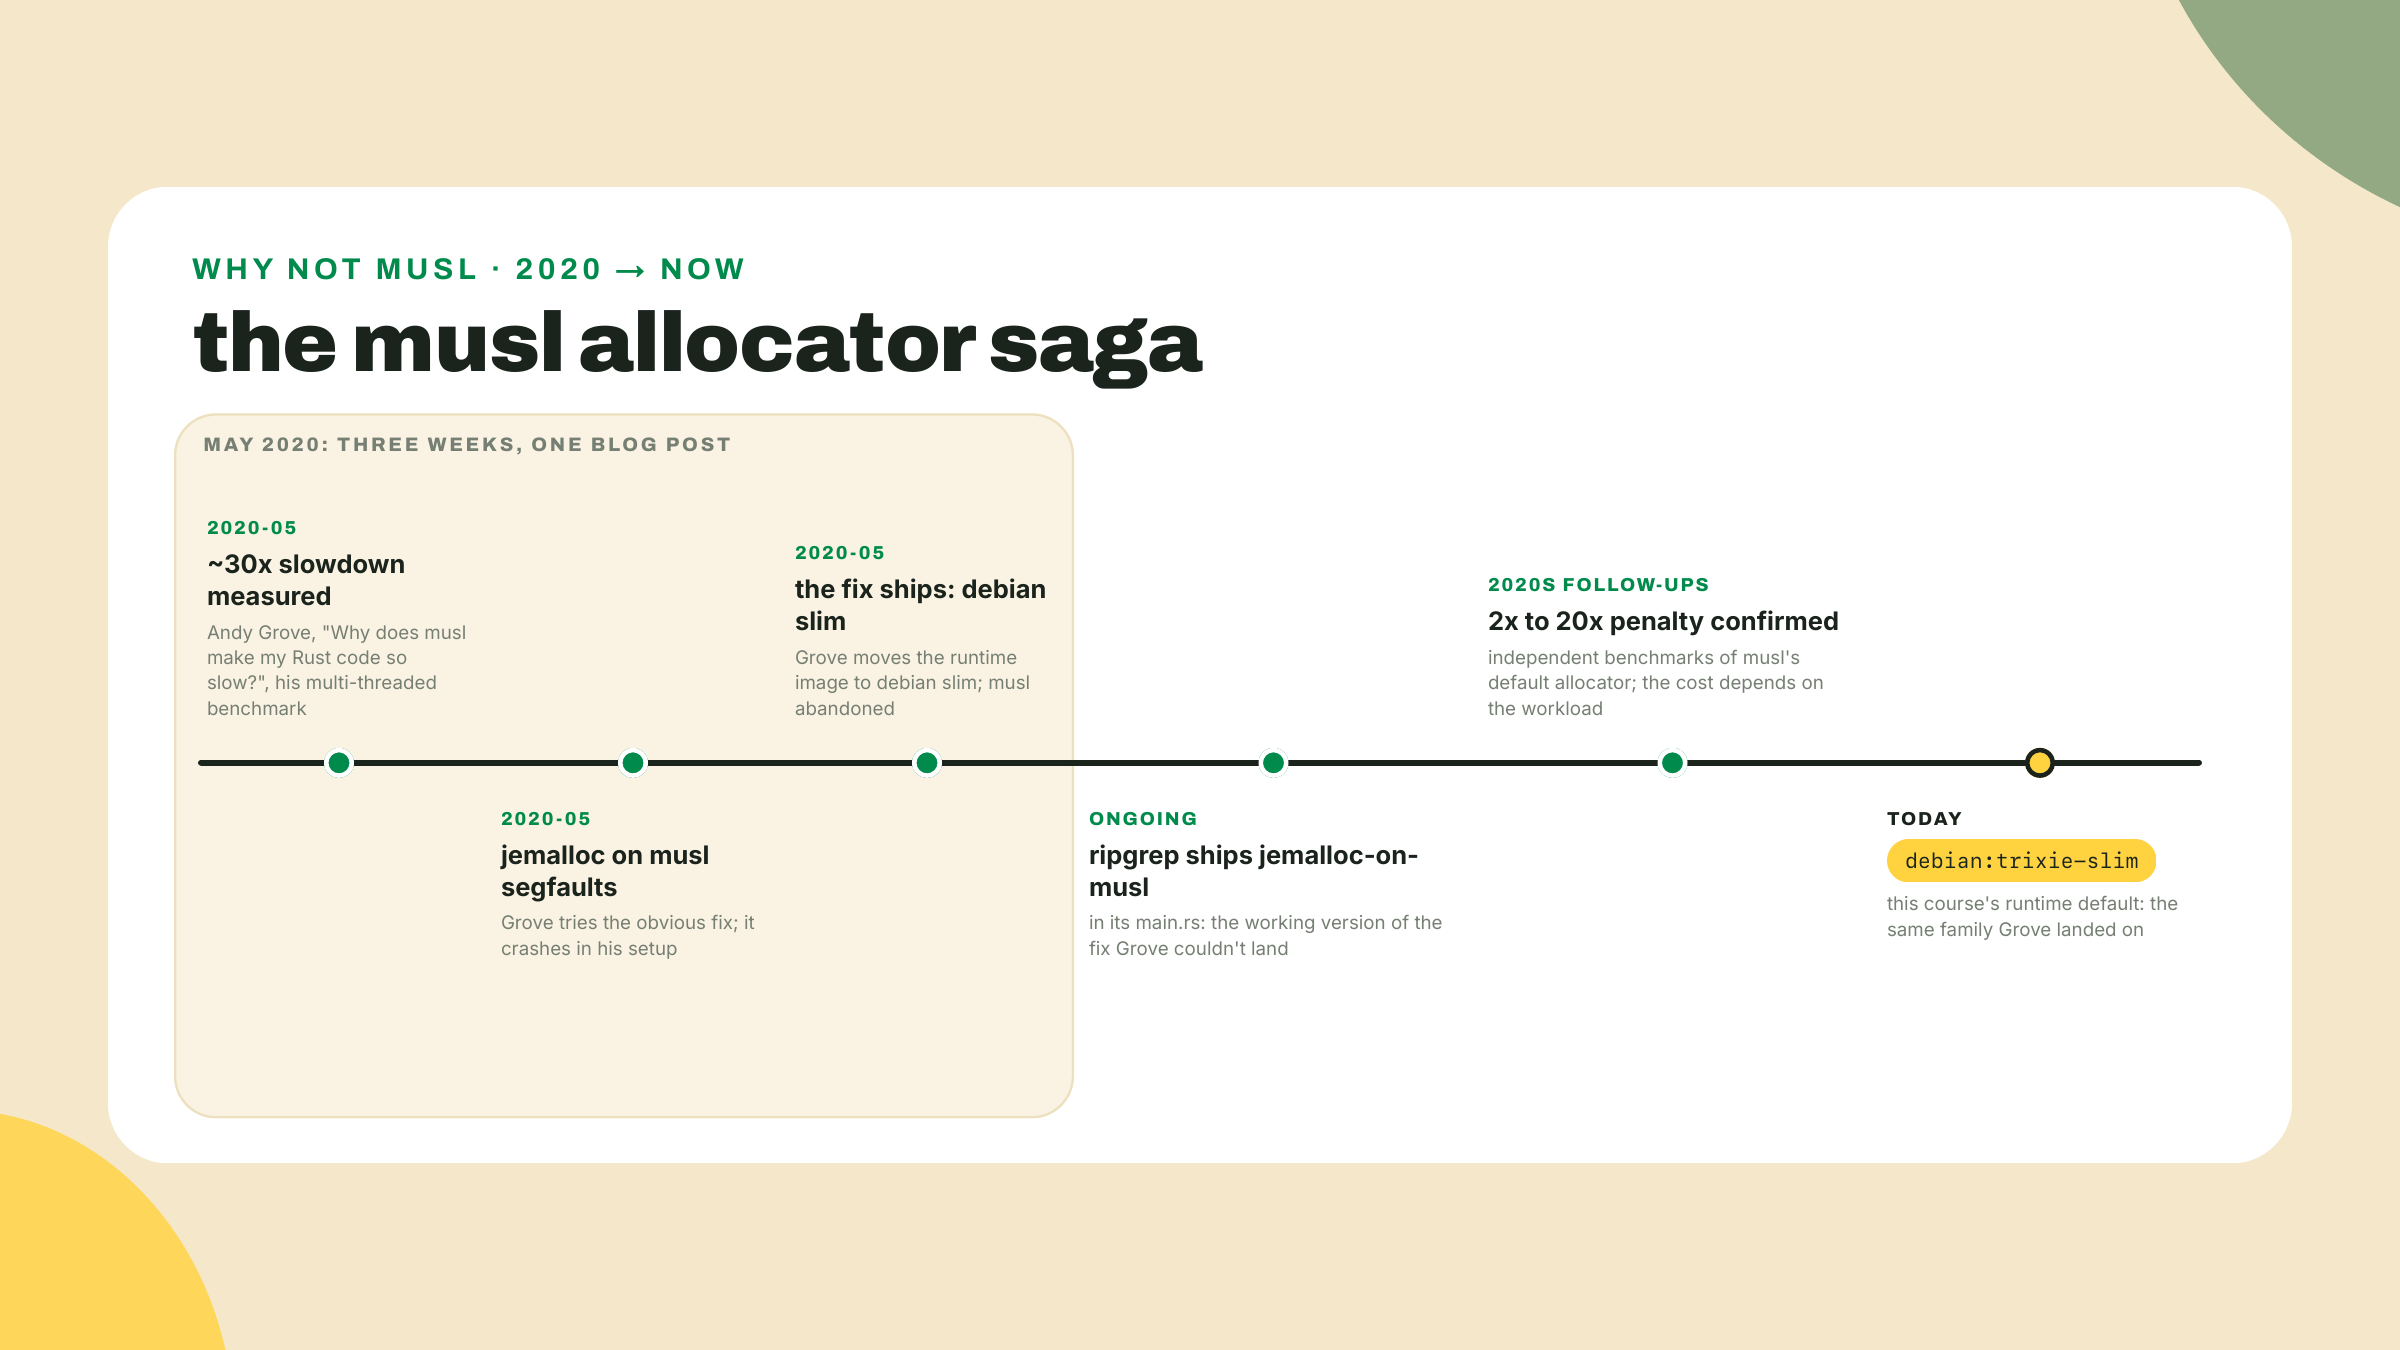
A pegadinha tem nome e data. Em maio de 2020, Andy Grove, do Apache Arrow e do DataFusion, publicou "Why does musl make my Rust code so slow?": o benchmark multi-thread dele rodou uns 30x mais devagar no musl que no glibc. Não por cento. Vezes. O culpado é o alocador default do musl, que degrada feio sob alocação multi-thread, e o nosso poller é precisamente um processo tokio multi-thread. Medições posteriores põem a penalidade em 2x a 20x conforme a carga de trabalho; todo número pertence ao benchmark dele, não ao seu. Grove tentou o conserto padrão, jemalloc. Deu segfault. O conserto de verdade dele foi mudar para debian slim e abandonar o musl: o homem que escreveu a reclamação do musl aterrissou na base exata que este curso ensina. O ripgrep foi pelo outro caminho e fez funcionar, entregando jemalloc nos builds musl dele até hoje. As duas são respostas honestas de engenharia. Nenhuma das duas é "alpine é menor, use alpine".
Existe uma segunda cilada do alpine, e esta não degrada, ela detona. Um binário Rust construído para o target musl linka musl estaticamente; as bibliotecas do próprio alpine, inclusive o OpenSSL dele, linkam musl dinamicamente. Ponha um binário musl-estático que também linka OpenSSL C dentro de uma caixa alpine e os dois musls se encontram na hora do handshake TLS; o resultado documentado é um segfault. A feature vendored do crate openssl é uma saída; o canon do curso é mais direto e bate com todo arquivo de regras de Rust neste repo: use rustls, nenhuma dependência de TLS em C, nenhum conflito de linkagem para ter. A parte satisfatória: você já vive assim. O reqwest 0.13 usa rustls por default (checado contra a lista de features da 0.13.4 no docs.rs), então o poller do m06-l1 não tem OpenSSL para brigar. Ele ainda precisa de certificados CA para verificar os servidores que ele sonda, que é o motivo de o estágio de runtime instalar exatamente um pacote, ca-certificates, e nada mais.
Então a comparação franca, nos eixos que importam:
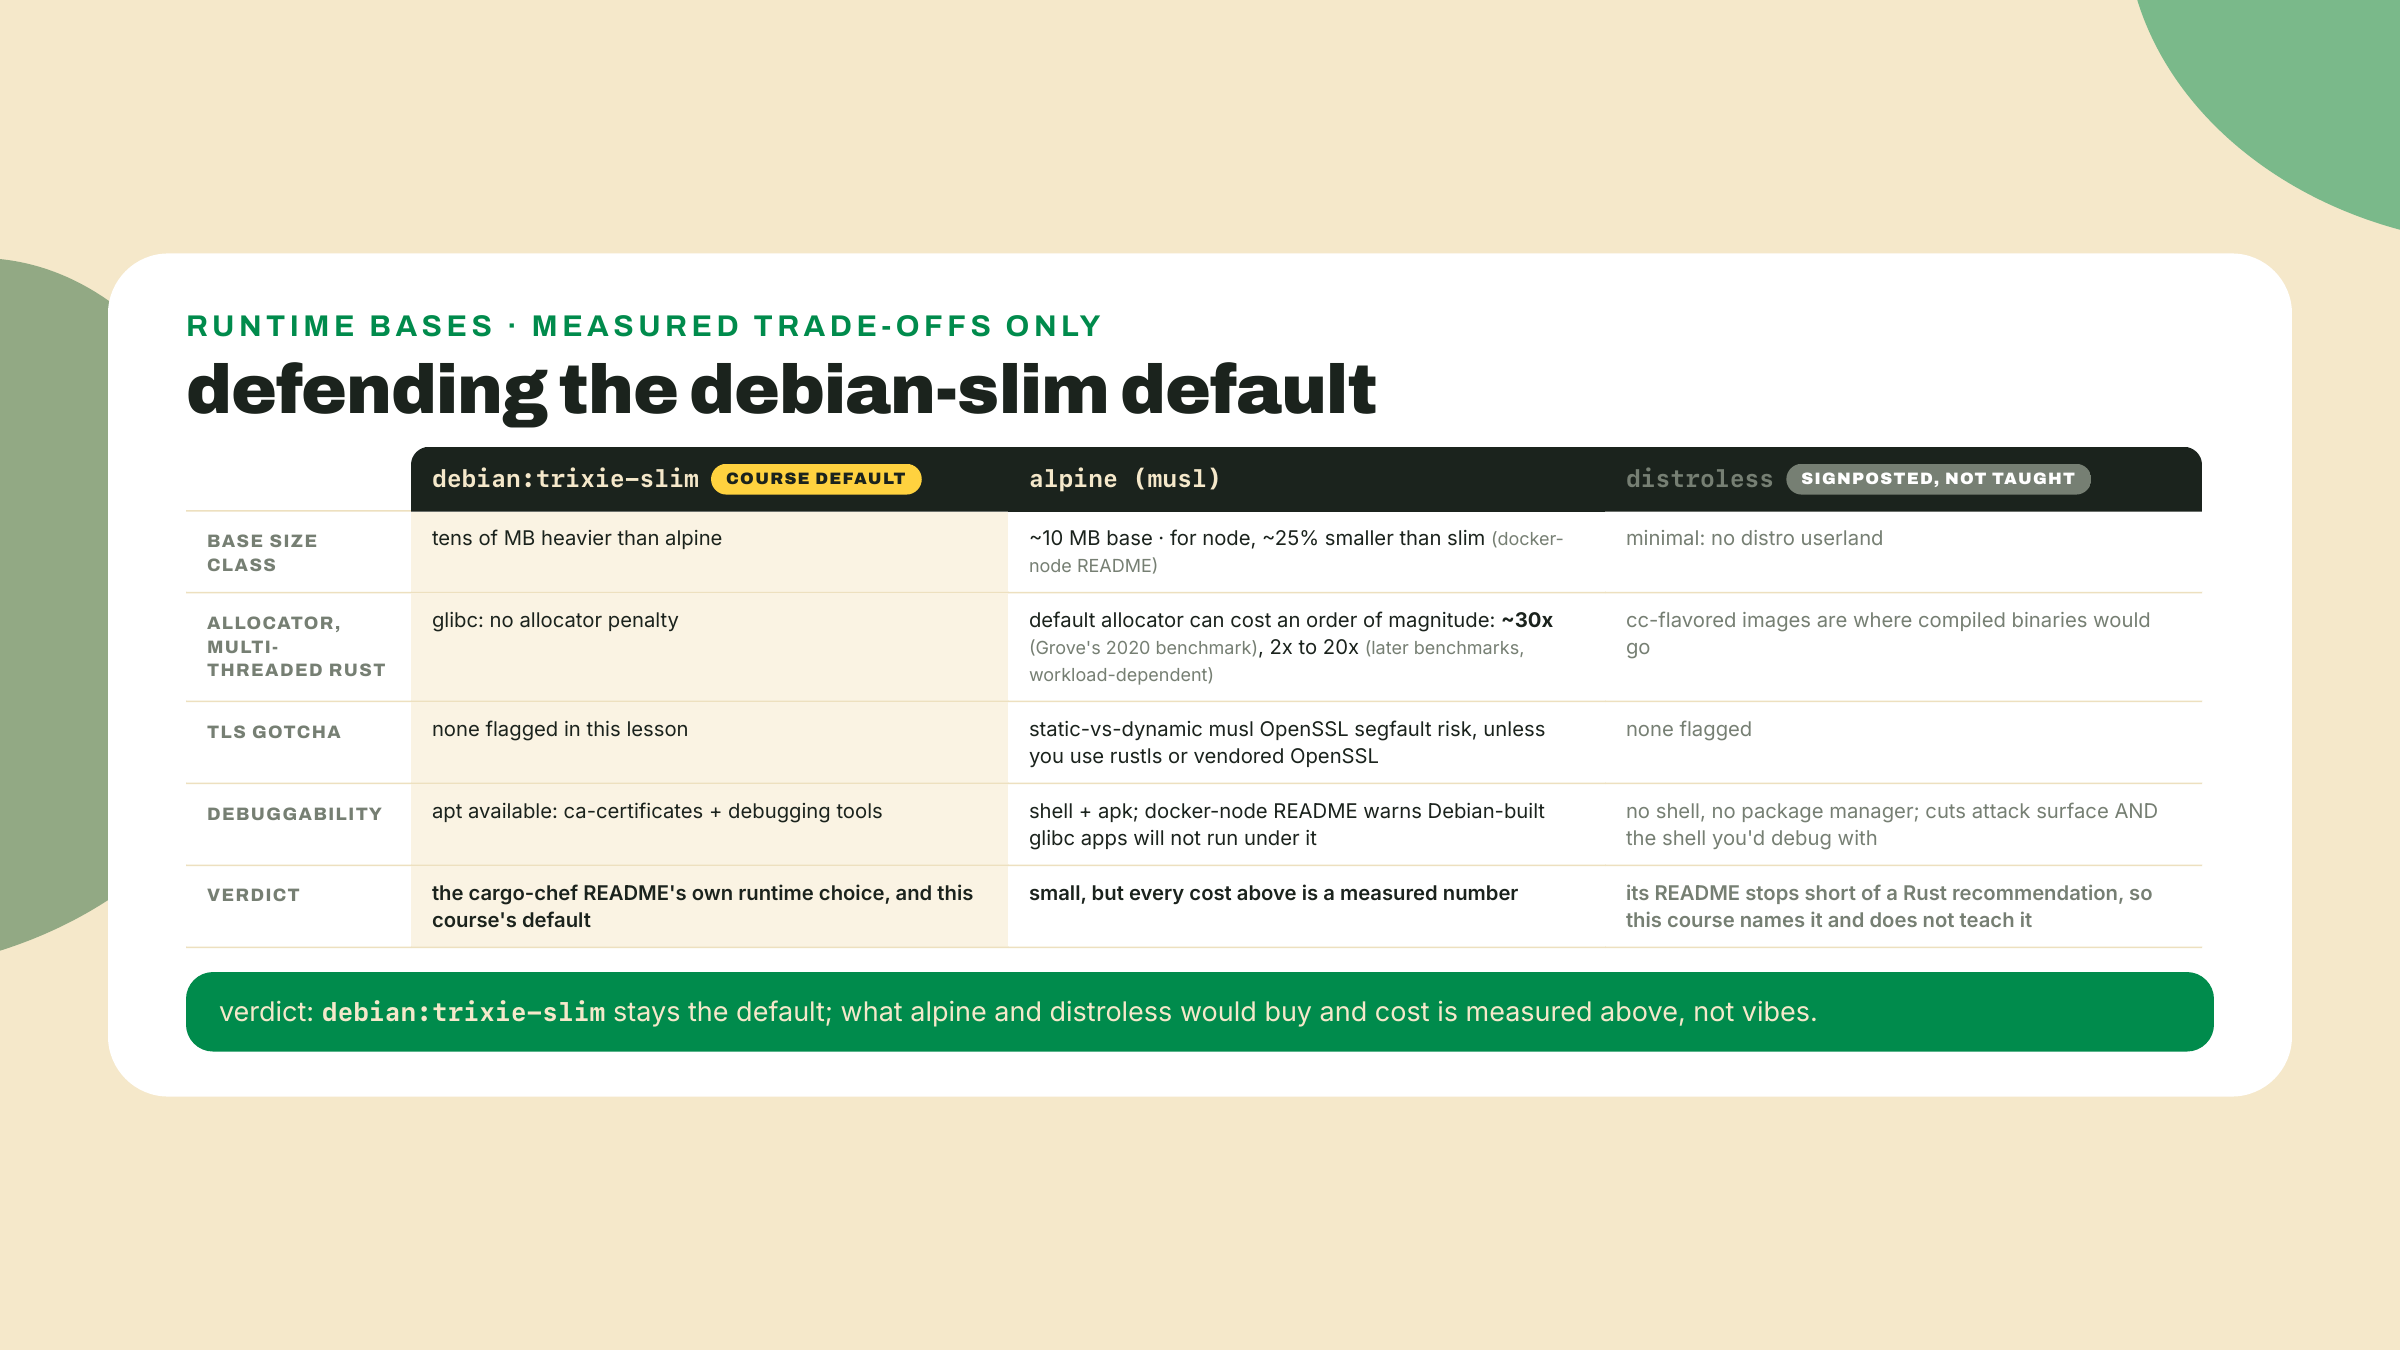
O trade-off, dito uma vez e sem rodeios: a imagem menor não é o binário mais rápido. O musl compra uma base de dez megabytes e pode te custar uma ordem de magnitude de vazão do alocador; o debian slim custa dezenas de megabytes a mais e simplesmente funciona; o distroless corta superfície de ataque e corta também o shell que você procuraria às 2 da manhã. Builds multi-stage adicionam o próprio custo silencioso deles também, o que você agora sabe pagar: a ordem de invalidação de cache vira uma preocupação de design, e um Dockerfile com as camadas na ordem errada recompila o mundo a cada build parecendo perfeitamente correto. A escolha da imagem base é um trade-off medido. Meça, escolha, escreva o porquê em um comentário, siga em frente.
Dois terminais, dois workspaces: pulse-rs para o poller, pulse-station para a frota. O seu número de baseline ingênua do m06-l2 vai no topo de uma nota de rascunho; toda medição abaixo aterrissa ao lado dele.
pulse-rs, substitua por inteiro o Dockerfile ingênuo da lição passada. Este aqui é totalmente resolvido; leia as anotações contra o flowchart de quatro estágios acima:FROM rust:1.98 AS chef
RUN cargo install cargo-chef --locked --version 0.1.78
WORKDIR /app
FROM chef AS planner
COPY . .
RUN cargo chef prepare --recipe-path recipe.json
FROM chef AS builder
COPY --from=planner /app/recipe.json recipe.json
RUN cargo chef cook --release --recipe-path recipe.json
COPY . .
RUN cargo build --release --bin pulse-pollerd
FROM debian:trixie-slim AS runtime
RUN apt-get update \
&& apt-get install -y --no-install-recommends ca-certificates \
&& rm -rf /var/lib/apt/lists/*
WORKDIR /app
COPY --from=builder /app/target/release/pulse-pollerd /usr/local/bin/pulse-pollerd
COPY pulse.config.json .
ENV POLLER_PORT=8080
EXPOSE 8080
CMD ["pulse-pollerd"]
As glosas, estágio por estágio. O AS chef nomeia um estágio para que estágios posteriores possam dar FROM ou COPY --from nele; o estágio chef é o toolchain compartilhado, rust:1.98 (o pin estável da lição passada, tag rechecada em 2026-09-02) mais o cargo-chef instalado uma vez, --locked para que o lockfile dele seja honrado, --version 0.1.78 para que a camada não mude em silêncio. O planner copia tudo mas produz só o recipe.json. O builder copia só a receita, cozinha as dependências para dentro da camada que sobrevive às suas edições, depois copia a sua fonte e constrói os seus crates. O estágio de runtime parte do debian:trixie-slim, a escolha do próprio README do cargo-chef, instala ca-certificates (um daemon de sonda que não consegue verificar TLS é um peso de papel) e recebe exatamente dois arquivos: o binário e a config. O ENV POLLER_PORT=8080 mantém o seu challenge do m06-l2 funcionando. Tudo que os estágios anteriores criaram fica para trás.
.dockerignore da lição passada ainda cerca target/ e .git/, então a transferência de contexto fica pequena. Então:docker build -t pulse-pollerd:slim .
docker images pulse-pollerd
O primeiro build é franco sobre o custo dele: ele compila a sua árvore de dependências uma vez dentro da camada do cook, então espere minutos, comparável ao build ingênuo. A recompensa é a coluna SIZE: o pulse-pollerd:slim deve aterrissar uma ordem de magnitude abaixo do seu número ingênuo, de gigabytes para poucas centenas de megabytes; o meu mediu 121 MB contra um ingênuo de 2.06 GB, um corte de 17x, e a maior parte do resto é a própria base Debian slim mais ca-certificates em volta de um binário e um arquivo JSON. Se algum tutorial te prometeu megabytes de dois dígitos, esse é o bairro do alpine e do musl estático, e a seção de teoria já precificou essa viagem. Escreva o número ao lado da baseline. Depois prove que ele ainda funciona:
docker run --rm -p 8080:8080 pulse-pollerd:slim
Do segundo terminal, curl -s localhost:8080/status deve responder com o mesmo JSON de sempre. Se, em vez disso, o contêiner morrer nomeando um arquivo .so que falta, você encontrou a falha clássica do multi-stage: o "file not found" que na verdade é um erro de linker, o estágio de runtime sem uma biblioteca compartilhada contra a qual o binário linka. Rodar de novo o contêiner que falha (docker run --rm pulse-pollerd:slim) imprime o nome da biblioteca que falta; para a lista completa, rode ldd onde as ferramentas e o binário Linux moram juntos, o estágio builder: docker build --target builder -t pulse-pollerd:builder . e depois docker run --rm pulse-pollerd:builder ldd /app/target/release/pulse-pollerd. (O seu host não ajuda: o macOS não tem ldd, e o seu binário de host não é o binário Linux de qualquer jeito.) A nossa stack evita o caso comum por construção, rustls em vez de OpenSSL C, mas o diagnóstico é seu para a vida toda.
Prove que o cache faz o que eu afirmei. Abra qualquer arquivo de fonte no pulse-engine ou no pulse-pollerd, mude uma mensagem de log ou adicione um comentário, salve, reconstrua com o mesmo comando e leia o log. O planner roda de novo e emite uma receita byte-idêntica, a etapa do cargo chef cook imprime CACHED, e o único trabalho de compilação são os seus próprios crates: segundos a poucos minutos em vez do build completo de dependências. A afirmação de até-5x do README é a medição do Luca nos projetos dele; a razão que você acabou de produzir é sua, e a sua é a que você pode citar. Agora mude uma linha no Cargo.toml, reconstrua, e veja a camada do cook invalidar com honestidade: a receita mudou, então as dependências recompilam uma vez. É esse o contrato de cache inteiro, demonstrado em dois rebuilds.
Dê ao fleet-runner um modo de serviço. Vá para o pulse-station, e seja preciso sobre QUAL arquivo fleet, porque a estação carrega dois. O contêiner roda packages/pulse-fleet/src/fleet.ts, o sondador guiado por config, rodar-uma-vez desde o nascimento: ele carrega a config dele, varre cada alvo pelo pool do probeAll, imprime os contadores de resumo dele e sai. (Ele não escreve arquivo de resultados nenhum; o status.json pertence ao OUTRO fleet.ts, o que fica na raiz do pacote e que a cron do m01-l3 invoca, e nada neste passo chega perto dele.) Primeira jogada: torne a forma rodar-uma-vez explícita embrulhando o corpo da varredura existente, do carregamento de config passando pelo probeAll até a impressão do resumo, em uma função, async function runSweep(configPath: string): Promise<void>, sem mudar nada dentro dela. Depois troque o tratamento de argumentos da entrada por isto:
const args = process.argv.slice(2);

const flagAt = args.indexOf("--interval");
const intervalRaw = flagAt === -1 ? process.env.FLEET_INTERVAL : args[flagAt + 1];
if (flagAt !== -1 && intervalRaw === undefined) {
  console.error("--interval needs a value in seconds");
  process.exit(1);
}
const positional =
  flagAt === -1 ? args : args.filter((_, i) => i !== flagAt && i !== flagAt + 1);

const configPath = positional[0];
if (!configPath) {
  console.error("usage: fleet [--interval <seconds>] <config-path>");
  process.exit(1);
}

let intervalSecs: number | undefined;
if (intervalRaw !== undefined) {
  intervalSecs = Number(intervalRaw);
  if (!Number.isFinite(intervalSecs) || intervalSecs <= 0) {
    console.error(`--interval wants a positive number of seconds, got "${intervalRaw}"`);
    process.exit(1);
  }
}

const stop = new AbortController();
process.on("SIGINT", () => stop.abort());
process.on("SIGTERM", () => stop.abort());

function sleep(ms: number, signal: AbortSignal): Promise<void> {
  return new Promise((resolve) => {
    if (signal.aborted) {
      resolve();
      return;
    }
    const timer = setTimeout(resolve, ms);
    signal.addEventListener(
      "abort",
      () => {
        clearTimeout(timer);
        resolve();
      },
      { once: true },
    );
  });
}

if (intervalSecs === undefined) {
  await runSweep(configPath);
} else {
  console.error(`fleet-runner: service mode, sweeping every ${intervalSecs}s`);
  while (!stop.signal.aborted) {
    await runSweep(configPath);
    await sleep(intervalSecs * 1_000, stop.signal);
  }
  console.error("fleet-runner: received stop signal, exiting cleanly");
}
Leia a interface primeiro, porque agora ela está congelada e o arquivo compose da próxima lição depende dela: um caminho de config posicional, uma flag --interval <seconds> opcional, uma variável de ambiente FLEET_INTERVAL como fallback da flag, rodar-uma-vez quando nenhuma das duas está definida. A cron do m01-l3 continua funcionando sem ser tocada pela razão mais direta nomeada acima: ela nunca chama este arquivo, ela roda o escritor da raiz do pacote. Uma divergência deliberada para nomear antes que alguém cite o m06-l1 para mim: aquela lição argumentou que o ticker do tokio ganha de dormir no fim do loop, e este loop dorme no fim. De propósito. O período dele é o tempo de varredura mais o intervalo, ruído para um runner que roda uma vez por minuto, enquanto o sleep abortável compra o desligamento limpo de que um contêiner precisa; o poller fica com o ticker porque ali o cronograma É o produto. O sleep é o padrão AbortController do m02-l3 apontado para dentro: SIGTERM ou Ctrl-C aborta o signal, quebrando a condição do loop e acordando o sleep na hora, então uma parada durante um cochilo de dez minutos não espera dez minutos. O tratamento de sinal não é decoração. Dentro de um contêiner o seu processo é o PID 1, e o docker stop manda SIGTERM; um processo node que ignora ele ganha dez segundos silenciosos e depois SIGKILL, que é como serviços acabam com escritas truncadas e nenhuma despedida nos logs.
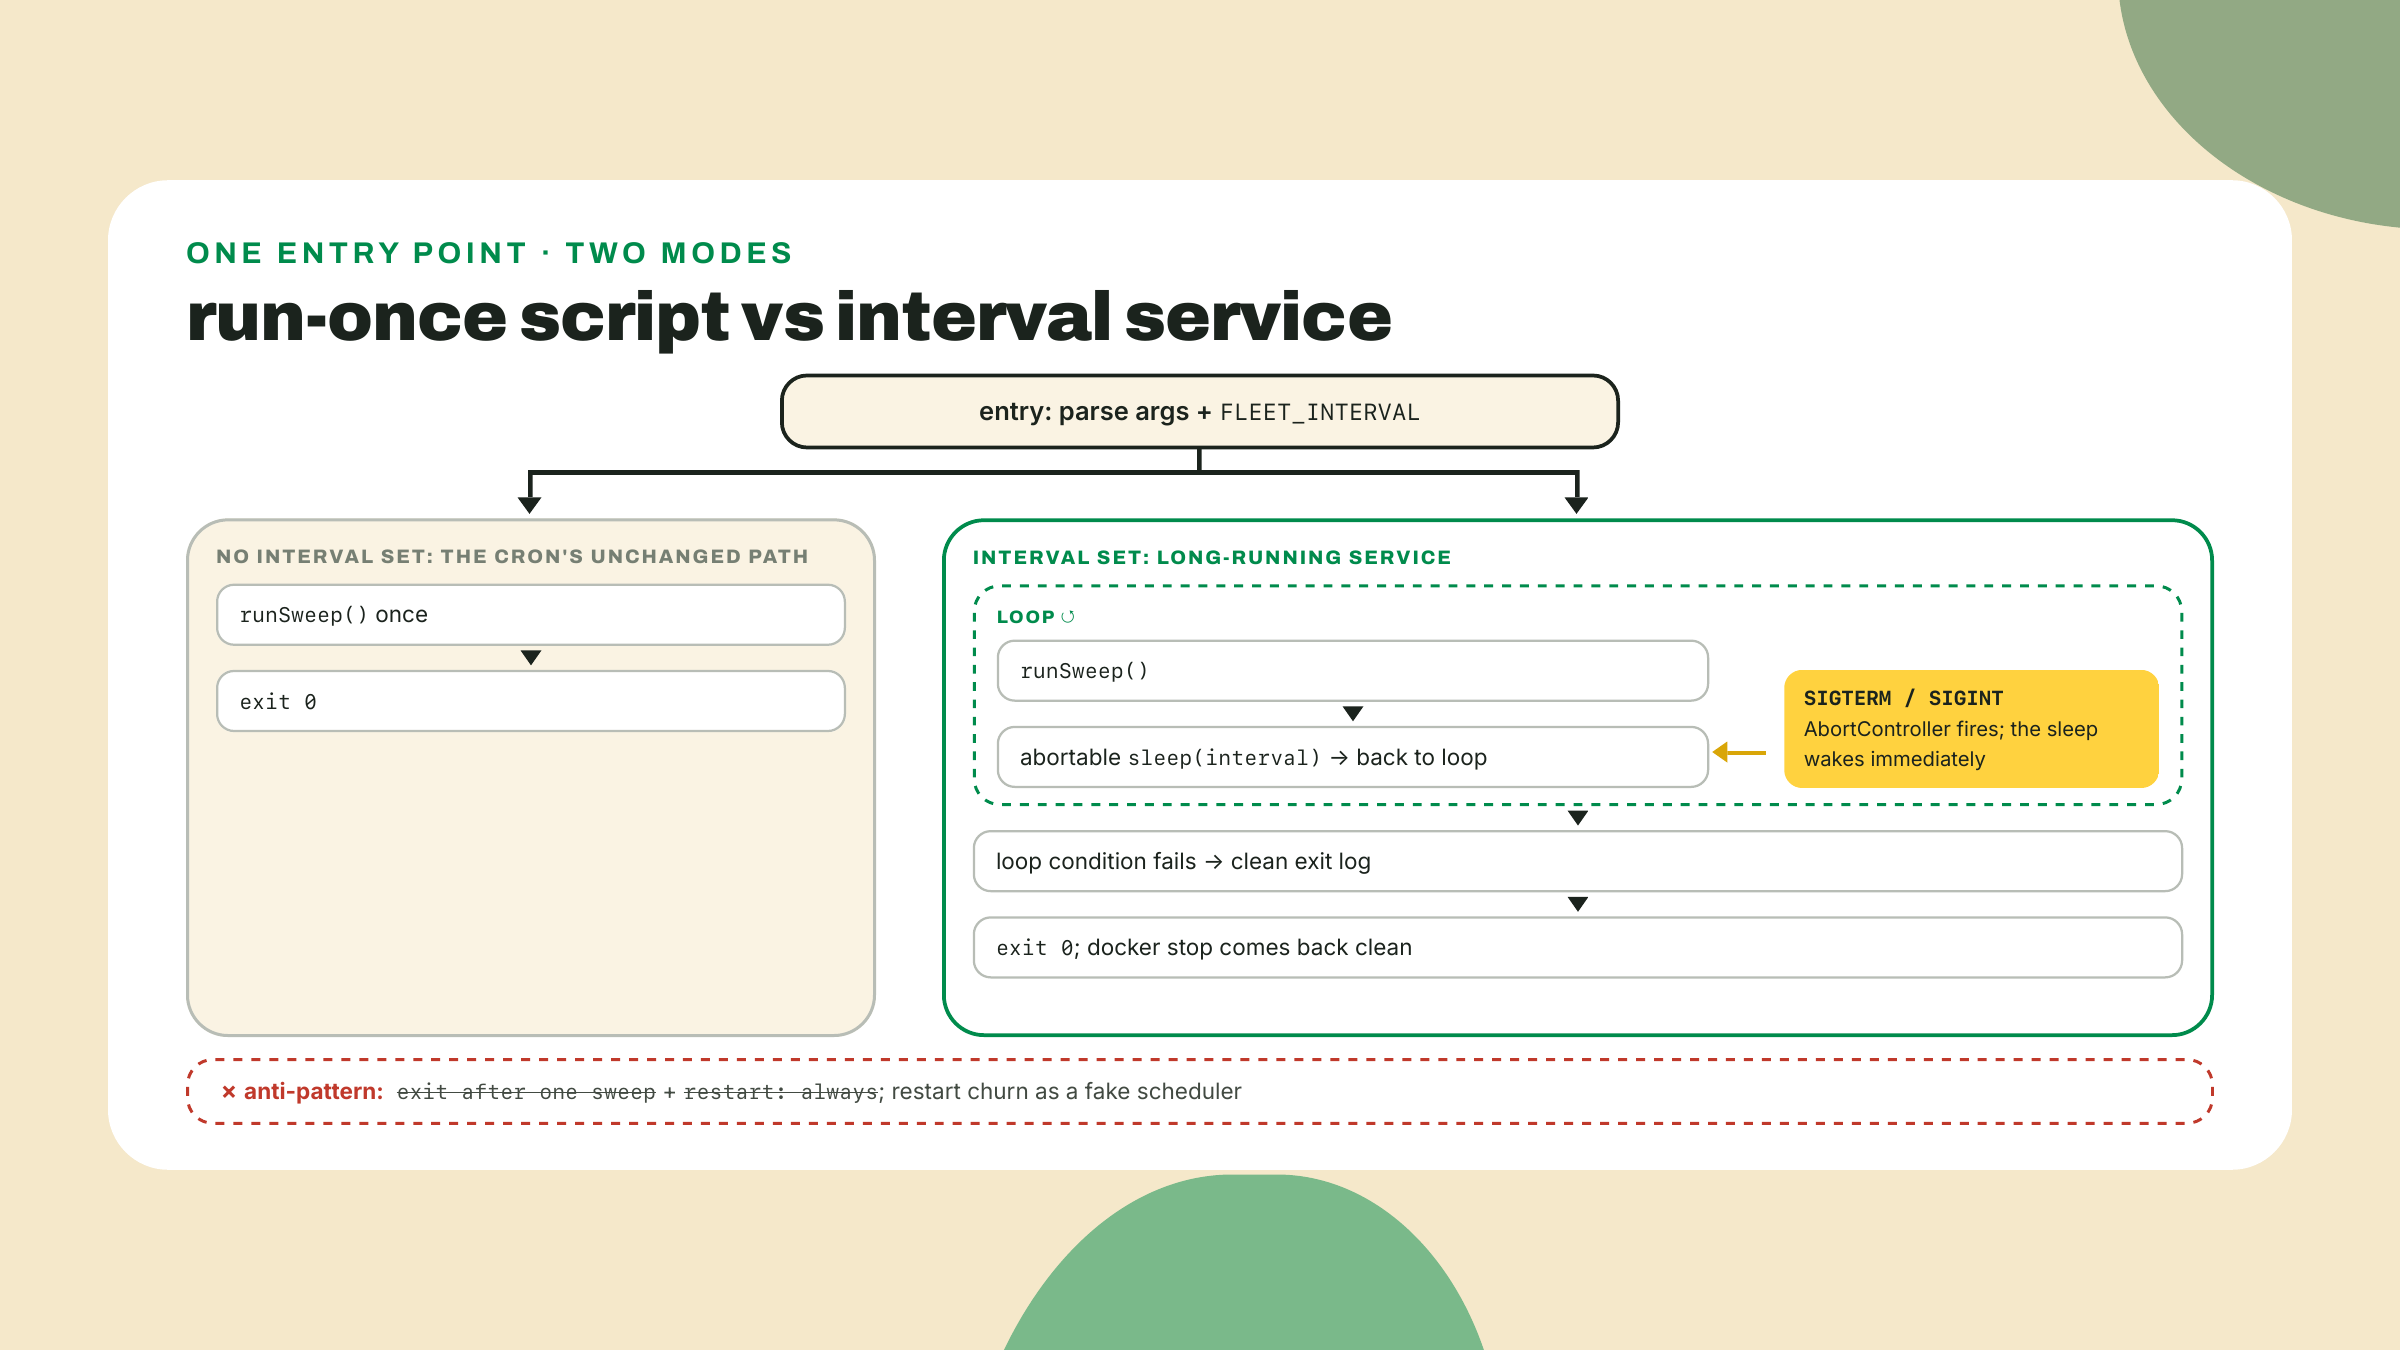
Teste no host antes de encaixotar: npx tsx src/fleet.ts pulse.config.json --interval 10 a partir de packages/pulse-fleet deve imprimir a linha de modo de serviço, completar uma varredura, pausar dez segundos, varrer de novo e sair limpo no Ctrl-C com a linha de despedida. Duas varreduras no log são a evidência de aceitação, e o checkpoint quer ela.
pulse-station, crie o Dockerfile.fleet, o nome explícito, não o default pelado, porque este arquivo mora na raiz do repo (o build precisa do workspace pnpm inteiro como contexto dele) enquanto o Dockerfile do próprio poller mora lá embaixo em pulse-rs/, e o arquivo compose e o job de CI da próxima lição vão referenciar o arquivo da frota exatamente por este nome:FROM node:24-slim AS base
RUN npm i -g pnpm@11.25.0
FROM base AS build
WORKDIR /app
# Dependency layer first, so a code edit cannot invalidate the install.
# TODO 1: COPY exactly what pnpm needs to resolve the workspace:
# pnpm-lock.yaml, pnpm-workspace.yaml, the root package.json,
# and each packages/*/package.json at its own path.
COPY ??? ???
RUN pnpm install --frozen-lockfile
# Source arrives AFTER the install layer.
# TODO 2: COPY the rest of the workspace in.
COPY ??? ???
RUN pnpm --filter pulse-core build \
&& pnpm --filter pulse-fleet build
RUN pnpm --filter pulse-fleet --prod deploy --legacy /out
FROM node:24-slim AS runtime
WORKDIR /app
# TODO 3: COPY --from the deployed bundle at /out into /app,
# and COPY the fleet's config file in next to it.
COPY ??? ???
COPY ??? ???
CMD ["node", "dist/fleet.js", "pulse.config.json"]
Três pedacinhos de fiação antes de ele conseguir construir, todos seus para colocar:
build no pulse-fleet que emite dist/. A escolha chata e correta é tsc com um tsconfig.build.json que estende a sua config estrita e define outDir: "dist", rootDir: "src" e, fácil de esquecer e obrigatório, include: ["src"], porque a raiz do pacote também carrega scripts avulsos (fleet.ts, probe.ts, smoke.ts) e um diretório tests/ que violam o rootDir no momento em que o tsc varre eles para dentro. Não existe noEmit para desligar: a base estrita nunca definiu ele, o CI do m01-l3 passa ele como flag, então um "noEmit": false explícito aqui é documentação inofensiva. (Construa o pulse-core primeiro, como o Dockerfile já faz; o build dele do m03-l4 emite as declarações que a compilação da frota lê.)"files": ["dist"] no package.json do pulse-fleet, para que o pnpm deploy saiba o que carregar.packages/pulse-fleet/package.json para packages/pulse-fleet/, porque o pnpm resolve o workspace pela forma. Se a sua camada de install roda de novo a cada edição de código, você copiou demais para o TODO 1; o visual de ordem de camadas acima é o mapa de debug.pulse-station ainda não tem .dockerignore, e construir sem um não só te constrange, ele falha. O contexto sem cerca pesa perto de 1.8 GB, uns 1.5 GB disso pulse-rs/target/, e pior, o COPY . . joga o node_modules construído no macOS do seu host em cima do install Linux novinho do contêiner; o pnpm --filter ... build dentro do contêiner então percebe o diretório de modules incompatível, tenta substituir ele e aborta o build de imagem inteiro com ERR_PNPM_ABORTED_REMOVE_MODULES_DIR_NO_TTY. Então crie o .dockerignore na raiz do pulse-station com as duas entradas que desbloqueiam o build:node_modules
pulse-rs/target/
Nenhum dos dois diretórios foi algum dia uma entrada de verdade, porque o build compila dentro do contêiner a partir de um install limpo. Então, da raiz do pulse-station:
docker build -f Dockerfile.fleet -t pulse-fleet-runner:slim .
docker run --rm -e FLEET_INTERVAL=15 pulse-fleet-runner:slim
Note o tamanho de transferring context que o log de build imprime: mesmo com a cerca de duas linhas ele está longe de arrumado, já que .git/, saída de cobertura e todo dist/ ainda pegam carona, e o challenge termina o serviço com números. A execução deve imprimir a linha de modo de serviço e depois varrer a cada quinze segundos; deixe duas varreduras aterrissarem, depois dê docker stop nela do outro terminal (docker ps para o nome) e veja a linha de saída limpa chegar dentro de um segundo, o seu sleep abortável fazendo o trabalho dele contra um SIGTERM de verdade. Depois a contabilidade final:
docker images
Leia a coluna SIZE para dentro da forma abaixo, com a sua nota de baseline fornecendo a linha do ingênuo:
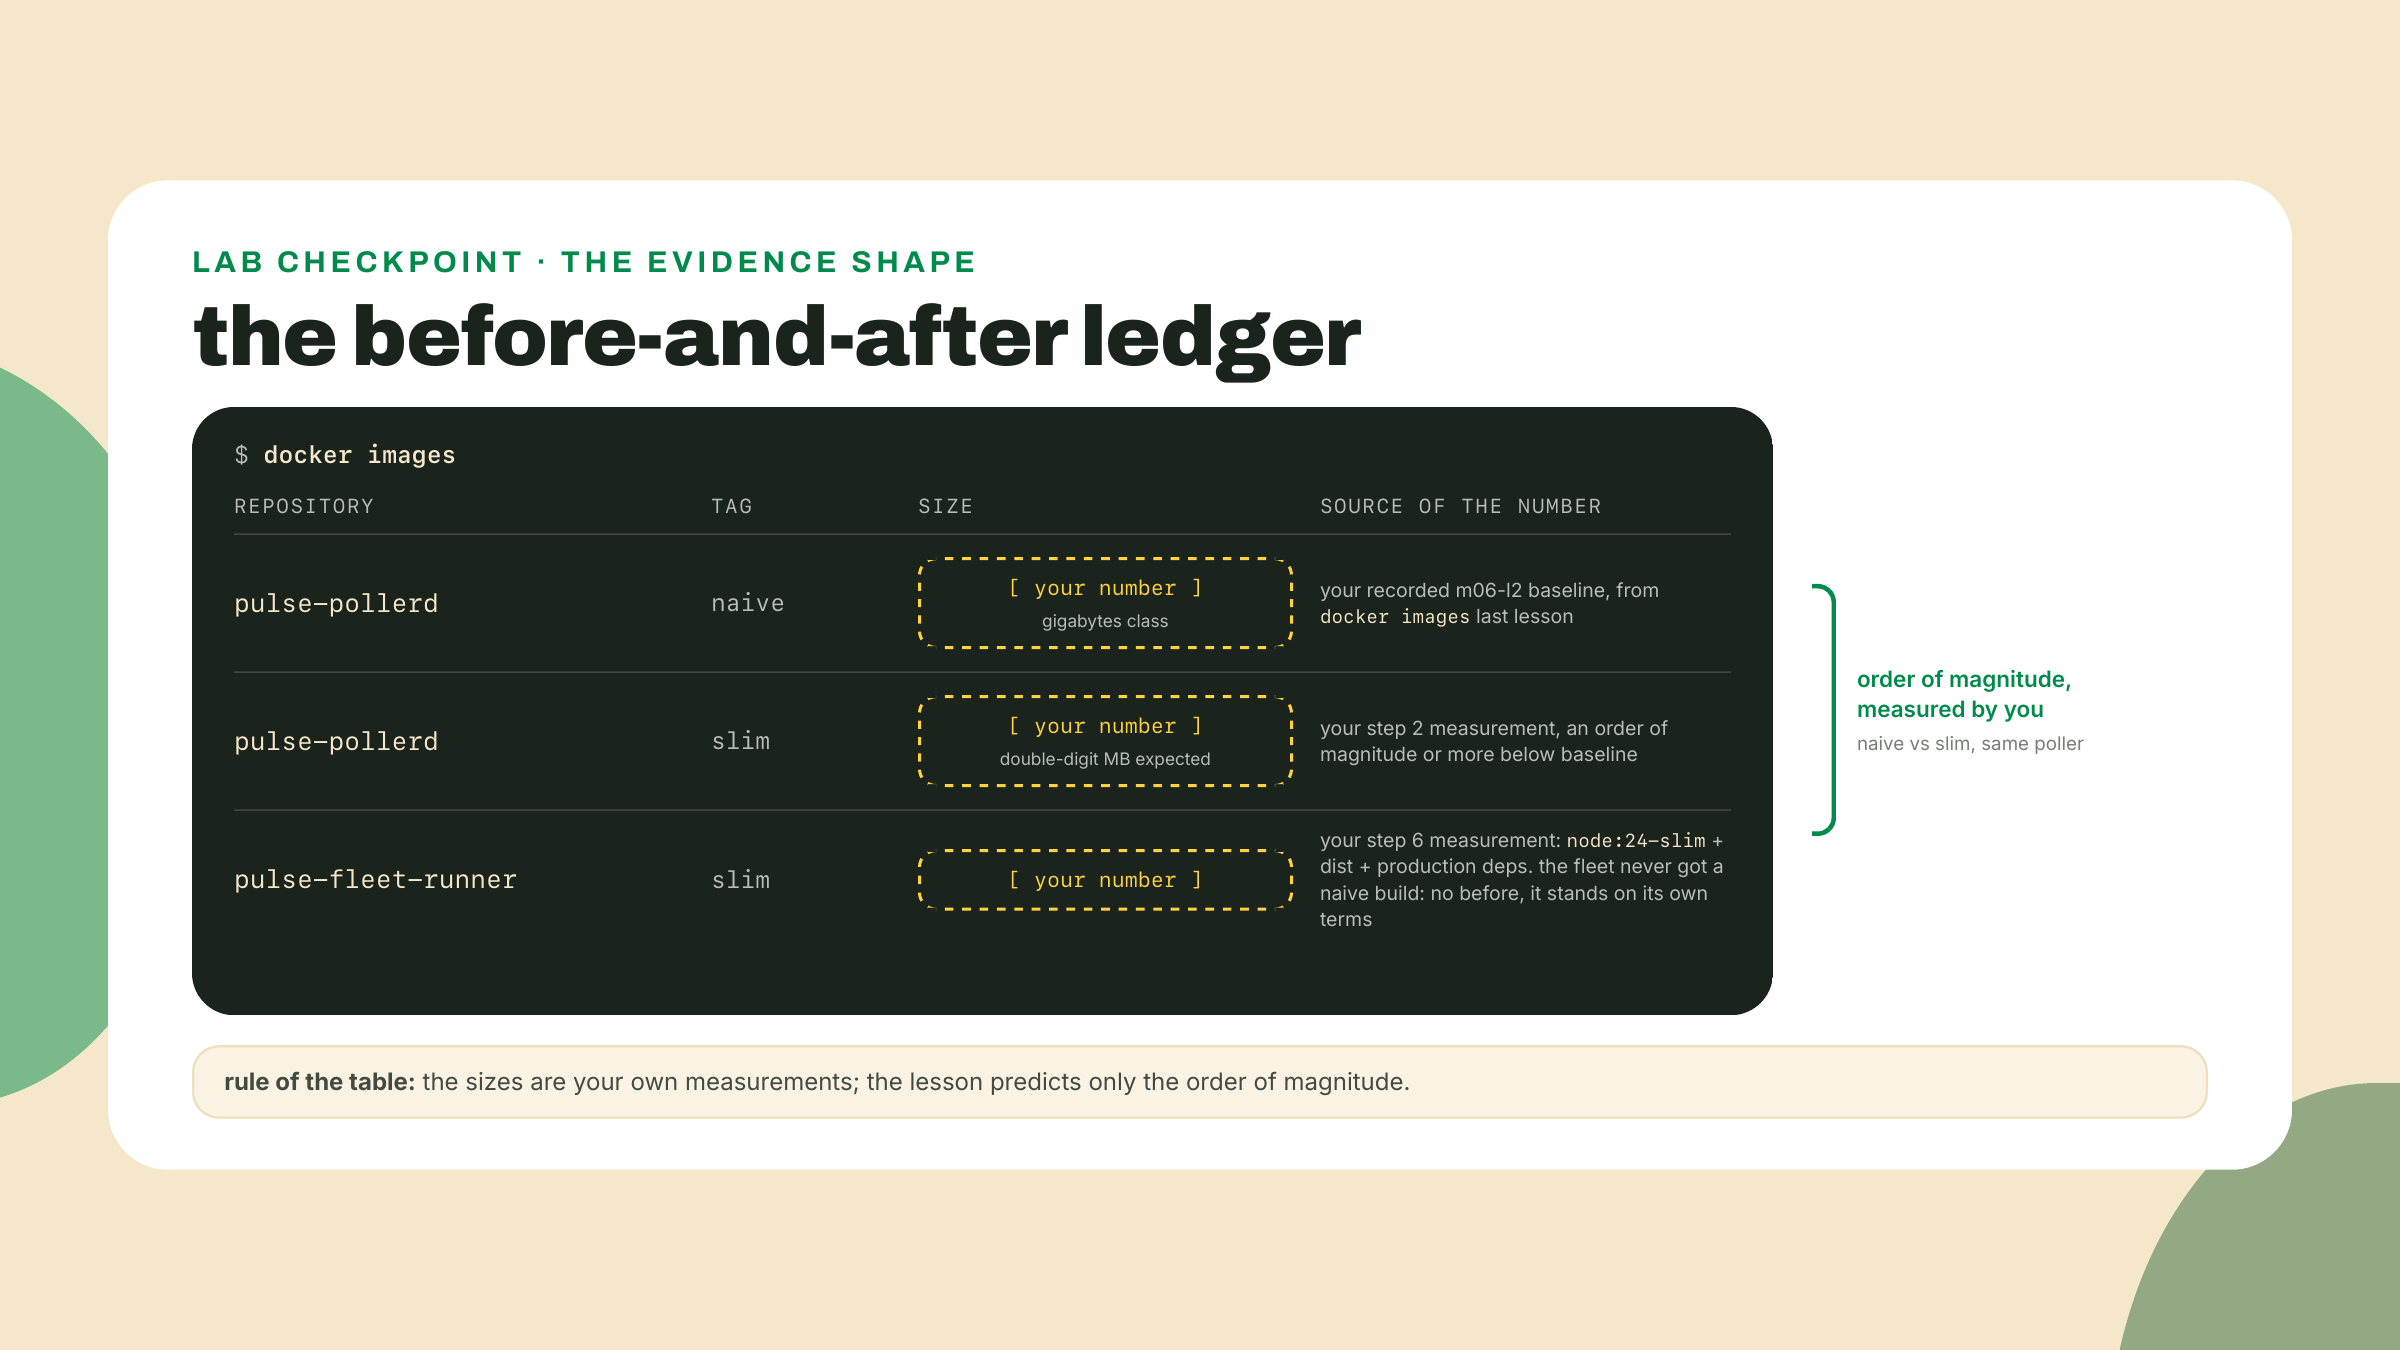
As duas tags slim ao lado da sua baseline ingênua, ordem de magnitude na tela, nos seus próprios números. Essa tabela mais o trecho de log de duas varreduras são o ônus da prova inteiro da lição.
Vá mais fundo (os 20%). builds multi-stage, COPY --from e cache de camadas são os 80% que funcionam do sistema de build; o maquinário por baixo é o BuildKit, o builder que é o default do Docker há anos (os próprios docs do Docker nem declaram mais uma versão-desde). Esta lição de propósito não imprime a versão atual do BuildKit, e a razão é instrutiva: o dígito checado em 2026-09-02, v0.32.2, foi superado pela v0.33.0 na mesma tarde. Nada aqui depende de nenhuma das duas, e um número de versão em prosa do qual nada depende é uma decoração com prazo de validade. Leia ele em github.com/moby/buildkit/releases no dia em que você precisar. A documentação dele em https://docs.docker.com/build/buildkit/ (verificada ao vivo em 2026-09-02) é o bookmark: cache mounts, secrets que nunca tocam uma camada, builds multi-plataforma, frontends customizados. Nada nesta lição ou na próxima depende do material dos bookmarks; quando uma necessidade de build crescer além do que você aprendeu hoje, essa página é onde a resposta mora.
Solo, terminando a cerca que o passo 6 começou: o .dockerignore de duas linhas desbloqueou o build, mas o contexto ainda arrasta todo o resto do repo. Complete o arquivo e prove com números, não com vibe. Cronometre o estado atual frio (time docker build --no-cache -f Dockerfile.fleet -t pulse-fleet-runner:slim .) e anote o tamanho de transferring context. Depois cerque o resto do peso morto, .git/, coverage/, todo dist/, mantendo as duas entradas do passo 6 no topo, e rode as duas medições de novo. Aceitação: a transferência de contexto despenca para a casa dos kilobytes (a minha mediu 9.89 kB; megabytes de um dígito só passam se você mantiver algo volumoso de propósito), o build frio fica mensuravelmente mais rápido, e a imagem ainda constrói e roda o loop de intervalo dela. Registre qual entrada fez o trabalho pesado: o pulse-rs/target/ sozinho carregava uns 1.5 dos 1.8 gigabytes originais, por que uma lista pronta de node_modules, dist/, .git/ teria deixado este contexto essencialmente sem corte, e por que você mede em vez de copiar listas. Uma sutileza que vale descobrir: o build compila dentro do contêiner a partir de um install limpo, então nada no node_modules foi algum dia uma entrada de contexto. Se ignorar alguma coisa quebra o build, ela era uma entrada de verdade e o erro nomeia ela; esse loop de feedback é bem mais amigável que o do .gitignore.
Trave no fazer, duas colagens. Primeiro, a tabela do docker images: a sua baseline ingênua registrada contra o pulse-pollerd:slim, com o corte de uma ordem de magnitude ou melhor visível, e o pulse-fleet-runner:slim ao lado nos termos próprios dele (nunca existiu um build ingênuo da frota para comparar com ele). Segundo, um trecho de log mostrando o fleet-runner conteinerizado completando duas varreduras de intervalo e depois saindo limpo no docker stop, sem nenhum restart envolvido. Se você também pegou a camada do cook imprimindo CACHED num rebuild só de código no passo 3, você verificou pessoalmente a afirmação que esta lição atribuiu em vez de asseverar, que é o hábito que sobrevive a qualquer ferramenta específica.
O que você consegue fazer agora, concretamente: dividir qualquer Dockerfile em estágios de build e de runtime e prever o que é entregue só a partir das linhas COPY; ordenar camadas para que installs de dependências sobrevivam a edições de código, na mão em node e via cargo-chef em Rust; escolher uma base de runtime como um trade-off medido e dizer em voz alta o que o alpine custaria ao seu alocador e ao seu TLS; e transformar um script rodar-uma-vez em um serviço que respeita sinais, que é a diferença entre um programa que consegue viver em um contêiner e um que só inicia nele.
Se a etapa do pnpm deploy brigou com você, ou se os TODOs de fronteira de estágio levaram mais tentativas do que parecia justo, diga isso no feedback do curso com o texto do erro; o Dockerfile de node é o apoio mais novo desta lição e os relatos decidem se os TODOs estão calibrados certo.
Duas imagens enxutas que rodam em qualquer lugar. E também: duas imagens enxutas que existem em exatamente um laptop, e "qualquer lugar" começa com um registro do qual outras máquinas consigam dar pull. A próxima lição liga a estação localmente, um arquivo compose substituindo os seus dois comandos de run digitados à mão, e aí o único pipeline de CI do curso aprende a construir as duas imagens e dar push nelas para o GHCR, onde o SHIP #3 vira uma imagem que a máquina de um estranho consegue dar pull.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.