Carregando...

 BetaBeta
O m06-l3 cortou as duas imagens em uma ordem de magnitude: cargo-chef em 3 estágios sobre debian-slim para o poller, node slim multi-stage com pnpm fixado para o fleet-runner, que também ganhou o modo de serviço por intervalo. Então agora você é dono de duas imagens enxutas e, se for honesto, de duas abas de terminal fazendo babá delas com flags de docker run digitadas à mão. Pior: essas imagens existem em exatamente uma máquina na Terra, a sua. O CI não consegue dar pull no que só você tem. Nem o futuro módulo que reentrega este poller com sondas de blockchain. Hoje fecha as duas lacunas, e a segunda é o SHIP #3: um arquivo compose substitui a babá de abas, e o único pipeline de Actions do curso aprende a dar push nas duas imagens para o ghcr.io, onde qualquer máquina com um docker daemon consegue dar pull nelas. Como o trabalho se divide: o arquivo compose e o job de CI são problemas de completion com TODOs estreitos, e o challenge de prefixo-de-log-mais-profile no fim é inteiramente seu. A cerimônia de plataforma continua sendo a minoria da contagem de palavras de propósito; a ideia do meio, onde o deploy de fato começa, é o centro do ensino.
Nenhuma instalação nova hoje, para a maioria de vocês: Docker Desktop e OrbStack já trazem o Compose como plugin do próprio CLI docker. A exceção é o caminho do colima do m06-l2, cujo brew install colima docker te deu um CLI docker pelado, sem plugin de compose; feche a lacuna com brew install docker-compose, depois ensine ao CLI onde o Homebrew põe plugins adicionando "cliPluginsExtraDirs": ["/opt/homebrew/lib/docker/cli-plugins"] ao ~/.docker/config.json (a ligação documentada do colima). Todo mundo confirma do mesmo jeito: docker compose version deve imprimir uma string de versão, não um command-not-found. Na raiz do repo da sua estação, ao lado do pnpm-workspace.yaml e do pulse-rs/, crie o compose.yaml:
services:
  pollerd:
    build:
      context: ./pulse-rs
    image: pulse-pollerd:local
    ports:
      # TODO 1: publish the poller's port. host:container, and the
      # container side is whatever POLLER_PORT says below.
      - "????:????"
    environment:
      POLLER_PORT: "8080"

  fleet-runner:
    build:
      context: .
      dockerfile: Dockerfile.fleet
    image: pulse-fleet-runner:local
    environment:
      # TODO 2: the runner's sweep interval, in seconds. Pick a value
      # you can watch without falling asleep. 60 is honest.
      FLEET_INTERVAL: "????"
    depends_on:
      - pollerd
Dois TODOs, ambos valores únicos que você já conhece: o mapeamento de portas é o mesmo 8080:8080 que você vem digitando com -p desde o m06-l2, e o intervalo é o que você passou para --interval na lição passada. Preencha os dois, depois:
docker compose up
Olhe o que um comando só acabou de fazer. Ele construiu as duas imagens a partir dos Dockerfiles delas (a do poller em pulse-rs/Dockerfile, onde o m06-l2 a colocou, a da frota na raiz do repo como Dockerfile.fleet porque o contexto de build dela precisa do workspace pnpm inteiro), criou uma rede privada para elas, subiu o pollerd primeiro porque o runner declara depends_on, e agora transmite os logs dos dois serviços em um terminal só, cada linha prefixada com o serviço que a escreveu. De um segundo terminal, curl -s localhost:8080/status responde exatamente como respondia quando você digitava as flags de run à mão. Duas abas de babá, aposentadas por um arquivo YAML curto.
Enquanto o par roda, faça o inventário de dez segundos naquele segundo terminal:
docker compose ps
Uma linha por serviço: nome, a imagem que ele roda, o estado dele e, para o poller, o mapeamento de portas na mesma forma host:container que o -p te ensinou. Essa é a colagem que o Checkpoint pede, e é onde eu olho primeiro sempre que uma stack composta se comporta mal, pela mesma razão que o docker ps era a primeira parada no m06-l2: estado e portas respondem metade de todos os relatos de "está quebrado" antes de qualquer log ser lido.
Por que dois serviços, então? Você poderia construir uma imagem gorda só, que roda os dois programas, e pular o YAML inteiro. A resposta é a própria regra do m06-l3 voltando com juros: um contêiner, um processo em primeiro plano. O poller e o runner têm necessidades de restart diferentes, logs diferentes, cadências de atualização diferentes (você vai reconstruir a imagem TS muito mais vezes que a de Rust), e enfiar os dois em uma caixa só solda tudo isso junto e te dá um problema de supervisor dentro do contêiner. O Compose existe exatamente para que manter processos separados pare de te custar abas de terminal.
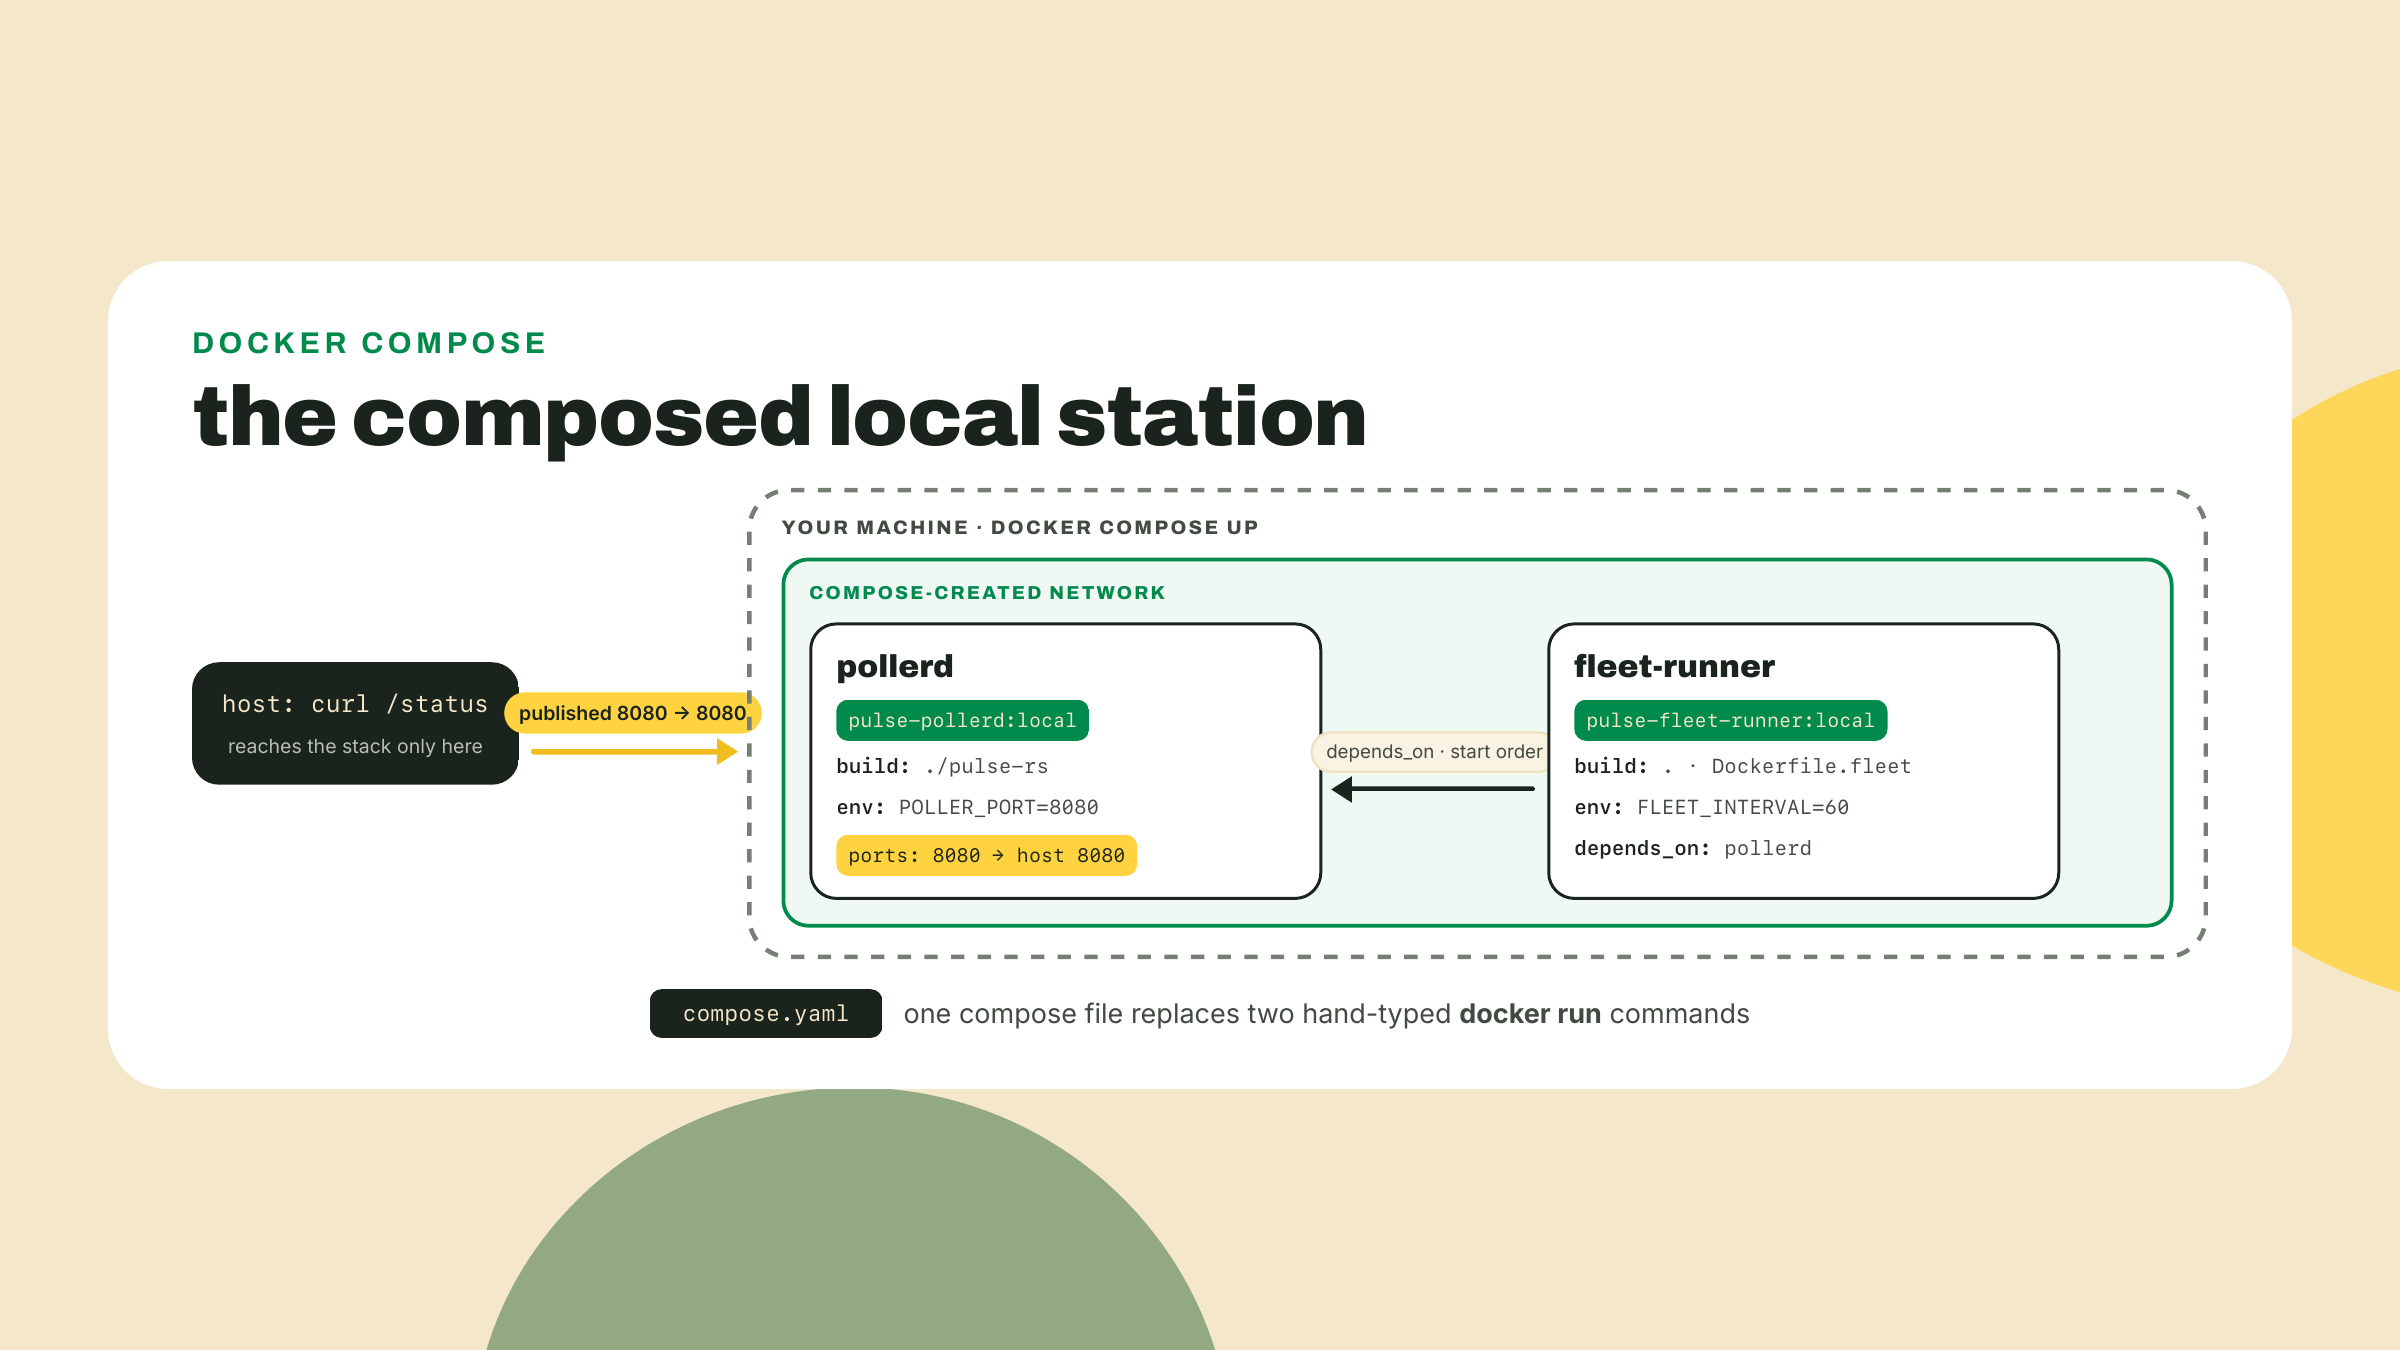
Agora a anatomia, campo por campo, porque você vai ler uma centena desses arquivos no mundo real e escrever uma dúzia. Um serviço é a unidade do compose: uma imagem, uma receita de contêiner, um nome. O nome é estrutural duas vezes. Ele prefixa o stream de log que você está assistindo, e ele se torna um hostname DNS naquela rede privada, então contêineres conseguem se alcançar por nome; adicione http://pollerd:8080/status como alvo na config da frota e sua frota TS sonda seu poller em Rust pela rede que o compose construiu, sem nenhum endereço IP colhido de lugar algum. O build aponta para um contexto e um Dockerfile opcional, e o image nomeia o que o build produz; marcamos essas com :local para que nunca colidam com as tags multi-stage que você mediu na lição passada. ports e environment são as suas flags -p e -e, escritas. O depends_on ordena a subida, e aqui está a honestidade que os docs te devem e que este curso vai cobrar: ele espera o contêiner do pollerd iniciar, não o poller estar pronto. Iniciar é um fato de processo; pronto é uma opinião da aplicação. Se a primeira varredura do runner disparar antes do socket do poller estar aberto, essa varredura falha e a próxima dá certo, que é exatamente o comportamento resiliente que sua frota aprendeu no m02: trate uma conexão recusada como uma sonda Down, não como um crash.
Quando um app genuinamente não tolera isso, um banco de dados que precisa aceitar conexões antes de uma migração rodar, digamos, o compose tem sim a forma mais forte: dê à dependência um healthcheck (um comando que o compose roda dentro do contêiner até ele dar certo) e escreva a dependência como depends_on com condition: service_healthy. Aí o compose espera pela prontidão como você a definiu, não pela mera subida. Nossa estação não precisa disso, o backoff da frota já absorve um poller que sobe devagar, então nomeamos a ferramenta e a deixamos na gaveta. Buscar maquinário de prontidão que um loop de retry já cobre é como arquivos compose crescem para duzentas linhas.
Uma checagem do tamanho de uma recapitulação enquanto você está aqui. A lição passada congelou a interface do runner de propósito: --interval no CLI, a variável de ambiente FLEET_INTERVAL como fallback dela, a flag ganhando quando as duas estão presentes, rodar-uma-vez quando nenhuma está definida. O arquivo compose acima fala a metade de env desse contrato, que é o idioma de contêiner pela mesma razão que o POLLER_PORT existe: uma imagem imutável, muitos deploys, o botão do lado de fora. Se o seu runner lê só a flag, volte e ligue o fallback do m06-l3 antes do up; a imagem em si nunca deve precisar de rebuild para mudar o cronograma dela.
Aqui está o loop diário inteiro em um cartão, rodado do diretório que contém o seu arquivo compose:
docker compose up -d           # start both services, detached
docker compose ps              # both services, their state, their published ports
docker compose logs -f         # tail the interleaved stream from both containers
docker compose up -d --build   # after you edit code; compose reuses images otherwise
docker compose down            # stop and remove the containers and the network
Os comandos do dia a dia, todos na forma com espaço: docker compose up -d para detached quando você já confiar no par, docker compose ps para ver os dois serviços com o estado e as portas deles, docker compose logs -f para dar tail no stream intercalado, docker compose up -d --build depois de editar código (o compose reaproveita imagens a menos que você mande reconstruir), e docker compose down para parar e remover os contêineres e a rede em um movimento. Esse último é o hábito de polidez que o --rm te deu, escalado para a stack inteira, e vale ser preciso sobre o que sobrevive a ele: o down remove os contêineres e a rede, enquanto as imagens ficam no seu cache local, então o próximo up é rápido. Nada que a sua estação escreveu dentro de um contêiner sobrevive ao down, e para nós isso é aceitável porque nada em nenhuma das duas caixas escreve nada que valha guardar: o estado do poller se reconstrói a partir de sondar, e a varredura conteinerizada é o src/fleet.ts, o sondador guiado por config que o m06-l3 teve o cuidado de desambiguar, que não escreve arquivo de resultados nenhum, ele imprime os contadores de resumo dele no stdout e sai. (O status.json pertence ao OUTRO fleet.ts, o script na raiz do pacote que a cron do m01-l3 invoca, e esse nunca entrou numa caixa.) Os canais que sobrevivem neste deploy são o stream de log (que o challenge deixa amigável a grep) e o durável status.json que a cron do Actions segue fazendo commit, que nunca deixou de ser a cópia canônica. No dia em que um serviço precisar de dados dentro do contêiner que sobrevivam ao contêiner dele, você vai conhecer volumes, que este curso deixa na mesma gaveta que as checagens de prontidão.
Uma confissão sobre a forma do comando: eu ainda digito docker-compose, com hífen e tudo, quando estou cansado, porque tutoriais de 2020 gravaram isso nas minhas mãos. Aquele binário com hífen é o Compose v1, morto há muito tempo. A coisa que você está usando é o Compose v2, o plugin na forma com espaço docker compose, e uma ruga de nomenclatura vale ser dita uma vez para que ninguém do seu time "corrija" você: a arquitetura se chama v2, enquanto as tags de release do projeto são v5.x, sendo a v5.5.0 a mais recente enquanto escrevo isto em 2026-09-02. Strings de versão derivam; a forma com espaço é o fato estável.
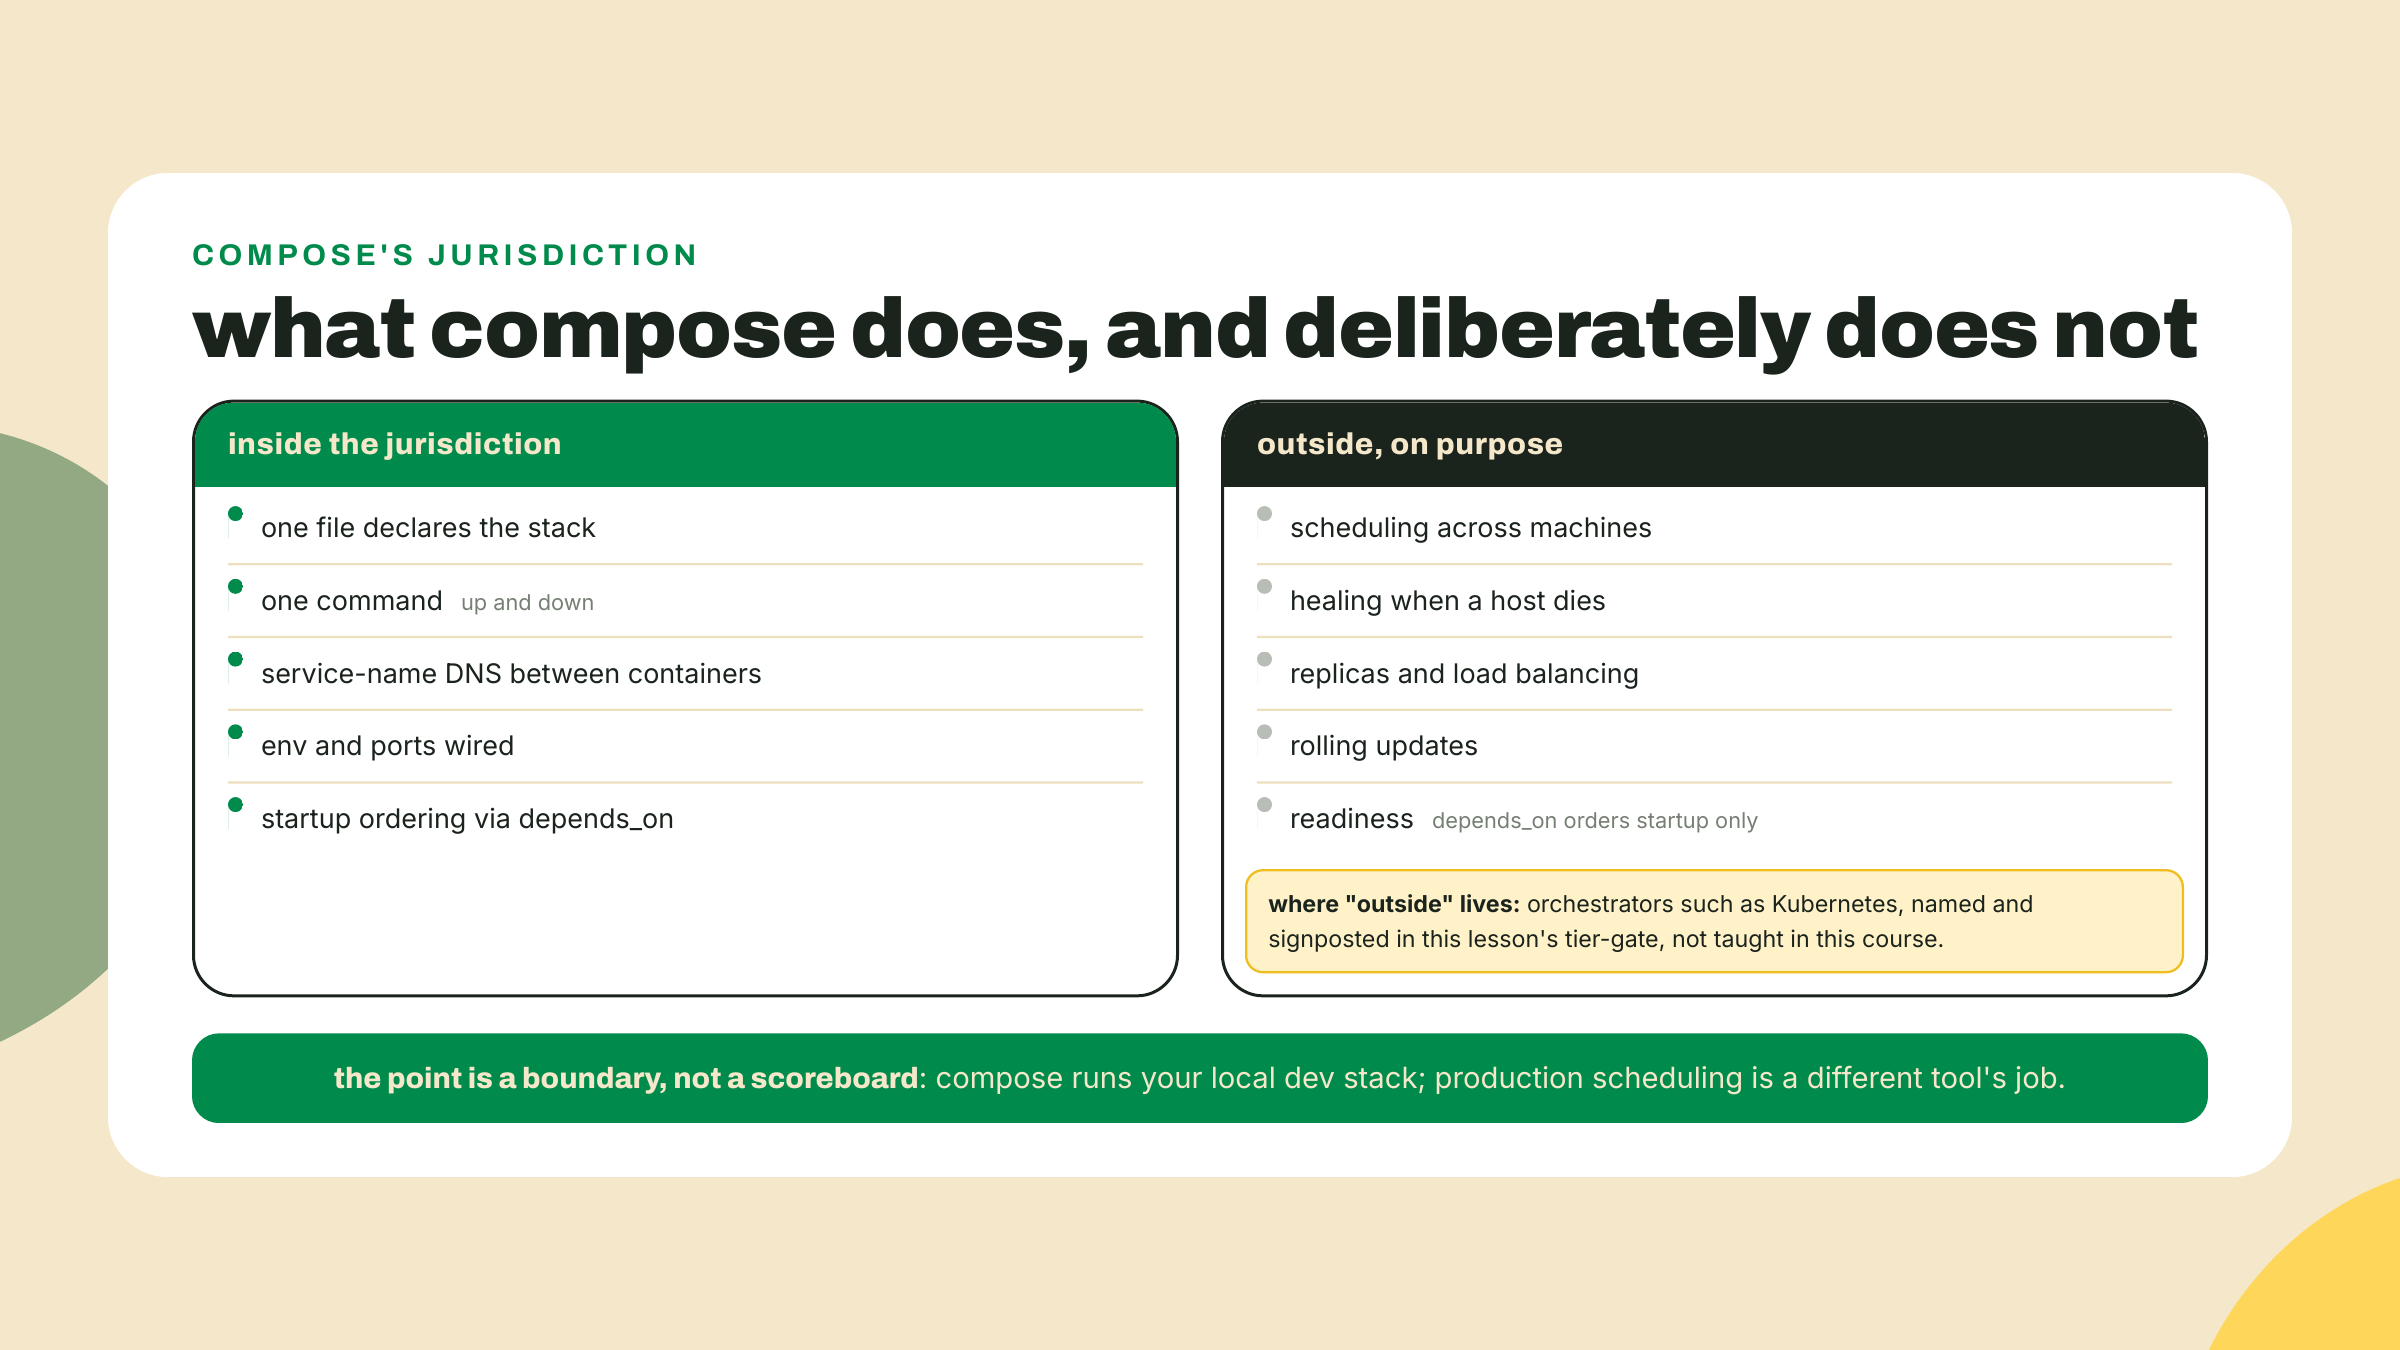
Diga em voz alta o que este arquivo é: um contrato de dev local. E diga o que ele não é: uma história de deploy. O compose não escalona nada além da sua única máquina. Se o poller cair às 3 da manhã, o compose pode reiniciar o contêiner se você pedir, mas se a máquina morrer, nada em lugar nenhum percebe. Ele não cura nada entre hosts, não balanceia nada, não faz rollout de nada gradualmente. No momento em que você quiser restart-em-falha entre máquinas, ou duas réplicas atrás de um endereço, ou uma atualização que troca versões sem downtime, você saiu da jurisdição do compose para orquestradores, e este curso deliberadamente não ensina esses; a trava do tier no fim desta lição os nomeia direito. O que o compose compra dentro da jurisdição dele é real e diário: a stack inteira em um arquivo, commitada no repo, então git clone mais docker compose up é o documento de onboarding inteiro para a próxima pessoa. Você vai ver arquivos compose de cosplay-de-produção no mundo real, um restart: always fazendo as vezes de operações. Leia-os como o que eles são: um time pequeno sendo honesto que uma máquina é tudo de que eles precisam por enquanto.
Agora a segunda metade, e a ideia para a qual este módulo vem caminhando. Suas imagens rodam em qualquer lugar onde viva um docker daemon, mas elas existem em exatamente um lugar. Um registro resolve a existência. Você já encontrou o formato duas vezes: o npm guarda pacotes, o crates.io guarda crates, um registro guarda imagens. Você até fez login em um, o Docker Hub, lá no m06-l2, para dar pull em imagens base com polidez. Hoje você dá push para um diferente: o GHCR, o GitHub Container Registry em ghcr.io, escolhido porque ele mora ao lado do repo, do pipeline e do token que você já tem, sem conta nova, sem relação de cobrança nova.
Uma referência de imagem lá se lê ghcr.io/<owner>/<name>:<tag>: host do registro, depois o seu namespace do GitHub, depois o nome e a tag da imagem. Uma quina afiada que vale conhecer antes do lab: nomes de imagem precisam ser minúsculos, então se o seu nome de usuário do GitHub tem letras maiúsculas, a tag que você dá push precisa dobrá-las para baixo; o job de CI do lab faz isso mecanicamente para que você nunca pense nisso de novo.
Você poderia dar push do seu laptop em vez de do CI? Mecanicamente, sim: crie um personal access token clássico com o escopo write:packages, faça docker login ghcr.io com ele, marque a tag, dê push. O lab não faz isso, e a razão vale ser assumida porque ela molda como times de verdade publicam. Um PAT de laptop é uma credencial de vida longa parada no seu chaveiro com acesso de escrita a todo pacote que é seu, e um push de laptop publica o que por acaso estava na sua working tree, testado ou não. O GITHUB_TOKEN do workflow é o oposto nos dois eixos: cunhado na hora para cada execução, morto minutos depois, escopado ao único repo pelas permissões que você vai escrever no YAML, e ele só consegue publicar um commit que acabou de sobreviver às suas travas. A costura do registro é exatamente onde você quer a disciplina de uma máquina em vez da memória de um humano. Então o canon do curso é push-só-por-CI, e a rota do PAT fica no seu bolso de trás para o dia em que você precisar dar push em um experimento pontual em algum lugar privado.
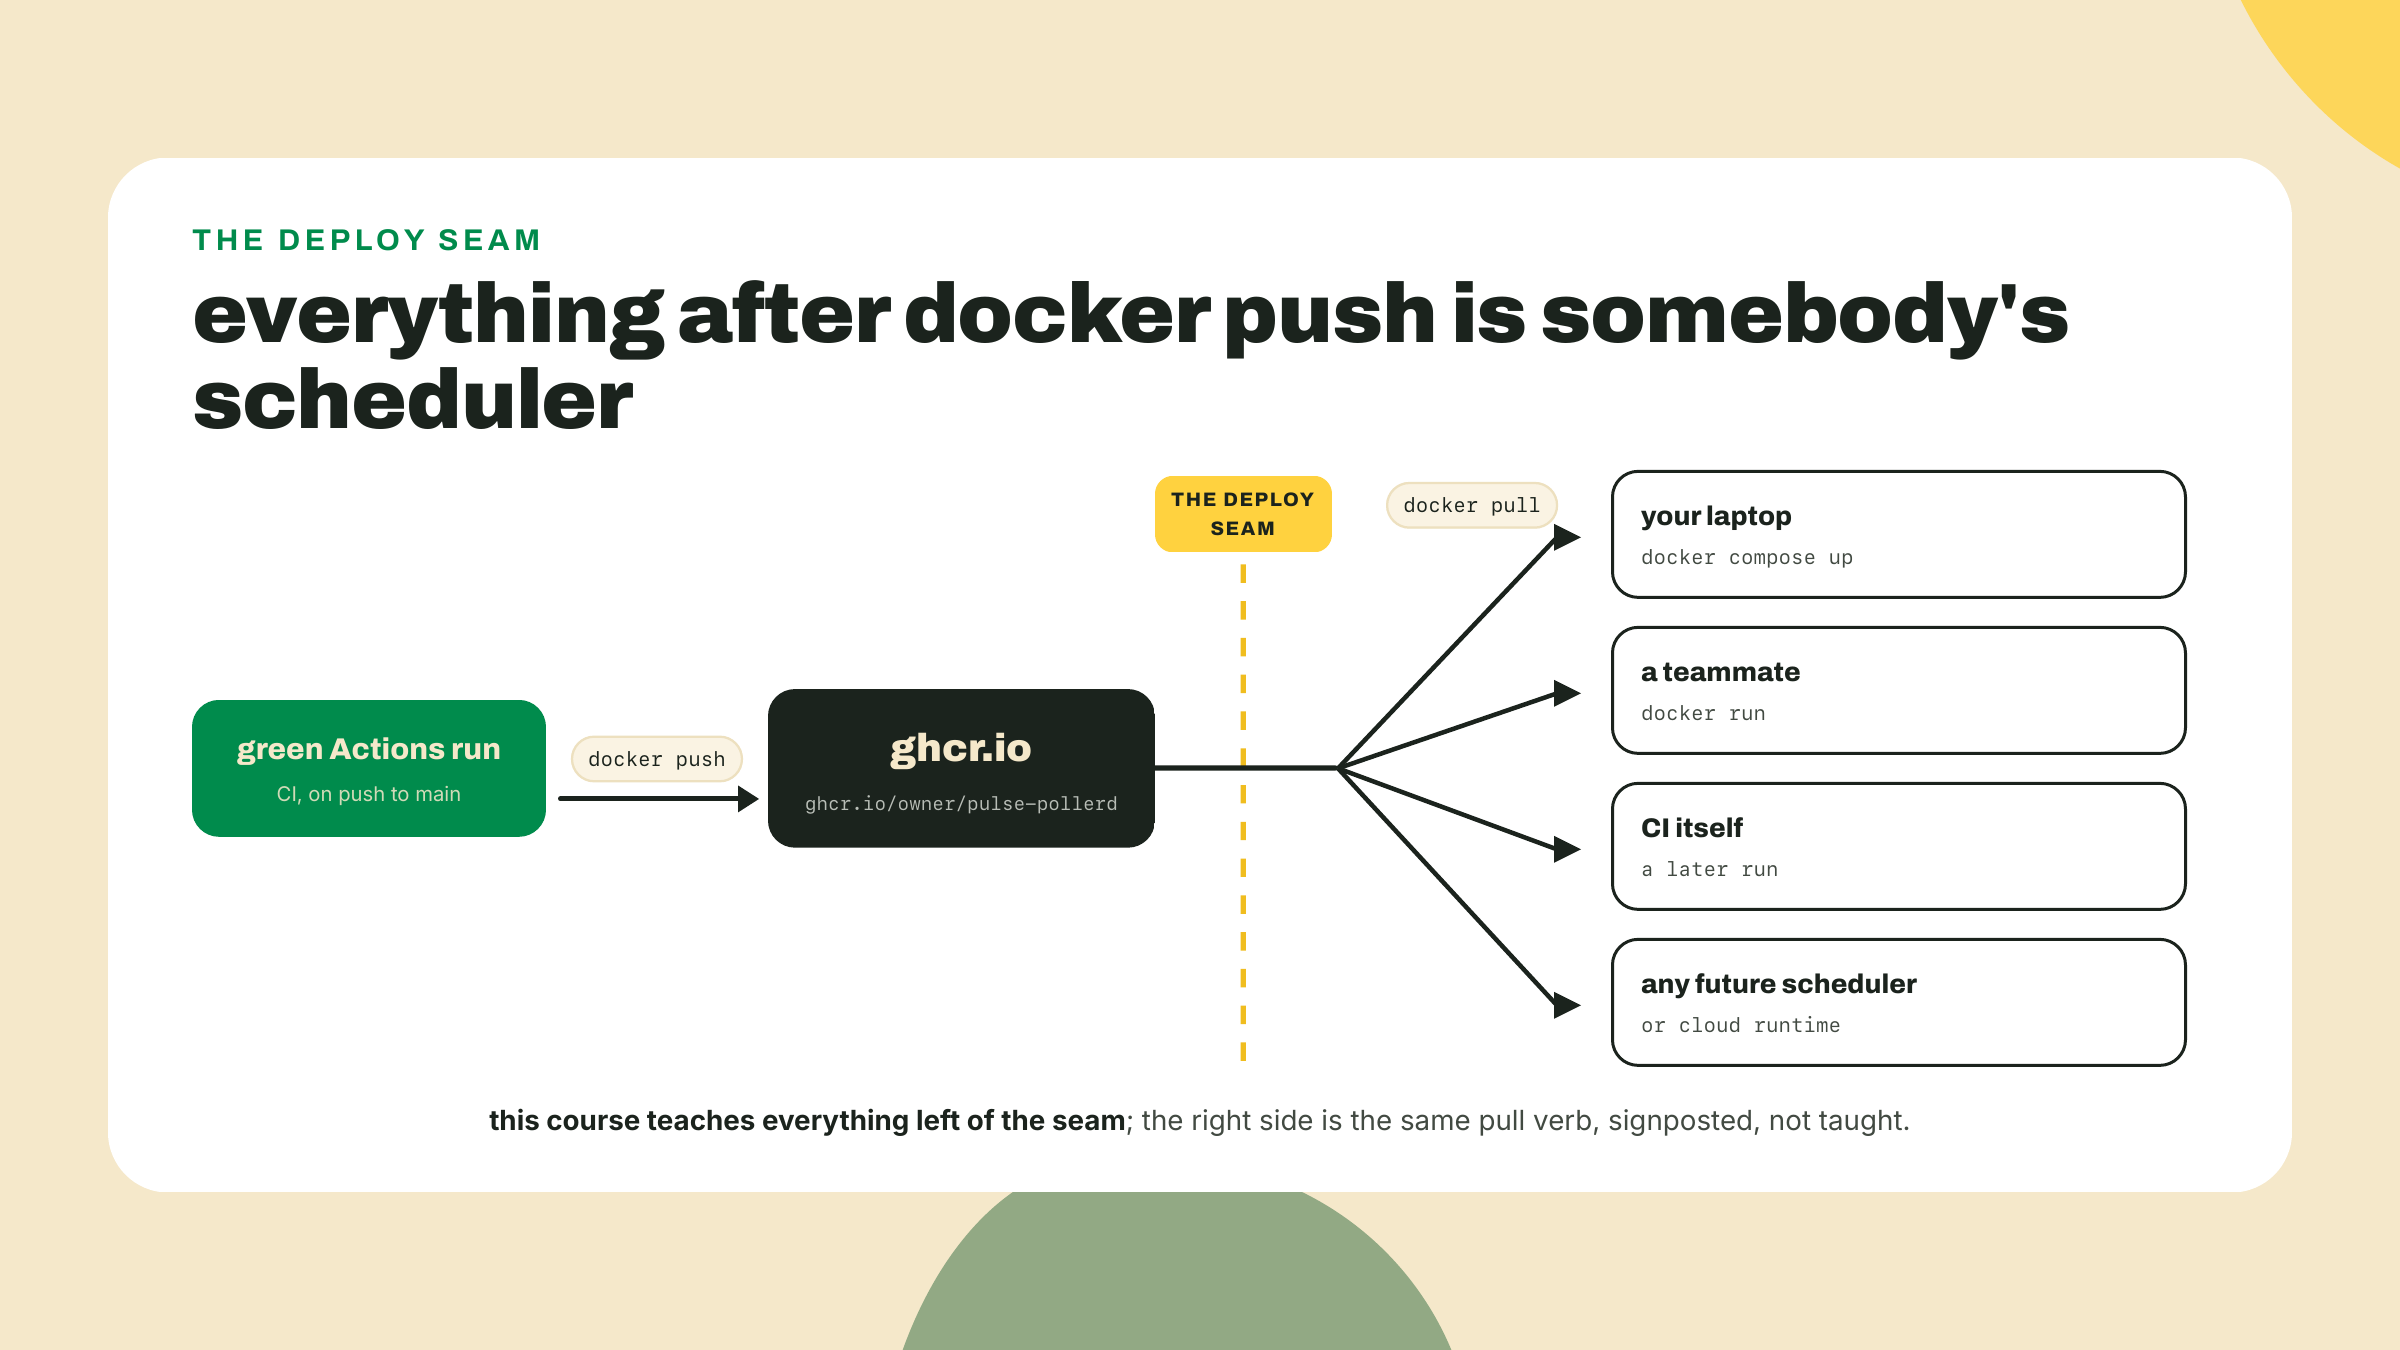
Aqui está a síntese, e é a frase com que este módulo termina. O registro é o deploy. Tudo depois do docker push é o escalonador de alguém: o seu laptop rodando docker compose up, o docker run de um colega de time, algum orquestrador futuro, um runtime de nuvem do qual você nunca ouviu falar. Todos começam com o mesmo verbo, pull, contra o mesmo endereço. O que quer dizer que a entrega que você está prestes a fazer é diferente em espécie da cron do SHIP #1 e da URL do painel do SHIP #2: aquelas entregaram comportamento; esta entrega um artefato que outras máquinas podem rodar. Uma nota de fronteira dita com clareza, para que a promessa fique honesta: o poller da estação continua rodando localmente, via compose ou docker run. Esta lição não dá ao poller uma URL pública, e nenhum tunneling ou self-hosting é ensinado aqui. A entrega é o próprio registro.
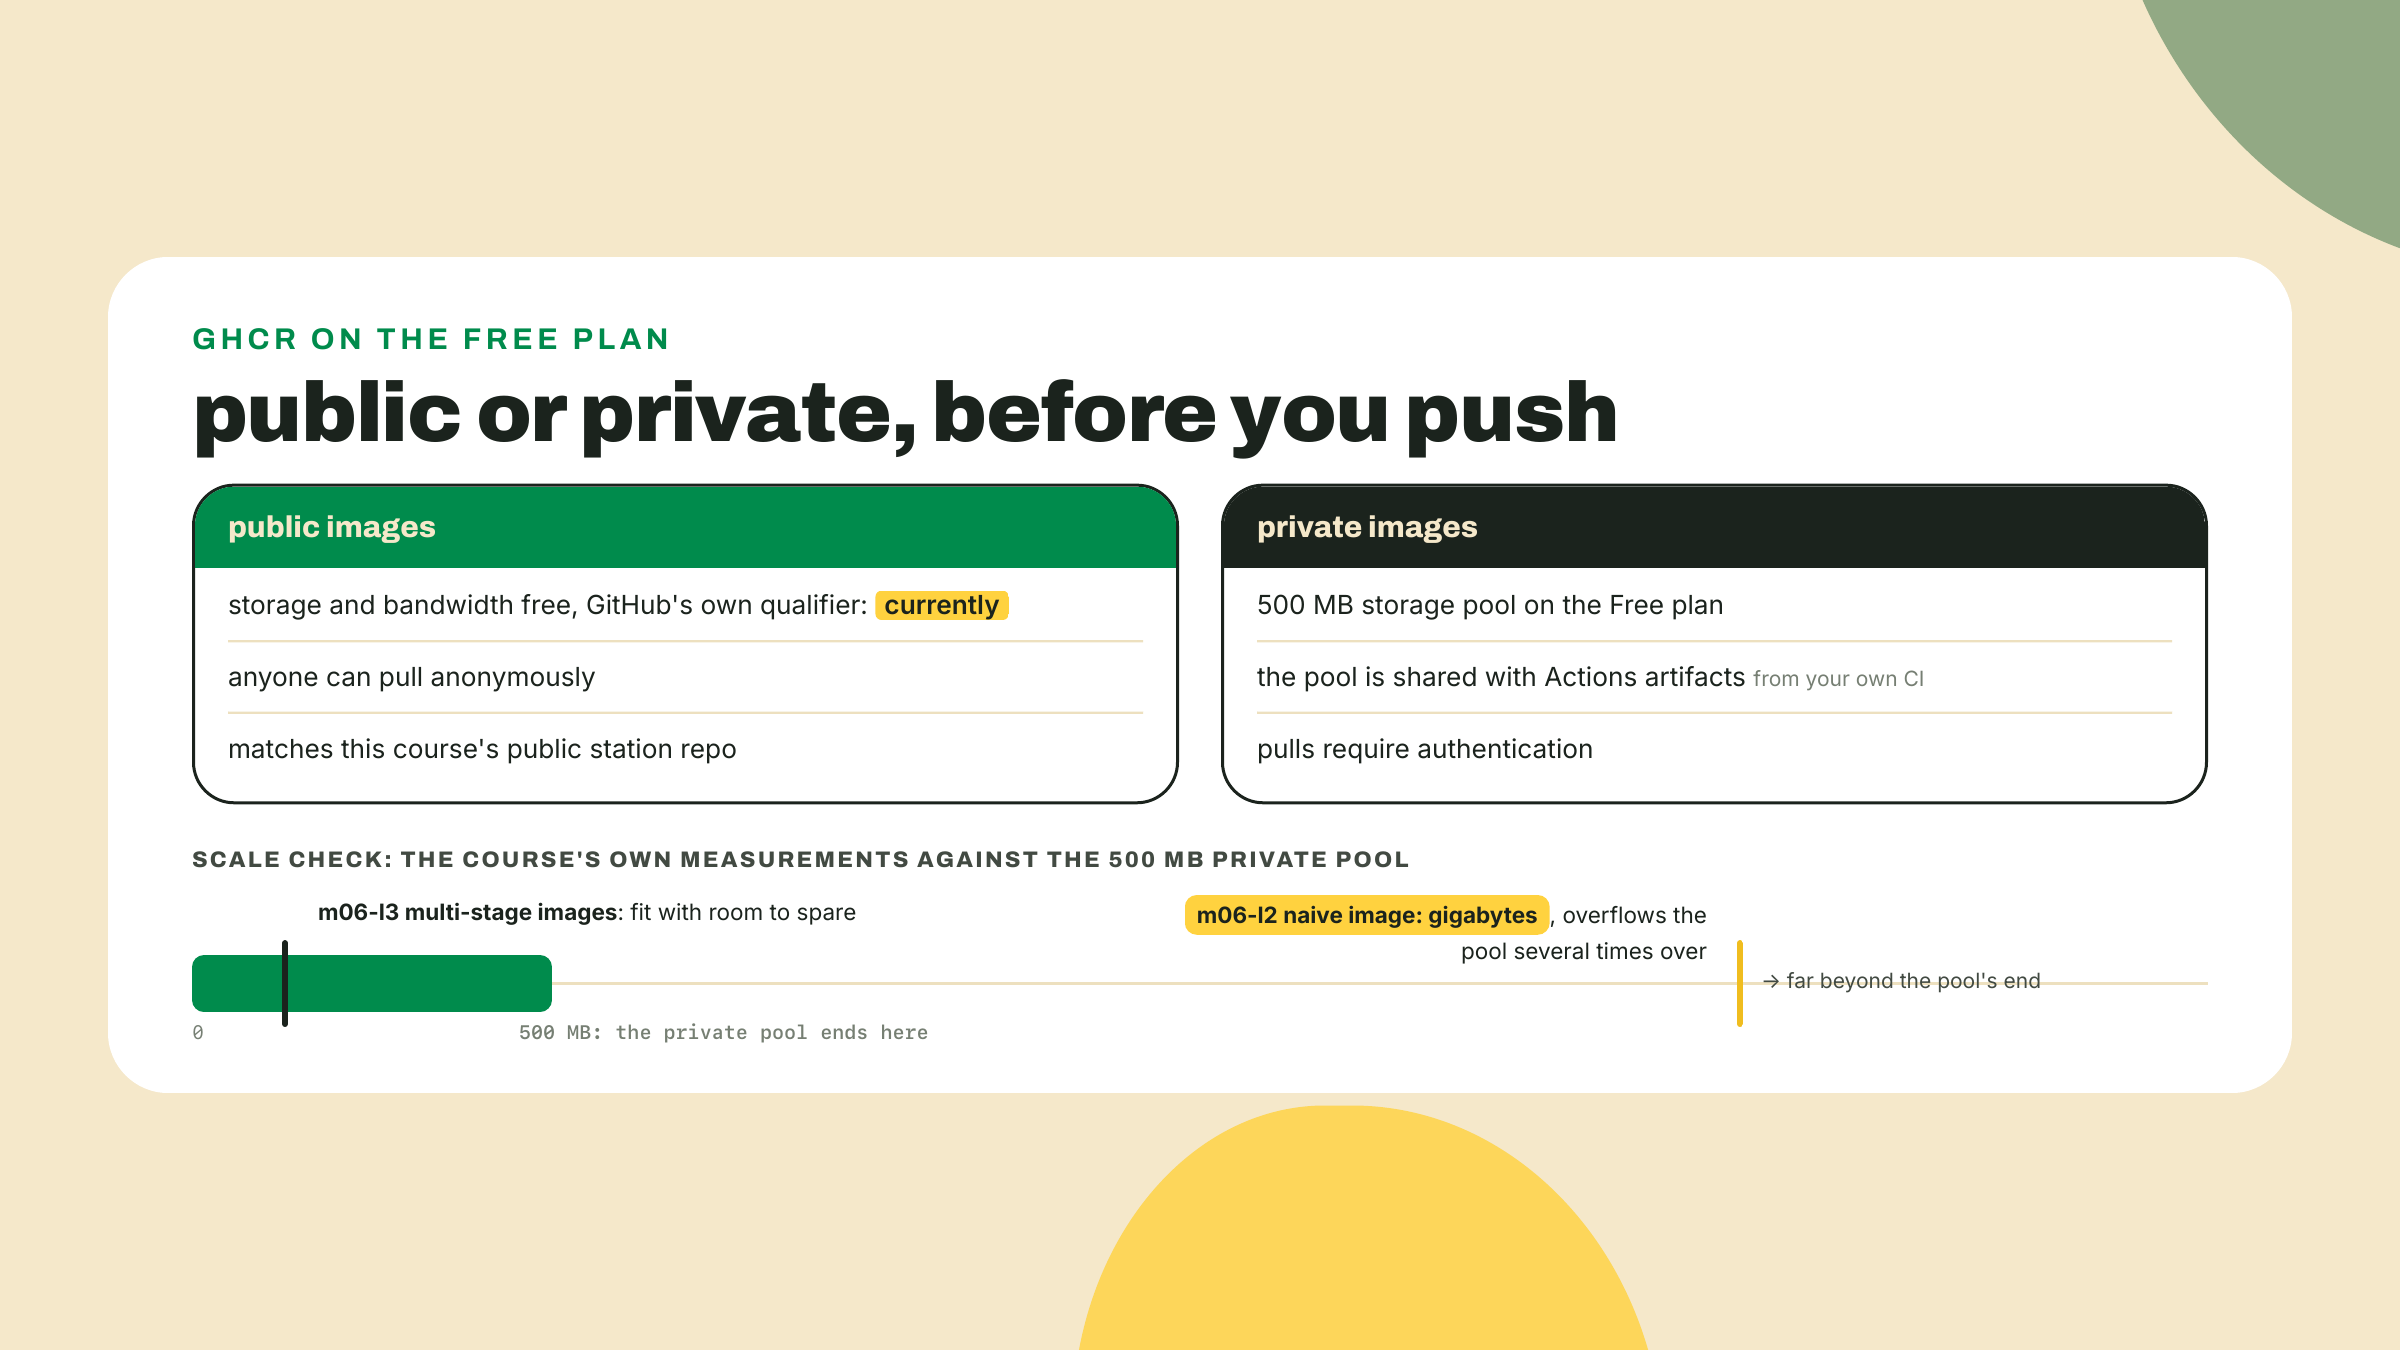
O parágrafo do dinheiro, franco e curto. Imagens de contêiner públicas no GHCR são gratuitas para armazenar e servir, e a própria página de cobrança do GitHub põe uma ressalva nisso com uma palavra, "currently", um advérbio de fornecedor que você deve ler como o tempo dos preços, não o clima. Imagens privadas, em vez disso, são cobradas contra um pool: o plano Free te dá 500 MB de armazenamento de pacotes privados e, a parte que morde, esse pool é compartilhado com os seus artefatos do Actions, então os uploads do seu próprio CI competem com as camadas das suas imagens. Rode o número contra o seu próprio histórico: a imagem ingênua que você mediu no m06-l2 pesava gigabytes, o que quer dizer que ela teria transbordado aquele pool privado inteiro várias vezes, sozinha, antes do seu primeiro artefato. Suas imagens multi-stage cabem confortavelmente. Isso é o trabalho da lição passada pagando aluguel. Uma distinção mantém o modelo mental em ordem quando você for ler a página de cobrança por conta própria: armazenamento é sobre os bytes que suas camadas ocupam em repouso, enquanto pulls gastam transferência, um medidor separado; manter uma imagem privada não fica mais barato porque ninguém baixa ela. Para a estação deste curso, cujo repo é público desde o m01-l3, imagens públicas são o default honesto e o gratuito.
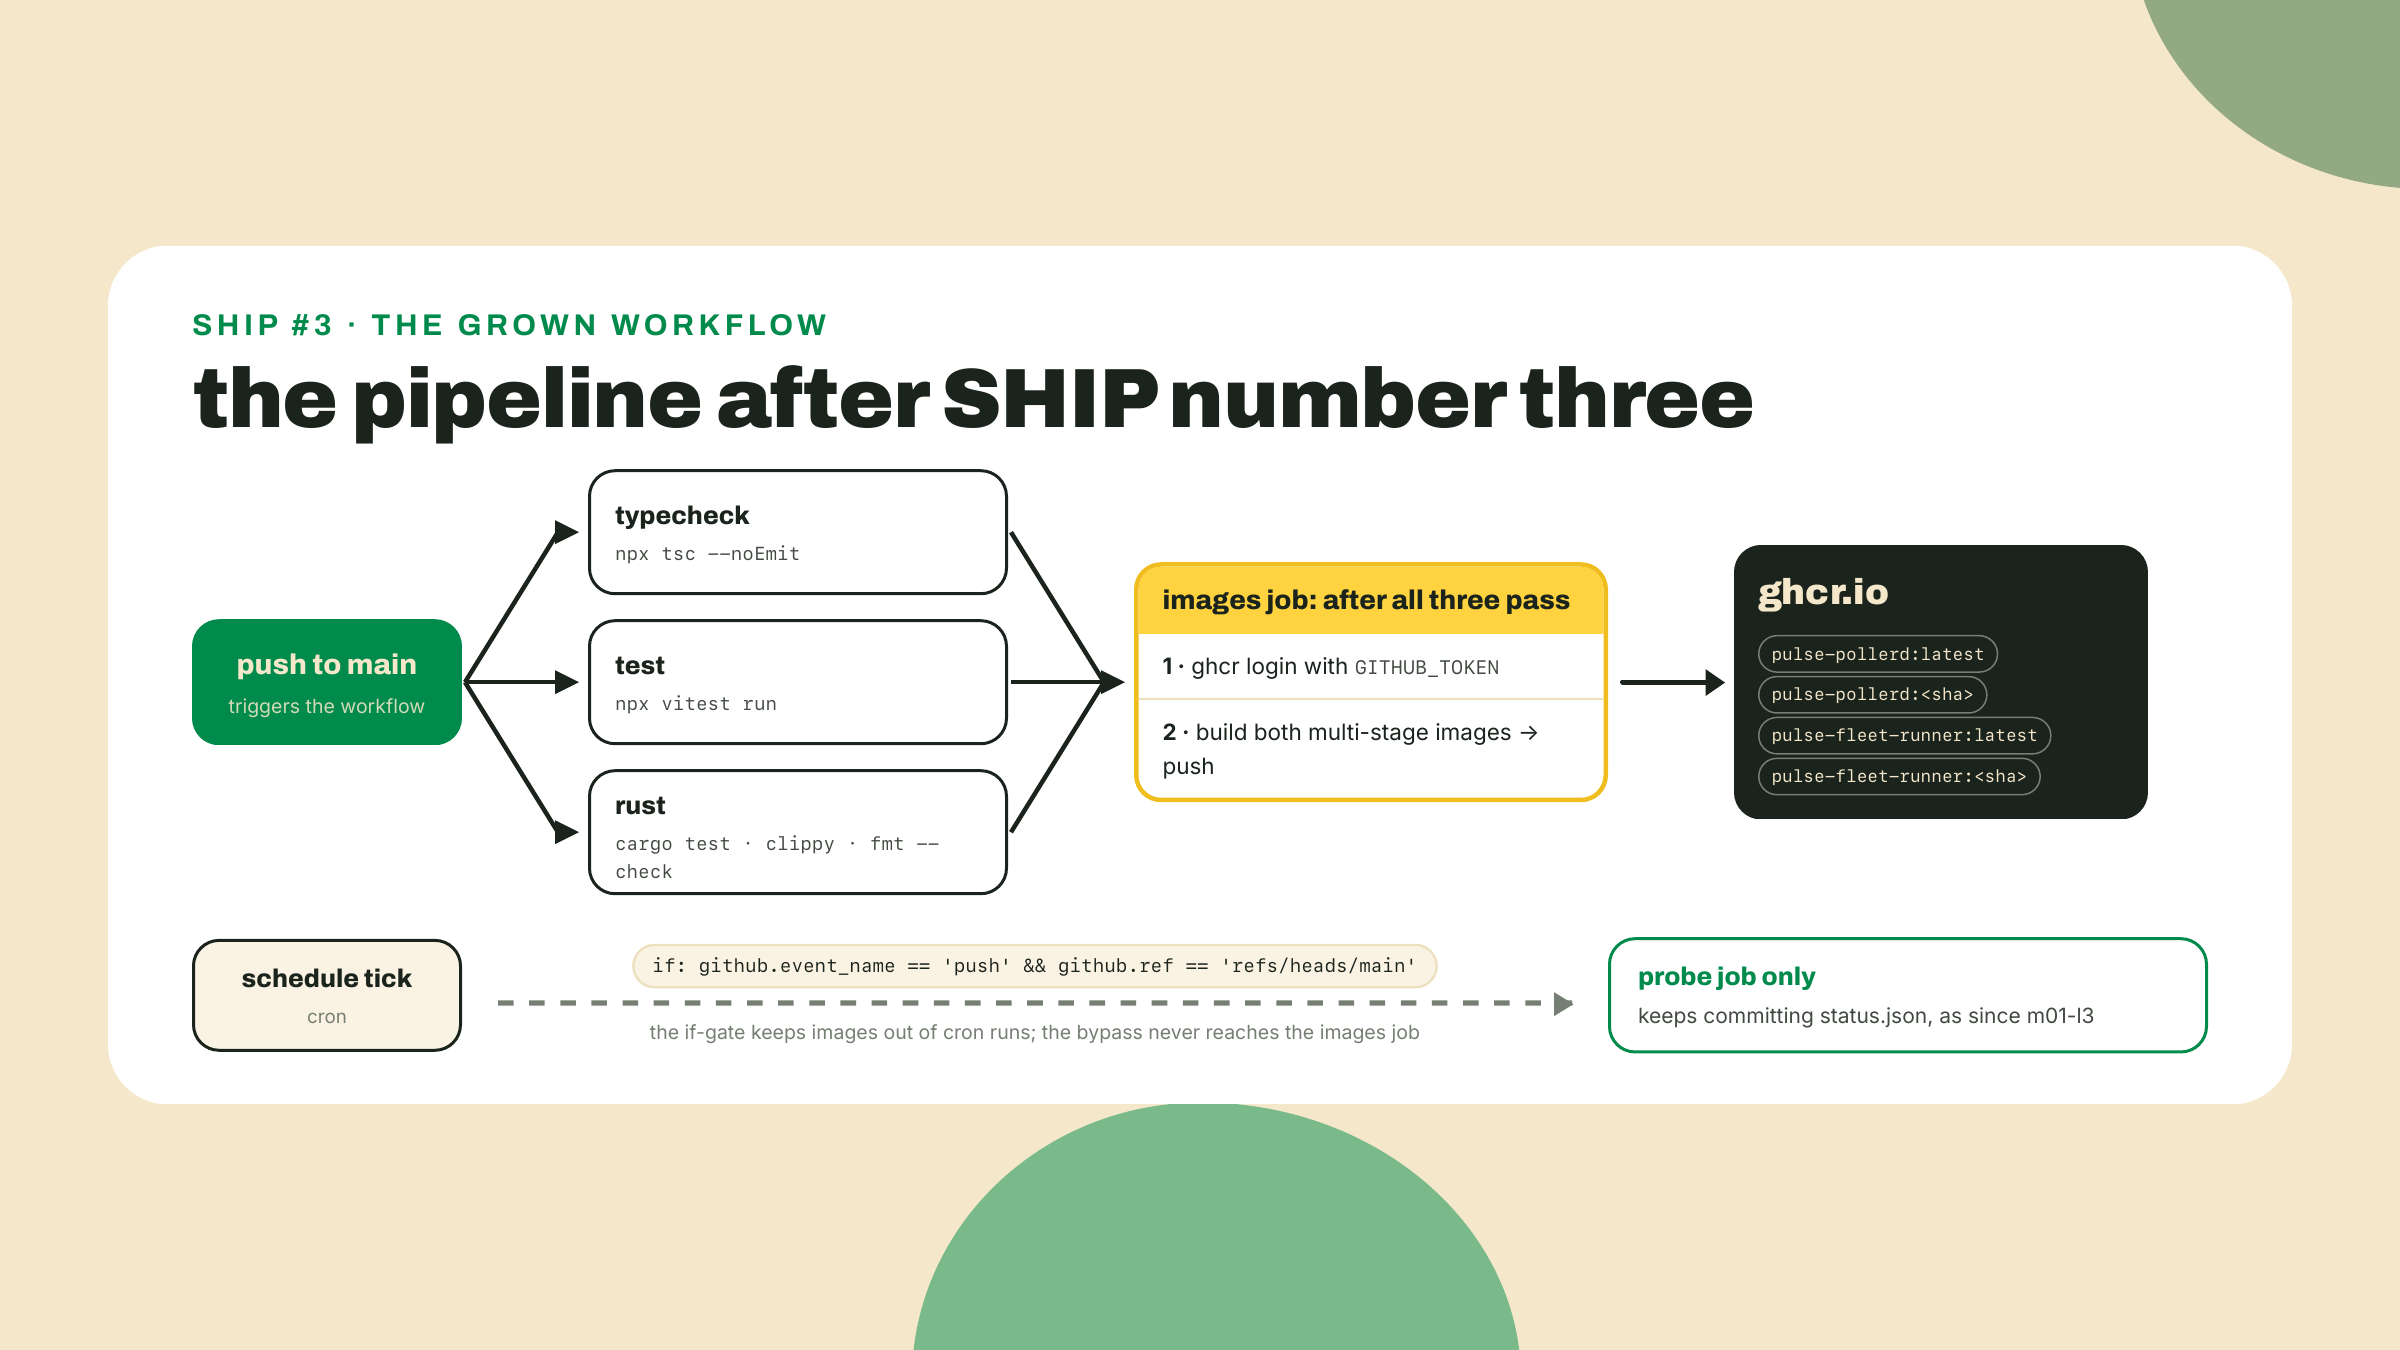
A reentrega. Mesmo repo, mesmo .github/workflows/pulse.yml que você vem fazendo crescer desde o m01-l3, já travando em vitest desde o m02-l4 e em cargo test, clippy e fmt desde o m04-l3. Ele ganha um job. O job está trabalhado abaixo, exceto o esquema de tags, que é o seu TODO; a virada de visibilidade e o pull de máquina limpa são seus para executar, porque executá-los é a lição.
Trave o job antes de escrevê-lo. Seu workflow dispara tanto em push quanto no agendamento do cron. O probe job deve continuar disparando 48 vezes por dia; um build de imagem não, porque nada nas imagens muda quando um agendamento bate. O job que você está prestes a adicionar, portanto, abre com um if que o roda só para pushes para a main. Leia a condição no YAML abaixo e diga as duas cláusulas para si mesmo antes de seguir: evento certo, branch certa.
Adicione o job images. Acrescente isto ao pulse.yml, no mesmo nível de indentação dos seus jobs existentes:
  images:
    if: github.event_name == 'push' && github.ref == 'refs/heads/main'
    needs: [typecheck, test, rust]
    runs-on: ubuntu-latest
    permissions:
      contents: read
      packages: write
    steps:
      - uses: actions/checkout@v7
      - name: log in to ghcr
        run: echo "${{ secrets.GITHUB_TOKEN }}" | docker login ghcr.io -u "${{ github.actor }}" --password-stdin
      - name: owner, lowercased
        run: echo "OWNER=$(echo '${{ github.repository_owner }}' | tr '[:upper:]' '[:lower:]')" >> "$GITHUB_ENV"
      - name: build and push pollerd
        run: |
          docker build -t "ghcr.io/$OWNER/pulse-pollerd:latest" pulse-rs
          docker push "ghcr.io/$OWNER/pulse-pollerd:latest"
          # TODO: also tag this same build with the commit SHA and push that tag too
      - name: build and push fleet-runner
        run: |
          docker build -f Dockerfile.fleet -t "ghcr.io/$OWNER/pulse-fleet-runner:latest" .
          docker push "ghcr.io/$OWNER/pulse-fleet-runner:latest"
          # TODO: same here, latest AND the commit SHA
Três glosas onde vivem as decisões interessantes. needs: [typecheck, test, rust] faz o registro ficar a jusante de cada trava que você construiu; uma imagem não pode fazer o ship a partir de um commit que os testes rejeitaram, que é o sentido inteiro de ter travas. O bloco permissions é o workflow declarando, no aberto, que o token dele pode escrever pacotes; você encontrou este bloco no m01-l3 quando contents: write deixou a sonda fazer commit do status.json, e a mesma recapitulação em meia frase cobre o token em si: pushes feitos com GITHUB_TOKEN não redisparam o workflow, então sem recursão. Esqueça packages: write e o step de push morre com um 403 que parece um problema de senha errada; não é, nenhum secret está faltando, o token simplesmente não recebeu o escopo, e agora você sabe ler aquele 403 como um problema de bloco de permissions para sempre. O step de minúsculas é a quina afiada de antes, lixada: o tr dobra o seu nome de usuário para que a referência de imagem seja sempre legal.
Preencha o TODO da tag. Duas tags por imagem, latest e o SHA do commit, com push separado. Por que as duas: latest é um ponteiro mutável de conveniência, ok para humanos; a tag de SHA é um recibo imutável que diz exatamente qual commit produziu esta imagem, e é dela que você faria deploy se algum dia precisasse fazer rollback. Dentro do job, o SHA é ${{ github.sha }}. A forma para o poller, sua para espelhar no runner:
docker build -t "ghcr.io/$OWNER/pulse-pollerd:latest" -t "ghcr.io/$OWNER/pulse-pollerd:${{ github.sha }}" pulse-rs
docker push "ghcr.io/$OWNER/pulse-pollerd:latest"
docker push "ghcr.io/$OWNER/pulse-pollerd:${{ github.sha }}"
Dê push e observe. Um eco do m06-l2 antes de você fazer: se o pulse-rs/pulse.config.json já foi um symlink na sua máquina, confirme que a substituição por arquivo real está COMMITADA, não só parada na sua working tree; o runner constrói a partir de um checkout novo, onde um symlink rastreado apontando para fora do contexto de build fica pendurado e a imagem do poller morre na subida, duas lições a jusante da causa dela. Depois commite, dê push, abra a aba Actions. O images job espera pelas suas três travas, depois constrói as duas imagens multi-stage no runner e dá push em quatro tags. Execução verde, nenhum erro, os dois pushes logados. Salve a URL da execução; o Checkpoint quer ela.
Enquanto ela roda, leia o log de build com os olhos da lição passada e note algo faltando: as linhas CACHED. Seu laptop reconstrói o poller em segundos porque a camada de dependências do cargo-chef está no seu cache local; o runner é uma máquina nova a cada execução, então ele compila o mundo frio, toda vez, e o images job vai ser o mais lento do seu pipeline por uma margem larga. Isso não é um bug no seu Dockerfile, é o preço de runners efêmeros, e o conserto (persistir o cache de build entre execuções de CI) é real, documentado e deliberadamente não ensinado aqui; arquive-o ao lado de orquestração como algo que você vai buscar quando os builds frios começarem a doer. A trava de if do passo 1 é o que mantém esse custo limitado: você paga por merge, nunca por tique de cron.
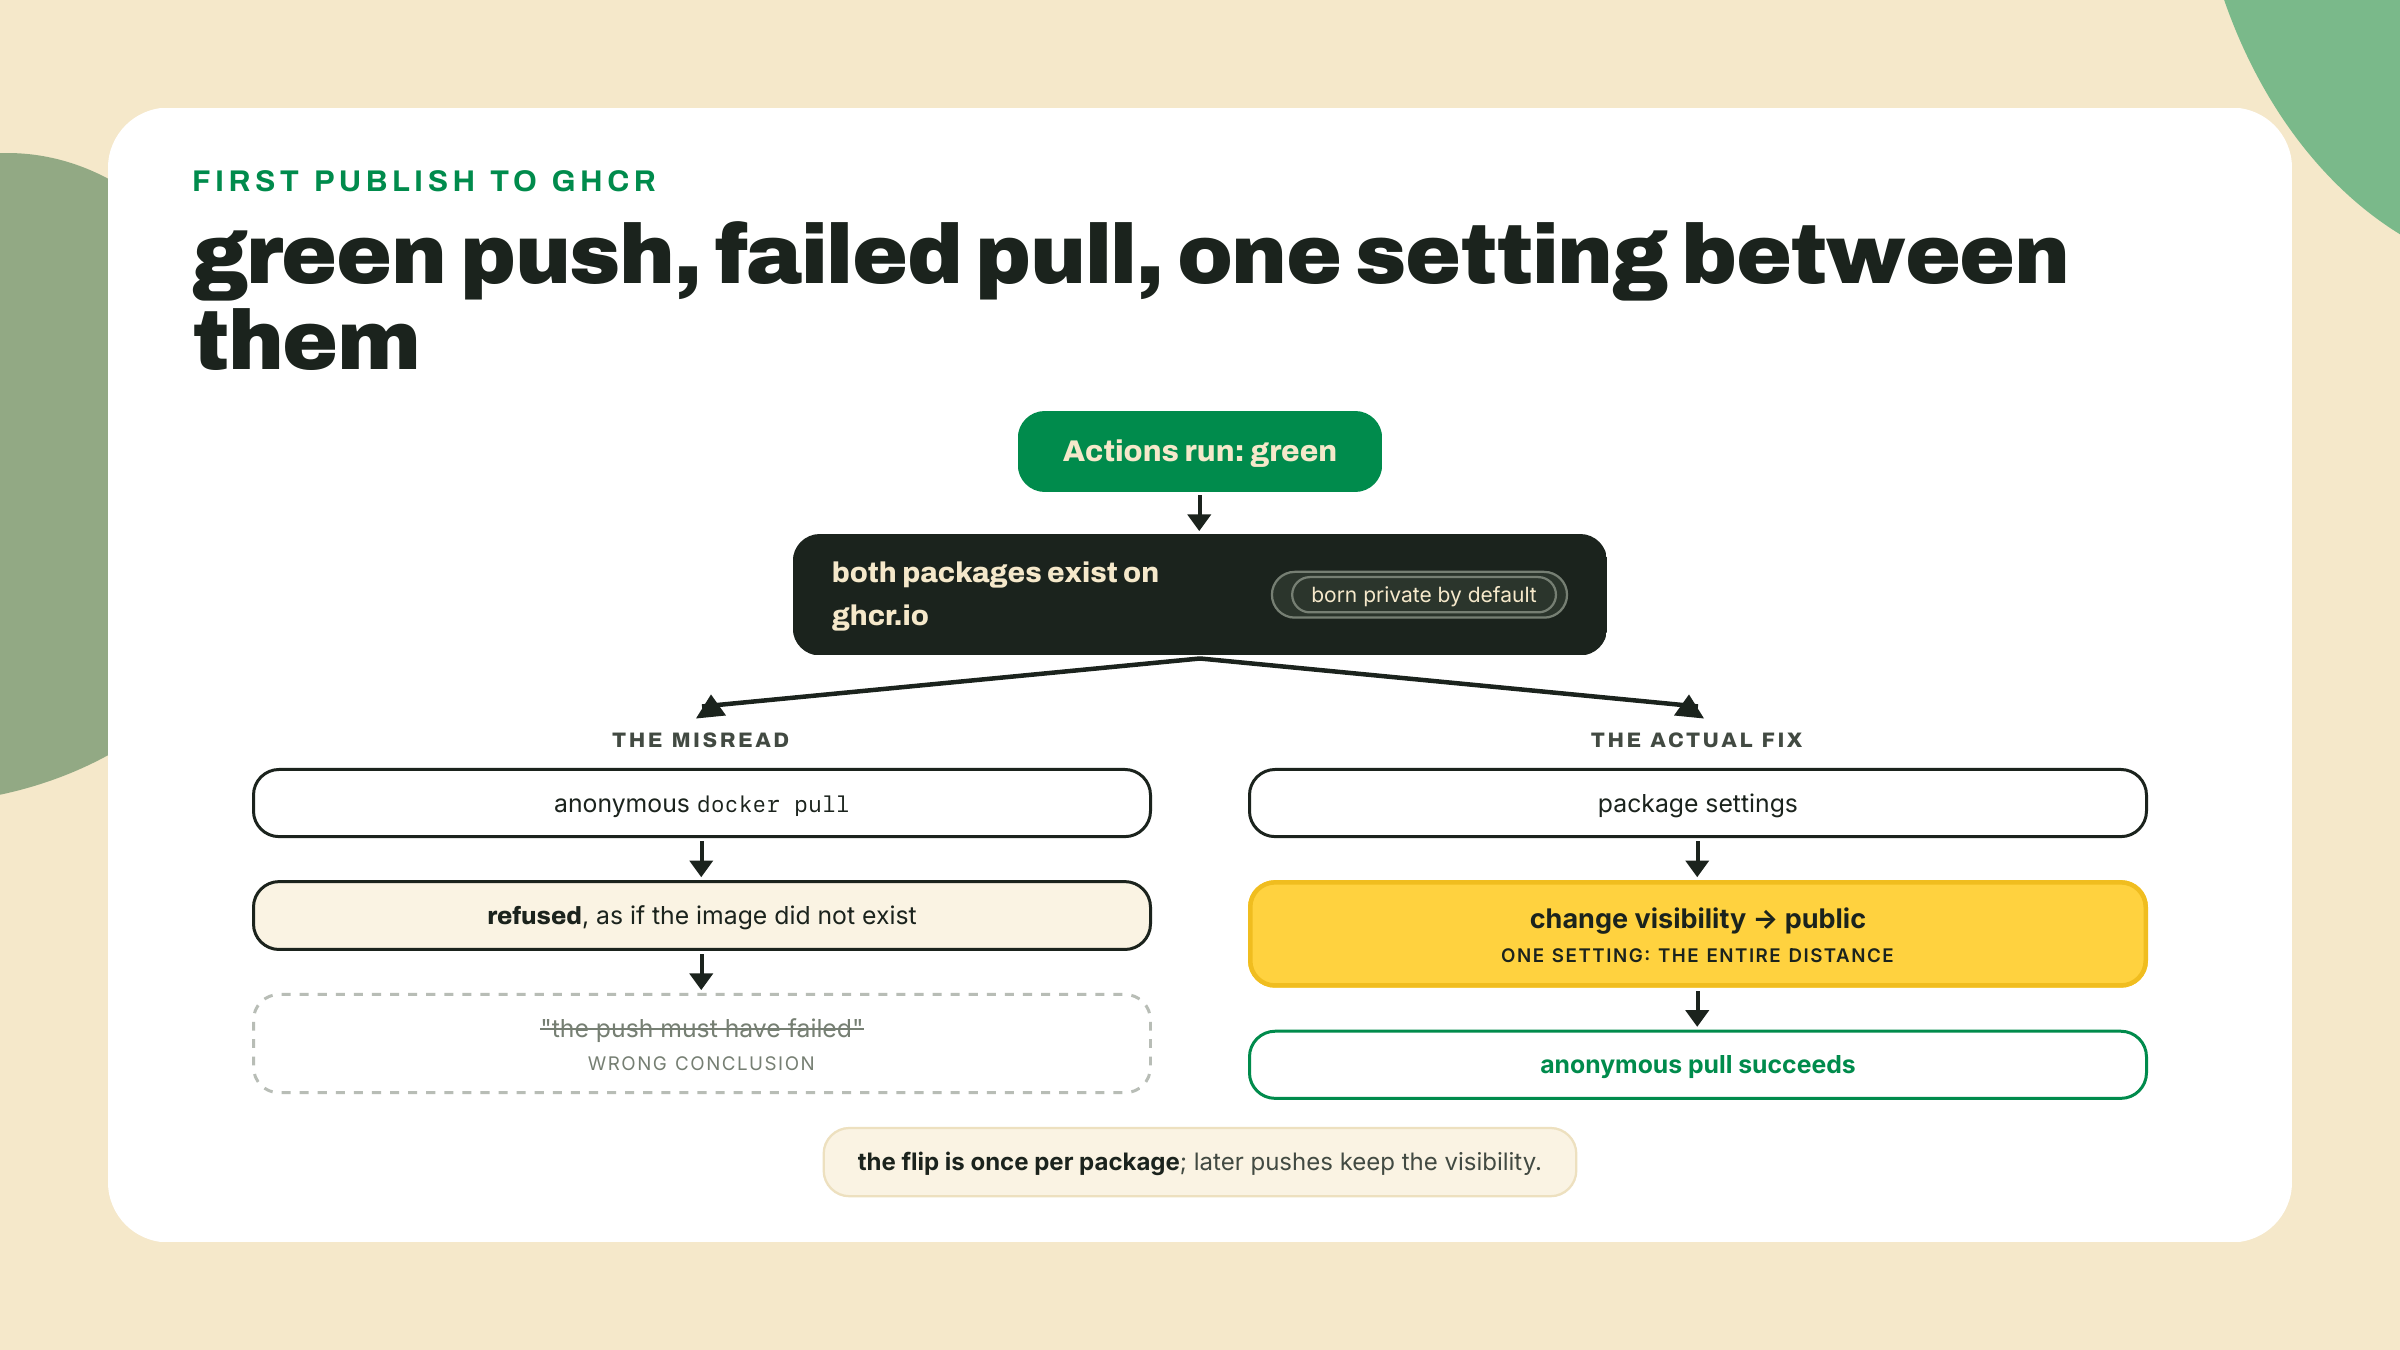
Agora tente usar, e conheça a pegadinha. A execução está verde, então as imagens são públicas, certo? Teste a afirmação do jeito que a máquina de qualquer estranho testaria:
docker logout ghcr.io
docker pull ghcr.io/<your-username>/pulse-pollerd:latest
O pull falha, denied, como se a imagem não existisse. Não conclua que o push falhou; um push que falha faz o step e a execução falharem, e a sua estava verde. Este é o default de primeira publicação do GHCR: todo pacote novo nasce privado, visível para você e para mais ninguém, e um pull anônimo é recusado sem nem confirmar que o pacote existe. O conserto é uma configuração, não código. No github.com, abra a aba Packages do seu perfil, clique em pulse-pollerd, depois em Package settings, depois, na danger zone, Change visibility para Public e digite o nome do pacote para confirmar. Faça o mesmo para o pulse-fleet-runner. Isso é uma virada única por pacote; pushes futuros para o mesmo pacote mantêm a visibilidade dele.
A prova que viaja. Esta é a checagem intermediária do módulo, e é deliberadamente o mesmo comando que um estranho rodaria. Ainda deslogado do ghcr.io, ou melhor, em uma segunda máquina que nunca viu o seu código:
docker pull ghcr.io/<your-username>/pulse-pollerd:latest
docker run --rm -p 8080:8080 ghcr.io/<your-username>/pulse-pollerd:latest
Depois curl -s localhost:8080/status de outro terminal. Aquele JSON é o seu poller, rodando a partir de uma imagem que a sua máquina puxou da internet pública, construída por um runner de CI que você nunca tocou, a partir de um commit que as suas travas aprovaram. O pull do GHCR é a prova: não "funciona na minha máquina", mas "funciona em qualquer máquina que consiga dar pull".
Solo, duas costuras, nenhum conceito novo. Primeiro, deixe os logs intercalados amigáveis a grep: dê às linhas de log de cada serviço uma forma estável de uma linha, algo como uma linha de resumo de sweep por intervalo para o runner e uma linha por poll para o poller, para que docker compose logs -f se leia como uma linha do tempo em vez de dois monólogos embaralhados juntos. Você está editando a saída dos seus próprios programas, não o compose; a linha do runner é um console.log no loop de intervalo, a do poller um println! (ou a linha de log que você já emite) no loop de poll. O teste de uma boa forma é que docker compose logs | grep sweep conte a história da última hora por conta própria. Segundo, profiles: marque o serviço fleet-runner com profiles: ["fleet"], depois ponha COMPOSE_PROFILES=fleet em um arquivo .env ao lado do compose.yaml para que um docker compose up simples ainda suba os dois serviços, enquanto COMPOSE_PROFILES="" docker compose up sobe só o poller. O compose lê aquele arquivo .env por conta própria; nada faz source nele. Aceitação: as duas variantes se comportam como descrito, e docker compose config --services mostra a lista de serviços mudando entre elas, dois nomes no caso default, um quando o profile é esvaziado.
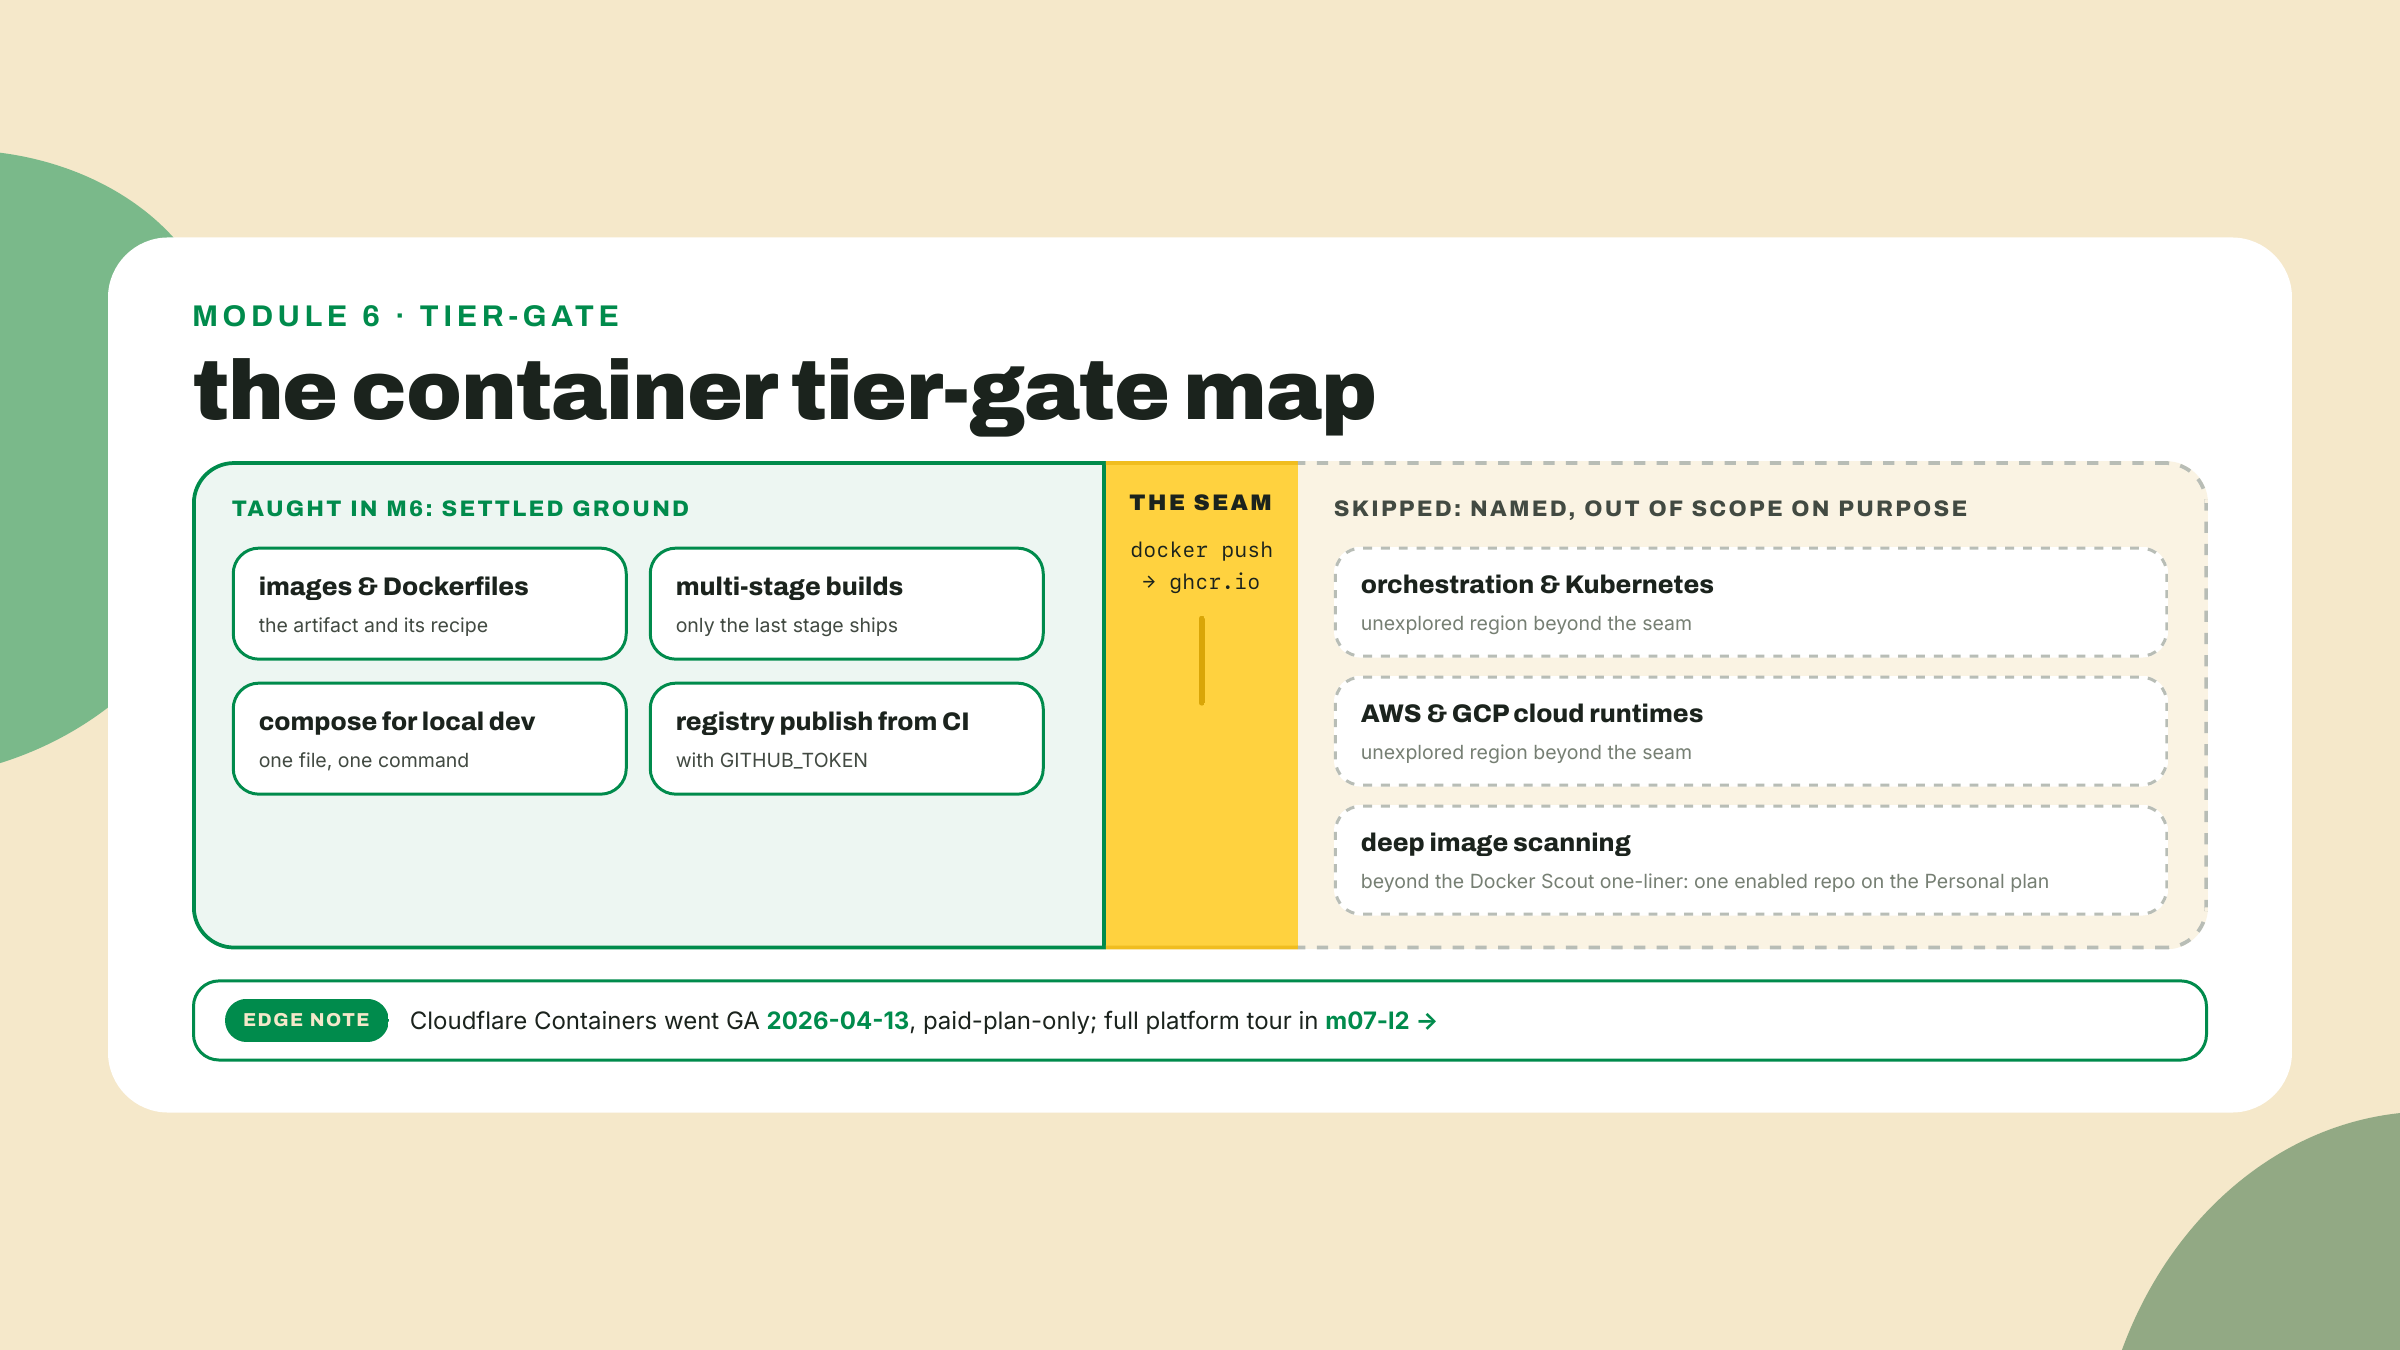
Toda fronteira de entrega neste curso te deve um mapa do que ela deixou de fora, e o mapa do tier de contêineres importa mais que a maioria porque o ecossistema acima dele é enorme. Isto é um mapa, não uma desculpa: o território pulado foi pulado porque os 80% do ciclo de vida de dev pelos quais você veio aqui não o exigem. Três nomes, sinalizados com honestidade.
Orquestração, com o Kubernetes à frente, é tudo do outro lado da costura de deploy: uma frota de máquinas que dá pull nas suas imagens, mantém rodando o número declarado de cópias, substitui as que morrem e faz rollout de novas versões gradualmente. Leia essa frase de novo e note que é o vocabulário do seu arquivo compose, serviços e imagens e estado desejado, esticado por muitas máquinas; é por isso que aprender compose com honestidade é o primeiro degrau certo mesmo que compose não seja a escada. O Kubernetes está fora de escopo de propósito, este curso não tem nenhum irmão a quem te passar para isso, e você agora tem exatamente o conceito, imagens em um registro, que todo orquestrador consome.
Runtimes de nuvem, AWS e GCP e os serviços gerenciados de contêiner deles, mesmo veredito: eles são consumidores do lado do pull da costura que você acabou de construir, e ensinar qualquer um deles teria custado um módulo que este curso gastou nas duas linguagens em vez disso. Profundidade de escaneamento de imagem ganha uma linha honesta: o Docker Scout escaneia em busca de camadas com vulnerabilidades conhecidas, o plano Personal dele inclui 1 repo habilitado, e esse é o seu ponto de entrada gratuito quando as imagens da estação começarem a carregar dependências que você não escreveu. Um toque de cor para a borda do mapa, porque ele diz algo verdadeiro sobre onde esta indústria está: em 2026-04-13 o Cloudflare Containers entrou em GA, a plataforma de edge functions admitindo que algumas cargas de trabalho só querem uma caixa Linux, mas ele fica atrás do plano Workers Paid de $5/mo, que reprova na regra sem-cartão deste curso; a família de plataformas à qual ele pertence ganha o tour completo dela no m07-l2.
Trave no fazer, três colagens: a saída do seu docker compose ps mostrando os dois serviços Up enquanto curl -s localhost:8080/status responde a partir da stack composta; a URL da execução verde do Actions cujo images job deu push nos dois pacotes; e o docker pull deslogado ou de segunda máquina da sua própria imagem no GHCR, seguido pelas primeiras linhas da saída do docker run dela. Aquela terceira colagem é a que seria impossível na hora do café da manhã.
Um pedido de calibração antes de você fechar o terminal. Esta lição apostou que o arquivo compose precisava de só dois TODOs e o job de CI de só um, na teoria de que três lições de Docker e dezoito de crescer pipeline ganharam essa magreza. Se algum dos dois pareceu preencher um formulário em vez de construir, ou se a virada de visibilidade te pegou mesmo com o aviso impresso acima dela, diga qual no feedback do curso; o cronograma do recuo é afinado exatamente por estes relatos.
A estação agora roda em qualquer lugar onde viva um docker daemon, e essa frase era a promessa inteira do módulo. Mas note o que ela ainda concede: a estação roda em um lugar por vez, o daemon de alguma máquina única, em algum lugar. No próximo módulo, as sondas deixam de morar em uma região, ponto. A mesma lógica de estação vai para o edge do Cloudflare, com deploy em centenas de cidades ao mesmo tempo, nas suas duas linguagens, TypeScript primeiro e depois a recompensa em Rust. O registro era o deploy; tudo depois do docker push é o escalonador de alguém. Hora de ir conhecer os escalonadores.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.