Carregando...

 BetaBeta
A m06-l4 fechou o tier de contêiner: o poller e o fleet-runner rodam localmente sob o compose, as duas imagens moram no GHCR com push pelo CI, e a trava do tier nomeou o que a gente pulou (K8s, nuvem, profundidade de escaneamento). Então a estação agora mede a internet a partir de um painel no Vercel, de um cron no Actions, e de um poller numa caixa. Cada um deles mede ela a partir de exatamente um lugar. Hoje isso muda: você faz o deploy do pulse-edge-ts, um Worker do Cloudflare que roda o mesmo classificador do pulse-core num agendamento, lembra o último status conhecido no Workers KV, guarda um segredo de verdade do jeito certo, e sonda o RPC público da Solana como só mais um alvo. O apoio que este módulo continua afinando: o esqueleto e a config do worker são dados, a fiação do KV e o loop do cron são TODOs de completion que você termina, e o segundo tipo de alvo de sonda no fim é inteiramente seu. Você já entregou para três plataformas; a quarta deveria parecer menos um tutorial e mais um reconhecimento.
Aqui está a dor, e é uma que a sua própria estação tem em silêncio desde o módulo um. Uma sonda que roda em uma região te fala da rota daquela região até o alvo, não do alvo. O seu cron do Actions roda onde quer que o GitHub tenha agendado ele. O seu poller roda na sua casa. Quando qualquer um dos dois diz "degraded, 900ms," você genuinamente não consegue dizer se o alvo ficou mais lento ou se um cabo transatlântico teve uma tarde ruim. O conserto não é um servidor maior. O conserto é o seu código rodando em centenas de cidades ao mesmo tempo, e um tier gratuito te entrega isso nos primeiros dez minutos desta lição. Faça isto agora:
npm create cloudflare@latest -- pulse-edge-ts
O scaffolder (a Cloudflare chama ele de C3, e ele desce pelo npm, nenhuma instalação além desta linha) faz uma série curta de perguntas. Responda: comece com o Hello World example, template Worker only, linguagem TypeScript, git Yes, e quando ele oferecer o deploy, diga No, porque a gente quer ler o que vai entregar antes. Duas notas de prompt de 2026-09-04: o C3 agora também oferece um arquivo AGENTS.md, responda não; e dentro do repo da estação o git Yes vira no-op em silêncio (o C3 detecta o repositório pai). Os dois estão de boa. Você recebe uma pasta contendo src/index.ts, uma config wrangler.jsonc, e o próprio wrangler fixado como dependência de dev (linha v4, 4.128.0 quando eu conferi em 2026-09-02), que é por que todo comando wrangler nesta lição roda através do npx. Agora:
cd pulse-edge-ts
npx wrangler dev
Abra a URL de localhost impressa, veja Hello World!, pare o dev server, e entregue ele de verdade:
npx wrangler deploy
O primeiro deploy te leva pelo login de navegador e pela escolha de um subdomínio workers.dev, depois imprime uma URL ao vivo no formato pulse-edge-ts.<your-subdomain>.workers.dev. Abra ela no seu telefone. Esse é o SHIP #4, uma quarta plataforma ao vivo antes de a seção de teoria acabar, e todo o resto desta lição é melhorar o que responde naquela URL. (Os ships até agora, em ordem: #1 o cron do Actions na m01-l3, #2 a URL do painel do Vercel na m03-l3, #3 as imagens do GHCR na m06-l4, #4 aqui. O gêmeo Rust da próxima lição aterrissa uma segunda URL sob este mesmo ship, porque a plataforma é o ship e o segundo motor é o ponto.)
O seu poller é um processo node: ele sobe, ele é dono de memória, ele roda até alguma coisa matar ele. Um Worker não é nada disso. O seu código roda dentro de um isolate, um sandbox leve dentro do workerd, o runtime da Cloudflare, e a plataforma sobe isolates em qualquer cidade dela em que o tráfego chegar, roda o seu handler para um evento, e joga o isolate fora sem cerimônia. Nenhum boot que você controla, nenhuma memória que você guarda, nenhum processo que seja "o" servidor. O contrato é um par de handlers: fetch roda quando um request chega, scheduled roda quando um cron dispara. Esse é o modelo de programação inteiro.
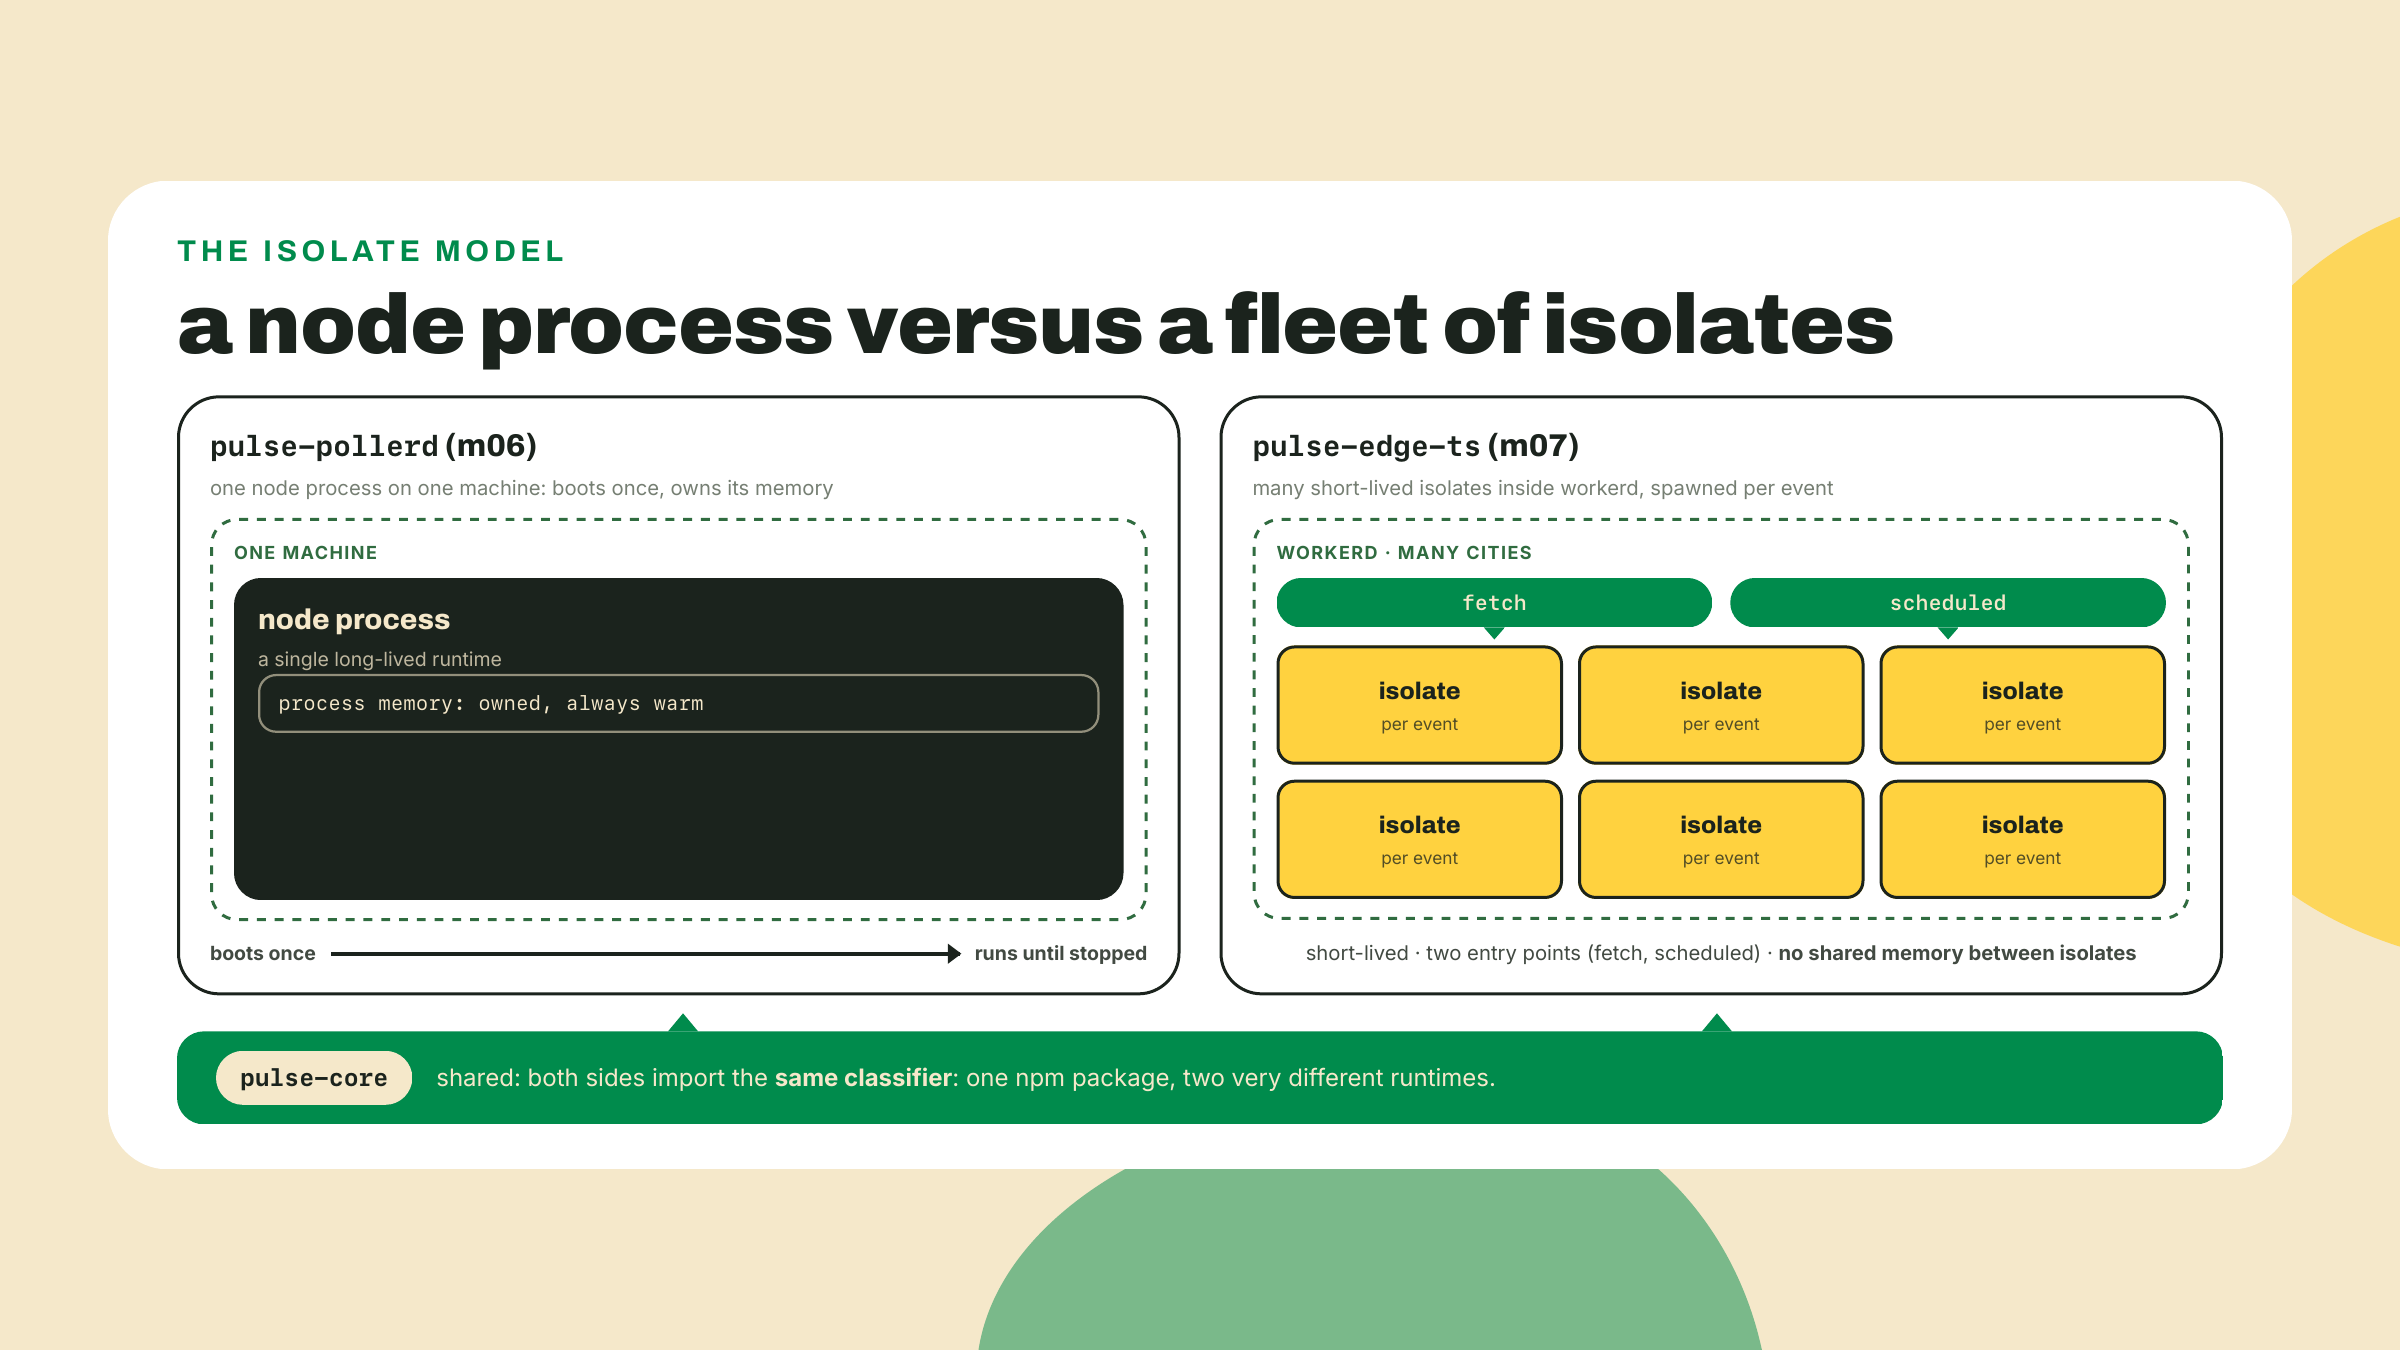
A frase honesta de uma linha, e ela desmonta boa parte da mística: o edge não é um servidor mais rápido, é o seu código onde o usuário já está. Tudo o que é estranho nos Workers decorre disso. Builtins do node existem só como shims, porque não existe node e não existe OS embaixo: uma chamada de sistema de arquivos não tem disco para alcançar. Nenhuma memória de vida longa, porque não existe "a máquina" para ela morar. Um orçamento de 10 ms de CPU por invocação no tier gratuito, porque mil cidades só conseguem se dar ao luxo de rodar você se você for pequeno. E as partes da sua base de código que sobrevivem a este ambiente sem mudança são exatamente as partes que a m03-l1 te obrigou a deixar puras. A gente vai descontar essa afirmação daqui a pouco.
Um parágrafo sobre o Pages, porque a internet vai tentar te rotear para lá. A Cloudflare historicamente entregou um segundo produto, o Pages, para sites estáticos, e tutoriais da era 2023 para "faça o deploy da sua página de status" vão apontar para ele. Quando eu sondei a documentação do Pages para esta lição em 2026-09-01, o banner da própria Cloudflare dizia: "O Workers suporta a maioria dos casos de uso do Pages e oferece um conjunto de recursos mais amplo. Ele é a plataforma principal da Cloudflare para construir aplicações. Comece projetos novos com o Workers." Isso é um fornecedor aposentando um produto por recomendação, à vista de todo mundo, e resolve a questão para a gente: este curso constrói Workers, ponto final, e assets estáticos pegam carona nos Workers quando a gente precisa deles. A lição durável supera a trivia de plataforma. Leia a documentação atual do fornecedor, não posts de blog do ano em que o tutorial foi escrito; você viu a documentação do Docker fazer a mesma migração silenciosa no verificador de links deste curso lá na m06-l2.
Agora a espinha dorsal de engenharia desta lição. Na m03-l1 você dividiu a estação em pulse-core (a união ProbeResult, o classifyProbe, os helpers de backoff, toda a lógica pura) e pacotes de app que fazem I/O em volta dela. Na m03-l4 você publicou o núcleo no npm sob o seu escopo. Aquela decisão se paga hoje, porque o worker é um projeto novo em folha fora do seu workspace, e ele consegue dar pull no motor como qualquer estranho daria:
npm i @YOUR_NPM_USERNAME/pulse-core
Tudo naquele pacote importa para dentro do workerd sem mudança. Classificadores, tipos, backoffDelay: funções puras sobre dados simples, nenhuma opinião sobre onde rodam. Essa é a razão inteira de a disciplina de extração existir, e este é o terceiro consumidor provando isso (o painel do Vercel foi o segundo).
O que não porta é tudo em volta do núcleo, e o workerd falha alto exatamente na costura, embora a falha tenha se movido desde os primeiros tempos dos Workers. O workerd atual já vem com uma camada de compatibilidade com o Node, ligada por padrão em datas de compatibilidade recentes, então import { readFileSync } from "node:fs" não quebra mais o build; o import resolve e readFileSync é uma função de verdade. O que falta é a máquina embaixo dela. O único sistema de arquivos que um worker enxerga é o próprio bundle somente leitura dele, montado em /bundle, então no momento em que aquela função vai atrás do arquivo de config da frota o runtime se recusa até a iniciar, nomeando o caminho que ele não conseguiu achar. Algumas APIs não chegam nem tão longe: child_process.spawn existe como nome e lança ERR_METHOD_NOT_IMPLEMENTED no instante em que você chama ele. Isto não é um bug para contornar; é a plataforma desenhando a fronteira núcleo-puro/casca-de-IO para você, em vermelho: os módulos têm shim, o sistema operacional está ausente. Cada lado da costura tem um substituto nativo da plataforma: I/O de arquivo vira fetch (aqui a rede é o disco), acesso a env vira bindings tipados no objeto env que os seus handlers recebem, e estado persistente vira KV. O port não é "faça a frota rodar no edge." É "importe o núcleo, reescreva a casca."
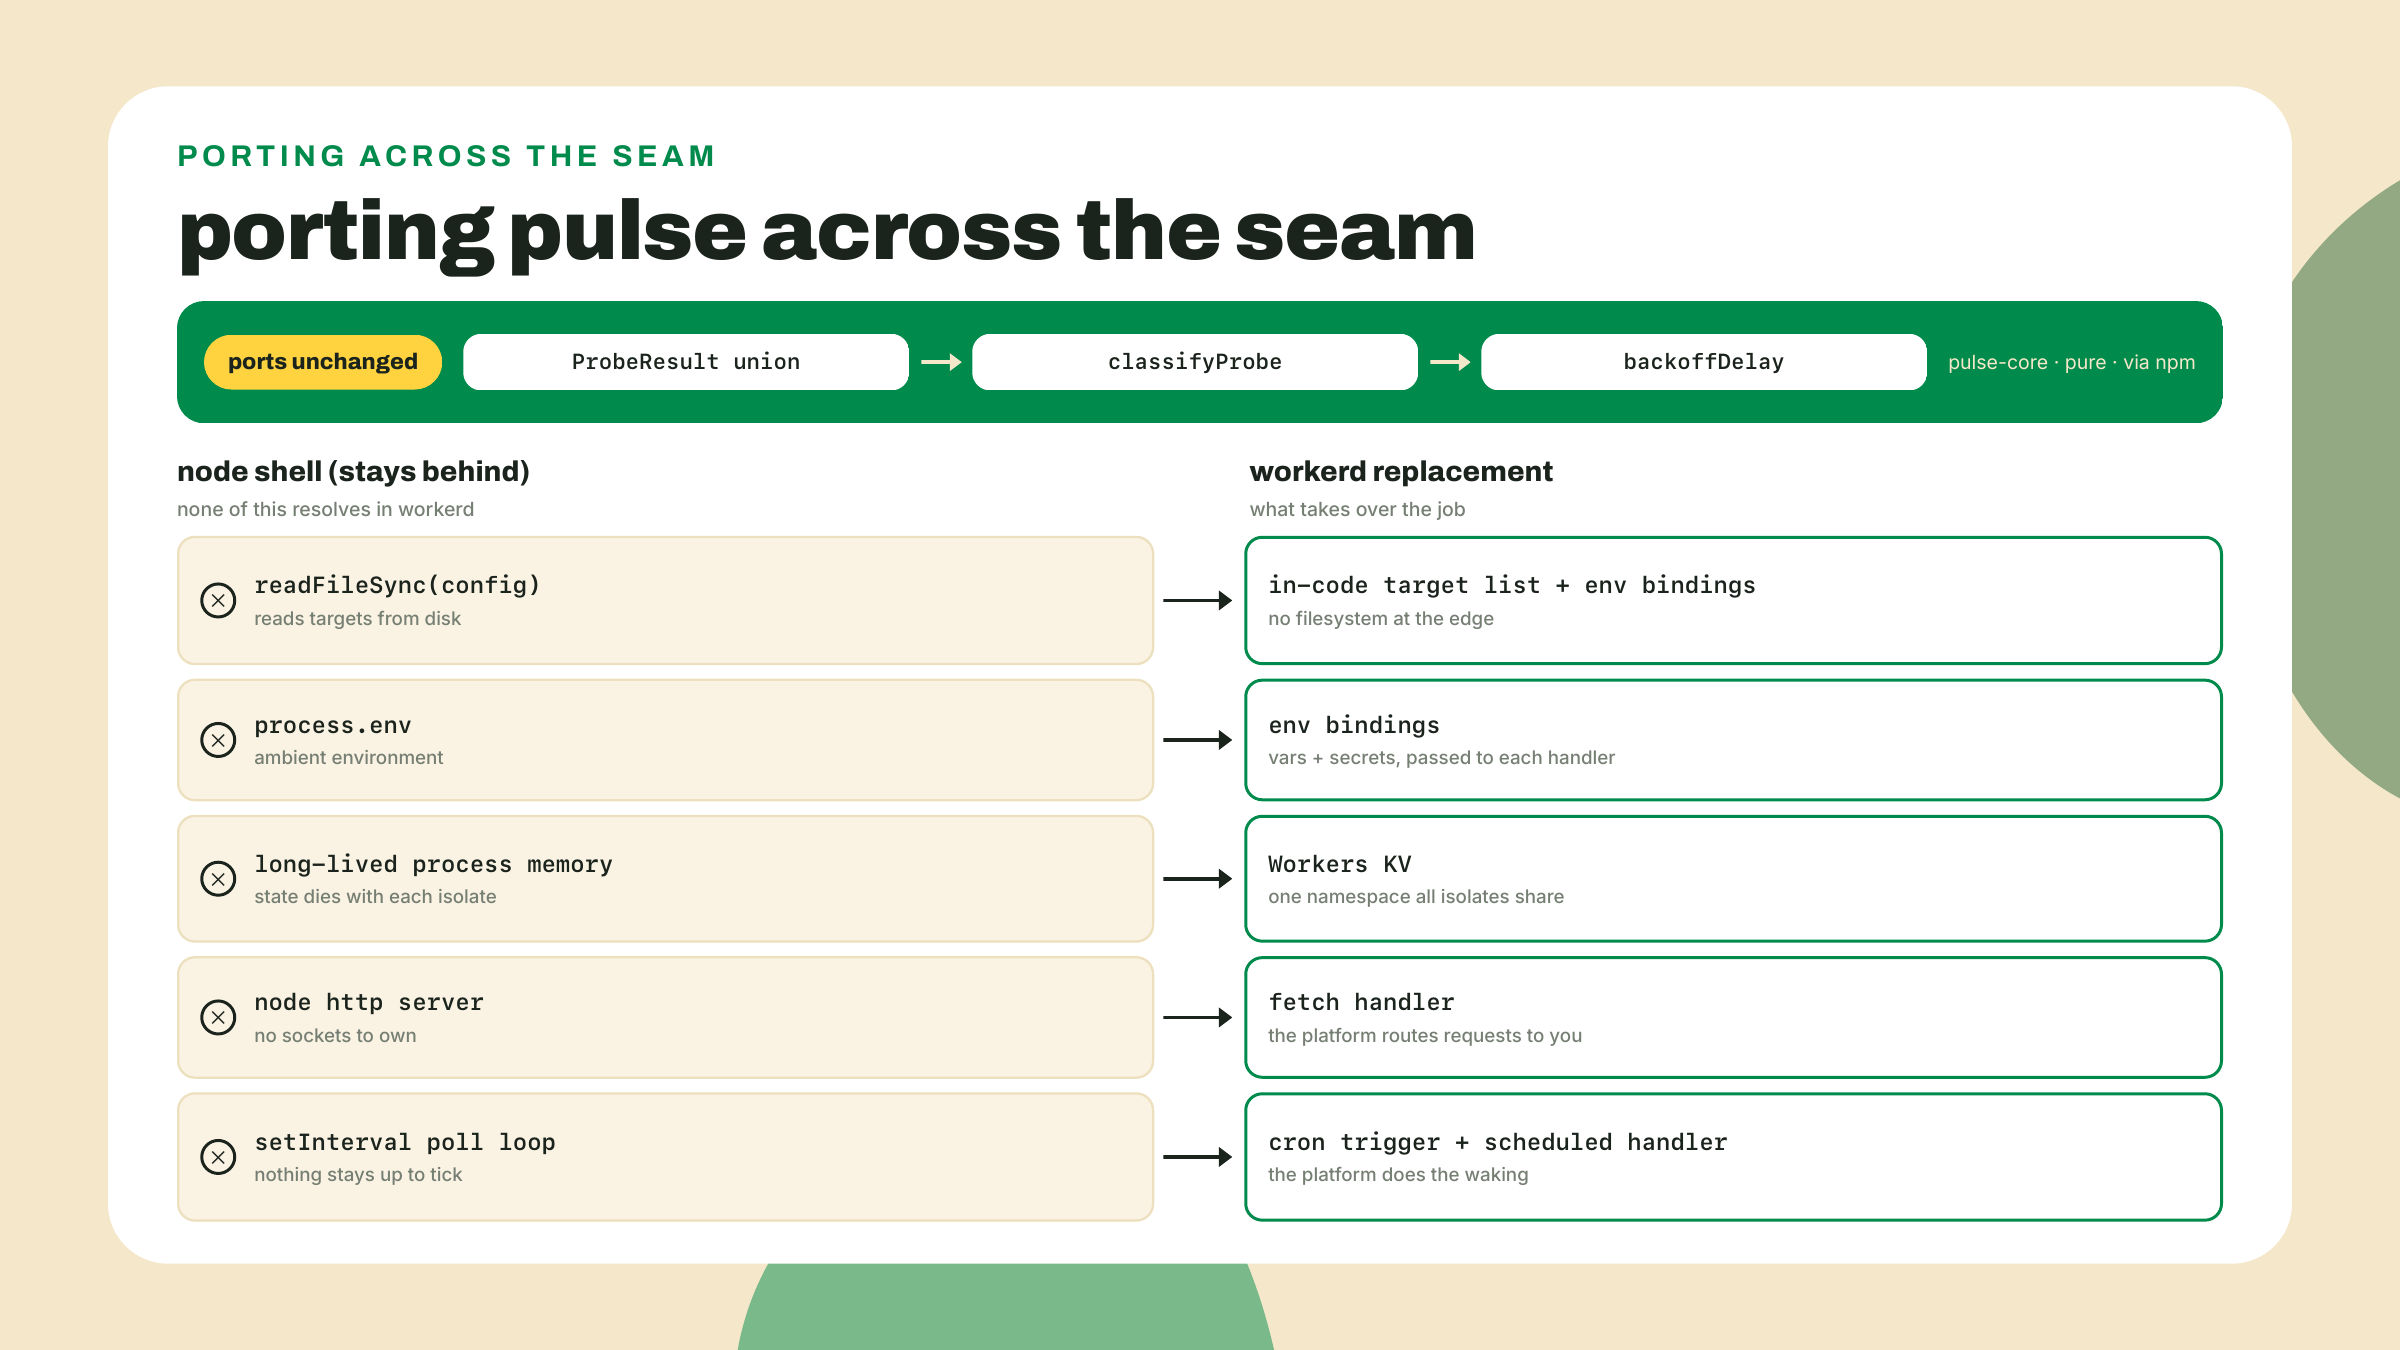
Mais uma palavra sobre esses bindings, porque eles são a melhor ideia silenciosa da plataforma e a relação inteira do worker com o mundo de fora. Na frota, configuração e capacidade chegavam de forma ambiente: process.env era uma sacola global em que qualquer módulo podia enfiar a mão, e nada na assinatura de uma função te dizia que ela precisava de um banco de dados ou de um token. Um Worker inverte isso. Toda capacidade que o seu código pode tocar (o namespace do KV, o segredo, vars de config comuns) é declarada na config do wrangler, e o runtime passa elas para o seu handler como um único parâmetro env tipado. Nada é ambiente. Leia a assinatura de um handler e você sabe o raio de impacto inteiro dele. É injeção de dependência imposta pela plataforma em vez de pela disciplina do time, e a história do TypeScript completa isso: o wrangler types lê a sua config e o .dev.vars e gera a interface Env, então adicionar um binding sem atualizar os tipos não é um erro que você consiga cometer em silêncio. Vindo do módulo três, isto deveria rimar: é a ideia do mapa de exports de novo, uma superfície pública curada substituindo acesso alcança-qualquer-coisa, aplicada a infraestrutura em vez de a módulos.
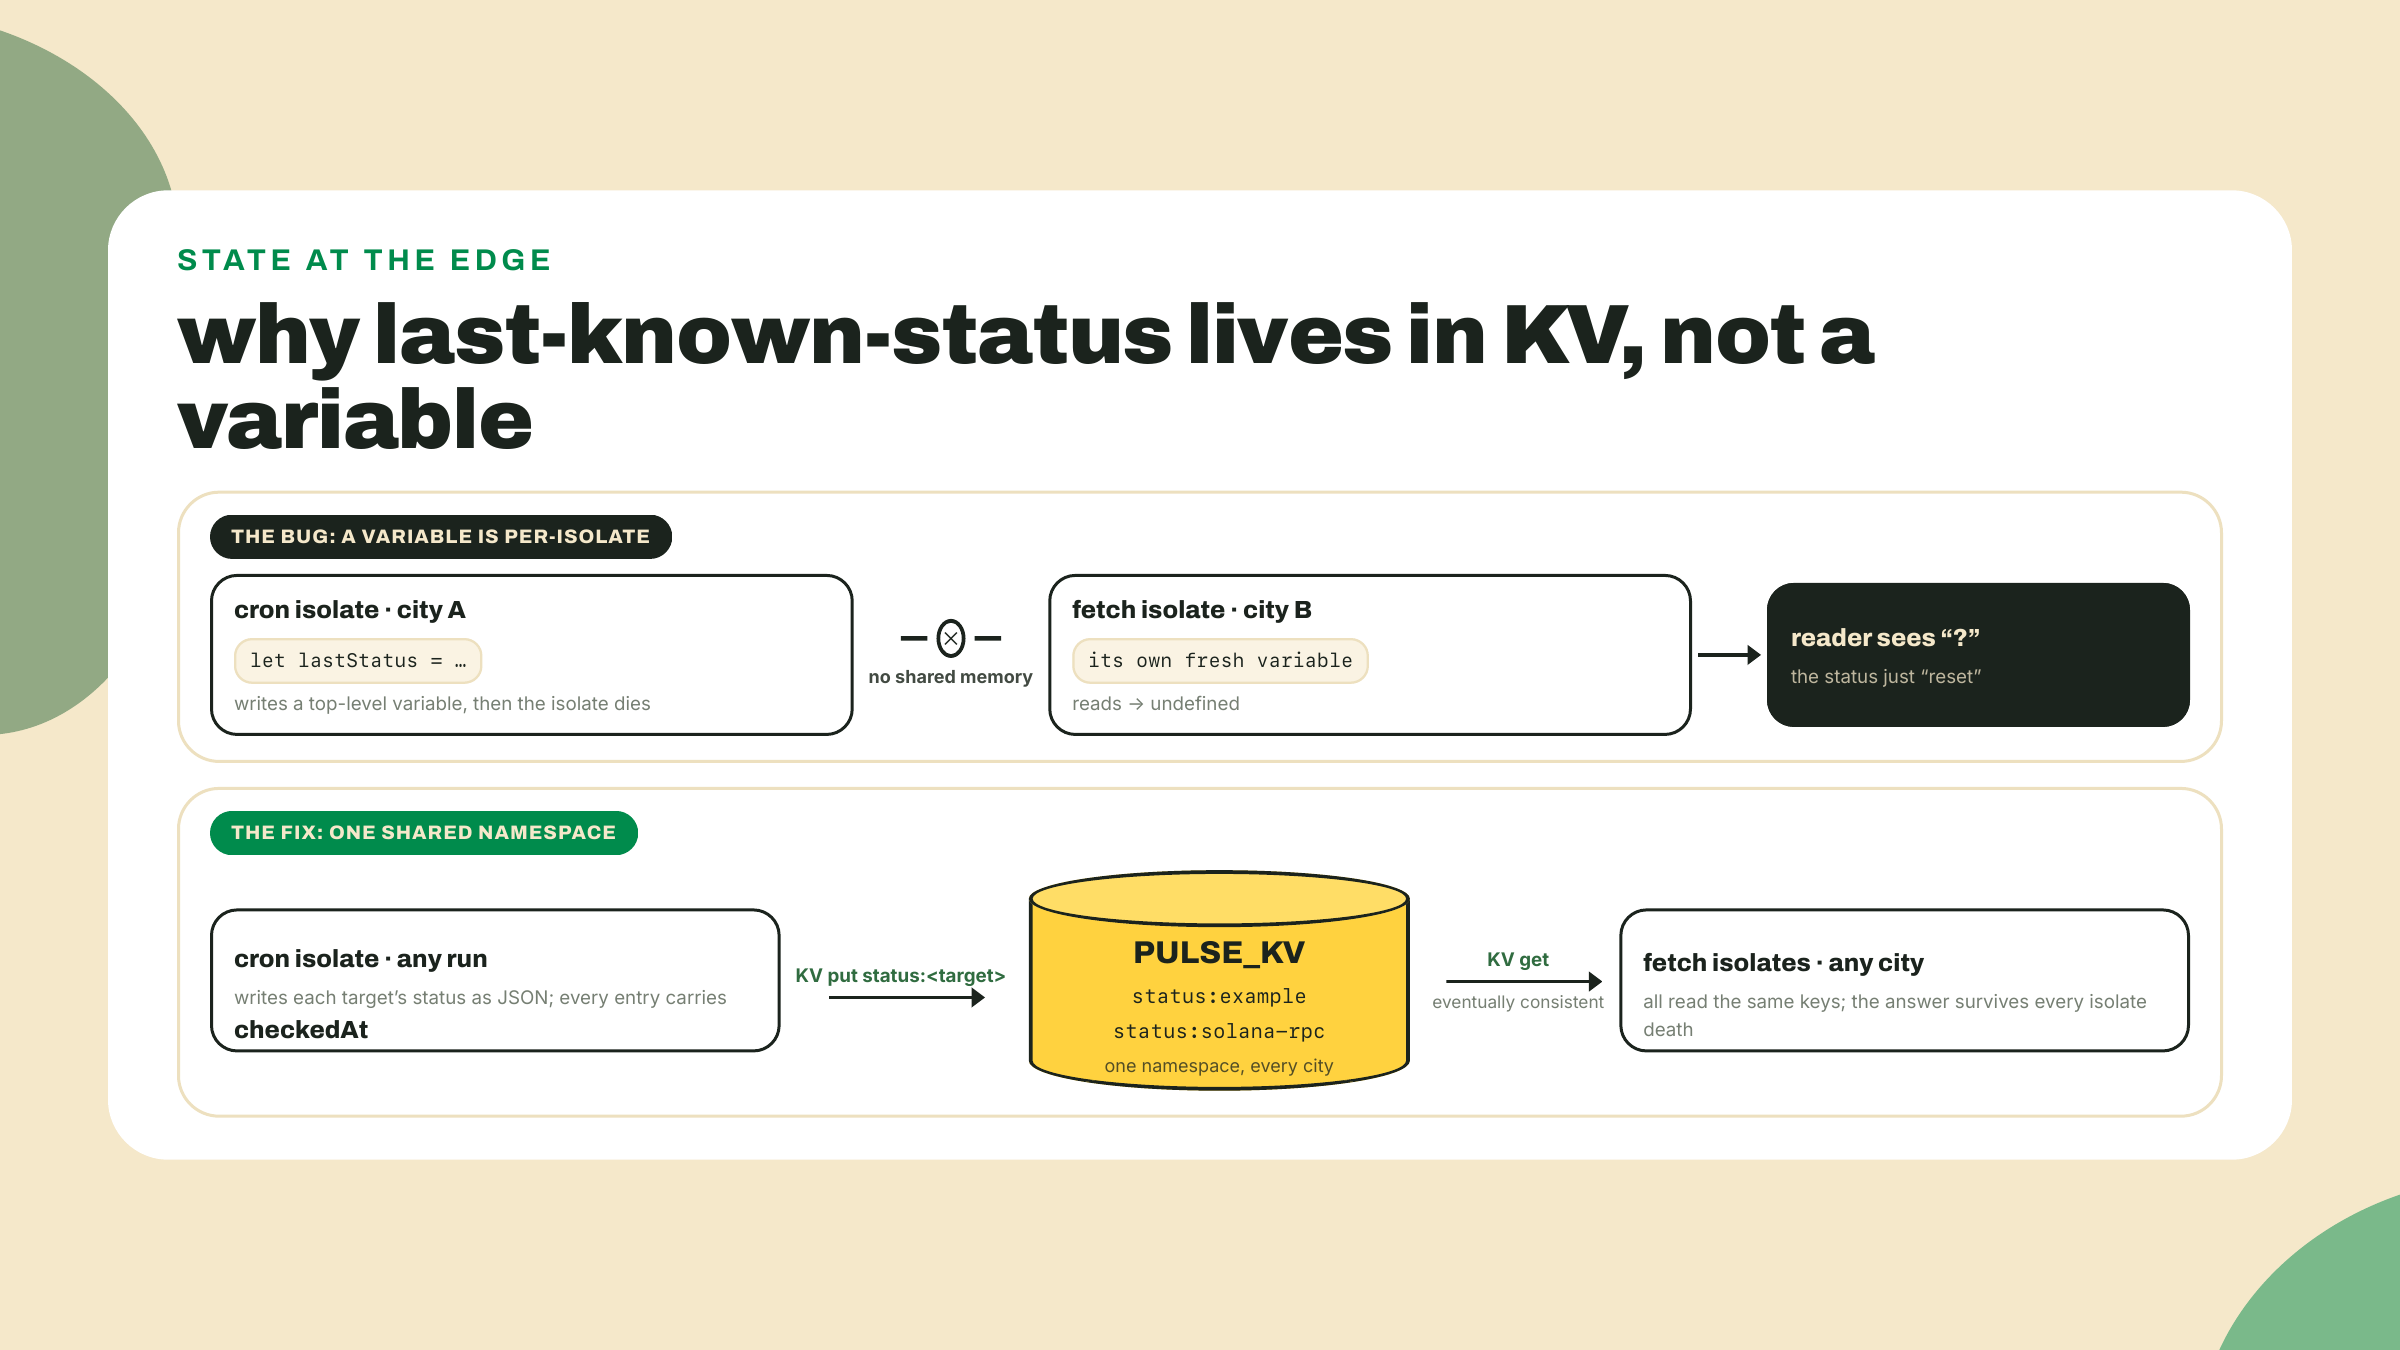
O trabalho da estação é o último status conhecido, e um isolate não consegue lembrar dele. Uma variável de topo funciona no wrangler dev por alguns requests, depois "reseta", porque o isolate em que você escreveu morreu, ou o próximo request aterrissou numa cidade diferente. Memória de worker não sobrevive a invocações e não atravessa localizações. Funcionou no dev é o bug de estado clássico nesta plataforma, e a cura é o armazenamento compartilhado da plataforma: o Workers KV, um namespace chave-valor global que o seu worker alcança através de um binding. A API é pequena o bastante para mostrar inteira:
await env.PULSE_KV.put("status:example", JSON.stringify(entry));
const stored = await env.PULSE_KV.get<StatusEntry>("status:example", "json");
const list = await env.PULSE_KV.list({ prefix: "status:" });
Put, get (com "json" fazendo o parse para você), list por prefixo. O KV é eventualmente consistente: uma escrita aterrissa em uma localização e se propaga para fora, então uma leitura em outra cidade pode ver brevemente o valor anterior. Para uma página de status cujas entradas dizem "a partir deste timestamp," aquela janela de desatualização é genuinamente aceitável, e dizer isso em voz alta é a habilidade de design: você está escolhendo consistência eventual porque o modelo de dados já carrega o próprio campo de freshness dele.
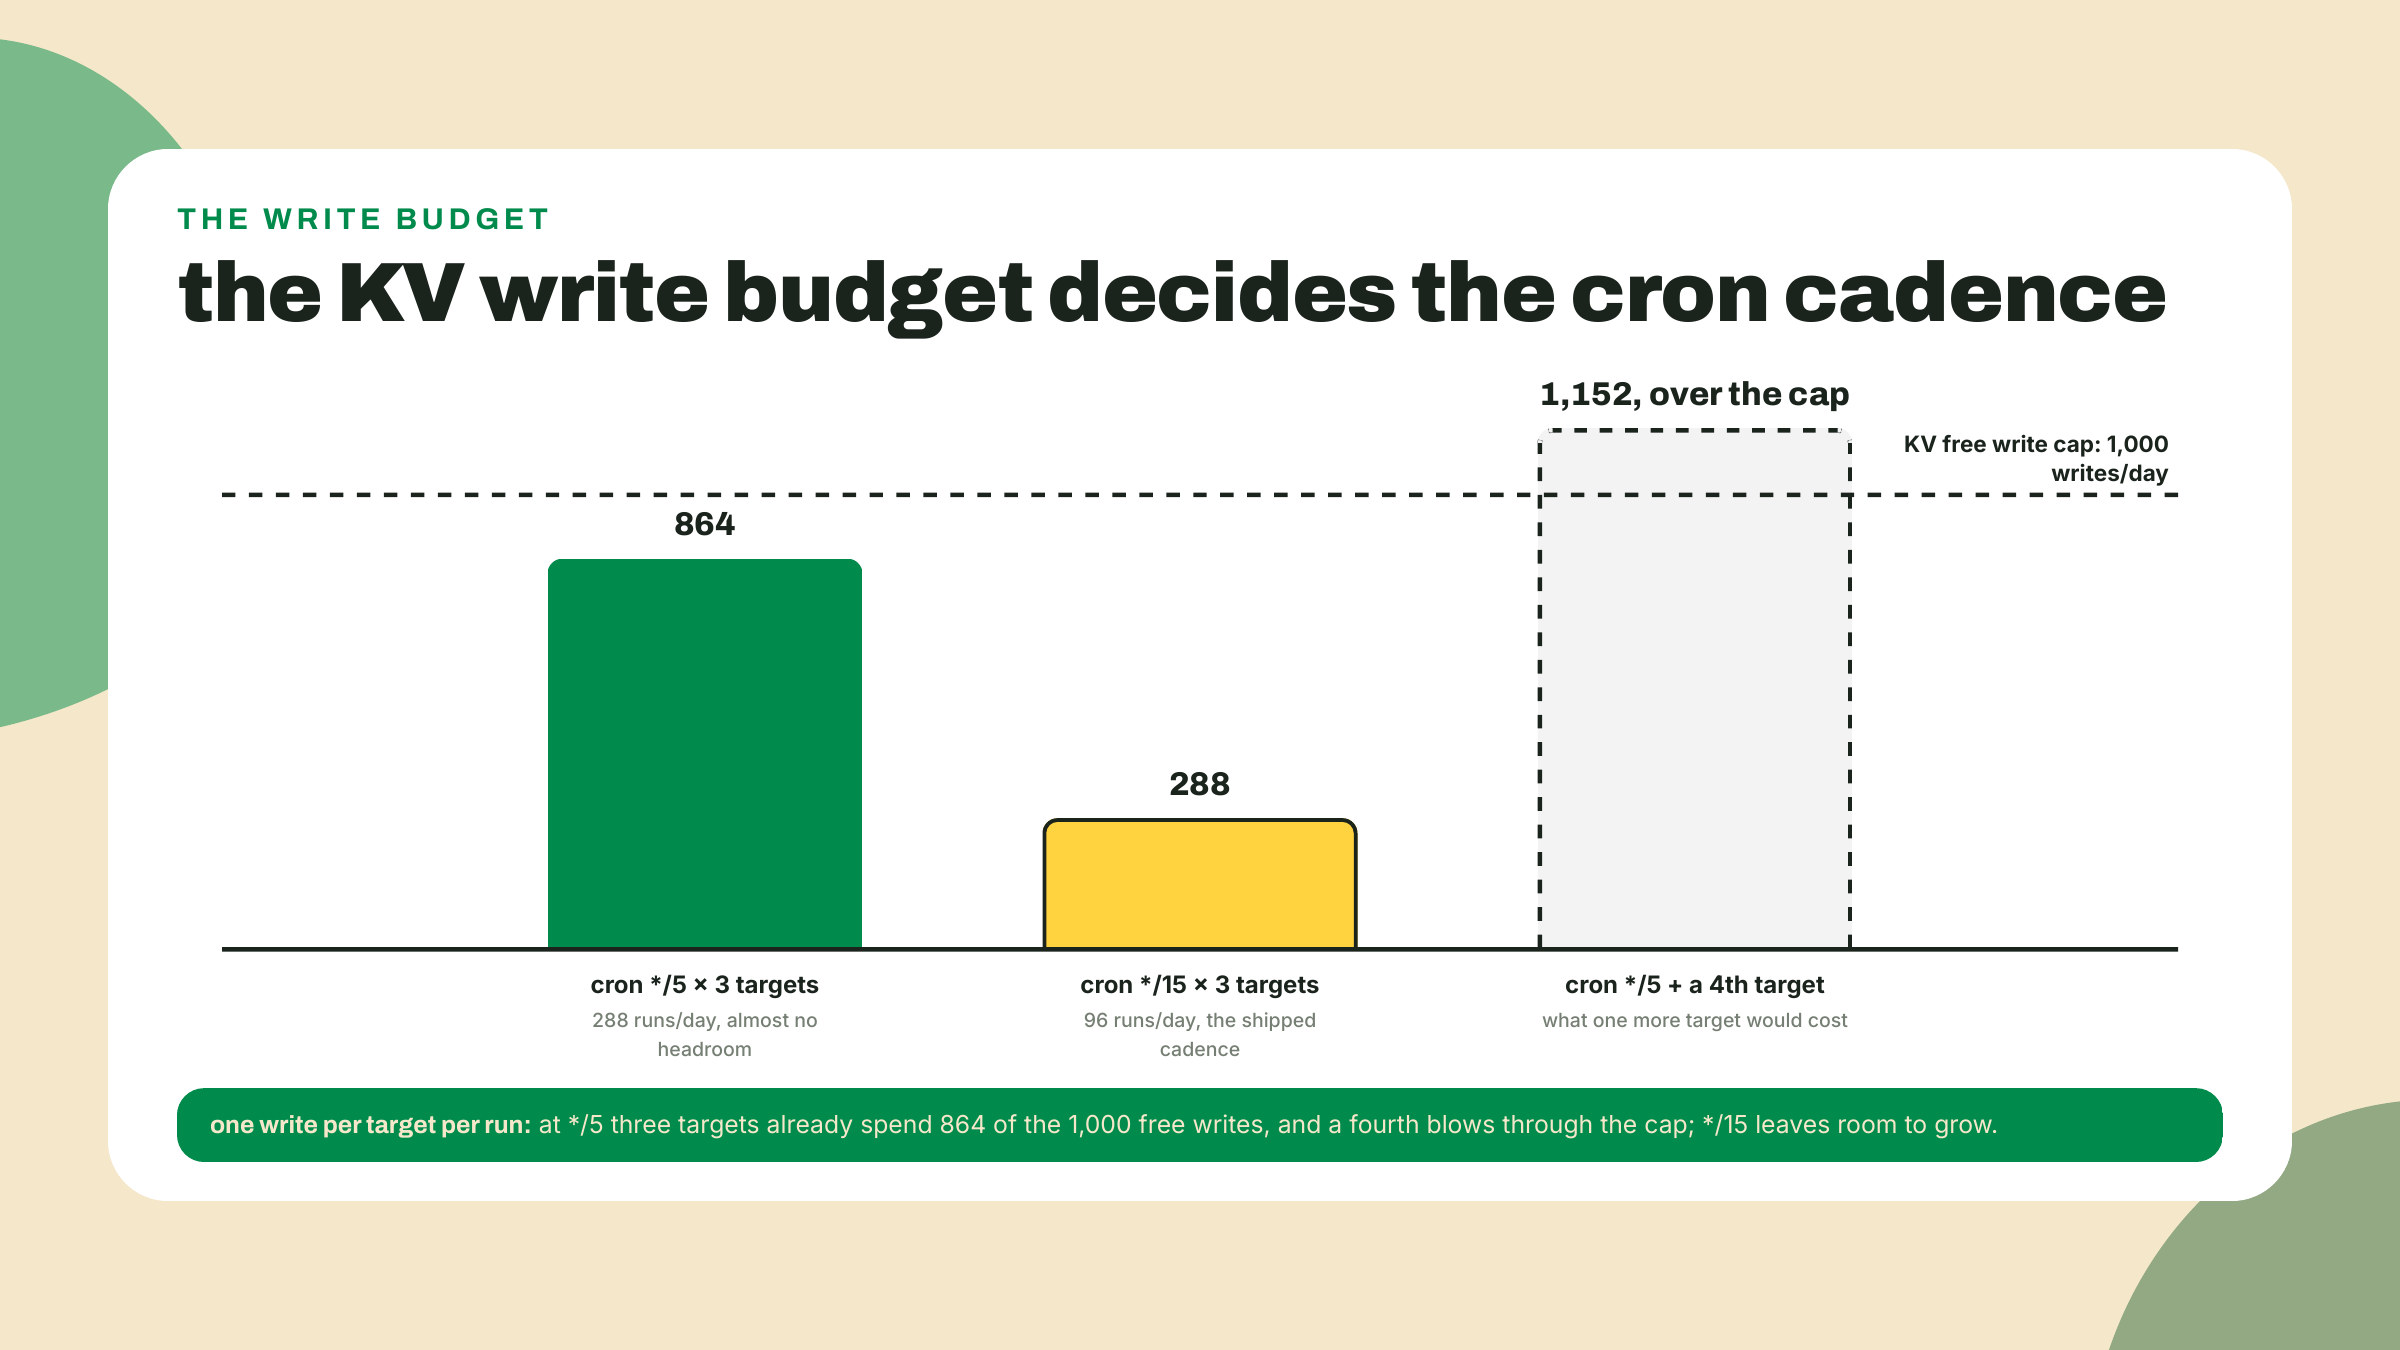
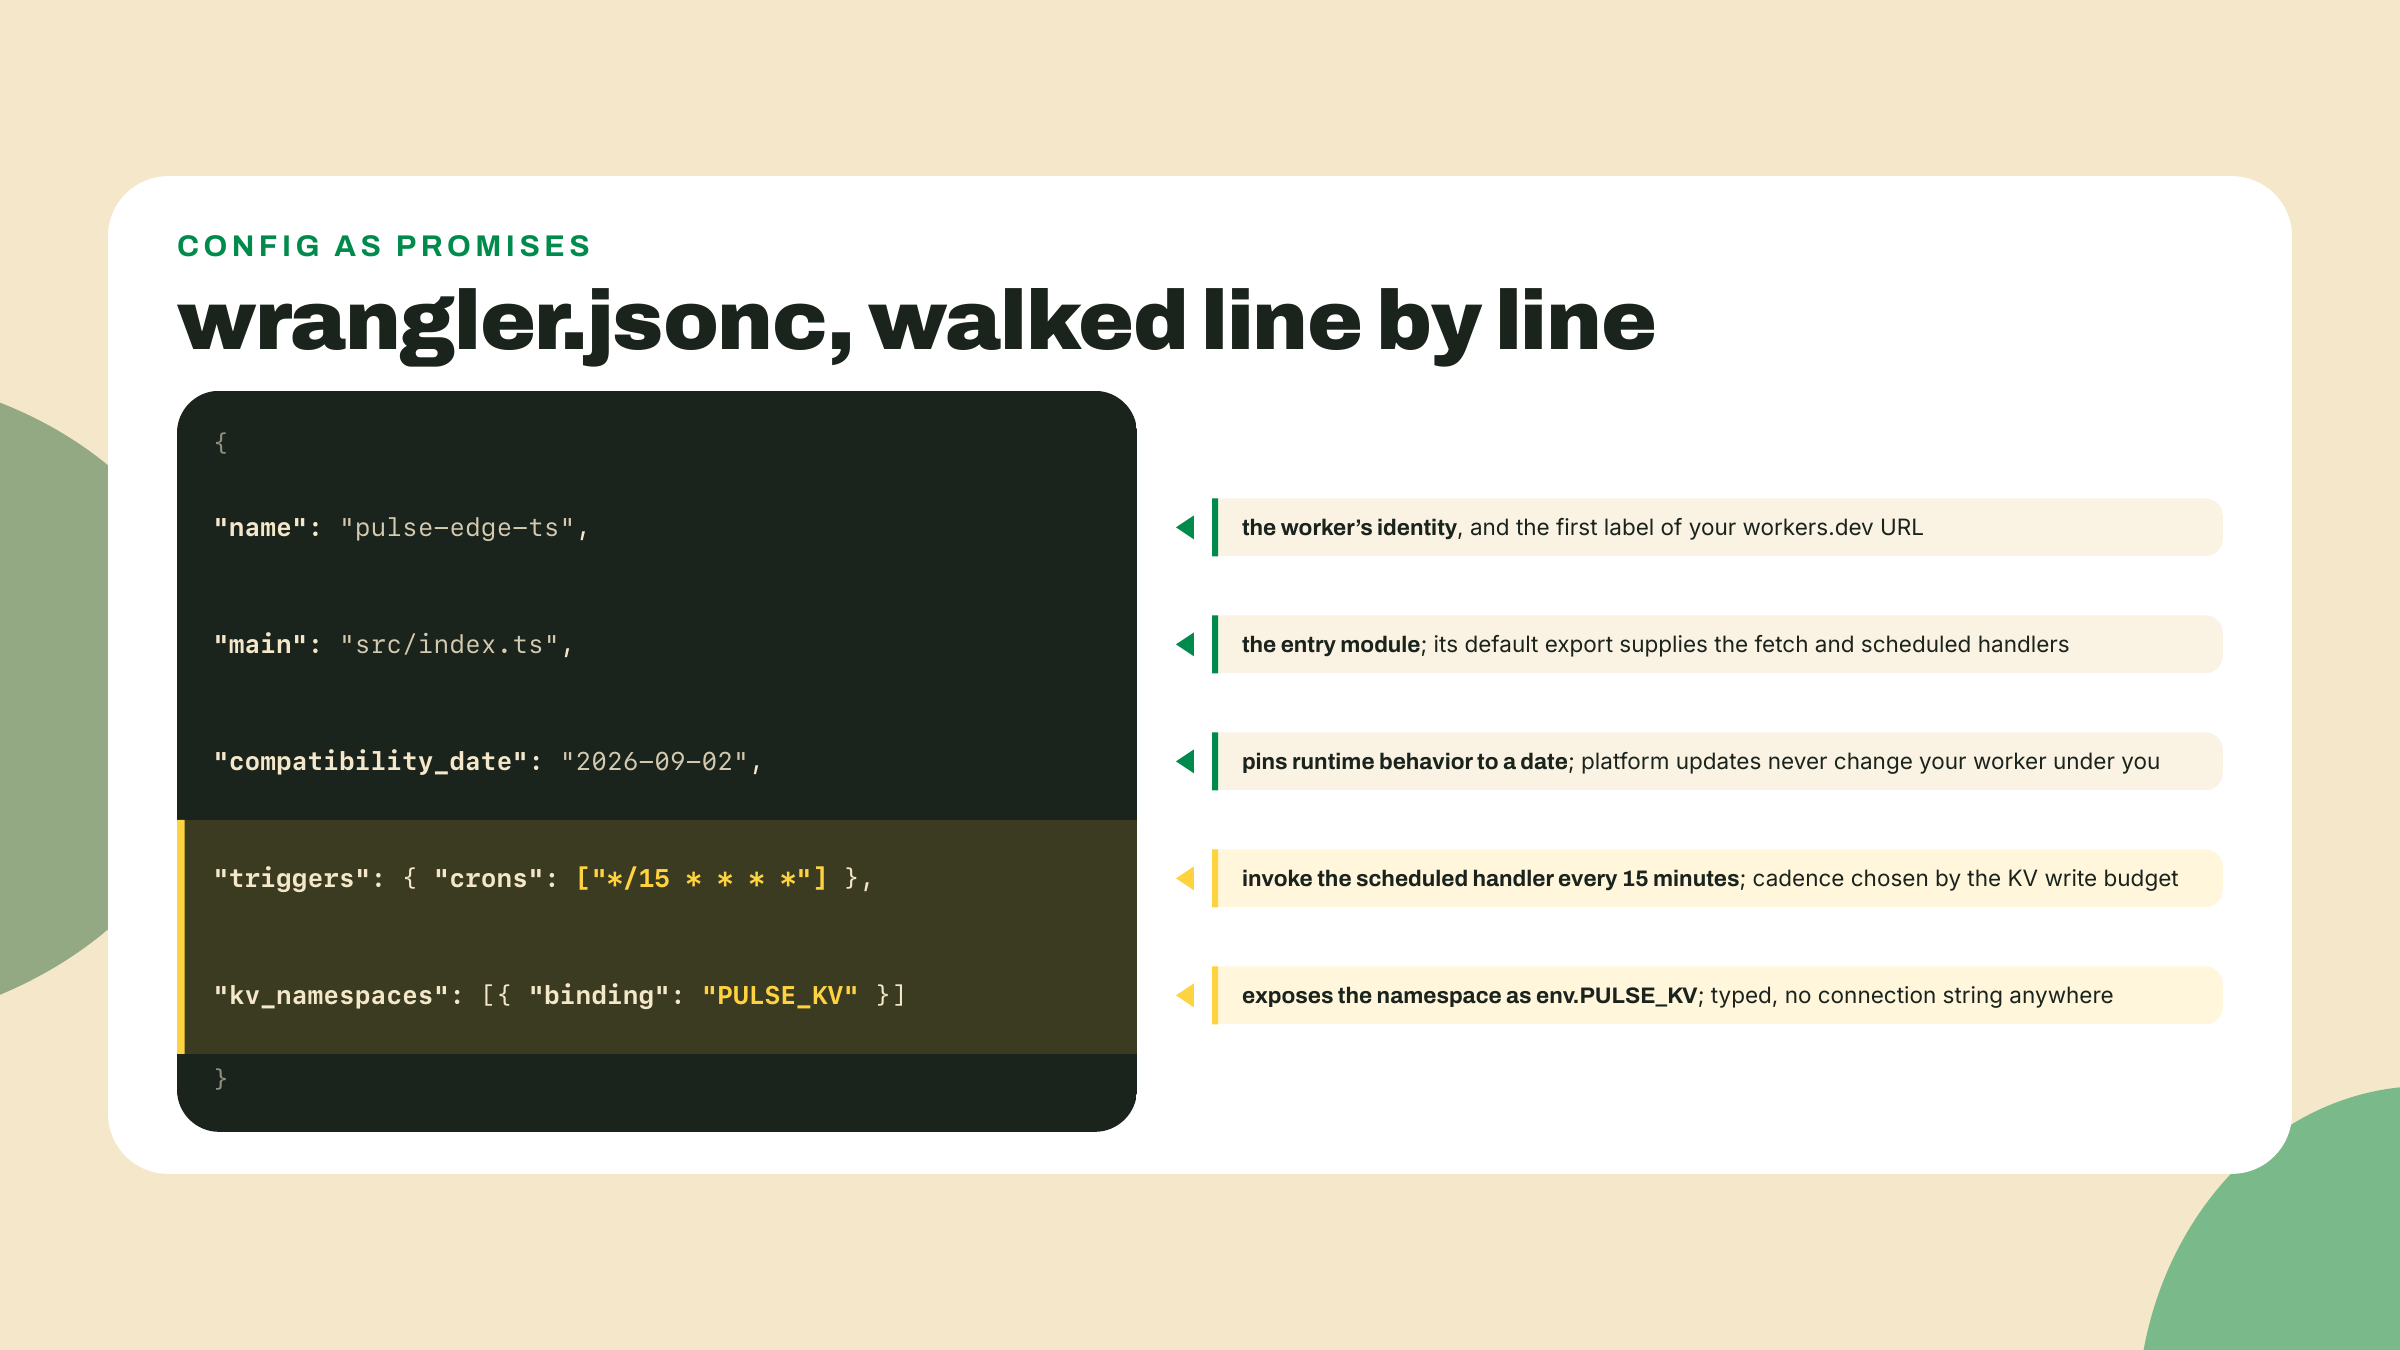
O KV no plano gratuito é medido, e os números moldam o design mais do que você imaginaria: 100,000 leituras por dia, 1,000 escritas por dia (segundo a página de preços, sondada em 2026-09-01). Leituras são abundantes; escritas são o recurso escasso. Faça a aritmética para o nosso worker antes de escrever uma linha: um cron a cada 5 minutos são 288 execuções por dia, e escrever uma chave por alvo quer dizer 288 vezes a contagem de alvos. Três alvos são 864 escritas, o que cabe abaixo de 1,000 com quase nenhuma folga; um quarto alvo passa do teto. A cada 15 minutos são 96 execuções, 288 escritas para três alvos, e espaço para crescer a lista de alvos. É por isso que a config abaixo diz */15. O orçamento fez o design, exatamente do jeito que CAP=25 dimensionou o seu pool na m02-l3.
O trigger de cron é configuração, não código. O seu wrangler.jsonc ganha um bloco triggers com um array de crons, e a plataforma invoca o seu handler scheduled naquela batida, a partir da infraestrutura dela. Nenhum laptop envolvido, mesma promessa do cron do Actions do M1, menos a subida do runner. Testar isso localmente seria miserável se você tivesse que esperar o tempo de relógio de verdade passar, então o wrangler dev expõe uma rota HTTP simples que dispara o handler sob demanda:
curl "http://localhost:8787/cdn-cgi/handler/scheduled"
(Se aquela rota der 404 na sua versão do wrangler, use a grafia mais antiga da mesma porta: inicie o dev com npx wrangler dev --test-scheduled e dê curl em "http://localhost:8787/__scheduled?cron=*+*+*+*+*" no lugar; o wrangler carregou as duas ao longo da linha v4.) Aquela rota se paga rápido quando o seu único ponto de entrada dispara num agendamento; você vai bater nela uma dúzia de vezes no lab.
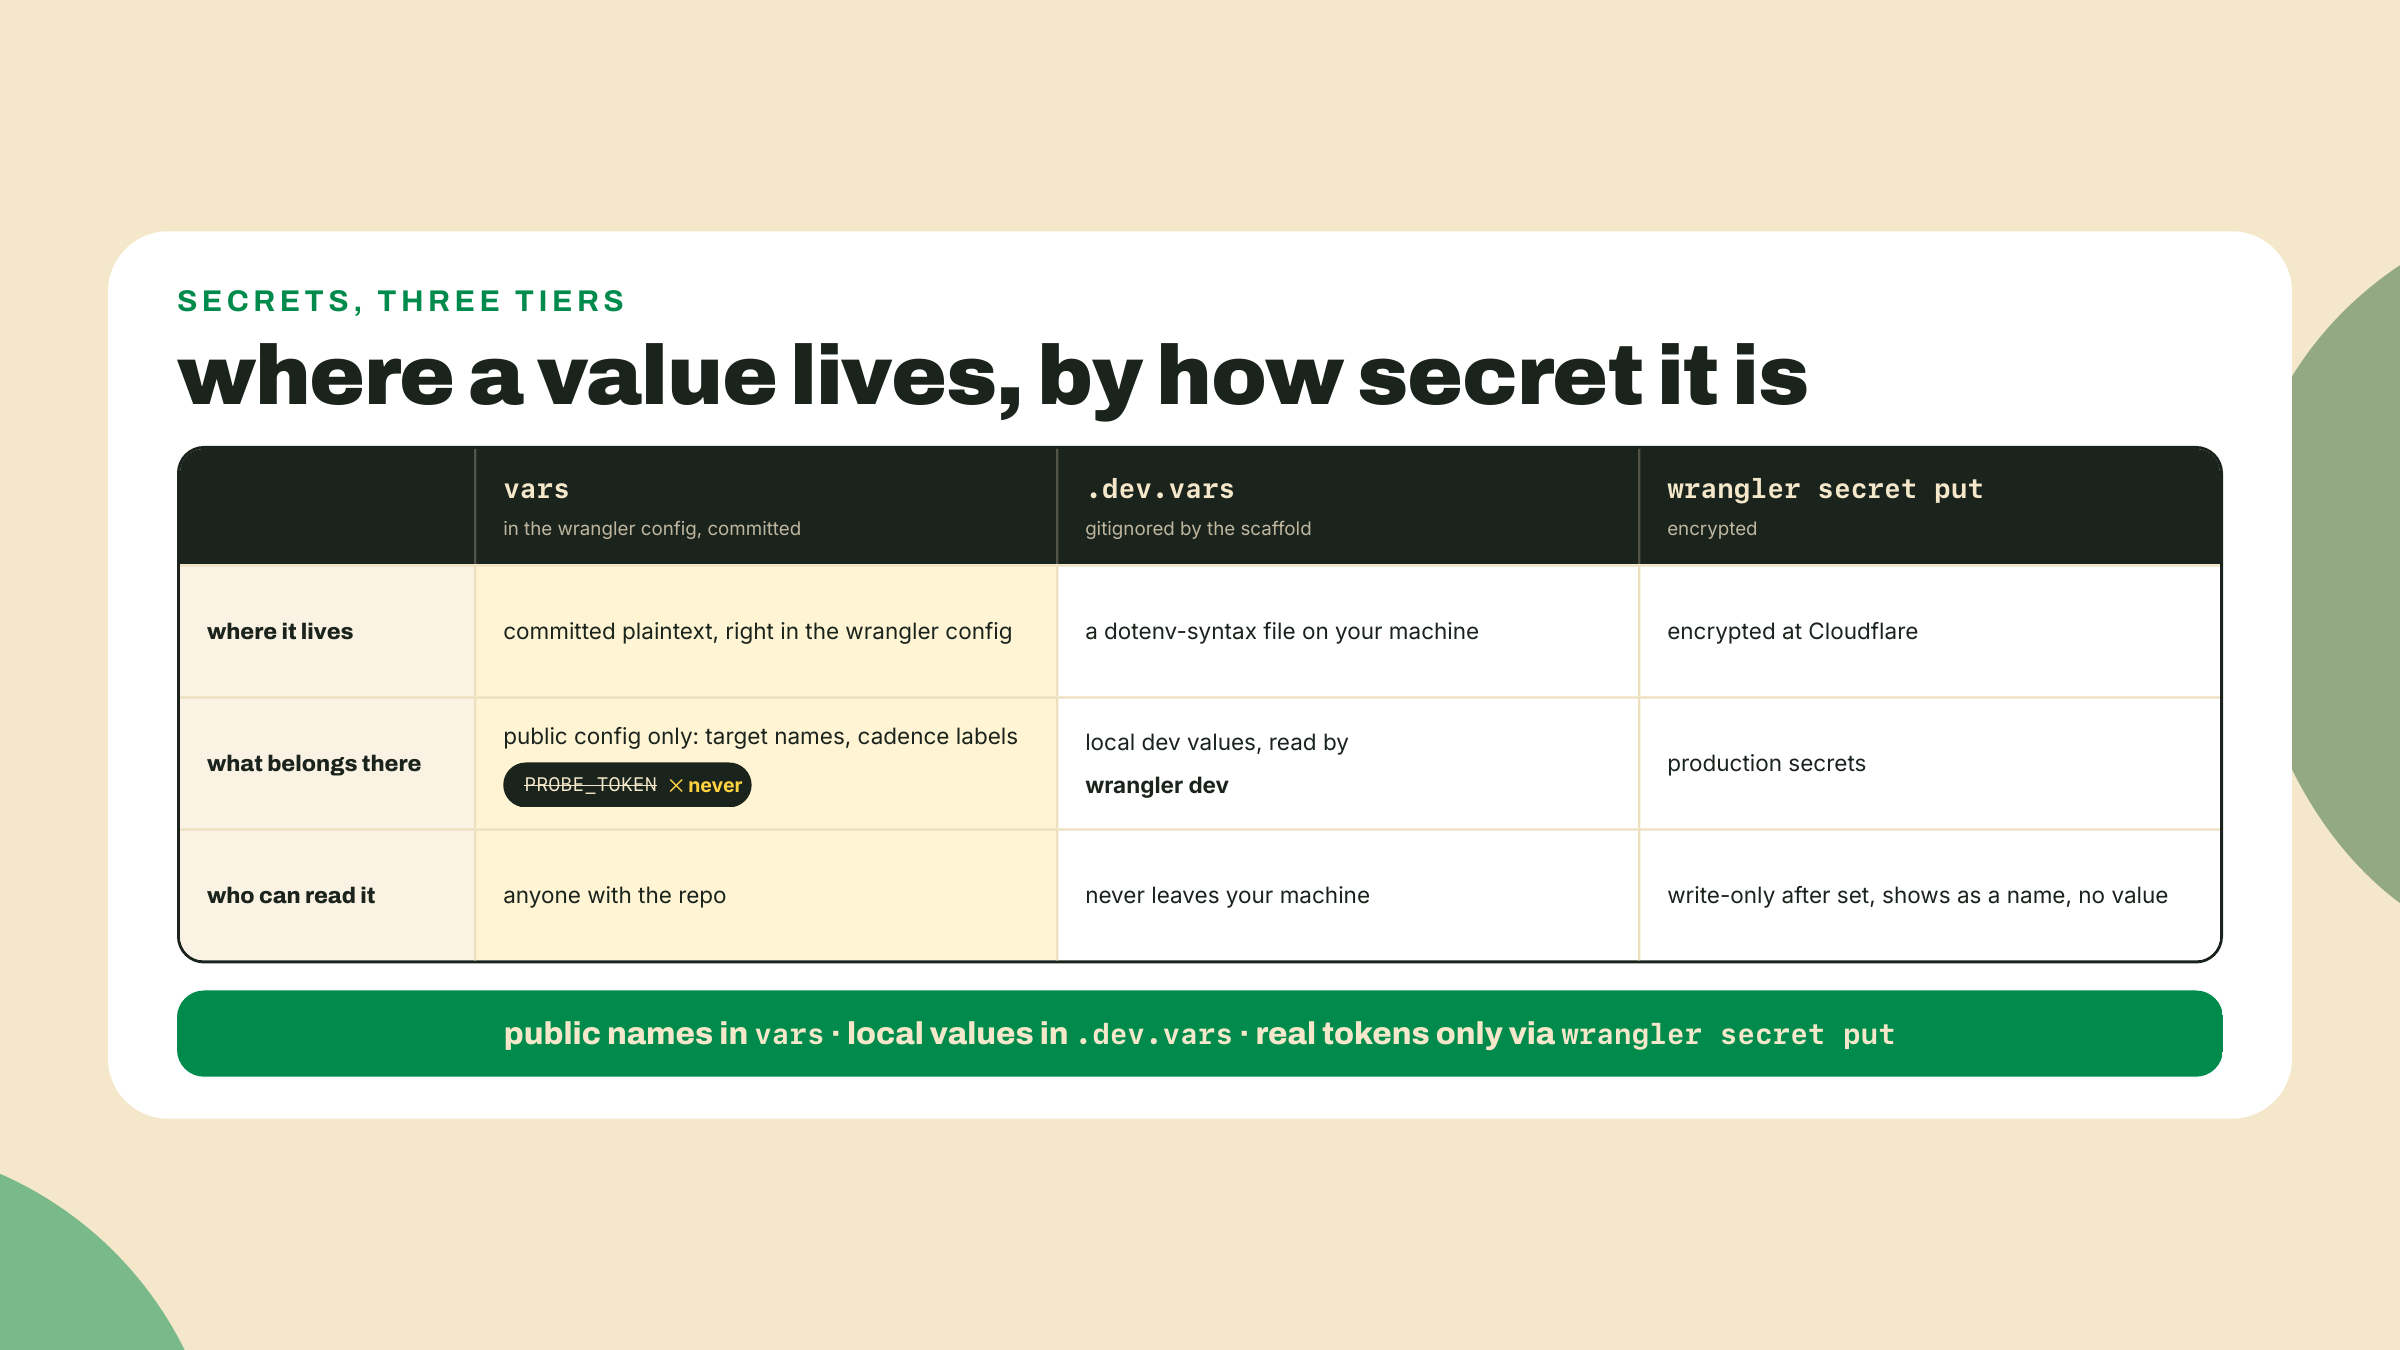
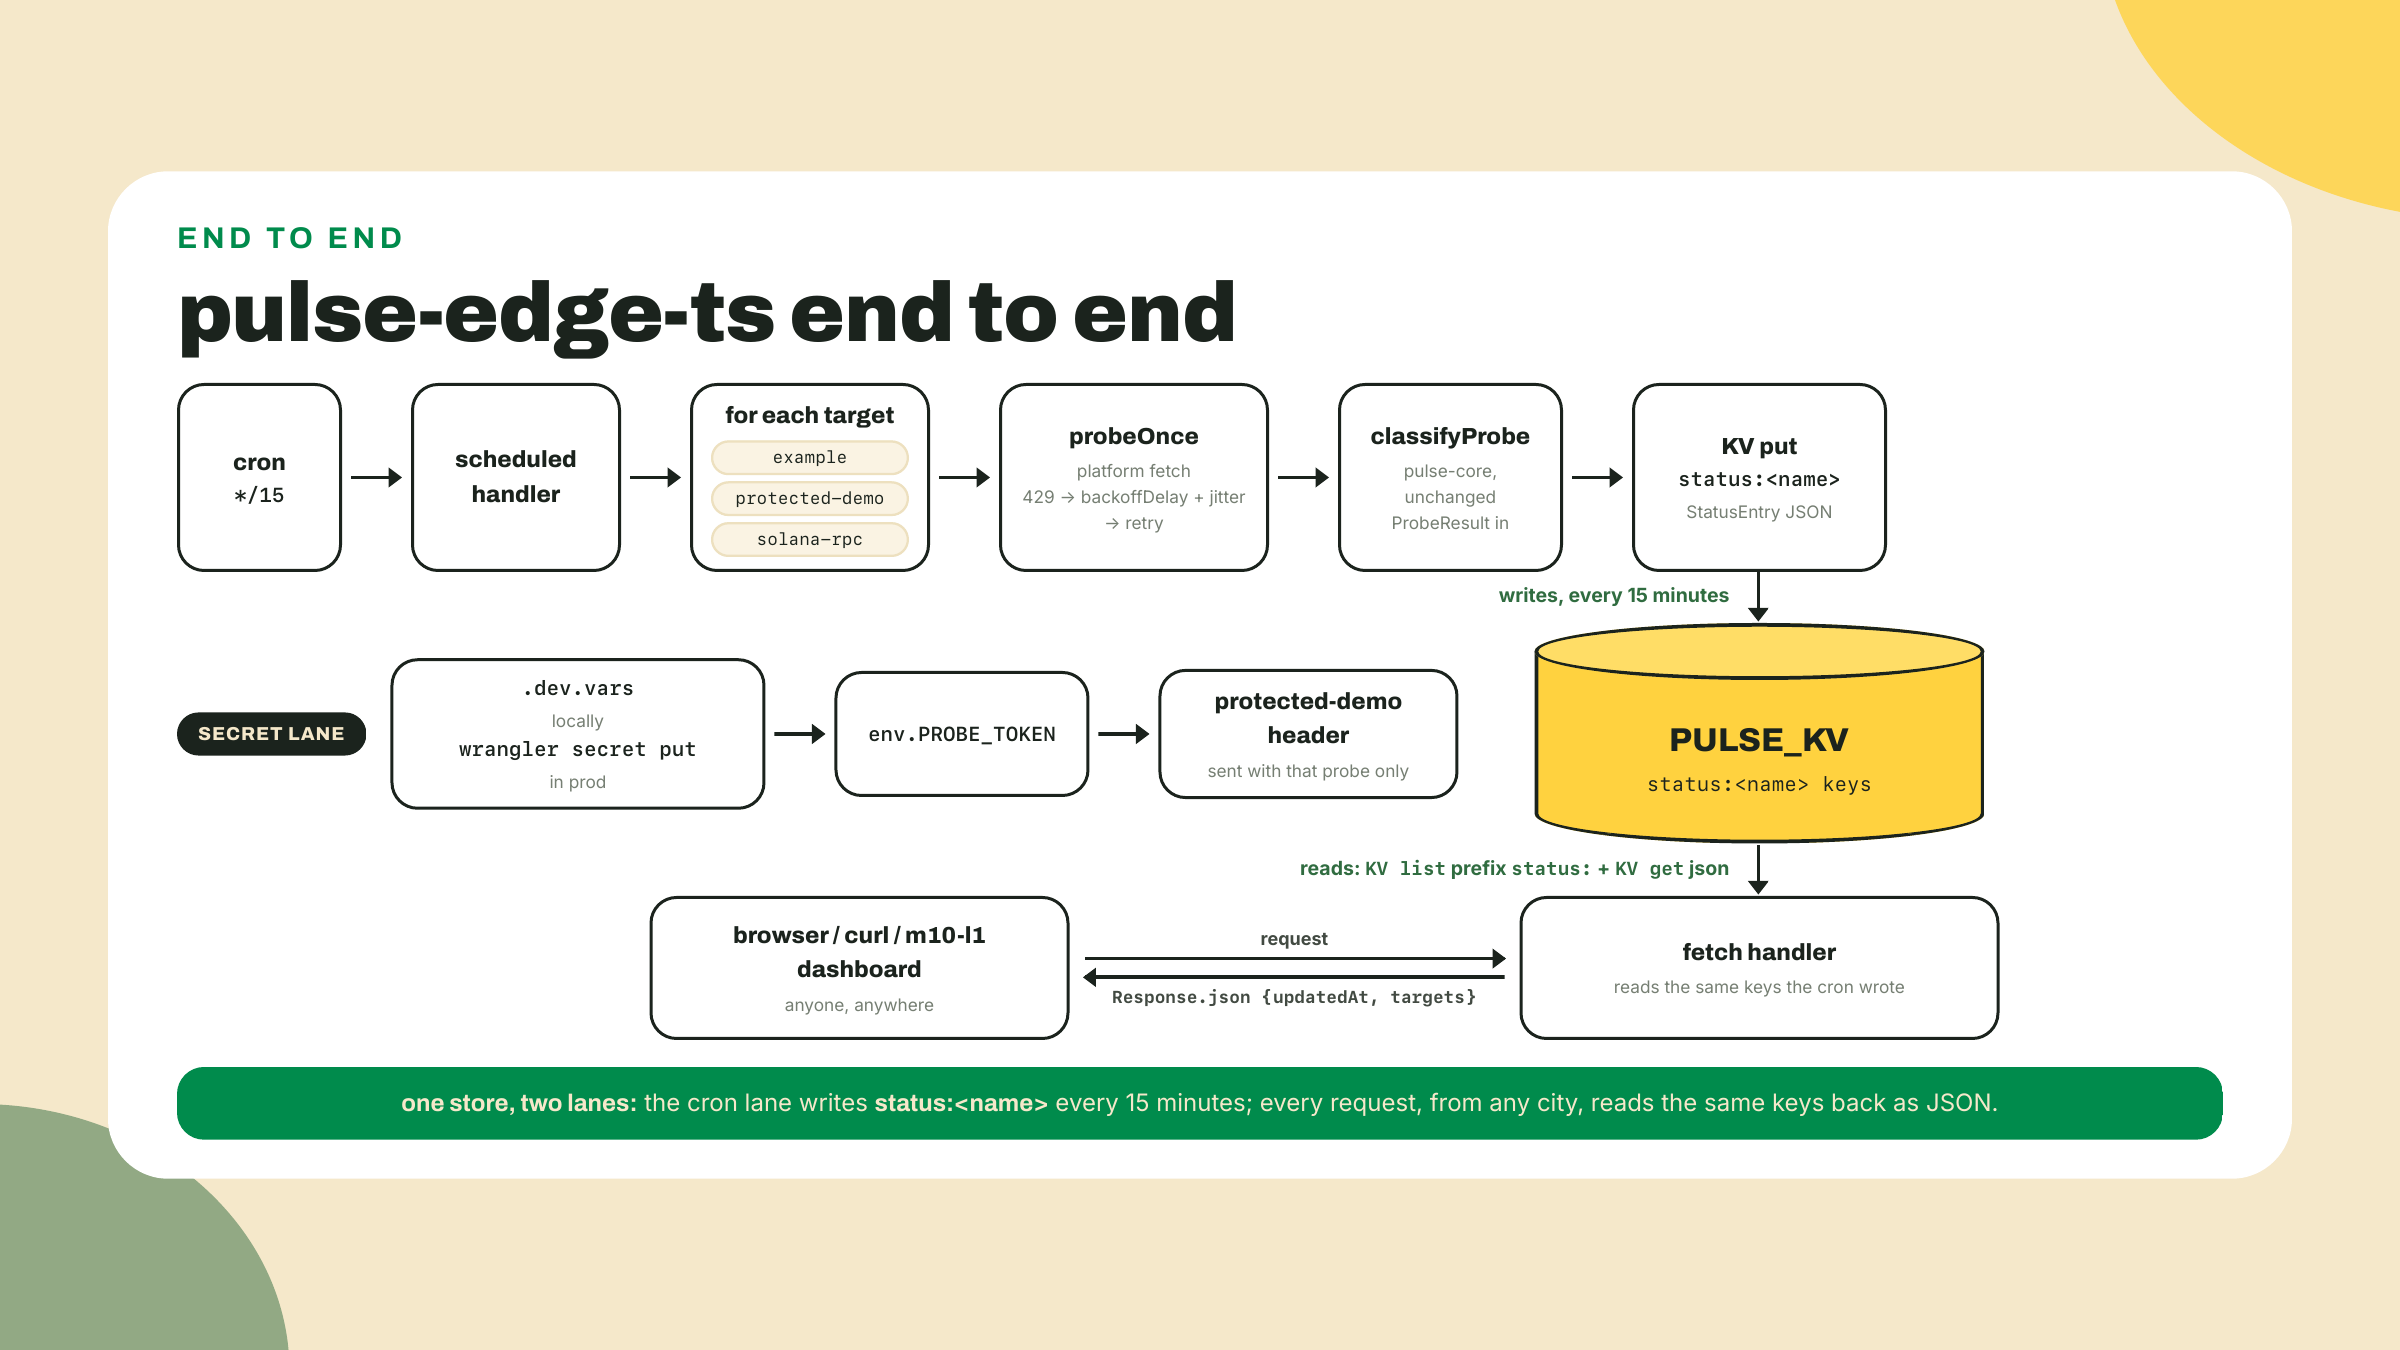
Segredos em seguida, e isto agora é um hábito ensinado, não uma nota de rodapé, porque o worker precisa de um de verdade: um token de header para um alvo de demo protegido. A regra tem três tiers. Config comum que qualquer um pode ler vai no bloco vars da config do wrangler, e só isso, porque aquele arquivo é commitado. Segredos de desenvolvimento local vão no .dev.vars, sintaxe dotenv, gitignorados pelo scaffold, lidos automaticamente pelo wrangler dev. Segredos de produção sobem com npx wrangler secret put <KEY>, que pergunta o valor, guarda ele encriptado, e nunca mostra ele de novo; não legível no painel, não legível pelo wrangler, visível só como um nome. Um token no bloco vars é texto puro commitado com a cara inocente de um arquivo de config. Esse é o modelo de higiene inteiro, e a m09-l2 vai varrer ele pelas quatro plataformas.
Agora o parágrafo do dinheiro, números ditos uma vez e sem rodeios, todos da página de preços sondada em 2026-09-01. Workers Free: 100,000 requisições por dia, e 10 ms de CPU por invocação. KV gratuito: as 100,000 leituras e 1,000 escritas por dia contra as quais você acabou de orçar. O número sutil é o da CPU, então segure ele contra a luz: 10 ms medem computação, não espera. Tempo gasto esperando um fetch é de graça; um loop síncrono apertado é o que estoura o orçamento. Deixe concreto com o nosso próprio domínio: suponha que uma versão futura guardasse histórico de sondas e você decidisse que o worker deveria calcular percentis móveis sobre dez mil amostras a cada requisição. Ordenar dez mil números é CPU de verdade, faça isso algumas vezes seguidas e você está raspando o medidor, e o modo de falha não é uma conta, é invocações dando erro no meio da computação enquanto a sua contagem de requisições fica longe do teto diário. Enquanto isso o worker atual espera três fetches e gasta bem menos de um milissegundo de fato computando. Essa assimetria é a personalidade inteira do tier: um worker de sonda cabe nele lindamente porque a vida dele é 99% esperar nos servidores dos outros, e computação pesada continua pertencendo ao poller Docker, onde a CPU é sua por hora em vez de medida por milissegundo. Sobre a pergunta do cartão: em lugar nenhum da documentação ou dos preços da Cloudflare o fornecedor imprime uma promessa de "sem cartão de crédito", então eu não vou colocar essas palavras na boca dela; o que eu posso dizer é que todo relato de 2026 do cadastro do Workers Free que a gente conseguiu achar não tinha cartão pedido na sonda de 2026-09-01. Se o seu cadastro pedir um, essa é uma nota de feedback do curso que eu quero.
A estação vem derivando na direção da Solana desde o M2, e hoje a blockchain vira um alvo monitorado, sem cerimônia e sem biblioteca nova. O RPC público da Solana fala JSON-RPC sobre POST HTTP simples, e a pergunta mais barata dele é getHealth:
curl -s https://api.mainnet.solana.com -X POST -H "content-type: application/json" \
  -d '{"jsonrpc":"2.0","id":1,"method":"getHealth"}'
Um nó saudável responde {"jsonrpc":"2.0","result":"ok","id":1}. Aquele hostname é a forma que a documentação de clusters da própria Solana imprime hoje, e é a que este curso usa em todo lugar; o M8 abre te contando qual é a grafia mais antiga que você vai encontrar em tutoriais e por que ela ainda resolve.
Uma nota de honestidade de produção antes de o seu worker sondar ele: aquele curl dar certo não promete que o mesmo POST dá certo de dentro do workerd. Endpoints de RPC público rodam política antiabuso sobre mais do que taxa de requisições; eles discriminam por impressão digital do cliente e por egress, e a partir de uma reverificação em 2026-09-04, o POST getHealth idêntico que devolve ok do curl volta assim de um isolate do wrangler dev na mesma máquina e no mesmo IP:
{"jsonrpc":"2.0","error":{"code":403,"message":"Your IP or provider is blocked from this endpoint"},"id":1}
Provedores bloqueiam alguns clientes por atacado, sem culpa nenhuma do seu código. Essa é a primeira lição de ops de verdade de um monitor: um upstream é um ponto único de recusa, então uma estação carrega um fallback documentado. O nosso é https://solana-rpc.publicnode.com, sem chave, mesmo JSON-RPC (verificado respondendo ok de dentro do workerd, 2026-09-04). O api.mainnet.solana.com continua canônico; o passo 7 te diz quando recorrer ao fallback. Para o worker, isto é mais um alvo: POST em vez de GET, medir a latência, alimentar o resultado no mesmo classifyProbe que toda outra parte da estação usa. Nada de @solana/kit ainda, de propósito; o M8 apresenta ele quando a gente começa a se importar com o que está dentro das respostas. Hoje o transporte respondendo com presteza é o sinal de saúde.
Seja preciso sobre o que aquele sinal é, porque ferramentas de monitoramento que exageram as próprias medições são o motivo de páginas de queda acabarem mentindo. O getHealth é o nó que você perguntou reportando sobre si mesmo: ele diz "ok" quando aquele nó acredita que está em dia com o cluster, e um nó não saudável ou atrasado responde com um corpo de erro JSON-RPC no lugar. É a autoavaliação de uma máquina atrás de um balanceador de carga, não um veredito sobre a Solana. A sua sonda portanto mede exatamente duas coisas honestas: se o RPC público te respondeu, e quão rápido, a partir de qualquer cidade em que o seu isolate rodou. É precisamente isso que uma estação de status deveria registrar, e precisamente como a entrada deveria ser lida. Quando o M8 começar a decodificar corpos de resposta com o kit, a estação é promovida de "o endpoint de RPC responde" para "e aqui está o que a blockchain diz," e a diferença entre essas duas frases é uma distinção que você agora domina.
Uma disciplina atravessa sem cortes. O RPC público permite 100 requisições por 10 segundos por IP, e um 429 vindo dele quer dizer a mesma coisa que um 429 queria dizer na m02-l3: estão te dizendo um orçamento, e martelar nele cava o buraco mais fundo. O backoff que você construiu lá, backoffDelay mais jitter igual, vem através do import do pulse-core e embrulha a sonda do RPC no lab. O argumento inteiro do M8 está neste parágrafo em miniatura: a blockchain é só mais um endpoint, com latências de verdade e limites de verdade, e as boas maneiras de engenharia que você construiu para HTTP instável são as maneiras que sondar a blockchain exige.
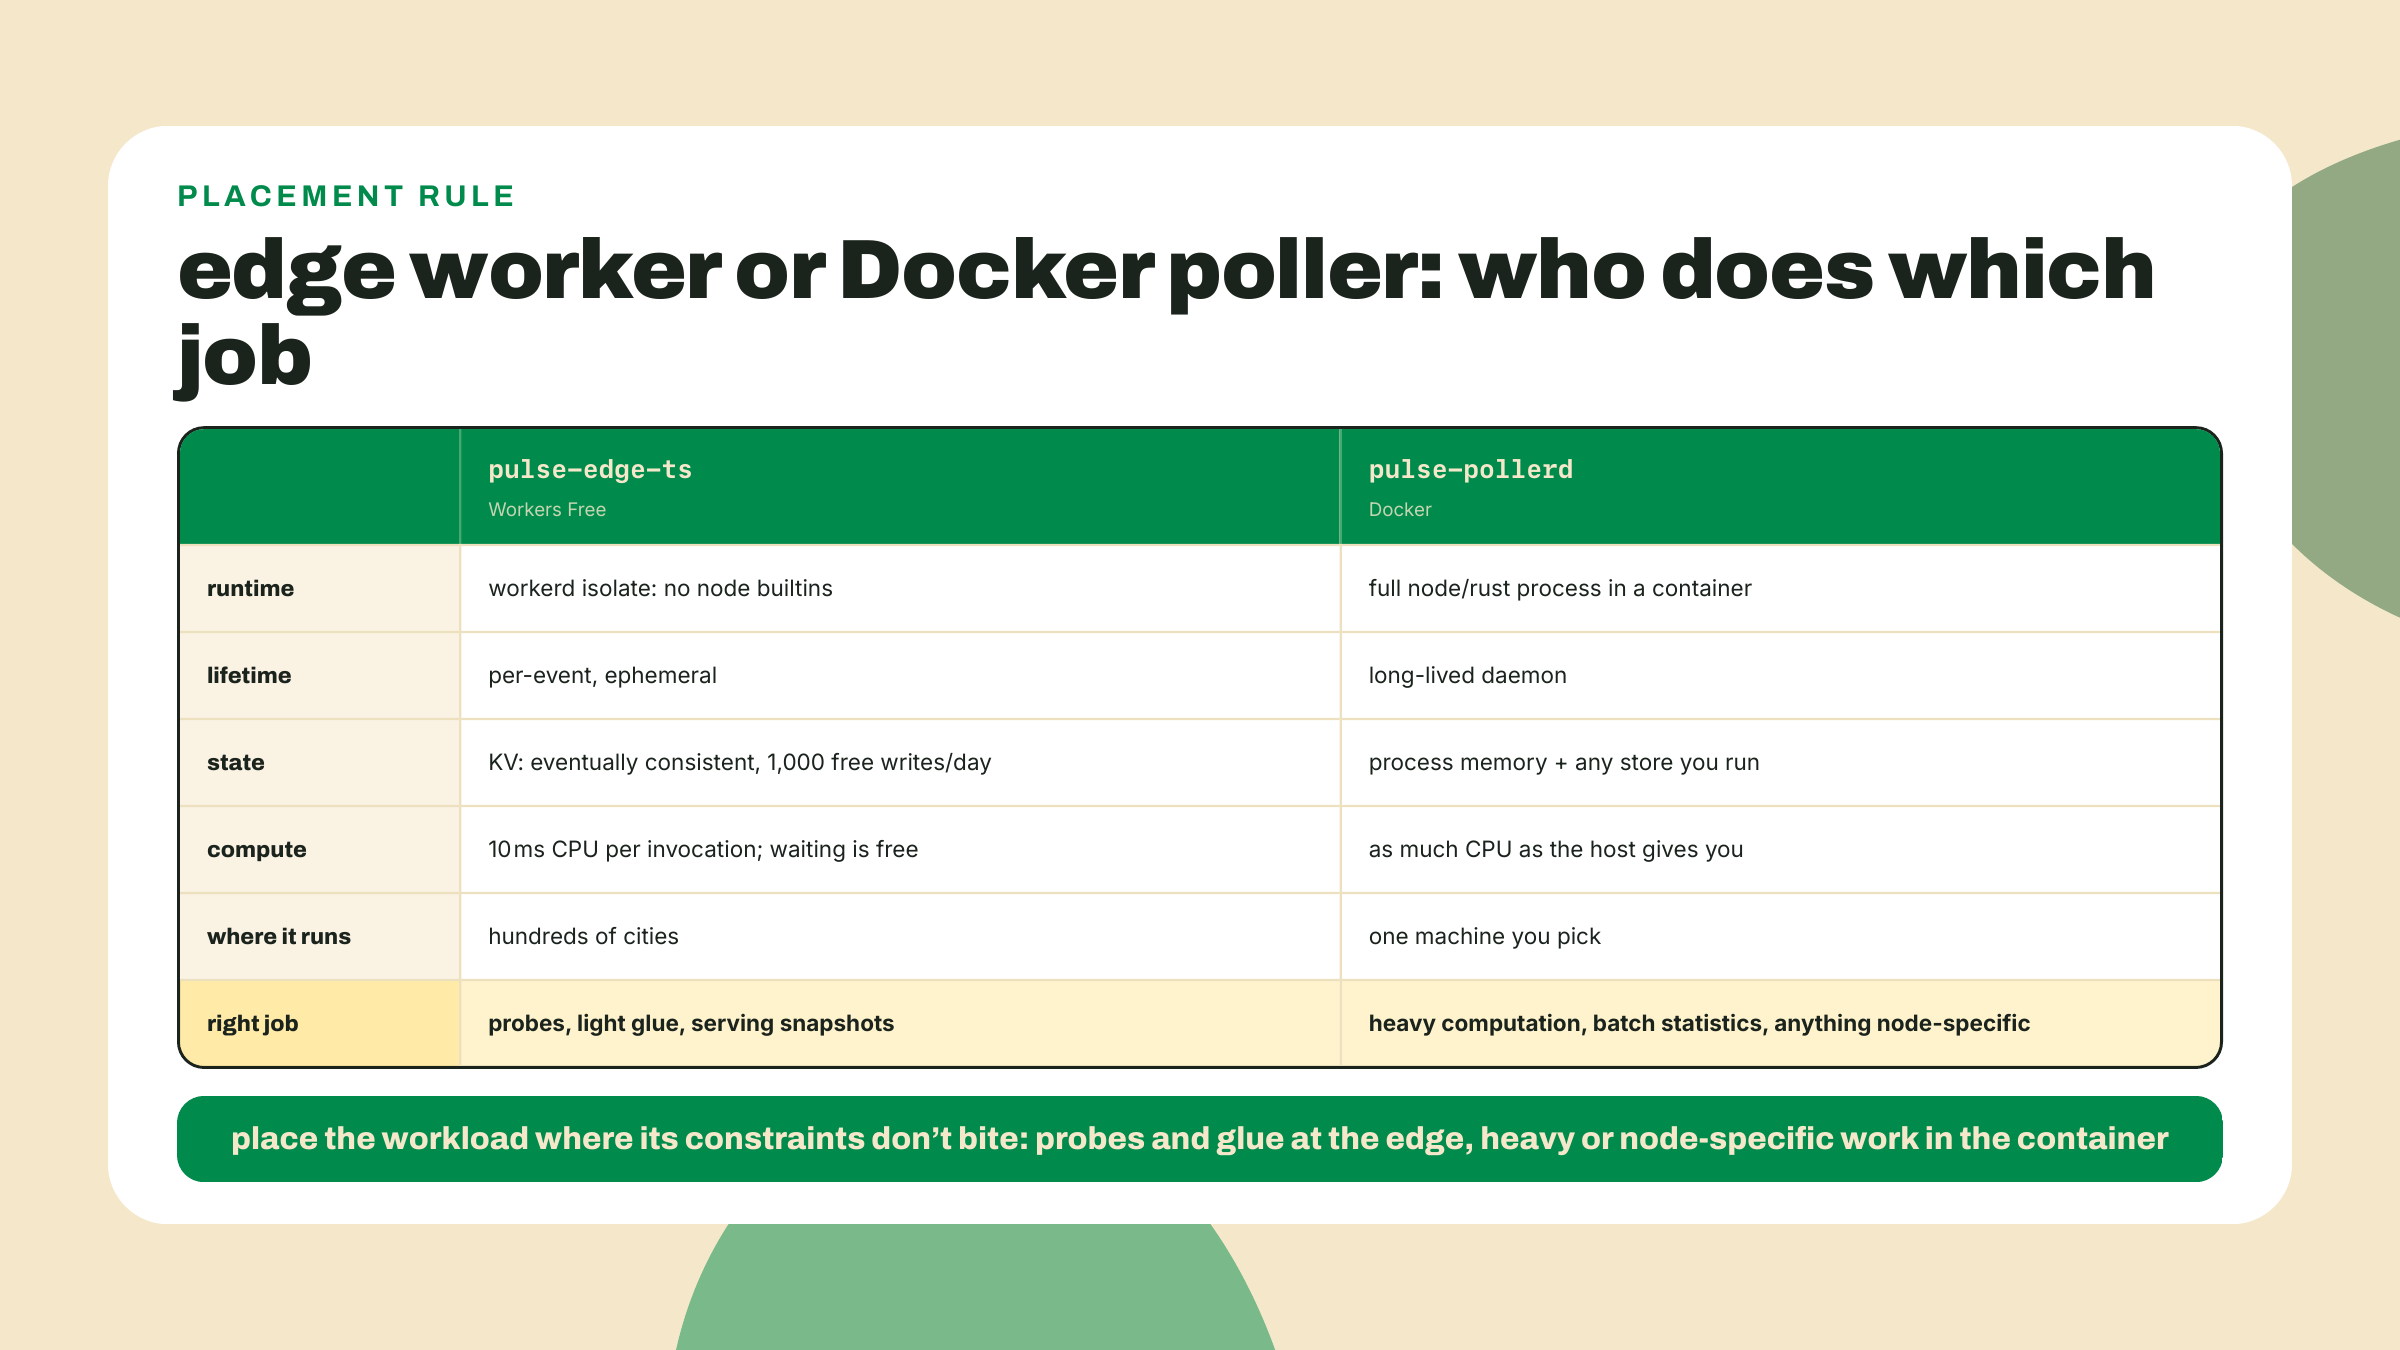
Esta seção ficou longa, então deixa eu nomear o trade-off e fechar a teoria. O edge te dá proximidade e escala que você não opera, e o preço é um runtime deliberadamente estreito: builtins do node como shims sem OS por trás deles, nenhuma memória de vida longa, nenhuma thread, 10 ms de CPU medida, e estado compartilhado só através de um armazenamento eventualmente consistente com uma cota diária de 1,000 escritas. O edge é onde sondas pertencem, não onde tudo pertence. Diga a divisão de trabalho em voz alta, porque você agora opera as duas metades: o worker mede e lembra a resposta mais recente; o poller, com um sistema de arquivos de verdade, CPU sem medição, e toda a memória de processo que ele quiser, é onde histórico se acumula e estatísticas são calculadas quando a estação criar essas ambições. O tier de contêiner do M6 continua existindo por um motivo, e quando a Cloudflare entregou os Containers em GA em 2026-04-13 (só planos pagos), a própria plataforma cedeu o ponto: algumas cargas de trabalho só querem uma caixa Linux. A sua mantém a caixa dela no GHCR; as sondas de hoje ganham as cidades.
Vá mais fundo (os 20%). esta lição ensinou a plataforma através do tanto dela que cabe em um worker: isolates, os dois handlers, KV, cron, segredos. O tour guiado de todo o resto (R2, D1, Durable Objects, Queues, o painel) mora no guia de primeiros passos da própria Cloudflare: https://developers.cloudflare.com/workers/get-started/guide/ (URL checada em 2026-09-02). Salve como bookmark, percorra ele depois do lab. Nada abaixo depende dele.
O recuo, dito: os passos 1 e 2 você já fez na abertura. O esqueleto e a config nos passos 3 a 5 são dados com o par do KV e o loop do cron como buracos que você preenche. O passo 6 é segredos, trabalhado de forma sucinta. O segundo tipo de alvo depois disso é o challenge, inteiramente seu.
Confirme o estado do scaffold. Você tem pulse-edge-ts/ com deploy feito com hello-world da abertura. Se não, rode os dois comandos do topo da lição agora. Tudo abaixo edita este projeto.
Instale o motor e prove a costura. Dois comandos, uma falha de propósito:
npm i @YOUR_NPM_USERNAME/pulse-core
(Pulou o publish no npm da m03-l4? Nenhuma conta necessária: npm pack dentro de packages/pulse-core, a mesma jogada de tarball que a m03-l4 usou para inspeção, depois npm i ../packages/pulse-core/<scope>-pulse-core-0.1.0.tgz; instalar a partir de um tarball local é novo aqui, e é um comando só.) Depois, no topo de src/index.ts, cole a jogada de carregamento de config da frota:
import { readFileSync } from "node:fs";
const config = JSON.parse(readFileSync("./pulse.config.json", "utf8"));
e rode npx wrangler dev. O import em si resolve, porque o workerd atual já vem com um shim de compatibilidade com o Node, e aí o runtime se recusa a iniciar:
✘ [ERROR] The Workers runtime failed to start.
...
Uncaught Error: no such file or directory, readAll '/bundle/pulse.config.json'
  ... in readFileSync
Leia aquele caminho. O /bundle é o único sistema de arquivos que um worker tem, o próprio código que ele subiu, somente leitura. Aquela recusa é a costura da seção de teoria, ao vivo na sua tela: o módulo portou, a máquina não. Delete as duas linhas. O import do núcleo no próximo passo resolve limpo, e agora você sabe por que a diferença existe.
Substitua a config. Abra o wrangler.jsonc e deixe ele assim (o id do seu namespace chega no passo 4; deixe o placeholder até lá):
{
  "name": "pulse-edge-ts",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-02",
  "triggers": {
    "crons": ["*/15 * * * *"]
  },
  "kv_namespaces": [
    { "binding": "PULSE_KV", "id": "<your-namespace-id>" }
  ]
}
Crie o namespace. Um comando, depois uma colagem:
npx wrangler kv namespace create PULSE_KV
A saída imprime o id do namespace e o trecho exato do binding; substitua <your-namespace-id> na sua config pelo id de verdade. Daqui em diante, o código do handler alcança o armazenamento como env.PULSE_KV, e a geração de tipos do scaffold mantém o Env honesto: rode npm run cf-typegen (o scaffold já traz ele; ele roda wrangler types por baixo do capô, então npx wrangler types se o seu template nomeou ele de outro jeito) toda vez que bindings mudarem.
O worker, com dois buracos. Substitua o src/index.ts pelo esqueleto abaixo. Tudo é dado menos os dois TODOs: o par put/get do KV, e o corpo por alvo do loop do cron com backoff no alvo do RPC. Preencha eles antes de ler as versões prontas que vêm depois.
import {
  classifyProbe,
  backoffDelay,
  type ProbeResult,
} from "@YOUR_NPM_USERNAME/pulse-core";

interface Env {
  PULSE_KV: KVNamespace;
  PROBE_TOKEN: string;
}

interface Target {
  name: string;
  url: string;
  kind: "http" | "solana-getHealth";
  headers?: Record<string, string>;
}

interface StatusEntry {
  name: string;
  verdict: ReturnType<typeof classifyProbe>;
  result: ProbeResult;
  checkedAt: string;
}

const TIMEOUT_MS = 3000;
const MAX_RETRIES = 2;
const BASE_MS = 500;
const CAP_MS = 4000;

const sleep = (ms: number) => new Promise((resolve) => setTimeout(resolve, ms));

// pulse-core exports the frozen (kind, value) boundary form. A dns-error
// carries a hostname, not a reading, so it is decided here, not there.
function verdictOf(result: ProbeResult): ReturnType<typeof classifyProbe> {
  switch (result.kind) {
    case "ok":
      return classifyProbe("ok", result.latencyMs);
    case "timeout":
      return classifyProbe("timeout", result.budgetMs);
    case "http-error":
      return classifyProbe("http-error", result.status);
    case "dns-error":
      return "down";
  }
}

function targetList(env: Env): Target[] {
  return [
    { name: "example", url: "https://example.com/", kind: "http" },
    {
      name: "protected-demo",
      url: "https://httpbin.org/bearer",
      kind: "http",
      headers: { authorization: `Bearer ${env.PROBE_TOKEN}` },
    },
    { name: "solana-rpc", url: "https://api.mainnet.solana.com", kind: "solana-getHealth" },
  ];
}

async function probeOnce(target: Target): Promise<ProbeResult> {
  const controller = new AbortController();
  const timer = setTimeout(() => controller.abort(), TIMEOUT_MS);
  const started = Date.now();
  try {
    const res =
      target.kind === "solana-getHealth"
        ? await fetch(target.url, {
            method: "POST",
            headers: { "content-type": "application/json" },
            body: JSON.stringify({ jsonrpc: "2.0", id: 1, method: "getHealth" }),
            signal: controller.signal,
          })
        : await fetch(target.url, { headers: target.headers, signal: controller.signal });
    await res.text();
    if (res.ok) {
      return { kind: "ok", latencyMs: Date.now() - started };
    }
    return { kind: "http-error", status: res.status };
  } catch {
    if (controller.signal.aborted) {
      return { kind: "timeout", budgetMs: TIMEOUT_MS };
    }
    return { kind: "dns-error", host: new URL(target.url).hostname };
  } finally {
    clearTimeout(timer);
  }
}

async function probeWithBackoff(target: Target): Promise<ProbeResult> {
  let result = await probeOnce(target);
  for (let attempt = 0; attempt < MAX_RETRIES; attempt++) {
    if (!(result.kind === "http-error" && result.status === 429)) break;
    const delay = backoffDelay(attempt, BASE_MS, CAP_MS);
    const jittered = delay / 2 + Math.random() * (delay / 2);
    await sleep(jittered);
    result = await probeOnce(target);
  }
  return result;
}

export default {
  async scheduled(controller: ScheduledController, env: Env, ctx: ExecutionContext) {
    const checkedAt = new Date().toISOString();
    for (const target of targetList(env)) {
      // TODO 1: probe this target (with backoff), classify the result with
      // verdictOf, assemble a StatusEntry, and put it into PULSE_KV
      // under the key `status:${target.name}` as JSON.
    }
  },

  async fetch(request: Request, env: Env): Promise<Response> {
    // TODO 2: list PULSE_KV keys with the "status:" prefix, get each entry
    // as JSON, and return { updatedAt, targets } via Response.json, with a
    // CORS header so a browser page may read this endpoint.
    return Response.json({ updatedAt: new Date().toISOString(), targets: [] });
  },
} satisfies ExportedHandler<Env>;
Leia o que já foi decidido para você antes de preencher buracos, cinco notas:
probeOnce da m02-l3 em fetch de plataforma, as mesmas quatro saídas para a mesma união; só um 429 dá a volta no loop de retry, com jitter, exatamente a disciplina da frota, agora mirada no teto do RPC de 100 requisições por 10 segundos por IP.Date.now() porque o workerd não é node e o performance.now() lá é deliberadamente engrossado por causa de ataques de temporização; campos de milissegundo lidos de um relógio grosso são honestos o bastante para uma página de status.dns-error. Se esse exagero coçar depois do parágrafo acima sobre ferramentas que exageram as medições delas, ótimo; a renomeação que a m02-l3 ofereceu (network-error, com o compilador te levando até todo switch) está a uma tarefa de distância.Env à mão para que esta página seja autocontida, mas no seu repo a saída do npm run cf-typegen do passo 4 é o Env autoritativo; assim que PROBE_TOKEN existir no .dev.vars (passo 6), rode a typegen de novo e aposente a interface local em favor da gerada, que é o mecanismo que o passo 4 vendeu.Agora o corpo completo do TODO 1, para depois de você ter escrito o seu:
const result = await probeWithBackoff(target);
const entry: StatusEntry = {
  name: target.name,
  verdict: verdictOf(result),
  result,
  checkedAt,
};
await env.PULSE_KV.put(`status:${target.name}`, JSON.stringify(entry));
console.log(`${target.name}: ${entry.verdict}`);
E o TODO 2:
const list = await env.PULSE_KV.list({ prefix: "status:" });
const targets: StatusEntry[] = [];
for (const key of list.keys) {
  const entry = await env.PULSE_KV.get<StatusEntry>(key.name, "json");
  if (entry) targets.push(entry);
}
return Response.json(
  { updatedAt: new Date().toISOString(), targets },
  { headers: { "access-control-allow-origin": "*" } },
);
Duas linhas aqui são interface, não implementação, então trate elas como congeladas. Primeiro, o formato da resposta: { updatedAt, targets } onde cada entrada carrega name, verdict, result, e checkedAt. Este JSON é a superfície exata em que o capstone do M10 faz polling quando o painel ganha uma coluna de edge, então os nomes de campo que você entrega hoje são os nomes de campo de que uma página futura vai depender. Segundo, o header de CORS: o capstone lê este endpoint de um navegador, navegadores bloqueiam leituras cross-origin por padrão, e access-control-allow-origin: * é a configuração honesta para um snapshot de status público e somente leitura. Nada aqui é sensível; o propósito inteiro do endpoint é ser lido por estranhos. (Se aquele header é novo para você, não desvie; o lado de navegador da história recebe o tratamento devido no capstone, quando uma página nossa de fato faz o fetching.)
A linha console.log não é decoração; é o que o wrangler tail te mostra no passo 7. Repare no que a linha do classificador prova: o classifyProbe, sem modificação, publicado a partir do seu workspace semanas atrás, está agora produzindo vereditos dentro de um isolate. O wrapper verdictOf em volta dele são quatro linhas de adaptador, não um segundo classificador: ele só desempacota cada variante no par (kind, value) que a fronteira publicada aceita, e decide sobre a única variante que não tem leitura numérica para dar a ele. Toda banda, todo limiar, todo julgamento continua sendo do pacote. Mesmo código do painel, mesmo código da CLI.
Higiene de scaffold: o template do C3 trouxe test/index.spec.ts, specs do vitest afirmando que o handler de fetch devolve Hello World!. Ele parou de fazer isso no momento em que você colou o esqueleto, então aquelas specs estão vermelhas daqui em diante. Delete o arquivo, ou reescreva as asserções dele contra o formato { updatedAt, targets }; testes que falham conscientemente ensinam todo mundo a ignorar o comando de teste.
Ligue o segredo, as duas metades. Localmente, crie .dev.vars na raiz do projeto (o gitignore do scaffold já cobre ele; verifique com git check-ignore .dev.vars):
echo 'PROBE_TOKEN=local-dev-token' > .dev.vars
Para produção:
npx wrangler secret put PROBE_TOKEN
Digite qualquer valor no prompt. Um pequeno crédito de honestidade ao httpbin aqui: o endpoint /bearer dele devolve 200 para qualquer bearer token e 401 para nenhum, o que faz dele um substituto gratuito de alvo protegido; o valor do token não importa, o encanamento importa. O que você está praticando é a regra de três tiers com comandos de verdade, e a checagem de aceitação no fim prova isso por grep.
Rode local, depois entregue. Inicie o npx wrangler dev, depois force o cron num segundo terminal:
curl "http://localhost:8787/cdn-cgi/handler/scheduled"
(Mesmo fallback da seção de teoria se isto der 404: npx wrangler dev --test-scheduled mais a rota /__scheduled?cron=*+*+*+*+*.) Veja o terminal de dev imprimir três linhas de veredito, depois bata em http://localhost:8787/ e leia o seu snapshot JSON. Depois:
npx wrangler deploy
npx wrangler tail
Deixe o tail rodando até o quarto de hora virar e o cron disparar em produção; as mesmas três linhas de log chegam da infraestrutura da Cloudflare sem nenhuma máquina sua envolvida. Aquele comando merece uma frase de respeito, porque é o seu primeiro gostinho de observabilidade numa plataforma onde você não consegue dar ssh em lugar nenhum: o tail faz streaming de logs e exceções ao vivo de toda cidade em que o seu worker roda, para dentro do seu terminal, e é a diferença entre "o cron provavelmente disparou" e ver ele disparar. O painel da Cloudflare mostra a mesma história na visão de worker dele se você prefere clicar a fazer streaming; qualquer um dos dois é evidência aceitável. Checkpoint: curl -s https://pulse-edge-ts.<your-subdomain>.workers.dev/ devolve JSON com uma entrada por alvo, e a entrada solana-rpc carrega um veredito da sonda getHealth mais recente. Se aquela entrada em vez disso disser down com {"kind":"http-error","status":403}, isso é a blocklist da seção de teoria recusando o seu isolate, não um bug: o seu worker acabou de tratar uma recusa de verdade corretamente. Troque o alvo pelo fallback documentado e dispare o cron de novo:
{ name: "solana-rpc", url: "https://solana-rpc.publicnode.com", kind: "solana-getHealth" }
A entrada vira up; fique com o endpoint que te responder, e anote a troca. (Workers com deploy fazem egress a partir de IPs de datacenter da Cloudflare, que o antiabuso de RPC público também policia, então o fallback importa em produção também.) Abra ela no seu telefone, fora do wifi, para o efeito completo.
Force uma falha e veja ela aparecer. Mude a URL do alvo example para https://definitely-not-a-real-host.example, faça o redeploy, e depois do próximo disparo do cron dê curl de novo no snapshot. A entrada agora mostra a variante dns-error e um veredito down, com timestamp. (Algumas execuções arquivam um timeout no lugar, quando a resolução de DNS que falha sobrevive ao abort de 3 segundos; qualquer um dos dois é honesto, o veredito é down dos dois jeitos, e um novo disparo normalmente mostra a grafia dns-error.) Aquele loop (quebre um alvo, veja o armazenamento dizer isso na próxima batida) é a razão inteira de a estação existir, agora rodando a partir de centenas de cidades. Restaure a URL e faça o redeploy.
Adicione um segundo tipo de alvo de sonda, de ponta a ponta, sem tocar no encanamento dado: uma checagem de código de status esperado. Um alvo como { name: "redirect-check", url: "https://example.com/missing", kind: "expect-status", expectStatus: 404 } deveria classificar up quando o status da resposta for igual a expectStatus (um 404 pode ser a resposta correta; uma checagem de saúde para uma página que não pode existir é um padrão de monitoramento de verdade), e cair na classificação normal caso contrário. Você vai precisar estender o tipo Target, ensinar o novo tipo ao probeOnce, e decidir para qual variante de ProbeResult uma correspondência de expectativa mapeia; existe uma resposta limpa usando a união do jeito que ela está. Aceitação: npx wrangler deploy dá certo; o seu JSON de workers.dev mostra o novo alvo classificado corretamente; o loop de falha forçada do passo 8 continua funcionando; e o segredo existe em prod via npx wrangler secret list. Depois commite o projeto do worker (git add pulse-edge-ts && git commit) antes da checagem final: git grep -i probe_token acha só o nome do binding, nunca um valor, e a sua config commitada não contém segredo nenhum. O commit vem primeiro porque o git grep busca só arquivos rastreados; num projeto sem commit ele não acha nada e não prova nada.
O que você consegue fazer agora, concretamente: explicar o que é um isolate e prever quais dos seus módulos vão e não vão rodar dentro de um antes de tentar; fazer o scaffold, desenvolver e fazer deploy de um Worker com npm create cloudflare@latest e npx wrangler deploy; persistir estado compartilhado no KV e dimensionar um orçamento de escrita contra um teto de tier gratuito; rodar um cron de verdade no edge e testar ele localmente através da rota scheduled; e manter um segredo fora do git na terceira plataforma seguida.
A recuperação de 30 segundos antes de você fechar a aba: por que o objeto de status parou de morar numa variável, e onde o tempo de CPU é gasto neste worker? Você está buscando: memória de isolate não sobrevive a invocações nem atravessa cidades, então estado compartilhado vai para o KV; e o orçamento de 10 ms mede só computação, então um worker que na maior parte do tempo espera fetches quase não gasta nada. Se as duas saíram limpas, o modelo da plataforma é seu.
Se a costura te mordeu em algum lugar que esta lição não previu (uma dependência de uma dependência indo atrás de um builtin do node é o clássico), mande o nome do módulo no feedback do curso; a tabela de portabilidade acima cresce exatamente a partir desses relatos.
A metade TS da estação agora roda em centenas de cidades. A próxima lição é a recompensa para a qual o arco inteiro de Rust vinha construindo: o mesmo motor puro do M4, compilado para WASM, com deploy no mesmo edge com o mesmo wrangler deploy. Um contrato de plataforma, duas linguagens.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.
Inscreva-se para fazer o quiz
O quiz faz parte do curso — inscreva-se para respondê-lo, acompanhar seu progresso e ganhar XP.